
炼丹师的福音:美团这篇论文教你如何用大模型的Scaling Law武装推荐系统
推荐系统大模型化:美团如何在CTR预估中真正落地Scaling Law?
Exploring Scaling Laws of CTR Model for Online Performance Improvement
论文地址:https://arxiv.org/abs/2508.15326
当前大模型(LLM)的参数狂飙突进,效果的攀升也证明了 **Scaling Law(扩展定律)**在自然语言处理领域的强大威力。但是,当把视角切换到电商和广告推荐的主战场——点击率预估(CTR)时,我们却发现传统的推荐模型往往面临“卷不动”的性能瓶颈。业界普遍认为,在CTR预估任务中,哪怕只是0.001的AUC提升也是极其困难,但上线后又有着巨大的收益潜力。那么,既然大规模参数和海量数据在LLM行之有效,CTR模型能不能也像LLM一样享受 Scaling Law 的红利?
美团的这篇最新研究给出了肯定的答案。他们先是证明了构建一个参数规模和训练数据共同扩展的高等级CTR模型确实能带来精度突破;但随之而来的问题是:推荐系统的线上推理有着极为严苛的延迟要求(往往要求在极高并发下低延迟响应),大规模的深层模型根本来不及进行线上预估。
为了破解这个僵局,这篇论文给出了漂亮的工业界解法:先构建一个具备 Scaling Law 潜力的高等级候选模型 SUAN (Stacked Unified Attention Network) ,再通过稀疏自注意力和并行推理技术将其“瘦身”为 LightSUAN ,最后使用**在线蒸馏(Online Distillation)**技术将大模型的深层知识平滑转移给这个轻量化学生模型,从而使得线上也能部署一个极高精度的CTR计算引擎。
1. 整体架构:统一特征建模的 SUAN
在讨论降维部署前,我们先来看看这个具备强大表征精度的模型 SUAN 是如何搭建的。它其实也顺应了典型的 Embedding与显式交互(Explicit Interaction)的模块范式。
为了彻底发挥序列建模的效能,SUAN 没有将用户动作序列与候选特征粗糙割裂,而是直接将候选对象(Candidate)的常规特征(如Item ID、Category ID等)加入到用户历史行为序列的尾部,组合成具有“目标感知(Target-aware)”的混合序列输入。
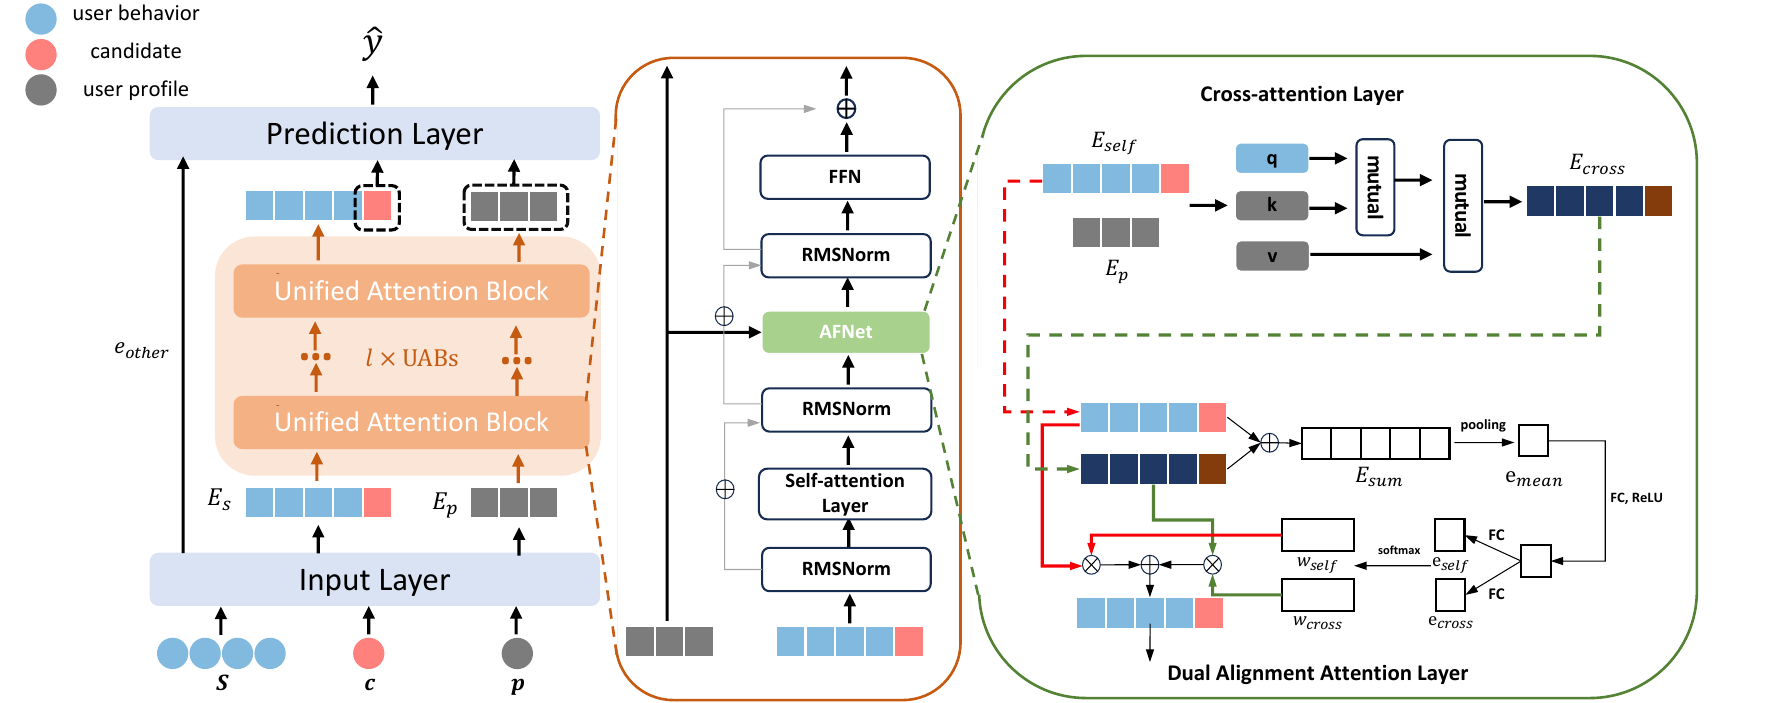
如上图所示,整个 SUAN 架构分为输入层、多层堆叠的统一注意力模块(UAB),以及负责汇总打分的最终预测层。在预测层中,模型提取了最后一个UAB的输出端 candidate 表征,与展平后的用户静态画像(User Profile)和其他细粒度辅助特征一并送入全连接网络(MLP):
y^=σ(z),z=MLP(Eblock[−1,:],ep,eother), \begin{equation} \hat{y} = \sigma(z), \quad z = \mathrm{MLP}(E_{\mathrm{block}}[-1,:], e_p, e_{\mathrm{other}}), \end{equation} y^=σ(z),z=MLP(Eblock[−1,:],ep,eother),
其中 σ\sigmaσ 为 sigmoid 激活概率分布函数,zzz 是输出的 logits 评分。
在这套计算层中,真正的魔法引擎在于中间的那一摞堆叠起来的 统一注意力模块 (UAB)。
2. 统一注意力模块 (UAB)
为了解决大模型下海量参数更新时梯度爆炸与崩塌的毛病,模型借鉴了 LLM 中久经考验的 RMSNorm(均方根层归一化)技术。UAB 模块在进行任何操作前首先应用预归一化:
Enorm=RMSNorm(Es), \begin{equation} E_{\mathrm{norm}} = \mathrm{RMSNorm}(E_s), \end{equation} Enorm=RMSNorm(Es),
不仅减轻了算力浪费,而且能够有效维护深度网络前向传播过程中的数值分布稳定。紧接着进入最核心的三大组件处理逻辑:
2.1 引入时空双维度的 Self-attention
要充分理解用户长短期的行为迁移脉络,自注意力层依然是不可或缺的骨干。但常规注意力其实并不能灵敏感知序列中各项行为在时间和位置上的偏离程度,因此论文在传统的 Scaled dot-product 注意力机制上叠加了“时序+位置”的偏移偏差(attention bias),用于捕捉元素之间的相对跨度和历史距离联系。
Q1,K1,V1=EnormW1Q,EnormW1K,EnormW1V,biasij=f1(Δtij)+f2(Δpij), i,j∈{1,2,…,L},Attention(Q1,K1,V1)=softmax(Q1K1Tn1d+bias)V1,Eself=Concat(Attention1,…,Attentionh)W1O, \begin{equation} \begin{aligned} Q_1, K_1, V_1 = E_{\mathrm{norm}}W_1^Q, E_{\mathrm{norm}}W_1^K, E_{\mathrm{norm}}W_1^V, \\ \mathrm{bias}_{ij} = f_1(\Delta t_{ij}) + f_2(\Delta p_{ij}),\ i, j \in \{1, 2, \ldots, L\}, \\ \mathrm{Attention}(Q_1, K_1, V_1) = \mathrm{softmax}\left(\frac{Q_1 K_1^T}{\sqrt{n_1d}} + \mathrm{bias}\right)V_1, \\ E_{\mathrm{self}} = \mathrm{Concat}(\mathrm{Attention}_1, \ldots, \mathrm{Attention}_h)W_1^O, \end{aligned} \end{equation} Q1,K1,V1=EnormW1Q,EnormW1K,EnormW1V,biasij=f1(Δtij)+f2(Δpij), i,j∈{1,2,…,L},Attention(Q1,K1,V1)=softmax(n1dQ1K1T+bias)V1,Eself=Concat(Attention1,…,Attentionh)W1O,
这里 Δtij\Delta t_{ij}Δtij 和 Δpij\Delta p_{ij}Δpij 就是对元素发生先后时间和物理列表跨度的直观表征函数。
2.2 自适应融合网络 (AFNet)
如果我们仅从序列库里去挖特征,很容易管中窥豹。真实场景下,用户的客观非序列资料(年龄段、性别偏好、消费等级等客观 User Profile)同样扮演着极高信噪比的底座角色。如果直接把动作序列特征和Profile直接粗暴地求和或者拼接,极易被离散序列里的点击杂音(比如无意的误触)淹没稀释。为此,本模块特别设计了 交叉注意力层与双对齐门控注意力,用来精细“提纯”。
交叉注意力 (Cross-attention):
简单理解,这步其实是套用自带“全局真理视野”的Profile特征,去复检用户一连串的碎散行为。它把通过 Self-attention 强化过的序列特征 EselfE_{self}Eself 当作请求端 Query,而把高度置信的用户主画像 EpE_pEp 当作可检索的 Key 和可获取信息的 Value。这相当于让行为特征去向静态表征“对冲”:
Q2,K2,V2=EselfW2Q,EpW2K,EpW2V,Attention(Q2,K2,V2)=softmax(Q2K2Tn1d)V2,Ecross=concat(Attention1,…,Attentionh)W2O, \begin{equation} \begin{aligned} Q_2, K_2, V_2 = E_{\mathrm{self}}W_2^Q, E_pW_2^K, E_pW_2^V, \\ \mathrm{Attention}(Q_2, K_2, V_2) = \mathrm{softmax}\left(\frac{Q_2 K_2^T}{\sqrt{n_1d}}\right)V_2, \\ E_{\mathrm{cross}} = \mathrm{concat}(\mathrm{Attention}_1, \ldots, \mathrm{Attention}_h)W_2^O, \end{aligned} \end{equation} Q2,K2,V2=EselfW2Q,EpW2K,EpW2V,Attention(Q2,K2,V2)=softmax(n1dQ2K2T)V2,Ecross=concat(Attention1,…,Attentionh)W2O,
双对齐注意力 (Dual Alignment Attention Layer):
拿到了自我沉淀的历史序列 (EselfE_{self}Eself) ,也拿到了向画像质检后的校正序列 (EcrossE_{cross}Ecross),接下来该如何分配两者的权重?在通道注意力(channel-wise attention)思想的启发下,模型引入了全局适配的均值池化(Global Mean Pooling)来拿捏分配天平:
Esum=Eself+Ecross,emean=1L∑i=1LEsum(i,:). \begin{equation} \begin{aligned} E_{sum}=E_{self}+E_{cross}, \\ e_{mean}=\frac{1}{L}\sum_{i=1}^L E_{sum}(i,:). \end{aligned} \end{equation} Esum=Eself+Ecross,emean=L1i=1∑LEsum(i,:).
当统揽了全貌 emeane_{mean}emean 后,系统会用两层门控来生成一个判决权重,削弱噪音,高亮关键关联特征:
eself,ecross=(ρ(emeanW1))W2,(ρ(emeanW1))W3,w=softmax([eselfecross])∈R2×L×n1d,wself,wcross=w[0,:,:],w[1,:,:], \begin{equation} \begin{aligned} e_{self},e_{cross}=(\rho(e_{mean}W_1))W_2,(\rho(e_{mean}W_1))W_3, \\ w = \mathrm{softmax}\left(\left[\begin{array}{c} e_{self} \\ e_{cross} \end{array}\right]\right) \in \mathbb{R}^{2 \times L \times n_1d}, \\ w_{self},w_{cross}=w[0,:,:],w[1,:,:], \end{aligned} \end{equation} eself,ecross=(ρ(emeanW1))W2,(ρ(emeanW1))W3,w=softmax([eselfecross])∈R2×L×n1d,wself,wcross=w[0,:,:],w[1,:,:],
这就平滑过渡出了混合后的全貌,也就是兼顾短线发散行为和长远本质刻画的表征:
EAFN=wself⊙Eself+wcross⊙Ecross.
\begin{equation}
E_{AFN} = w_{self}\odot E_{self}+w_{cross}\odot E_{cross}.
\end{equation}
EAFN=wself⊙Eself+wcross⊙Ecross.
2.3 LLM同款平滑层:SwiGLU FFN
既然要吃透 Scaling Law,大厂的做法便是照抄LLM中的黄金搭档——基于Swish平滑激活函数的门控机制网络 SwiGLU 来替换原本粗糙死板的普通ReLU计算层。这不仅改善了深层网络的失活盲区,还在参数拓展时维持了极其优秀的响应:
EFFN=(ϕ(EAFNW1FFN)⊙EAFNW2FFN)W3FFN, \begin{equation} E_{FFN}=(\phi (E_{AFN}W_1^{FFN}) \odot E_{AFN}W_2^{FFN})W_3^{FFN}, \end{equation} EFFN=(ϕ(EAFNW1FFN)⊙EAFNW2FFN)W3FFN,
3. 面向线上的极限瘦身:LightSUAN的浴火重生
尽管上文中的模型堆料极其豪华,甚至能随参数量指数级攀升效果,但是高额的时间复杂度和长序列导致的计算灾难,注定它是无法作为排序主节点上线的。于是美团祭出了“减负”的两套心法:Sparse self-attention 和 Parallel inference。
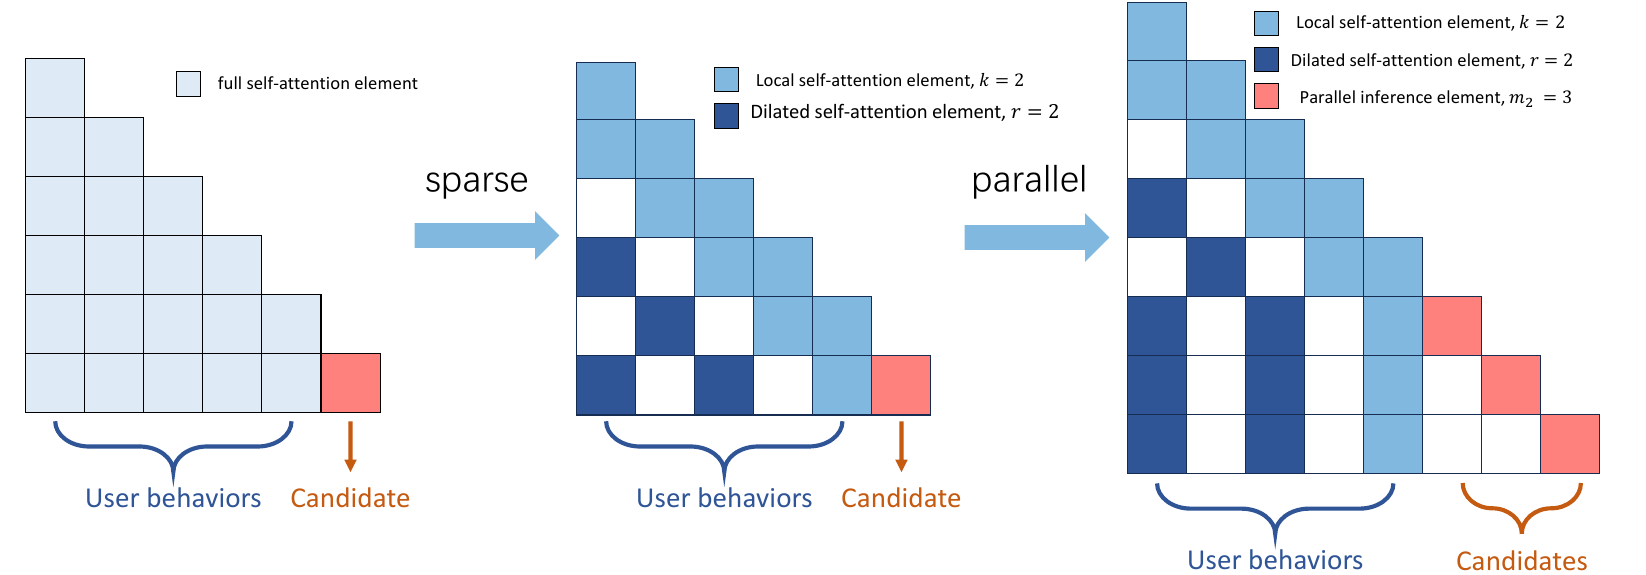
为了降低模型矩阵计算量,稀疏自注意力(Sparse self-attention)强制打散了注意力全连接。只容许特征保留最近身边的连结(窗口感知 k),或者周期性地进行跨度极广的空洞连接(膨胀率 r)。这一砍就干掉了大部分多余参数计算。此外,因为 CTR 在线上往往需要同时筛选评估海量物品,基于序列缓存前置的设计允许复用序列编码,而无需对每个商品重启一次沉重的 Attention 解析,也就是通过**并行推断机制 (Parallel inference)**在时间开销上狠狠地挤干了水分。
但这并不是最终解法:仅仅依靠稀疏化减负构建出来的轻量级模型 LightSUAN 纵然能上线,其表现精度却是残缺的(与庞大的深度大模型 SUAN 无法匹敌)。
3.1 在线蒸馏反哺:小身板爆发出大能量
为了弥补这一鸿沟,美团直接引入了“老带新”的教育机制,即在线蒸馏 (Online Distillation) 技术,把线上算不动的大基座网络强悍内力传输给瘦身后的轻量模型。
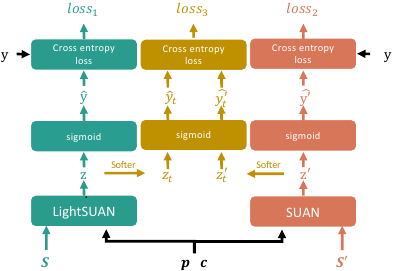
它的运行逻辑并不是离线干学,而是完全的双轨并线、端到端学习同步更新。小号的学生端输入略短的截断历史 SSS ,巨无霸教师端吃进漫长的历史上下文 S′S'S′ 。在优化过程中不仅共享实际发生点击与否带来的传统误差 Loss,小号学生还要尽全力去拟合巨无霸教师输出的“置信概率软分布”(Soft Label):
loss=loss1+loss2+λloss3,
\begin{equation}
loss = loss_1+loss_2+\lambda loss_3,
\end{equation}
loss=loss1+loss2+λloss3,
由于模型把分类映射分值 zzz (logits)按照温度参数 ttt 的系数重新缩放了,教师网络的那些隐秘的信息量全被平滑过滤到了交叉组合 Loss 里,从根本上防止了浅层网络一跑偏就过拟合的顽疾。
4. 实验效果及Scaling Law验证
为了充分展现这套架构的威力,研究团队毫不吝啬地在包含工业界数亿行日志在内的数据集上进行了狂轰滥炸式的对比。
| Dataset | #Users | #Items | #Samples | |||
|---|---|---|---|---|---|---|
| Eleme | 14,427,689 | 7,446,116 | 128,000,000 | |||
| Taobao | 1,141,729 | 461,527 | 700,000,000 | |||
| Industry | 88,976,000 | 14,054,691 | 1,230,715,133 |
在多梯队的打榜对决中,原生 SUAN 模型势如破竹,不仅稳操胜券干翻了各种倚仗预检索框架(如ETA、SIM)和常规注意力重构的网络,更可怕的是,只要增加输入行为包的尺度(如 SUAN(L) ),它的极值甚至还能再次顶开天花板,以遥遥领先的相对提升率让行业为之侧目。
| Dataset | Metric | Group | Group | Group | |||||||
| DIN | CAN | SoftSIM | HardSIM | ETA | TWIN | BST | HSTU | SUAN | SUAN(L) | ||
| Industry | AUC | 0.7002 | 0.7004 | 0.7025 | 0.7020 | 0.7024 | 0.7028 | 0.7028 | 0.7036 | 0.7098±0.00004 | 0.7135±0.00048 |
| Eleme | AUC | 0.6363 | 0.6378 | 0.6399 | 0.6389 | 0.6398 | 0.6410 | 0.6600 | 0.6631 | 0.6669±0.00028 | 0.6690±0.00090 |
| Taobao | AUC | 0.6198 | 0.6184 | 0.6212 | 0.6239 | 0.6220 | 0.6215 | 0.6370 | 0.6397 | 0.6472±0.00011 | 0.6495±0.00088 |
拆开来看消融实验(Ablation Study)也很好地印证了其模块内部构造的刚需合理性。剔除掉那些看似眼花缭乱却精密至极的(交叉结合、自适应权重池化、时序偏差引入)任何一环,都在引起模型表现向庸俗化退让。
| Model | Industry | Eleme | Taobao |
|---|---|---|---|
| SUAN | 0.7098 | 0.6669 | 0.6472 |
| Variant A(去SwiGLU) | 0.7093 | 0.6644 | 0.6468 |
| Variant B(去AFNet核心) | 0.7075 | 0.6644 | 0.6431 |
| Variant C(简单暴力的相加而非注意力门控融合) | 0.7080 | 0.6652 | 0.6441 |
| Variant D(剥削Target感知拼接序列的红利) | 0.7042 | 0.6638 | 0.6434 |
| Variant E(完全阉割序列空间时序偏移表征) | 0.7040 | 0.6631 | 0.6433 |
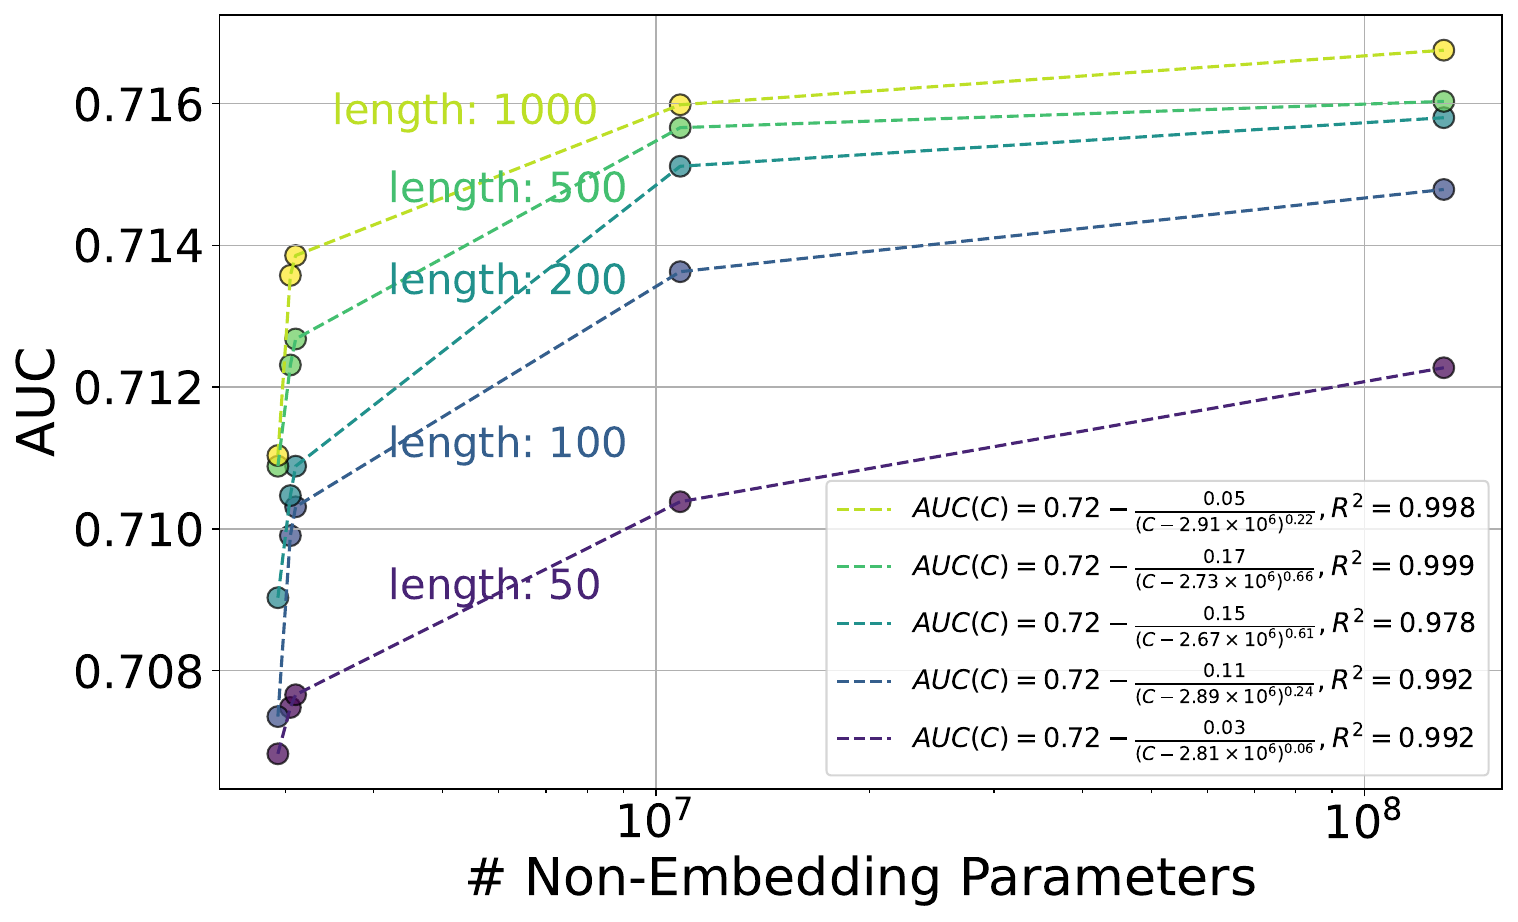
而 Scaling Law 在 SUAN 身上究竟存不存在?答案是肯定的,且极其粗暴明显。看下面这个随数据集投入倍数激增以及隐层通道加总规模后所带起的曲线抛物线:越往里面喂参数、投模型算力底座规模,模型吐出的 AUC 置信度居然是稳健走高而且毫无断层塌方的意思!
最后,也是这套方案最具硬通货的部分——大模型部署在严苛业务线的在线A/B真枪实战效果如何?
| Model | Model Size | Length | Sparse | AUC |
|---|---|---|---|---|
| LightSUAN-1 | size-2 | 100 | r=2, k=2 | 0.7095 |
| SUAN-1 | size-4 | 100 | - | 0.7133 |
| SUAN-2 | size-4 | 200 | - | 0.7146 |
| SUAN-3 | size-5 | 1000 | - | 0.7168 |
请注意,这甚至不再只是测试集空跑了。使用含有千篇万律知识的蒸馏特训体系(DistilSUAN-3,学生是低档参数级,但在学习超级大哥跑1000长序列的内力)不仅让原本只能做到 0.7095 极限的轻量模型拉超到高维原版的段位,更能保持秒回请求的能力顺畅切流。
经过工业平台漫长考核周期的对照流测试,这个经在线蒸馏降解落地出来的大模型版本甚至在实时生产环境中拿下了 点击流 (CTR) +2.81%,千次展示纯利 (CPM) +1.69% 的夸张收益。
写在最后
美团的这项研究可谓是一套推荐预估领域工业价值极高的“大模型着陆指南”,它既打破了 CTR 一直缺乏纯粹 Scaling Law 生命力释放的刻板印象,同时用极为聪明的蒸馏与计算并行技术化解了推荐系统严苛的耗时瓶颈“死锁”,让大模型技术落地产生巨大的变现效益,对其他厂家的探索研究也极具深刻启迪。
更多推荐


 11
 0
- 0


 已为社区贡献1条内容

所有评论(0)