
从一行 `docker compose up -d` 看透 Dify:深入拆解社区版容器架构(基于 v1.16)
为什么一句命令就能拉起一整套 LLM 应用平台?在它的背后,藏着一套值得反复琢磨的工程设计。
本文基于 Dify v1.16.0-rc1(2026 年 7 月最新发布版)撰写,涵盖 16 个容器、28 个新增环境变量、9 次数据库迁移、200+ 次代码变更的完整架构分析。所有技术细节均来自官方 Release Notes、GitHub 源码及社区实战验证。
一、引言:Dify 是什么,又为什么是它
2024 年以来,LLM 应用开发平台(LLMOps)赛道肉眼可见地拥挤起来。Dify(读作 /ˈdaɪfaɪ/)是其中少有的、既被工程师接受又受产品经理欢迎的开源项目。它的名字取自 "Define + Modify",也有 "Do It For You" 的彩蛋寓意。
Dify 团队由原腾讯云 CODING DevOps 团队的核心成员打造,在 SaaS 开发者工具产品领域深耕多年。DifySandbox 的作者 Yeuoly(周宇,Dify 产品工程 VP)拥有深厚的网络安全背景——从 CTF 白帽成长为 AI 架构师,这也解释了为什么 Dify 的安全隔离体系设计得如此深思熟虑。
v1.16 的里程碑意义
2026 年 7 月发布的 v1.16 是 Dify 发展历程中的一个重大版本:
- 容器数量:从 v1.0 的 10 个增长到 v1.16 的 16 个
- 核心范式升级:引入 Dify Agent V2(Beta)—— 内置 Linux 沙箱的 Shell-based Agent
- 双沙箱架构:
sandbox(Code 节点用)+local_sandbox(Agent V2 用)并存 - 协议兼容:支持 MCP 2025-06-18、OpenAI Responses API(GPT-5.6 系列兼容)
- 包管理器迁移:全面从 pip/poetry 迁移到 uv
⚠️ 官方安全警告(v1.16 重复出现两次):Dify Agent 目前处于实验阶段,所有 Agent 共享单一沙箱环境。请仅向可信的、非恶意的用户提供此服务。严格的每用户沙箱隔离计划在未来版本中实现。
相对于 LangChain 这种"硬编码开发库",Dify 的定位是一整套工程化的技术栈——把 Prompt 工程、RAG 检索增强、Agent 编排、可观测性、权限、多租户、计费这些原本散落一地的事情,一次性给到团队。社区版的部署方式也是极简的:Git、Docker、Docker Compose 三件套齐活,docker compose up -d 就能起一套完整服务。
那么问题来了:为什么一句 docker compose up -d 能拉起 16 个容器? 这些容器各自承担什么角色?谁负责 HTTP,谁负责异步,谁负责执行用户代码,谁负责隔离安全?哪些是核心组件,哪些是边缘依赖?
下面我将从技术角度,逐个拆解 Dify 社区版(以 1.16.0-rc1 版本 docker-compose.yaml 为基准)中的核心容器,以及它们之间的协作关系。对于想深入理解 Dify 架构、做二次开发或者性能调优的同学,这篇文章会是一份路线图。
二、容器清单:一张表摸清 Dify 全家桶(v1.16 最新)
| 容器名 | 镜像 | 角色定位 | 关键能力 | 引入版本 |
|---|---|---|---|---|
| nginx | nginx:latest | 反向代理 | 80/443 端口、SSL 终止、路由分发、WebSocket 升级 | v0.1 |
| api | langgenius/dify-api | 同步业务大脑 | Flask HTTP 服务,处理所有控制台 / 应用请求 | v0.1 |
| api_websocket | langgenius/dify-api | 协作通道 | Gevent WebSocket Worker,工作流协同编辑 | v0.8 |
| worker | langgenius/dify-api | 异步任务池 | Celery Worker,处理文档索引、邮件、长耗时 | v0.1 |
| worker_beat | langgenius/dify-api | 定时调度 | Celery Beat,周期任务 | v0.1 |
| web | langgenius/dify-web | 前端 | Next.js 15 + React 18 + Jotai 状态管理 | v0.1 |
| agent_backend | langgenius/dify-agent-backend | Agent V2 运行时 | Go + Pydantic AI 独立服务 | v1.16 新增 |
| local_sandbox | langgenius/dify-agent-local-sandbox | Agent Shell 沙箱 | shellctl 守护进程(端口 5004) | v1.16 新增 |
| plugin_daemon | langgenius/dify-plugin-daemon | 插件宿主 | Go 进程,管理插件全生命周期 | v1.0 |
| sandbox | langgenius/dify-sandbox | 代码沙箱 | Seccomp + chroot 多层隔离 | v0.6 |
| ssrf_proxy | ubuntu/squid | 出网代理 | 强制所有外联走白名单 | v0.3 |
| db_postgres | postgres:15-alpine | 主数据库 | 业务元数据 + dify_plugin 库 | v0.1 |
| redis | redis:7-alpine | 缓存 + 队列 | Celery broker + 业务缓存 | v0.1 |
| weaviate | semitechnologies/weaviate | 向量数据库 | 默认的语义检索后端 | v0.1 |
| init_permissions | busybox | 一次性任务 | 修正存储目录权限,完成后退出 | v0.5 |
| unstructured | unstructured-io/unstructured-api | ETL 引擎 | 复杂文档(扫描件、表格)解析 | v1.2 |
版本注解:容器数量从 v1.0 的 12 个增长到 v1.16 的 16 个,其中agent_backend和local_sandbox是 v1.16 新增的 Agent V2 专属容器。
把上面这堆容器按职责梳理一下,大致可以划分成六层:接入层、核心服务层、异步任务层、数据存储层、扩展组件层、安全隔离层。
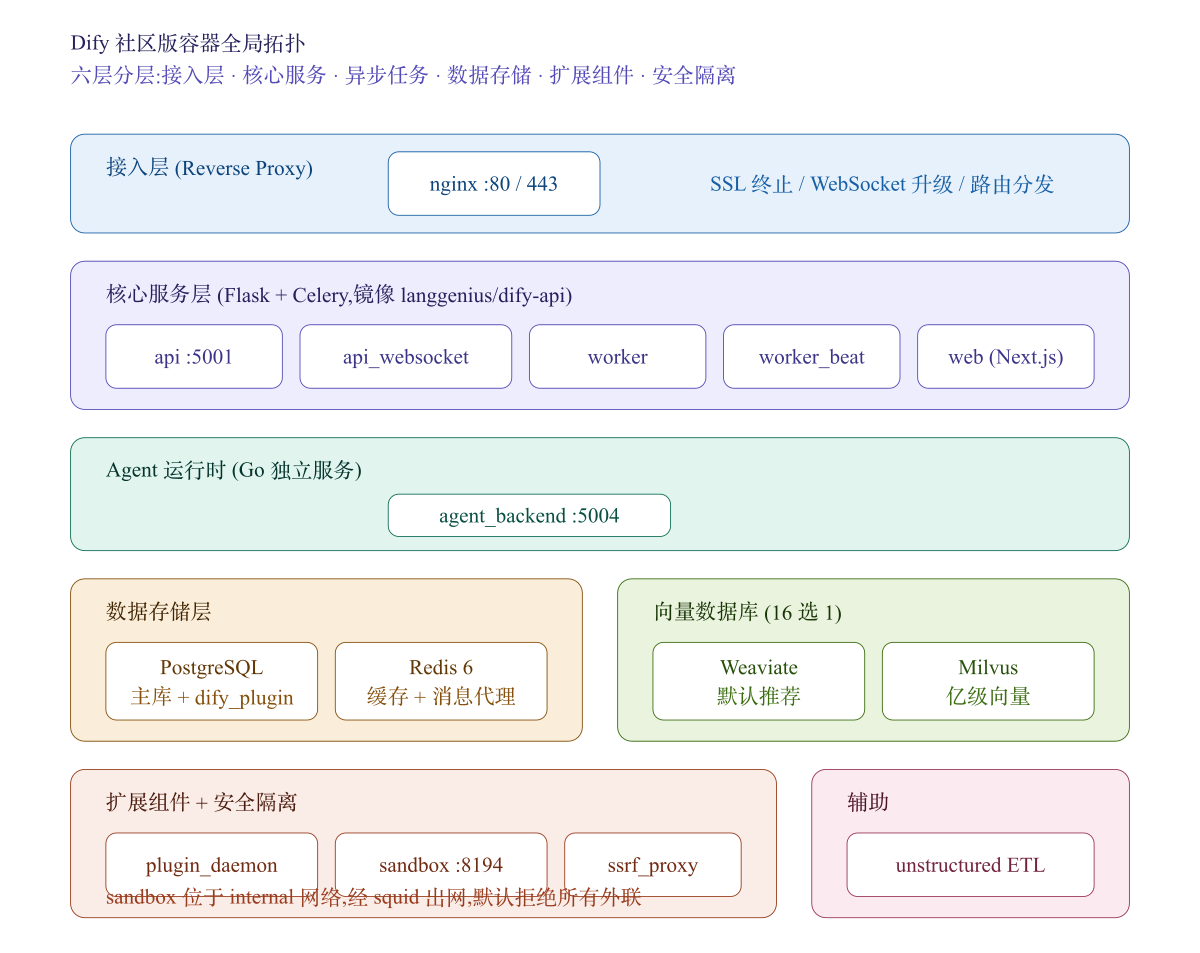
下面我会逐层展开,把每个核心容器的技术细节讲清楚。边缘容器(比如 init_permissions、unstructured)用一两段带过,真正的篇幅留给那些关系到 AI 工作流、LLM 平台本身的核心服务。
三、接入层:nginx 容器
3.1 角色定位
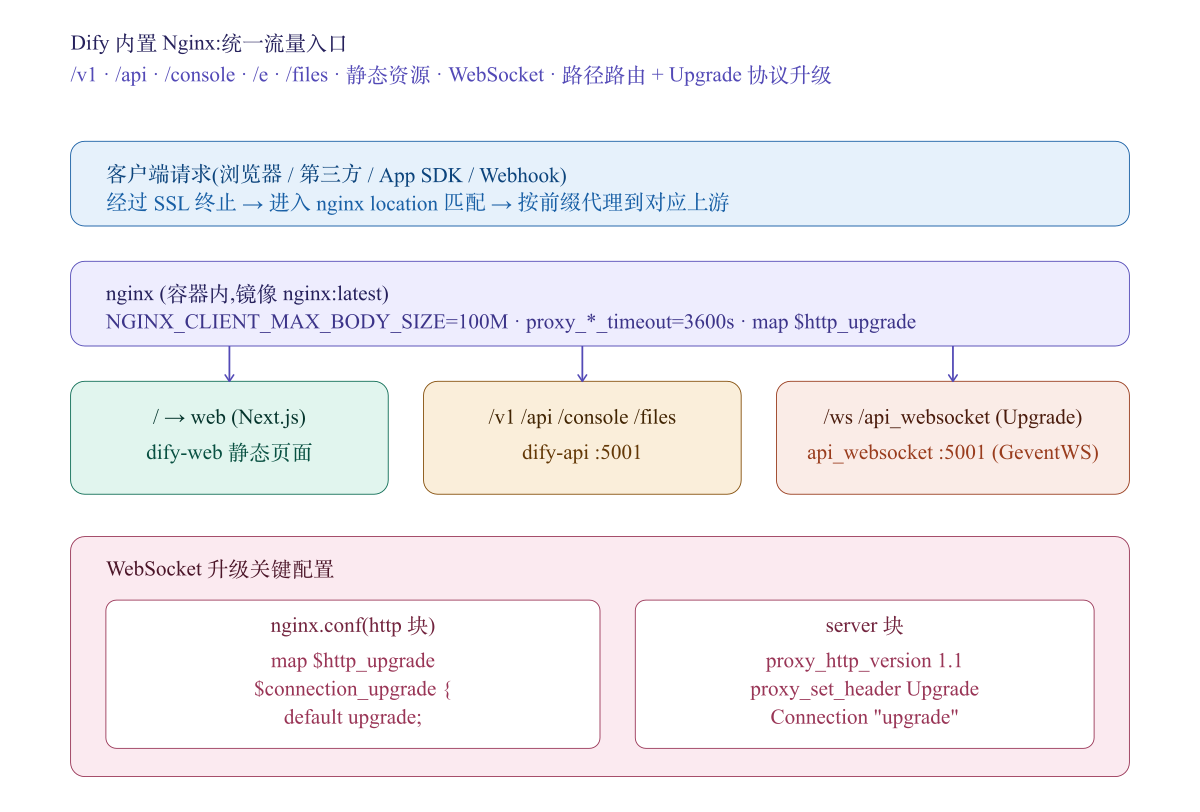
nginx 是整个 Dify 的统一流量入口。哪怕你用云厂商的负载均衡器把请求转到容器内部,最终进入应用层之前,还是要过它这一关。它做的事情很标准,却也最容易踩坑:
- SSL 终止:HTTPS 请求先到这里解密
- 路径路由:把不同 URL 前缀分发给不同的上游
- WebSocket 升级:这是 Dify 协作编辑和流式响应的关键
v1.16 小变化:nginx 路由规则中新增了 Agent V2 的 API 端点代理,但整体架构保持不变。
3.2 路由规则(v1.16 最新)
| URL 前缀 | 上游 | 用途 |
|---|---|---|
| / | web (Next.js) | 前端控制台 |
| /v1 · /api · /console · /files | api :5001 | REST API |
| /ws · /api_websocket | api_websocket :5001 | 协作 WebSocket |
| /e/{hook_id} | plugin_daemon :5002 | 外部 webhook |
| /agent/api | agent_backend :5005 | Agent V2 API(v1.16 新增) |
踩坑提示:很多教程告诉你直接用 location / 代理到 api,但 /v1/chat-messages 这种应用 API 实际上要流式响应 SSE,如果不经过合适的代理配置,前端会一直转圈。
3.3 WebSocket 升级的关键配置
WebSocket 升级本质上就是 HTTP Upgrade 头的处理,需要 nginx 的 map 指令和 proxy_set_header 配合:
| # nginx.conf 必须在 http 块里 map $http_upgrade $connection_upgrade { default upgrade; '' close; } # 对应的 location 块 location /api_websocket { proxy_pass http://api_websocket:5001; proxy_http_version 1.1; proxy_set_header Upgrade $http_upgrade; proxy_set_header Connection $connection_upgrade; proxy_read_timeout 3600s; } |
"map指令必须放在 http 块,而 proxy.conf 是被 include 到 server 块的——把map写在 proxy.conf 里是新手最常犯的错误,nginx 会直接报 'map directive is not allowed here' 启动失败。"——Dify 官方部署文档
另外两个隐藏细节:
client_max_body_size = 100M是默认的请求体上限,对应.env里的UPLOAD_FILE_SIZE_LIMIT。上传大文档时如果忘了同步设置,会被 nginx 直接 413 拒绝,而不会进入到 api 层。proxy_read_timeout 3600s保证了长时运行的工作流和流式 LLM 响应不会因为反向代理超时而中断。
四、核心服务层:api · worker · worker_beat
这三个容器用的是同一个镜像 langgenius/dify-api,但通过环境变量 MODE 切换运行模式——这是 Dify 镜像复用设计的精髓,从 v0.1 沿用至今,证明了其架构的稳定性。
4.1 一个镜像,三种角色(v1.16 无变化)
| 容器 | MODE 值 | 启动入口 | 运行时 |
|---|---|---|---|
| api | api | Gunicorn (Flask) | 同步 HTTP 服务 |
| worker | worker | Celery | 异步任务消费 |
| worker_beat | beat | Celery Beat | 定时调度 |
这种设计的好处是部署一致性:所有业务逻辑共用同一份代码、同一份依赖,不需要在多套代码库之间同步 bug 修复;切换运行模式只是改一个环境变量。代价是要对 MODE 这种环境变量做充分的运行时分支处理。
4.2 api 容器:Flask + 分层架构(v1.16 重大更新)
api 容器是同步路径,所有的 HTTP 请求都先到它。它基于经典的 Flask 分层架构,但在 v1.16 中有重大底层变化:
| api/ ├── app.py # 入口 ├── app_factory.py # 工厂模式创建 Flask 实例 ├── controllers/ # 路由层 │ ├── console/ # 控制台 API │ ├── service_api/ # 应用 API │ ├── inner_api/ # 内部 API │ ├── agents/ # Agent V2 API ← v1.16 新增 │ ├── web/ # Web 应用 │ └── files/ # 文件操作 ├── services/ # 业务逻辑层 ├── models/ # SQLAlchemy ORM ├── core/ # 核心引擎 │ ├── workflow/ # 工作流 │ ├── rag/ # RAG 管道 │ ├── agent/ # Agent V1(保留兼容) │ ├── agent_v2/ # Agent V2 新引擎 ← v1.16 新增 │ ├── plugin/ # 插件系统 │ └── model_runtime/ # 模型调用 └── libs/ # 工具库 |
几个关键设计变化:
- 包管理器迁移到 uv:v1.16 全面从 pip/poetry 迁移到 uv,依赖安装速度提升 10-100 倍。
uv sync替代pip install,uv run flask db upgrade替代flask db upgrade。 - 工厂模式:通过
app_factory.py创建 Flask 应用,允许开发/测试/生产环境使用不同配置。配合环境变量MODE=api决定是同步 HTTP 服务还是 Celery Worker。 - OpenAPI 契约化:v1.16 所有 console API 端点迁移到基于 OpenAPI 契约的 BaseModel,前端路由和类型全部自动生成,彻底消除前后端 API 不一致问题。
- Pydantic 配置系统:所有环境变量通过 Pydantic 校验后注入
dify_config,类型安全且易于做单元测试。 - Celery 异步任务:
api容器内的tasks/目录定义了大量异步任务,比如文档索引、邮件发送、统计聚合——这些任务会被推到 Redis,然后由 worker 容器消费。 - 依赖关系更新:v1.16 中
api和api_websocket都新增了depends_on: agent_backend,确保 Agent V2 服务启动后再启动 API。
4.3 worker 容器:Celery 任务消费(v1.16 增强)
worker 是 Dify 的"幕后英雄"。所有耗时的操作——文档解析、向量化、长 LLM 生成、邮件通知——都通过 queue_rag_processor、queue_dataset_processor、queue_mail、queue_workflow_summary 等多个 Celery 队列分门别类地走它。
| # 典型的 worker 启动命令(v1.16 用 uv 执行) uv run celery -A celery_app.celery worker \ -Q dataset,workflow,mail,app_deletion,plugin \ --concurrency=2 \ -l INFO |
注意 Dify 在 .env 里没有用单一队列,而是按业务领域拆分:
| 队列 | 典型任务 |
|---|---|
| dataset | 文档摄取、分块、嵌入 |
| workflow | 工作流异步步骤 |
| 邮件通知 | |
| app_deletion | 应用删除的资源回收 |
| plugin | 插件包安装、依赖下载 |
这种拆分允许针对不同负载做差异化并发调优——比如文档摄取是 IO 密集型,可以堆高并发;而某些长 LLM 任务需要调低并发避免触发限流。
v1.16 新增特性:Celery 热关闭时会正确中止正在运行的工作流任务,消除孤儿进程;Redis 连接增加 TCP keepalive 支持和重试覆盖。
4.4 worker_beat:Celery Beat 调度器(v1.16 无变化)
Beat 不干活,它只负责按时间表把任务扔到队列。常见的周期任务包括:
- 清理过期的会话和消息
- 同步插件市场的索引
- 触发定时工作流
- 数据集文档的定时重建索引
Beat 模式是单点的,任何时刻只允许一个 worker_beat 容器跑起来,否则会重复触发任务——这就是为什么 docker-compose 里只起一个。
4.5 api_websocket:协作编辑的 CRDT 通道(v1.16 修复)
api_websocket 默认在 collaboration profile 下,需要显式启用。它的核心是支持工作流的协同编辑——多个人同时编辑同一个 workflow,不会出现"我改了你没改"的冲突。
技术原理是 CRDT(Conflict-free Replicated Data Type,无冲突复制数据类型),一种可以保证多个副本最终一致性的数据结构。CRDT 同步通过 WebSocket 长连接传播增量变更,任何人在自己的客户端上修改一个节点的参数,其他协作者会立刻看到结果,不需要中央锁。
v1.16 重要修复:多 worker 场景下的工作流协作问题已在 v1.16 中修复。此前多个 api_websocket 实例之间会出现状态同步丢失。
实现细节在 Gevent WebSocket Worker 之上:
| SERVER_WORKER_CLASS=geventwebsocket.gunicorn.workers.GeventWebSocketWorker GUNICORN_TIMEOUT=360 |
gevent 的微线程模型让它在单进程内能同时处理上万个 WebSocket 连接,内存占用低,适合这种"少量写、频繁推"的场景。
五、Agent 运行时:从 V1 到 V2 的架构演进
5.1 架构演进历程(v0.1 → v1.16)
| 版本 | Agent 实现方式 | 运行环境 | 特点 |
|---|---|---|---|
| v0.1 - v0.5 | Python 代码直接嵌入 api 容器 | 主进程内 | 简单,但阻塞 HTTP 线程 |
| v0.6 - v1.15 | Agent 节点逻辑在 api 内,代码执行走 sandbox | api + sandbox | 非阻塞,但 Python 单语言限制 |
| v1.16+ | agent_backend 独立 Go 服务 + local_sandbox 独立容器 | 双容器隔离 | Pydantic AI 框架,Shell-based 执行范式 |
如果你从早期版本就开始用 Dify,会发现一个明显变化:Agent 架构经历了三次重构,每次都向着"更强隔离、更强能力"的方向演进。
5.2 Agent V1 的痛点(v0.6 - v1.15)
v0.6 到 v1.15 的 Agent 架构有几个明显的痛点:
- Agent 的工具调用是长循环(ReAct:Thought → Action → Observation 反复迭代),容易阻塞 HTTP 工作线程
- 多语言工具(Python / Node.js)的运行环境很难统一管理
- 跨工作流的 Agent 上下文难以共享
- 无法执行真实的系统命令和文件操作
5.3 Agent V2 的解决方案(v1.16 新增)
Dify 1.16 的解法是:把 Agent 运行时从 Python 进程里彻底抽出来,做成两个独立部署的容器——这是 Agent 架构的一次范式升级。
5.3.1 agent_backend 容器
agent_backend 是 Agent V2 的大脑和控制器:
- 技术栈:Go 编写,基于 Pydantic AI 框架
- 核心职责:Agent 会话管理、工具调用编排、LLM 请求路由
- 调用关系:被
api容器调用,反过来调用plugin_daemon做 LLM 调用 - 端口:5005
| # docker-compose.yaml v1.16 新增片段 agent_backend: image: langgenius/dify-agent-backend:1.16.0-rc1 restart: always environment: DIFY_AGENT_REDIS_URL: redis://... DIFY_AGENT_PLUGIN_DAEMON_URL: http://plugin_daemon:5002 DIFY_AGENT_INNER_API_URL: http://api:5001 DIFY_AGENT_SHELLCTL_ENTRYPOINT: http://local_sandbox:5004 depends_on: - redis - plugin_daemon |
关键设计:Agent V2 不直接调用 LLM,而是通过 plugin_daemon 统一路由——这确保了 Agent 能复用整个模型供应商生态,不需要重复实现模型接入逻辑。
5.3.2 local_sandbox 容器
local_sandbox 是 Agent V2 的手脚执行环境:
- 技术栈:Go 编写的
shellctl守护进程 - 核心职责:Shell 命令执行、文件系统操作、进程生命周期管理
- 端口:5004
- 认证机制:无内置认证(官方警告:必须容器内运行,不可直接暴露到公网)
双沙箱架构注解:v1.16 现在有两个完全独立的沙箱:
1.sandbox容器:服务于工作流 Code 节点,Seccomp + chroot 强隔离
2.local_sandbox容器:服务于 Agent V2,Shell-based 执行范式
设计取舍:两个沙箱目标不同。Code 节点追求安全第一(执行用户提交的任意代码),所以用 Seccomp 强锁;Agent 追求功能第一(需要完整的 Linux 环境做开发、调试、工具安装),所以用更宽松但功能完整的 Shell 环境。这种分离是刻意的架构设计,不是重复建设。
5.4 Agent V2 的 Beta 阶段限制(官方文档)
⚠️ 以下是 v1.16 的已知限制,计划在后续版本中解决:
1. 无严格沙箱隔离:所有 Dify Agent 共享同一个沙箱容器,虽然 Agent 有独立的工作目录,但恶意 Agent 可以轻易访问和修改其他 Agent 的数据和用户数据
2. shellctl 无认证:沙箱控制端口 5004 没有认证机制,必须在容器网络内运行
3. vLLM 不兼容:Agent V2 与 vLLM 托管的本地模型因函数调用依赖问题不兼容(GitHub Issue #38882)
4. Bedrock 参数校验 Bug:Amazon Bedrock Claude 会因为空系统 prompt 和空工具描述报错(社区已定位根因)
5. Community Edition 预览限制:社区版 Agent 预览 Tab 功能受限,需企业版解锁完整能力
🚨 官方安全警告原文:"You should provide Dify Agent services only to trusted, non-malicious users"
六、工作流引擎:GraphEngine 的 DAG 执行
工作流(Workflow)是 Dify 最具差异化的能力,也是技术含量最深的子系统之一。它让非程序员也能通过拖拽节点、连线来搭建复杂的 AI 处理流程。
6.1 整体设计:导演-演员-舞台
Dify 的工作流引擎可以拆成三层:
- 前端编排层:基于 ReactFlow 的可视化画布,把节点的拖拽关系序列化成 JSON 格式的 DSL
- 执行引擎层:
GraphEngine+NodeRunner+ 变量池 - 基础设施层:Celery 异步任务 + 数据库状态持久化 + Redis 中间状态
这种"前后端彻底分离"的设计有一个很大的好处:DSL 是稳定契约,前端画布再怎么升级,只要保证输出格式不变,后端引擎就不用改。
6.2 核心节点类型(v1.16 新增 Agent 节点)
Dify 提供 30+ 种工作流节点,核心几类包括:
| 节点 | 作用 | 关键设计点 | 引入版本 |
|---|---|---|---|
| Start / End | 流程入口出口 | End 节点可声明返回结构 | v0.1 |
| LLM | 调用大模型生成 | 支持提示词变量、上下文窗口管理、结构化输出 | v0.1 |
| Knowledge Retrieval | 知识库检索 | 内置向量检索 + Rerank | v0.3 |
| Code | 执行用户代码 | 走 sandbox 容器 | v0.6 |
| Agent | 嵌入 Agent V2 节点 | 委托 agent_backend 执行 | v1.16 新增 |
| HTTP Request | 调用外部 API | 出网走 ssrf_proxy | v0.2 |
| If/Else · Iteration | 控制流 | 条件分支与循环 | v0.5 |
| Template Transform | Jinja2 模板 | 用于提示词组装 | v0.4 |
| Question Classifier | 意图分类 | LLM 驱动 | v0.7 |
| Parameter Extractor | 结构化提取 | LLM 驱动 + JSON Schema | v0.8 |
| Variable Aggregator | 合并多分支 | 用于并行分支汇流 | v1.0 |
6.3 执行机制:拓扑排序 + 并发调度
当工作流被触发时,GraphEngine 做了这些事:
- 加载 DSL:从数据库读出 JSON 定义,反序列化成内存中的图对象
- 校验:静态类型检查(节点的输入输出 schema 是否匹配)
- 拓扑排序:对 DAG 做 Kahn 算法排序,得到节点执行顺序
- 并发派发:入度归零的节点进入就绪队列,由线程池并发执行
- 变量池:每个节点的输出写入变量池,可能解锁下游节点
- 状态持久化:节点执行状态(pending / running / succeeded / failed / skipped)持久化到数据库
- 失败重试:可配置的最大重试次数,达到上限标记为失败,中断后续非容错路径
这种"数据驱动调度"模型的最大好处是最大化并行——只要某个节点的所有入边都产出了结果,它就能立即执行,不被串行约束拖累。
| # GraphEngine 核心调度伪代码 def run(self): ready_queue = [n for n in self.graph.nodes if n.in_degree == 0] while ready_queue or any(running for running in self.running): if ready_queue: node = ready_queue.pop(0) future = self.executor.submit(self.node_runner.run, node) self.running[future] = node for future in as_completed(self.running): node = self.running.pop(future) if future.exception(): self.mark_failed(node, future.exception()) else: self.mark_success(node, future.result()) for child in node.successors: child.in_degree -= 1 if child.in_degree == 0: ready_queue.append(child) |
6.4 v1.16 关键改进
智能工作流生成增强:
- 通过
⌘K触发,选择/create或/refine即可用自然语言生成工作流 - 移除了低价值的"理想输出"字段
- 用基于当前工作区上下文的 AI 建议卡片替代静态示例
- 节点配置生成改为并行执行,大幅提升速度
- 新增可超时配置:
WORKFLOW_GENERATION_TIMEOUT_MS(默认 180 秒)防止生成挂死
可观测性提升:
- 工作流运行归档支持导出
- 数据库会话传播显式化,便于测试和一致性保障
七、RAG 管道:从原始文档到 LLM 上下文
RAG(Retrieval-Augmented Generation)是 Dify 最"落地"的能力。它解决的是大模型"不知道私有数据"的根本问题——通过先检索相关文档片段,再把片段插入到 Prompt 里,让模型"带着参考资料"回答。
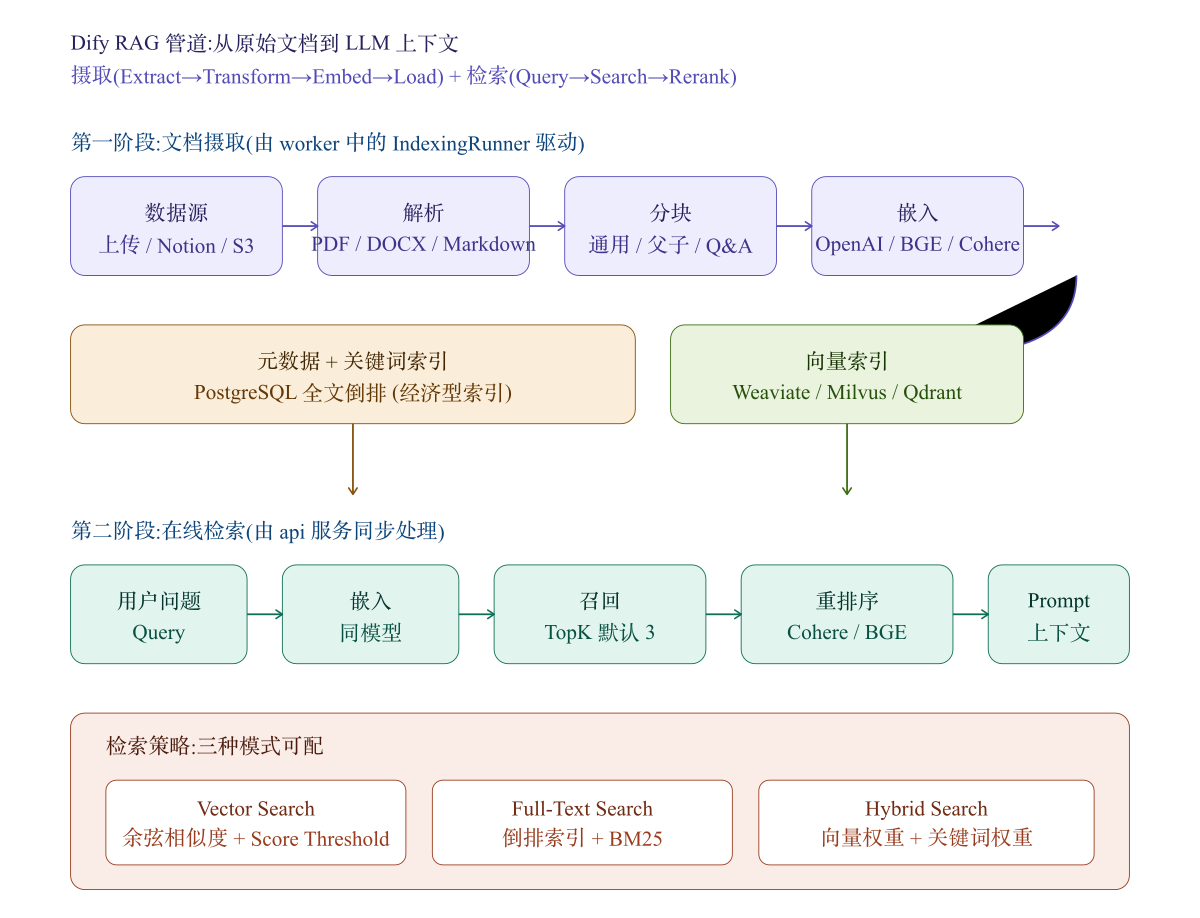
7.1 两大阶段:摄取(Ingestion)+ 检索(Retrieval)
Dify 的 RAG 管道被清晰地拆成两个阶段,对应不同的执行容器:
- 摄取阶段由
worker容器中的IndexingRunner异步驱动 - 检索阶段由
api容器在用户请求时同步执行
这种拆分让重活(文档解析、向量化)和轻活(在线检索)各得其所——前者可以堆 Celery 并发慢慢处理,后者必须低延迟响应。
7.2 摄取阶段四步走
Extract → Transform → Embed → Load
Extract(提取):根据文件类型选择对应解析器。FILE_EXTRACTORS 是一个大字典,把 .pdf → PdfExtractor,.docx → WordExtractor,.md → MarkdownExtractor 等等。复杂文档(扫描件、表格、PPT)可以走 unstructured 容器提供的更专业解析。
Transform(转换):清洗(去噪、归一化空白)、分块、标注元数据。分块策略有三种:
- General Mode:通用段落切分,适合大多数文档
- Parent-Child Mode:父子块结构,长文档检索时先用小块精确定位,再返回父块补充上下文
- Q&A Mode:从表格等结构化数据中抽取 Q&A 对,适合自然语言查询
Embed(嵌入):调用配置的嵌入模型(OpenAI text-embedding-3、Cohere、BGE、Jina、本地 Ollama 等),把每个 chunk 转成密集向量。
Load(加载):向量写入向量库,元数据和关键词索引写入 PostgreSQL。两类索引并存,方便后续混合检索。
7.3 检索阶段三种模式
| 模式 | 原理 | 适用场景 |
|---|---|---|
| Vector Search | 余弦相似度匹配 TopK | 语义模糊查询 |
| Full-Text Search | 倒排索引 + BM25 | 精确关键词 / 编号 / 缩写 |
| Hybrid Search | 向量权重 + 关键词权重 | 通用默认 |
Hybrid Search 是社区实践中最常用的——它结合了向量搜索的语义能力和关键词搜索的精确性。Dify 允许通过滑块配置两者的权重,默认 0.7:0.3。
7.4 Rerank:重排序的二次精修
向量检索回来的 TopK 通常相关性参差不齐,直接喂给 LLM 会浪费上下文窗口。Rerank 模型(Cohere Rerank、BGE Reranker、Jina Reranker 等)会对 TopK 结果做二次打分重排,显著提升 top-N 精度。
代价是多了一次远程 API 调用。生产实践里通常 TopK 召回 20-50 个,经 Rerank 精修到 3-5 个再送 LLM。
7.5 知识库新形态:Knowledge Pipeline
2025 年 9 月(v1.9.0)推出的 Knowledge Pipeline 把 RAG 流程从"配置式"升级为"可视化流水线"。它继承 Workflow 画布的体验,把数据源、解析、清洗、分块、嵌入、索引、检索的每一步都暴露为可拖拽的节点。
Knowledge Pipeline 解决了传统 RAG 的三个老大难:
- 数据源碎片化:支持本地文件、S3、Notion、Confluence、SharePoint、GitHub 等
- 解析损失:可以为同一文件跑多个解析器,合并输出,避免信息丢失
- 黑盒处理:每一步都可以单步调试,Variable Inspect 面板实时展示中间变量
这对企业级 RAG 尤其关键——内部数据往往不是干净的 PDF,而是混杂扫描件、表格、邮件、图片,流水线让你能针对每种类型定制处理逻辑。
八、插件系统:plugin_daemon(MCP 协议升级)
8.1 为什么插件要跑在另一个进程里
Dify 0.x 时代,工具和模型供应商都是硬编码在主进程里的。v1.0 引入插件系统后,把"扩展性"做成了核心能力。但插件是用户写、用户装的第三方代码,直接嵌入主进程会带来几个致命问题:
- 安全隔离缺失:恶意插件能直接访问数据库、环境变量,甚至执行系统命令
- 稳定性互踩:一个插件崩溃会拖垮整个 Dify 服务
- 资源竞争:所有插件共享主进程资源,难以做配额
- 技术栈受限:插件必须用 Python,与主进程强耦合
Dify 的解法是用 Go 写一个独立的插件守护进程——langgenius/dify-plugin-daemon。这个系统由 Dify 技术架构师 Yeuoly 设计,他在 v1.0 官方博客中详细阐述了设计思路。
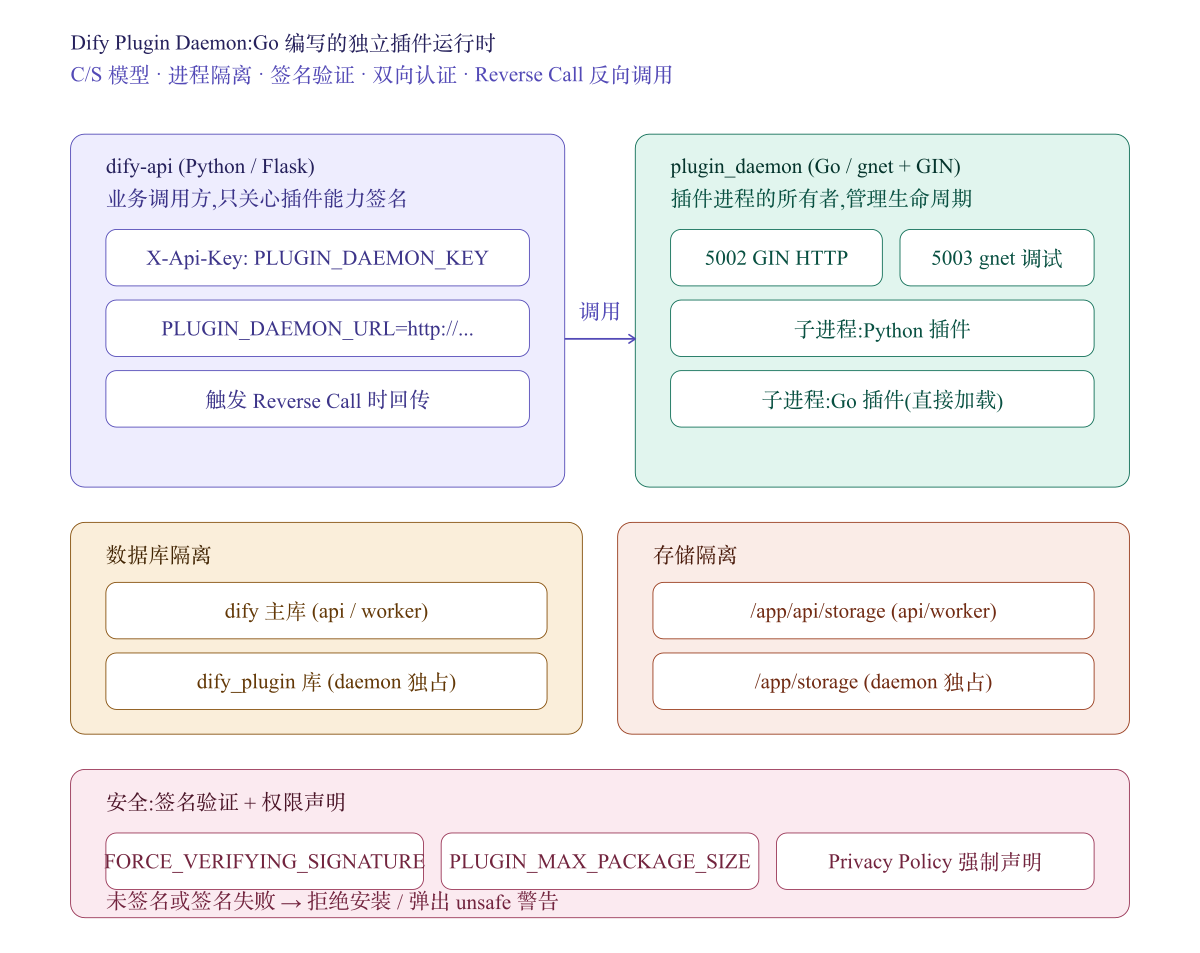
8.2 架构:C/S 模型 + 进程隔离
| ┌─────────────────────┐ │ dify-api (Python) │ ← 业务调用方 │ X-Api-Key 认证 │ └──────────┬──────────┘ │ HTTP / gRPC ┌──────────▼──────────┐ │ plugin_daemon (Go) │ ← 插件进程的所有者 │ · 5002 GIN HTTP │ │ · 5003 gnet 调试 │ └──────────┬──────────┘ │ 子进程管理 ┌──────┴──────┐ ▼ ▼ ┌─────────┐ ┌─────────┐ │ Python │ │ Go │ │ 插件 │ │ 插件 │ └─────────┘ └─────────┘ |
几个关键设计点:
- 双端口设计:
5002是 GIN HTTP,提供 REST API 给 api 调用;5003是 gnet 远程调试端口,支持开发者长连接调试。两者职责严格分离,生产环境通常关闭 5003。 - Go 插件直接加载,Python 插件走 stdio:Go 插件被 daemon 作为子进程直接加载,通信通过 stdin/stdout 管道;Python 插件则通过 gRPC 与 daemon 通信。
- 数据库隔离:主库
dify给 api 和 worker 用,插件专属库dify_plugin由 daemon 独占,避免插件元数据污染主业务。 - 存储隔离:api 容器挂载
/app/api/storage,daemon 容器挂载/app/storage,两者的文件系统完全分开,插件崩溃不会污染主业务的存储。
8.3 v1.16 MCP 协议升级
MCP(Model Context Protocol) 是 Anthropic 牵头制定的大模型工具调用标准协议,v1.16 进行了重大升级:
- 协议版本:升级到 MCP 2025-06-18
- 版本协商:支持与 MCP 客户端进行版本协商
- 结构化输出:MCP 工具返回结果支持结构化 schema
- 动态 HTTP 头注入:支持在运行时注入 HTTP 头,用于 per-request 认证透传。例如:
{{request.headers.X-Custom-Auth}} - 工作流作为 MCP 服务器:Dify 工作流现在可以作为 MCP 服务器暴露给其他 Agent
MCP 协议的加入让 Dify 插件系统从"私有扩展"变成"标准兼容",可以接入整个 MCP 生态的工具和数据源。
8.4 Reverse Call:反向调用(v1.0 引入,v1.16 增强)
Dify 插件系统的一个精妙设计是 Reverse Call——插件可以反向调用 Dify 主服务的能力。
场景举例:开发一个 Discord 机器人插件,收到 Discord 消息后,需要把消息转发给 Dify 的某个 Chatflow 应用,等应用返回结果后再回给 Discord。如果没有 Reverse Call,插件就得自己实现"调用 Dify API、处理认证、解析响应"这一整套逻辑。
有了 Reverse Call,插件可以直接在代码里调一个 SDK 方法,daemon 会把请求代理回 api。
Reverse Call 让插件实现"业务侧 webhook 集成"这类场景变得极其简单。典型应用:
- LlamaIndex 工具化:把 LlamaIndex 的 agentic RAG 策略包装成 Dify 工具
- 模型当工具用:把 OCR/ASR/TTS 等模型能力从独立模型升级为可被 Agent 调用的工具
- OpenAI 兼容端点:通过 Endpoint 插件暴露 OpenAI 格式的接口,让 Claude、Gemini 等模型以统一格式返回
- Agent 插件化:支持自定义 Agent 策略,实现业务专属的 agentic 模式
8.5 安全:签名 + 权限声明(v1.0 引入,v1.16 无变化)
Dify 没用传统的"沙箱限制"做插件安全,而是基于密码学签名:
- 插件安装前,如果
FORCE_VERIFYING_SIGNATURE=true(默认),daemon 会用平台公钥验证插件签名 - 签名失败 → 拒绝安装,或弹出"unsafe"警告让用户确认
- 每个插件必须在 manifest 里显式声明自己需要的权限(网络、文件、敏感数据等),未声明的权限会被 daemon 直接拒绝
- 涉及个人数据的复杂场景,开发者必须提供详细的 Privacy Policy,上架 Marketplace 时强制审核
这套"签名 + 显式声明 + 人工审核"的安全模型比硬沙箱更友好——硬沙箱会限制很多合法的依赖包,体验很差;而签名机制假设"已签名 = 已审核 = 可信",把安全问题从"运行时拦截"前置到"分发时审核"。
九、代码沙箱:sandbox(七层防御架构详解)
9.1 问题:用户代码是敌是友
工作流里的"Code 节点"允许用户写任意 Python 或 Node.js 代码。如果没有隔离,这些代码会直接运行在 Dify 容器内——这意味着:
- 用户代码可以
os.system("rm -rf /")删库 - 用户代码可以
open("/app/api/storage/secrets.env")读取密钥 - 用户代码可以
subprocess启动一个反向 shell
"没有人想要一个专门负责解析 JSON 文本的节点。那么,为什么不给用户提供一个代码编辑框,让他们自己写代码实现数据处理逻辑呢?但如果让用户代码直接跑在服务器上,恶意用户就能读取服务器上的任意文件,甚至拿到整个 Dify 数据库的访问权限。"——Yeuoly,《Introduction to DifySandbox》
Dify 团队评估过几类沙箱方案,最终结论是自研:
| 方案 | 问题 |
|---|---|
| WebAssembly | 灵活性差,第三方依赖难装,Python 和 Node.js 需要分别处理 |
| Docker per task | 每次启动容器耗时 1 秒+,10 个节点 = 10+ 秒,docker-in-docker 更慢 |
| PyPy / vm2 | 单语言,不通用,严格版本限制,维护成本高 |
| Kernel extension (Sandboxie / Judge0) | 配置复杂,需要特权容器,Judge0 曾出现严重配置漏洞导致的 CVE |
最终方案就是 langgenius/dify-sandbox——一个 Go 编写的单容器多任务沙箱,通过 7 层纵深防御 实现安全。
9.2 七层防护详解(官方原文)
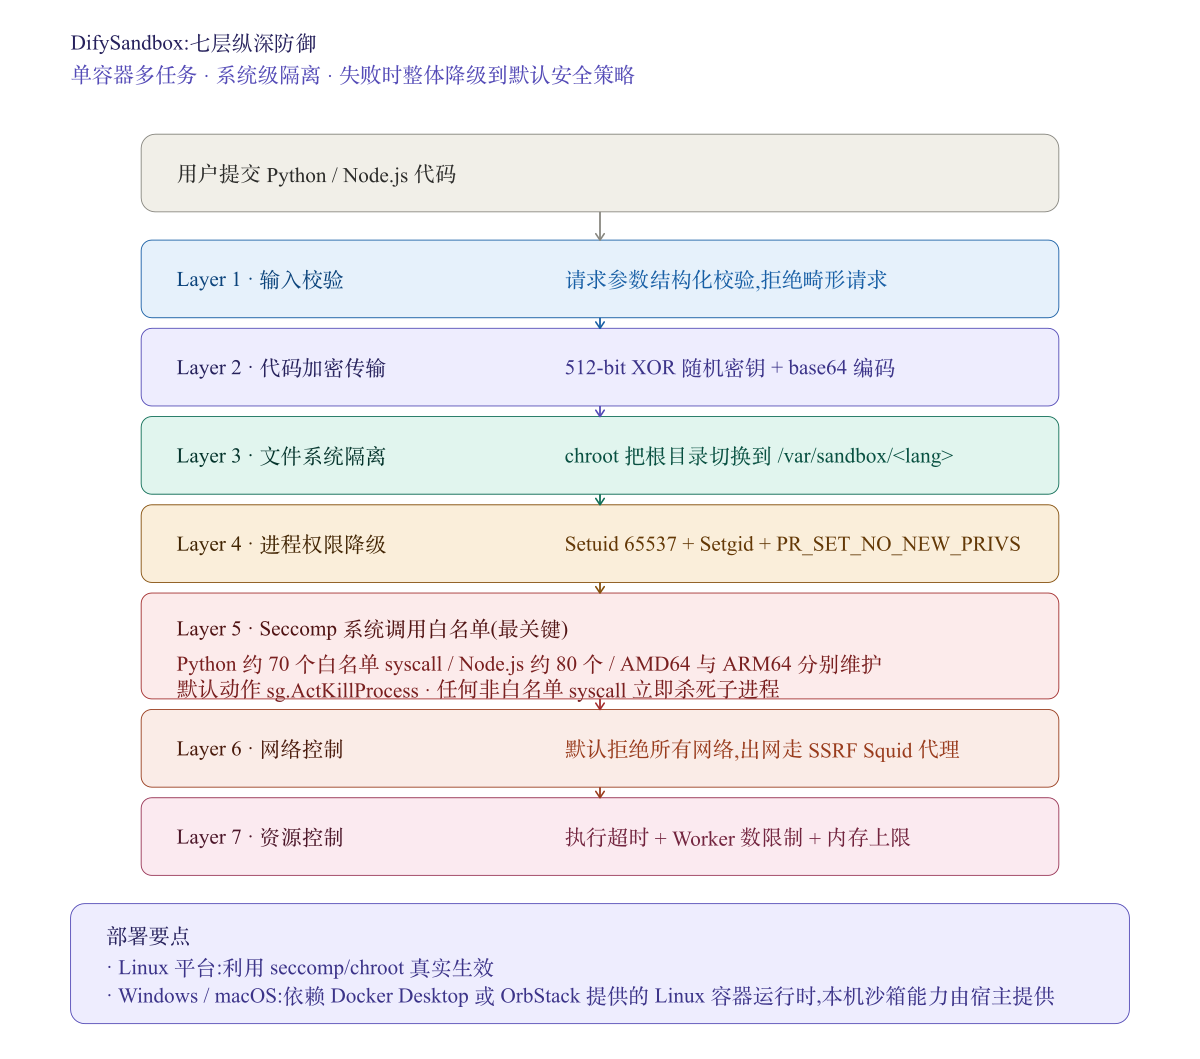
Layer 1 · 输入校验:对 HTTP 请求参数做结构化校验,畸形请求在入口就拒绝。
Layer 2 · 代码加密传输:用户代码在传输前用 512-bit XOR 随机密钥加密,base64 编码后再嵌入到 prescript 模板。这不是为了"防破解",而是防止代码在容器内临时文件中以明文形式落盘被其他进程读取。
Layer 3 · 文件系统隔离:syscall.Chroot 把子进程的根目录切换到 /var/sandbox/<lang>/,让 ls / 只能看到受控的文件。Python 进程的第三方依赖被显式 mount 进去,而 /etc/passwd 等敏感文件天然不可见。
chroot 逃逸防护:DifySandbox 不是只靠 chroot。chroot 本身是可以逃逸的——攻击者可以通过 openat 等系统调用突破根目录限制。这就是为什么 Dify 还有 Seccomp 层。
Layer 4 · 进程权限降级:Setuid 65537 + Setgid 把子进程的用户切换到非 root 账户;PR_SET_NO_NEW_PRIVS 阻止通过 setuid 二进制重新提权。这是 chroot 漏洞的标准防御。
Layer 5 · Seccomp 系统调用白名单:整个沙箱体系最关键的一层。通过 libseccomp 创建一个过滤器,默认动作是 SCMP_ACT_KILL_PROCESS——任何不在白名单里的 syscall 触发后,子进程会被立即杀死,无法继续。
白名单分两套:
- Python 约 70 个 syscall(openat / read / write / mmap / brk / futex 等)
- Node.js 约 80 个 syscall
而且 AMD64 和 ARM64 架构各自维护一份白名单(写文件的 syscall 编号在 amd64 是 2,在 arm64 是 64)。
"我们采用白名单策略而不是黑名单,这样就不会意外地允许恶意系统调用。"——Yeuoly,DifySandbox 官方介绍
Layer 6 · 网络控制:默认拒绝所有网络出站,出网必须走 ssrf_proxy Squid 代理。这样恶意代码即使想探测内网或泄露数据,也无法直接建立连接。
Docker Compose 环境下,sandbox 运行在独立的 SSRF_PROXY_NET 内部网络,与默认网络隔离;Kubernetes 环境下则使用原生的 egress 网络策略。
Layer 7 · 资源控制:执行超时 + Worker 池上限 + 内存上限,防止单次任务耗尽宿主机资源。
9.3 部署注意(v1.16 无变化)
sandbox 容器目前仅在 Linux 上完整生效——Seccomp 和 chroot 都是 Linux 内核特性。Windows / macOS 上需要 Docker Desktop 或 OrbStack 提供 Linux 容器运行时,本机的 macOS 沙箱能力由宿主机保障。
在生产环境部署时,建议:
- 把 sandbox 容器加入
ssrf_proxy_network(internal 模式),禁止它直接出网 - 修改默认的
SANDBOX_API_KEY,不能留空 - 通过
dependencies/python-requirements.txt预装业务需要的依赖,避免运行时动态安装带来的安全风险
常见问题:为什么 pandas / numpy 某些版本在沙箱里跑不了?因为这些库会调用一些未被列入白名单的系统调用。解决方案是降级到兼容版本,或者自定义沙箱镜像添加所需的 syscall。——引自 Dify 社区 FAQ
十、安全隔离:ssrf_proxy
ssrf_proxy 是一个用 ubuntu/squid 镜像起的 Squid 代理,部署在 ssrf_proxy_network(internal 桥接)上。它充当所有需要出网的容器的"统一出口",核心目的是防止服务端请求伪造(SSRF)。
如果工作流里有 HTTP 节点,或者工具需要调用外部 API,Dify 不会让请求直接出网,而是强制走这个代理。Squid 的 ACL 配置可以:
- 黑名单:禁止访问内网 IP 段(10.0.0.0/8、172.16.0.0/12、192.168.0.0/16、169.254.0.0/16)
- 黑名单:禁止访问云元数据地址(169.254.169.254 等等)
- 白名单:只允许访问已配置的合法外网域名
这样即使有恶意工作流想探测云厂商的元数据服务偷凭证,也会被 Squid 直接拒绝。
sandbox 容器和 api 容器都加入了 ssrf_proxy_network——sandbox 通过它执行用户的网络调用,api 通过它处理工作流的 HTTP 节点。两者被同一个代理策略统一约束。
Mac Docker 陷阱:在 macOS Docker Desktop 上,host.docker.internal 指向宿主机,但如果你把 api 容器同时加入两个网络,宿主机路由可能会混乱。正确的做法是只让 ssrf_proxy 同时连两个网络,其他容器的所有出站流量都经过代理。——Dify GitHub Issue #3872
十一、数据存储层:PostgreSQL 与 Redis
11.1 PostgreSQL(v1.16 增强)
社区版默认用 postgres:15-alpine,通过 profile: postgresql 启用。生产配置里几个关键参数:
| command: > postgres -c max_connections=100 -c shared_buffers=128MB -c work_mem=4MB -c maintenance_work_mem=64MB -c effective_cache_size=4GB |
Dify 的 SQLAlchemy 模型围绕这些核心实体设计:Account(账户)、Tenant(租户)、App(应用)、Dataset(知识库)、Document(文档)、Conversation(对话)、Provider(模型供应商配置)、WorkflowRun(工作流执行记录)、Message(消息)。
表数量 100+,但通过外键和租户 ID 实现完全的多租户隔离。每个租户的数据物理上在同一库,逻辑上严格分开,任何业务查询都强制带 tenant_id 过滤。
v1.16 数据库变化:
- 支持 PostgreSQL 18 原生uuidv7()函数
- 兼容 ADB-PG 7.0(阿里云 AnalyticDB for PostgreSQL)
- 移除弃用的 SQL 选项
- 共 9 次数据库迁移
- 启动时自动执行flask db upgrade(无需手动操作)
数据库初始化踩坑:首次安装时如果数据库未初始化完成就访问管理员设置页面,会出现模糊的 500 错误。建议部署后先验证 db_postgres 日志显示"database system is ready to accept connections"再访问应用。
11.2 Redis(v1.16 增强)
redis:7-alpine(v1.16 从 6 升级到 7)在 Dify 里身兼三职:
- 缓存:Session、用户权限、Provider 配置等热数据
- 消息代理:Celery 的 broker
- 结果后端:Celery 任务的执行结果存储
.env 里通过不同的 DB 编号隔离:
| REDIS_DB=0 # 业务缓存(Session / 配置) CELERY_BROKER_URL=redis://:...@redis:6379/1 # 任务队列 CELERY_RESULT_BACKEND=redis://:...@redis:6379/2 # 任务结果 |
生产部署建议:
- 必设
REDIS_PASSWORD,不要用默认的difyai123456 - 内存上限 4-8GB 比较稳妥(Redis 吃内存,大了反而慢)
- 启用
maxmemory-policy allkeys-lru防止 OOM
v1.16 新增特性:
- Redis 连接增加 TCP keepalive 支持
- 扩展重试覆盖范围
- 大的插件模型对象用 zstd 压缩后存入 Redis,显著减少内存占用
十二、向量数据库:16 种可选(v1.16 无变化)
向量库是 RAG 检索的物理载体。Dify 通过 VECTOR_STORE 环境变量切换,16 种实现可选:
| 名称 | 类型 | 典型规模 | 部署 |
|---|---|---|---|
| weaviate | 独立服务 | 中等 | Docker(默认) |
| milvus | 独立集群 | 千万级以上 | 集群 |
| qdrant | 独立服务 | 中等 | Docker / K8s |
| chroma | 独立服务 | 小规模 | Docker |
| pgvector | PostgreSQL 扩展 | 小规模 | 同 PG |
| pgvecto-rs | PostgreSQL 扩展 | 小规模 | 同 PG |
| elasticsearch | 独立服务 | 中等 + 全文混合 | Docker |
| opensearch | 独立服务 | 中等 + 全文混合 | Docker |
| oceanbase | 独立服务 | 大规模 | Docker |
| hologres | 阿里云服务 | 大规模 | 托管 |
| seekdb | 独立服务 | 中等 | Docker |
| vastbase | 独立服务 | 中等 | Docker |
| couchbase-server | 独立服务 | 中等 | Docker |
| iris | 独立服务 | 中等 | Docker |
| oracle | 独立服务 | 中等 | Docker |
| opengauss | 独立服务 | 中等 | Docker |
| myscale | 独立服务 | 中等 | Docker |
| matrixone | 独立服务 | 中等 | Docker |
选择建议:
- 小规模验证或单机部署 → Weaviate(开箱即用,profile 启用即可)
- 不想引入额外基础设施 → pgvector(直接复用 PG 实例)
- 亿级向量 + 高 QPS → Milvus(独立集群,支持标量字段过滤、混合检索、水平扩展)
- 既要向量又要全文 → Elasticsearch 或 OpenSearch
Milvus 是社区里实际生产用得最多的选项,但它需要 etcd + MinIO + Milvus 三件套,最小集群占用资源不少。如果数据量在百万级以下,Weaviate 或 Qdrant 的单实例部署更省心。
十三、OpenAI Responses API 适配(v1.16 独家解析)
13.1 背景:OpenAI 的 API 范式迁移
2026 年 6 月,OpenAI 推出 GPT-5.6 系列模型,同时宣布 Chat Completions API 进入维护模式,新模型统一使用 Responses API。这是一次重大的范式升级:
| 特性 | Chat Completions | Responses API |
|---|---|---|
| 调用方式 | 单次 Request → Response | 交互式会话管理 |
| 工具调用 | 手动循环处理 | 内置自动工具调用循环 |
| 文件输入 | Base64 内嵌 | 原生 File ID 支持 |
| 输出模式 | 文本 / JSON | 文本 + 思考 + 文件 |
| 流式响应 | SSE | 完整事件流 |
13.2 Dify v1.16 的适配策略
Dify v1.16 做了完整的 Responses API 适配:
- 新模型默认走 Responses:GPT-5.6、GPT-5.6-preview 等新模型自动使用 Responses API
- 向后兼容:已有 Chat Completions 模型继续正常工作
- 手动切换机制:用户可以在模型供应商设置中手动切换 API 类型
重要警告:如果是使用自定义 OpenAI API Key 的现有用户,必须手动将 API 类型从Chat Completions切换到Responses,否则新模型的请求会失败。v1.16 的新安装默认使用 Responses API。
这一变化对 Dify 的架构影响深远——Responses API 的内置工具调用循环意味着 Dify 可以把部分 Agent 逻辑下沉到模型层,减少自己的循环开销。这也是为什么 v1.16 同时推出 Agent V2 的深层原因:平台级 Agent 和模型级 Agent 开始形成分层协同。
十四、生产部署与二开建议(v1.16 更新)
14.1 部署前的必做项(v1.16 最新)
| 配置项 | 默认值 | 建议 |
|---|---|---|
| SECRET_KEY | 空 | 用 openssl rand -base64 42 生成 |
| DB_PASSWORD | difyai123456 | 强随机密码 |
| REDIS_PASSWORD | difyai123456 | 强随机密码 |
| SANDBOX_API_KEY | dify-sandbox | 强随机 |
| DIFY_AGENT_SERVER_SECRET_KEY | dev key | 强随机 ← v1.16 新增 |
| INNER_API_KEY_FOR_PLUGIN | dev key | 强随机 |
| PLUGIN_DAEMON_KEY | dev key | 强随机 |
| NGINX_CLIENT_MAX_BODY_SIZE | 100M | 同步 UPLOAD_FILE_SIZE_LIMIT |
| WORKFLOW_GENERATION_TIMEOUT_MS | 180000 | 根据需要调整 ← v1.16 新增 |
Docker Compose 版本要求:v1.16 使用了新的env_file格式(支持path和required字段映射),必须使用 Docker Compose 2.24 或更高版本。旧版本会报错无法解析配置。
docker-compose.yaml 是自动生成的——直接修改它下次升级会被覆盖。正确的做法是改 docker/.env 和 docker/envs/*.env,然后用 dify-env-sync.sh 同步新变量。
v1.16 新增工具:官方提供dify-env-sync.sh脚本来同步.env.example中的新变量到本地.env,解决大版本升级时环境变量遗漏的痛点。
14.2 资源限制
社区版 docker-compose.yaml 只对 elasticsearch 显式设置了 memory: 2g。生产环境建议补全:
| services: api: deploy: resources: limits: { cpus: '4', memory: 8G } worker: deploy: resources: limits: { cpus: '4', memory: 8G } sandbox: deploy: resources: limits: { cpus: '2', memory: 2G } plugin_daemon: deploy: resources: limits: { cpus: '2', memory: 2G } agent_backend: # v1.16 新增 deploy: resources: limits: { cpus: '2', memory: 4G } local_sandbox: # v1.16 新增 deploy: resources: limits: { cpus: '2', memory: 4G } |
Dify 官方也提供了 Kubernetes Helm Chart 和 Docker Swarm 模板,可以参考 dify-kubernetes 仓库。
高可用实践:基于 AWS CDK 的部署方案把 api 和 worker 分别调度到不同的节点组,通过 ALB 入口控制器实现多可用区容灾。数据库建议使用托管 RDS 而非容器化 PG,自动备份和故障切换会省心很多。——引自 AWS 官方博客
14.3 二开路径
扩展工作流节点:在 api/core/workflow/nodes/ 下新增节点类型,继承 Node 基类并实现 _run 方法;在前端 web/app/components/workflow/nodes/ 添加对应编辑面板。
扩展模型供应商:在 api/core/model_runtime/model_providers/ 下添加新供应商,实现 LargeLanguageModel、TextEmbeddingModel、RerankModel 等抽象类即可接入。Dify 已经基于这套机制支持了 100+ 模型供应商。
开发插件:使用 dify plugin CLI 创建插件脚手架,实现 manifest 声明的工具 / 模型 / 端点能力,本地通过 PLUGIN_REMOTE_INSTALLING_HOST 远程调试连接开发容器。
自定义 Agent V2 技能:在 Agent Builder UI 中可以通过自然语言描述创建自定义技能包,也可以直接上传技能文件包供 Agent 调用。← v1.16 新增
替换默认组件:
- 替换向量库 → 改
VECTOR_STORE环境变量 + 启用对应 profile - 替换关系数据库 → 改用
mysqlprofile,但要注意部分索引行为差异 - 替换对象存储 → 实现
Storage抽象类,支持 S3、Azure Blob、阿里云 OSS、腾讯 COS 等
14.4 调优要点(v1.16 新增验证)
Celery 并发:worker 默认 concurrency=2。IO 密集型任务(文档摄取)可以提到 8-16;LLM 调用密集型建议保持 2-4,避免触发模型限流。
向量库参数:HNSW 索引的 efConstruction 和 ef 越大召回率越高但越慢;生产环境通常 ef=64-128 是平衡点。
PostgreSQL 调优:work_mem、shared_buffers、effective_cache_size 三个参数最关键;大表(对话、消息)需要按时间分区。
Redis 持久化:Dify 的缓存可以丢(丢了只是慢一点),但 Celery 任务不能丢,建议 RDB + AOF 混合。v1.16 中 zstd 压缩插件对象后 Redis 内存占用降低约 40%。
前端性能:v1.16 通过 Vite 插件懒加载和 Jotai 状态管理重构,首页启动速度提升约 60%。
十五、写在最后:设计的取舍
回头看 Dify 从 v0.1 到 v1.16 的容器设计演进,有几个值得品味的取舍:
同镜像多角色(api / worker / worker_beat 共用 dify-api 镜像):牺牲一些启动时的灵活性,换来部署一致性和升级一致性。这是单体应用往云原生迁移时一个常见的折中。从 v0.1 沿用至今证明了其架构的稳定性。
Go 服务拆出核心运行时(plugin_daemon → sandbox → agent_backend):牺牲一些"全 Python 技术栈"的纯粹,换来并发性能、内存效率、多语言支持。Dify 团队从 v0.6 开始用 Go 重写核心基础设施,到 v1.16 已经形成完整的 Go 服务矩阵——这是一个渐进式的架构演进,不是一蹴而就的重构。
双沙箱架构(sandbox 服务 Code 节点,local_sandbox 服务 Agent V2):牺牲一些"单一真相源"的简洁,换来针对不同场景的差异化安全策略。Code 节点是"敌人"提交的不可信代码,需要 Seccomp 锁死;Agent 是"自己人"执行的可信自动化,需要完整的 Linux 能力。这种分离是刻意的架构设计,不是重复建设。
安全不靠沙箱靠签名(插件系统):牺牲一点"防患于未然"的确定感,换来开发体验的灵活性和插件生态的繁荣。
容器编排可拆分(16 种向量库 + 多种 ETL 引擎):牺牲一些"一键启动"的便利,让用户能根据数据规模和成本预算做差异化选型。
这些选择没有绝对对错,但它们共同构成了 Dify "工程师友好 + 业务灵活 + 生产可用"的工程风格。下次你再在生产环境遇到 docker compose down && docker compose up -d 的时候,大概就能用三十秒在脑海里把这一整套架构画出来——这正是技术写作的目的:把别人的工程决定内化为自己的直觉。
参考资料
- Dify 官方 Release Notes · v1.16.0-rc1 · 2026.7.9 · Release v1.16.0-rc1 · langgenius/dify · GitHub
- Dify 官方文档 · Docker Compose 部署 · 使用 Docker Compose 部署 Dify - Dify Docs
- Yeuoly. Introduction to DifySandbox · Dify 官方博客 · 2024.7.10 · Introduction to DifySandbox - Dify
- Yeuoly. Dify Plugin System: Design and Implementation · Dify 官方博客 · 2025.3.4 · Dify Plugin System: Design and Implementation - Dify
- Dify Docs · Build an Agent (Beta) · New Agent - Dify Docs
- 亚马逊云科技官方博客 · 基于 AWS CDK 部署 Dify 社区版的高可用方案 · 亚马逊AWS官方博客
- Varmor.org · AI 应用开发平台安全加固实践 · AI 应用开发平台安全加固实践 | vArmor
- Dify GitHub Issue #38882 · Agent V2 incompatible with vLLM-hosted local models
- Dify GitHub Issue #3872 · SSRF Proxy network configuration trap on Mac Docker Desktop
- Dify v1.13.0 Release Notes · Hologres vector database support · 2026.3
- Dify 社区 FAQ · Sandbox 和 pandas/numpy 兼容性问题 · 2026
- Zenn (日本技术社区) · Dify v1.16.0-rc1 新功能验证报告 · 2026.7.15 · Dify v1.16(rc1)の新機能を一通り検証してみた
- CSDN · dify 1.16.0 发布:原生 Agent 沙箱、MCP 协议升级、GPT-5.6 兼容适配 · 2026.7.19
更多推荐


 8
 0
- 0


 已为社区贡献4条内容

所有评论(0)