
Kubernetes(K8s)笔记Day01:K8s介绍与工作原理
一、Kubernetes 简介
1.1 什么是 Kubernetes
Kubernetes 是一个可移植的、可扩展的开源容器编排平台,用于自动化部署、伸缩和管理容器化应用。
Kubernetes 拥有一个庞大且快速增长的生态系统,其服务、支持和工具广泛可用。
名称来源: “Kubernetes” 源于希腊语,意为"舵手"或"飞行员"。
发展历程:
- Google 在 2014 年开源了 Kubernetes 项目
- Kubernetes 建立在 Google 在大规模运行生产工作负载方面十几年的经验基础上
- 结合了社区中最好的想法和实践
1.2 容器优势
| 优势 | 说明 |
|---|---|
| 敏捷性 | 敏捷应用程序的创建和部署:与使用 VM 镜像相比,提高了容器镜像创建的简便性和效率 |
| 及时性 | 持续开发、集成和部署:通过快速简单的回滚(由于镜像不可变性),支持可靠且频繁的容器镜像构建和部署 |
| 解耦性 | 关注开发与运维的分离:在构建/发布时创建应用程序容器镜像,而不是在部署时,从而将应用程序与基础架构分离 |
| 可观测性 | 可观察性不仅可以显示操作系统级别的信息和指标,还可以显示应用程序的运行状况和其他指标信号 |
| 跨平台 | 跨开发、测试和生产的环境一致性:在便携式计算机上与在云中相同地运行 |
| 可移植 | 跨云和操作系统发行版本的可移植性:可在 Ubuntu、RHEL、CoreOS、本地、Google Kubernetes Engine 和其他任何地方运行 |
| 简易性 | 以应用程序为中心的管理:提高抽象级别,从在虚拟硬件上运行 OS 到使用逻辑资源在 OS 上运行应用程序 |
| 大分布式 | 松散耦合、分布式、弹性、解放的微服务:应用程序被分解成较小的独立部分,并且可以动态部署和管理,而不是在一台大型单机上整体运行 |
| 隔离性 | 资源隔离:可预测的应用程序性能 |
| 高效性 | 资源利用:高效率和高密度 |
1.3 容器化面临的问题
单纯使用容器(如 Docker)在生产环境中会遇到以下挑战:
- 弹性的容器化应用管理
- 强大的故障转移能力
- 高性能的负载均衡访问机制
- 便捷的扩展
- 自动化的资源监测
- …
1.4 为什么使用 Kubernetes
容器是打包和运行应用程序的好方式。在生产环境中,你需要管理运行应用程序的容器,并确保不会停机。例如,如果一个容器发生故障,则需要启动另一个容器。
Kubernetes 提供了一个可弹性运行分布式系统的框架,是 Linux 之上的服务编排框架。
Kubernetes 提供的能力:
| 能力 | 说明 |
|---|---|
| 服务发现和负载均衡 | 可以使用 DNS 名称或自己的 IP 地址公开容器;如果进入容器的流量很大,Kubernetes 可以负载均衡并分配网络流量,从而使部署稳定 |
| 存储编排 | 允许自动挂载你选择的存储系统,例如本地存储、公共云提供商等 |
| 自动部署和回滚 | 可以描述已部署容器的所需状态,以受控的速率将实际状态更改为期望状态;可以自动化创建新容器、删除现有容器并将所有资源用于新容器 |
| 自动完成装箱计算 | 允许指定每个容器所需 CPU 和内存(RAM);当容器指定了资源请求时,Kubernetes 可以做出更好的决策来管理容器的资源 |
| 自我修复 | 重新启动失败的容器、替换容器、杀死不响应用户定义的运行状况检查的容器,并且在准备好服务之前不将其通告给客户端 |
| 密钥与配置管理 | 允许存储和管理敏感信息,例如密码、OAuth 令牌和 ssh 密钥;可以在不重建容器镜像的情况下部署和更新密钥和应用程序配置,也无需在堆栈配置中暴露密钥 |
| … |
为了生产环境的容器化大规模应用编排,必须有一个自动化的框架系统,Kubernetes(K8s)等编排软件应运而生。
1.5市场份额
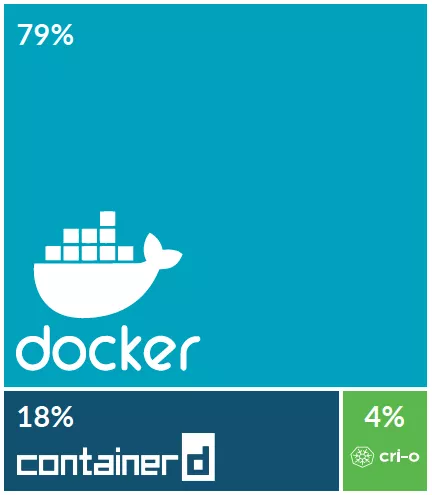
目前,容器化市场份额由Docker牢牢占据市场第一
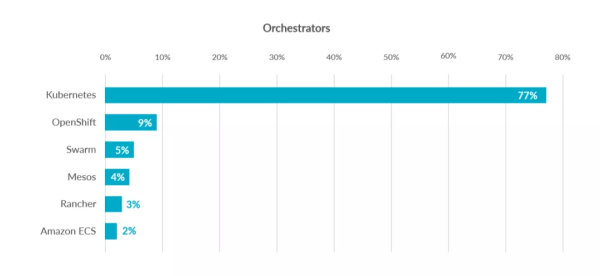
而在容器编排方面的市场,Kubernetes(K8s)独占鳌头
二、Kubernetes 集群原理
2.1 Master-Node 架构
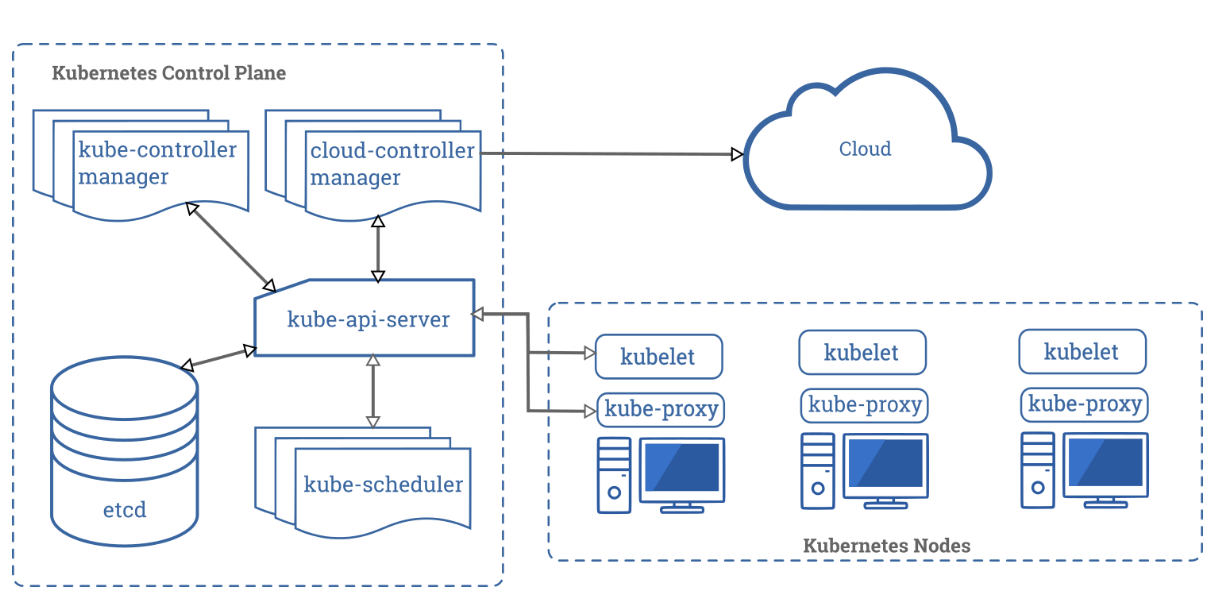
Kubernetes 采用 Master-Node(主从) 架构:
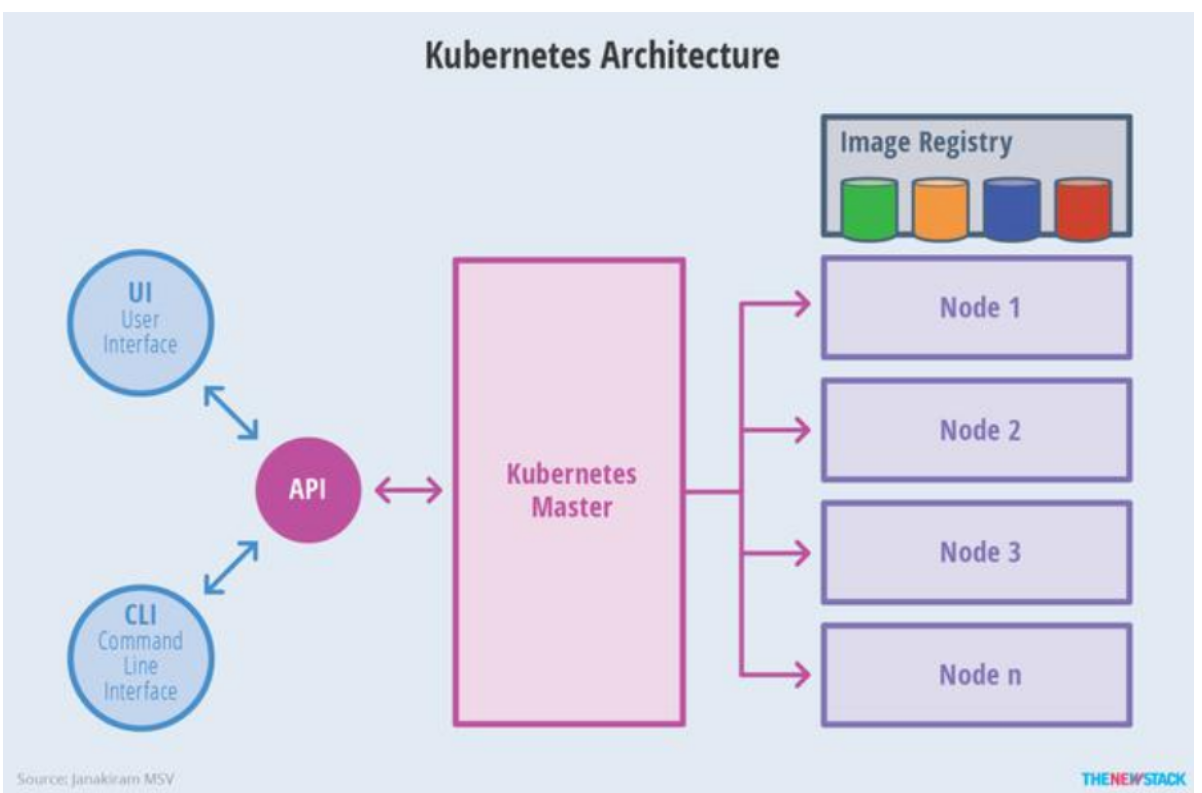
Master 和 Worker 的交互方式:
- Master 决定 Worker (node) 里面都有什么,做什么
- Worker 只和 Master 的 API Server 通信
- 所有对 Kubernetes 集群的“管理操控”(增删改查资源),都必须通过 API Server;但用户的“业务流量”不经过 API Server
- 每一个节点各司其职
运维人员使用 UI(网页控制台) 或者 CLI (命令行)操作 K8s 集群的 Master,就可以知道整个集群的状况。
2.2 核心组件详解
Master (主节点)组件
| 组件 | 说明 |
|---|---|
| API Server | 访问管理 K8s 集群的唯一入口,同时其他组件通过 API Server 实现通信。相当于 MVC 模式中的 Controller 层 |
| etcd | 分布式键值数据库(nosql),存储了整个 K8s 集群的状态信息(不存储实际的应用数据,、配置信息等)。注意:etcd 不存储实际的应用数据(比如数据库里的业务记录),)。是 K8s 的"记账本"和"记事本" |
| Scheduler(调度器) | 负责选出最佳的一个节点来部署容器。从所有 Node 节点中剔除不符合条件的节点,接着给剩下的 Node 打分,得分最高者被选中 |
| Controller Manager(控制管理器) | 控制容器的数量,确保集群状态与期望状态一致(如Deployment、ReplicaSet、Node等),将当前状态推向用户定义的期望状态 |
这四个组件负责“决策”和“大脑”功能,它们必须跑在控制平面(Master)节点上
Node (Worker工作节点)组件
| 组件 | 说明 |
|---|---|
| kubelet | 每一个 Node 节点上必须安装的组件。负责每一个节点上容器的启停,以及收集节的信息汇报给 API Server。可以理解为"监工" |
| kube-proxy | 运行在每个Node上的网络代理。负责实现Service的虚拟IP和端口转发。当Pod访问Service时,kube-proxy通过iptables或IPVS规则将请求分发到后端的实际Pod,并处理会话保持。 |
master节点也存在这两个组件,严格来说这两个组件属于是节点级组件,而非单纯是worker组件
2.3 工作原理:Pod部署流程详解
什么是Pod?
在英文中,Pod是豆荚的意思。在这里,你可以把容器当成豆子,Pod就是装豆子的豆荚。
所以,Pod是容器的载体,是一个容器组。Pod 是 Kubernetes 中最小的可部署单元,也是调度的基本单位
部署流程详解
Kubernetes 部署的是 Pod,调度的是 Pod,管理的是 Pod。Pod是K8s管理的单元,容器只是 Pod 内部的实际运行载体。
在 K8s 集群中部署一个容器组(Pod)的完整过程(简略版本):
a kubectl 向 API Server 发送部署 Pod 的请求
b API Server 将请求信息保存到 etcd记录期望状态(信息保存完毕,etcd会回复apiserver)
c Controller Manager(控制管理器) 通过apiserver感知到 etcd 的变化,生成 Pod 的部署信息,并通过apiserver写回 etcd (信息保存完毕,etcd会回复apiserver)
d Scheduler(调度器) 通过apiserver感知到 etcd 中的 Pod 信息,剔除不合格节点,打分选出最佳节点,将调度结果通过apiserver写回 etcd
e 被选中的 Node 上的 kubelet 通过apiserver感知到 etcd 的变化,在本地启动容器
f kubelet 将容器状态汇报给 API Server,API Server 保存到 etcd
需注意,apiserver是一个切实的中转站,(除了工作节点的业务请求之外的)一切管理请求都要经过它。各组件之间不直接通信,全部通过 API Server 进行交互。
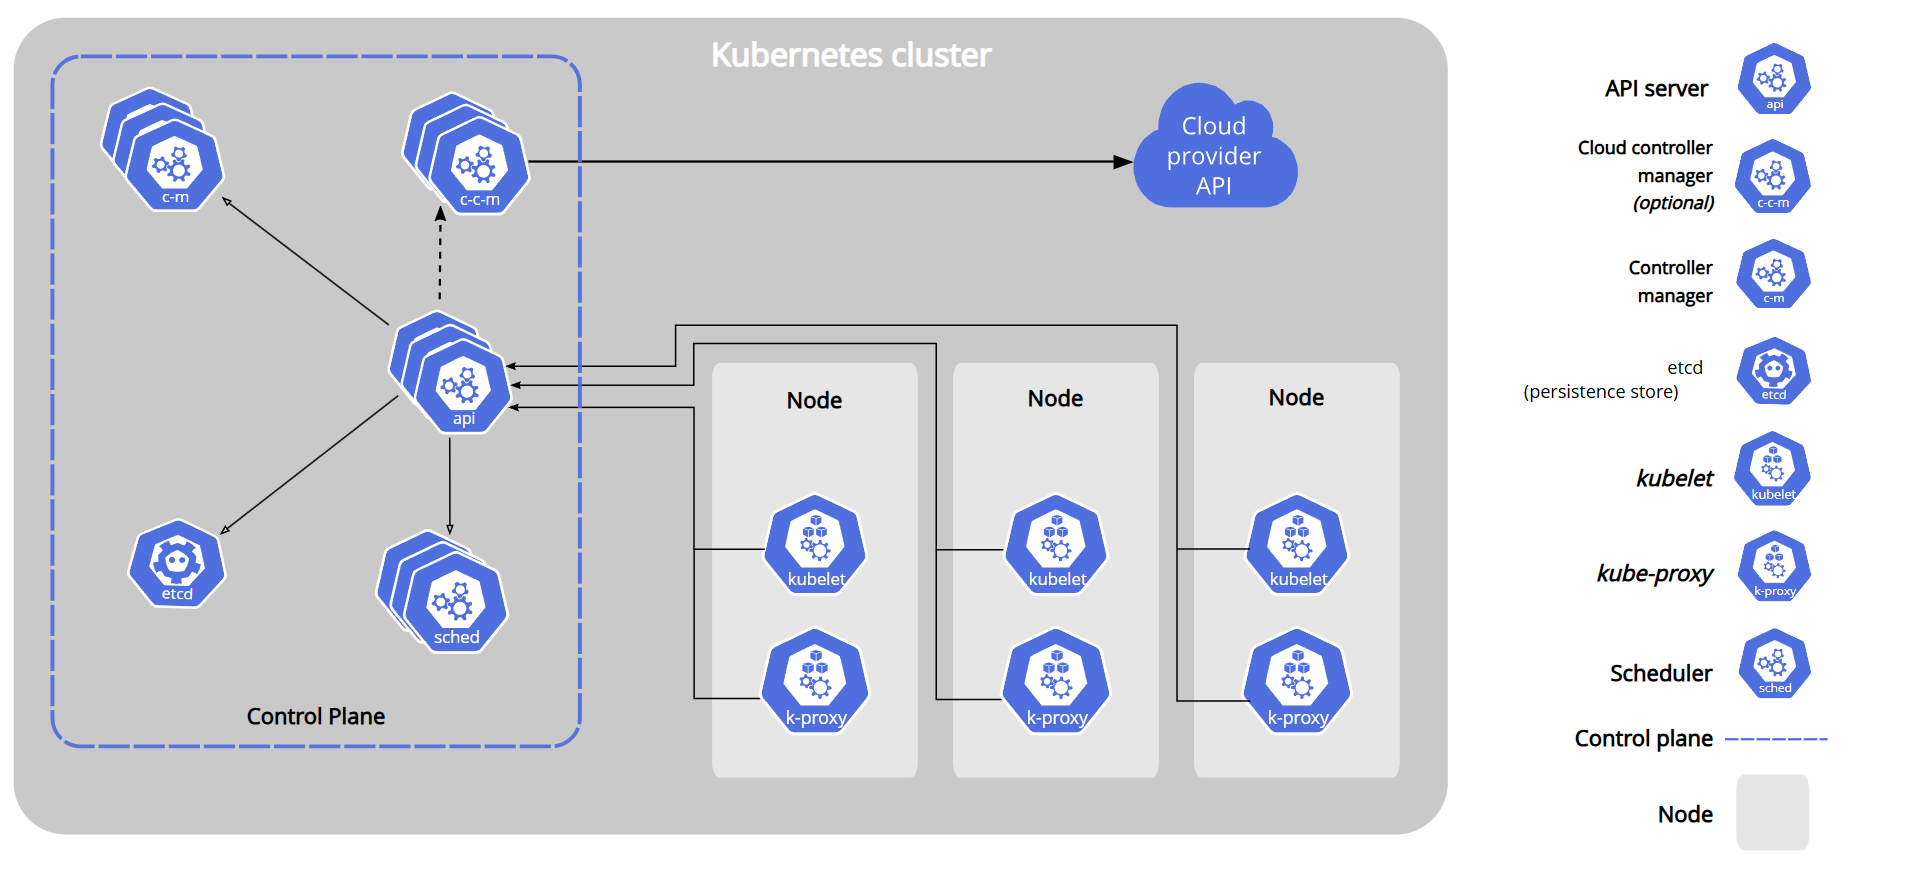
master节点控制整个集群:
- Controller Manager:控制管理器
- etcd:键值数据库(redis)【记账本,记事本】,存储集群的状态
- scheduler:调度器
- api server:api网关(并非真正的网关,而是因为所有的控制都需要通过api-server,功能类似网关),集群的统一入口和中枢神经
- kubelet:负责启动控制平面组件(静态 Pod)
- kube-proxy:负责主节点网络规则
补充:Master节点还有一个常被提及的组件叫 Cloud Controller Manager(云控制器管理器,如果跑在云厂商上),用于对接底层云服务商的负载均衡、存储等,但在纯自建本地集群中通常不涉及。
- “本地”控制器(Deployment / ReplicaSet / StatefulSet 等):管理的是集群内部的无状态资源。它们只盯着 etcd 里的数据,确保集群内该有多少个 Pod、Pod 该用哪个镜像版本。它们完全不关心这些 Pod 跑在哪台物理机/虚拟机上,也不关心底层网络怎么连到外网
- 云控制器(Cloud Controller Manager):管理的是集群外部的云基础设施资源。它负责调取云厂商的 API,去创建/删除/监控云上的负载均衡器(SLB/ELB)、云硬盘(块存储)、虚拟机节点(Node) 以及 VPC 路由表。
node节点(worker工作节点):
- kubelet(监工):每一个node节点上必须安装的组件。管理业务 Pod,并通过容器运行时(如 Docker)实际启停容器
- kube-proxy:代理。实现 Service 网络转发(业务流量)
注意:本图为了方便理解把这两个组件只划分到了node工作节点,意思是工作(node)节点只有kubelet和kube-proxy,不代表主节点不存在kubelet和kube-proxy组件
部署一个应用的详细步骤
- 用户通过 kubectl 提交 应用 创建请求。
- API Server 接收请求,将 应用 对象写入 etcd。
- Controller Manager 感应到变化,生成 Pod 资源对象,并通过 API Server 写入 etcd。
- Scheduler 监听到未被调度的 Pod,通过计算选出最合适的节点(Node2)。
- Scheduler 将调度结果写入 API Server,API Server 更新 etcd。
- Node2 上的 kubelet 监听到了指派给自己的 Pod 事件,调用底层容器运行时启动 Pod。
- kubelet 将 Pod 的最新运行状态汇报给 API Server,最终存入 etcd。
核心理解: 所有组件都通过 API Server 通信,etcd 作为状态存储中心,Controller Manager 负责维护期望状态,Scheduler 负责智能调度。
2.4 K8s特性
无论访问哪个机器,都可以访问到真正应用(Service 背后的 Pod)
有人可能会好奇,这是为什么?为什么我在没有部署服务的集群主机上也能访问到我在其他服务器部署的服务?
这主要归功于** kube-proxy(网络代理)**
错误认知:你的 Tomcat Pod 跑在了 hd2 上。如果你访问 hd1(Master)的 IP 加 8080 端口,绝对访问不到,因为 hd1 机器上根本没这个容器进程
真实情况:
你创建一个 Service,类型选 NodePort。Kubernetes 会在集群内所有节点(包括 hd1、hd2、hd3) 的物理网卡上,同时打开一个随机端口(比如 30001)。此时,无论你访问 hd1:30001、hd2:30001 还是 hd3:30001,流量都会被 **kube-proxy(网络代理)**劫持,并负载均衡转发到真正运行 Pod 的 hd2 机器上去
原理
简单讲,就是因为 kube-proxy 会监听集群中每个节点上发生的变化,Service 虽然是命名空间级别的资源(不同命名空间可以有同名 Service),但它创建时,API Server 会把这个信息广播给所有节点上的 kube-proxy。
每个节点的kube-proxy监听到 API Server 上 Service 和 Endpoints 的变化之后,就会在本地节点上写入对应的网络规则(iptables 或 IPVS),把 Service 的 ClusterIP 映射到后端的 Pod IP。
最终,每个节点的内核网络栈里都有了一套完整的转发规则。无论请求从哪个节点进来,都能命中正确的规则,转发到对应的 Pod。
至于nodeport是什么,需要在后续慢慢去学习了解
三、组件交互原理(串行详解)
完整的组件交互流程
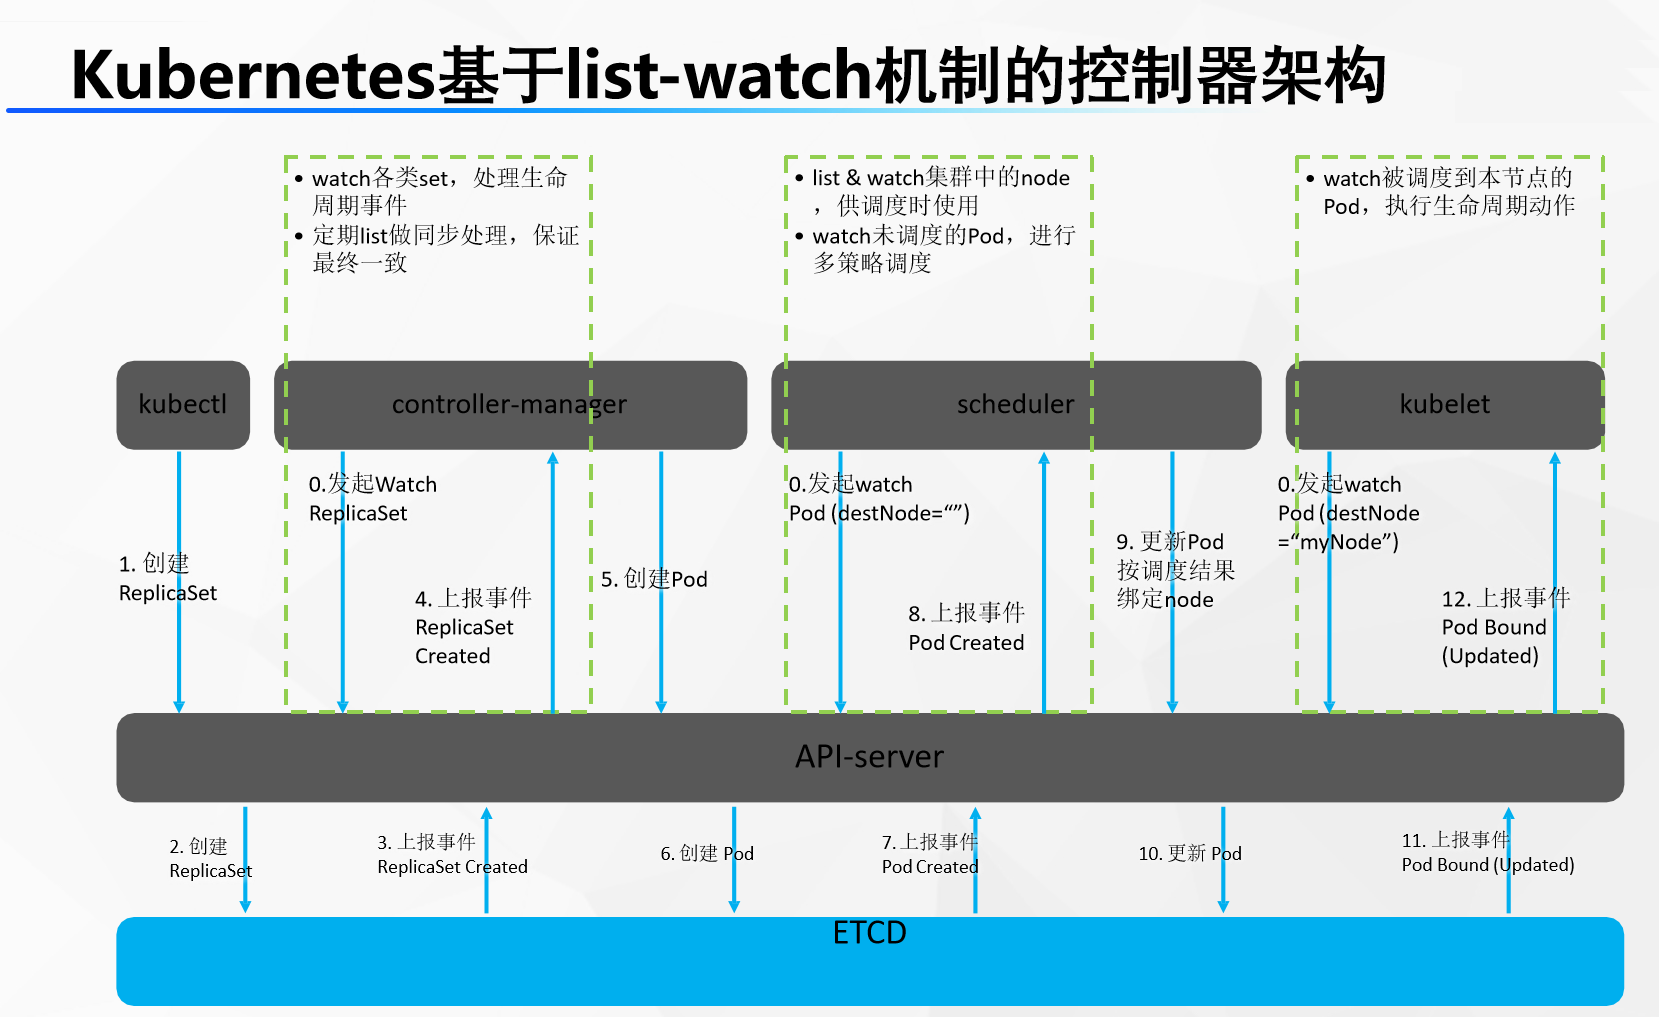
0. 开机默认状态
   所有节点的 kubelet、Master 节点的 scheduler(调度器)、controller-manager(控制器管理器) 一直监听 Master 的 API Server 发来的事件变化(for :: 无限循环监听)

1. 运维工程师使用 kubectl(命令行工具)
   kubectl create deploy tomcat --image=tomcat8
   → 告诉 Master 让集群使用 tomcat8 镜像部署一个 tomcat 应用

2. kubectl 将请求内容发给 API Server
   → API Server 保存此次创建信息到 etcd

3. etcd 给 API Server 上报事件
   → "刚才有人往我里面保存了一个部署 Tomcat 的信息"

4. Controller Manager 监听到 API Server 的事件
   → 识别出是"部署 Tomcat"事件

5. Controller Manager 处理该事件
   → Controller Manager 生成 Pod 的部署信息

6. Controller Manager 把 Pod 信息交给 API Server
   → API Server 再次保存到 etcd

7. etcd 上报事件【Pod 信息】给 API Server

8. Scheduler调度器 专门监听【Pod 信息】(从 API Server 监听到
的)   → 拿到 Pod 信息,计算哪个节点合适
   → 生成"Pod 调度过后的信息(node: node-02)"

9. Scheduler调度器 把调度结果交给 API Server
   → API Server 保存到 etcd

10. etcd 上报事件【Pod 调度过后的信息(node: node-02)】给 API Server

11. 所有节点的 kubelet 专门监听 【pod调度过后的信息(node: node-02)】 事件, 从 API Server 拿到该事件

12. 每个节点的 kubelet 判断是否属于自己的事情
    → node-02 的 kubelet 发现是他的事情

13. node-02 的 kubelet 启动这个 Pod
    → 汇报给 Master 当前启动好的所有信息
核心组件对应关系
| 组件 | 角色比喻 | 职责 |
|---|---|---|
| API Server | 网关/前台 | 所有请求的唯一入口,MVC 中的 Controller |
| etcd | 记账本/记事本 | 存储集群的所有状态信息(键值数据库) |
| Scheduler | 调度员 | 为 Pod 选择最合适的 Node 节点 |
| Controller Manager | 监工/管理者 | 控制容器数量,维护期望状态 |
| kubelet | 节点代理/监工 | 启停容器,汇报节点状态 |
| kube-proxy | 网络代理 | 负载均衡和服务发现 |
四、Kubernetes 集群安装方法
| 方法 | 说明 |
|---|---|
| kubeadm(官方推荐) | 安装工具,每个组件都是容器化的。默认证书有效期为 1 年 |
| 二进制安装 | 复杂方式,适合深入学习 |
五、核心知识点总结
5.1 Kubernetes 核心价值
- 容器编排:自动化管理容器化应用
- 服务发现与负载均衡:自动分配流量
- 自我修复:自动重启失败的容器
- 自动扩缩容:根据负载自动调整副本数
- 滚动更新与回滚:零停机部署
- 存储编排:自动挂载存储系统
5.2 组件职责
Master 节点(控制平面):
├── API Server    → 唯一入口,所有组件通过它通信
├── etcd          → 存储集群状态(键值数据库)
├── Scheduler     → 智能调度,为 Pod 选择节点
└── Controller Manager → 维持期望状态(如:始终运行 5 个副本)

Worker 节点:
├── kubelet       → 节点代理,启停容器,汇报状态
└── kube-proxy    → 网络代理,负载均衡
5.3 部署流程总结
kubectl → API Server → etcd → Controller Manager → Scheduler → kubelet → 容器运行时
整个流程通过 API Server 作为中枢,etcd 作为状态存储,所有组件松耦合协同工作,实现了 Kubernetes 的自动化容器编排能力。
更多推荐
 9
 0
- 0


 已为社区贡献27条内容

所有评论(0)