
开源大模型“集体破壁“:当模型不再是护城河,生态才是
开源大模型"集体破壁":当模型不再是护城河,生态才是
2026 年的春天,对全球 AI 行业是安静而震荡的八周。
4 月 23 日到 6 月中旬,中国的 DeepSeek、月之暗面、智谱(Z.ai) 三家实验室密集开源了四个万亿参数级的前沿模型;紧接着,腾讯的 Hy3 重新改写了"效率前沿"。再过不到一个月,在 7 月 17 日到 20 日的 WAIC 世界人工智能大会上,"开源"被写进了中国 AI 的国家叙事——“中国正成为开源 AI 的标准制定者”。
说"集体破壁",不是因为某一个模型超了一两个分数。是因为这些公告之间,关于"模型是不是稀缺资产"这件事,市场的定价逻辑开始逆转。
一个事实正在发生:开源,追上了闭源。
一、8 周,4 个前沿开源模型,到底发生了什么
把时间线摊开看:
4 月 23 日,DeepSeek V4(Pro + Flash)正式上线。这是这场"破壁"的起点。V4 Pro 是一个 1.6 万亿参数的混合专家(MoE)架构,每次推理激活 490 亿参数,原生支持 1 百万 token 的上下文,使用 MIT 许可证开源。在 SWE-Bench Verified 上拿下 80.6%,在 GPQA Diamond(研究生级推理)上 90.1%。托管 API 报价大约是 $0.14 输入 / $0.28 输出 每百万 token——换句话说,是 Anthropic 旗舰 Claude Fable 5 的大约七十分之一。
几乎同时,月之暗面发布并开源了 Kimi K2.6。K2.6 是面向"子代理并行"重新设计的 1 万亿参数 MoE,原生支持 256K 上下文。它在 SWE-Bench Pro 上成为第一个击败 GPT-5.4 的开源权重模型。比起"分数",K2.6 的真正意义在架构——它把"调度多个 task-scoped 子代理并行"做成了第一公民。
5 月,智谱 Z.ai(曾经的"智谱清言")开源了 GLM-5 与 GLM-5.1。这是一个 754B 的 MoE 模型,发布时就在 SWE-Bench Pro 上拿到了 58.4 分——比 GPT-5.4(57.7)和 Claude Opus 4.6(57.3)都高。但更重要的是训练方式:整个 GLM-5 是在 10 万颗华为昇腾 910B 国产芯片上训练的,整个训练流程没有用到任何美国制造的硬件。
紧接着,阿里通义开源了 Qwen 3.5。397B 的 MoE,Apache 2.0(不是改 MIT,是更干净的企业级许可证),原生 256K 上下文,覆盖 201 种语言。在数学视觉这种"既要懂数学又要看图像"的硬基准上,Qwen 已经超过 GPT-5.2。
6 月到 7 月,腾讯 Hy3 改写"效率前沿"。这是一个只有 295B 总参数、激活 21B 的 MoE,却达到了接近 GLM-5.2 的智能水平——只用了对方大约一半的算力。Apache 2.0 许可证,对企业法务最友好。
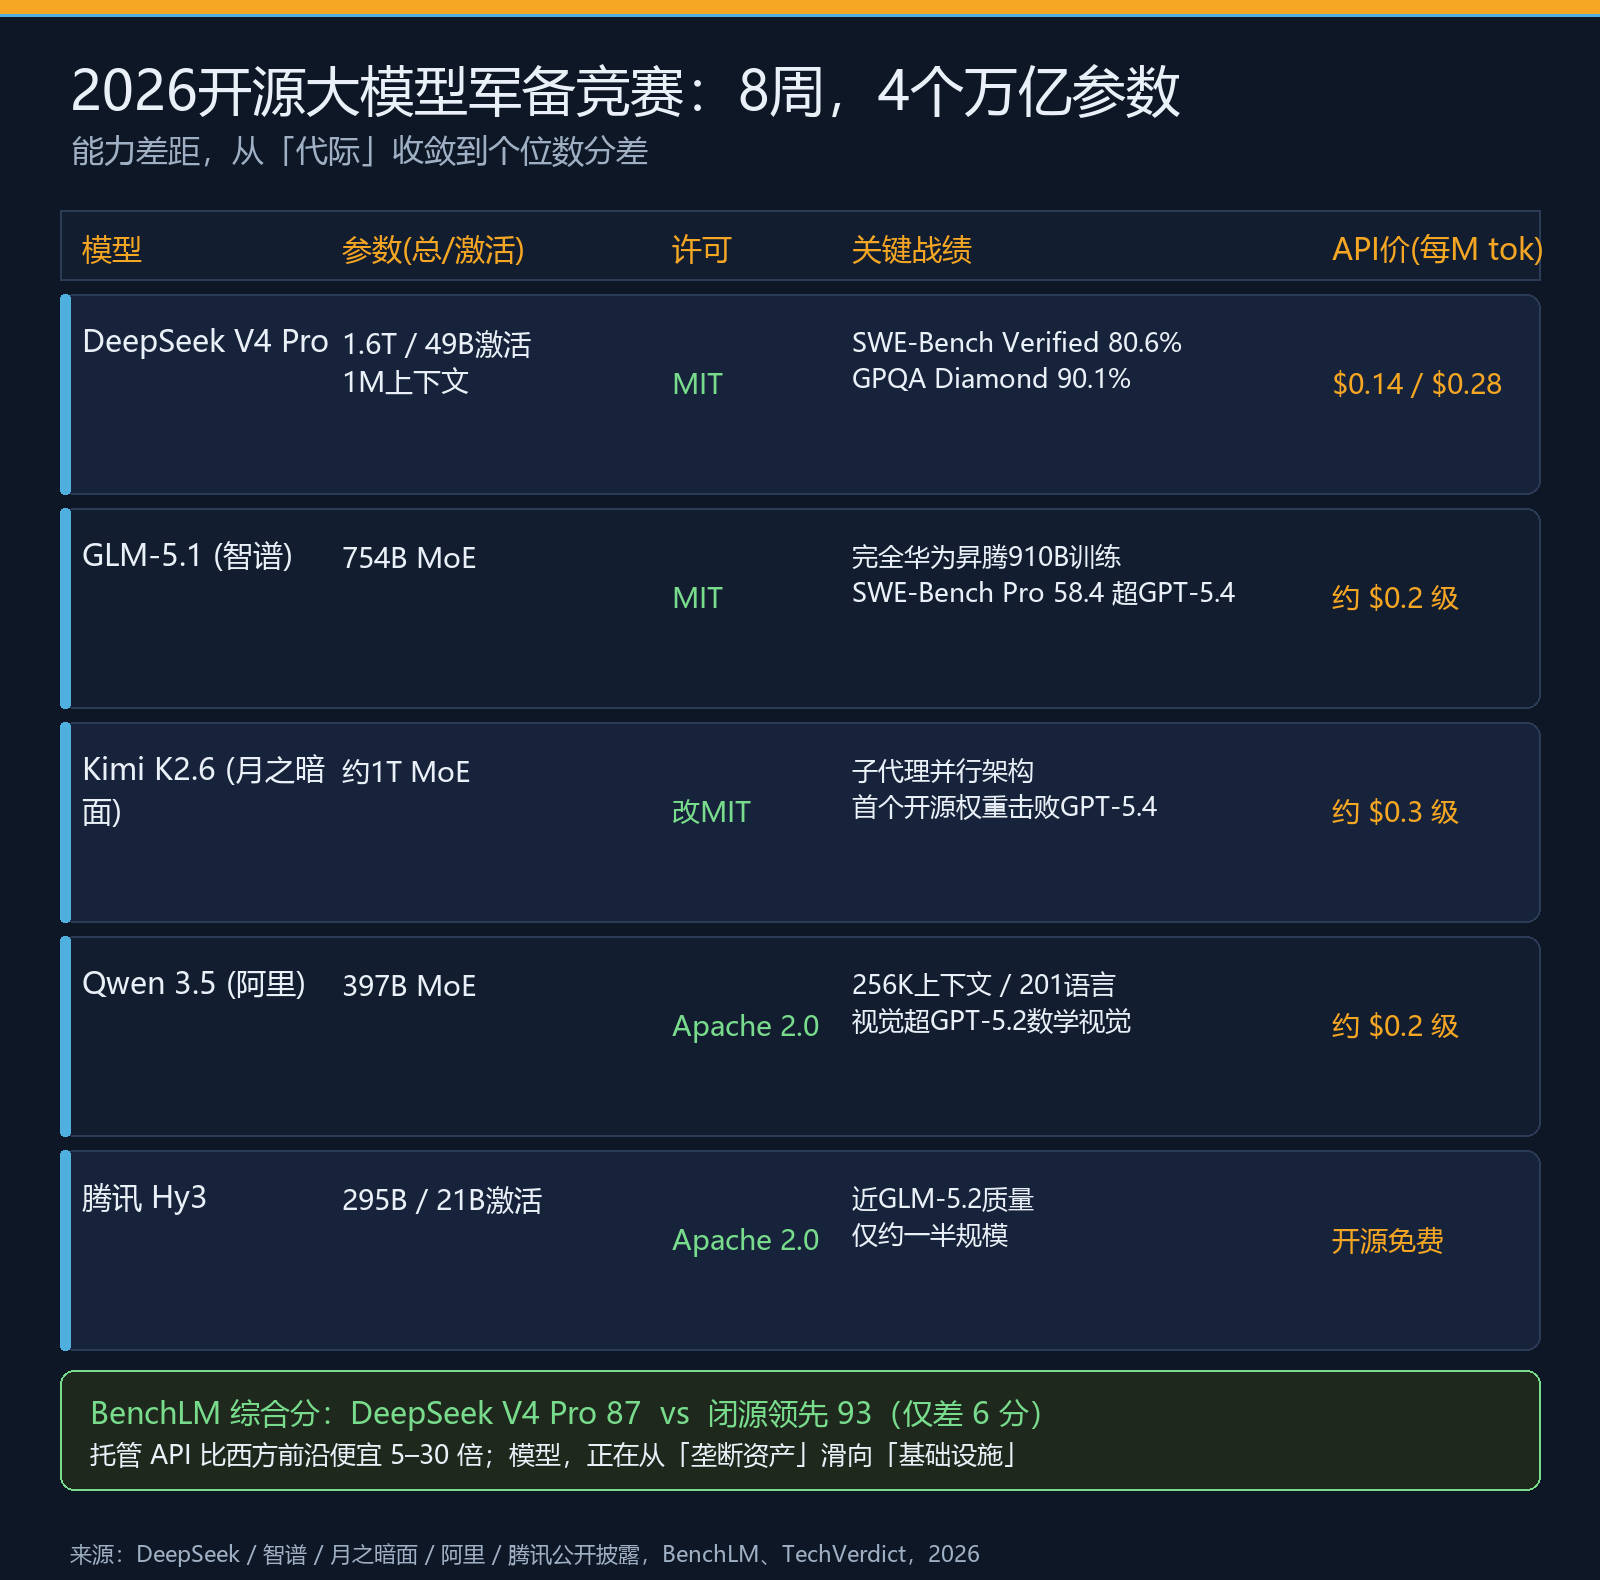
如果把这些成绩聚到一个综合分数上(BenchLM 2026 年 7 月版),闭源的最强选手是 93 分,DeepSeek V4 Pro 87 分,GLM-5.1 83 分,Kimi K2.6 81 分,Qwen 3.5 79 分。
分数差,从 2023 年的两位数,收到 2024 年的个位数,再收到 2026 年的 6 分。 能力差距的"代际"感没有了。
这不是说开源已经赢了。是说在"能不能用、好不好用"这条主线上,开闭源已经同台竞争。剩下 6 分的差距,大多数客户,已经不愿意为它单独付闭源的溢价。
二、这意味着什么——大模型正在变成"基础设施"
我们先承认一个事实:模型能力在 2025 到 2026 年间被快速商品化,这个事实在之前的几次发布中已经反复出现。但这一次的特殊性在于:商品化的主力,从"闭源厂商之间的互相踩踏",变成了"开源对闭源的能力平权"。
我把它类比成 Linux 当年的局面。
2000 年代初,Windows 是闭源的事实标准;Linux 是"爱好者的玩具"。但在服务器市场,Linux 凭借开源、可改、可私有部署、用多少算多少的特性,三五年内吃掉了云厂商的工作负载。今天你打开 AWS 或阿里云的 ECS,几乎每一台虚拟机都跑在 Linux 上。Windows Server 活着,但再也没有定价权。
大语言模型正在走同样的路。
几个直接的证据。
第一,价格地板被重新设定。DeepSeek V4 Pro 报 $0.14 / $0.28 每百万 token;Qwen 3.5、GLM-5、Tencent Hy3 大致在 $0.2 到 $0.3 的量级。西方前沿闭源模型的同口径报价大约是这个数的 5 到 30 倍。客户侧的算账方式从此被改写:“我为什么要在能力只差几个点的时候,多付十倍的钱?”
第二,商业闭环已经形成。DeepSeek V4 启动了首轮外部融资,估值大约 200 亿美元。这说明资本市场认同:开源旗舰模型的背后,可以长出企业服务和商业授权的盈利支点。开源不再是"情怀驱动"。
第三,许可足够干净。DeepSeek V4、GLM-5、Qwen 3.5、Tencent Hy3 全都在 MIT 或 Apache 2.0 之下。你能下载、能改、能塞进自己的产品、自己卖——不需要问任何人的意见。这是过去十年的开源软件都没能做到过的事。
但开源不是免费的。
DeepSeek V4 Pro 的满血版本需要大约 800GB 显存才能跑——相当于 10 张 H100 80G。这种规模的部署,今天全世界没多少家企业是自己扛的:要么用托管 API(背后是别人的数据中心),要么用"轻量兄弟"——V4-Flash,284B / 13B 激活,单卡可上,但只能拿到 77 分的综合能力。
模型免费,账单在别处。
三、当模型不再是护城河,那什么是
这才是 2026 年最值得追问的问题。
如果能力平权、价格平权、许可证平权——三件事同时发生——那么模型本身,作为企业竞争资源,已经不再具备稀缺性。
谁有模型不重要。谁能把模型真正用起来才重要。
我把这一轮竞争中胜出的护城河,划分为四种。
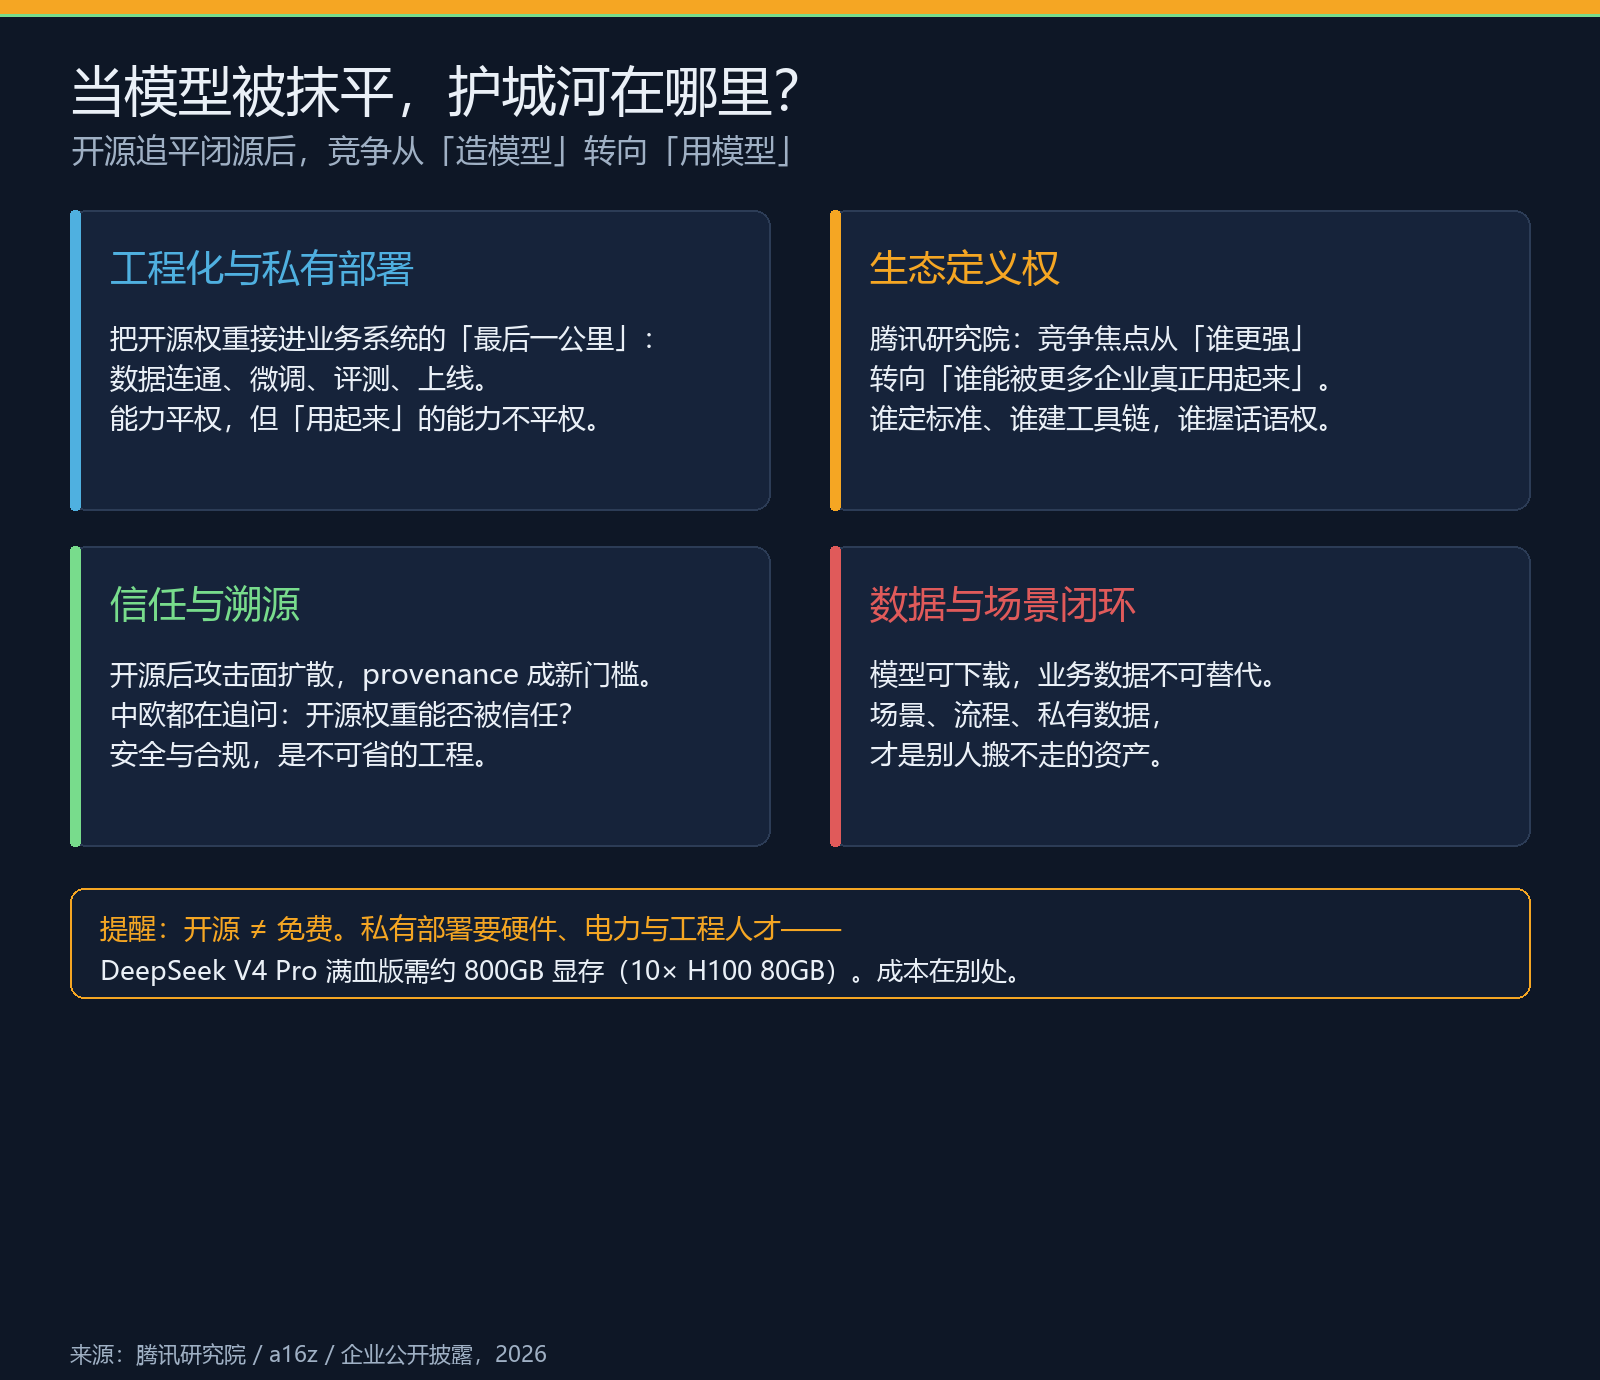
1. 工程化与私有部署。 开源权重再便宜,是"装上能跑";接进业务系统,是另一回事。哪家企业能让 GLM-5.1 跑在自己的数据上、符合自己的精度、稳定支撑自己的峰值流量、同时遵守自己的合规要求,谁就有了第一道护城河。
这是个工程化的护城河——所以我把它的造价放在第一位。这一道,有研发时间和钱可以堆。但堆不出来的人,就在门外站着。
2. 生态定义权。 腾讯研究院近期有一句话很值得抄:“当 DeepSeek V4、Kimi K2.6、Qwen 3.6-Max 三款国产万亿参数模型在四天之内集中开源,行业竞争的焦点正在从『谁更强』转向『谁能被更多企业真正用起来』。”
什么是"被用起来"?不是 API 调一次试试。是你写进了它的 SDK,你接到了它的插件生态,你的企业 SOP 把它的工具调用当作默认动作。
Linux 靠内核 + 包管理器 + 发行版拿下了服务器市场。AI 模型的下一战,是看谁能把"模型 + 评测 + 微调 + 部署 + 治理工具链"做成事实标准。
3. 信任与溯源。 当所有人可以下载 DeepSeek V4 的权重,攻击面也同时被打开。提示注入、权重后门、训练数据中毒、模型蒸馏摘取敏感模式——这些攻击,在开源模型被数十个第三方打包、二次微调之后,会变得前所未有地隐蔽。
2026 年 4 月 28 日,中国国家网信办对剪映、猫箱、即梦 AI 公开查处——理由就是"未有效落实《人工智能生成合成内容标识办法》"。同月,欧盟 AI Act 高危 AI 的合规截止日正在 8 月 2 日锁死。
信任与溯源已经不是次要问题。它是新的入场券。
4. 数据与场景闭环。 这是模型可下载、企业不可下载的部分。
你可以在公网上训练一个非常强的 Qwen 3.5。但你没有这家医院过去十年的诊断数据,没有这家工厂过去五年的故障台账,没有这家律所过去二十年的判例库。模型可以换,唯独数据与场景的纵深,搬不走。
这是为什么我们看到:模型层在激烈竞争、利润在收缩;应用层在安静地把每一处业务、每一份流程、每一段独有的数据,变成越来越不可替代的资产。
四、三个暗礁
平权时代不是田园诗。三种新的风险正在浮现,企业在拥抱开源大模型之前,最好把它们标记在路线图上。
暗礁一:地缘政治依赖。 托管中国开源模型意味着你的请求会经过受中国数据法约束的基础设施;托管美国闭源模型意味着你可能踩到出口管制或训练数据来源规则。一个严肃的问题是:真正能"自己拥有"的,是你能下载下来、跑在你自己的机房里的开源权重。拿在手里是资产,托管出去,是风险。
暗礁二:运营成本失控。 开源不等于低成本。a16z 在 2026 年的企业 Agent 调查中给出一个让人冷静的数字:42% 的组织至少经历过一次 Agent 成本事故——失控的 Agent 几小时烧掉数千美元的 token。如果再叠加自托管的 800GB 显存、几千瓦的机柜功率、专门的推理工程团队——平权的另一面,是"付得起的人才玩得起"。
暗礁三:评估与漂移。 这些模型迭代很快——半年一个主要版本,三月一次微调。你的内部评测线、你的合规检查表、你的安全过滤器,能不能跟上这个速度?如果跟不上,你可能用着一个"看起来很先进"的旧版本上生产。
把这三个暗礁标完,你会发现:今天押注"开源大模型"这件事,已经不是技术选择,而是治理能力的选择。
结尾:那这件事对我们意味着什么
回到那句开始的话。
2026 年的春天,开源大模型用八周时间,完成了"追平闭源"这件事。这不是开源运动的高潮——高潮还要往后很多年。这是潮水的方向,从此确定。
从今往后,企业在大模型这件事上的真正问题,不再是"我该选哪个模型"。而是:
“谁有能耐,把开源模型接进我的业务里,把国产芯片塞进我的机柜里,把合规要求缝进我的治理里,把我的数据变成客户离不开的护城河?”
模型,已经平权。生态,刚刚开始。
行动建议(给企业决策者)
第一,如果你今天还在为闭源 API 的高溢价买单,重新跑一次内部 ROI。能力差距已经收到个位数分,价格差还停在十倍以上。这是一个能被严肃会计支持的动作。
第二,把"私有部署 + 自有微调"放进明年的预算里,不是为了情怀,是为了风险隔离。开源权重的战略价值,是在你不能上托管的时候,你还能上。
第三,预算的真正主战场,从"买模型的钱"挪到"治理的钱"。评测、监控、合规、SLA、应急演练——这些是新的基础设施。
第四,把你的客户数据、内部流程、行业纵深——这些"模型下载不了"的东西——当成公司当下最值钱的资产来经营。模型被开源之后,剩下能竞争的就是这些。
更多推荐


 2
 0
- 0


 已为社区贡献8条内容

所有评论(0)