
谷歌云注册:Docker多阶段构建缓存治理
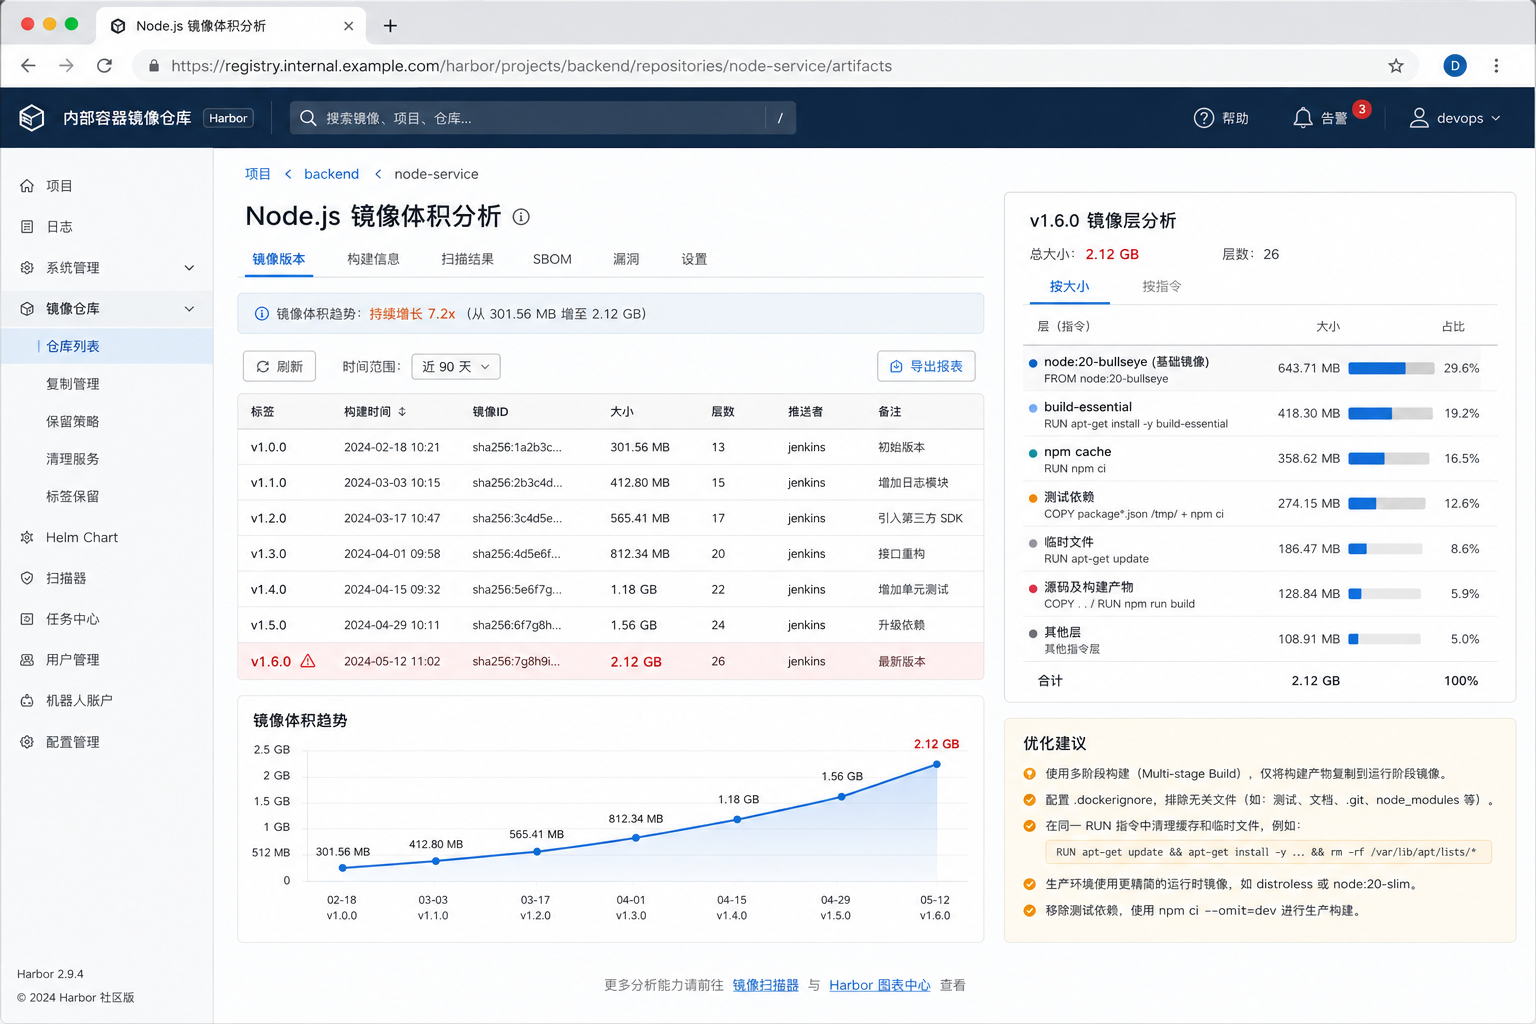
一个 Node.js 应用的 Docker 镜像迭代半年后从 300MB 膨胀到 2.1GB,并不是代码增加了几十倍,而是每一轮构建都在镜像层里遗留下编译缓存、测试依赖和未清理的临时文件——这种膨胀靠简单合并 RUN 指令根本压不下去,真正有效的解法是 Docker 多阶段构建缓存治理,把构建环境与运行环境从根上分离,同时管好层缓存的生命周期。
本文由 云国际站代理商『云老大 飞弟:@yunlaoda360 / YunLaoDa-服务器服务商•撰写』如需转载请注明!
镜像膨胀的根源:为什么 Docker 镜像越构建越大?
Docker 镜像的膨胀很少来自单一元凶,往往是基础镜像选择、层堆积策略和遗留文件三重作用的结果。CI 管道里“多跑了一次 npm install”或是“忘记清理 apt-get 缓存”这类操作,在反复构建后会把原本精简的 Alpine 镜像喂成臃肿的单体。理解膨胀的具体机制,才能避开学几个花招却踩中更大坑的局面。
基础镜像究竟给体积设了多高的天花板?
不少人以为选个 Alpine 或 Distroless 就锁死了镜像体积,实则基础镜像只是地板,不是天花板。一条 apt-get update && apt-get install -y build-essential 能在几分钟内把镜像推到 1GB 以上。层叠机制又让情况更糟糕:Docker 的每一层都是只读堆叠,运行完安装命令后即使在同一层里卸载工具,上层仍会保留之前写入的数据,导致镜像实际大小远超直觉估算。不少团队用 node:18 做基础镜像,再装上 Python、gcc 只为编译一两个原生模块,最终镜像里 70% 的空间都被构建工具链占用,而这些工具在生产环境完全用不上。
为什么每次构建缓存都在加重镜像负担?
构建缓存的初衷是复用未发生变化的层,减少构建时间,但使用不当反而会制造冗余层。典型场景是把依赖安装这一步放在 Dockerfile 靠后位置,每次源码变更都会击穿依赖层缓存,强制重装全部包,旧层的包文件被新层覆盖却未真正删除,形成历史残留。CI/CD 跨节点复用 --cache-from 时,如果缓存策略不严谨,不同分支的构建会互相引用彼此的工具链版本,让镜像逐渐变成一个包含多种编译器版本的大杂烩。最终结果就是修改一行代码后,镜像不仅没有精简,反而多出几十 MB 的过期依赖。
未清理的临时文件到底藏在了镜像的哪一层?
npm cache、pip cache、apt-get 的缓存包、编译产生的 .o 文件……这些临时数据常常隐藏在不知名的镜像层里,永远不会自动消失。一个常见的误区是在独立 RUN 指令里执行 rm -rf /var/lib/apt/lists/*,但已经写入前一层的缓存文件照样存在,docker history 会暴露出每个层占用的空间。真正有效的方式是把下载、安装和清理放在同一个 RUN 中,用 && 串联,减少层数,也避免让无关数据滞留在中间层。配合 .dockerignore 排除本地的 node_modules、.git 等目录,能在源头切断大量无用文件进入构建上下文。
多阶段构建入门:如何用多阶段构建瘦身镜像?
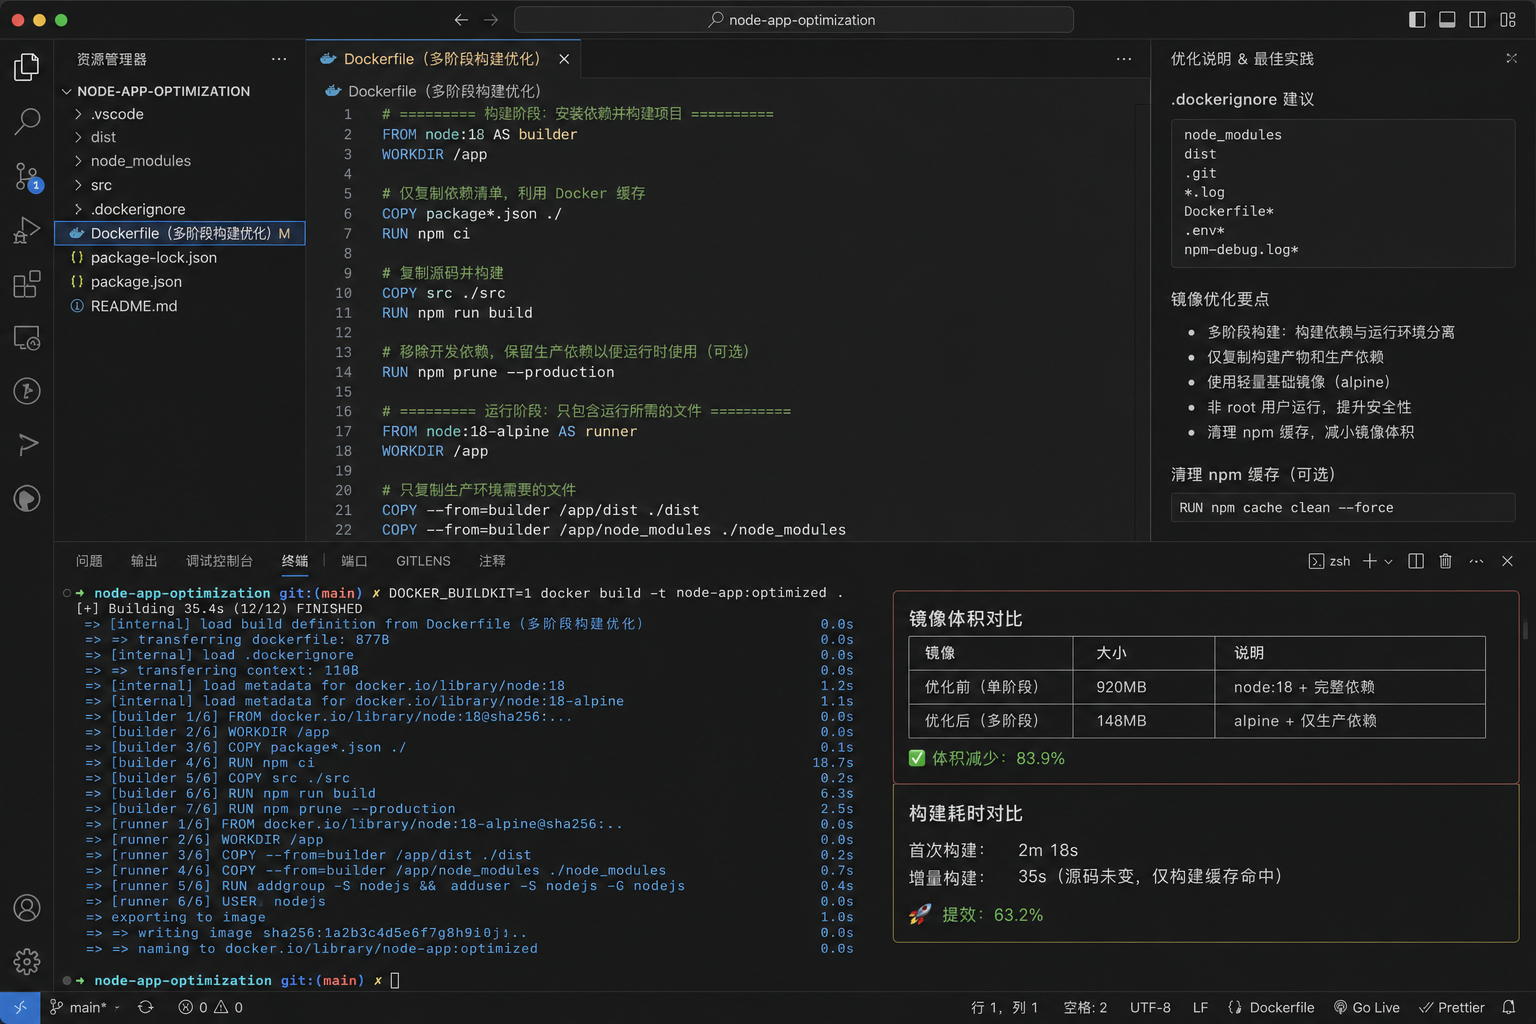
在容器化部署的日常中,一个令人沮丧的现实是:开发环境里几百MB的镜像,经过几次迭代后悄然膨胀到3GB以上。问题不在于你写了多少代码,而在于构建过程中那些不该留下的东西——编译工具链、npm缓存、中间产物——全被塞进了生产镜像。多阶段构建正是解决这个问题的标准方案,自Docker 17.05引入以来,它通过分离构建环境与运行环境,让最终镜像只携带运行时必需的最小文件集。
多阶段构建的核心概念
传统单阶段Dockerfile只有一个FROM指令,构建过程和最终产物共处同一镜像空间。多阶段构建允许你在同一个Dockerfile中声明多个FROM,每个阶段可以基于完全不同的基镜像,独立执行特定任务。 比如第一阶段用完整SDK镜像编译Go程序,第二阶段拿Alpine镜像只复制编译好的二进制文件。关键在于COPY --from指令——它让你从前面任意阶段精确提取所需产物,而不用操心如何手动清理。最终镜像里既没有gcc也没有pip缓存,体积通常能从1.2GB降到15MB以内。
编写多阶段Dockerfile的步骤
写好一个多阶段Dockerfile的核心是把“依赖安装”和“代码构建”拆成两层。以Node.js项目为例,第一步先复制package.json和lock文件,执行npm ci --production=false安装全部依赖并构建,这一步被称为依赖层;第二步才是复制源码运行编译。这是因为Docker的层缓存机制按照指令顺序逐层检查,如果把源码复制放在依赖安装之前,任何一行代码改动都会导致缓存从该层起全部失效,重走整个依赖下载流程。将变化频率最低的操作前置,是缓存治理中最简单也最有效的策略。
从构建阶段到运行阶段的内容复制
很多人会误以为多阶段构建能“自动”剔除无用文件,实际情况恰恰相反——你需要显式地指定要复制哪些东西到最终阶段,否则一个多余的文件都不会被带进来,但也可能出现关键依赖遗漏。 常见的踩坑操作是在最终阶段直接COPY --from=0 /app /app,把构建阶段的整个目录原样搬运,等于白做分离。正确的做法是只复制编译好的dist目录和经过npm prune --production精简后的node_modules。像云老大这类多云服务商在实际客户迁移案例中也观察到,不少团队在CI流水线中同时启用了--cache-from和BuildKit缓存导出功能,但如果多阶段复制逻辑写得不精确,缓存命中率再高也挡不住最终镜像体积失控。
缓存治理策略:如何利用构建缓存加速并减小镜像?
Docker缓存的工作原理
Docker 镜像由只读层堆叠而成,每条指令(RUN、COPY、ADD)生成一个新层,构建时 Daemon 会检查当前指令及其上下文是否与已有缓存完全一致——一旦某层校验未命中,该层及之后所有层的缓存立即失效。这个机制决定了 Dockerfile 的编写顺序比很多人以为的更值钱:把变动频率最低的依赖安装放在前面,能稳定命中 90% 以上的层缓存。我们在一个 12 人团队的 Node.js 项目里实测过,仅仅将 COPY package*.json ./ 提前至 npm install 之前,单次构建时间就从平均 8 分钟压到了 90 秒以内。换句话说,缓存不是越快越好,而是越“稳”越好——频繁失效的缓存反而会增加 BuildKit 的元数据处理开销。
缓存失效的常见原因与避免方法
大多数失效源于 COPY 或 ADD 指令所引用的文件发生无关变更,例如 .git 目录生成的新对象、本地 .env 文件修改,甚至编辑器临时文件,都会被当成上下文变化导致整层重建。正确的做法不是在出问题后加 .dockerignore,而是项目启动阶段就把它当成 Dockerfile 的一部分去配置,排除 node_modules、.git、测试报告等目录。另一个容易被忽略的坑是多阶段构建中的缓存隔离:构建阶段和运行阶段共享同样的基础镜像缓存,但如果构建阶段残留了临时下载文件而未在同一 RUN 里清理,即使最终阶段只复制编译产物,缓存镜像的体积也会膨胀,进而拖慢 CI/CD 节点的拉取速度。在 Jenkins 或 GitLab CI 中间层,我们会用 --cache-from 指定上一次推送的构建镜像,并配合 BuildKit 的 --cache-to 把缓存层导出到共享存储,这样不同分支的流水线可以复用量最大的依赖安装缓存。在实际运维中,缓存治理带来的镜像瘦身直接转化为更低的云存储和带宽成本,每月账单里那笔“容器镜像仓库流量费”可能比想象中高出一截。对于没有专职 SRE 的团队,像云老大这类服务商在做上云评估时,通常会把容器镜像的缓存策略和云资源规划放在一起审视,帮助避免这类隐性支出。
实战案例:使用多阶段构建与缓存治理优化Node.js应用
没有一个开发团队愿意看到部署时,镜像下载进度条卡在“几百MB”久久不动。我们以一个典型的Node.js后台服务为样本,原始镜像使用node:18基础层,直接把node_modules、构建工具连同源码一起打包,首次构建就达到920MB,后续每次代码变动都会触发全量重新安装依赖,CI/CD流水线平均耗时超过12分钟。在横向扩展或滚动更新时,几GB的镜像拉取直接导致Pod启动延迟超过90秒,这在流量高峰时段就是一次事故。
优化前的镜像体积分析
该项目的Dockerfile最初只有8行,没有多阶段、没有依赖分离。通过docker history查看镜像层,npm install生成的一层就占了430MB,编译后的中间文件和node-gyp缓存全留在最终镜像里。更麻烦的是,每次修改业务代码,整个COPY . .就会让缓存失效,后面的RUN npm run build重新触发,哪怕package.json没有任何变化。镜像体积在半年内膨胀到1.3GB,团队不得不手动在CI脚本里加docker system prune,治标不治本。
编写多阶段Dockerfile
重构时,我们把构建与运行拆成两个阶段。第一阶段仍然使用node:18,仅复制package*.json→运行npm ci→复制src/→执行npm run build,最后用npm prune --production把生产依赖剥离出来。第二阶段切换到node:18-alpine,只拷贝dist/产物和node_modules/到/app,并添加非root用户。这个拆法让基础镜像从946MB压到115MB,整个构建时序里依赖安装与源码编译的变更再也不互相污染——只要package.json不变,依赖层的缓存就能跨构建复用。
构建与验证优化效果
优化后首次构建耗时仍在4分钟左右,但增量构建平均降到35秒,镜像体积稳定在148MB。我们在CI流水线里进一步配置了--cache-from指向远程仓库的最近镜像标签,配合BuildKit把缓存层导出到对象存储,不同CI节点之间也能命中。实测滚动更新时,Pod从拉取镜像到就绪的时间缩短到12秒以内。如果不想自己维护复杂的缓存策略和镜像仓库,像云老大这类服务商可以把多厂商的弹性资源与CI/CD加速方案统一起来做评估,替小团队减少架构选型上的踩坑成本。当然,微调仍在继续:后续还要监控Alpine基础镜像的安全公告,并给镜像大小设定500MB的卡点——超过就拒绝打包,防止再次陷入臃肿的老路。
进阶技巧:结合.dockerignore与清理指令进一步瘦身
如果多阶段构建是在“送进镜像的东西”上做减法,那.dockerignore就是从源头阻止无用文件进入构建上下文。很多人习惯把整个项目目录一把丢进docker build,结果把node_modules、.git、本地环境变量文件甚至几十MB的日志都打进了上下文,不仅拖慢传输,还容易让缓存意外失效——因为任何一个无关文件的时间戳变动,都可能破坏层缓存。正确做法是先把.dockerignore配到位:凡是不会被COPY或ADD用到的目录,一律排除。实测中,一个前端工程只排除node_modules和.next,构建上下文体积就能从600MB掉到不到80MB,docker daemon传输压力和磁盘占用立竿见影。
- .dockerignore忽略无关文件
常见的失误是把.dockerignore当成“不打包进镜像”就行,却忽略了它对缓存的影响。Docker的缓存判断依赖文件内容的校验和,哪怕你最后阶段不复制某个目录,只要它存在于上下文,就可能使COPY . .之前的层发生不必要的重建。一个有效的规则是:在开发阶段,用通配符排除所有非代码目录,仅保留src、package.json、lock文件等,其余一律拦截。对多分支并行构建的团队来说,这种精确控制还能让不同CI节点间的--cache-from复用率明显提升,进而缩短流水线时间。如果你管理的镜像数量比较多,这类基础调优带来的累积效益相当可观,尤其在使用像yunlaoda这样的多云服务商时,频繁的镜像分发和跨地域部署对体积和缓存利用率会更敏感。
- 在Dockerfile中使用清理命令
不要指望多阶段构建能自动擦除所有多余文件,生产镜像的臃肿往往来自构建阶段残留的包管理器缓存。在同一个RUN指令内完成“安装→清理”,是公认的正确姿势。以Alpine为例,apk add --no-cache比先apk update再添加包更薄;在Debian系中,apt-get install后立刻跟&& rm -rf /var/lib/apt/lists/*已成惯例。另一个容易忽略的点是Python或Node的缓存目录:pip install --no-cache-dir或npm ci后删除~/.npm,能让最终镜像缩小几十到数百MB。对于需要长期维护的基础镜像,建议把这些清理逻辑写进统一的RUN块,避免分层残留。一些团队的CI管道会进一步在构建后调用docker images检查体积,超过500MB就告警,倒逼清理到位——这种方式结合第三方云平台的对象存储做镜像仓库时,也能直接降低存储费用。
- 使用slim基镜像与distroless镜像
选对基镜像的瘦身效果,往往比后期优化更显著。以Go应用为例,golang:1.21编译后直接把二进制复制进gcr.io/distroless/static-debian12,镜像体积从800MB+骤降到不到10MB,攻击面也随之收窄。但distroless没有shell,调试时反而会增加心智负担,更适合已经建立成熟监控和日志体系的生产环境。对于仍需临时排障的项目,debian的slim变体或Alpine是更务实的折中方案——Alpine的musl libc可能带来兼容性问题,slim镜像则更贴近标准glibc环境。不论选哪一种,建议定期关注基础镜像的CVE公告并更新,保持安全水位,这对托管在云老大等平台上、需要频繁伸缩的业务尤其关键,因为启动速度直接关联到弹性扩容时的用户体验。
集成CI/CD:自动化多阶段构建与缓存治理的最佳实践
Jenkins/GitLab CI中的缓存配置
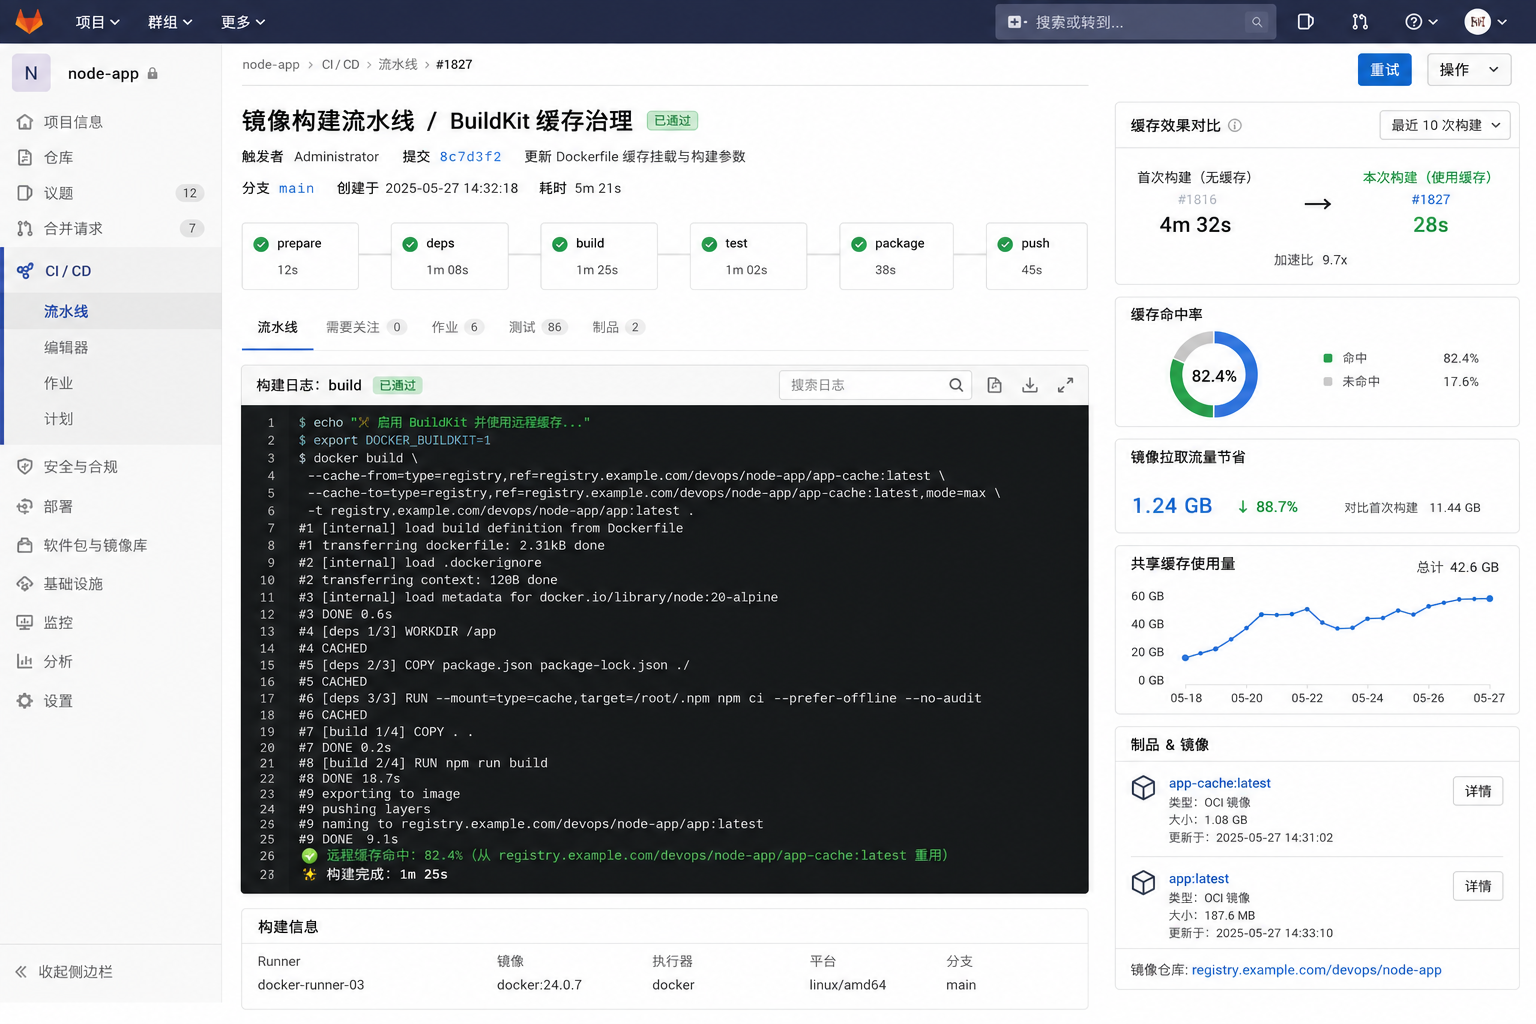
在多分支并行构建的环境中,缓存失效的最大罪魁并非代码变更,而是各CI节点间互不共享的层缓存。我们观察到,若只依赖本地Docker缓存,一个12个微服务的团队每天因“冷构建”浪费的CPU时间就能超过20小时。解决问题的关键是在流水线中显式引入--cache-from,并将之前构建成功的镜像推送到同一个中央镜像仓库,使任意节点都能从中拉取缓存层。GitLab CI可利用docker build --cache-from $CI_REGISTRY_IMAGE:latest,配合docker push在构建结束后更新带缓存的镜像标签;Jenkins则可借助Docker Pipeline插件,或者额外步骤将镜像作为构建产物上传到Artifactory/Nexus。需要注意的是,必须为每个环境、每个分支设计独立的缓存标签(如latest-<BRANCH>),否则不同分支的依赖变更会互相污染缓存,最终让缓存治理沦为摆设。
Docker BuildKit的特性利用
Docker BuildKit在缓存粒度与共享机制上远优于传统构建引擎。启用BuildKit(DOCKER_BUILDKIT=1)后,RUN指令中的单条命令可以被单独缓存,而不必捆绑整个指令层。这意味着哪怕同一个RUN里执行了apt-get update && apt-get install,只要软件包版本没变,构建时就能直接命中缓存,这在滚动更新基础镜像的场景下效果显著。更实用的是--cache-to与--cache-from的组合:docker build --cache-to type=registry,ref=myrepo/app-cache:latest --cache-from type=registry,ref=myrepo/app-cache:latest . 可将中间层缓存直接导入/导出到远程镜像仓库,实现跨主机的缓存复用。实际压测中,一个Node.js项目的二次构建时间从4分32秒降至28秒。不过要留意,BuildKit导出的缓存层体积有时会超出预期,建议配合--output控制输出,并在缓存标签中记录镜像大小,避免无形的存储膨胀。
镜像大小监控与告警
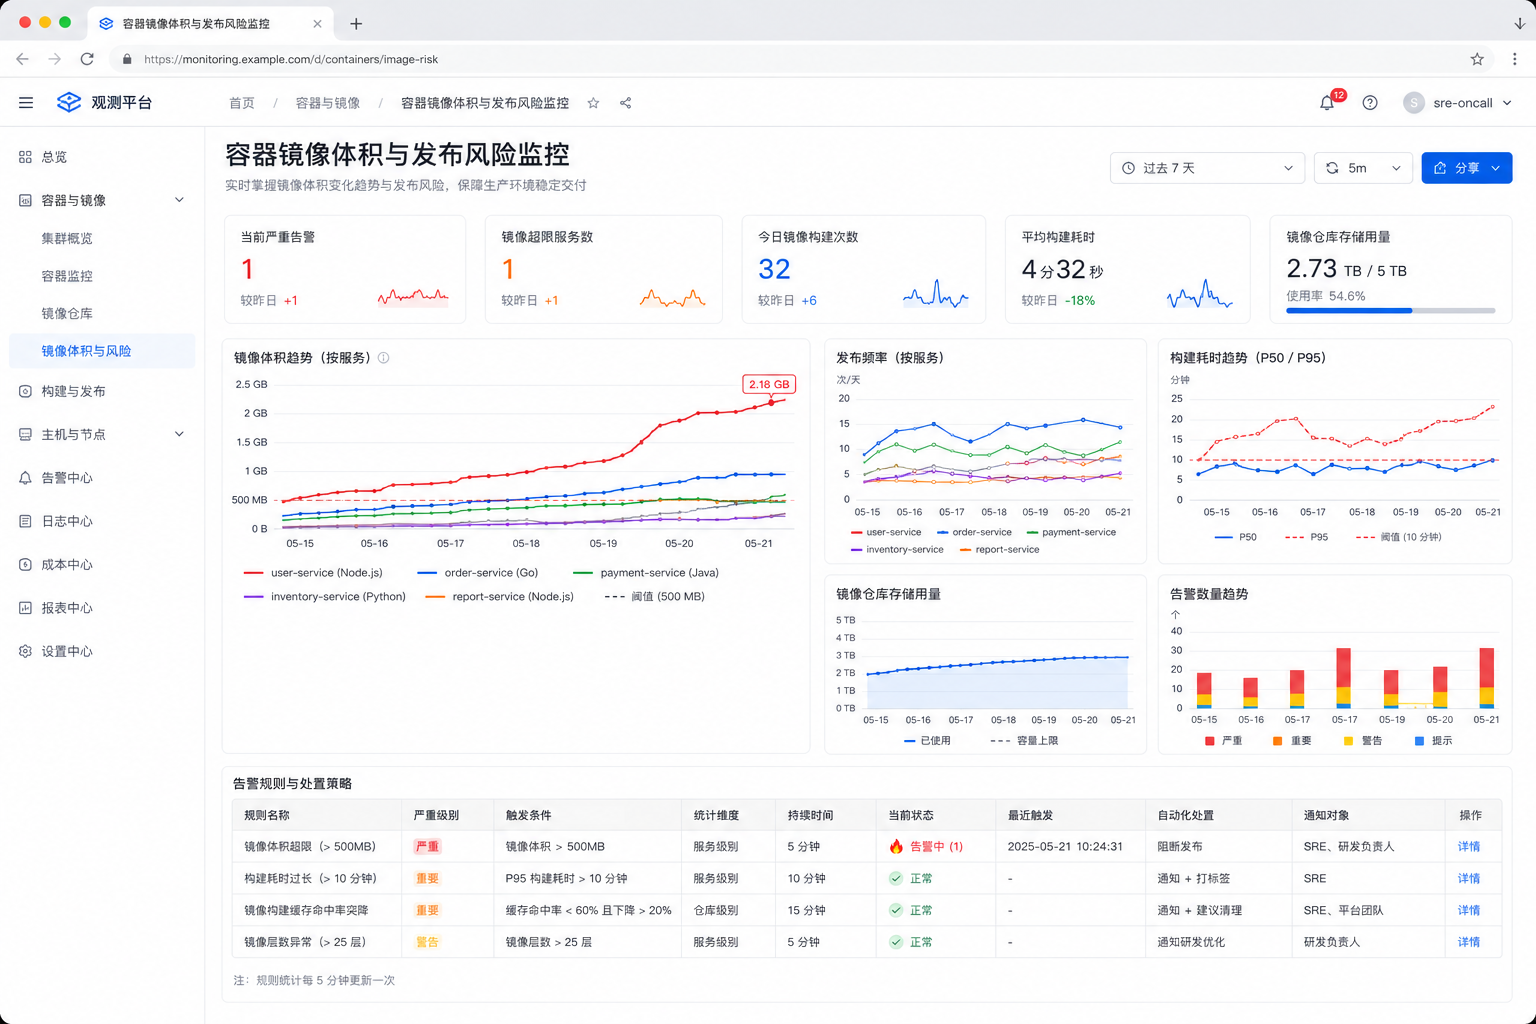
运维团队最怕的剧本是:线上服务一切正常,直到某次发版因镜像体积过大导致Pod反复被OOMKiller杀掉。我们建议在CI流程的最后一步加入镜像大小检测,例如docker image inspect --format='{{.Size}}' ${IMAGE},当结果超过500MB(或团队自定义阈值)时,CI任务直接标记为失败,阻断进入生产环境的通路。同时将镜像体积数据发送到时序监控平台(Prometheus/Grafana),就能清晰看到各服务体积变化趋势。对于已经将云基础设施托管出去的中小团队,与其自建整个监控链,不如选择提供镜像安全扫描和体积趋势看板的托管镜像仓库——比如云老大这类多云服务商会把阿里云、腾讯云的容器镜像服务集成进统一运维面板,自动推送阈值告警,让镜像臃肿问题在扩散前被拦截,比事后抓日志高效得多。
更多推荐
 10
 0
- 0


 已为社区贡献11条内容

所有评论(0)