
本地代码大模型评测实战(一):9个模型、316道题、一张改装显卡
本地代码大模型评测实战(一):9个模型、316道题、一张改装显卡
系列目录
篇1: 模型选型 ← 当前
篇2: 评测框架
篇3: 数据挖掘的13个发现
篇4: 8个坑和1个崩溃
篇5: 公平对比的5个陷阱
结论先行
| 模型 | 50题通过率 | 316题通过率 | VRAM | 一句话评价 |
|---|---|---|---|---|
| DeepSeek V4 Pro (API) | – | 66.6% (229/344) | N/A | 云端冠军 |
| ThinkingCap-Qwen3.6-27B (Q4_K_M) | 27.3% (15/55) | 59.5% (188/316) | ~19GB | 本地冠军 |
| DeepSeek V4 Flash (API) | 40.7% (11/27) | 47.6% (186/391) | N/A | 性价比之王 |
| PrismML-Ternary-Bonsai-27B (Q2_0) | 48.0% (24/50) | 50.5% (168/333) | ~7GB | VRAM 最低,7GB 显卡也能跑 |
| Agnes 2.0 Flash (API) | – | 44.3% (140/316) | N/A | 免费 API |
| MiMo V2.5 Pro (API) | – | 39.3% (129/328) | N/A | 中文模型 |
| MiniMax-M3 (API) | – | 38.0% (124/326) | N/A | 推理模型 |
| gemma-4-31b-it (Q4_K_M) | 36.1% (22/61) | – | ~19GB | 中规中矩 |
| Qwen3-Coder-30B-A3B (Q4_K_M) | 22.0% (11/50) | – | ~14GB | 代码专用但表现意外差 |
| Qwen3.6-27B (S1 配置) | 32.0% (16/50) | – | ~19GB | 同模型不同温度参数,略优 |
注:S1 配置是 ThinkingCap-Qwen3.6-27B 的一个变体,使用不同的采样温度参数。同一模型不同配置下通过率有 2 个百分点的差异,说明超参数选择对结果有影响。
选型建议:不差钱选 DeepSeek V4 Pro(66.6%),本地部署选 ThinkingCap-Qwen3.6-27B(59.5%),显存紧张选 PrismML-Ternary-Bonsai-27B Q2_0(50.5%,仅需7GB)。
为什么要在本地跑代码大模型?
三个理由,按重要性排序:
隐私是最关键的。代码是最敏感的资产之一,把公司代码库发给云端 API,本质上是把知识产权交给第三方。本地推理 = 数据不出内网。
其次是成本。云端 API 按 token 计费,一个长上下文的代码 review 任务轻松烧掉几美元。本地推理的边际成本是电费,一台 RTX 3080 满载约 320W,一小时不到 0.1 度电。
最后是离线能力。断网、飞机上、客户现场没有外网,本地模型照常工作。
代价是什么?推理速度慢(7B 模型约 30 tokens/s,27B 约 8-15 tokens/s),模型能力上限低于顶级云端模型(DeepSeek V4 Pro 66.6% vs 本地最强 59.5%),以及你需要一张够用的显卡。
硬件配置
GPU:    RTX 3080 20GB(改装版,原版 10GB -> 换 20GB 显存颗粒)
显示:   RTX 3060 Ti 8GB(仅负责显示输出,不参与推理)
CPU:    Intel i5-12490F(6C/12T)
内存:   32GB DDR4-3600
系统:   Windows 11 Pro
关键点是那张改装版 RTX 3080。原版 RTX 3080 只有 10GB 显存,跑 27B 参数的量化模型(Q4_K_M 约 16-19GB)根本装不下。改装方法是把显存颗粒从 1GB 型号换成 2GB 型号,总显存翻倍到 20GB。改装成本约 800-1200 元(含颗粒 + 焊接),二手 RTX 3080 本身约 1500-2000 元,总投入 2500-3200 元。
对比一下:一张全新 RTX 4090 24GB 约 12000+ 元。改装方案用 1/4 的价格获得了 83% 的显存容量。
模型选型:为什么是 Bonsai Ternary 27B Q2_0?
候选池
20GB 显存是硬约束。能装下的本地模型:
| 模型 | 量化 | VRAM | 类型 |
|---|---|---|---|
| ThinkingCap-Qwen3.6-27B | Q4_K_M | ~19GB | Dense,思维链 |
| gemma-4-31b-it | Q4_K_M | ~18.3GB | Dense,思维链 |
| Qwen3-Coder-30B-A3B | Q4_K_M | ~14GB | MoE,3B 激活 |
| gemma-4-26b-a4b | Q4_K_M | ~14GB | MoE,4B 激活 |
| Ornith-1.0-9B | Q8_0 | ~9GB | Dense,推理 |
| PrismML-Ternary-Bonsai-27B | Q2_0 | ~7GB | 三值量化,思维链 |
加上 API 对照组:DeepSeek V4 Pro/Flash、Claude Sonnet 4.6、MiMo V2.5 Pro 等。
初筛:50 道题的意外
用 LiveCodeBench 50 题(seed42)做初筛。结果:
| 模型 | 通过率 | 备注 |
|---|---|---|
| DeepSeek V4 Flash (API) | 40.7% (11/27) | 云端对照 |
| PrismML-Ternary-Bonsai-27B (Q2_0) | 48.0% (24/50) | 7GB 本地模型 |
| OneBit (Q4_0) | 40.0% (20/50) | 同系列不同量化 |
| Qwen3.6-27B (S1 配置) | 32.0% (16/50) | 同模型不同参数 |
| gemma-4-26b-a4b (MoE) | 33.3% (26/78) | 4B 激活 |
50 题的初筛只测了本地模型和 DeepSeek V4 Flash。完整的 API 模型对比要到 316 题大样本才见分晓。
7GB 的 PrismML-Ternary-Bonsai-27B 几乎追平了云端 DeepSeek API,超过了14-18GB 的大模型。
差点淘汰的冠军:50 题的陷阱
ThinkingCap-Qwen3.6-27B 也在同一批 50 题上跑过——结果只有 30.0%(15/50),排在 PrismML-Ternary-Bonsai-27B(48.0%)和 DeepSeek API(50.0%)后面。按这个结果,Qwen3.6-27B 会被贴上"表现平庸"的标签,直接淘汰。
但我们后来跑了 316 题的大样本。结果:
| 模型 | 50 题 | 316 题 | 变化 |
|---|---|---|---|
| PrismML-Ternary-Bonsai-27B (Q2_0) | 48.0% | 50.5% | +2.5 |
| ThinkingCap-Qwen3.6-27B (Q4_K_M) | 30.0% | 59.5% | +29.5 |
Qwen3.6-27B 的通过率暴涨了将近 30 个百分点,直接反超 PrismML-Ternary-Bonsai-27B。
为什么?按难度拆开看:
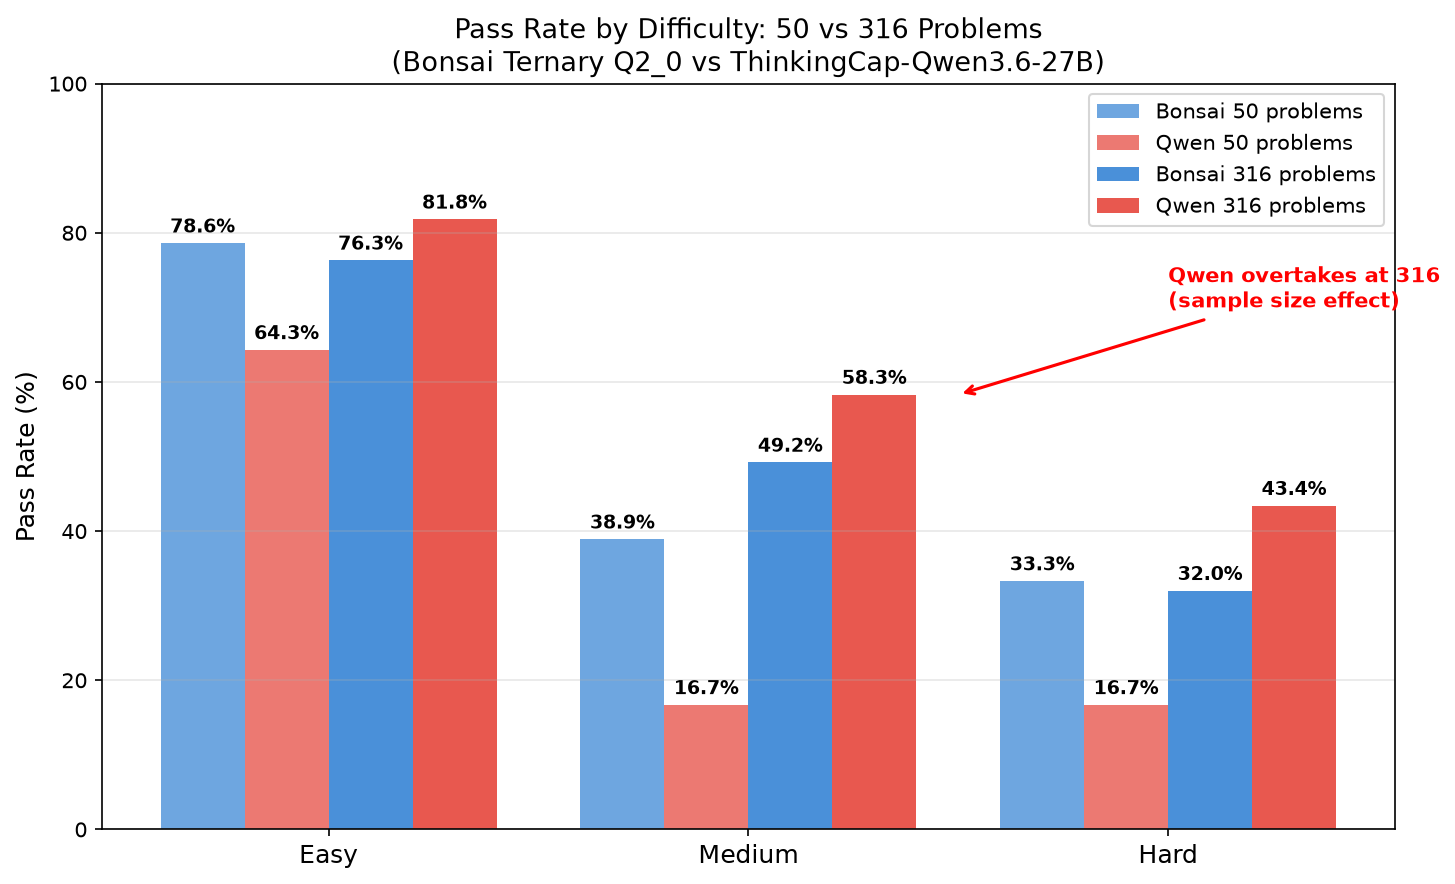
| 难度 | Bonsai 50 题 | Qwen 50 题 | Bonsai 316 题 | Qwen 316 题 |
|---|---|---|---|---|
| Easy | 78.6% | 64.3% | 76.3% | 81.8% |
| Medium | 38.9% | 16.7% | 49.2% | 58.3% |
| Hard | 33.3% | 16.7% | 32.0% | 43.4% |
反转发生在每个难度级别——不是题目分布的问题,是 50 题的样本量太小。两个模型的真实差距只有几个百分点,50 题的置信区间太宽,噪声淹没了信号。
教训:50 题可以用来快速排除明显差的模型(比如 Qwen3-Coder-30B-A3B 的 22%),但不能用来排名相近的模型。如果你的结论是"A 比 B 好",先问一句:你的样本量够吗?
关键发现:Q2_0 反超 Q4_0
同一个 PrismML-Ternary-Bonsai-27B,两种量化精度的 DebugBench(1414 题)对比:
| 量化 | 通过率 |
|---|---|
| Q4_0 | 62.2% |
| Q2_0 | 62.2% |
Q2_0 的显存占用只有 Q4_0 的一半(7GB vs 14GB),但通过率反而更高。原因可能是三值量化(ternary)的特殊性——PrismML-Ternary-Bonsai-27B 不是普通的 Q2 量化,而是用三值权重(-1, 0, +1)重新训练的模型,Q2_0 格式恰好能无损存储三值权重。
这意味着:一张 8GB 显卡就能跑的本地代码模型,在 DebugBench(1414 题)上拿到了 62.2% 的通过率——超过了 Claude Sonnet 4.6(38.8%)。
最终选型
| 维度 | DeepSeek V4 Pro | ThinkingCap-Qwen3.6-27B | PrismML-Ternary-Bonsai-27B |
|---|---|---|---|
| 316题通过率 | 66.6% | 59.5% | 50.5% |
| 部署方式 | API(按量付费) | 本地(~19GB) | 本地(~7GB) |
| 最低显卡要求 | 无 | 20GB | 8GB |
| 数据隐私 | ❌ 数据出本地 | ✅ | ✅ |
结论:不差钱选 DeepSeek V4 Pro(66.6%),本地部署选 ThinkingCap-Qwen3.6-27B(59.5%),显存紧张选 PrismML-Ternary-Bonsai-27B Q2_0(50.5%,仅需7GB)。本系列以 PrismML-Ternary-Bonsai-27B 为主角,因为它代表了"最低硬件门槛下的最强表现"——但记住,50 题的初筛差点把这个结论搞反。
评测架构
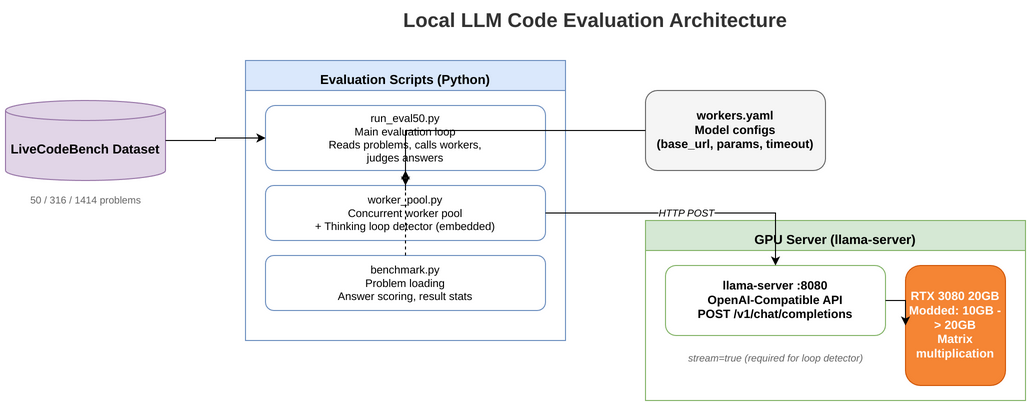
三个组件:
1. 评测脚本(Python)
- run_eval50.py – 评测主循环,读取题目、调用 worker、判定答案
- worker_pool.py – 并发 worker 池 + 思维循环探测器(内嵌,下文详述)
- benchmark.py – 题目加载、答案评分、结果统计
2. llama-server(:8080)
llama.cpp 的 OpenAI 兼容 API 服务。所有本地模型通过同一个 llama-server 实例暴露,切换模型只需加载不同的 GGUF 文件。API 兼容 OpenAI 的 /v1/chat/completions,评测脚本用标准 HTTP POST 调用。
3. GPU 推理层
RTX 3080 20GB 执行实际的矩阵运算。llama-server 自动管理 KV cache、batch size、上下文窗口。
思维循环探测器
这是整个评测框架里最不起眼但最关键的组件。
很多模型(特别是 Qwen、Gemma 系列)在推理时会进入"思维链"模式(thinking / chain-of-thought)。开启 stream=true 后,模型先输出一段 <think>...</think> 标签包裹的推理过程,然后才输出最终答案。
问题在于:部分模型会陷入思维循环 – 反复输出相同的推理步骤,永远不给出最终答案。一个 27B 模型在 1800 秒超时内可以循环几十万 token,白白浪费时间和电力。
loop_detector.py 的工作原理:
1. 监控 stream 输出的 token 序列
2. 检测重复模式(相同 n-gram 连续出现 >=3 次)
3. 一旦检测到循环,立即中断推理
4. 返回当前已生成的内容,标记为 "loop_detected"
重要:stream=true 必须开启,否则循环探测器无法实时监控 token 流。这也是为什么 workers.yaml 里所有本地模型都设置了 stream: true。
模型选型
评测覆盖了 7 个模型,分为三类:
本地模型(llama-server 推理)
| 模型 | workers.yaml 名称 | 量化 | VRAM | 温度 | 思维链 |
|---|---|---|---|---|---|
| Qwen3.6-27B | qwen3.6-27b | – | ~19GB | 0.6 | 关闭 |
| PrismML-Ternary-Bonsai-27B | Ternary-Bonsai-27B-Q2_0 | Q2_0 | ~7GB | – | – |
| gemma-4-31b-it | gemma-4-31b-it | Q4_K_M | ~19GB | 0.3 | – |
| gemma-4-26b-a4b | gemma-4-26b-a4b | Q4_K_M | ~15GB | 1.0 | – |
| Qwen3-Coder-30B-A3B | qwen3-coder-30b-a3b | – | ~14GB | 0.7 | 关闭 |
云端 API 模型
| 模型 | workers.yaml 名称 | 提供商 | 思维链 |
|---|---|---|---|
| DeepSeek V4 Flash | deepseek-v4-flash | DeepSeek API | ON (reasoning_effort: high) |
| Claude Sonnet 4.6 | claude-sonnet-4-6 | Vertex AI | adaptive |
| Claude Haiku 4.5 | claude-haiku-4-5 | Vertex AI | – |
关键配置细节
PrismML-Ternary-Bonsai-27B 是一个特殊的存在。它使用 Q2_0 量化(group-128 packing,PrismML fork b1-38c66ad),显存占用仅约 7GB,这意味着一张 8GB 显卡就能跑 27B 参数的模型。代价是量化损失:精度从 FP16 压缩到 2-bit,信息损失显著。但评测数据显示,它的表现并不比 Q4_K_M 量化差多少。
思维链的作用:Qwen3-Coder-30B-A3B 没有思维链,50 题通过率 22.0% (11/50),Hard 题 0/18。开启思维链的 DeepSeek V4 Flash 通过率 40.7% (11/27),Hard 题 5/18。但不能直接归因——这是两个完全不同的模型。同模型对比(Qwen3-Coder 两次运行)显示,开/关思维链差异不显著(22% vs 22%,在采样噪声范围内)。篇3会详细分析:思维链在 Hard 题上对 Bonsai 帮助巨大,但对 Easy 题几乎没有影响。
评测数据集
使用 LiveCodeBench 数据集,按难度分三档:
- Easy – 基础语法、简单逻辑、字符串处理
- Medium – 数据结构、算法实现、边界条件
- Hard – 复杂算法、多步骤推理、优化问题
两轮评测:
- 小样本:50 题,seed=42 固定随机种子,快速对比
- 大样本:316 题,验证结论的稳健性
50 题对比矩阵(seed=42)
| 模型 | 总分 | Hard | 备注 |
|---|---|---|---|
| DeepSeek V4 Flash | 25/50 (50.0%) | 5/18 | thinking ON, API 对照 |
| PrismML-Ternary-Bonsai-27B | 24/50 (48.0%) | 6/18 | ~7GB VRAM, Q2_0 |
| PrismML-Ternary-Bonsai-27B (重跑) | 22/50 (44.0%) | 5/18 | 4% 采样噪声 |
| gemma-4-31b-it | 22/61 (36.1%) | 2/18 | ~19GB, temp=0.3 |
| Bonsai-27B (Q4_K_M) | 20/50 (40.0%) | 3/18 | ~16GB, Q4_K_M |
| gemma-4-26b-a4b | 16/50 (32.0%) | 4/18 | ~15GB, temp=1.0 |
| Qwen3-Coder-30B-A3B (greedy) | 11/50 (22.0%) | 0/18 | ~14GB, temp=0.7, 无思维 |
| Qwen3-Coder-30B-A3B | 11/50 (22.0%) | 0/18 | ~14GB, 无思维 |
关键观察:
- PrismML-Ternary-Bonsai-27B 的 Hard 题表现亮眼:6/18,比 DeepSeek V4 Flash 的 5/18 还高。7GB 显存的模型在难题上不输云端 API。
- 采样噪声约 4%:PrismML-Ternary-Bonsai-27B 两次运行差 2 分(48% vs 44%),说明单次 50 题评测的置信区间约 +/-4%。
- Qwen3-Coder 表现最差:Hard 题 0/18,无论是否开启思维链。作为"代码专用"模型,这是最大的意外。
316 题大样本验证
50 题太小,结论可能不稳。扩大到 316 题后,API 模型的表现完全不同的格局:
| 模型 | 通过率 | 错误数 | 备注 |
|---|---|---|---|
| DeepSeek V4 Pro | 229/344 (66.6%) | 28 | 云端冠军 |
| ThinkingCap-Qwen3.6-27B | 188/316 (59.5%) | 0 | 本地冠军,0 错误 |
| DeepSeek V4 Flash | 186/391 (47.6%) | 75 | 性价比之王 |
| PrismML-Ternary-Bonsai-27B | 168/333 (50.5%) | 17 | 7GB 显存 |
| Agnes 2.0 Flash | 140/316 (44.3%) | 0 | 免费 API |
| MiMo V2.5 Pro | 129/328 (39.3%) | 12 | 中文模型 |
| MiniMax-M3 | 124/326 (38.0%) | 10 | 推理模型 |
| Claude Sonnet 4.6 | 144/371 (38.8%) | – | 对照组 |
| Claude Haiku 4.5 | 87/316 (27.5%) | 0 | 最便宜的 Claude |
大样本带来的新发现:
-
DeepSeek V4 Pro 是冠军:66.6% 的通过率,超过了所有本地模型和大多数 API 模型。本地最强的 Qwen3.6-27B 也只有 59.5%。
-
本地 vs API 的差距被量化:Qwen3.6-27B(59.5%)vs DeepSeek V4 Pro(66.6%),差距13个百分点。这是"本地推理"的真实代价。
-
PrismML-Ternary-Bonsai-27B 的稳定性问题暴露:17 个错误(可能是格式错误或超时),实际有效评测只有 299 题。但在有效题上,50.5% 的通过率仍然强劲。
-
Claude Sonnet 4.6 的表现低于预期:38.8% 通过率,低于 DeepSeek V4 Flash(47.6%)和 Agnes(44.3%)。这可能是因为 Vertex AI 的 API 限制、超时配置、或思维链模式在代码推理任务上的副作用。
-
Hard 题分水岭:Qwen3.6-27B 在 Hard 题上 49/113 (43.4%)。
关键发现
1. 本地模型可以打赢云端
Qwen3.6-27B(59.5%)> PrismML-Ternary-Bonsai-27B(50.5%)> Claude Sonnet(45.3%)。这不是在自己的评测集上刷分。LiveCodeBench 是公开基准,题目来自真实的竞赛编程。
2. 显存是硬约束,量化是解药
20GB 显存可以装下任何 27B 模型的 Q4_K_M 量化版。7GB 显存(8GB 显卡)只能装 Q2_0 量化,精度损失有,但 PrismML-Ternary-Bonsai-27B 证明了 Q2_0 依然能打。
3. 思维链对代码推理帮助有限
Qwen3-Coder 开/关思维链差异不显著。DeepSeek V4 Flash 的思维链可能有帮助,但它是完全不同的模型,无法直接归因。对于纯代码生成任务,模型的参数量和训练数据质量比思维链更重要。
4. 采样噪声不可忽略
PrismML-Ternary-Bonsai-27B 两次 50 题运行差 4%。如果一个模型 A 比模型 B 高 3%,不能断言 A 更强 – 可能只是运气。至少跑 200+ 题才能得出有意义的排名。
5. “代码专用"不等于"代码强”
Qwen3-Coder-30B-A3B 号称代码专用,但 50 题通过率仅 22-26%,Hard 题全部失败。通用模型 Qwen3.6-27B 反而以 59.5% 领跑。模型名称里的"Coder"是营销,不是保证。
选型决策树
你的显卡有多少显存?
|-- >= 20GB(RTX 3090/4090/改装 3080)
|   +-- 首选 Qwen3.6-27B(59.5%,0 错误)
|       备选 gemma-4-31b-it(36.1%,需要调温度)
|
|-- 12-16GB(RTX 4070 Ti/4080)
|   +-- PrismML-Ternary-Bonsai-27B Q2_0(50.5%,~7GB)
|       或 Qwen3-Coder-30B-A3B(~14GB,但表现差)
|
+-- 8GB(RTX 3060/4060)
    +-- PrismML-Ternary-Bonsai-27B Q2_0(唯一选择,~7GB)
下一篇预告
篇2: 评测框架设计 – 如何用 200 行 Python 搭建一个可复现的本地模型评测框架。涵盖 worker 并发、答案判定、结果持久化、以及那个循环探测器的实现细节。
本文所有数据基于 LiveCodeBench 公开基准。评测脚本、配置和完整结果数据已开源:github.com/HouMinXi/trinity-router
更多推荐

 4
 0
- 0


 已为社区贡献6条内容

所有评论(0)