
本地代码大模型评测实战(三):测试数据告诉我的13件事
本地代码大模型评测实战(三):测试数据告诉我的13件事
系列目录
篇1: 模型选型
篇2: 评测框架
篇3: 数据挖掘的13个发现 ← 当前
篇4: 8个坑和1个崩溃
篇5: 公平对比的5个陷阱发布后将链接替换为实际 URL
你以为跑完评测,看看通过率就完事了?数据里藏着13件事,每一件都比通过率本身更有意思。
这篇是系列第三篇。前两篇讲了怎么搭评测环境、怎么选基准。这篇换个角度——不聊方法论,聊数据。我跑了 DebugBench 和 LCB(LiveCodeBench)两个基准,覆盖了 Bonsai、DeepSeek、Gemma4、Qwen3-Coder、ThinkingCap、Sonnet 等模型,攒了上万条测试记录。把这些数据翻来覆去看了几遍,发现了13个有意思的模式。
每个故事的结构:数据 → 模式 → 解读。
第一组:时间的故事
1. 失败的比成功的更费时间
这可能是最反直觉的发现。
DebugBench 上,通过的题中位耗时 87 秒,没通过的中位 142 秒——慢了 62%。LCB 的 50 道题更夸张:通过的中位 539 秒,没通过的中位 760 秒,慢了 41%。
Hard 题的差距最大:通过的 138 秒,没通过的 198 秒,多出整整 60 秒。
DebugBench:  passed 87s  vs failed 142s  (+62%)
LCB 50题:    passed 539s vs failed 760s  (+41%)
Hard题:      passed 138s vs failed 198s  (+60s)
解读:模型在不会做的题上会"死磕"。 它不会早早放弃,而是反复尝试,输出更多推理、更多代码、更多修正,直到超时或被迫停止。这对实际部署意味着什么?失败请求不仅结果差,还占用了更多算力。如果你在做推理服务的容量规划,失败请求的成本不能按和成功请求等价来算。
2. 输出越长越可能错
DebugBench 的数据显示,通过的题代码长度中位 421 字符,没通过的中位 759 字符——长了 69%。
passed code_len 中位: 421 字符
failed code_len 中位: 759 字符  (+69%)
解读:模型不确定的时候倾向于写更多代码。 这和人类程序员的行为相反——老手写得少是因为知道该写什么,新手写得多是因为在摸索。模型也一样:它对题目有把握的时候,输出简洁精准;没把握的时候,就会写一堆"以防万一"的代码,结果反而引入更多 bug。
这个指标可以作为置信度的代理信号:如果模型输出明显偏长,大概率它没想清楚。
3. 思维推理长度和通过率负相关
这个发现和上一条是同一个故事的两面。
通过的题平均推理长度 12,358 字符,失败的题平均 17,625 字符——失败的推理长度是通过的 1.43 倍。
passed 平均推理长度: 12,358 字符
failed 平均推理长度: 17,625 字符  (1.43x)
解读:失败的题推理更长,因为模型在死磕。 它不是不想答对,是答不对还在硬撑。这和第1条的时间数据互相印证:更长的推理时间、更长的输出文本,都指向同一个行为模式——模型在不擅长的题上会过度投入。
从工程角度看,设置推理长度上限不仅是成本控制,也是质量信号。推理特别长的请求,很可能本身就答不对。
4. 最快 pass 只要 17 秒
LCB 的 nim-game 题,17 秒就 pass 了,输出只有 82 个字符。最慢的 pass 花了 1618 秒——差了将近 100 倍。
最快: nim-game  17秒  (82字符)
最慢: 某道Hard  1618秒
差距: ~100x
解读:秒答来自训练数据记忆,不是推理。 Nim Game 是经典的博弈论题目,在各种编程教材、LeetCode 讨论区、竞赛题解里出现过无数次。模型大概率在训练数据里见过几乎一模一样的题目,所以不需要推理,直接"背"出答案。
这对评测设计有启示:如果你的基准题在网上大量存在,模型的高通过率可能只是在展示记忆力,不是推理能力。LCB 用的是 2023-2025 年的新题,但经典的题目类型还是会"泄漏"。
第二组:模型的死法
5. 思维循环不是均匀分布的
LCB 316 道题中,Easy 题出现思维循环的比例是 14.8%,Medium 也是 14.8%,Hard 是 12.4%。看起来差不多?看通过率:
Easy  循环后通过率: 77.0%
Medium循环后通过率: 未标注(介于两者之间)
Hard  循环后通过率: 28.6%
解读:Hard 题循环了基本就废了。 Easy 题出现循环不要紧,模型绕几圈还是能绕出来。Hard 题一旦进入循环,说明模型在某个推理步骤上卡住了,反复尝试同一个思路但走不通——这时候它几乎不可能自己跳出来。
什么叫"思维循环"?就是模型在推理过程中重复输出类似的推理步骤,像是在一个圈子里打转。比如反复尝试同一种解法、反复验证同一个边界条件、反复写又反复删。检测方法很简单:把推理文本按段落切分,计算相邻段落的编辑距离,如果连续多段的相似度超过阈值,就判定为循环。
6. 多重错误是主要挑战
DebugBench 按错误类型统计通过率:
syntax 错误:    79.3% 通过
logic 错误:     79.3% 通过
reference 错误: 73.9% 通过
multiple 错误:  66.5% 通过
单个语法错误、逻辑错误、引用错误,模型都能修,通过率在 74%-79%。但一旦多个 bug 叠加,通过率直接掉到 66.5%。
解读:单个 bug 模型能修,多个 bug 叠加就难了。 这和人类 Debug 的经验一致——一个 bug 的时候,定位和修复都比较直接;多个 bug 相互交织的时候,修一个可能引入另一个,需要更强的全局理解能力。
这说明评测基准如果只测单 bug 场景,会高估模型的实际 Debug 能力。真实的代码库里,一个提交引入多个 bug 是常态。
7. 多重错误题 76% 死于缺 import
在 DebugBench 的 207 道失败题中,158 道(76%)的错误类型是 missing_import 或 undefined reference。
207 道失败题:
  158 道 (76%) → missing_import / undefined
  49 道  (24%) → 其他错误类型
解读:模型的主要短板不是推理能力,是细节遗漏。 它能把复杂的逻辑修对,但忘了加一行 import numpy as np。这看起来是个小问题,但在实际使用中很致命——缺 import 的代码直接跑不起来,用户必须自己补上。
这个发现对模型训练有启示:与其继续提升推理能力,不如在"代码完整性检查"上做更多工作。比如在生成完代码后,跑一遍静态分析,自动补全缺失的 import。
8. Bonsai 两次跑分有 12% 的翻转率
同一套题、同一个模型,跑了两次,结果有 6 道题翻转了——第一次 pass 第二次 fail,或者反过来。6 道翻转题占 50 道题的 12%。
最极端的是 2919 号题:第一次跑 4859 秒通过,第二次跑 618 秒失败。花的时间多了 8 倍,反而通过了——说明第一次它在长时间推理中碰巧找到了正确路径,第二次虽然更快但走错了。
翻转题: 6/50 = 12%
2919号: 4859s PASS vs 618s FAIL
解读:12% 的通过率波动就是这 6 道题造成的。 如果你只跑一次评测,通过率可能偏差 4 个百分点(6/50 = 12%,但翻转是双向的,净影响约 4%)。这对评测的统计显著性有直接影响——任何声称"模型 A 比模型 B 高 2 个百分点"的结论,如果只跑了一次,都不可靠。
建议:关键评测至少跑两次,用翻转率来衡量基准的噪声水平。
第三组:模型之间的秘密
9. 每个模型都有 2 道"独家题"
在 LCB 的 50 道题中,有些题只有某个模型能做对:
Bonsai 独家通过:  3220、3682
DeepSeek 独家通过: 2867、3210
Gemma4 独家通过:  2893、3510
Qwen3-Coder:      0 道独家
ThinkingCap:      0 道独家
解读:模型之间有互补性。 每个模型都有自己擅长的"独家领域"。Bonsai 的思维链推理在某些题上有独特优势,DeepSeek 在另一些题上更强,Gemma4 又有自己的一技之长。
这对实际应用意味着什么?如果你在做代码辅助,可以考虑用多个模型做 ensemble——一道题先让主模型做,做不出来再换另一个模型试试。简单的 fallback 策略就能覆盖那些"独家题"。
Qwen3-Coder 和 ThinkingCap 没有独家题,说明它们能做的题,其他模型也能做。这不是说它们差,而是它们没有独特的"杀手锏"。
10. Hard 题是模型能力的分水岭
不同难度的通过率差异巨大:
模型                Easy    Medium    Hard
Bonsai (LCB316)    76.3%   49.2%    32.0%
Qwen3.6 (LCB316)   81.8%   58.3%    43.4%
解读:Hard 题是区分模型的关键。 Easy 题大家都会做(76-82%),Medium 题开始拉开差距,Hard 题才是真正考验。Qwen3.6-27B 在 Hard 题上 43.4%,比 Bonsai 的 32.0% 高出11个百分点——这是大样本下本地模型的真实差距。
如果你的使用场景涉及复杂算法或高难度 Debug,选模型时要重点看 Hard 题通过率,而不是总分。
第四组:能力的边界
11. DebugBench vs LCB 的能力断层
同一个模型在两个基准上的表现:
DebugBench 通过率: 62.2%
LCB 通过率:        50.5%
差距: 18 个百分点
解读:修 bug 和从零写是两种不同能力。 DebugBench 是给一段有 bug 的代码让模型修,LCB 是从零开始写。模型在"修"的场景下表现明显更好,因为已经有了一段代码作为起点,只需要找到并修正错误;而从零写需要完整的理解、设计和实现。
这个差距对产品设计有直接指导:如果你的工具是"代码修复"场景(比如 CI 里的自动修 bug),模型的表现会比"代码生成"场景好得多。反过来,如果你指望模型从空白文件写出完整功能,当前的模型还不够好。
12. 模型对 Easy 题的共识极高
4 个模型(Bonsai、DeepSeek、Gemma4、Qwen3-Coder)同时跑 LCB 的 50 道题:
4 模型全对: 14 道
4 模型全错: 19 道
有分歧:     17 道
解读:19 道全错是难题,17 道分歧题才是评测的价值。 14 道全对的题对区分模型没用——大家都会做。19 道全错的题也没用——大家都不会做。真正有信息量的是那 17 道有分歧的题:它们能区分出哪个模型更强。
这意味着评测基准的质量可以用"分歧率"来衡量。如果一套题所有模型都全对或全错,这套题就没有区分度。好的基准应该让不同模型的表现有足够大的分散。
第五组:钱的故事
13. 本地推理的能耗实测
在 RTX 3080 上实测:
平均功耗:        278.3W
推理速度:        43.9 tok/s
能效:            0.1576 tok/W-s
每 1000 tokens:  1.76 Wh ≈ $0.0003
对比 DeepSeek API:
DeepSeek API:    $0.00014 / 1000 tokens (输入)
本地推理:        $0.0003  / 1000 tokens
差距:            本地约 2 倍
整个评测过程跨越 7 天(7月20-27日),总推理时间 137.9 小时,能耗约 40 kWh。
按上海居民峰谷电价计算:
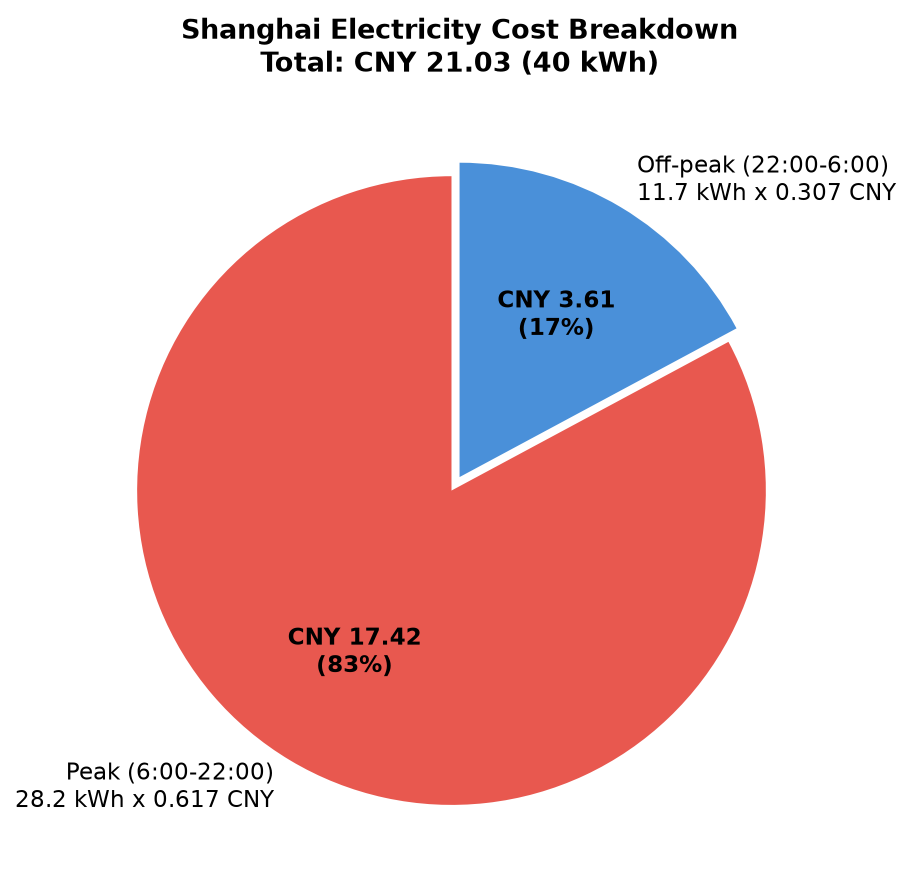
峰时 (6:00-22:00):  28.2 kWh × ¥0.617 = ¥17.43
谷时 (22:00-6:00):  11.7 kWh × ¥0.307 = ¥3.61
合计:               40.0 kWh            = ¥21.03
¥21 跑完全部评测,约等于两杯奶茶。
解读:本地推理比 API 贵约 2 倍,但你买的是隐私和可控性。 从纯成本角度看,调 API 更便宜——DeepSeek 的价格已经压得很低了。但本地推理有三个 API 给不了的东西:数据不出本地、不受 API 限流影响、可以随意折腾模型参数。
¥21 跑完全部评测,这个成本对于个人开发者来说完全可以接受。如果你在做评测研究,本地跑和 API 跑可以并行——本地跑用来调参和调试,API 跑用来出正式结果。
能效方面,RTX 3080 的 0.1576 tok/W-s 是一个基线值。换成 4090 或者 5090,这个数字会好不少。量化精度(4-bit vs 8-bit vs FP16)对能效的影响也很大,但那是另一个话题了。
总结:13 件事的 3 个核心洞察
回头看这 13 个发现,它们指向三个核心洞察:
第一,失败不是均匀的。 模型在不会做的题上花更多时间、写更长代码、推理更久——所有"失败"的信号都指向同一个行为模式:死磕。这对推理服务的成本模型有直接影响。
第二,评测的噪声比你想的大。 12% 的翻转率、17 道分歧题、19 道全难题——任何声称"模型 A 比模型 B 强 X%"的结论,都需要考虑这些噪声源。单次跑分的置信度远低于你的想象。
第三,能力是多维的。 修 bug 和写代码是两种能力,思维链在 Hard 题上的优势是显著的,模型之间有独特的互补性。单一通过率掩盖了太多信息。
下次你跑完一个评测,别只看通过率。翻翻数据,里面的故事比你想象的多。
系列下一篇预告:篇4 将讨论如何构建自己的评测基准——选题、标注、防泄漏的完整流程。
附录:图表
图1:延迟分布对比
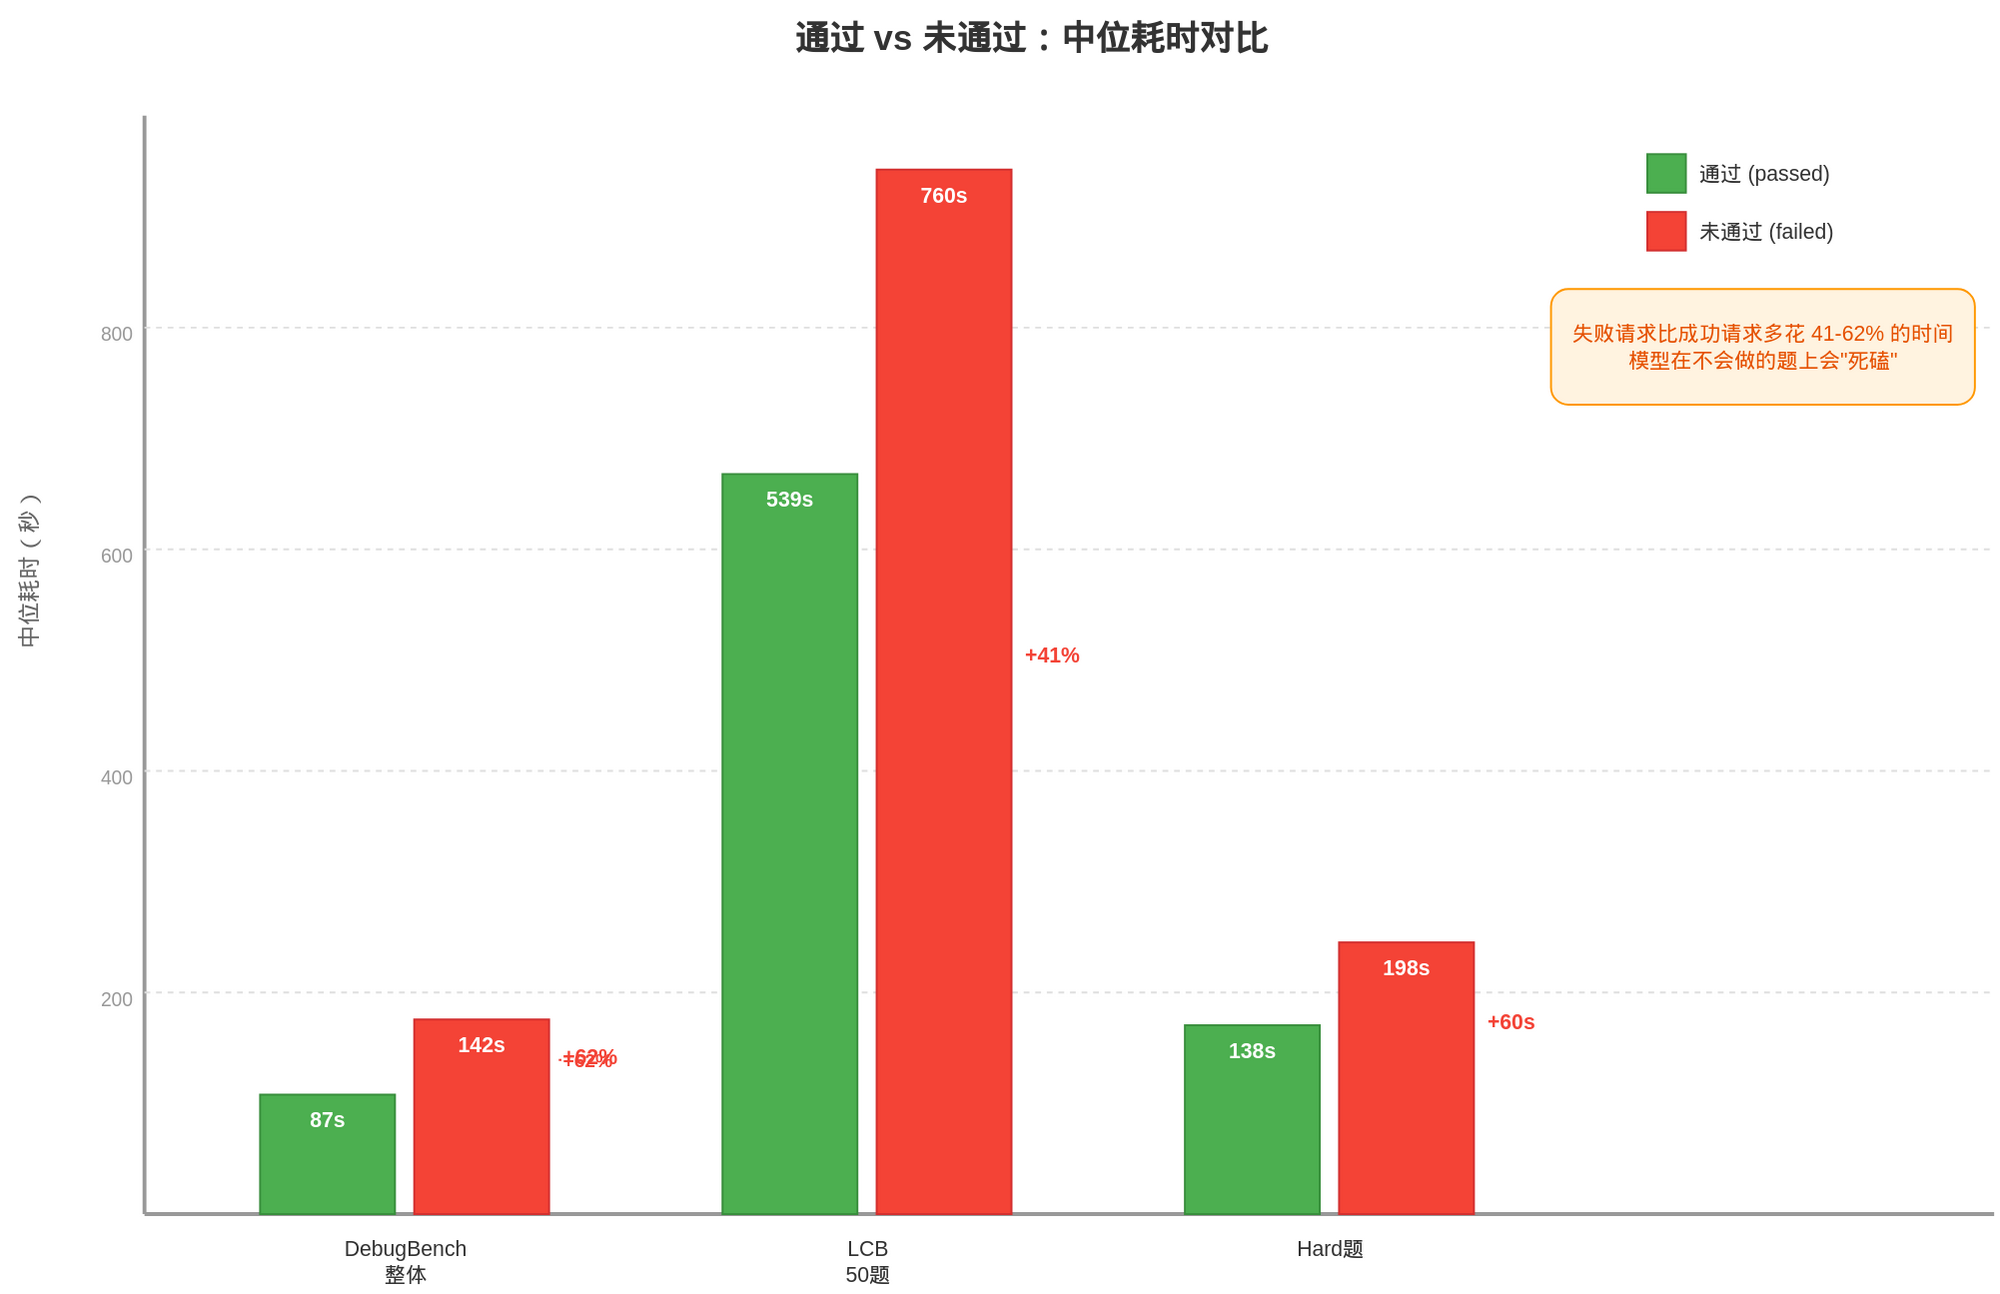
通过与未通过请求的中位耗时对比。数据来源:DebugBench + LCB。
图2:思维循环检测流程
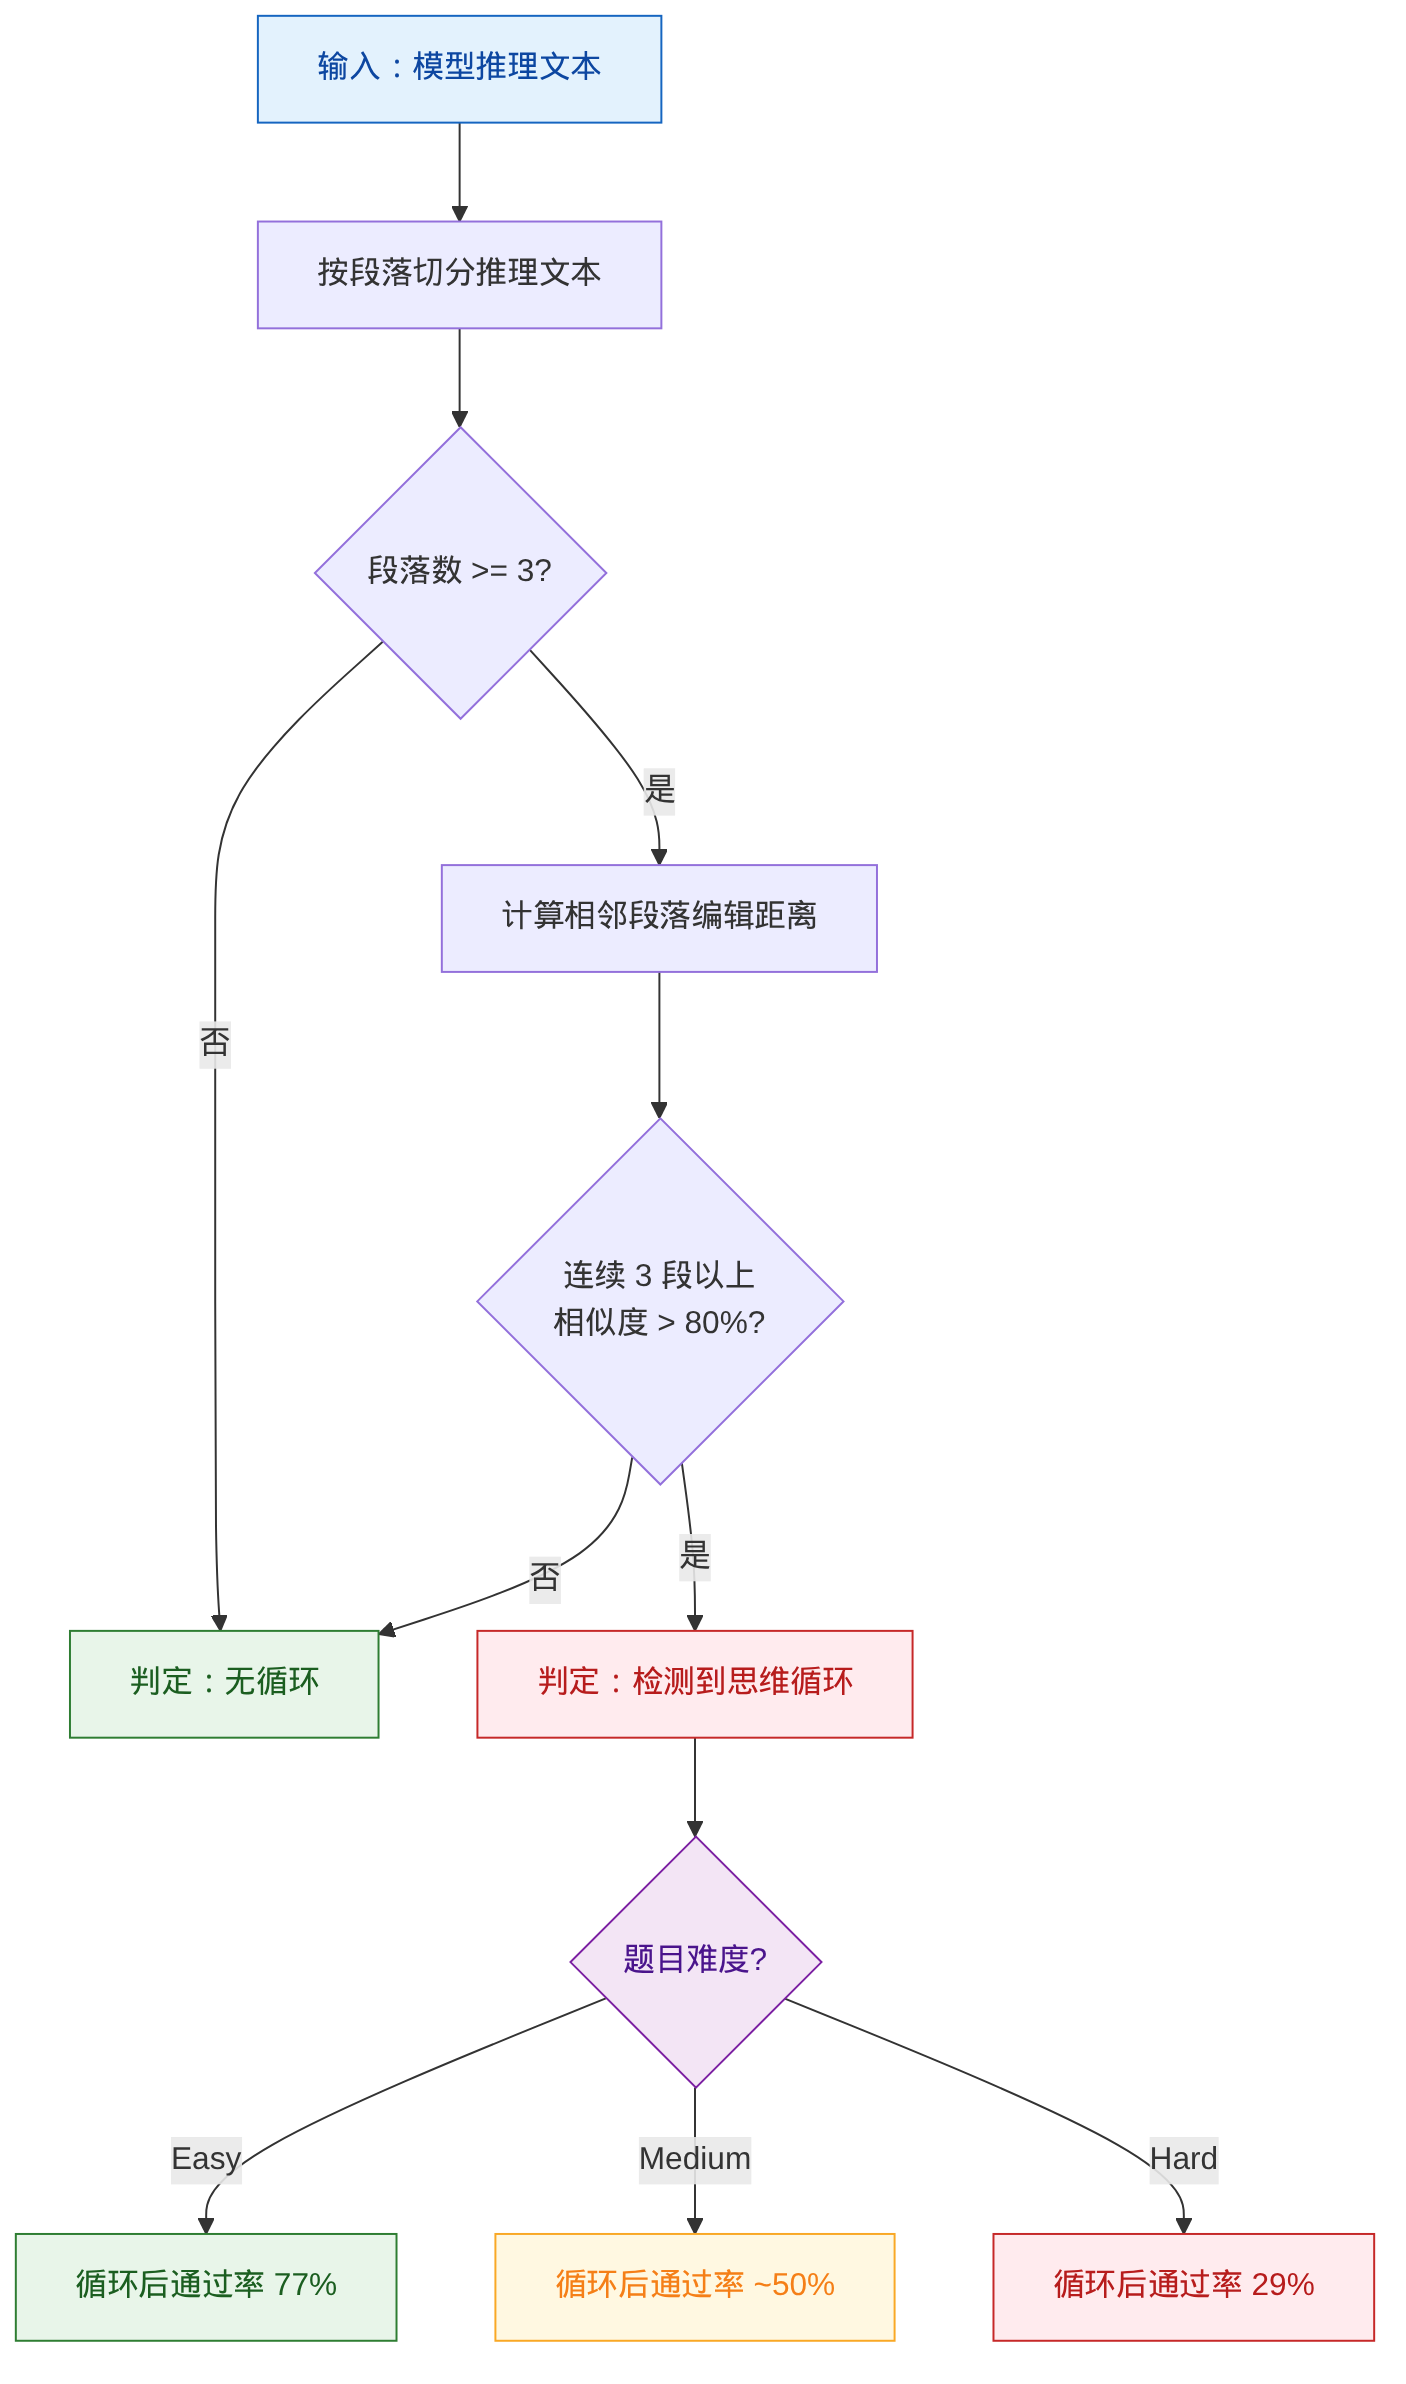
思维循环检测的逻辑流程:按段落切分推理文本,计算编辑距离,判定是否进入循环。
图3:能效对比
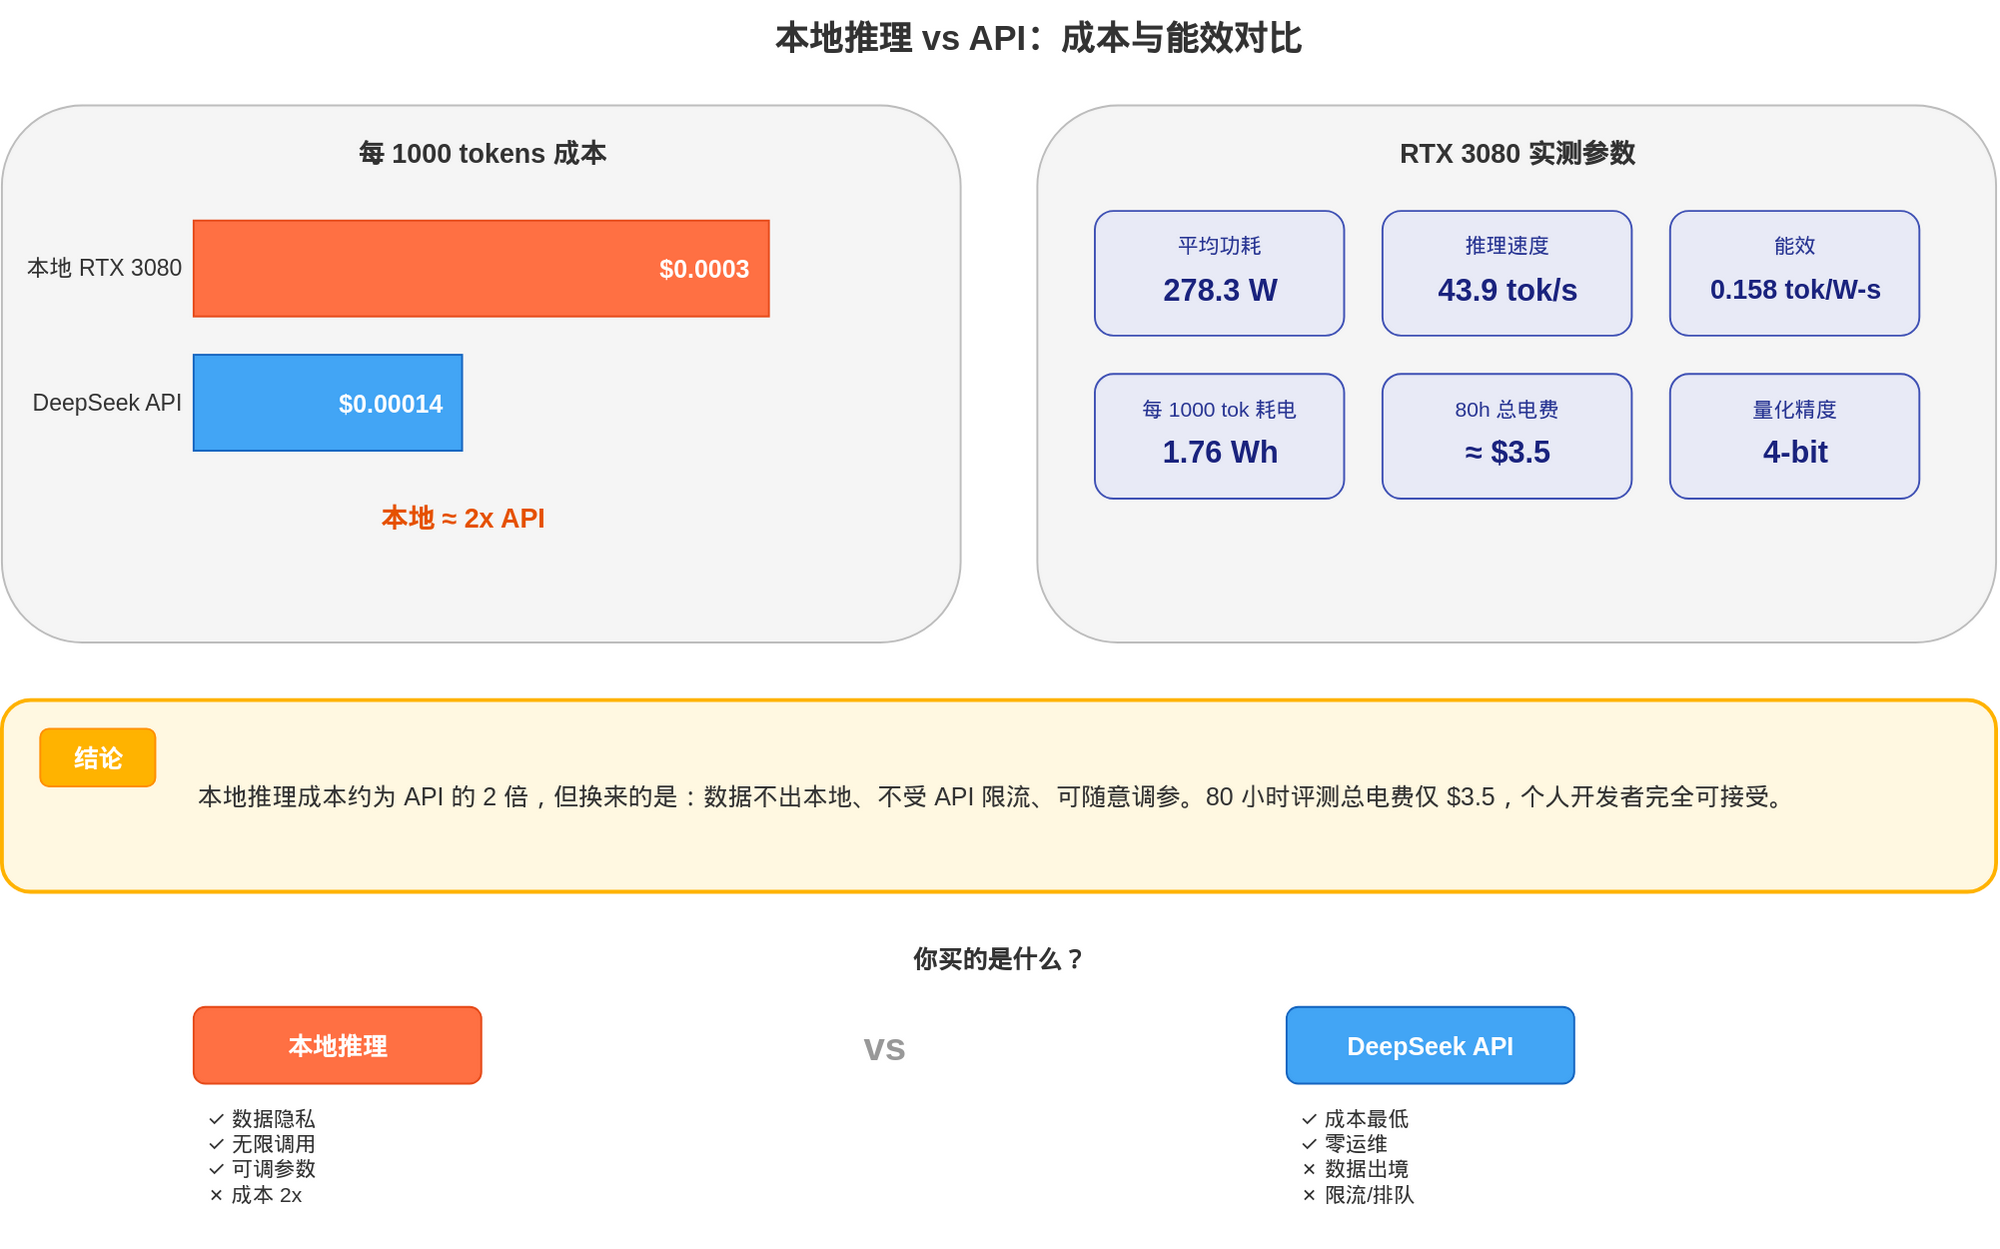
本地推理(RTX 3080)与 DeepSeek API 的成本和能效对比。
更多推荐

 6
 0
- 0


 已为社区贡献6条内容

所有评论(0)