
本地代码大模型评测实战(二):评测框架
本地代码大模型评测实战(二):1414道题测出的修bug能力
系列目录
篇1: 模型选型
篇2: 评测框架 ← 当前
篇3: 数据挖掘的13个发现
篇4: 8个坑和1个崩溃
篇5: 公平对比的5个陷阱PrismML-Ternary-Bonsai-27B 在 DebugBench 上拿到了 62.2%(排除 skip),比 LCB 从零写算法的 50.5% 高出整整 18 个百分点。模型修 bug 比写算法强得多——但一旦涉及多重错误,通过率直接掉到 66.5%,弱点暴露。
为什么要加这个维度
上一篇我们用 LCB(LiveCodeBench)测了模型从零写算法的能力。但真实的开发场景里,程序员更多时间不是在写新代码,而是在修 bug。给一段有毛病的代码,找出问题并修复——这跟从空白页面开始写完全是两种能力。
DebugBench 就是为这个场景设计的。它从 LeetCode 题目出发,给模型一段有 bug 的 Python 解法,要求模型修复后通过所有测试用例。1414 道题,覆盖语法错误、逻辑错误、引用错误、多重错误四大类。
简单说:LCB 测"你会不会写",DebugBench 测"你会不会修"。
数据集长什么样
DebugBench 的每道题包含:
- 题目描述(LeetCode 原题)
- 一段有 bug 的 Python 代码(人工注入的错误)
- 参考测试用例
题目按难度分为 Easy(335 题)、Medium(494 题)、Hard(469 题),按 bug 类型分为 syntax(语法)、logic(逻辑)、reference(引用)、multiple(多重错误)四类。
需要注意的是,192 道题的参考解本身跑不通(skip),这些题不参与评分。实际评测 1222 道题。
全量结果
1414 道题,最终成绩:
| 指标 | 数量 |
|---|---|
| Pass | 879 |
| Fail | 343 |
| Skip(参考解跑不通) | 192 |
| 全量通过率 | 62.2% |
| 排除 skip 通过率 | 62.2% |
62.2% 的全量通过率看起来还行,但更有意义的是排除 skip 后的 62.2%——这才是模型真实能力的体现。
按难度拆解
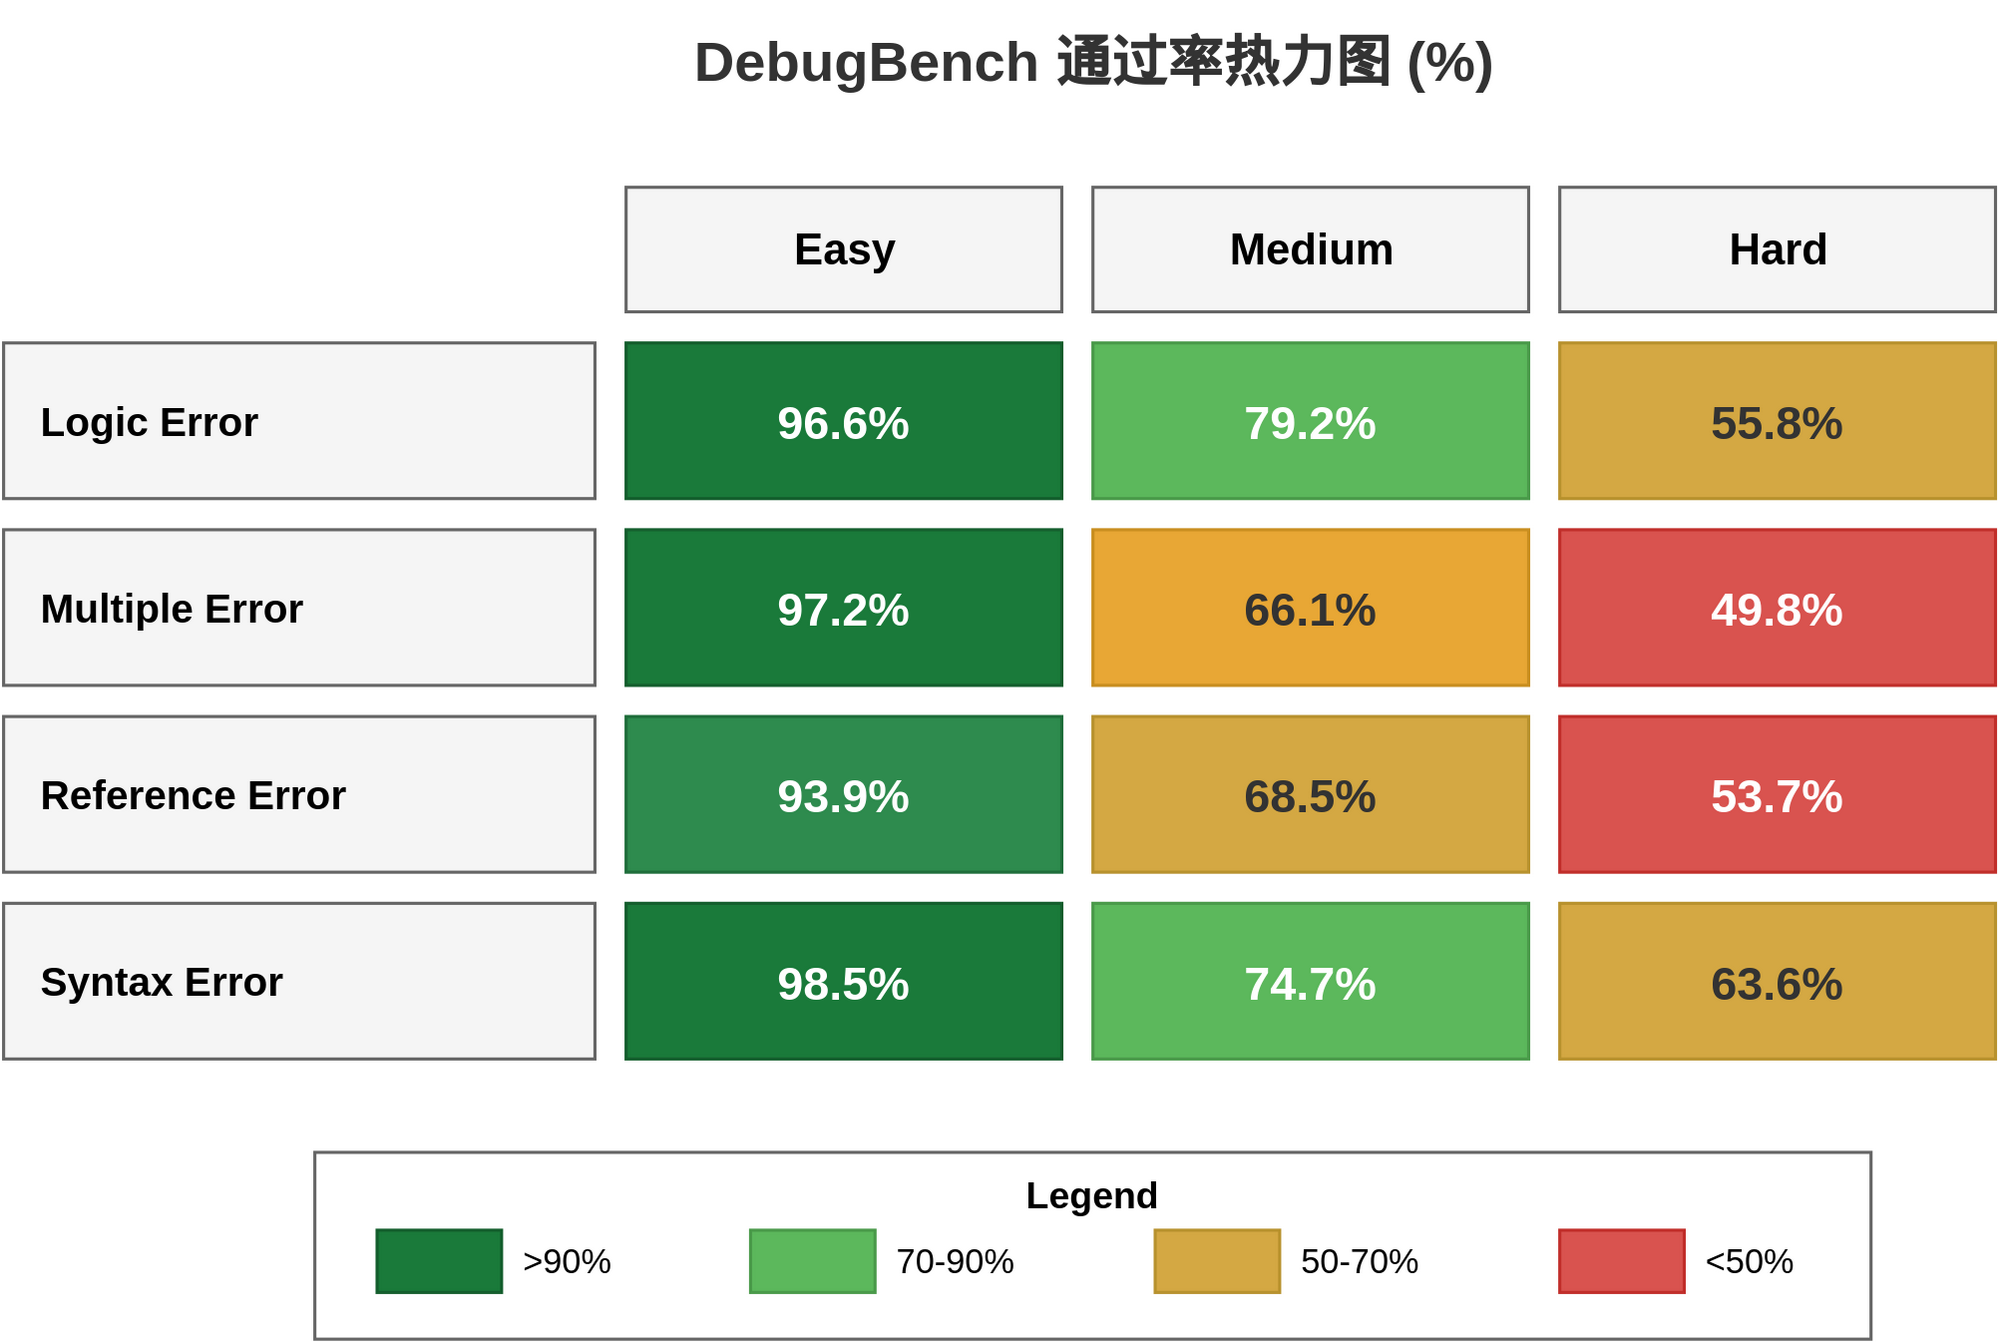
| 难度 | 题数 | 通过 | 通过率 |
|---|---|---|---|
| Easy | 335 | 324 | 96.7% |
| Medium | 494 | 346 | 70.0% |
| Hard | 469 | 209 | 53.2% |
Easy 题近乎满分,96.7% 意味着 335 道只错了 11 道。Medium 掉到 70%,Hard 腰斩到 53.2%。难度梯度非常明显。
这个分布跟 LCB 类似,但绝对值高出一截——说明修 bug 确实比从零写更容易。
按 bug 类型拆解
| Bug 类型 | 通过率 |
|---|---|
| Syntax(语法错误) | 79.3% |
| Logic(逻辑错误) | 79.4% |
| Reference(引用错误) | 75.6% |
| Multiple(多重错误) | 66.5% |
语法和逻辑错误的通过率几乎一样(79% 左右),引用错误稍低(75.6%),多重错误明显拉胯(66.5%)。
有意思的是,语法错误并没有想象中那么容易。按直觉,"少了个括号"这种题应该比"算法逻辑写反了"简单得多,但实际上两者通过率几乎持平。这说明模型在语法修复上也有盲区,不只是推理能力的问题。
多重错误是杀手
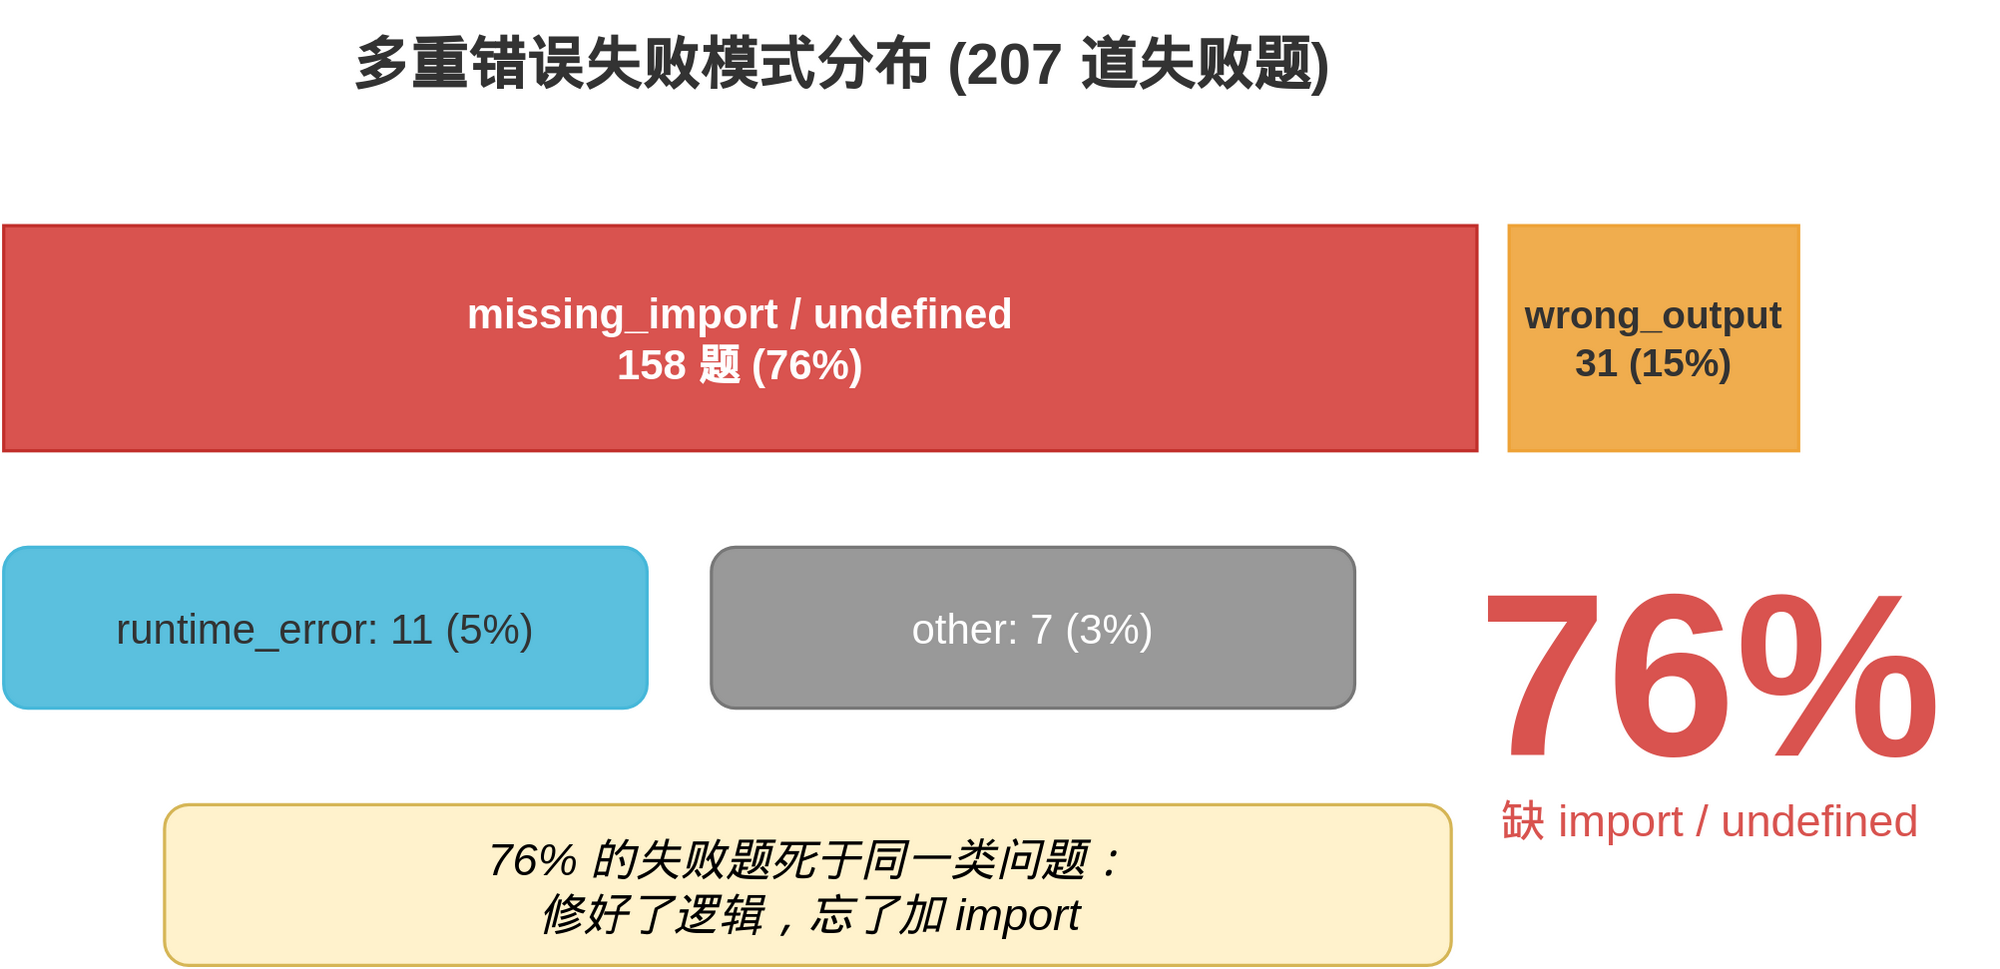
207 道失败的题里,158 道(76%)死于同一类问题:缺 import 或变量未定义。
具体分布:
- missing_import / undefined:158 道(76%)
- wrong_output:31 道(15%)
- runtime_error:11 道(5%)
- other:7 道(3%)
这个分布非常说明问题。模型不是不会修 bug,而是在面对多个同时存在的错误时,修了一个忘了另一个。最典型的表现:修好了逻辑错误,但忘了加上缺失的 import 语句。
多重错误(multiple)类题目通过率只有 66.5%,比单类错误低了将近 10 个百分点。这不是能力问题,是注意力问题——模型在多点修复时容易顾此失彼。
修 bug vs 从零写:18 个百分点的能力断层
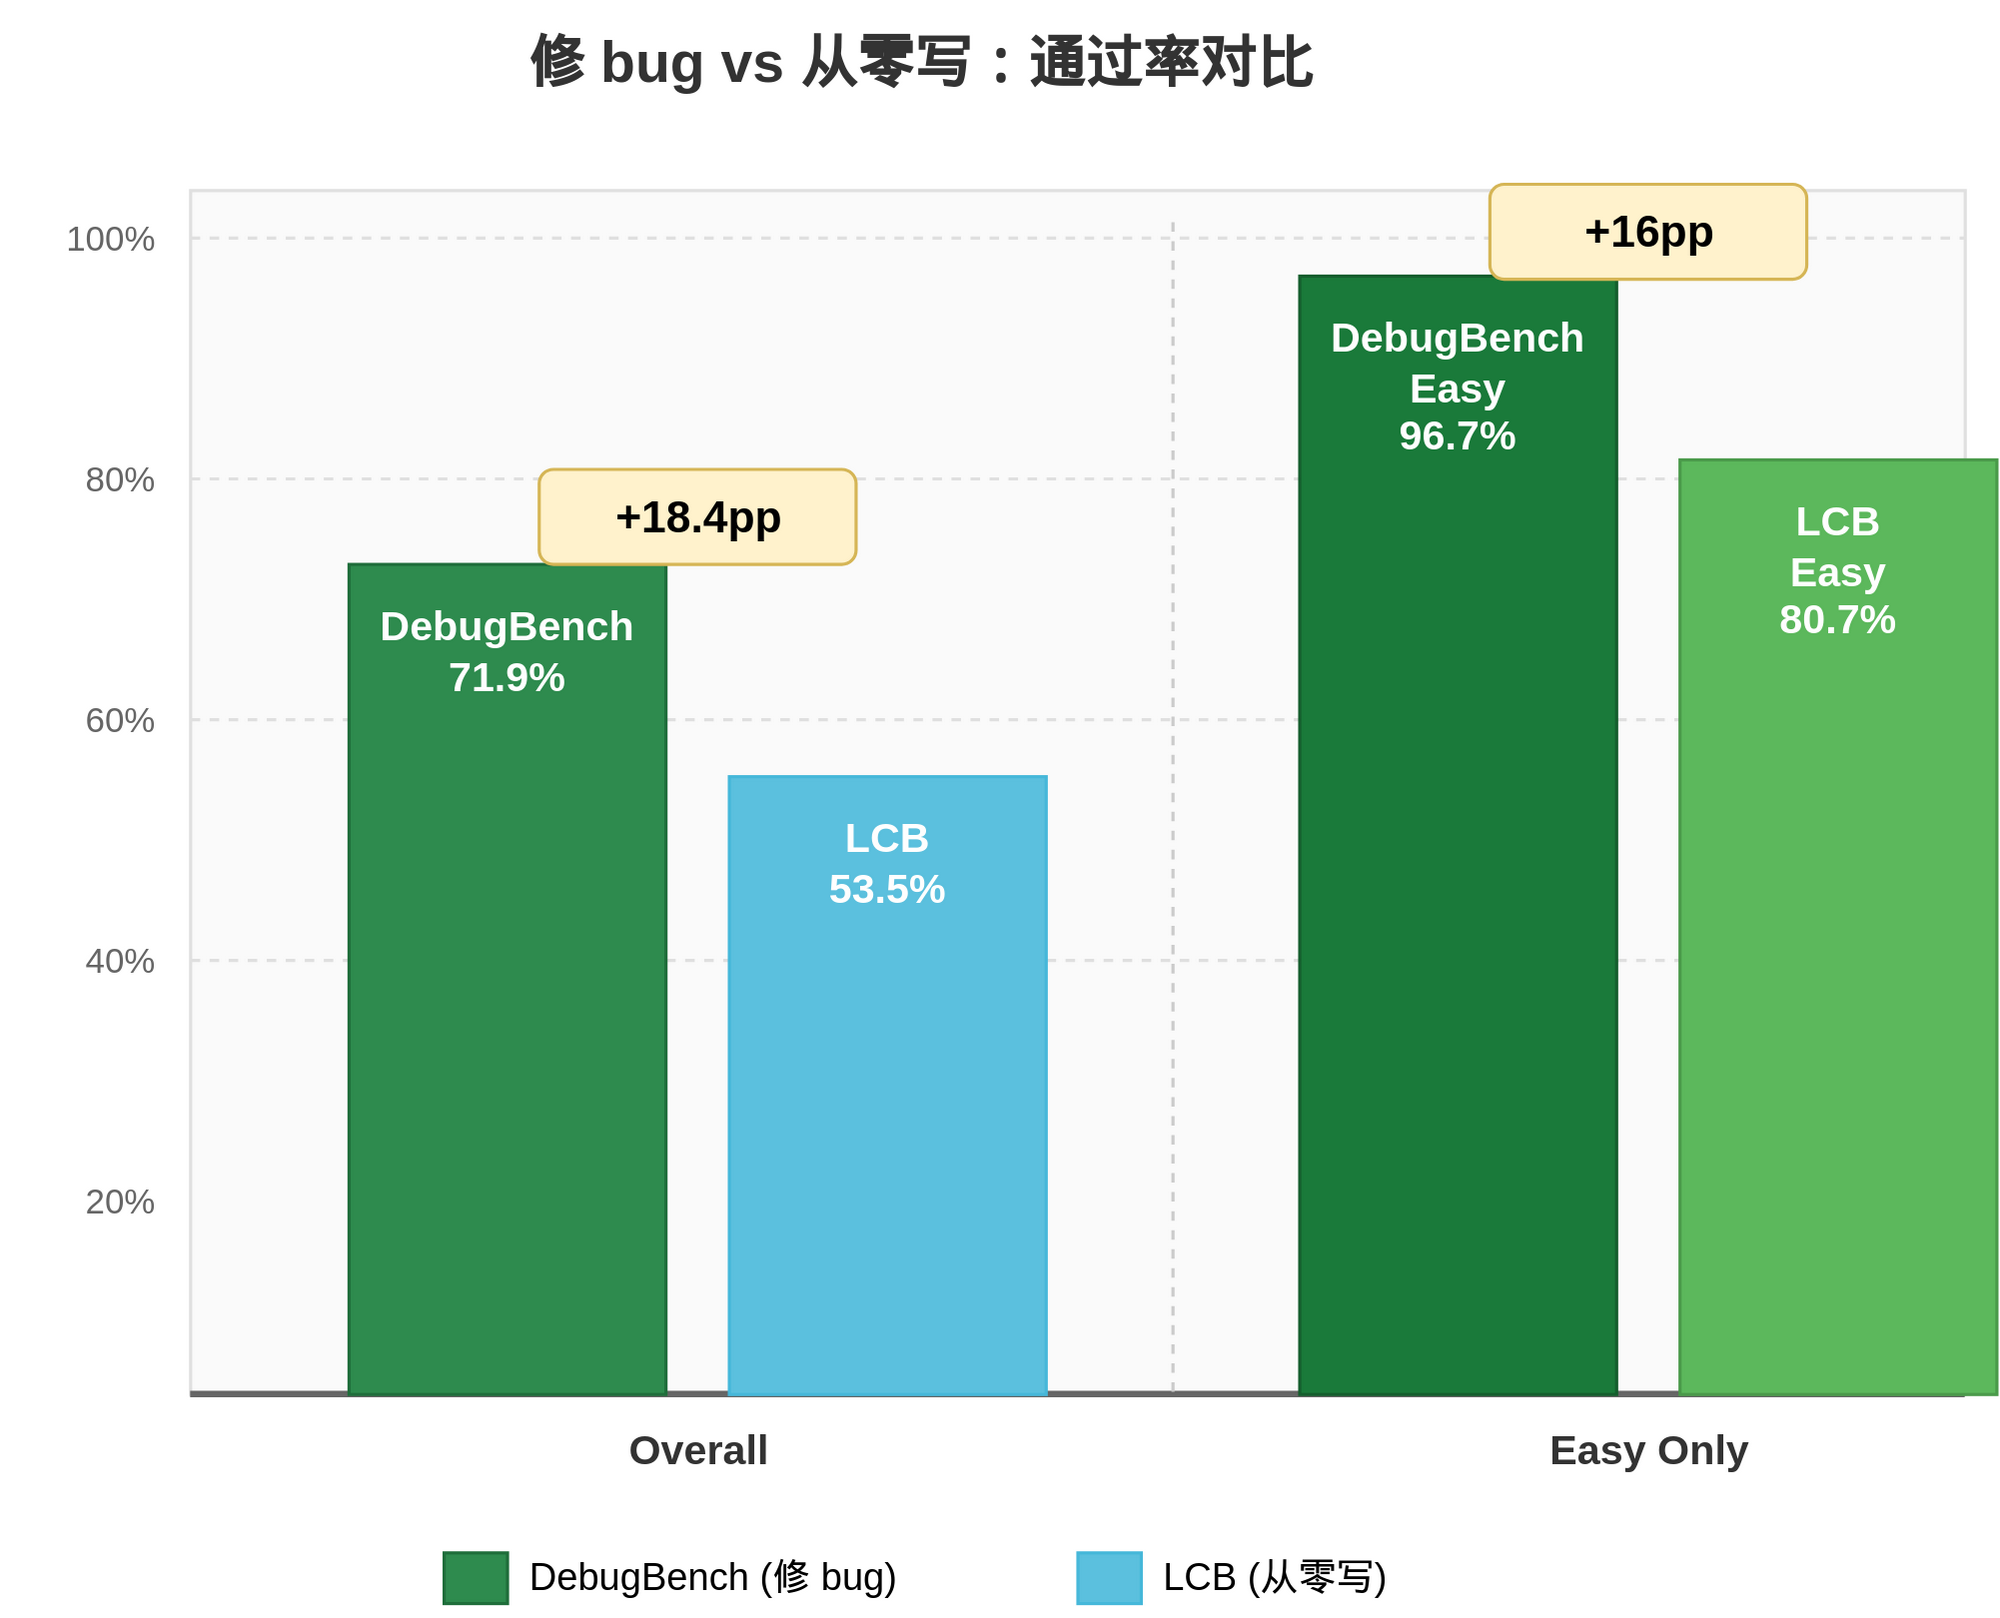
| 评测 | 通过率 |
|---|---|
| DebugBench(修 bug) | 62.2% |
| LCB(从零写算法) | 50.5% |
| 差值 | +18.4pp |
| 难度 | DebugBench Easy | LCB Easy |
|---|---|---|
| 通过率 | 96.7% | 80.7% |
18 个百分点的差距不是噪声,是结构性差异。
两种任务对模型的要求完全不同:
修 bug 是模式识别。 模型需要做的是"找到哪里不对"。给定一段大部分正确的代码,模型只需要定位错误点,然后做局部修改。这更像是 pattern matching——见过类似的 bug 模式,就能修。
从零写是推理构建。 模型需要从题目描述出发,设计算法,实现代码,处理边界。这是从无到有的构建过程,对推理能力的要求高得多。
这也解释了为什么 Easy 题的差距更大(96.7% vs 80.7%,差 16pp):Easy 题的 bug 模式简单且常见,模式识别的优势最大化;而 Easy 题从零写虽然也不难,但仍然需要完整的推理链。
Easy 题失败的 11 道:引用错误是主力
335 道 Easy 题只错了 11 道,但这 11 道值得细看。
主要失败模式是 reference error(引用错误):变量名拼错、函数名不存在、作用域问题。这类错误在语法上可能是合法的(不会报 SyntaxError),但运行时会出问题。
模型在这类错误上的表现比语法错误差,原因可能是:语法错误有明确的报错信息可以对齐,而引用错误需要模型理解变量的语义和作用域,这更接近"理解代码"而非"匹配模式"。
结论与启示
-
修 bug 是模型的强项。 62.2% 的通过率比从零写的 50.5% 高出 18 个百分点,说明当前模型在"给定上下文做局部修改"这个任务上表现不错。
-
多重错误是明确的短板。 76% 的失败题死于缺 import/undefined,说明模型在多点修复时容易遗漏。这不是推理能力问题,是注意力分配问题。
-
模式识别 vs 推理构建是两种不同的能力。 修 bug 更偏前者,从零写更偏后者。模型在模式识别上的优势可以解释很多"看起来聪明但实际写不出来"的现象。
-
难度梯度存在但不对称。 Easy 到 Hard 的衰减曲线在两种任务上形态相似,但 DebugBench 的绝对值始终更高——说明即使在 Hard 题上,修 bug 也比从零写容易。
-
实际意义: 如果你在用 AI 辅助编程,修 bug 的场景比从零写的场景更可靠。但涉及多个同时存在的错误时,最好分步修复而不是一次性让模型搞定。
下一篇:模型在实际代码仓库里的表现如何?从单题评测到项目级评测的跨越。
更多推荐

 7
 0
- 0


 已为社区贡献6条内容

所有评论(0)