
大模型价格一直在降,为什么企业AI项目反而越来越贵?
同等能力的大模型调用价格仍在下降,可不少企业复盘AI预算时,看到的却是系统接入、效果评测和运行支持持续增加。两者并不矛盾。模型价格计算一次推理,企业承担的是一项任务从发起到被业务接受的完整成本。只有把核算单位从Token改成有效任务,才能判断预算增长究竟来自业务扩展,还是来自失败重试和重复建设。
最近很多AI项目纷纷上线,每个企业都在思考如何借助AI来实现降本增效,但当进行预算复盘时,经常会出现一组看起来互相矛盾的数字:模型API的报价比项目立项时低了,AI项目的总预算却没有跟着下降,有些项目第二年的预算还会更高。增加的费用并不都在模型账单里,系统改造、数据处理、效果评测和运行支持往往占了更大部分。
从数据来看模型价格确实在下降,大模型的价值一直在大幅度的下降,但是价格下降发生在模型调用这一层,预算增加常常发生在完整任务这一层,两张账计算的对象不同。
API价格只覆盖一次推理
模型服务商通常按照输入、输出、缓存或预留容量计费,这部分支出容易统计。财务部门可以按模型、API Key和部门查看Token用量,也能比较不同模型完成同类请求的大致价格。
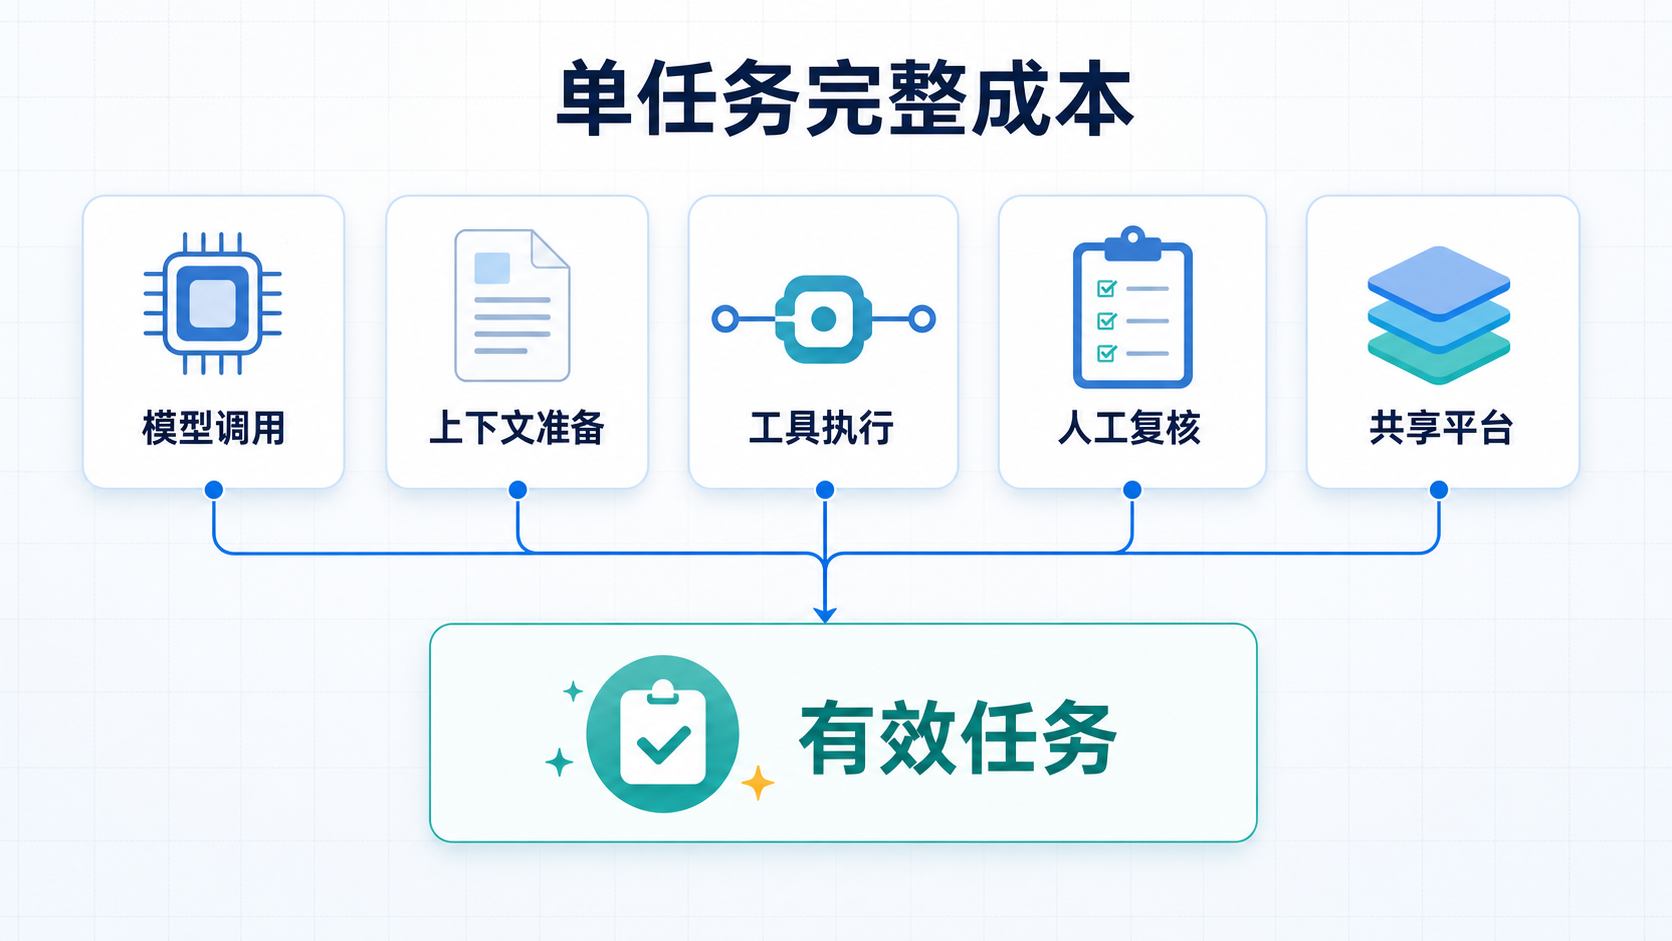
企业项目还有另外两层成本。项目成本包含场景开发、系统对接、测试上线和后续维护;任务成本则关注完成一次业务动作究竟消耗了多少模型、系统与人工资源。预算评审真正需要观察的是任务成本,因为低价Token只有转化为可被业务接受的结果,才产生实际价值。
可以把一项任务的完整成本写成一个简单公式:
单任务完整成本 = 模型调用 + 上下文准备 + 工具执行 + 人工复核 + 失败重试 + 共享平台摊销
其中只有第一项直接跟模型报价变化。其余部分可能受益于模型能力提升,却不会自动消失。模型调用便宜一半,如果任务仍需人工重新整理材料,或者工具接口经常失败,项目总成本不会按同样比例下降。
一项业务任务会放大调用链
以供应商准入材料复核为例:Agent收到申请材料后,要识别文档内容,核对采购系统中的主体信息,调用风险规则服务,发现缺项时生成退回意见,经办人确认后再把结果写入审批流程。员工看到的是一个任务,后台运行的却是一串模型请求和系统动作。
材料解析可能调用专用模型,规则理解需要调取企业上下文,工具返回后还要重新组织信息。如果接口超时或材料格式异常,任务会进入重试或人工接管。任何一个环节失败,都可能让前面的模型调用变成无效消耗。
上下文长度也会改变成本。试用时只放几份示例材料,进入生产后要加入最新制度、供应商历史记录和当前审批状态。缓存可以降低重复内容的输入费用,但动态业务数据不能全部依靠缓存;为了提高结果稳定性而增加校验步骤,也会产生新的调用。
所以,同一个模型完成一次对话可以很便宜,完成一项企业任务却未必便宜。两者之间没有固定倍数,差异取决于任务长度、系统数量、异常概率和人工参与方式。
生产环境会把隐性成本暴露出来
Demo允许项目团队挑选样本并在旁边随时修正。系统正式开放后,输入不再整齐,业务规则也会变化。供应商名称可能有多种写法,制度文件会更新,采购系统字段也可能调整。上下文工程由此变成持续工作,团队要维护资料版本、检索范围和字段映射,旧数据失效时还要重新评测。
工具接入同样不是把API调通就结束。生产任务需要处理超时、限流和重复提交,写回系统时还要保证同一结果不会被执行两次。接口参数发生变化后,Agent可能仍然生成格式正确但业务含义错误的请求。项目团队需要保留任务轨迹,才能分辨问题来自模型理解、工具转换还是业务系统。
结果验证也会形成固定投入。一个能生成合理答案的Agent,遇到边界样本时仍可能输出不一致结果。上线前需要准备评测集,上线后要跟踪人工驳回和失败任务,模型或Skill更新后还要重新测试。高风险步骤保留人工确认,会增加成本,却比事后返工更容易控制。
企业还会为容量和可靠性付费。公开API的按量价格不等于生产服务的完整报价,预留吞吐、优先处理和服务等级协议通常采用另一套计费方式。OpenAI的Scale Tier就是一个公开例子:企业购买的不只是Token,还包括预先分配的吞吐能力以及延迟和可用性承诺。模型单价能够解释调用费用,却解释不了整套生产服务的预算。
价格下降以后,用量可能增长得更快
模型降价会让原本不值得接入AI的任务变得可行。一个部门试点成功后,其他部门会提出相近需求;原来只处理文本的流程开始增加图片和文件;单轮请求逐渐变成长任务,并加入工具调用和结果校验。单次成本下降,总任务数和单任务调用量可能同时上升。
这种现象可以借用杰文斯悖论来理解:资源使用效率提高后,需求扩张可能抵消单位成本下降带来的节省。不过,这只是解释框架,不能据此认定每个AI项目都会增加预算。对一家企业来说,总费用增长是否合理,还要看有效任务量和业务结果是否同步变化。
FinOps Foundation的2025年度调查提供了一个侧面观察。在这组以大型云支出组织为主的样本中,63%的受访团队已经开始管理AI支出,关注重点先落在成本可见性、分摊、预测和业务价值,直接优化模型价格的优先级反而较低。这组数据不能代表所有企业,但它反映了一个现实:当AI支出分布在SaaS、公共云、私有环境和内部平台中,单看模型账单已经很难回答预算问题。
换成按任务核算
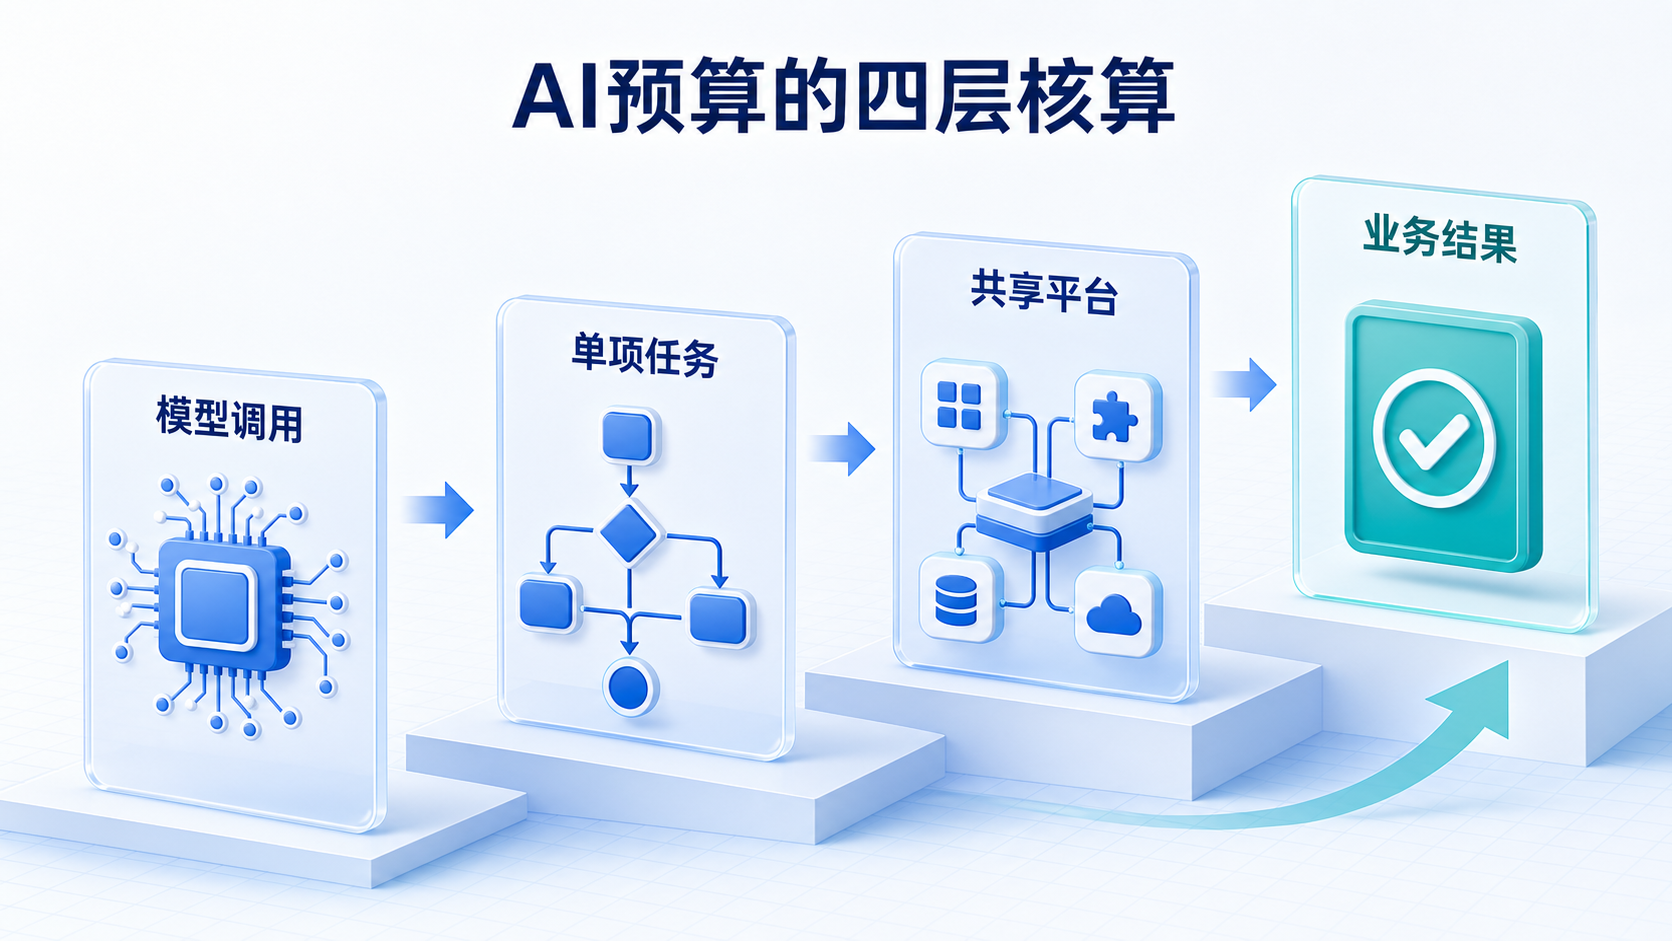
AI项目进入预算评审时,可以把模型调用、单项任务、共享平台和业务结果分开计算。四个口径解决的问题不同,不应混成一个总数。
| 核算对象 | 主要观察内容 | 能回答的问题 |
|---|---|---|
| 模型调用 | Token、缓存、模型选择和峰值容量 | 哪类模型调用更经济 |
| 单项任务 | 完成率、重试、工具执行和人工复核 | 完成一次有效任务需要多少钱 |
| 共享平台 | 接入、评测、运行和运营投入 | 哪些固定能力可以由多个项目使用 |
| 业务结果 | 处理周期、返工、风险和实际产出 | 新增投入是否值得 |
核算单项任务前,需要先定义“有效完成”。供应商准入场景不能把Agent生成一份审核意见视为完成,结果经过经办人确认并进入审批系统,才算形成一次有效任务。没有完成定义,调用量增长很容易被误认为使用效果改善。
固定投入与变动成本也要分开。系统连接、评测框架和任务运行属于前期投入,使用范围扩大后可以被更多任务分摊;模型调用和人工复核会随任务量变化。两类费用混在一起,会让试点阶段的单任务成本看起来很高,也会掩盖正式运行后的异常消耗。
预算增加并不一定是坏结果。如果有效任务量增长更快,单任务成本持续下降,说明平台投入正在被复用。相反,模型费用下降了,请求量不断增加,但任务完成率没有改善,低价调用反而会掩盖重试、返工和无效使用。
先减少重复建设
当多个部门分别开展AI项目,模型采购通常不会成为最大的重复投入。真正反复发生的是模型适配、系统接入、任务追踪和效果评测。每个项目都从头建设一套运行能力,固定成本很难被后续场景复用,模型再便宜也无法抵消重复开发和维护。
共享平台可以统一这些公共部分,业务团队只维护自己的规则、工具和验收标准。平台建设本身也需要投入,更适合从已经出现重复需求的组织开始,不必为了架构完整一次性铺开全部能力。
例如凡泰AI可以通过FinClaw统一管理模型、Agent、Skill、工具与任务运行,让不同项目复用接入和运营能力,并按任务观察用量与结果,减少部门重复建设。
模型降价之后,更要看完整账单
大模型价格下降降低了企业尝试AI的门槛,也给模型路由、缓存和任务分级留下了更多优化空间。它解决的是一次推理多少钱,并不会自动解决一次任务要调用多少次、失败以后怎样处理,以及固定投入能否被多个项目使用。
下一次复盘AI预算时,总费用不需要孤立地与API降价幅度比较。更有意义的指标是有效完成了多少任务,每项任务包含多少无效调用和人工返工,前期建设的能力又被多少项目复用。完成量增加、单任务成本下降时,总预算增长可能是业务扩展的正常结果;请求量上涨而有效结果不变,才说明便宜的模型没有带来更好的单位经济。
更多推荐



 10
 0
- 0


 已为社区贡献19条内容

所有评论(0)