
大模型手搓文件对比工具(9)扫描有进度,想停就能停
上一期把同步预览、备份和回滚补上以后,文件写入这条链路基本有了安全边界。
但目录一大,另一个问题马上就暴露出来了:点击对比以后,界面只显示一句“正在对比文件”,进度条一直转,却看不到程序走到哪里,也不知道还要等多久。
如果选错了目录,还不能取消。只能等它把左右目录全部扫完,再把每个文件的 SHA-256 算完。
原来的目录扫描流程很直接:
扫描左侧目录
  └── 发现一个文件,立即计算 SHA-256
扫描右侧目录
  └── 发现一个文件,立即计算 SHA-256
合并相对路径
构建结果树
一次性刷新表格
小目录这样写没有明显问题。文件数量上千、目录嵌套较深,或者里面有几个大文件时,问题就比较集中:
- 不知道当前是在遍历目录,还是在读取大文件。
- 不知道已经处理多少文件、多少字节。
- 选错目录以后不能停。
- 左右两侧完全串行扫描和 Hash,等待时间偏长。
- 新扫描一开始就清空旧表格,失败后什么结果都看不到。
- 后面如果直接加取消,旧任务还可能在后台完成后覆盖新任务。
所以这期进入开发计划里的 P2:把扫描拆成明确阶段,增加实际进度、取消操作和受控并行 Hash。
这次看起来只是多一条进度条和一个取消按钮,真正需要处理的却是后台任务、磁盘 I/O、结果一致性和 Swing 线程安全。
先确定一个原则:进度必须有依据
扫描一开始,程序还不知道目录里有多少文件。
如果这时直接显示 20%、50%,这些数字没有计算基础,只能靠估算。目录遍历到一半时,又可能刚好进入一个包含几万个文件的子目录,进度甚至需要倒退。
所以本期把任务拆成四个阶段:
发现文件 → 计算 Hash → 构建结果 → 更新界面
1. 发现文件
目录发现阶段只做三件事:
- 遍历左右目录。
- 应用目录名、扩展名和通配符过滤规则。
- 记录文件路径、相对路径、大小和修改时间。
这个阶段不知道最终总量,因此使用不确定进度条,只显示实时数据:
- 左侧发现文件数。
- 右侧发现文件数。
- 已发现总字节数。
- 已排除目录和文件数量。
- 当前访问路径。
2. 计算 Hash
发现结束后,候选文件数和总字节数已经确定,这时再切换为确定进度。
Hash 阶段同时显示两组数字:
已完成文件 / 总文件
已读取字节 / 总字节
主进度按字节计算,而不是只按文件数。
原因很简单:一个 4 GB 文件和一个 2 KB 文件不能各占一份相同进度。按文件数计算时,界面可能很快显示 99%,然后卡在最后一个大文件上很久。
3. 构建结果
Hash 全部完成后,再合并左右相对路径,判断相同、不同、仅左侧和仅右侧,并构建可折叠目录树。
4. 更新界面
结果树准备完成后,Swing 表格不能一次塞入大量行。程序按每批最多 200 行准备新的表格模型,全部完成后再替换当前结果。
这四个阶段确定后,进度条才不只是一个动画,而是能反映实际工作的状态。
UI 先确认,再动扫描代码
这次仍然没有直接修改正式代码,而是先做实施方案和三张效果图。
扫描进度放在主窗口左右路径和结果区之间,不使用阻塞式弹窗。这样有旧结果时,用户仍然可以查看、滚动和展开目录。
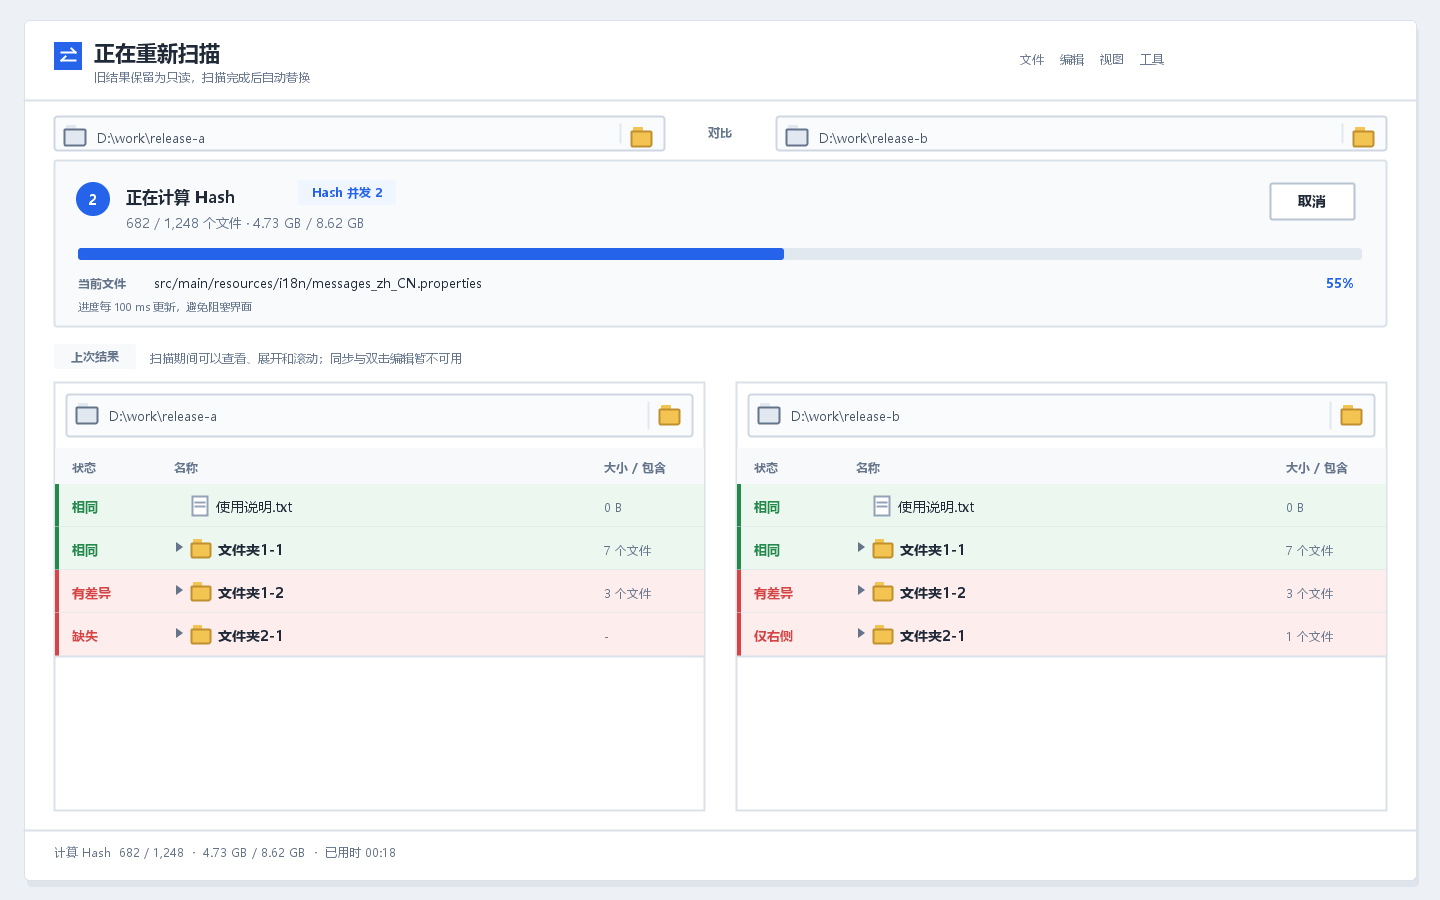
扫描期间旧结果标记为上次结果,同步和双击编辑暂时禁用。只有新任务完整成功后,旧结果才会被替换。
取消后不弹二次确认。目录对比是只读操作,取消不会修改磁盘文件,再加一道确认只会增加操作负担。
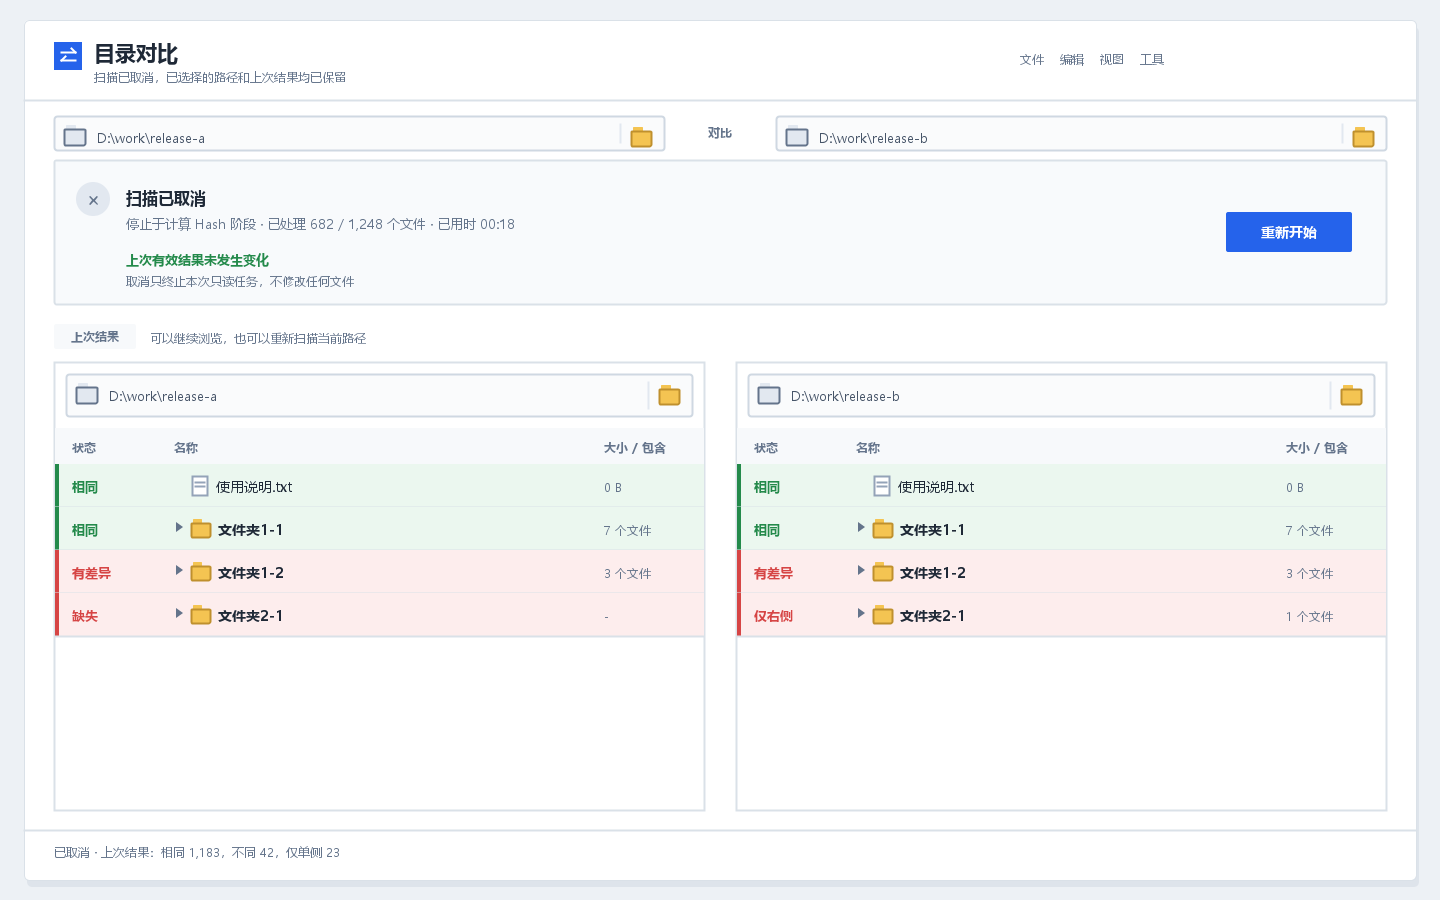
任务真正退出后,状态区保留取消阶段、处理数量和耗时,并提供“重新开始”。左右路径不清空,上一次有效结果也不变化。
正常完成后不自动弹统计窗口,避免每次按 F5 都多关一个窗口。用户可以点击底部详情,或者从工具菜单打开。
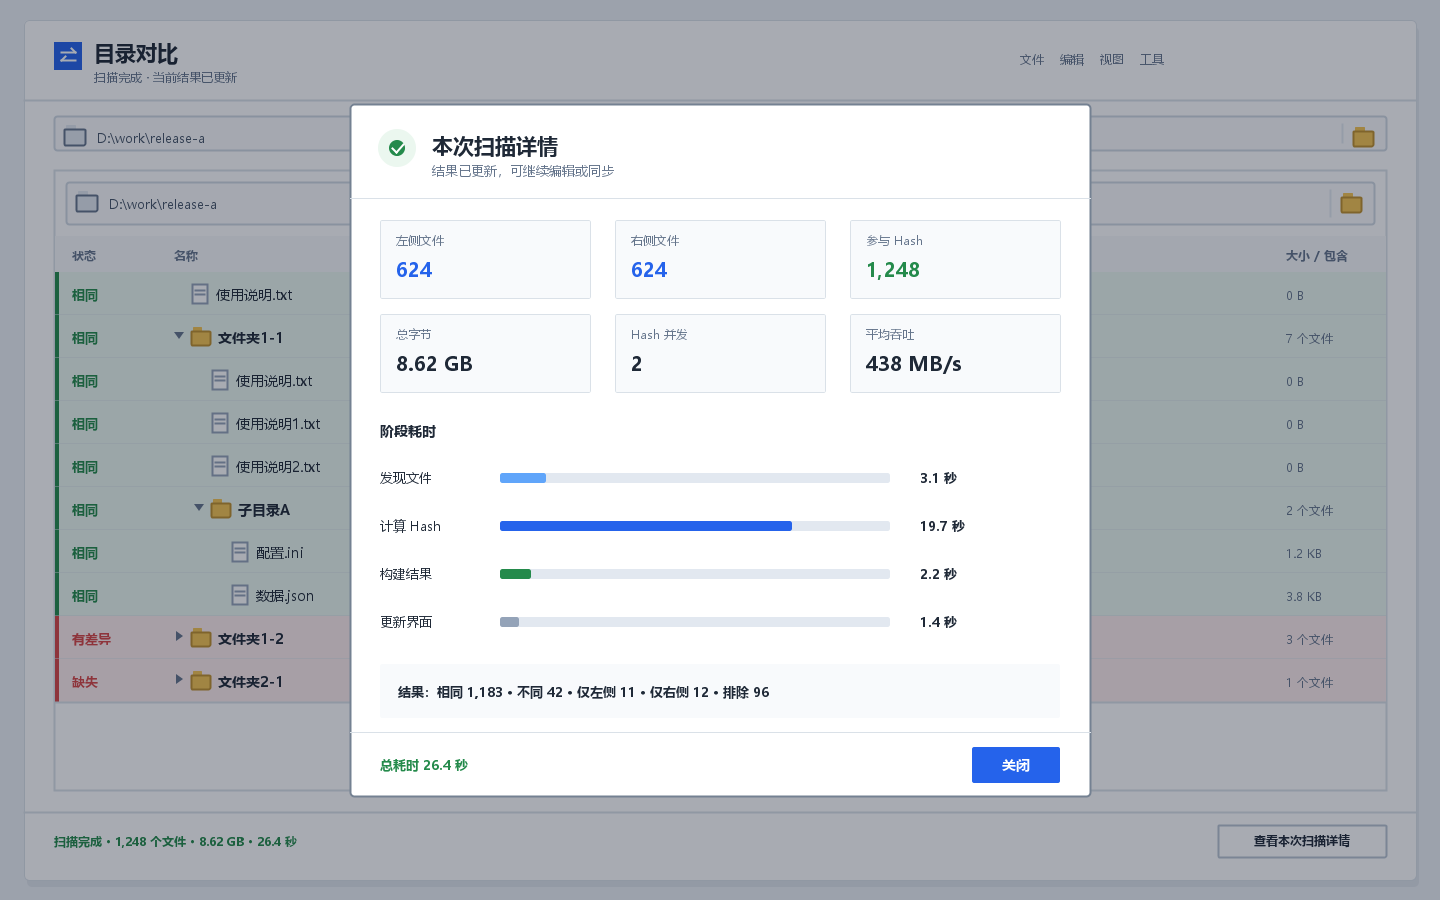
详情里显示文件数、总字节、Hash 并发数、发现耗时、Hash 耗时、构建耗时、界面更新时间和平均吞吐量。
方案确认后,才开始修改正式扫描代码。
第一步不是开线程,而是拆掉旧扫描流程
旧实现把目录遍历、过滤、文件读取和 SHA-256 全部写在主窗口里。
核心结构类似这样:
Files.walkFileTree(root, new SimpleFileVisitor<Path>() {
    @Override
    public FileVisitResult visitFile(Path file, BasicFileAttributes attrs)
            throws IOException {
        snapshot.files.put(relativePath,
                new FileInfo(file, relativePath, attrs.size(),
                        attrs.lastModifiedTime().toMillis(), hash(file)));
        return FileVisitResult.CONTINUE;
    }
});
每发现一个文件就立刻执行 hash(file)。这种写法拿不到最终文件数,也不能单独控制发现和 Hash 的并发。
本期新增了独立的 CompareScanService,主窗口不再负责读取文件正文。
新的数据流是:
ScanRequest
  ↓
Directory Discovery
  ↓
List<FileCandidate>
  ↓
Parallel Hash
  ↓
ScanResult
  ↓
CompareResult + CompareNode
  ↓
Swing Table Model
FileCandidate 在发现阶段只保存:
side
absolutePath
relativePath
size
modifiedTime
进入 Hash 前,候选列表冻结。这样可以准确计算总文件数和总字节数,也能根据任务规模决定并发数。
扫描核心不依赖 Swing。临时目录测试可以直接调用服务,验证 Hash、取消和异常,不需要先打开主窗口再模拟按钮。
左右目录可以并行发现,但 Hash 不能随便开线程
左右目录发现最多使用两个任务,每侧一个。发现过程主要读取目录项和文件属性,不读取完整文件内容。
Hash 阶段没有简单按 CPU 核数开线程。
文件 Hash 同时受磁盘读取和 CPU 影响。线程越多,不代表越快:
- 同一块机械硬盘上并发读多个文件,磁头来回寻道可能更慢。
- 网络共享高并发会放大延迟和服务端压力。
- 大量小文件的瓶颈可能是目录和文件打开次数。
- 少量文件本身没有必要创建多线程调度。
Java 8 标准 API 也不能可靠识别本地磁盘到底是 SSD 还是机械硬盘。因此程序没有显示一个看起来很专业、实际上不可靠的“磁盘类型识别”。
当前采用保守策略:
| 条件 | Hash 线程数 |
|---|---|
| 文件对比 | 1 |
| 候选文件少于 64 个 | 1 |
| 总字节少于 64 MB | 1 |
| UNC、SMB、CIFS、NFS 等网络路径 | 1 |
左右目录位于同一个本地 FileStore | 最多 2 |
左右目录位于不同本地 FileStore | 最多 4 |
| CPU 不超过 2 核 | 1 |
全局硬上限是 4。
每个线程使用 1 MB 读取缓冲区,Hash 额外缓冲内存最多约 4 MB。后续如果真实项目数据证明同盘两个线程仍然会让某些机械盘退化,再增加可持久化的性能设置,不在这一期先放一个复杂线程数输入框。
文件多时,不能给每个文件创建一个 Future
如果目录里有几十万个文件,为每个文件调用一次 submit(),会同时创建大量任务对象,并把它们放进线程池队列。
本期使用固定工作线程和一个原子索引:
worker 1 ─┐
worker 2 ─┼─> AtomicInteger nextIndex ─> candidates
worker N ─┘
每个线程完成当前文件后,通过 nextIndex.getAndIncrement() 领取下一项。线程总数固定,候选文件再多也不会生成同等数量的 Future。
左右候选按顺序交错放入列表,避免先把左侧全部算完,再开始右侧。
取消不是调用 Thread.stop
扫描任务可以停,但不能用强制终止线程的方式处理。
本期使用共享 CancellationToken,内部是 AtomicBoolean。以下位置都会检查:
- 进入目录前。
- 访问文件时。
- Hash 线程领取下一项前。
- 每读取 1 MB 内容后。
- Hash 完成准备提交结果前。
- 构建结果循环中。
- 每批 Swing 表格发布前。
点击取消后:
- 按钮变成“正在取消”。
- 设置取消令牌。
- 目录遍历停止继续访问。
- Hash 线程不再领取新文件。
- 正在读取的线程在下一个 1 MB 检查点关闭输入流。
- 后台任务完全退出后,界面显示“重新开始”。
没有在用户点击按钮的瞬间立即允许第二个扫描任务启动。否则旧任务还在读磁盘,新任务又建立一组线程,两批 I/O 会同时争抢资源。
下面是 960×620 最小窗口下的实际扫描界面:
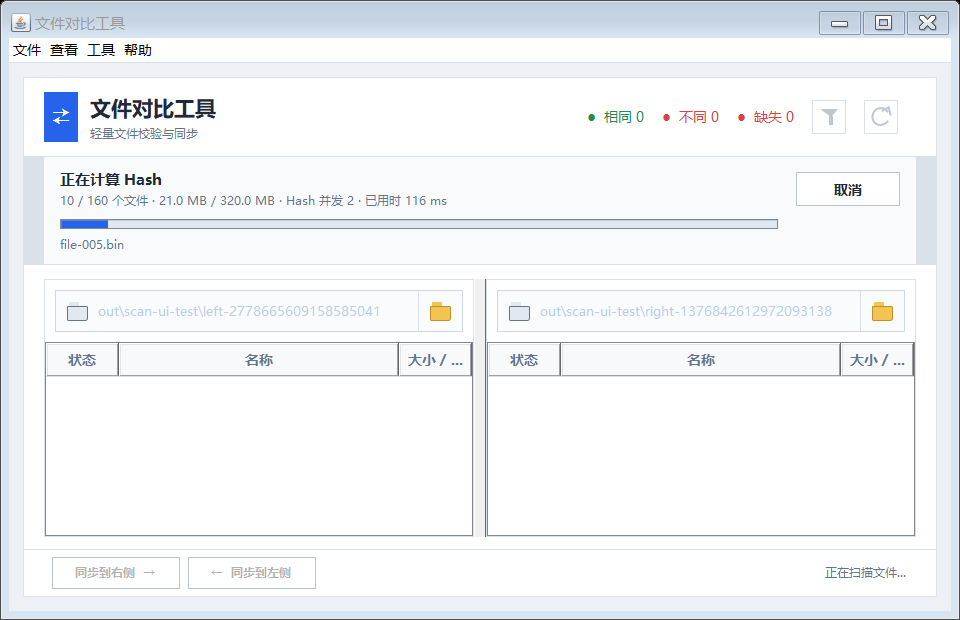
界面显示当前阶段、文件数、字节数、Hash 并发数、耗时和当前文件。长路径会在界面中间省略,完整路径保留在悬浮提示里。
取消后为什么还要保留旧结果
旧版开始新扫描时会先执行:
leftTableModel.setRowCount(0);
rightTableModel.setRowCount(0);
如果扫描失败,原来还能参考的结果也被清空了。
现在把 lastResult 当作已提交结果处理:
- 新任务开始:旧结果继续显示,只读。
- 新任务取消:旧结果不变。
- 新任务失败:旧结果不变。
- 新任务完整成功:提交新结果。
这和同步事务不是一回事,但思路相似:未完成的新结果不能替换已经可用的旧结果。
下面是实际取消后的状态:
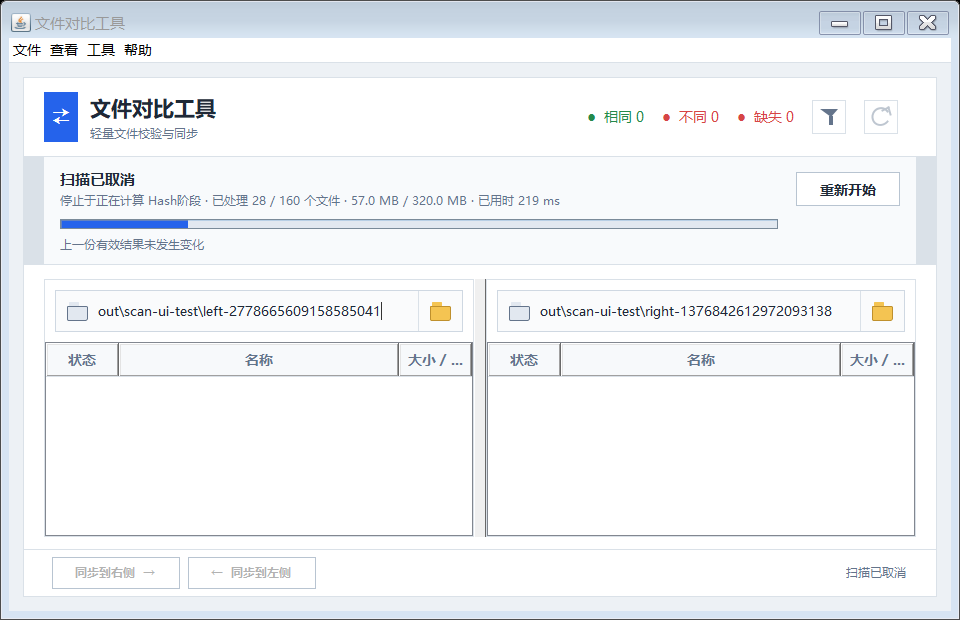
取消后路径仍然保留,状态区显示停止阶段、已处理文件和字节数,右侧可以直接重新开始。
旧任务不能覆盖新任务
有取消和重新开始以后,会出现一个并发边界:旧任务可能因为底层文件读取延迟,晚于新任务返回。
如果只在 SwingWorker.done() 里直接更新界面,就可能发生:
任务 1 开始
任务 1 取消
任务 2 开始
任务 2 完成并显示新结果
任务 1 延迟返回,又把旧结果盖回界面
所以每次扫描都有单调递增的 taskId。所有进度、完成结果和界面发布批次都携带任务编号。
EDT 更新前必须满足:
event.taskId == activeCompareTaskId
不匹配的事件直接丢弃。
窗口关闭时还会取消令牌并让当前任务 ID 失效,避免后台任务继续尝试更新已经销毁的 Swing 组件。
Hash 时文件变化,不能接受混合内容
扫描项目目录时,构建工具、日志程序或编辑器可能正在修改文件。
如果文件在 Hash 过程中发生变化,读取到的可能是前半段旧内容和后半段新内容。这个 Hash 既不对应修改前文件,也不对应修改后文件。
发现阶段已经记录文件大小和修改时间。Hash 完成后,程序重新读取属性:
- 大小和修改时间未变化:接受 Hash。
- 发生变化:回退第一次读取的进度字节,更新总字节,再 Hash 一次。
- 第二次仍变化:本次扫描失败。
这里没有无限重试。一个持续变化的日志文件如果一直重算,任务永远无法结束。
不可读文件也不会被静默跳过。
跳过以后生成的结果看起来完整,实际上少了一个未知文件,后续同步可能误判。因此本期采用严格语义:不可读文件让新任务失败,同时保留上一次有效结果,并显示失败路径。
进度事件也不能发得太勤
Hash 线程每读取 1 MB 都会更新原子字节计数,但不会每次都调用 Swing。
进度快照最多每 100 ms 发布一次。
如果每读取一个缓冲区就向 EDT publish(),高速磁盘和多个线程会产生大量界面事件。最终用户看到的不是更平滑的进度,而是事件队列拥堵、表格滚动卡顿。
后台线程只更新计数或生成不可变进度快照,Swing 组件只在 EDT 中读取最后一份快照。
结果分批准备,但旧表格不能提前清空
这一部分在实际检查时又改了一次。
最初虽然计划每批发布 200 行,但实现时如果先把当前表格清空,再逐批加入新行,用户仍然会看到旧结果突然消失。取消发生在发布阶段时,还需要复杂地把旧表格重新构建回来。
最后改成离屏准备:
- 后台构建完整目录树。
- EDT 每批最多 200 行写入新的左右表格模型。
- 旧表格模型继续显示。
- 新模型全部完成后,一次调用
setModel()切换。 - 最后才更新
lastResult并恢复同步和双击编辑。
因此“成功后才替换旧结果”不仅覆盖扫描和 Hash,也覆盖最后的界面发布阶段。
实施过程中修正的几个问题
这期不是代码一次写完就结束。测试和真实窗口检查中又发现了几处问题。
1. 读取失败被误判成取消
某个 Hash 工作线程读取失败后,需要通知其他线程停止。如果只共用一个取消标记,主窗口可能看到标记已设置,就把真实 I/O 异常显示成“用户取消”。
最终单独保留第一个 IOException。工作线程停止后,服务优先抛出真实失败;只有没有业务异常且用户主动设置令牌时,才进入取消状态。
2. 文件变大后进度可能超过 100%
第一次 Hash 期间文件变大,重试时如果只回退已读取字节,却不修正总字节,最终已处理字节可能超过发现阶段记录的总量。
现在重试时同时调整总字节,并在进度快照层再次限制已完成值不能超过总量。测试增加了明确断言。
3. 最小窗口按钮文字被截断
第一次真实截图中,取消后的“重新开始”按钮在 960px 宽度下显示成了省略号。
最后固定了任务操作按钮的最小宽度,再重新运行视觉测试。UI 效果图只能说明方向,真实 Swing 窗口仍然必须跑起来检查字体和布局。
4. 批量发布不能逐行触发表格事件
即使每批处理 200 行,如果内部仍循环调用 addRow(),就会产生 200 次表格事件。
最终每批直接向模型数据增加行,然后每侧只触发一次 fireTableRowsInserted()。
这次测试了哪些内容
本期新增 CompareScanServiceTest,真实创建左右目录和文件,覆盖:
- 左右目录发现。
- 目录过滤跳过整个子树。
- 相同文件 Hash 一致。
- 不同文件 Hash 不同。
- 文件对比固定单线程。
- 小任务固定单线程。
- 同一
FileStore并发不超过 2。 - 全局工作线程不超过 4。
- Hash 中途取消。
- 文件在 Hash 期间变化后重试一次。
- 重试后总字节正确调整。
- 文件被删除或无法读取时归类为失败,不误报取消。
- 已处理文件数和字节数不超过总量。
另外增加 CompareProgressVisualSmokeTest,在项目目录下生成左右各 80 个、每个 2 MB 的测试文件,完整执行:
启动主窗口
  ↓
自动选择左右目录
  ↓
进入 Hash 阶段
  ↓
截取扫描中界面
  ↓
点击取消
  ↓
检查重新开始按钮和保留状态
  ↓
重新扫描
  ↓
检查 80 行结果完整显示
窗口固定为 960×620,用来检查最小尺寸下的长路径、进度条、状态文字和按钮。
最后继续运行原有非视觉回归测试,包括:
- 过滤规则。
- 编码检测和保存。
- 换行保真。
- 文本差异算法。
- 差异行对齐。
- 差异块应用。
- 同步计划。
- 同步、备份和回滚集成测试。
Java 8 全源码和测试源码编译通过,现有测试全部通过。
这次实际修改了哪些内容
1. 扫描服务
- 新增独立
CompareScanService。 - 目录发现与 Hash 完全拆开。
- 左右目录最多两个发现任务。
- 生成不可变候选列表和准确总量。
- 文件变化自动重试一次。
- 不可读文件保持严格失败语义。
2. 并行 Hash
- 自动选择 1 到 4 个工作线程。
- 网络路径、小任务和文件模式保持串行。
- 同一个
FileStore最多两个线程。 - 固定线程通过原子索引领取文件。
- 每个线程使用 1 MB 缓冲区。
3. 任务与取消
- 增加取消令牌。
- 发现、Hash、构建和界面发布都检查取消。
- 后台任务完全结束后才允许重新开始。
- 任务 ID 过滤旧进度和旧结果。
- 关闭窗口时取消并解绑活动任务。
4. 结果保护
- 新扫描开始时不再清空旧结果。
- 取消和失败保留上一份有效结果。
- 新表格按每批 200 行离屏准备。
- 完整成功后一次切换左右模型。
5. Swing 界面
- 增加全宽扫描状态区。
- 显示阶段、文件数、字节数、排除数、并发数和当前路径。
- 增加取消、正在取消和重新开始状态。
- 增加本次扫描详情入口。
- 扫描期间旧结果可浏览,但禁止同步和双击编辑。
6. 测试与文档
- 增加扫描服务测试。
- 增加取消与重新开始视觉烟测。
- 生成扫描中和取消后真实截图。
- 更新 README、开发计划和 P2 实施方案。
- 开发计划中的扫描性能状态改为已完成。
最终版提示词
如果需要给一个现有 Java 8 Swing 文件工具增加同类扫描能力,可以直接使用下面这份提示词:
请继续开发一个现有的 Java 8 Swing 文件对比工具。工具已经支持文件和目录
SHA-256 对比、可折叠目录树、过滤规则、F5 刷新、联动滚动、差异块编辑、
编码与换行保真,以及同步预览、备份和失败回滚。

本次实现 P2“扫描进度、取消和受控并行 Hash”。当前实现使用一个
SwingWorker,先扫描并 Hash 左侧目录,再扫描并 Hash 右侧目录;开始任务时
会清空旧结果,界面只有不确定进度,不能取消。

功能和技术要求:

1. 将单次对比拆成发现文件、计算 Hash、构建结果和更新界面四个阶段。
2. 目录发现阶段只遍历目录、应用过滤规则并读取必要属性,不计算 Hash。
3. 发现阶段不知道最终总量,使用不确定进度条,实时显示左右文件数、
   已发现字节数、排除目录数、排除文件数和当前访问路径,不显示虚假百分比。
4. 发现完成后冻结文件候选列表,再计算准确总文件数和总字节数。
5. Hash 阶段以已读取字节/总字节为主进度,同时显示已完成文件/总文件。
6. 空文件虽然不增加读取字节,但完成后必须增加文件计数。
7. Hash 使用 1 MB 缓冲区,每读取一个缓冲区检查取消。
8. 后台计数可以高频更新,但 Swing 进度事件最多每 100 ms 发布一次,
   避免阻塞 EDT。
9. 增加受控并行策略,工作线程全局硬上限为 4。
10. 文件模式、候选少于 64 个、总字节少于 64 MB、CPU 不超过 2 核、
    UNC/SMB/CIFS/NFS 网络路径使用 1 个 Hash 线程。
11. 左右目录位于同一个本地 FileStore 时最多 2 个线程;位于不同本地
    FileStore 时最多 4 个线程。
12. Java 8 无法可靠识别 SSD/HDD,不得在 UI 中显示伪磁盘类型或基于
    不可靠结果承诺性能。
13. 不为每个文件创建 Future。固定工作线程通过 AtomicInteger 原子索引
    从不可变候选列表领取下一项,避免大目录产生海量任务对象。
14. 左右候选交错排列,并发上限是全局上限,不是左右各创建一组线程。
15. 增加 CancellationToken,在进入目录、访问文件、领取 Hash 项、每个
    1 MB 读取块、结果构建循环和每批 EDT 发布前检查。
16. 点击取消不二次确认。按钮立即显示正在取消,后台线程完全退出后再显示
    重新开始,不允许新旧两个 I/O 任务同时运行。
17. 每次任务分配单调递增 taskId。所有进度、完成结果和 EDT 发布批次必须
    校验 taskId,旧任务不能覆盖当前进度或结果。
18. 新任务开始时保留上一份有效结果。扫描期间允许滚动和展开旧结果,
    但禁用同步和双击编辑。
19. 取消或失败不得清空、替换上一份有效结果;首次扫描取消时保留已选路径。
20. 完整成功前不得更新 lastResult。后台先构建目录树,再按每批最多 200 行
    在 EDT 中准备新的左右表格模型,全部完成后一次替换旧模型。
21. 每批表格更新每侧只触发一次 fireTableRowsInserted,不能逐行产生事件。
22. 发现阶段记录文件大小和修改时间。Hash 完成后重新读取属性,属性变化时
    回退第一次读取进度并重试一次;第二次仍变化则让本次任务失败。
23. 文件重试后必须修正总字节,进度中的已完成文件和字节永远不能超过总量。
24. 不可读、被删除或持续变化文件让本次任务失败并显示阶段、侧别和路径,
    不能静默跳过,也不能误报成用户取消。
25. 关闭窗口、返回首页或切换模式时取消并解绑活动任务,后台事件不能访问
    已销毁 Swing 组件。
26. 主界面增加全宽扫描状态区,显示阶段、进度、统计、当前路径和取消按钮。
    长路径中间省略,并通过 tooltip 显示完整路径。
27. 取消后状态区常驻,显示停止阶段、处理量、耗时、结果是否保留和重新开始。
28. 正常完成后不自动弹窗。通过底部状态或工具菜单打开本次扫描详情,显示
    左右文件数、总字节、排除数、实际并发数、Hash 重试数、各阶段耗时、
    总耗时和平均吞吐量。
29. 将扫描核心拆成不依赖 Swing 的服务,便于临时目录测试。
30. 增加测试,至少覆盖空目录、中文和深层路径、过滤子树、串行与并行 Hash
    一致性、并发上限、发现取消、Hash 取消、文件变化重试、持续变化、读取失败、
    进度边界、旧任务隔离、取消保留旧结果和分批发布。
31. 完成后使用 Java 8 编译全部源码和测试,运行现有编码、换行、差异块、
    同步和回滚回归测试。
32. 启动真实 Swing 窗口,在 960×620 和 1280×760 下使用大量测试文件检查
    扫描中、取消、重新开始、完成详情、长路径和按钮文字,并生成最终截图。

修改前先阅读现有扫描实现和开发计划,给出实施计划、进度口径、取消语义、
并发策略、错误处理和 UI 效果图。我确认后再修改正式代码。实现完成后更新
README、开发计划、P2 实施方案,并记录实际测试结果。
下一步
按照开发计划,扫描性能完成后,下一项准备做 P2“对比历史缓存”。
目前每次启动程序都要重新选择左右路径。实际工作里经常反复检查同一组项目目录,例如开发目录和发布目录、配置模板和环境配置、两个版本的部署包。
下一步计划保存最近使用过的文件或目录对比任务,包括:
- 对比模式。
- 左右路径。
- 当时使用的过滤条件或预设。
- 最近打开时间。
历史记录只负责恢复任务,不直接缓存旧结果。点击历史记录后仍然要检查路径并重新扫描,避免磁盘内容已经变化,界面却展示过期状态。
后面还有过滤规则持久化与预设、窗口和偏好设置、发布打包。顺序继续按开发计划推进。
最后
这期最直观的变化是一条进度条和一个取消按钮,但真正完成的是扫描任务的边界。
以前点击对比以后,程序只有“开始”和“结束”两个状态。现在它知道自己在发现文件、读取 Hash、构建结果还是更新界面,也知道什么时候可以安全停止、什么时候可以提交新结果。
并行 Hash 也没有追求线程越多越好。磁盘 I/O 和 CPU 计算不是同一种负载,同盘、跨盘、网络路径和小任务需要不同策略。先用 1 到 4 个线程做保守控制,比把处理器核心数全部开满更适合一个桌面文件工具。
当前使用体验仍然不算完整。程序还不能从最近对比中一键恢复任务,过滤规则关闭后不会保留,也没有提供用户可调的性能策略;扫描完成详情目前只保存本次数据,没有长期性能记录。
后面继续按开发计划优化。下一期先处理对比历史缓存,让经常使用的左右目录不用每次重新选择。
更多推荐


 11
 0
- 0


 已为社区贡献15条内容

所有评论(0)