
机器学习入门:决策树(Decision Tree)
机器学习入门:决策树(Decision Tree)
前言:本文是“机器学习入门”系列的第四站。前两篇我们学习了 KNN 和逻辑回归,它们属于“参数化”或“基于距离”的模型。本篇将进入一个全新的流派——基于规则的树模型。决策树是一类白盒模型,决策过程如同“如果……那么……”的流程图,人类完全能够看懂并解释预测结果。我们将从信息熵、基尼系数出发,理清 ID3、C4.5、CART 三种主流算法的原理,并讲解如何通过剪枝防止过拟合。
目录
- 一、认识决策树
- 二、特征选择的核心指标
- 三、三大主流算法详解
- 四、过拟合与剪枝策略
- 五、算法对比与应用场景
- 六、决策树核心 API 速查
- 七、实战案例
- 八、总结
一、认识决策树
在机器学习的世界里,大部分算法(如逻辑回归、SVM)都像是一个“黑盒”,输入数据得出结果,但很难解释它为什么这么判断。而决策树(Decision Tree)是一个真正的白盒模型。
1.1 什么是决策树?
决策树是一种有监督学习算法。它通过学习训练样本,建立一套分类规则,然后依据这套规则对新数据进行分类预测。
核心思想:所有数据从根节点开始,经过一层一层的条件判断(内部节点),最终落定在叶子节点上,得出分类结果。
1.2 树的结构
一棵标准的决策树由以下三部分组成:
- 根节点(Root Node):树的起点,包含所有训练样本,决定最初的分支特征。
- 内部节点(Internal Node):中间的判断节点(例如:“年龄是否大于30岁?”、“是否有房?”)。
- 叶子节点(Leaf Node):树的最末端,代表最终的分类结果,不再继续分裂。
1.3 通俗理解
可以把决策树想象成一套用来猜谜语的“判断题”流程:
- 进入根节点,问第一个问题。
- 根据“是”或“否”的答案,走向不同的下一个问题。
- 一路问下去,直到最后得出一个明确的“结论”(叶子节点)。
1.4 三个核心问题
构建一棵高性能的决策树,需要解决三个核心问题:
- 特征选择:哪个特征作为根节点?哪些特征作为内部节点?
- 节点分裂:分支的条件怎么定?
- 分裂标准:用什么数学指标来衡量一个特征到底“好”还是“不好”?
二、特征选择的核心指标
为了解决“分裂标准”的问题,我们需要引入信息论中的概念:熵(Entropy)。
2.1 信息熵(Entropy)
概念:熵表示随机变量的不确定性,通俗地说就是物体内部的混乱程度。
- 熵值越小 -> 节点越“纯”(大部分样本属于同一类)。
- 熵值越大 -> 节点越“混乱”(各类样本混杂在一起)。
计算公式:
H
(
X
)
=
−
∑
i
=
1
n
p
i
log
2
p
i
H(X) = -\sum_{i=1}^{n} p_i \log_2 p_i
H(X)=−i=1∑npilog2pi
举例对比:
- A集合:
[1, 1, 1, 1, 1, 1, 1, 1, 2, 2](绝大多数是1)
熵值 ≈ 0.722(混乱度低,纯度高) - B集合:
[0, 1, 2, 3, 4, 5, 6, 7, 8, 9](十个样本各不相同)
熵值 = 3.322(混乱度极高)
结论:我们希望分裂后的子节点熵值越来越小,直至达到叶子节点时熵值接近0。
三、三大主流算法详解
围绕如何度量“混乱程度”和“特征好坏”,诞生了三种经典的决策树算法。
3.1 ID3 算法(信息增益)
ID3 算法依据**信息增益(Information Gain)**来选择特征。
计算公式:
信息增益 = 分裂前的熵 - 分裂后的条件熵。增益越大,说明该特征让数据变得越“纯”。
经典手算推演(“打网球”数据集):
假设有14天样本,9天打球(Yes),5天不打球(No)。
-
计算根节点总熵值:
H ( D ) = − 9 14 log 2 9 14 − 5 14 log 2 5 14 = 0.940 H(D) = - \frac{9}{14}\log_2\frac{9}{14} - \frac{5}{14}\log_2\frac{5}{14} = 0.940 H(D)=−149log2149−145log2145=0.940 -
以“天气”特征为例计算条件熵:
- 晴天5天(2天Yes,3天No),熵值 = 0.971
- 阴天4天(全Yes),熵值 = 0(因为已经很纯了)
- 雨天5天(3天Yes,2天No),熵值 = 0.971
- 天气的加权条件熵 =
5 14 × 0.971 + 4 14 × 0 + 5 14 × 0.971 = 0.693 \frac{5}{14} \times 0.971 + \frac{4}{14} \times 0 + \frac{5}{14} \times 0.971 = 0.693 145×0.971+144×0+145×0.971=0.693
-
计算“天气”特征的信息增益:
G a i n ( 天气 ) = 0.940 − 0.693 = 0.247 Gain(天气) = 0.940 - 0.693 = 0.247 Gain(天气)=0.940−0.693=0.247 -
遍历其余特征:
- 温度信息增益:0.029
- 湿度信息增益:0.151
- 有风信息增益:0.048
结论:信息增益排序为 天气(0.247) > 湿度(0.151) > 有风(0.048) > 温度(0.029)。因此 ID3 选择“天气”作为根节点。
ID3 的局限性:ID3 偏好选择取值较多的特征。例如,如果有“客户编号”这种每个样本都不同的特征,它会算出极高的信息增益,导致错误选择。
3.2 C4.5 算法(信息增益率)
为了克服 ID3 的局限性,C4.5 引入了信息增益率(Gain Ratio)。
计算公式:
G
a
i
n
R
a
t
i
o
(
D
,
A
)
=
G
a
i
n
(
D
,
A
)
H
(
A
)
GainRatio(D, A) = \frac{Gain(D, A)}{H(A)}
GainRatio(D,A)=H(A)Gain(D,A)
其中 ( H(A) ) 是特征自身的固有熵值(作为惩罚项)。
手算对比:
在“打网球”的数据中,C4.5 算出的增益率排序依然是:天气 > 湿度 > 有风 > 温度。
但在有“编号”这种特征的数据中,C4.5 会通过除以其非常大的固有熵值,把它的增益率拉低,从而有效避免错误选择。
3.3 CART 算法(基尼系数)
CART(Classification and Regression Tree)是目前工业界最常用的算法。它使用的是基尼系数(Gini Index),而不是熵。基尼系数越小,样本越纯。
二分类基尼系数公式:
G
i
n
i
(
p
)
=
2
p
(
1
−
p
)
Gini(p) = 2p(1-p)
Gini(p)=2p(1−p)
(( p ) 为某类样本在该节点中的占比)
手算推演(经典“银行信贷”数据集):
假设有15个客户,9人贷款,6人未贷。我们看“是否有房”这个特征:
-
有房客户(6人,其中5人贷款,1人未贷)的基尼系数:
G i n i ( 有房 ) = 2 × 5 6 × ( 1 − 5 6 ) = 0.2778 Gini(有房) = 2 \times \frac{5}{6} \times (1-\frac{5}{6}) = 0.2778 Gini(有房)=2×65×(1−65)=0.2778 -
无房客户(9人,其中4人贷款,5人未贷)的基尼系数:
G i n i ( 无房 ) = 2 × 4 9 × ( 1 − 4 9 ) = 0.4938 Gini(无房) = 2 \times \frac{4}{9} \times (1-\frac{4}{9}) = 0.4938 Gini(无房)=2×94×(1−94)=0.4938 -
“有房”特征的加权平均基尼系数(即数据集在该特征下的总体不纯度):
G i n i ( D , 有房 ) = 6 15 × 0.2778 + 9 15 × 0.4938 = 0.4074 Gini(D, 有房) = \frac{6}{15} \times 0.2778 + \frac{9}{15} \times 0.4938 = 0.4074 Gini(D,有房)=156×0.2778+159×0.4938=0.4074
经过计算,其他特征的基尼系数均大于这个值,因此 CART 算法选择“是否有房”作为根节点。
四、过拟合与剪枝策略
4.1 为什么要剪枝?
如果对决策树不加限制,它会一直分裂到每个叶子节点只有一个样本为止。这会导致训练集准确率 100%,但在新数据上表现极差。这种现象叫作 过拟合(Overfitting)。
4.2 预剪枝策略
预剪枝是指在构建树的过程中提前停止分裂。最常用的预剪枝方法有:
- 限制树的深度:限定树最多长多少层。
- 限制叶子节点的最小样本数:如果分裂后某个叶子节点的样本数少于指定值,就不允许继续分裂。
- 限制信息增益/基尼系数的下降阈值:如果分裂带来的纯度提升不够大,则停止分裂。
五、算法对比与应用场景
5.1 核心对比
| 算法 | 分裂标准 | 分支数量 | 数据类型 | 特点 |
|---|---|---|---|---|
| ID3 | 信息增益 | 多叉树 | 离散型 | 简单,但偏好取值多的特征 |
| C4.5 | 信息增益率 | 多叉树 | 离散+连续 | 改进了ID3,可处理缺失值 |
| CART | 基尼系数 | 二叉树 | 离散+连续 | 速度快,分类回归皆可,工业首选 |
5.2 典型应用场景
- 金融风控:信用评分,判断客户是否会违约。
- 医疗诊断:根据体检指标判断患病的概率。
- 用户流失预测:判断客户下个月是否会注销账户。
六、决策树核心 API 速查
6.1 导包方式
分类任务与回归任务分别从 sklearn.tree 中导入对应的类:
- 分类:
DecisionTreeClassifier - 回归:
DecisionTreeRegressor
其他常配套使用的模块包括:数据集划分(train_test_split)、交叉验证(cross_val_score)以及各类评估指标(分类报告、混淆矩阵、MSE、R² 等)。
6.2 核心参数详解
决策树的参数可分为两类:树结构参数和剪枝参数。
| 参数名 | 类型 | 默认值 | 说明 |
|---|---|---|---|
| 树结构参数 | |||
criterion | str | "gini" | 分裂标准。分类可选 "gini"(基尼系数)或 "entropy"(信息增益),回归固定为 "squared_error"(均方误差) |
max_depth | int / None | None | 树的最大深度,默认 None 表示不限制(树会完全生长),推荐手动设置(如 3~15)以防过拟合 |
min_samples_split | int / float | 2 | 内部节点再分裂所需的最小样本数,值越大,树越保守 |
min_samples_leaf | int / float | 1 | 叶节点所需的最小样本数,值越大,树越平滑 |
max_features | int / str / float | None | 每次分裂时考虑的最大特征数,设为 "sqrt" 可增加随机性 |
| 剪枝参数 | |||
max_leaf_nodes | int / None | None | 树的最大叶节点数,限制叶节点数量可有效控制过拟合 |
min_impurity_decrease | float | 0.0 | 节点分裂所需的最小不纯度减少量,值越大,分裂越谨慎 |
ccp_alpha | float | 0.0 | 代价复杂度剪枝参数,值越大,剪枝力度越强(sklearn 0.22+ 支持) |
| 其他参数 | |||
class_weight | dict / "balanced" | None | 类别权重,设为 "balanced" 可自动处理类别不平衡 |
random_state | int / None | None | 随机种子,固定后结果可复现 |
6.3 常用属性
训练完成后,可通过以下属性获取模型内部信息:
| 属性名 | 说明 |
|---|---|
feature_importances_ | 特征重要性(最常用),返回长度为特征数的数组,值越大表示该特征对预测越关键 |
tree_ | 底层的树对象,可获取树的结构信息(如节点数、深度等) |
n_features_in_ | 训练时使用的特征数量 |
classes_ | 分类任务中所有类别的标签(分类模型专属) |
n_classes_ | 分类任务中的类别数量(分类模型专属) |
6.4 常用方法
| 方法名 | 适用任务 | 说明 |
|---|---|---|
fit(X, y) | 分类 / 回归 | 训练模型,一切开始的地方 |
predict(X) | 分类 / 回归 | 预测新样本的类别(分类)或数值(回归) |
predict_proba(X) | 分类专属 | 预测新样本属于每个类别的概率 |
score(X, y) | 分类 / 回归 | 返回评估分数:分类返回准确率,回归返回 R² 决定系数 |
apply(X) | 分类 / 回归 | 返回每个样本在树中落入的叶节点索引 |
get_depth() | 分类 / 回归 | 获取树的深度 |
get_n_leaves() | 分类 / 回归 | 获取树的叶节点数量 |
七、实战案例
7.1 分类树:电信客户流失预测
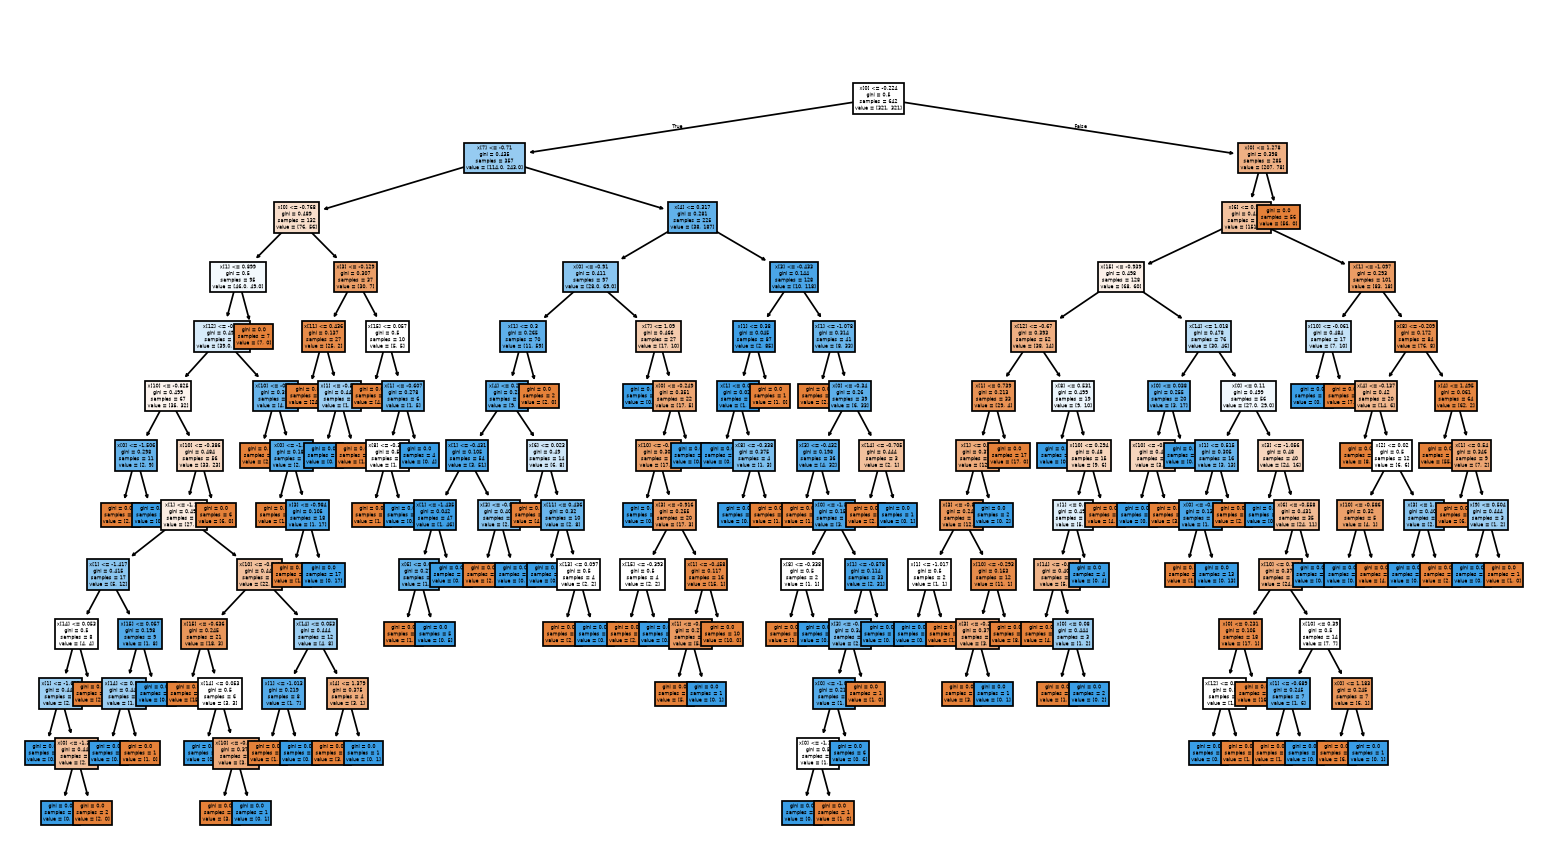
本案例使用电信客户流失数据,预测客户是否会流失(二分类问题)。由于流失样本通常较少,我们使用 SMOTE 过采样 平衡正负样本,并利用 交叉验证 寻找最优的树深度,防止过拟合。
实现功能:
- 读取数据,提取特征与标签。
- 使用
StandardScaler进行数据标准化。 - 使用
SMOTE进行过采样平衡数据。 - 单参数调优:通过交叉验证寻找最优的树深度(
max_depth)。 - 训练最优模型,并输出分类报告与混淆矩阵。
import pandas as pd
import numpy as np
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn import tree
from sklearn.model_selection import cross_val_score
from sklearn import metrics
from imblearn.over_sampling import SMOTE
import matplotlib.pyplot as plt


def cm_plot(y, yp):
    from sklearn.metrics import confusion_matrix
    cm = confusion_matrix(y, yp)
    plt.matshow(cm, cmap=plt.cm.Reds)
    plt.colorbar()
    for x in range(len(cm)):
        for y in range(len(cm)):
            plt.annotate(cm[x, y], xy=(y, x), va='center', ha='center')
            plt.ylabel('True label')
            plt.xlabel('Predicted label')
    return plt


# ===================导入数据=========================
datas = pd.read_excel('电信客户流失数据.xlsx')
X = datas.iloc[:, :-1]
y = datas.iloc[:, -1]

# ===================数据标准化=========================
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# ===================划分训练集与测试集=========================
X_train_w, X_test_w, y_train_w, y_test_w = train_test_split(
    X_scaled, y, test_size=0.3, random_state=7
)

# ===================SMOTE 过采样=========================
oversampler = SMOTE(random_state=7)
X_train, y_train = oversampler.fit_resample(X_train_w, y_train_w)

# ===================交叉验证选择最优深度=========================
depth_range = [3, 5, 7, 10, 15, None]
best_score = -1
best_depth = 3

print("===== 交叉验证(8折)=====")
for depth in depth_range:
    dtr = tree.DecisionTreeClassifier(
        max_depth=depth,
        class_weight='balanced',
        random_state=7
    )
    scores = cross_val_score(dtr, X_train, y_train, cv=8, scoring='recall')
    score_mean = np.mean(scores)
    print(f'depth={str(depth):<5} | recall={score_mean:.4f}')

    if score_mean > best_score:
        best_score = score_mean
        best_depth = depth

print(f'\n最优深度: {best_depth}, 最优召回率: {best_score:.4f}')

# ===================使用最优深度训练模型=========================
dtr = tree.DecisionTreeClassifier(
    max_depth=best_depth,
    class_weight='balanced',
    random_state=7
)
dtr.fit(X_train, y_train)

# ===================训练集评估=========================
train_pred = dtr.predict(X_train)
print("\n训练集分类报告:")
print(metrics.classification_report(y_train, train_pred, digits=6))
cm_plot(y_train, train_pred).show()

# ===================测试集评估=========================
test_pred = dtr.predict(X_test_w)
print("\n测试集分类报告:")
print(metrics.classification_report(y_test_w, test_pred, digits=6))
cm_plot(y_test_w, test_pred).show()

# ===================可视化决策树=========================
from sklearn.tree import plot_tree
fig, ax = plt.subplots(figsize=(32, 32))
plot_tree(dtr, filled=True, ax=ax)
plt.show()
输出示例:
开始单参数优化:寻找最优树深度 (max_depth)
depth=3     | recall=0.6985
depth=5     | recall=0.7669
depth=7     | recall=0.7669
depth=10    | recall=0.7732
depth=15    | recall=0.7858
depth=None  | recall=0.7858
最优树深度:15
最优召回率:0.7858

【训练集评估报告】
              precision    recall  f1-score   support

           0   1.000000  1.000000  1.000000       321
           1   1.000000  1.000000  1.000000       321

    accuracy                       1.000000       642
   macro avg   1.000000  1.000000  1.000000       642
weighted avg   1.000000  1.000000  1.000000       642


【测试集评估报告】
              precision    recall  f1-score   support

           0   0.783333  0.752000  0.767347       125
           1   0.483333  0.527273  0.504348        55

    accuracy                       0.683333       180
   macro avg   0.633333  0.639636  0.635847       180
weighted avg   0.691667  0.683333  0.686986       180
7.2 回归树:人体血压预测(小样本示例)
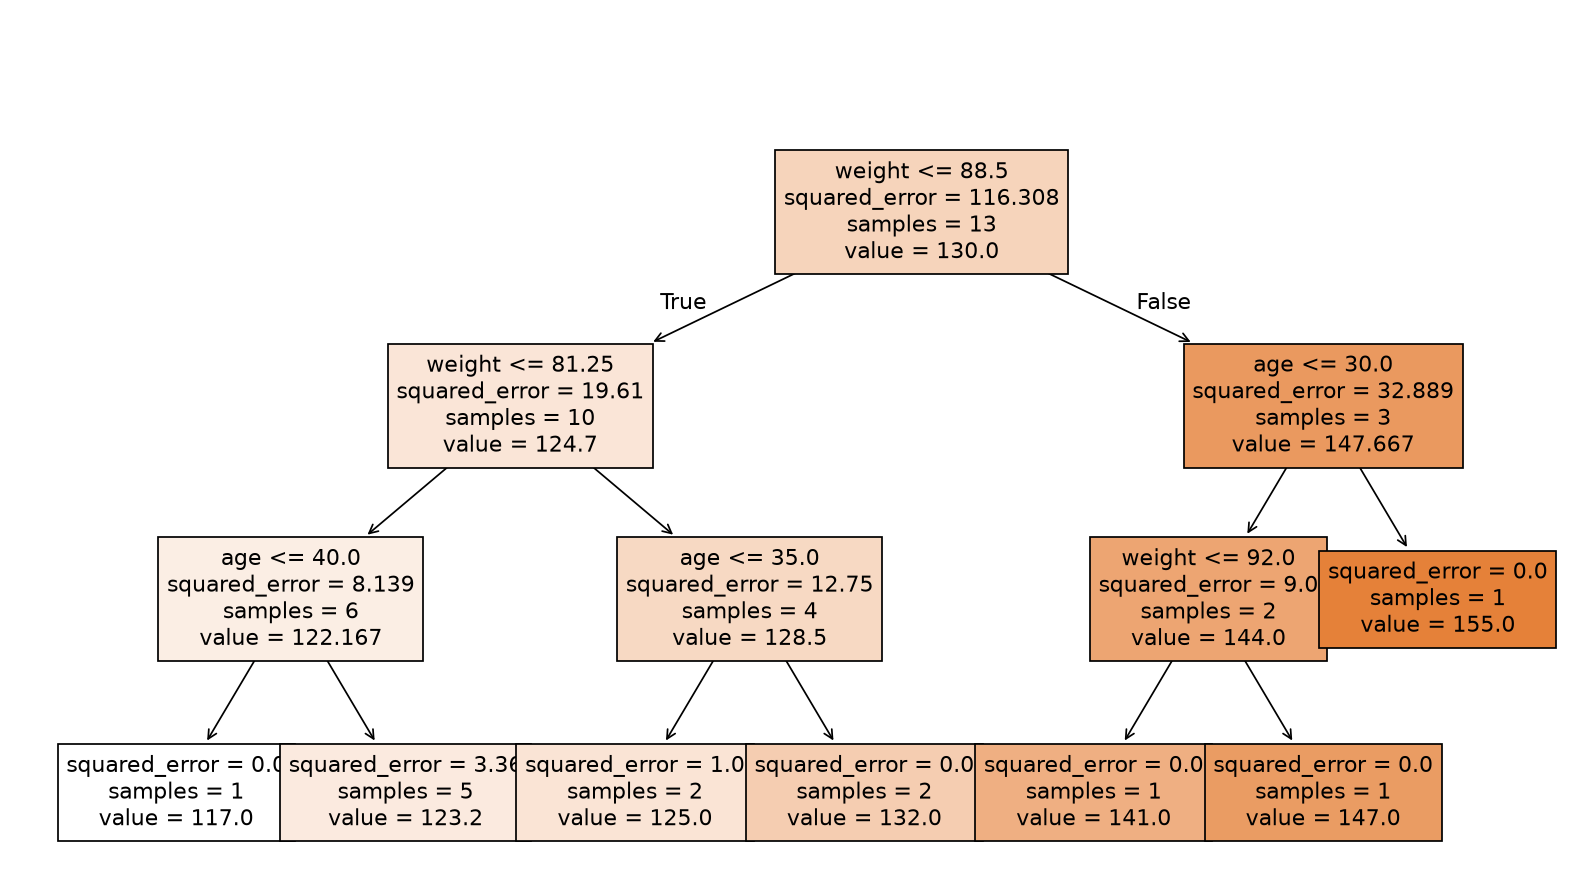
本案例使用多元线性回归数据集(包含体重和年龄),预测人体的收缩压。由于样本量极少(仅做演示),这里不划分测试集,而是直接用全量数据训练并验证模型在训练集上的拟合程度。
实现功能:
- 读取数据,提取特征(体重、年龄)与目标(血压)。
- 使用 DecisionTreeRegressor 构建回归树。
- 设置 max_depth=3 限制树深度防止过拟合。
- 输出 R² 决定系数 评估模型拟合效果。
import pandas as pd
from sklearn import tree
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

# ===================导入数据=========================
data = pd.read_csv('多元线性回归.csv', encoding="gbk", engine="python")

# ===================划分特征与标签=========================
X = data[['体重', '年龄']]
y = data['血压收缩']

# ===================训练回归树模型=========================
dtr = tree.DecisionTreeRegressor(
    max_depth=3,
    min_samples_split=2,
    random_state=7
)
dtr.fit(X, y)

# ===================模型评估=========================
score = dtr.score(X, y)
print(f"模型在训练集上的 R² 决定系数:{score:.4f}")

# ===================可视化回归树=========================
fig, ax = plt.subplots(figsize=(20, 12))
plot_tree(dtr, filled=True, ax=ax, feature_names=['体重', '年龄'])
plt.show()
输出示例:
模型在训练集上的 R² 决定系数:0.9876
八、总结
核心知识点速查
| 知识点 | 关键概念 |
|---|---|
| 树的结构 | 根节点、内部节点、叶子节点 |
| 熵与基尼系数 | 衡量节点纯度 |
| ID3 算法 | 信息增益(偏好取值多的特征) |
| C4.5 算法 | 信息增益率(改进 ID3) |
| CART 算法 | 基尼系数(二叉树,工业首选) |
| 过拟合 | 树太深,泛化能力差 |
| 预剪枝 | 限制深度、限制叶子节点样本数 |
| 后剪枝 | ccp_alpha 代价复杂度剪枝 |
核心 API 一览
| 用途 | 对应模块 / 方法 |
|---|---|
| 分类模型 | sklearn.tree.DecisionTreeClassifier |
| 回归模型 | sklearn.tree.DecisionTreeRegressor |
| 训练 | fit(X, y) |
| 预测 | predict(X) |
| 概率预测(分类) | predict_proba(X) |
| 特征重要性 | feature_importances_ |
| 树结构可视化 | sklearn.tree.plot_tree |
注意事项
| 要点 | 说明 |
|---|---|
| 白盒模型 | 决策过程完全可视化,易于解释 |
| 无需标准化 | 决策树不依赖特征缩放(与 KNN / 逻辑回归不同) |
| 防过拟合 | 必须使用预剪枝或后剪枝 |
| 缺失值 | C4.5 和 CART 天然支持缺失值处理 |
| 类别不平衡 | 设置 class_weight='balanced' 可缓解 |
系列直达
- 上篇:机器学习入门:逻辑回归(Logistic Regression)
- 本篇:机器学习入门:决策树(Decision Tree)(本文)
- 下篇:机器学习入门:随机森林(Random Forest)
更多推荐

 9
 0
- 0


 已为社区贡献15条内容

所有评论(0)