
知识库问答平台(基于FastAPI + Milvus + 阿里云百炼大模型)
知识库问答平台
版本: 1.0.0
Python: 3.13+
框架: FastAPI + Milvus + 阿里云百炼大模型
最后更新: 2026-08-04
目录
1. 项目概述
1.1 项目简介
知识库问答平台是一个基于 检索增强生成(Retrieval-Augmented Generation) 技术的企业级智能问答平台。系统支持多租户、多部门的文档管理,通过混合检索(Dense + BM25)和重排序(Rerank)技术,结合大语言模型生成准确、有依据的回答。
1.2 核心特性
| 特性 | 说明 |
|---|---|
| 多租户隔离 | 基于 tenant_id 分区键实现数据隔离,支持多企业共用 |
| 权限控制 | 管理员/员工两级角色,支持公司级/部门级文档可见性 |
| 混合检索 | Dense 向量检索 + BM25 关键词检索,融合排序(RRF) |
| 智能重排 | 专用 Rerank 模型对候选结果精排,提升回答质量 |
| 版本管理 | 文档支持多版本发布,自动去重,版本切换零停机 |
| 来源追溯 | 每个回答绑定引用来源 Chunk,可追溯至原始文档 |
| 拒答机制 | 知识库证据不足时明确拒答,避免模型幻觉 |
1.3 开发阶段
本项目按以下 5 个阶段递进开发:
- 用户授权 — 基于 Token 的身份切换与角色鉴权
- 文档分块 — Markdown 结构化智能切分
- 向量生成 — 文本转 Embedding 稠密向量
- Milvus 数据库 — 向量存储与混合检索
- 知识问答 — Dense + BM25 混合检索 + Rerank + 大模型回答
2. 系统架构
2.1 分层架构
┌─────────────────────────────────────────────────────────────┐
│                    前端层 (static/)                          │
│   index.html (完整功能)  |  chat.html (精简版)              │
└────────────────────────────┬────────────────────────────────┘
                             │ HTTP/REST API
┌────────────────────────────┴────────────────────────────────┐
│                    API 层 (app/api/)                         │
│   auth_api  |  ai_api  |  document_api  |  knowledge_api    │
│   路由定义  |  参数校验  |  依赖注入      |  响应序列化       │
└────────────────────────────┬────────────────────────────────┘
                             │
┌────────────────────────────┴────────────────────────────────┐
│                 Service 层 (app/service/)                    │
│   auth_service  |  ai_service  |  document_service  |  ...  │
│   业务编排      |  权限校验委托  |  文件校验                  │
└────────────────────────────┬────────────────────────────────┘
                             │
┌────────────────────────────┴────────────────────────────────┐
│                  DAO 层 (app/dao/)                           │
│   auth_dao  |  ai_dao  |  document_dao  |  knowledge_dao    │
│   Token解析 |  模型调用  |  入库流程      |  RAG 问答流程     │
└────────────────────────────┬────────────────────────────────┘
                             │
┌────────────────────────────┴────────────────────────────────┐
│                 Store 层 (app/store/)                        │
│         milvus_store (Milvus)  |  user_store (内存)          │
└────────────────────────────┬────────────────────────────────┘
                             │
┌────────────────────────────┴────────────────────────────────┐
│                 Utils 层 (app/utils/)                        │
│   embedding_model  |  filtering  |  markdown_chunker        │
└─────────────────────────────────────────────────────────────┘
2.2 数据流图
RAG 问答案例
用户提问
    │
    ▼
[1] KnowledgeApi.query(question)
    │
    ▼
[2] KnowledgeDao.query_knowledge()
    │
    ├──► [3] AiDao.create_embeddings([question])  → 问题向量
    │
    ├──► [4] MilvusStore.hybrid_search()           → 混合检索(Dense+BM25)
    │         └─ build_permission_filter(user)     → 权限过滤
    │
    ├──► [5] AiDao.rerank(question, chunks, top_n) → 重排序
    │
    ├──► [6] _build_prompt(question, chunks)       → 构造 Prompt
    │
    ├──► [7] AiDao.generate_answer(messages)       → LLM 生成答案
    │
    ├──► [8] _validate_answer()                    → 校验答案结构
    │
    └──► [9] 绑定来源 Chunk 详情                    → 返回完整结果
文档入库流程
上传 Markdown
    │
    ▼
[1] DocumentApi.create_document()
    │
    ▼
[2] DocumentService.assert_markdown()              → 校验格式/大小
    │
    ▼
[3] DocumentDao._save_version()
    │
    ├──► [4] normalize_markdown()                  → 统一换行符
    ├──► [5] chunk_markdown()                      → 智能分块
    ├──► [6] MilvusStore.query()                   → 查询历史记录
    ├──► [7] hash_text()                           → SHA-256 去重
    ├──► [8] AiDao.create_embeddings()             → 批量向量化
    ├──► [9] MilvusStore.insert()                  → 写入 Milvus
    ├──► [10] write_source()                       → 保存原始文件
    └──► [11] MilvusStore.set_active()             → 切换版本生效
3. 技术栈与依赖
3.1 核心依赖
| 包名 | 版本 | 用途 |
|---|---|---|
fastapi | >= 0.141.1 | Web 框架,提供异步 HTTP 接口 |
uvicorn | >= 0.52.0 | ASGI 服务器 |
pymilvus | >= 3.0.1 | Milvus 向量数据库 Python SDK |
sentence-transformers | >= 5.6.1 | HuggingFace 本地 Embedding/Rerank 模型(测试备选) |
pydantic-settings | >= 2.14.2 | 环境变量配置映射 |
python-multipart | >= 0.0.32 | 文件上传支持 |
3.2 外部服务
| 服务 | 用途 | 当前配置 |
|---|---|---|
| 阿里云百炼大模型 | 答案生成 | qwen3.7-max-preview |
| 阿里云 Embedding API | 文本向量化 | qwen3.7-text-embedding (512维) |
| 阿里云 Rerank API | 候选重排序 | qwen3-rerank |
| Zilliz Cloud Milvus | 向量存储与检索 | Serverless 杭州节点 |
3.3 开发工具
| 工具 | 用途 |
|---|---|
uv | Python 包管理与虚拟环境 |
Python 3.13 | 运行时版本 |
4. 环境准备
4.1 前置条件
- Python 3.13+
- uv 包管理器
- Milvus 实例(本地或 Zilliz Cloud)
- 阿里云百炼 API Key
4.2 安装步骤
1. 克隆项目
python后端:
git clone https://gitee.com/weh_coder/rag-knowledge-base.git
前端vue项目(可选):
git clone https://gitee.com/weh_coder/rag-search-vue.git
2. 安装依赖
使用 uv(推荐):
uv sync
或使用 pip:
pip install -r requirements.txt
3. 配置环境变量
在项目根目录创建 .env 文件:
# 应用配置
APP_TITLE=Rag知识问答
APP_VERSION=1.0.0
APP_DESCRIPTION=这是一个基于RAG的知识问答系统
APP_PORT=3000

# 大模型配置(答案生成)
AI_API_URL=https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions
AI_API_KEY=sk-your-api-key-here
AI_MODEL_NAME=qwen3.7-max-preview

# Embedding 模型配置(文本向量化)
EMBEDDING_API_URL=https://dashscope.aliyuncs.com/compatible-mode/v1/embeddings
EMBEDDING_MODEL_NAME=qwen3.7-text-embedding
EMBEDDING_DIMENSIONS=512

# Rerank 模型配置(重排序)
RERANK_API_URL=https://dashscope.aliyuncs.com/compatible-mode/v1/rerank
RERANK_MODEL_NAME=qwen3-rerank

# Milvus 数据库配置
MILVUS_ADDRESS=https://your-cluster.api.gcp-us-west1.zillizcloud.com
MILVUS_TOKEN=your-milvus-token
MILVUS_COLLECTION=rag_knowledge_base

# 存储配置
STORAGE_ROOT=./storage/documents
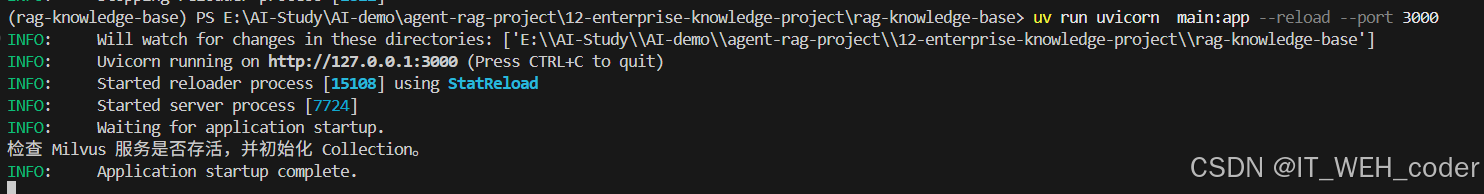
4. 启动服务
# 使用 uv
uv run uvicorn main:app --reload --port 3000

# 或直接运行
uv run python main.py
5. 验证服务
# 健康检查
curl http://127.0.0.1:3000/api/health

# 预期返回
# {"status":"ok","service":"rag-knowledge-base","timestamp":"2026-08-04T12:00:00+00:00"}
5. 项目结构
rag-knowledge-base/
│
├── .env                            # 环境变量配置(敏感信息,不提交 Git)
├── .gitignore                      # Git 忽略规则
├── .python-version                 # Python 版本指定:3.13
├── pyproject.toml                  # uv 项目配置与依赖声明
├── requirements.txt                # pip 兼容依赖列表
├── uv.lock                         # uv 锁定文件
├── main.py                         # FastAPI 应用入口
├── README.md                       # 项目概述
├── DEVELOPMENT_GUIDE.md            # 开发文档(本文档)
│
├── app/                            # 应用核心代码(分层架构)
│   │
│   ├── api/                        # API 路由层
│   │   ├── auth_api.py             # 授权认证接口
│   │   ├── ai_api.py               # AI 直接聊天接口
│   │   ├── document_api.py         # 文档 CRUD + 版本管理
│   │   └── knowledge_api.py        # RAG 知识问答接口
│   │
│   ├── config/                     # 配置层
│   │   ├── settings.py             # 全局 Pydantic Settings
│   │   └── milvus_config.py        # Milvus 连接配置
│   │
│   ├── dao/                        # 数据访问层(核心业务逻辑)
│   │   ├── auth_dao.py             # Token 解析、角色鉴权
│   │   ├── ai_dao.py               # Embedding/Rerank/LLM 统一封装
│   │   ├── document_dao.py         # 文档入库主流程
│   │   └── knowledge_dao.py        # RAG 问答主流程
│   │
│   ├── exception/                  # 异常定义
│   │   └── exceptions.py           # 统一业务异常基类 + HTTP 异常
│   │
│   ├── models/                     # 数据模型(dataclass)
│   │   ├── document.py             # 文档相关数据结构
│   │   ├── grounded_answer.py      # LLM 结构化回答
│   │   └── user.py                 # 用户身份数据结构
│   │
│   ├── service/                    # 业务服务层
│   │   ├── auth_service.py         # 授权服务(FastAPI 依赖)
│   │   ├── ai_service.py           # AI 聊天服务
│   │   ├── document_service.py     # 文档业务逻辑
│   │   └── knowledge_service.py    # 知识库问答服务
│   │
│   ├── store/                      # 存储层
│   │   ├── milvus_store.py         # Milvus 向量数据库封装
│   │   └── user_store.py           # 演示用户数据
│   │
│   └── utils/                      # 工具层
│       ├── embedding_model.py      # HuggingFace 本地模型(测试备选)
│       ├── filtering.py            # Milvus Filter 表达式构造
│       └── markdown_chunker.py     # Markdown 智能分块器
│
├── static/                         # 前端静态文件
│   ├── index.html                  # 完整版聊天室(~2590行)
│   ├── chat.html                   # 精简版聊天室(~960行)
│   └── favicon.svg                 # 网站图标
│
└── storage/                        # 文档原始文件存储
    └── documents/
        └── {tenant_id}/            # 按租户分目录
            └── {document_uuid}/    # 按文档 UUID 分目录
                ├── v1.md           # 版本 1
                ├── v2.md           # 版本 2
                └── ...
6. 核心模块详解
6.1 入口文件 main.py
入口文件负责:
- Lifespan 管理:启动时初始化 Milvus Collection,退出时关闭连接
- FastAPI 实例化:从
settings读取标题、版本、描述 - CORS 中间件:允许
http://localhost:5173和http://127.0.0.1:5173 - 路由注册:注册 4 个路由模块
- 异常处理:自定义
KnowledgeBaseError和RequestValidationError的 JSON 响应 - 静态文件挂载:将
static/目录挂载到根路径/
# 启动时初始化 Milvus Collection,退出时关闭连接
@asynccontextmanager
async def lifespan(_: FastAPI):
    milvus_store = MilvusStore()
    milvus_store.ensure_collection()
    try:
        yield
    finally:
        milvus_store.close()
6.2 配置层 app/config/
settings.py — 全局配置
使用 pydantic_settings.BaseSettings 从 .env 自动映射配置项:
| 配置项 | 环境变量 | 默认值 | 说明 |
|---|---|---|---|
app_title | APP_TITLE | Rag知识问答 | 应用名称 |
app_version | APP_VERSION | 1.0.0 | 应用版本 |
app_port | APP_PORT | 3000 | 服务端口 |
ai_api_url | AI_API_URL | - | 大模型 API 地址 |
ai_api_key | AI_API_KEY | - | 大模型 API Key |
ai_model_name | AI_MODEL_NAME | - | 大模型名称 |
embedding_api_url | EMBEDDING_API_URL | - | Embedding API 地址 |
embedding_model_name | EMBEDDING_MODEL_NAME | - | Embedding 模型名称 |
embedding_dimensions | EMBEDDING_DIMENSIONS | 512 | 向量维度 |
rerank_api_url | RERANK_API_URL | - | Rerank API 地址 |
rerank_model_name | RERANK_MODEL_NAME | - | Rerank 模型名称 |
milvus_address | MILVUS_ADDRESS | http://127.0.0.1:19530 | Milvus 地址 |
milvus_token | MILVUS_TOKEN | - | Milvus Token |
milvus_collection | MILVUS_COLLECTION | rag_knowledge_chunks | Collection 名称 |
storage_root | STORAGE_ROOT | ./storage/documents | 原始文件存储路径 |
通过 @lru_cache() 实现单例模式,避免重复加载。
milvus_config.py — Milvus 配置
封装 Milvus 连接参数,提供 URI 规范化功能(自动替换 localhost 为 127.0.0.1,添加 http:// 前缀)。
6.3 AI 数据访问层 app/dao/ai_dao.py
AiDao 是模型调用的统一封装层,包含三大核心功能:
create_embeddings(inputs) — 批量文本转向量
def create_embeddings(self, inputs: list[str]) -> list[list[float]]:
- 分批处理:每批 20 条,避免超过 API 限制
- 顺序恢复:按返回结果的
index字段排序,确保与输入顺序一致 - 备选方案:代码中保留了本地 HuggingFace 模型的调用入口(已注释)
rerank(question, chunks, top_n) — 重排序
def rerank(self, question: str, chunks: list[RetrievedChunk], top_n: int = 4) -> list[RetrievedChunk]:
- 使用远程 Rerank API 对候选 Chunk 重新打分
- 将
title和content拼接作为文档输入 - 返回按相关性分数降序排列的 Top-N 结果
generate_answer(prompt) — 生成答案
def generate_answer(self, prompt: list[dict[str, str]]) -> Any:
- 调用 LLM 生成 JSON 格式回答
- 重试机制:指数退避(0.4s → 0.8s → 1.6s),最多 3 次
- JSON 提取:支持从非纯 JSON 响应中提取 JSON 内容
- 请求参数:
temperature=0(确定性回答),response_format=json_object
call_llm() — 底层 HTTP 请求
def call_llm(*, url, body, api_key, max_attempts=3) -> tuple[int, dict]:
使用 urllib.request 发送请求,处理 429(限流)和 5xx(服务端错误)重试。
6.4 文档数据访问层 app/dao/document_dao.py
_save_version() — 文档入库主流程
这是系统最复杂的业务流程,包含 11 个步骤:
- 读取并规范化 Markdown(统一换行符为
\n) - 智能分块:调用
chunk_markdown()按标题层级切分 - 查询历史记录:判断是否已存在该文档
- 计算 SHA-256:用于内容去重
- 去重检查:内容/标题/部门/可见性均未变化则跳过
- 生成新版本号:
max(历史版本) + 1 - 批量向量化:为每个 Chunk 生成 Embedding
- 组装 Milvus 数据:Chunk + 向量 + 元数据
- 保存原始文件:写入
storage/documents/{tenant}/{doc_id}/v{version}.md - 插入 Milvus:批量写入新 Chunk
- 切换生效状态:旧 Chunk 失效,新 Chunk 生效;失败时回滚
并发控制
使用线程锁 (threading.Lock) 保证同一租户下同一文档的更新操作串行执行:
def _with_lock(self, key: str, task):
    with self._locks_guard:
        lock = self._locks.setdefault(key, threading.Lock())
    with lock:
        return task()
注意:这是单进程锁,多实例部署时应替换为分布式锁(如 Redis Lock)。
delete_document() — 软删除
不物理删除数据,而是将生效 Chunk 的 is_active 置为 False,保留历史版本和原始文件。
6.5 知识问答数据访问层 app/dao/knowledge_dao.py
query_knowledge() — RAG 问答主流程
def query_knowledge(self, user: UserModel, question: str) -> dict[str, object]:
完整的 5 步流程:
- 生成问题向量:
AiDao.create_embeddings([question]) - 混合检索:
MilvusStore.hybrid_search(user, question, query_vector)— Dense + BM25,携带权限 Filter - 重排序:
AiDao.rerank(question, chunks, top_n=4) - 生成答案:
_build_prompt()构造 Prompt →AiDao.generate_answer(messages) - 校验与绑定:
_validate_answer()校验 JSON 结构 → 绑定来源 Chunk 完整信息
返回结构
{
  "status": "answered",
  "answer": "根据退款规则,您可以在购买后7天内申请全额退款。",
  "sources": [
    {
      "chunkId": "qiteng:doc-uuid:v1:0:abc123",
      "documentId": "doc-uuid",
      "title": "退款政策",
      "version": 1,
      "chunkIndex": 0,
      "sourcePath": "qiteng/doc-uuid/v1.md",
      "content": "..."
    }
  ],
  "pipeline": {
    "permissionFilter": "tenant_id == \"qiteng\" and is_active == true",
    "recalledCount": 10,
    "rerankedCount": 4,
    "latencyMs": 1234,
    "candidates": [...]
  }
}
拒答机制
当模型判断知识库证据不足时,返回统一拒答文案:
REFUSAL_ANSWER = "根据当前知识库资料,无法回答这个问题。"
6.6 Markdown 分块器 app/utils/markdown_chunker.py
分块策略
normalize_markdown():统一换行符为\n,保证 checksum 和分块结果稳定_parse_sections():按标题层级(#{1,6})分块,支持代码块(```),段落合并_split_long_text():超长文本按max_length切分,保留overlap重叠chunk_markdown():主入口,默认max_length=700,overlap=80
关键特性
- 标题注入:每个 Chunk 都会重复注入其所属的标题路径,避免正文脱离标题后失去语义
- 代码块保护:代码块内容不会被拆分,保持完整性
- 段落合并:相邻短段落会合并,减少碎片化 Chunk
# 示例
# 输入 Markdown:
# # 退款政策
# ## 申请条件
# 购买后7天内可无条件退款。
#
# 输出 Chunk:
# "退款政策 / 申请条件\n\n购买后7天内可无条件退款。"
6.7 Milvus 存储层 app/store/milvus_store.py
Schema 设计
| 字段 | 类型 | 说明 | 索引 |
|---|---|---|---|
chunk_id | VARCHAR(256) | 主键,格式 {tenant}:{doc_id}:v{ver}:{idx}:{hash} | - |
tenant_id | VARCHAR(64) | 租户 ID(分区键) | - |
document_id | VARCHAR(64) | 文档 UUID | - |
version | INT32 | 文档版本号 | - |
chunk_index | INT32 | Chunk 在文档中的序号 | - |
is_active | BOOL | 是否生效 | - |
department_id | VARCHAR(64) | 部门 ID | - |
visibility | VARCHAR(32) | 可见性(company/department) | - |
title | VARCHAR(256) | 文档标题 | - |
source_path | VARCHAR(512) | 原始文件存储路径 | - |
checksum | VARCHAR(64) | 文档内容 SHA-256 | - |
content | VARCHAR(8192) | Chunk 正文(启用 jieba 分词) | BM25 |
dense_vector | FLOAT_VECTOR | 稠密语义向量 | AUTOINDEX + COSINE |
sparse_vector | SPARSE_FLOAT_VECTOR | 稀疏关键词向量 | SPARSE_INVERTED_INDEX |
updated_at | INT64 | 更新时间戳(毫秒) | - |
BM25 Function
Milvus 自动从 content 字段生成 sparse_vector,应用层无需手动计算:
schema.add_function(
    Function(
        name="content_bm25",
        function_type=FunctionType.BM25,
        input_field_names=["content"],
        output_field_names=["sparse_vector"],
    )
)
混合检索 hybrid_search()
def hybrid_search(self, user: UserModel, question: str, query_vector: list[float], top_k: int = 10):
- 构造权限 Filter:
build_permission_filter(user) - 构建两个
AnnSearchRequest:- Dense 路线:
dense_vector字段,召回 12 条 - BM25 路线:
sparse_vector字段,传入原始问题文本,召回 12 条
- Dense 路线:
- 使用
RRFRanker(60)融合排序,返回 Top-K 结果
7. API 接口文档
7.1 健康检查
GET /api/health
响应:
{
  "status": "ok",
  "service": "rag-knowledge-base",
  "timestamp": "2026-08-04T12:00:00+00:00"
}
7.2 授权认证
获取演示用户列表
GET /api/session/users
响应:
[
  {
    "token": "project-qiteng-admin",
    "id": "u-qiteng-admin",
    "name": "张三",
    "tenantId": "qiteng",
    "tenantName": "奇腾科技",
    "departmentId": "platform",
    "departmentName": "平台管理",
    "role": "admin"
  }
]
演示用户:
| 姓名 | 租户 | 部门 | 角色 | Token |
|---|---|---|---|---|
| 张三 | 奇腾科技 | 平台管理 | admin | project-qiteng-admin |
| 李四 | 奇腾科技 | 客户服务部 | employee | project-qiteng-customer-service |
| 王五 | 奇腾科技 | 财务部 | employee | project-qiteng-finance |
| 魏六 | 有趣名食 | 平台管理 | admin | project-youqu-admin |
7.3 AI 直接聊天
POST /api/ai/chat
Content-Type: application/json
请求体:
{
  "question": "你好,介绍一下你自己"
}
说明: 直接调用大模型对话,不经过 RAG 检索流程。用于测试模型连通性。
7.4 文档管理
所有文档接口需要 Authorization: Bearer <token> 请求头。
查询文档列表
GET /api/documents/
Authorization: Bearer <token>
响应:
[
  {
    "documentId": "550e8400-e29b-41d4-a716-446655440000",
    "title": "奇腾科技退款规则",
    "version": 2,
    "departmentId": "customer-service",
    "visibility": "company",
    "checksum": "a1b2c3d4...",
    "sourcePath": "qiteng/550e8400.../v2.md",
    "chunkCount": 8,
    "updatedAt": 1722758400000
  }
]
创建新文档
POST /api/documents/
Content-Type: multipart/form-data
Authorization: Bearer <admin-token>
表单字段:
| 字段 | 类型 | 必填 | 说明 |
|---|---|---|---|
file | File | 是 | Markdown 文件(.md,<= 2MB) |
title | String | 是 | 文档标题 |
departmentId | String | 是 | 部门 ID |
visibility | String | 是 | 可见性:company 或 department |
权限: 仅管理员(admin)可操作
更新文档版本
PUT /api/documents/{document_id}
Content-Type: multipart/form-data
Authorization: Bearer <admin-token>
说明: 为已有文档发布新版本,自动进行内容去重。
删除文档
DELETE /api/documents/{document_id}
Authorization: Bearer <admin-token>
说明: 软删除,将生效 Chunk 置为不可检索。
查看版本历史
GET /api/documents/{document_id}/versions
Authorization: Bearer <token>
7.5 知识问答
POST /api/knowledge/query
Content-Type: application/json
Authorization: Bearer <token>
请求体:
{
  "question": "奇腾科技的退款条件是什么?"
}
响应:
{
  "status": "answered",
  "answer": "根据奇腾科技退款规则,购买后7天内可无条件全额退款。",
  "sources": [
    {
      "chunkId": "qiteng:doc-uuid:v1:0:abc123def456",
      "documentId": "doc-uuid",
      "title": "奇腾科技退款规则",
      "version": 1,
      "chunkIndex": 0,
      "sourcePath": "qiteng/doc-uuid/v1.md",
      "content": "购买后7天内可无条件全额退款..."
    }
  ],
  "pipeline": {
    "permissionFilter": "tenant_id == \"qiteng\" and is_active == true",
    "recalledCount": 10,
    "rerankedCount": 4,
    "latencyMs": 1234,
    "candidates": [
      {
        "rank": 1,
        "chunkId": "...",
        "title": "奇腾科技退款规则",
        "version": 1,
        "retrievalScore": 0.85,
        "rerankScore": 0.92,
        "content": "..."
      }
    ]
  }
}
8. 数据模型
8.1 用户模型 UserModel
@dataclass
class UserModel:
    token: str              # 用户 Token
    id: str                 # 用户 ID
    name: str               # 用户名
    tenant_id: str          # 租户 ID
    tenant_name: str        # 租户名称
    department_id: str      # 部门 ID
    department_name: str    # 部门名称
    role: UserRole          # 角色:"admin" | "employee"
8.2 文档模型
# 可见性枚举
Visibility = Literal["company", "department"]

# 文本分块
@dataclass(frozen=True)
class TextChunk:
    index: int              # 分块序号
    content: str            # 分块内容

# 保存文档输入
@dataclass(frozen=True)
class SaveDocumentInput:
    title: str              # 文档标题
    department_id: str      # 部门 ID
    visibility: Visibility  # 可见性
    file_name: str          # 文件名
    content: bytes          # 文件内容

# 检索到的数据块
@dataclass(frozen=True)
class RetrievedChunk:
    chunk_id: str           # Chunk 唯一标识
    tenant_id: str          # 租户 ID
    document_id: str        # 文档 ID
    version: int            # 版本号
    chunk_index: int        # 分块序号
    department_id: str      # 部门 ID
    visibility: Visibility  # 可见性
    title: str              # 文档标题
    source_path: str        # 源文件路径
    checksum: str           # 内容校验和
    content: str            # Chunk 正文
    retrieval_score: float  # 检索得分
    rerank_score: float | None = None  # 重排得分

# 文档摘要
@dataclass(frozen=True)
class DocumentSummary:
    document_id: str
    title: str
    version: int
    department_id: str
    visibility: Visibility
    checksum: str
    source_path: str
    chunk_count: int        # Chunk 数量
    updated_at: int         # 更新时间(毫秒时间戳)
8.3 回答模型
Status = Literal["answered", "insufficient_evidence"]

@dataclass(frozen=True)
class GroundedAnswer:
    status: Status                  # 回答状态
    answer: str                     # 回答内容
    source_chunk_ids: list[str]     # 引用来源 Chunk ID 列表
8.4 Chunk ID 格式
{tenant_id}:{document_id}:v{version}:{chunk_index}:{content_hash[:12]}

# 示例
qiteng:550e8400-e29b-41d4-a716-446655440000:v2:3:a1b2c3d4e5f6
9. Milvus 向量数据库
9.1 Collection 设计
- Collection 名称:
rag_knowledge_base(可配置) - 分区数: 16(
num_partitions=16) - 分区键:
tenant_id(实现租户数据物理隔离) - 主键:
chunk_id(VARCHAR,非自增)
9.2 索引配置
| 字段 | 索引类型 | 距离度量 | 参数 |
|---|---|---|---|
dense_vector | AUTOINDEX | COSINE | - |
sparse_vector | SPARSE_INVERTED_INDEX | BM25 | inverted_index_algo=DAAT_MAXSCORE |
9.3 核心操作
ensure_collection() — 初始化
检查 Collection 是否存在,不存在则创建 Schema + 索引 + 加载。
insert(data) — 插入数据
批量插入 Chunk 数据并 flush,确保数据立即可检索。
set_active(data, is_active) — 切换生效状态
通过 Partial Upsert 只更新 is_active 字段,实现版本切换零停机。
query(filter_expression, limit) — 查询
按 Filter 表达式查询,默认 limit 5000,用于文档管理和版本历史。
hybrid_search(user, question, query_vector, top_k) — 混合检索
Dense + BM25 双路召回 + RRF 融合排序。
9.4 连接管理
# 创建客户端(兼容本地 Milvus 和 Zilliz Cloud)
client = MilvusClient(uri=config.address, token=config.token)

# 应用退出时关闭连接
milvus_store.close()
10. RAG 核心流程
10.1 流程图
                    ┌──────────────────────┐
                    │   用户提问 + 身份     │
                    └──────────┬───────────┘
                               │
                    ┌──────────▼───────────┐
                    │  1. 生成问题向量      │
                    │  AiDao.create_       │
                    │  embeddings()        │
                    └──────────┬───────────┘
                               │
                    ┌──────────▼───────────┐
                    │  2. 构造权限 Filter   │
                    │  build_permission_   │
                    │  filter(user)        │
                    └──────────┬───────────┘
                               │
                    ┌──────────▼───────────┐
                    │  3. 混合检索          │
                    │  Dense(12) + BM25(12)│
                    │  → RRF 融合 → Top-10 │
                    └──────────┬───────────┘
                               │
                    ┌──────────▼───────────┐
                    │  4. Rerank 重排序     │
                    │  AiDao.rerank()      │
                    │  → Top-4             │
                    └──────────┬───────────┘
                               │
                    ┌──────────▼───────────┐
                    │  5. 构造 Prompt       │
                    │  System 规则 +       │
                    │  4 个 Chunk 上下文    │
                    └──────────┬───────────┘
                               │
                    ┌──────────▼───────────┐
                    │  6. LLM 生成答案      │
                    │  temperature=0       │
                    │  response_format=    │
                    │  json_object         │
                    └──────────┬───────────┘
                               │
                    ┌──────────▼───────────┐
                    │  7. 校验答案结构      │
                    │  status + answer +   │
                    │  sourceChunkIds      │
                    └──────────┬───────────┘
                               │
                    ┌──────────▼───────────┐
                    │  8. 绑定来源详情      │
                    │  从候选集提取被引用   │
                    │  的 Chunk 完整信息    │
                    └──────────┬───────────┘
                               │
                    ┌──────────▼───────────┐
                    │   返回完整结果        │
                    └──────────────────────┘
10.2 Prompt 设计
system_prompt = """你是企业知识库问答助手,只能根据本次提供的 Chunk 回答。

规则:
1. Chunk 能支撑答案 → status=answered,给出 answer 和对应的 sourceChunkIds。
2. Chunk 无法支撑 → 不得用自身知识补充或猜测。返回 status=insufficient_evidence,answer="根据当前知识库资料,无法回答这个问题。",sourceChunkIds=[]。
3. sourceChunkIds 只能从本次提供的 Chunk ID 中选择。
4. 资料给了明确的金额/时间/条件时,可用用户数据做简单比较,这仍是有据回答。
5. 回答“是否”类问题,第一句先给明确结论,再详细说明理由。
6. 只返回 JSON:{"status":"answered 或 insufficient_evidence","answer":"答案","sourceChunkIds":["chunk_id"]}"""
10.3 检索链路信息
前端可通过 pipeline 字段观察完整的检索过程:
| 字段 | 说明 |
|---|---|
permissionFilter | 本次检索使用的权限过滤表达式 |
recalledCount | 混合检索召回的候选数 |
rerankedCount | 精排后的候选数 |
latencyMs | 端到端延迟(毫秒) |
candidates | 精排候选列表,含 retrievalScore 和 rerankScore |
11. 权限控制
11.1 角色定义
| 角色 | 说明 |
|---|---|
admin | 企业管理员,可查看和管理当前租户全部文档 |
employee | 普通员工,只能查看企业公开和本部门文档 |
11.2 文档可见性
| 可见性 | 说明 |
|---|---|
company | 全公司可见 |
department | 仅所属部门可见 |
11.3 权限 Filter 构造
def build_permission_filter(user: UserModel) -> str:
    tenant = f'tenant_id == "{user.tenant_id}"'
    active = 'is_active == true'

    if user.role == "admin":
        # 管理员:可查看当前租户全部生效文档
        return f"{tenant} and {active}"

    # 员工:可查看企业公开文档 + 本部门文档
    department = f'department_id == "{user.department_id}"'
    return f'{tenant} and {active} and (visibility == "company" or {department})'
11.4 API 权限校验
使用 FastAPI 依赖注入实现:
# 需要登录用户
@router.get("/")
def list_documents(user: UserModel = Depends(current_user)):
    ...

# 需要管理员权限
@router.post("/")
def create_document(user: UserModel = Depends(current_admin)):
    ...
12. 前端页面
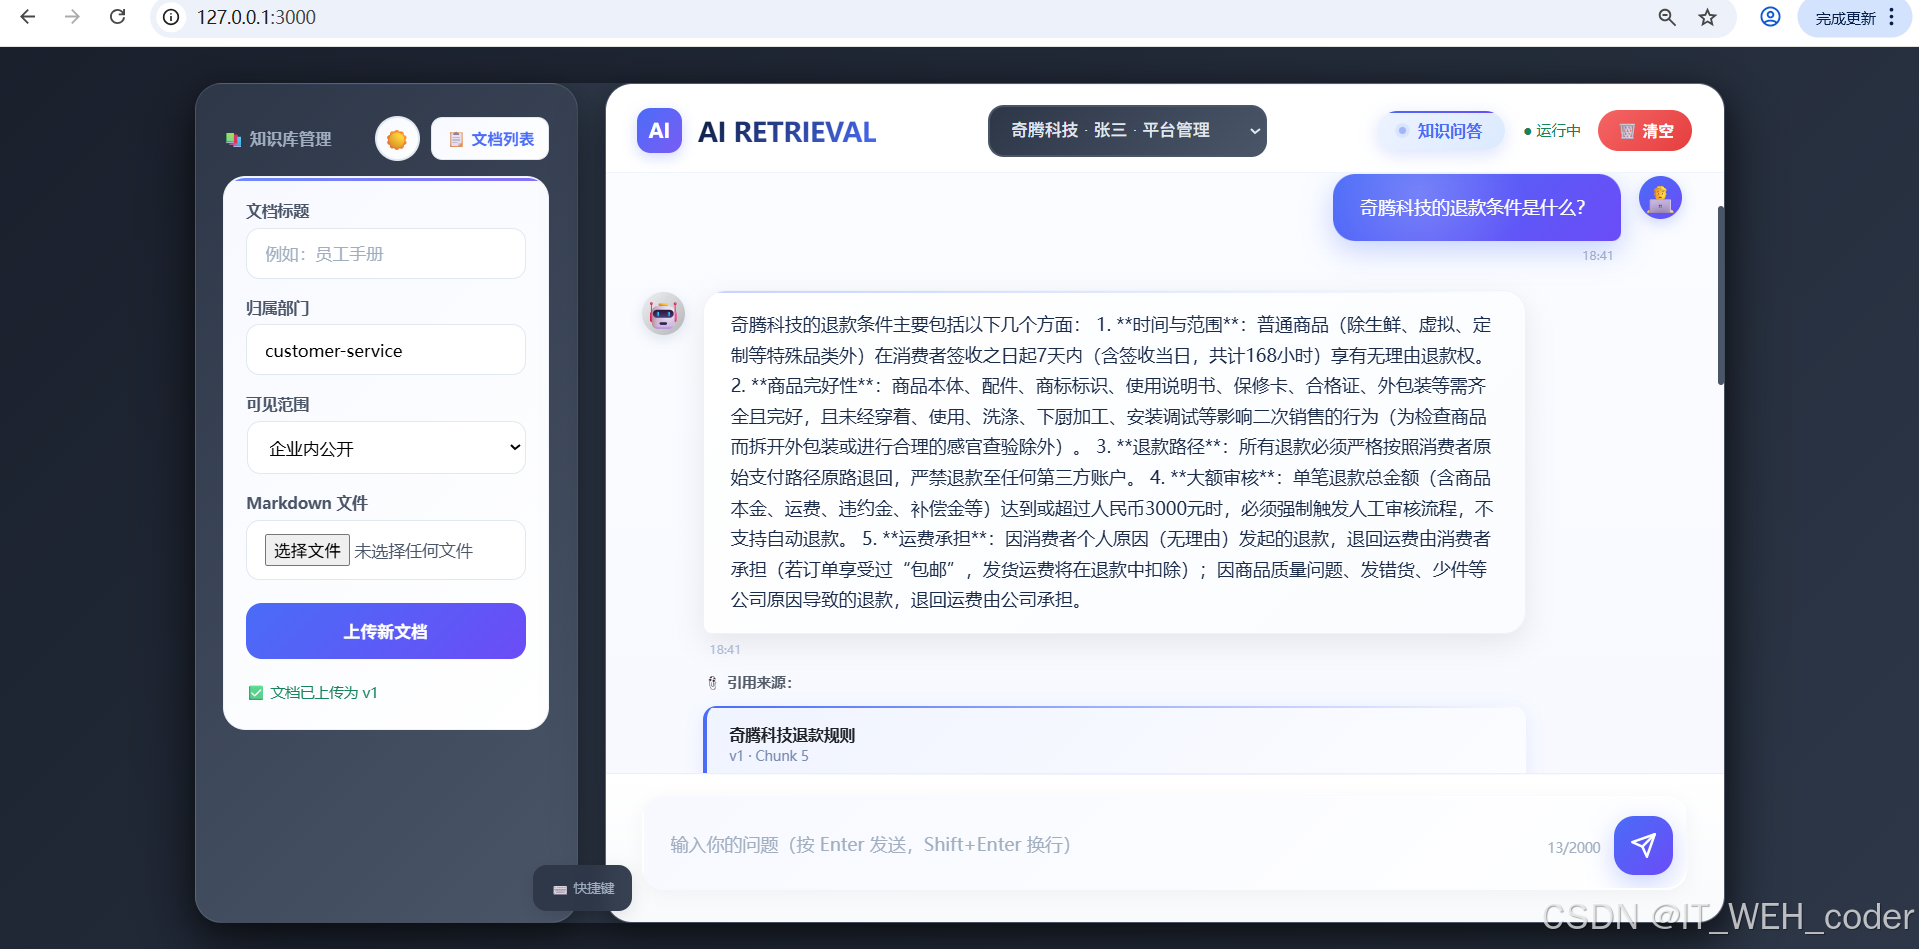
12.1 index.html — 完整版聊天室
完整功能的单页应用(~2590 行),包含:
布局
- 左侧边栏:知识库管理面板
- 右侧聊天区:对话界面
侧边栏功能
| 功能 | 说明 |
|---|---|
| 用户身份选择器 | 切换 4 个演示用户 |
| 文档上传表单 | 标题 / 部门 / 可见性 / Markdown 文件 |
| 文档列表弹窗 | 查看、版本更新、删除 |
| 版本更新弹窗 | 上传新版本 Markdown |
| 主题切换 | 亮色 / 暗色模式 |
聊天区功能
| 功能 | 说明 |
|---|---|
| 消息气泡 | 用户 / AI / 系统三种样式 |
| 引用来源卡片 | 展示回答引用的 Chunk 详情 |
| 检索链路展示 | 权限 Filter、召回数、精排数、延迟 |
| 快捷问题卡片 | 预设常见问题快速提问 |
| 打字指示器 | AI 正在输入时的动画效果 |
| 消息复制 | 一键复制 AI 回答 |
| 历史消息导航 | 上下箭头浏览历史消息 |
| 字符计数 | 输入框字符数统计 |
快捷键
| 快捷键 | 功能 |
|---|---|
Enter | 发送消息 |
Shift+Enter | 换行 |
Ctrl+K | 聚焦输入框 |
Ctrl+/ | 切换主题 |
数据持久化
使用 localStorage 缓存:
- 聊天记录
- 主题偏好
- 最后选择的 Token
12.2 chat.html — 精简版聊天室
纯对话界面(~960 行),特点:
- 无侧边栏
- 调用
/api/ai/chat(直接 LLM 对话,非 RAG) - 包含本地模拟回复库作为 fallback
- 无用户认证、文档管理、来源引用
12.3 favicon.svg — 网站图标
紫色闪电图标,使用 SVG 滤镜效果。
13. 异常处理
13.1 异常层级
KnowledgeBaseError (500)           # 统一基类
├── BadRequestError (400)          # 请求参数错误
├── UnauthorizedError (401)        # 未认证
├── ForbiddenError (403)           # 无权限
├── NotFoundError (404)            # 资源不存在
└── ServiceUnavailableError (503)  # 服务不可用
13.2 全局异常处理
@app.exception_handler(KnowledgeBaseError)
async def handle_business_error(_: Request, error: KnowledgeBaseError):
    return JSONResponse(
        status_code=error.status_code,
        content={"message": error.message}
    )

@app.exception_handler(RequestValidationError)
async def handle_validation_error(_: Request, error: RequestValidationError):
    messages = [
        ".".join(str(item) for item in detail["loc"]) + " " + detail["msg"]
        for detail in error.errors()
    ]
    return JSONResponse(status_code=422, content={"message": messages})
13.3 常见异常场景
| 场景 | 异常 | HTTP 状态码 |
|---|---|---|
| 文件格式非 Markdown | BadRequestError | 400 |
| 文件大小超过 2MB | BadRequestError | 400 |
| Token 无效或缺失 | UnauthorizedError | 401 |
| 非管理员上传文档 | ForbiddenError | 403 |
| 文档不存在 | NotFoundError | 404 |
| Embedding API 调用失败 | ServiceUnavailableError | 503 |
| LLM 未返回合法 JSON | ServiceUnavailableError | 503 |
| Milvus 操作失败 | RuntimeError | 500 |
14. 配置说明
14.1 .env 文件模板
参见 环境准备 章节。
14.2 配置校验
AiDao._assert_config() 在模型调用前校验必要配置:
AI_API_URL不能为空AI_API_KEY不能为空AI_MODEL_NAME不能为空EMBEDDING_DIMENSIONS必须是 256、512、1024 或 2048
14.3 存储路径
原始文档存储路径格式:
{STORAGE_ROOT}/{tenant_id}/{document_uuid}/v{version}.md

# 示例
./storage/documents/qiteng/550e8400-e29b-41d4-a716-446655440000/v1.md
15. 开发指南
15.1 添加新 API 接口
- 在
app/api/下创建新的路由文件 - 在
main.py中注册路由 - 在
app/service/下创建对应的 Service(可选) - 在
app/dao/下创建对应的 DAO(如需数据访问)
15.2 添加新的数据模型
- 在
app/models/下创建新的 dataclass - 使用
@dataclass(frozen=True)保证不可变性 - 提供
to_json()方法方便序列化
15.3 编写单元测试
项目依赖注入设计使得单元测试非常方便:
# 测试 KnowledgeDao
def test_query_knowledge():
    mock_ai = Mock(spec=AiDao)
    mock_milvus = Mock(spec=MilvusStore)

    dao = KnowledgeDao(ai=mock_ai, milvus=mock_milvus)
    # ...
15.4 切换本地模型
代码中保留了 HuggingFace 本地模型的调用入口。如需切换:
- 取消
app/dao/ai_dao.py中hugging_face_embeddings()的注释 - 取消
app/dao/ai_dao.py中rerank_documents()的注释 - 确保已下载模型到本地(首次运行会自动从 HuggingFace 镜像下载)
15.5 多实例部署注意
- 将
DocumentDao._with_lock()中的线程锁替换为分布式锁(如 Redis Lock) - 将
user_store.py中的硬编码用户替换为数据库存储 - 配置生产级 CORS 允许的域名
16. 部署与运维
16.1 启动命令
# 开发环境
uv run uvicorn main:app --reload --port 3000

# 生产环境
uvicorn main:app --host 0.0.0.0 --port 3000 --workers 4
16.2 日志
当前使用 print() 输出调试日志,生产环境建议替换为标准 logging:
import logging
logger = logging.getLogger(__name__)
16.3 监控指标
建议监控以下指标:
| 指标 | 来源 | 说明 |
|---|---|---|
| 端到端延迟 | pipeline.latencyMs | RAG 问答总耗时 |
| 召回数 | pipeline.recalledCount | 混合检索召回的候选数 |
| 精排数 | pipeline.rerankedCount | 重排序后的候选数 |
| 拒答率 | status=insufficient_evidence | 知识库证据不足的比例 |
| API 调用失败 | ServiceUnavailableError | 模型服务可用性 |
16.4 数据备份
- Milvus 数据:使用 Milvus 的备份工具或 Zilliz Cloud 的快照功能
- 原始文档:定期备份
storage/documents/目录 - 环境变量:安全保管
.env文件
17. 常见问题
Q1: Milvus 连接失败
现象: 启动时报 Milvus 连接错误
解决:
- 检查
MILVUS_ADDRESS和MILVUS_TOKEN是否正确 - 确认网络可访问 Milvus 实例
- 本地 Milvus 需先启动:
milvus start
Q2: Embedding API 调用失败
现象: 上传文档或提问时报 503
解决:
- 检查
AI_API_KEY是否有效 - 确认账户余额充足
- 检查 API 配额和限流设置
Q3: 文档上传后检索不到
现象: 上传文档成功,但问答时找不到相关内容
解决:
- 检查文档的
visibility和当前用户的department_id - 确认
is_active是否为true - 查看
pipeline.permissionFilter确认权限 Filter 是否正确
Q4: 模型返回拒答
现象: 返回 “根据当前知识库资料,无法回答这个问题。”
解决:
- 检查知识库中是否确实包含相关内容
- 尝试调整 Rerank 的
top_n参数 - 检查 Chunk 分块质量,确认关键信息未被截断
Q5: 如何切换到本地 Milvus?
修改 .env:
MILVUS_ADDRESS=http://127.0.0.1:19530
MILVUS_TOKEN=
MILVUS_COLLECTION=rag_knowledge_base
附录
A. 相关文档
更多推荐
 11
 0
- 0


 已为社区贡献5条内容

所有评论(0)