
【2026最新】大模型批量文本分析实战教程:情感分析、合同审查、AI率自查、视频转笔记一篇搞定
一、本文能解决什么问题
如果你遇到过以下任一场景,这篇教程适合你:
- 手里有几百条用户评论/客服记录/问卷回答,想做情感分析和意图分类,但一条条贴给 AI 太慢
- 拿到一份合同,想让 AI 做合同风险审查,输出条款级的风险清单
- 论文用了 AI 辅助,想在提交前做AIGC 检测自查和降 AI 味改写
- 有一堆网课/会议视频,想自动生成结构化学习笔记
本文用阿里云百炼的命令行工具 bl 完成上述全部任务,所有命令均可直接复制使用,Windows 和 macOS 通用。
二、环境准备
前置要求:Node.js(LTS 版本即可,官网 nodejs.org 下载)
第 1 步:安装 CLI
npm install -g bailian-cli
第 2 步:获取 API Key。打开百炼控制台 API Key 页面(免费注册,新用户送免费额度),创建并复制 Key。
第 3 步:登录
bl auth login
按提示粘贴 Key 即完成。验证是否可用:
bl text chat --message "你好"
有正常回复即环境就绪。更多命令能力可以查看官方 CLI 介绍页。
三、实战 1:批量评论情感分析(核心)
3.1 准备数据
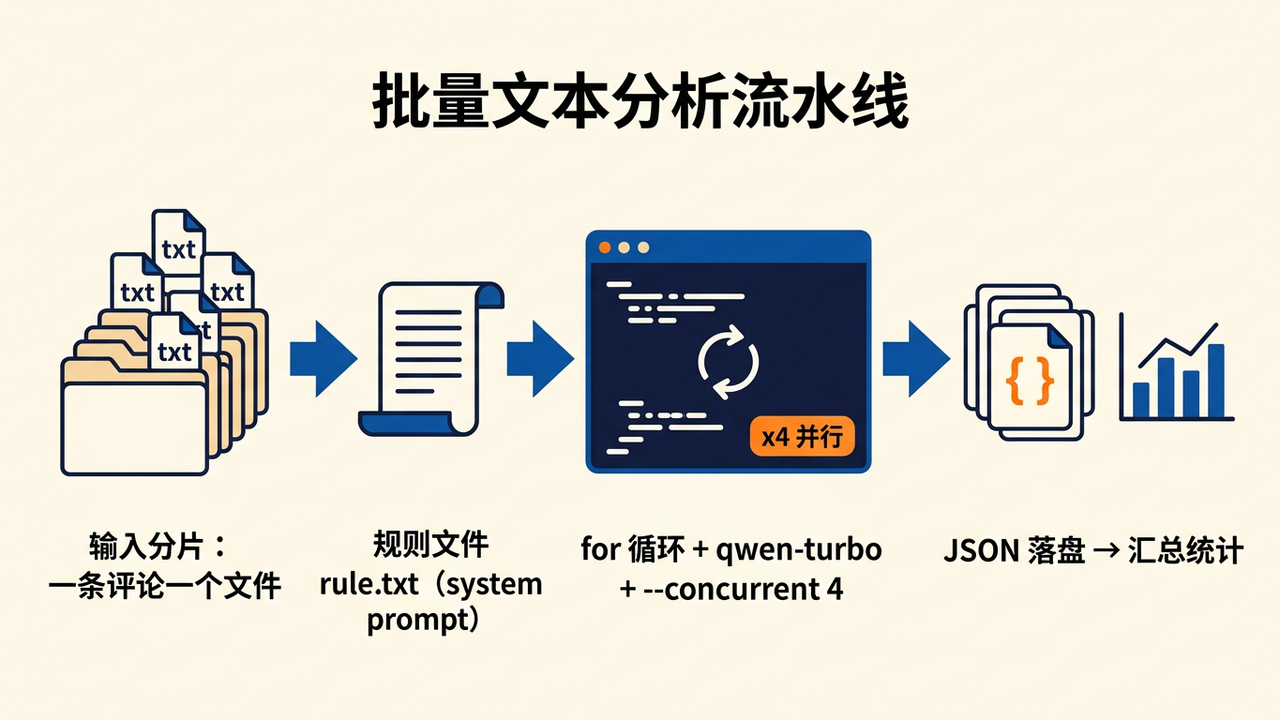
把评论从平台导出后拆成单条文件放进 reviews/ 目录(拆分可以用 Excel 分列或让 AI 写个脚本)。拆小文件的好处:失败可以只重跑失败的那几条。
3.2 编写分析规则
新建 rule.txt:
你是评论分析器。对输入的评论输出 JSON:{"sentiment": "正面/负面/中性", "aspect": ["口味","配送","包装","价格","服务"中命中的项], "intent": "表扬/吐槽/建议/询问", "summary": "十字以内概括"}。只输出 JSON,不要解释。
标签体系按你的业务改,比如电商换成"质量/物流/包装/价格/售后"。
3.3 批量执行
macOS/Linux(Bash):
for f in reviews/*.txt; do bl text chat --model qwen-turbo --system "$(cat rule.txt)" --message "$(cat "$f")" --output json > "out/$(basename "$f" .txt).json"; done
Windows(PowerShell):
Get-ChildItem reviews\*.txt | ForEach-Object { bl text chat --model qwen-turbo --system (Get-Content rule.txt -Raw) --message (Get-Content $_ -Raw) --output json | Out-File "out\$($_.BaseName).json" }
参数说明:
--model qwen-turbo:便宜档模型。打标签是重复性任务,用它和旗舰模型效果几乎一样,成本低一个量级--system:分析规则,保证 500 条用同一套标准(这正是对话框做不到的)--output json:输出结构化 JSON,方便进 Excel/Python 统计
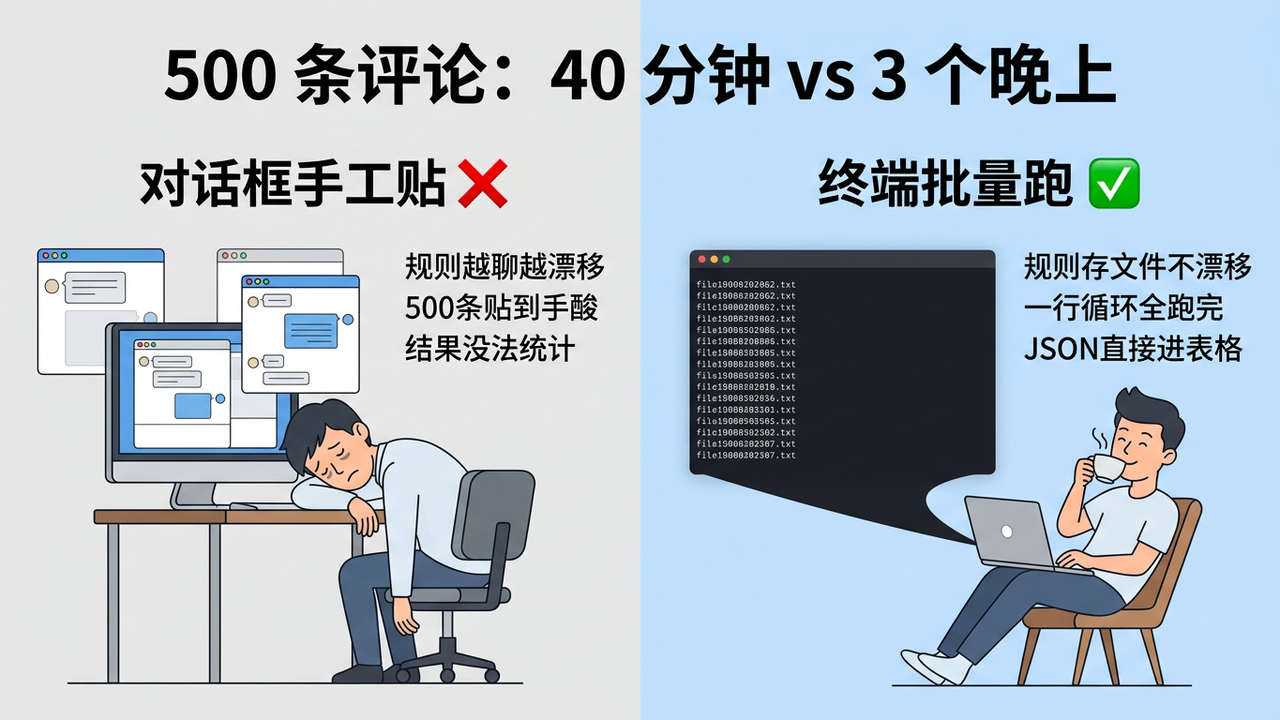
提速:命令里加 --concurrent 4 可 4 路并行,500 条从约 40 分钟缩到约 11 分钟。
3.4 效果参考
实测 500 条外卖评论:负面集中在"配送"(占 62%),并从五星好评里挖出 17 条改进建议。总成本几毛钱。
四、实战 2:合同风险审查
把合同文本存成 contract.txt,然后:
bl text chat --system "你是合同审读助手。只列出对乙方不利或异常的条款,每条给出:原文引用、风险说明、建议的修改方向。常规条款不要复述。" --message "$(cat contract.txt)"
Windows 写法:--message (Get-Content contract.txt -Raw)。
实测 7 页租房合同挑出 4 条风险条款,每条带原文引用。注意:prompt 里"常规条款不要复述"这句必须加,否则它会点评所有正常条款,输出没法看。
适用边界:结果是初筛清单,适合租房、外包这类日常合同;大金额合同请把 AI 清单当作"咨询律师时的问题列表"。
五、实战 3:论文 AI 率自查与降 AI 味
先明确:任何工具都不能保证通过知网等检测系统,AI 检测本身存在误判。本方法用于定位 AI 味重的段落并获取改写建议,最终改写请人工完成。
bl text chat --system "分析输入文本的 AI 生成特征:机械的排比结构、高频套话('综上所述''不难发现')、缺少具体细节的空泛论述。逐段给出 AI 特征明显度(高/中/低)和具体的人工化改写建议,建议要具体到句。" --message "$(cat chapter3.txt)"
输出会逐段给出高/中/低评级和具体到句的改写方向(例如把"随着科技的不断发展"这类空泛开头替换为具体领域现状)。
衍生用法:把 system prompt 换成"逐条列出语法错误:位置、错误类型、修改建议",就是英文论文语法检查器。
六、实战 4:视频转学习笔记
bl vision describe --video ./lecture.mp4 --prompt "这是一节课程视频。输出 Markdown 格式学习笔记:按讲解顺序分章节,每章列出核心论点、关键例子、涉及的公式或代码。结尾附全课要点清单。适配 Obsidian 语法。"
支持 mp4/mov/avi/mkv/webm,本地文件自动上传。2 小时视频几分钟出带章节结构的 Markdown 笔记,可直接导入 Obsidian。
七、成本与用量查询
bl usage stats --days 7
查最近 7 天调用统计。免费额度余量:
bl usage free
实测参考:500 条评论 + 1 份合同 + 3 段论文 + 1 个 2 小时视频,总费用不到 3 元,大部分在免费额度内。
八、常见问题(FAQ)
Q1:提示 npm 不是内部或外部命令?
未安装 Node.js,去 nodejs.org 装 LTS 版后重开终端。
Q2:批量跑到一半个别文件失败怎么办?
这就是拆小文件的意义——只重跑失败的文件。失败常见原因是文本含特殊字符,清洗后重试即可。
Q3:分析质量不稳定?
检查 system prompt 是否含负面约束(“不要解释”“不要复述常规条款”)。分析类任务中,限制它不做什么比描述做什么更有效。
Q4:能处理英文内容吗?
可以,评论打标、语法检查、社媒帖子话题分类对英文同样有效,规则文件用英文写更佳。
Q5:担心批量任务花超?
跑之前 bl usage free 看额度,跑完 bl usage stats 对账;批量任务建议先拿 10 条试跑确认输出格式再全量执行。
更多推荐



 2
 0
- 0


 已为社区贡献3条内容

所有评论(0)