
别再死磕公式了!8 大机器学习核心算法,通俗讲透
前言
很多刚接触机器学习的同学,一上来就被满屏的公式推导劝退。其实经典算法的核心思想都来自生活常识,根本不用死记硬背公式。本文用最通俗的语言讲解多元线性回归、逻辑回归、KNN、决策树、随机森林、SVM、K-Means 等 8 大核心算法,讲清回归与分类、监督与无监督的本质区别,配合直观示意图帮你建立底层认知,零基础也能看懂。
一、先分清:什么是回归?什么是分类?
在讲算法之前,必须先搞懂机器学习两大核心任务,这是选择算法的根本依据。
一句话区分:看输出是什么
- 回归(Regression):输出是连续的数值。比如预测房价多少万、明天气温多少度、销售额多少钱。核心是 "算一个数"。
- 分类(Classification):输出是离散的类别。比如判断邮件是不是垃圾邮件、肿瘤是良性还是恶性、图片里是猫还是狗。核心是 "归到哪一类"。
举个生活化的例子:
- 预测小明这次考试考多少分 → 回归问题
- 判断小明这次考试及格还是不及格 → 分类问题
很多算法既能做分类也能做回归,只是最终输出形式不同,下面会具体讲到。
二、监督学习算法(有标准答案的学习)
监督学习就是训练数据里既有输入特征,又有正确答案(标签),模型学着从特征推导出答案。
1. 多元线性回归
核心思想:找一条最 "合身" 的直线 / 超平面
一元线性回归就是我们初中学的 y = ax + b,用一条直线拟合 x 和 y 的关系。多元线性回归就是特征不止一个,比如预测房价不仅看面积,还要看房间数、楼层、地段等,相当于在高维空间里找一个最优拟合平面。
怎么算 "合身"?就是让所有数据点到这条直线的误差总和最小,专业上叫 "最小二乘法"。
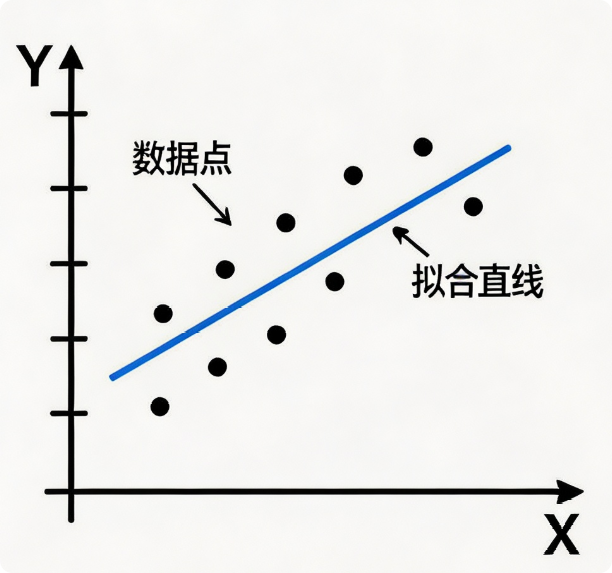
通俗理解:就像你在纸上点了一堆点,然后画一条直线,让尽可能多的点都离这条线最近。每个特征前面都有一个权重,权重越大说明这个特征对结果影响越大。
适用场景:房价预测、销量预测、薪资预估等线性关系明显的连续值预测。
优缺点
- 优点:简单易懂、计算快、可解释性强(每个特征的权重一目了然)
- 缺点:只能拟合线性关系,现实中很多问题不是线性的;对异常值很敏感
2. 逻辑回归
核心思想:在线性回归外面套一层 "概率转换器"
注意:名字里带 "回归",但它是分类算法!
逻辑回归先像线性回归一样算出一个数值,然后通过 Sigmoid 函数把这个值压缩到 0~1 之间,这个值就代表了 "属于正类的概率"。通常以 0.5 为阈值,大于 0.5 判为正类,小于 0.5 判为负类。
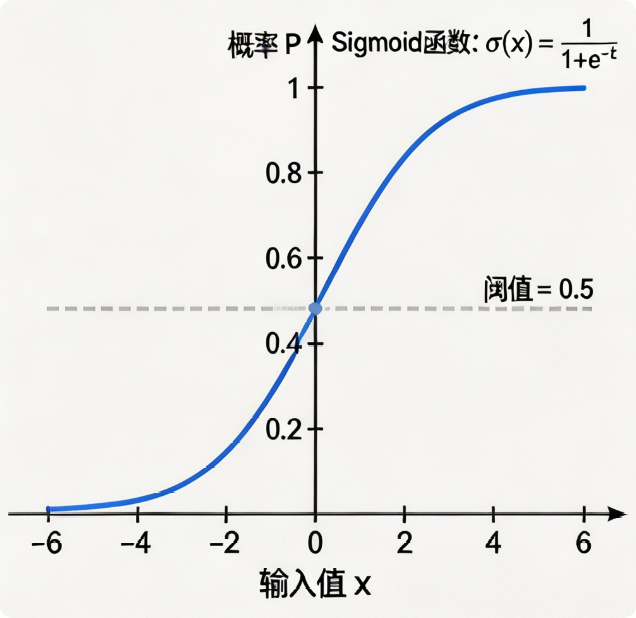
通俗理解:就像考试打分,先算出卷面分(线性回归部分),然后设定一个及格线(0.5 阈值),高于 60 分算及格,低于算不及格。只不过逻辑回归输出的不是分数,而是 "及格的概率有多大"。
适用场景:二分类问题,比如垃圾邮件识别、用户是否会点击、疾病诊断、金融风控违约判断。
优缺点
- 优点:计算快、输出是概率可解释、不容易过拟合
- 缺点:只能处理线性可分问题,复杂非线性场景效果不好
3. K 近邻算法(KNN)
核心思想:近朱者赤,近墨者黑
KNN 是最简单的机器学习算法之一,它甚至没有 "训练" 过程,属于 "懒惰学习"—— 来了新样本才开始计算。
原理很简单:给一个新样本,在训练数据里找到离它最近的 K 个邻居,看看这 K 个邻居里哪一类最多,就把新样本归为哪一类。如果是回归任务,就取这 K 个邻居的平均值。
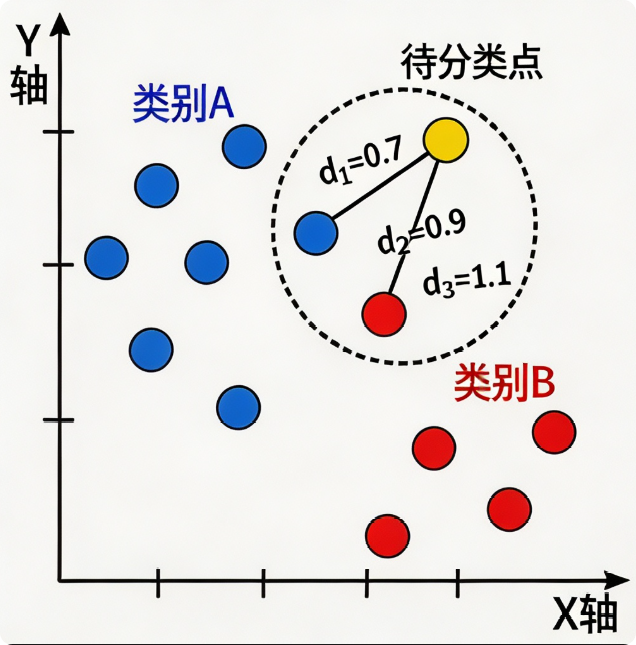
通俗理解:你想判断一个人是什么样的人,就看他走得最近的 K 个朋友是什么样的人,多数是什么样他大概率就是什么样。
K 值怎么选?
- K 太小:容易受个别噪声点影响,过拟合
- K 太大:容易被远距离的无关样本带偏,欠拟合
- 一般取奇数,避免平票
适用场景:手写数字识别、推荐系统找相似用户、小数据集分类。
优缺点
- 优点:原理简单、不用训练、上手快
- 缺点:预测慢(每个新样本都要和所有样本算距离)、数据量大了根本跑不动、对高维数据效果差
4. 决策树 & 决策回归树
核心思想:像玩 "二十问" 游戏一样层层判断
决策树模拟人的决策逻辑:从根节点开始,一步步根据特征做判断,每判断一次就往下走一个分支,最后走到叶子节点得到结果。
每个节点选哪个特征来分裂是有讲究的,目标是分裂后两边的数据尽可能 "纯净"—— 也就是同一类的尽量凑到一起。常用衡量标准有信息熵、基尼系数等。
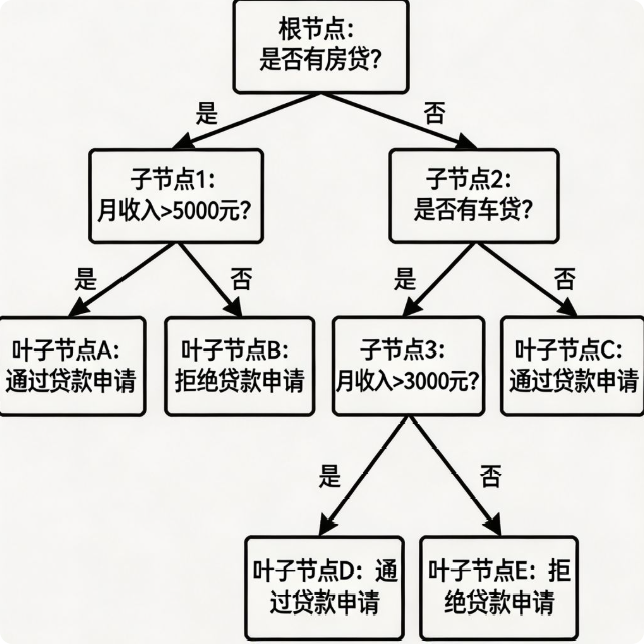
分类树 vs 回归树
- 决策树(分类树):叶子节点输出类别,比如 "通过贷款" 或 "拒绝贷款"
- 决策回归树:叶子节点输出数值(一般取该节点所有样本的均值),比如预测房价
通俗理解:就像贷款审批流程 —— 先看有没有房贷?有→再看月收入够不够?够→通过;不够→拒绝。一层一层问下去,最后得出结论。
适用场景:贷款审批、医疗诊断、用户分层等需要强解释性的场景。
优缺点
- 优点:可解释性极强(能画出完整决策流程)、不需要特征归一化、能处理数值和类别特征
- 缺点:很容易过拟合(树长太深就把噪声都学进去了)、对数据波动敏感
5. 随机森林
核心思想:三个臭皮匠,顶个诸葛亮
随机森林是集成学习的代表,简单说就是 "集体决策"。它同时训练很多棵决策树,每棵树只看一部分数据、一部分特征,最后所有树一起投票,票数最多的结果就是最终答案。
为什么叫 "随机"?因为有两处随机:
- 每棵树随机抽取一部分样本训练(有放回抽样)
- 每个节点分裂时随机选一部分特征来挑选最优分裂特征
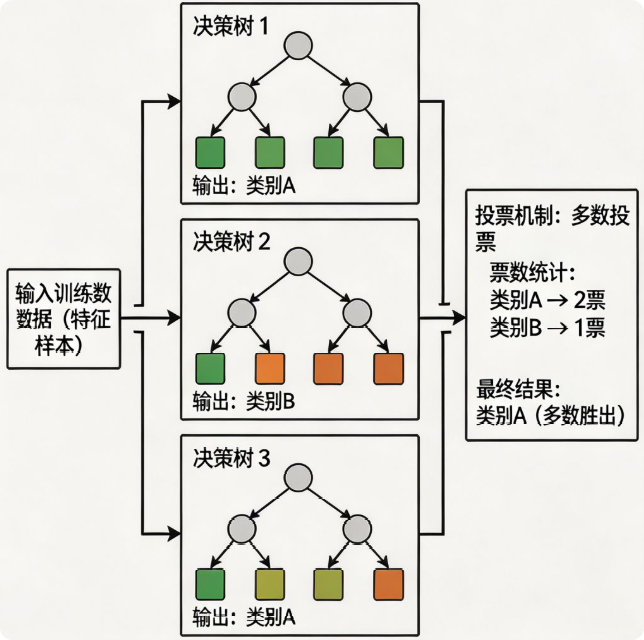
通俗理解:就像专家会诊,一个医生可能看走眼,但十几个医生一起诊断,多数人同意的结果准确率就高很多。每个医生只看病人的部分检查结果,最后大家投票。
适用场景:几乎所有分类回归场景都能用,是竞赛和工业界的 "万金油" 算法。
优缺点
- 优点:准确率高、不容易过拟合、能处理高维数据、不用太费心调参
- 缺点:模型大了训练慢、可解释性比单棵决策树差(黑盒感增强)
6. 支持向量机(SVM)
核心思想:找一条最 "安全" 的分界线
SVM 的目标是找到一个最优超平面,把两类样本分开,而且要让离分界线最近的那些样本到分界线的距离尽可能大。这些离分界线最近的样本就叫 "支持向量",它们决定了分界线的位置。
对于线性不可分的数据,SVM 用 "核技巧" 把数据映射到更高维空间,让它在高维里变得线性可分。
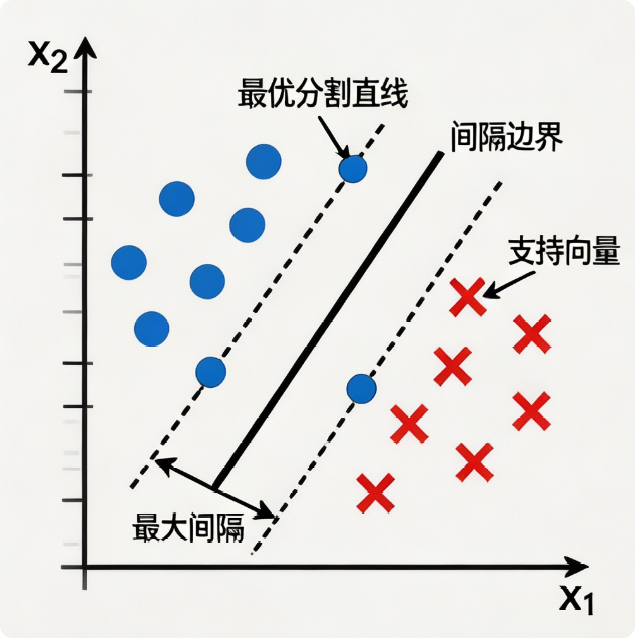
通俗理解:就像在地上摆了两堆球,你要放一块木板把它们分开。普通方法只要分开就行,但 SVM 要找那块最 "稳" 的木板 —— 两边留出的空隙最大,这样即使球稍微挪一点位置也不会分错。
适用场景:小样本高维数据分类、文本分类、图像识别、生物信息学。
优缺点
- 优点:小样本下效果好、泛化能力强、适合高维稀疏数据
- 缺点:大数据量训练极慢、对核函数和参数敏感、可解释性差
三、无监督学习算法(没有标准答案的学习)
无监督学习的数据只有特征没有标签,模型自己去发现数据内部的结构和规律。
K-Means 聚类
核心思想:物以类聚,人以群分
K-Means 是最经典的聚类算法。K 是你指定的簇数,算法通过迭代把数据分成 K 个群,每个群内部的样本都尽可能相似,群和群之间尽可能不同。
算法步骤:
- 随机选 K 个点作为初始聚类中心
- 把每个样本分配给离它最近的中心
- 重新计算每个簇的中心(取均值)
- 重复 2、3 步,直到中心不再变化
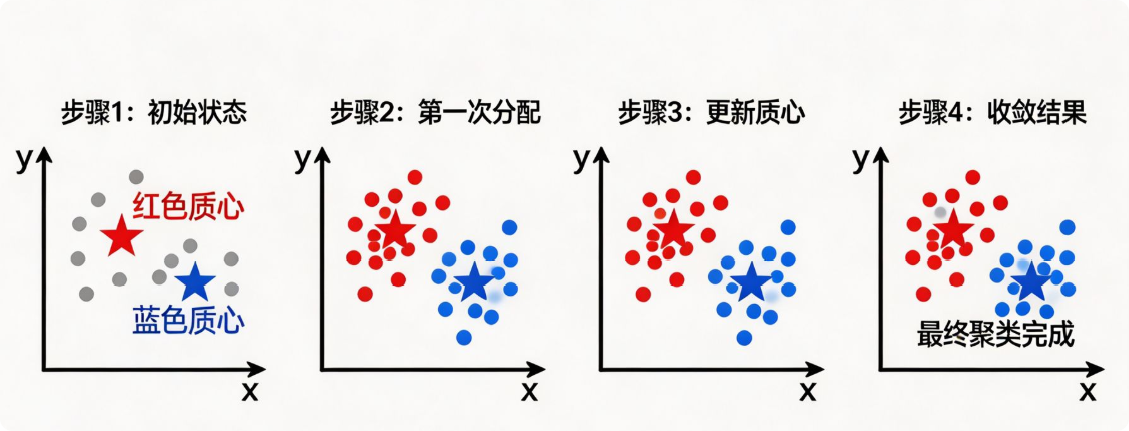
通俗理解:就像班里分小组,先随便指定 K 个组长,然后每个人选离自己最近的组长加入;接着每组重新选一个中心点当新组长;一直重复,直到大家的分组不再变了为止。
K 值怎么选? 常用肘部法则:画出不同 K 值对应的误差曲线,曲线拐弯的那个点就是比较合适的 K。
适用场景:用户分群、图像分割、异常检测、市场细分。
优缺点
- 优点:原理简单、速度快、效果直观
- 缺点:需要提前指定 K、对初始中心点敏感、对异常值敏感、适合球状簇
四、算法速查对比表
| 算法 | 类型 | 核心思想 | 擅长场景 | 解释性 |
|---|---|---|---|---|
| 多元线性回归 | 监督 - 回归 | 拟合最优超平面 | 线性关系的连续预测 | 强 |
| 逻辑回归 | 监督 - 分类 | 线性回归 + Sigmoid 转概率 | 二分类、风控、点击率 | 强 |
| KNN | 监督 - 分类 / 回归 | 找最近的 K 个邻居投票 | 小数据集、简单分类 | 中 |
| 决策树 | 监督 - 分类 / 回归 | 层层特征判断 | 需要解释性的业务场景 | 极强 |
| 随机森林 | 监督 - 分类 / 回归 | 多棵树集体投票 | 通用场景、追求准确率 | 中 |
| SVM | 监督 - 分类 / 回归 | 最大化间隔的最优超平面 | 小样本高维数据 | 弱 |
| K-Means | 无监督 - 聚类 | 按距离聚成 K 类 | 用户分群、数据探索 | 中 |
更多推荐



 28
 0
- 0


 已为社区贡献6条内容

所有评论(0)