
Kubernetes 集群部署
Kubernetes 集群部署
一、集群部署总体思路
Kubernetes(K8s)作为容器编排平台,部署的核心目标是让控制平面(Control Plane)与工作节点(Worker Node)通过安全的 API 通道协同工作。本文采用 kubeadm + 私有镜像仓库 + Flannel 网络插件 的方案,在 4 台主机(1 台 Harbor 镜像仓库 + 1 台 master + 2 台 worker)上完成集群搭建,并同步梳理每一步背后的原理。
1.1 集群组件
| 角色 | 组件 | 职责 |
|---|---|---|
| 控制平面 | kube-apiserver | 集群唯一入口,所有请求(kubectl、组件间通信)都经过它,承担认证、授权与 API 转发 |
| 控制平面 | etcd | 集群状态的权威存储,保存所有资源对象数据 |
| 控制平面 | kube-controller-manager | 运行各类控制器,不断把实际状态向期望状态收敛 |
| 控制平面 | kube-scheduler | 为新 Pod 挑选最合适的节点 |
| 工作节点 | kubelet | 节点上的管理者,负责 Pod 生命周期与健康检查,并与 apiserver 保持心跳 |
| 工作节点 | kube-proxy | 维护节点网络规则,实现 Service 的负载均衡与转发 |
| 工作节点 | 容器运行时(CRI) | 真正启停容器,K8s 通过 CRI 接口与运行时解耦 |
1.2 为什么需要私有镜像仓库
集群几乎所有组件的镜像(kube-apiserver、etcd、coredns、pause……)默认来自 k8s.gcr.io / registry.k8s.io,国内网络环境下拉取困难。因此先在 Harbor 上搭建私有仓库,形成一条镜像链路:
- master 节点从国内镜像源(阿里云)拉取官方组件镜像;
- 重新打标签(reg.timinglee.org/k8s/xxx)后推送到内网 Harbor;
- 所有主机统一从
reg.timinglee.org拉取组件镜像,既解决网络问题,也实现镜像的集中管理。
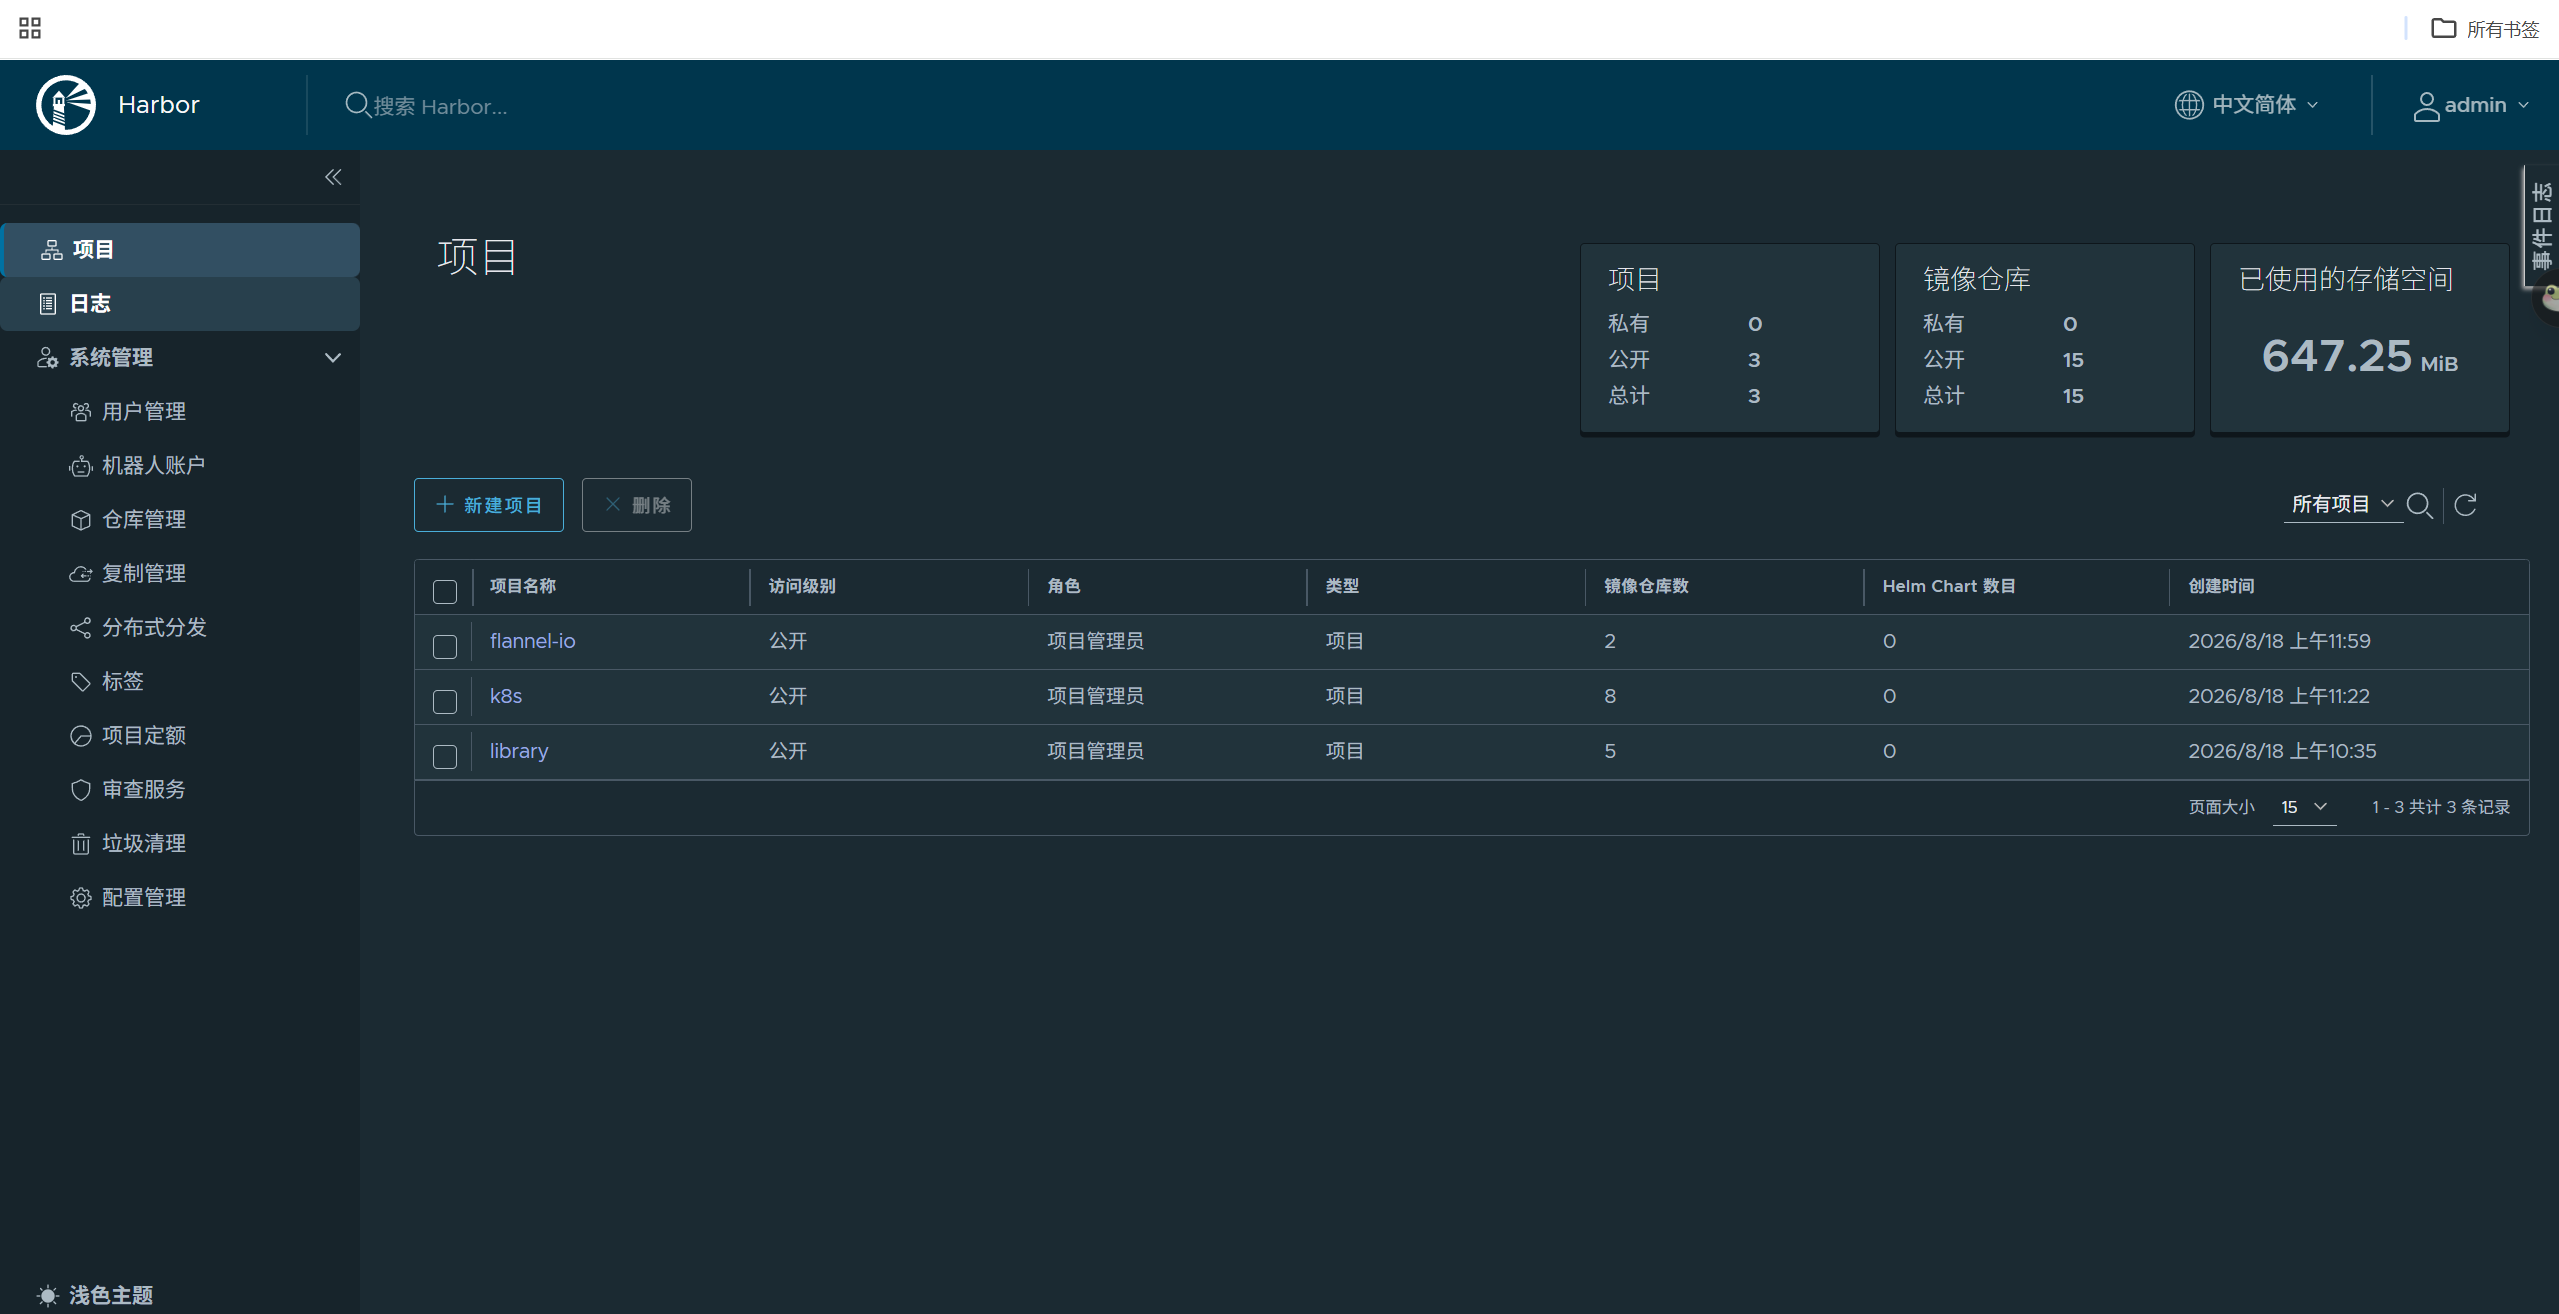
【截图 2:Harbor Web 界面(登录页 / 项目与镜像列表)】
二、搭建 Harbor 镜像仓库
2.1 安装 Docker 并配置桥接转发
Docker 是 Harbor 的运行时底座。安装后必须开启内核桥接转发(br_netfilter)并允许 IP 转发,否则后续容器与 Pod 流量无法穿过 iptables:
cat > /etc/yum.repos.d/docker.repo <<EOF
[docker]
name = docker
baseurl = https://mirrors.aliyun.com/docker-ce/linux/rhel/9.6/x86_64/stable/
gpgcheck = 0
EOF

dnf install docker-ce-3:28.5.2-1.el9 -y

echo br_netfilter > /etc/modules-load.d/docker_mod.conf
modprobe -a br_netfilter

cat > /etc/sysctl.d/docker.conf <<EOF
net.bridge.bridge-nf-call-iptables = 1
net.bridge.bridge-nf-call-ip6tables = 1
net.ipv4.ip_forward = 1
EOF
sysctl --system

systemctl enable --now docker
2.2 生成仓库证书
Harbor 走 HTTPS 访问,需要自签证书,且必须包含仓库域名 SAN(subjectAltName),否则客户端校验证书时会因域名不匹配而失败:
mkdir /data/certs -p
openssl req -newkey rsa:4096 \
  -nodes -sha256 -keyout /data/certs/timinglee.org.key \
  -addext "subjectAltName = DNS:reg.timinglee.org" \
  -x509 -days 365 -out /data/certs/timinglee.org.crt
2.3 配置并安装 Harbor
tar zxf harbor-offline-installer-v2.5.4.tgz -C /opt/
cd /opt/harbor/
cp harbor.yml.tmpl harbor.yml
# 修改 harbor.yml 关键项:
#   hostname: reg.timinglee.org
#   certificate: /data/certs/timinglee.org.crt
#   private_key: /data/certs/timinglee.org.key
#   harbor_admin_password: <自行设置>
./install.sh --with-chartmuseum
2.4 信任证书并验证仓库
mkdir -p /etc/docker/certs.d/reg.timinglee.org/
cp /data/certs/timinglee.org.crt /etc/docker/certs.d/reg.timinglee.org/ca.crt
# /etc/hosts 增加解析:
# 172.25.254.200   reg.timinglee.org

systemctl restart docker
docker compose up -d
docker login reg.timinglee.org -u admin
# 输出 Login Succeeded 即仓库可用

原理说明:/etc/docker/certs.d/<域名>/ca.crt 是 Docker 客户端信任私有仓库证书的标准位置,放入后无需配置 insecure-registry 即可 HTTPS 登录。整个集群的主机共享同一份证书,就建立起了对私有仓库的统一信任。
三、节点主机规划
| 主机名 | IP | 配置 | 角色 |
|---|---|---|---|
| harbor.timinglee.org | 172.25.254.200 | 1C / 1G | Harbor 镜像仓库 |
| master-node | 172.25.254.100 | 4C / 4G+ | master:控制平面节点 |
| node1 | 172.25.254.10 | 2C / 2G | worker:工作节点 |
| node2 | 172.25.254.20 | 2C / 2G | worker:工作节点 |
tips:master节点至少3G内存
四、所有节点通用配置
4.1 关闭 swap
kubelet 默认要求节点禁用 swap(否则 kubelet 无法启动),且 /etc/fstab 中的 swap 行必须注释,否则重启后 swap 会重新启用:
systemctl disable --now swap.target
systemctl mask swap.target
sed '/swap/s/^/#/g' -i /etc/fstab
# 重启后验证:swapon -s 无任何输出
4.2 安装 Docker 并信任私有仓库
# 安装 docker(步骤同 2.1)
mkdir -p /etc/docker/certs.d/reg.timinglee.org/
# 从 harbor 主机向各节点分发证书
for i in 100 10 20; do
  scp /data/certs/timinglee.org.crt root@172.25.254.$i:/etc/docker/certs.d/reg.timinglee.org/ca.crt
done

# 配置镜像加速,统一走私有仓库
cat > /etc/docker/daemon.json <<EOF
{ "registry-mirrors":["https://reg.timinglee.org"] }
EOF
systemctl restart docker
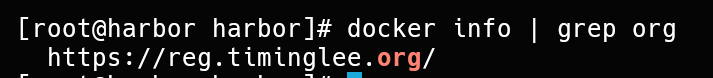
docker info   # Registry Mirrors 中出现 reg.timinglee.org
4.3 主机名解析
所有主机写入彼此的主机名解析,保证 kubeadm join、证书校验等环节按主机名通信不报错:
cat >> /etc/hosts <<EOF
172.25.254.100     master
172.25.254.10      node1
172.25.254.20      node2
172.25.254.200     reg.timinglee.org
EOF
4.4 配置 Kubernetes 软件源
使用阿里云镜像保持 kubelet / kubeadm 版本一致(本实验为 v1.35):
cat > /etc/yum.repos.d/kubernetes.repo <<EOF
[kubernetes]
name = kubernetes
baseurl = https://mirrors.aliyun.com/kubernetes-new/core/stable/v1.35/rpm/
gpgcheck = 0
EOF
dnf list kubelet   # 能列出即为源可用
五、kubeadm 部署流程
5.1 安装 cri-dockerd(运行时适配层)
Kubernetes 自 1.24 起移除了内置的 dockershim,Docker 引擎不再被 CRI 直接支持。cri-dockerd 是 Docker 与 CRI 之间的适配层:对外暴露 CRI 接口 /var/run/cri-dockerd.sock,对内调用 Docker API,让仍以 Docker 为运行时的集群可以平滑过渡。
rpm -ivh cri-dockerd-0.3.14-3.el8.x86_64.rpm libcgroup-0.41-19.el8.x86_64.rpm

# 修改 /lib/systemd/system/cri-docker.service 的 ExecStart:
# /usr/bin/cri-dockerd --container-runtime-endpoint fd:// \
#   --network-plugin=cni \
#   --pod-infra-container-image=reg.timinglee.org/k8s/pause:3.10.1

ll /var/run/cri-dockerd.sock   # 套接字存在即启动成功

5.2 安装 kubelet / kubeadm / kubectl
# master 节点安装三件套;node 节点仅需 kubelet + kubeadm
dnf install kubelet kubeadm kubectl -y
systemctl enable --now kubelet.service

# master 节点补全命令行补全
echo "source <(kubectl completion bash)" >> ~/.bashrc
echo "source <(kubeadm completion bash)" >> ~/.bashrc
source ~/.bashrc
5.3 拉取镜像并推送私有仓库
kubeadm 可自动列出并拉取集群所需镜像。这里先从阿里云镜像站拉取,再统一打标签推送到 Harbor,全程无需访问境外源:
kubeadm config images pull \
  --image-repository registry.aliyuncs.com/google_containers \
  --kubernetes-version v1.35.3 \
  --cri-socket=unix:///var/run/cri-dockerd.sock

# 重新打标签(google_containers/xxx → reg.timinglee.org/k8s/xxx)
docker images --format "{{.Repository}}:{{.Tag}}" |
  awk -F "/" '/google/{system("docker tag "$0" reg.timinglee.org/k8s/"$3)}'

# 批量推送
docker images --format "{{.Repository}}:{{.Tag}}" |
  awk -F "/" '/timinglee/{system("docker push "$0)}'
5.4 初始化集群(master 节点)
kubeadm init --pod-network-cidr=10.244.0.0/16 \
  --image-repository reg.timinglee.org/k8s \
  --kubernetes-version v1.35.3 \
  --cri-socket=unix:///var/run/cri-dockerd.sock
参数原理:
--image-repository reg.timinglee.org/k8s:指定组件镜像从私有仓库拉取,路径与 5.3 推送结果一致;--pod-network-cidr=10.244.0.0/16:声明 Pod 网段,必须与后续网络插件(Flannel 默认 10.244.0.0/16)保持一致,否则跨节点 Pod 无法互通;--cri-socket=unix:///var/run/cri-dockerd.sock:指定 CRI 运行时为 cri-dockerd。
初始化成功后输出 join 凭证(每次都不同):
kubeadm join 172.25.254.100:6443 --token tdwjoc.8d1yw3wl4r4tm6c4 \
  --discovery-token-ca-cert-hash sha256:6b5950ef2cdba85d6dfdb564ee90d4187fa3d341767dc9852cbdd5c9dee4f927
原理说明:join 凭证由两部分构成——bootstrap token(默认 24 小时有效的一次性准入凭证)与 discovery-token-ca-cert-hash(apiserver 根证书 SHA256 指纹,防止节点加入时被中间人欺骗)。token 过期后可在 master 上执行 kubeadm token create --print-join-command 重新生成。
配置 kubectl 环境并查看节点:
echo "export KUBECONFIG=/etc/kubernetes/admin.conf" > ~/.bash_profile
source ~/.bash_profile
kubectl get nodes
# NAME     STATUS     ROLES           AGE    VERSION
# master   NotReady   control-plane   102s   v1.35.3
5.5 工作节点加入集群
在 node1 / node2 上执行 join 命令(注意追加 --cri-socket 指向 cri-dockerd):
kubeadm join 172.25.254.100:6443 --token jl4ztx.cax3iysvu7onsh5s \
  --discovery-token-ca-cert-hash sha256:6b5950ef2cdba85d6dfdb564ee90d4187fa3d341767dc9852cbdd5c9dee4f927 \
  --cri-socket=unix:///var/run/cri-dockerd.sock
此时节点均为 NotReady —— 节点已成功入群,但集群网络尚未打通(缺少 CNI 插件),这是部署的正常中间态。
5.6 安装 Flannel 网络插件
CNI(Container Network Interface)是容器网络的标准接口。Flannel 基于 VXLAN 覆盖网络,在现有物理网络上隧道化传输 Pod 流量,实现跨节点 Pod 互通,且无需改动底层网络设备:
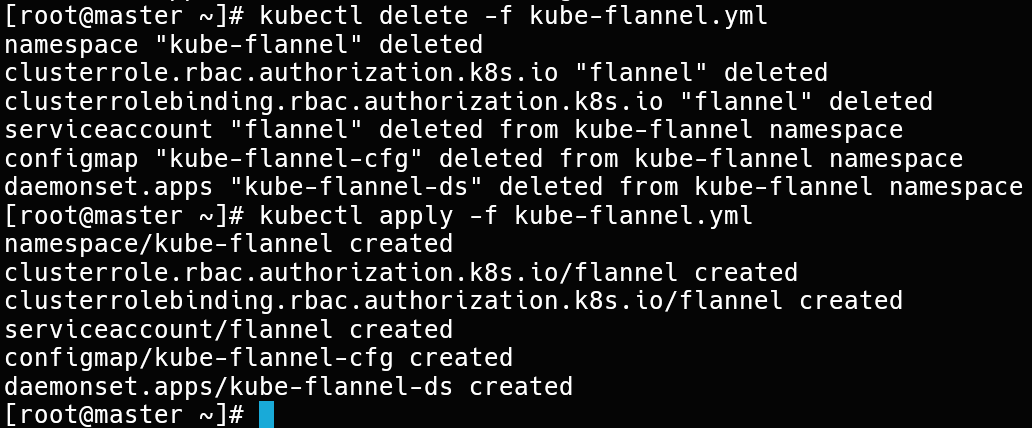
tips:网络通信出现问题可以
docker load -i flannel-0.28.1.tar

# flannel 主程序与 CNI 插件镜像推送到私有仓库
docker tag ghcr.io/flannel-io/flannel:v0.28.1 reg.timinglee.org/flannel-io/flannel:v0.28.1
docker push reg.timinglee.org/flannel-io/flannel:v0.28.1
docker tag ghcr.io/flannel-io/flannel-cni-plugin:v1.9.0-flannel1 reg.timinglee.org/flannel-io/flannel-cni-plugin:v1.9.0-flannel1
docker push reg.timinglee.org/flannel-io/flannel-cni-plugin:v1.9.0-flannel1

# 修改 kube-flannel.yml 中的 image 为私有仓库地址
vim kube-flannel.yml
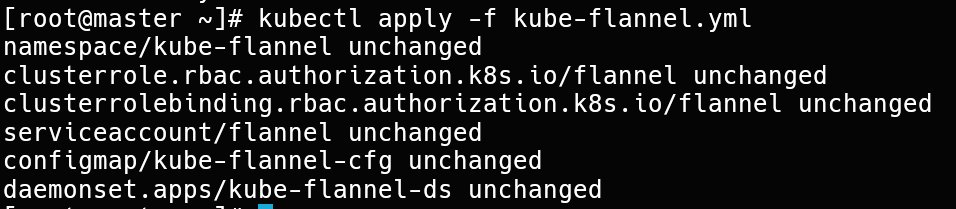
kubectl apply -f kube-flannel.yml
六、集群验证
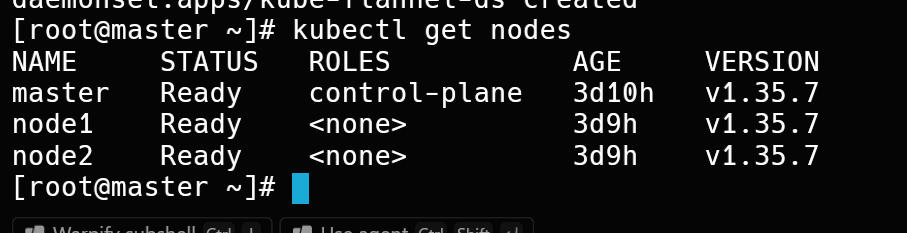
kubectl get nodes
# NAME     STATUS   ROLES           AGE     VERSION
# master   Ready    control-plane   13m     v1.35.3
# node1    Ready    <none>          9m44s   v1.35.3
# node2    Ready    <none>          9m36s   v1.35.3
三个节点全部 Ready,集群部署完成。
七、常见问题
| 现象 | 原因 | 解决 |
|---|---|---|
| 节点一直 NotReady | 网络插件未安装,或插件网段与 pod-network-cidr 不一致 | 安装 Flannel / Calico 并核对网段 |
| join 提示 token 无效 | bootstrap token 默认 24h 过期 | master 执行 kubeadm token create --print-join-command |
| 初始化中途失败 | 参数错误 / 网络问题 | kubeadm reset --cri-socket=unix:///var/run/cri-dockerd.sock 重置后重新 init,并清理 $HOME/.kube |
8.8 命令速记表
| 目的 | 常用命令 |
|---|---|
| 看节点 | kubectl get nodes -o wide |
| 看全部 Pod | kubectl get pods -A -o wide |
| 查 Pod 事件 | kubectl describe pod <pod> -n <ns> |
| 查容器日志 | kubectl logs <pod> -n <ns> |
| 看服务后端 | kubectl get endpointslices -n <ns> |
| 发布状态 | kubectl rollout status deployment/<name> -n <ns> |
| 回滚发布 | kubectl rollout undo deployment/<name> -n <ns> |
| 应用配置 | kubectl apply -f <file> |
| 预览差异 | kubectl diff -f <file> |
| 查事件 | kubectl get events -A --sort-by=.lastTimestamp |
| 进容器 | kubectl exec -it <pod> -n <ns> -- /bin/sh |
| 临时端口转发 | kubectl port-forward svc/<svc> 8080:80 -n <ns> |
掌握这些命令后,日常操作可以归纳为三类:
- 观察:用
get快速查看集群状态 - 定位:用
describe、logs、events排查问题 - 调整:用
apply、rollout、scale更新期望状态
更多推荐

 7
 0
- 0


 已为社区贡献4条内容

所有评论(0)