
Day44-微服务架构篇:Nacos注册中心与配置中心深度实践
90天从 CRUD 到 AI 工程师的完整跃迁路径 · Day 44 作者:数据军师·老梁
运维 Nacos 的方式,五花八门:
- 有人直接用默认 Derby 数据库跑在单节点上,宕机一次全完;
- 有人配置了 MySQL 持久化,但是把 3 个 Nacos 节点全连到同一个 MySQL,MySQL 一挂全完;
- 有人用 Nacos 做注册中心,结果不区分 AP/CP(distro/raft 协议),健康检查策略全靠默认心跳,服务一抖动就误剔除。
这是 Java 后端工程师最容易被忽视的"基础设施中的基础设施"。今天这篇,我把 Nacos 真正能上生产的姿势讲透:AP/CP 怎么选、配置灰度怎么发、集群怎么搭、跟 Eureka/Consul 到底差在哪。
一、先搞懂 Nacos 的双面性:注册中心 + 配置中心
Nacos 跟 Eureka/Consul 最大的不同:它把服务发现和动态配置合并成了一个产品。这两个能力背后,是两套完全不同的协议。
|
能力 |
协议 |
一致性模型 |
核心场景 |
|
服务注册发现 |
Distro(自研 AP 协议)+ 一致性临时实例 |
AP(可用性优先) |
服务上下线高频,不能因为少数节点故障就拒绝服务 |
|
持久化配置 |
Raft(CP 协议) |
CP(一致性优先) |
配置数据是控制面,错了就全错,必须强一致 |
怎么选? 一句话:服务发现用 AP,配置持久化用 CP。 Nacos 在 1.x 之后帮你做了内部切换,但你必须知道切换条件。
yaml
# Nacos 客户端配置:临时实例走 AP,持久实例走 CP
spring:
  application:
    name: order-service
  cloud:
    nacos:
      discovery:
        # ephemeral=true 走 distro 协议(AP),节点下线后自动剔除
        ephemeral: true
        # 心跳间隔默认 5s,5s 没收到心跳就标记不健康,15s 剔除
        heart-beat-interval: 5000
        heart-beat-timeout: 15000
      config:
        # 配置走 Raft(CP),必须保证集群多数节点写入成功才算成功
        server-addr: 127.0.0.1:8848
        file-extension: yaml
        # 命名空间做环境隔离(dev/test/prod)
        namespace: prod-xxxx
服务注册发现一定要用临时实例(ephemeral=true)。持久实例(false)要走 Raft 同步,节点上下线要过半节点确认,注册一次几百毫秒,根本扛不住几千个服务的频繁心跳。
Nacos 2.x 之后还引入了 gRPC 长连接 + 推送能力,心跳不再是 UDP 探测,而是客户端主动 keep-alive。这让服务变更的感知延迟从 5s 降到 200ms 以内。
二、AP/CP 切换的真实业务场景
很多教程告诉你"默认就是 AP"就完事了。但生产上,某些关键场景必须切 CP。
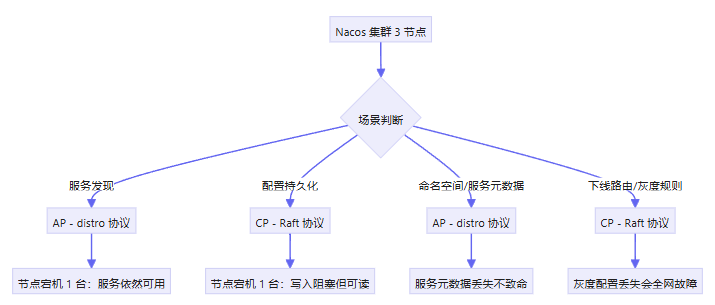
真实案例:一个支付路由服务,要求配置变更时整个集群必须同时感知,不能有的节点拿到新配置、有的还在跑旧的(否则会出现"老节点按新规则路由失败")。这种配置必须用持久化实例 + CP。
/**
 * Nacos 2.x 客户端:根据业务重要性选择一致性级别
 * 1. ephemeral=true → 临时实例,AP,服务发现专用
 * 2. ephemeral=false → 持久实例,CP,命名空间/路由规则专用
 */
@Service
public class DynamicRouteService {

    @NacosInjected
    private NamingService namingService;

    /**
     * 支付路由服务注册:必须用持久实例(CP)
     * 因为它挂了整个支付链路会受影响,宁可注册慢一点也不能丢
     */
    public void registerPayRoute() throws NacosException {
        Instance instance = new Instance();
        instance.setIp("10.0.0.5");
        instance.setPort(8080);
        instance.setEphemeral(false);  // 关键:持久实例走 Raft
        instance.setHealthy(true);
        instance.addMetadata("weight", "100");
        instance.addMetadata("region", "cn-east-1");

        namingService.registerInstance("pay-route-service", "DEFAULT_GROUP", instance);
    }
}
实战建议:
- 99% 的业务服务用 ephemeral=true(临时实例、AP)。服务挂了 Nacos 帮你摘掉,挂了 1 节点对业务无感。
- 关键元数据服务用 ephemeral=false(持久实例、CP)。比如:支付路由配置、灰度规则、限流阈值。这些丢了代价太大。
- 配置中心 永远走 CP(Nacos 内部自动用 Raft),不要尝试用临时配置。
三、配置中心的高级用法:灰度发布 + 监听 + 回滚
配置中心最值钱的功能不是"集中存配置",是"灰度发布 + 实时推送 + 一键回滚"。这才是替代 Spring Cloud Config 的核心价值。
3.1 灰度发布:让 5% 的服务先吃新配置
```java
/**
 * 灰度配置订阅:通过 Nacos 的 beta 机制实现
 * 步骤:
 * 1. 在 Nacos 控制台发布一个带 IP 标签的 beta 配置
 * 2. 指定灰度机器 IP(一般是 2~3 台)
 * 3. 灰度机器收到推送,其他机器无感知
 * 4. 验证无误 → 正式发布 → 全量推送
 */
@Component
public class GrayConfigSubscriber {

    private static final String DATA_ID = "order-service.yaml";
    private static final String GROUP = "DEFAULT_GROUP";

    @NacosConfigListener(dataId = DATA_ID, group = GROUP)
    public void onConfigUpdate(String newConfig) {
        // 反序列化新配置
        OrderConfig config = YamlUtil.parse(newConfig, OrderConfig.class);

        // 1. 校验配置合法性(防止上线就报错)
        if (config.getMaxRetryCount() < 0 || config.getMaxRetryCount() > 10) {
            log.error("配置非法,拒绝更新: maxRetryCount={}", config.getMaxRetryCount());
            return;
        }

        // 2. 动态替换业务参数(线程安全)
        ConfigCenter.update(config);

        // 3. 记录审计日志(谁在什么时候改了什么)
        auditLog.info("配置更新, maxRetryCount={}, timeout={}ms",
                     config.getMaxRetryCount(), config.getTimeoutMs());
    }
}
```
3.2 通过 Spring Cloud 原生方式监听
如果你用 Spring Boot,标准做法更简单:
# bootstrap.yml
spring:
  application:
    name: order-service
  cloud:
    nacos:
      config:
        server-addr: 127.0.0.1:8848
        file-extension: yaml
        # 关键:开启配置刷新
        refresh-enabled: true
        # 长轮询:30s 拉一次,服务端有变更会主动推送
        config-long-poll-timeout: 30000
/**
 * 任何 @Value 注入的配置,加了 @RefreshScope 就能热更新
 * 这是 Spring Cloud 提供的便利,但本质还是 Nacos 推送
 */
@RestController
@RefreshScope  // 关键注解:配置变更时重新初始化 Bean
public class OrderController {

    @Value("${order.max-retry-count:3}")
    private int maxRetryCount;

    @Value("${order.timeout-ms:5000}")
    private long timeoutMs;

    @GetMapping("/order/config")
    public Map<String, Object> showConfig() {
        return Map.of("maxRetryCount", maxRetryCount, "timeoutMs", timeoutMs);
    }
}
3.3 监听配置的"真正高级"用法
光刷新 @Value 不够用。生产上很多配置是结构化的、嵌套的,刷新到内存后还要触发业务行为变更(比如重新初始化线程池、重新加载路由表)。
/**
 * 高级监听:监听 Nacos 配置变更 + 重建业务对象
 * 场景:路由表变更后,必须重建 GrpcChannel 池
 */
@Component
public class RouteConfigRefresher implements ApplicationRunner {

    @NacosConfigListener(dataId = "route-table.json", group = "GATEWAY_GROUP")
    public void onRouteTableUpdate(String newConfig) {
        // 1. 解析新的路由表
        List<RouteRule> newRules = parseRoutes(newConfig);

        // 2. 原子替换:双缓冲,避免读到一半的配置
        AtomicReference<List<RouteRule>> ref = RouteTableHolder.getRef();
        List<RouteRule> oldRules = ref.get();
        if (!ref.compareAndSet(oldRules, newRules)) {
            log.warn("路由表更新冲突,重试一次");
            ref.set(newRules);
        }

        // 3. 关闭旧的 gRPC 连接池(避免连接泄漏)
        if (oldRules != null) {
            GrpcChannelPool.evictChannels(oldRules);
        }
    }
}
四、Nacos 集群部署:3 节点是最小生产单位
生产上 Nacos 必须 3 节点起步,最好 5 节点。 单点 Nacos 等于没有高可用。
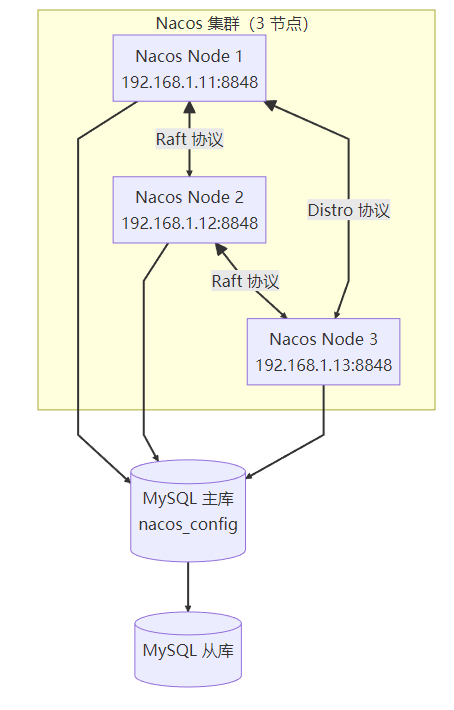
4.1 集群核心配置
# application.properties(每个节点都要配)
server.port=8848
nacos.inetutils.ip-address=192.168.1.11

# 集群节点列表(每个节点都要列全)
nacos.cluster.member.list=192.168.1.11:8848,192.168.1.12:8848,192.168.1.13:8848

# MySQL 持久化(必须,所有节点共享同一 MySQL)
spring.datasource.platform=mysql
db.url.0=jdbc:mysql://192.168.1.20:3306/nacos_config?useSSL=false&serverTimezone=Asia/Shanghai
db.user.0=nacos_user
db.password.0=Nacos@2024!

# Raft 日志存储
nacos.core.protocol.raft.data.path=/data/nacos/raft
4.2 客户端连接集群
yaml
spring:
  cloud:
    nacos:
      discovery:
        # 写多个地址,客户端自动重试
        server-addr: 192.168.1.11:8848,192.168.1.12:8848,192.168.1.13:8848
        # 命名空间:每个环境独立
        namespace: prod-aaaaa-bbbb-cccc-ddddd
关键点:客户端连的是 Nacos 的 8848 端口(HTTP/gRPC),Nacos 内部通过 7848 端口做集群节点间通信(gRPC)。7848 必须互通,否则集群脑裂。
4.3 集群健康检查脚本
#!/bin/bash
# nacos-health-check.sh
# 每分钟执行一次,监控 Nacos 集群健康状态

NACOS_NODES=("192.168.1.11:8848" "192.168.1.12:8848" "192.168.1.13:8848")
HEALTHY_COUNT=0

for NODE in "${NACOS_NODES[@]}"; do
    IP=$(echo $NODE | cut -d: -f1)
    PORT=$(echo $NODE | cut -d: -f2)

    # 调用 Nacos 健康检查接口
    HTTP_CODE=$(curl -s -o /dev/null -w "%{http_code}" \
        "http://$IP:$PORT/actuator/health")

    if [ "$HTTP_CODE" = "200" ]; then
        echo "[OK] $NODE is healthy"
        HEALTHY_COUNT=$((HEALTHY_COUNT+1))
    else
        echo "[DOWN] $NODE is unhealthy (HTTP $HTTP_CODE)"
        # 发送告警
        curl -X POST "http://alertmanager/api/v1/alerts" \
            -d "{\"labels\":{\"severity\":\"critical\"},\"annotations\":{\"summary\":\"Nacos 节点 $NODE 失联\"}}"
    fi
done

# 集群可用性判断:存活节点数必须 >= 2(3节点集群允许挂1台)
if [ $HEALTHY_COUNT -lt 2 ]; then
    echo "[CRITICAL] Nacos 集群不可用,仅 $HEALTHY_COUNT 节点存活"
    # 触发紧急告警
fi
五、Nacos vs Eureka vs Consul:真实选型矩阵
|
维度 |
Nacos 2.x |
Eureka 2.x |
Consul 1.16 |
|
一致性 |
AP+CP 双模 |
AP only |
CP(基于 Raft) |
|
配置中心 |
✅ 内置 |
❌ 无 |
✅ KV 存储 |
|
健康检查 |
客户端心跳 + 服务端探测 |
仅客户端心跳 |
多协议(HTTP/TCP/gRPC) |
|
长连接推送 |
✅ gRPC |
❌ 轮询 |
✅ Long Polling |
|
灰度发布 |
✅ Beta + Tag |
❌ |
✅(需结合 Consul Template) |
|
多语言 |
Java/Go/Python/Node |
Java only |
多语言 |
|
运维成本 |
中(需 MySQL 支撑) |
低 |
中(需部署多节点) |
|
适用场景 |
阿里系/Spring Cloud Alibaba |
Netflix 技术栈 |
多语言混合云 |
实战建议:
- 如果你的技术栈是 Spring Cloud Alibaba,直接用 Nacos,别犹豫。配置中心和注册中心开箱即用,中文文档完整,社区活跃。
- 如果你的技术栈是 Spring Cloud Netflix,继续用 Eureka + Spring Cloud Config。强行迁移 Nacos 收益不大。
- 如果你的服务是多语言混合(Go + Java + Python),用 Consul。它的健康检查和多语言 SDK 更成熟。
- 如果你要做单元化的灰度发布(同服务多版本灰度),Nacos 的 Tag + Metadata 比 Eureka 强一档。这是国内大厂几乎都选 Nacos 的原因。
六、经验
1. Nacos 必须 3 节点起步 + MySQL 持久化,缺一不可
单点 Nacos + 内嵌 Derby 数据库 = 业务定时炸弹。一旦节点宕机,所有服务发现失效,所有配置拉取失败。MySQL 一定要做主从,否则 Nacos 集群再怎么稳也没用。
2. 临时实例用 AP,持久实例用 CP,但不要随便用持久实例
持久实例的注册延迟是临时实例的 5~10 倍(要走 Raft 同步)。如果你把所有服务都设成持久实例,注册中心会变成性能瓶颈。只有那些"挂了代价巨大"的核心服务才用持久实例(支付路由、限流配置中心、风控规则服务)。
3. Nacos 2.x 之前是 HTTP 短轮询,2.x 之后是 gRPC 长连接
升级到 2.x 后,配置推送延迟从秒级降到百毫秒级。但 gRPC 对网络更敏感——集群节点之间必须保证 7848 端口互通。我见过太多团队升级完 Nacos 2.x 后集群脑裂,全是因为 7848 端口没在防火墙开放。
结尾
注册中心是微服务的"神经系统",看似不起眼,挂一次就要命。与其在故障后疯狂救火,不如在上线前把 Nacos 的高可用和配置灰度做扎实。
下篇预告:Day 45 我们讲 Sentinel 流量治理——限流、熔断、降级、自适应保护,从规则配置到生产调优完整实战。Sentinel 是 Spring Cloud Alibaba 的"防御三件套"之一,理解了 Nacos 之后再聊 Sentinel,会更顺。
更多推荐


 17
 0
- 0


 已为社区贡献5条内容

所有评论(0)