
文本匹配问题:传统统计算法 -> BERT预训练模型 -> LLM大模型
第一章 文本匹配业务定义与工业全场景
1.1 文本匹配基础定义
文本匹配是 NLP 领域基础核心任务:给定一对文本(文本 A、文本 B),通过算法计算两段内容的语义关联程度,最终输出 0~1 区间的相似度分数,或是「相似 / 不相似 / 蕴含 / 矛盾」分类标签。
任务核心目标不只是匹配字面文字,而是判断深层语义是否等价、相关或存在逻辑关系,是检索、对话、问答系统必不可少的底层组件。
1.2 主流业务场景
- 意图识别
输入:用户 query vs 预设意图模板;
示例:用户 “帮我退订单” 匹配「退款」业务意图,用于客服对话路由。 - FAQ 问答检索
输入:用户提问 vs 知识库标准问题;
示例:用户 “花呗怎么分期” 匹配库中相近标准问答,快速返回答案。 - 语义搜索
输入:用户检索词 vs 海量文档 / 文章段落;
示例:搜索 “人工智能就业前景” 召回相关行业资讯、教程。 - 文本去重与内容聚类
输入:多条新闻、评论、UGC 文本两两比对;
示例:聚合重复新闻、把同主题评论归类,清洗冗余数据。 - 自然语言推断 (NLI)
输入:前提文本 vs 假设文本;
判断三者关系:蕴含、矛盾、中性,常用于文本理解评测。
1.3 统一核心痛点
- 字面不一致但语义相同:句式改写、同义词替换,纯字符 / 关键词匹配无法识别;
- 字面高度重合但语义无关:词汇重叠多但表达完全相反,容易产生误匹配;
- 一词多义歧义:同一个词语在不同上下文代表不同含义,简单词向量无法区分;
- 文本长度差异干扰判断:长短文本、短句 vs 长段落,统计算法容易出现长度偏差;
- 领域新词 / 专业术语缺失:垂直行业专有名词、网络新词无有效表征,降低匹配精度。
第二章 传统统计文本匹配方法
2.1 字符级匹配:编辑距离
将字符串 A 变换为字符串 B 所需的最少单字符编辑操作数(插入、删除、替换)
刷力扣的对这个问题挺熟悉的,可以跳转力扣的第72题。
常规解法是动态规划,往A插入等价于在B删除。其实就三种转移方式:在A后面加1个;在B后面加1个;如果字母相等、不用加
# dp[i][j] 表示word1下标为i之前、word2下标为j之前的最少操作次数
class Solution:
    def minDistance(self, word1: str, word2: str) -> int:
        n, m = len(word1), len(word2)
        if n * m == 0:
            return n + m

        dp = [[0]*(m+1) for _ in range(n+1)]

        for i in range(n+1):
            dp[i][0] = i
        for i in range(m+1):
            dp[0][i] = i

        for i in range(n):
            for j in range(m):
                if word1[i] == word2[j]:
                    dp[i+1][j+1] = min(dp[i][j], dp[i+1][j]+1, dp[i][j+1]+1)
                else:
                    dp[i+1][j+1] = min(dp[i][j+1], dp[i+1][j], dp[i][j]) + 1

        return dp[n][m]
编辑距离是后端开发者最容易上手的基础文本匹配算法。这个方法在精准匹配上有优势,但也有其局限性:无法理解语义;计算开销慢
2.2 初代词向量基线:Word2Vec/GloVe均值匹配
做法是先有一个词表,然后提取出句子里面的词,比如一个句子有三个词,将这三个词的词向量做个平均,将结果表示这个句子。然后计算两个句子向量的余弦相似度,分数越高代表文本越相似。
优势:
- 具备基础语义能力,能识别同义词、近义词,优于纯字符、关键词匹配;
- 推理速度快,无需深度学习框架,轻量化易部署;
- 无需标注数据,仅依靠无监督语料即可训练词向量,冷启动成本低。
劣势:
- 词袋假设,丢失语序:“猫追狗” 与 “狗追猫” 均值向量完全一致,无法区分语义;
- 一词多义无法区分:同一个词只有单一固定向量,无法根据上下文区分多义(bank = 银行 / 河岸);
- 未登录词 OOV 问题:新词、专业术语不在词表中,无法生成向量,丢失语义信息;
2.3 统计检索算法:TF-IDF
这个统计算法认为:一段文本里,出现频率高、且在全局文档中罕见的词汇,是区分文本语义的核心特征。TF-IDF 结合「词频」与「逆文档频率」,给每个词汇赋予权重,通过两段文本的特征向量相似度完成匹配检索。
核心思想:词的重要性 = 在本文档的词频(TF)× 在整个文档集中的稀有程度(IDF)
TF(t,d) = 词t出现次数 / 文档d总词数
IDF(t) = log(N / df(t)) N=总文档数, df=含t的文档数
TF-IDF 综合得分:score(t, d) = TF(t, d) × IDF(t)
比如说 “的” 这个词几乎在每个文章里面都有,它的IDF就很低,得分约等于0;“深度学习”这个词大多数在ai相关的专业文章出现,得分就会高,如果一篇文章是写的学习经验分享、用到了“深度学习”这个词(如:黄同学深度学习了写作技巧),但是整篇文章只出现了这一次,得分也不会高。
优点
- 无监督,不需要人工标注数据,开箱即用;
- 自动压低通用虚词权重,放大专业关键词的区分作用;
- 计算简单、速度快,适合大规模文档粗召回;
- 工业搜索引擎早期标配,ES 等检索引擎原生支持。
缺点
- 仅停留在字面关键词匹配,完全不理解语义,无法识别同义词;
- 长文档天然占优:文本越长,词越多,TF-IDF 总分更容易偏高;
- 不考虑词语顺序、句法结构,纯词袋模型;
- 无法解决一词多义,相同词汇在不同语境下权重一致。
2.4 工业检索标配:BM25(TF-IDF升级版)
BM25 是对 TF-IDF 两大缺陷的针对性优化:一是 TF 无上限叠加导致重复词汇权重爆炸,二是长文档天然得分偏高。它引入 TF 饱和机制与文档长度归一化,更贴合人类检索逻辑,是 Elasticsearch、OpenSearch 等检索引擎默认的召回算法,也是 RAG 系统通用粗召回基线。
公式是:BM25(q,d) = Σ IDF(qi) × f(qi,d)×(k1+1) / [f(qi,d) + k1×(1-b + b×|d|/avgdl)]
参数说明:
- (f(q_i,d)):查询词 (q_i) 在文档 d 中的出现次数;
- (|d|):当前文档长度,avgdl:全量语料平均文档长度;
- (k_1):控制词频饱和速度,工业常用 1.2~2.0,推荐 1.5;
- b:文档长度归一化强度,取值 0~1,推荐 0.75;
- (IDF(q_i)):沿用 TF-IDF 逆文档频率,区分通用词与专业词。
优点
- 继承 TF-IDF 无监督、轻量化、高速检索的优势,无需标注;
- 解决 TF-IDF 长文档偏向、关键词堆砌作弊问题,检索相关性显著提升;
- 各大检索引擎原生内置,部署简单,是工业落地通用基线;
- 常作为深度学习向量模型的兜底召回方案,防止向量失效无结果。
缺点
- 仍属于关键词匹配模型,不具备深层语义理解,无法匹配同义词、句式改写;
- 只做词级字面匹配,无法处理多义词、语义蕴含类文本;
- 不支持提前预计算文档特征,每次检索需要遍历候选文档实时计算分数,海量数据召回速度弱于向量模型。
2.5 传统方法横向对比小结
| 方法 | 语义理解能力 | 推理速度 | 核心优势 | 明显短板 | 适用场景 |
|---|---|---|---|---|---|
| 编辑距离 | 无(仅字符匹配) | 极快 | 精准匹配字形、拼写纠错 | 完全不懂语义,长文本计算慢 | OCR后处理、拼写纠错、短文本精确匹配 |
| Word2Vec/GloVe均值 | 基础近义词能力 | 快 | 能识别同义词,无标注即可使用 | 丢失语序、一词多义、OOV新词失效 | 简单短文本粗匹配、低资源小业务基线 |
| TF-IDF | 无(纯关键词统计) | 快 | 自动过滤虚词,突出专业关键词 | 长文档加分、关键词堆砌权重无限上涨 | 简单文档检索、简易文本去重 |
| BM25 | 无(纯关键词统计) | 快 | 修复TF-IDF长度偏差、词频饱和,工业标准 | 仅字面匹配,无法理解深层语义 | ES/检索引擎召回、RAG粗召回兜底、FAQ基线 |
第三章 BERT预训练时代
3.1 两大核心架构:BiEncoder vs CrossEncoder
3.1.1 架构差异对比
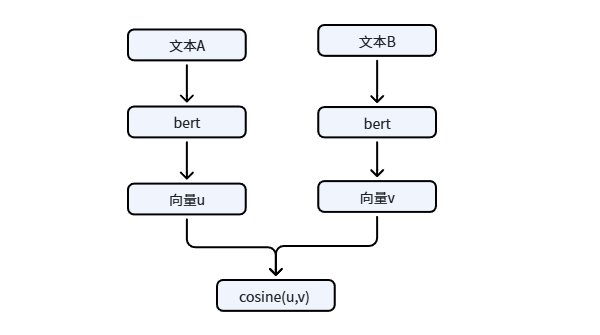
表示型 BiEncoder示意图:
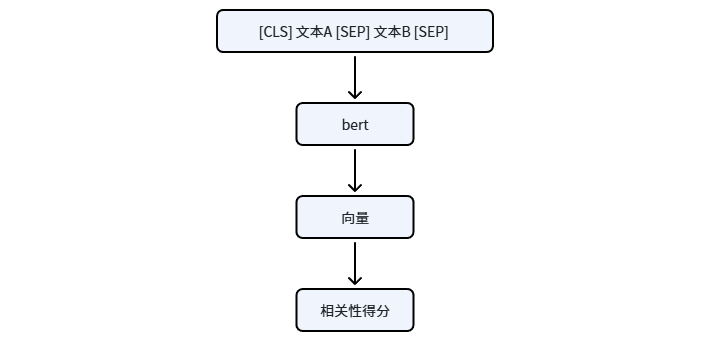
交互型 CrossEncoder示意图:
BiEncoder 的做法是先离线预计算文档向量,在线查询只需向量相似度计算 (ANN),适合百万级大规模召回
CrossEncoder 的精度显著更高,无法预计算,只适合小规模的精排
3.1.2 BiEncoder 与 CrossEncoder 对比
| 维度 | BiEncoder(表示型) | CrossEncoder(交互型) |
|---|---|---|
| 编码方式 | A、B各自独立编码 | A+B拼接联合编码 |
| 交互深度 | 仅在最后向量层计算相似度 | 所有BERT层全深度交互 |
| 离线预计算 | 可以(文档库预计算完毕) | 不可以(需要query才能编码) |
| 在线时间 | O(1) 向量相似度查找 | O(N) N次BERT推理 |
| 延迟(10万docs) | < 1ms (ANN) | 分钟级(不可接受) |
| 精度 | 中等 | 更高(token‑级交互) |
| 适用规模 | 百万/亿级 | 百~千级候选 |
| 典型应用 | 大规模召回/检索 | 精排/重排序 |
两者不是替代关系,而是互补关系。效率优先选 BiEncoder,精度优先选 CrossEncoder,实际工业场景常组合使用。
3.1.3 工业标准流水线:双塔粗召回 + Cross精排
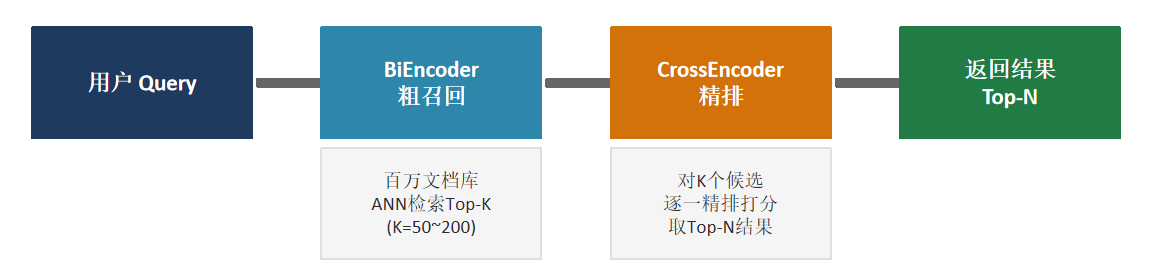
- 先用 BiEncoder 双塔模型做海量文档粗召回,快速筛选出一批相似度靠前的候选文本;
- 再把少量候选送入 CrossEncoder 交互模型做精细重排序,提升最终匹配精度。
优势:兼顾大规模检索速度与细粒度语义匹配效果,是检索、FAQ、RAG 场景通用方案。
3.2 训练方法
3.2.1 两种主流训练损失
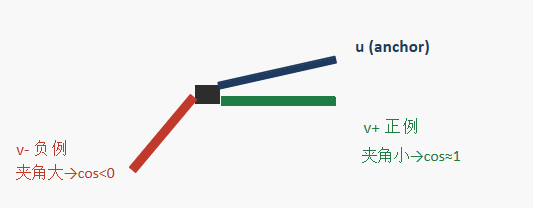
训练方式一:CosineEmbeddingLoss
输入:文本正负样本对,正例标签+1,负例标签-1
正例的 Loss = 1 - cos(u, v),目标:cos(u,v) -> 1,向量方向完全一致
负例的 Loss = max(0, cos(u,v) - margin),目标:cos(u,v) < margin(默认0),向量足够远
训练方式二:Triplet Loss
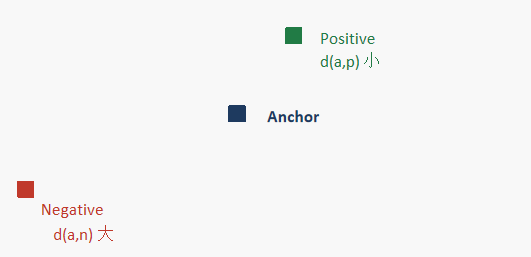
核心思想:三元组 (anchor, positive, negative) —— 正例更近,负例更远
Loss = max(0, d(a,p) - d(a,n) + margin)
3.2.2 进阶对比学习优化
- SimCSE无监督方案:同一句子两次经过模型,依靠不同dropout生成两个向量作为正例,同 batch 其他句子自动作为负例,无需人工标注;
- In-Batch批内负例:同一个batch内其余句子自动作为负样本,负例数量充足,大幅提升向量区分度;
第四章 LLM大模型实现文本匹配
4.1 Prompt方案
就是熟悉的写提示词方案了,比如这样写:
判断以下两句话是否表达相同意思。
只输出"相同"或"不同",不解释。

句子1: {text_a}
句子2: {text_b}

答案:
也可以加上示例
你是一个意图匹配专家。判断用户输入
是否与意图描述匹配(是/否)。

示例1:
 输入: "帮我订明天去上海的机票"
 意图: "航班预订"
 答案: 是

示例2:
 输入: "查一下明天天气"
 意图: "航班预订"
 答案: 否

现在请判断:
 输入: "{query}"
 意图: "{intent}"
 答案:
4.2 伪标签蒸馏BERT小模型
蒸馏就是抄答案,把业务文本发给优秀的llm模型,让llm生成给bert的训练数据。
4.3 微调
lora微调,步骤与之前博客写的一样,可以到“文本分类”这个文章里看下。
第五章 核心代码与流程
5.1 BiEncoder 模型
经过共享的bert处理后,选择一个池化策略提取表征,然后dropout,再归一化
class BiEncoder(nn.Module):
    """
    表示型文本匹配:Siamese Bi-Encoder

    结构:
      shared BertModel → 池化 → Dropout → L2 归一化 → 句向量

    匹配方式:
      sim = cosine_similarity(encode(s1), encode(s2))
      sim ∈ [-1, 1],越接近 1 越相似

    支持两种 Loss:
      CosineEmbeddingLoss — 直接用相似度与标签计算损失
      TripletLoss         — 拉近 (anchor, positive),推远 (anchor, negative)

    参数:
      bert_path         : 预训练权重路径(本地目录或 HuggingFace 模型名)
      pool              : 向量提取策略,'cls' / 'mean' / 'max'
                          mean 在句子相似度任务上通常优于 cls(Sentence-BERT 结论)
      dropout           : Dropout 比例
      num_hidden_layers : BERT Transformer 层数;None = 全量 12 层
    """

    def __init__(self, bert_path, pool="mean", dropout=0.1, num_hidden_layers=None):
        super().__init__()
        assert pool in ("cls", "mean", "max"), f"pool 须为 cls/mean/max,收到: {pool}"

        config = BertConfig.from_pretrained(bert_path)
        if num_hidden_layers is not None:
            config.num_hidden_layers = num_hidden_layers

        _prev = transformers.logging.get_verbosity()
        transformers.logging.set_verbosity_error()
        self.bert = BertModel.from_pretrained(bert_path, config=config)
        transformers.logging.set_verbosity(_prev)

        self.pool    = pool
        self.dropout = nn.Dropout(dropout)

    def encode(self, input_ids, attention_mask, token_type_ids):
        """
        单句编码,返回 L2 归一化后的句向量 [B, H]

        L2 归一化后:cosine_sim(u, v) == dot(u, v)
        可用矩阵乘法批量计算所有两两相似度,适合向量检索场景(如 RAG)
        """
        out = self.bert(
            input_ids=input_ids,
            attention_mask=attention_mask,
            token_type_ids=token_type_ids,
            return_dict=True,
        )
        vec = self._pool(out.last_hidden_state, attention_mask)  # [B, H]
        vec = self.dropout(vec)
        return F.normalize(vec, p=2, dim=-1)

    def forward(self, batch_a, batch_b):
        """返回 (emb_a, emb_b),各形状 [B, H],可直接计算余弦相似度"""
        emb_a = self.encode(**batch_a)
        emb_b = self.encode(**batch_b)
        return emb_a, emb_b

    def _pool(self, last_hidden, attention_mask):
        if self.pool == "cls":
            return last_hidden[:, 0, :]

        mask = attention_mask.unsqueeze(-1).float()  # [B, L, 1]

        if self.pool == "mean":
            sum_h = (last_hidden * mask).sum(dim=1)
            count = mask.sum(dim=1).clamp(min=1e-9)
            return sum_h / count

        if self.pool == "max":
            masked = last_hidden + (1 - mask) * (-1e9)
            return masked.max(dim=1).values
5.2 CrossEncoder 模型
输入格式:[CLS] 句子1 [SEP] 句子2 [SEP],经过bert处理后接一个二分类头
class CrossEncoder(nn.Module):
    """
    交互型文本匹配:Cross-Encoder

    结构:
      BertModel([CLS] s1 [SEP] s2 [SEP]) → CLS 向量 → Dropout → Linear(H, 2) → logits

    对比 BiEncoder:
      优点:两句在每一层都交互,表达能力更强,精度更高
      缺点:无法预计算向量,每对句子都要完整过 BERT,不适合大规模检索
      典型用途:Reranker(对召回的 Top-K 候选精排),即 rag_annual_report 中的做法

    参数:
      bert_path         : 预训练权重路径
      dropout           : 分类头 Dropout 比例
      num_hidden_layers : 同 BiEncoder,限层数加速
    """

    def __init__(self, bert_path, dropout=0.1, num_hidden_layers=None):
        super().__init__()

        config = BertConfig.from_pretrained(bert_path)
        if num_hidden_layers is not None:
            config.num_hidden_layers = num_hidden_layers

        _prev = transformers.logging.get_verbosity()
        transformers.logging.set_verbosity_error()
        self.bert = BertModel.from_pretrained(bert_path, config=config)
        transformers.logging.set_verbosity(_prev)

        hidden_size  = self.bert.config.hidden_size
        self.dropout = nn.Dropout(dropout)
        self.classifier = nn.Linear(hidden_size, 2)

    def forward(self, input_ids, attention_mask, token_type_ids):
        """返回 logits [B, 2],未经 softmax(CrossEntropyLoss 内部处理)"""
        out = self.bert(
            input_ids=input_ids,
            attention_mask=attention_mask,
            token_type_ids=token_type_ids,
            return_dict=True,
        )
        cls_vec = out.last_hidden_state[:, 0, :]  # [B, H]
        cls_vec = self.dropout(cls_vec)
        return self.classifier(cls_vec)            # [B, 2]
5.3 BiEncoder 余弦损失训练流程
- 读取句子对数据集,每条样本包含句子 1、句子 2、标签(1 代表相似,0 代表不相似);
- 两句文本分别送入权重共享的 BERT,经过池化、L2 归一化,得到两条独立句向量;
- 将原始标签 {0,1} 映射为损失函数需要的 {‑1, 1};
- 使用 CosineEmbeddingLoss 优化向量相似度:正样本尽量让余弦相似度靠近 1;负样本相似度低于 margin(0.3)便不会产生损失;
- 依靠梯度累积节省显存、梯度裁剪防止梯度爆炸,配合 Warm‑up 学习率迭代更新 BERT 参数;
- 一轮训练结束后在验证集搜索最优相似度阈值,划分相似 / 不相似,保存 F1 指标最优的双塔模型。
5.4 BiEncoder 三元组损失训练流程
- 仅依托原始训练集当中 label=1 的正样本对,每一条正样本对生成一组 (anchor基准句、positive相似句、negative随机负样本)。negative如果在出现过(label为0)用出现的,不然随机选一条;
- 三份文本分别调用 encode 经过权重共享BERT、池化、L2归一化,得到三条独立的单位句向量;
- 执行 Triplet‑Margin‑Loss 约束向量间距:让基准句和正样本的欧氏距离,比基准句和负样本的距离至少小 margin(0.3);
- 通过梯度累积节约显存、梯度裁剪规避梯度爆炸,搭配 Warm‑up 学习率更新模型权重;
- 每轮训练完毕后在验证集搜寻最佳相似度阈值区分相似、不相似样本,保存F1指标最优的双塔模型。
5.5 CrossEncoder 训练流程
- 读取原始句子对数据集,样本包含句子1、句子2以及匹配标签(1代表相似,0代表不相似);
- 将两条文本拼接为
[CLS] s1 [SEP] s2 [SEP]的完整序列,依靠 token_type_ids 区分两段句子; - 拼接之后的整段Token送入BERT,依靠自注意力机制实现两句之间多层语义交互;
- 取出 [CLS] 特征向量,经过Dropout和全连接分类头输出二分类logits;
- 使用 CrossEntropyLoss 计算分类损失,采用梯度累积节省显存、梯度裁剪防止梯度爆炸,搭配Warm‑up学习率策略更新模型参数;
- 验证阶段直接对logits执行argmax获取预测结果,不需要搜索相似度阈值;保存验证集F1指标最优的模型权重。
第六章 全方案横向对比 & 落地选型小结
6.1 全技术方案综合对比表
本文使用的是 AFQMC数据集。label 0 表示不匹配,label 1表示匹配
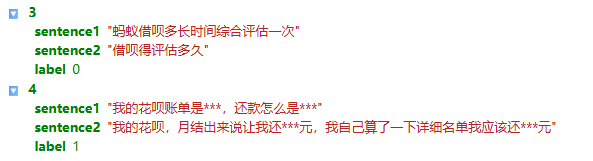
bert设置的12层,效果如下:
| 实现方案 | 整体准确率 | 加权 F1 | 总训练时长 |
|---|---|---|---|
| BiEncoder‑余弦损失 | 0.7338 | 0.7321 | ~3.9 min(3 epoch × 78s) |
| BiEncoder‑三元组损失 | 0.6974 | 0.7037 | ~1.8 min(3 epoch × 35s) |
| CrossEncoder 交叉编码器 | 0.7410 | 0.7405 | ~3.6 min(3 epoch × 71s) |
| Qwen‑Plus API(零样本) | 0.7000 | 0.6610 | 0(无需训练) |
| Qwen2‑0.5B LoRA 微调 | 0.6400 | 0.6534 | ~5.2 min(3 epoch × 103s) |
6.2 分场景选型总结
| 实现方案 | 核心优势 | 现存短板 | 适用业务场景 |
|---|---|---|---|
| BiEncoder‑余弦损失 | 精度表现优秀;双塔可离线缓存向量;训练开销适中 | 需要在验证集搜索最优相似度阈值 | 大规模知识库召回、RAG粗召回、百万级文本检索 |
| BiEncoder‑三元组损失 | 训练耗时最短,向量表征优化方向 | 随机负样本效果一般,整体精度最低 | 向量库优化、检索任务;搭配在线难负样本挖掘后能力提升 |
| CrossEncoder 交叉编码器 | 准确率与加权F1最优,句间深度语义交互 | 无法预计算向量,推理速度慢 | 候选集精排、文本相似度打分、意图匹配精细筛选 |
| Qwen‑Plus API(零样本) | 无需训练、开箱即用,省去数据集调试 | 指标弱于微调BERT,调用成本高、延迟不可控 | 项目快速原型测试、小规模临时业务 |
| Qwen2‑0.5B LoRA 微调 | 适配复杂高阶语义任务潜力大 | 训练耗时最长,本次文本匹配效果垫底 | 带有上下文、复杂推理的高级文本匹配;简单任务不推荐 |
更多推荐
 8
 0
- 0


 已为社区贡献4条内容

所有评论(0)