
大模型训练故障诊断:从进程栈、日志到Profiling的时空对比分析思路
作者:LQL、AEPJ、CHD(HPC Group @ Shanghai AI Lab)
大模型训练任务的故障诊断面临一个典型矛盾:用户看到的现象往往是全局性的(例如任务 hang、训练崩溃、step time 变慢、NCCL timeout 或 loss 异常);但触发这些现象的原因可能是局部的(例如某个 rank 的数据加载阻塞、某个节点的网卡异常、某块 GPU 的硬件错误,或者某个训练阶段的配置问题)。
训练过程的强同步机制导致了这一现象:局部异常会扩散为全局等待。同时,训练结构的同步性(不同 rank 在相近阶段的相似行为)及周期性(同一 rank 在稳定阶段的重复行为)的特征,也为通过空间或时间对比来定位故障提供了条件。
本文从训练任务自身的结构特点出发,梳理 L4、EROICA、SysOM-AI、Minder、C4 等工作中的诊断思路与工程经验,将它们归纳为三条对比轴线——空间对比、时间对比和跨任务对比,并分别从进程栈、日志和 Profiling 三个数据层面展开分析。本文将详细介绍:训练故障诊断中为什么“对比”是有意义的,已有的对比分析方法与经验,以及落地到诊断系统中需要处理哪些工程细节。
1. 问题界定
训练任务故障诊断至少包含三个层次的问题。
第一是症状识别。任务是否已经异常?异常表现为 hang、crash、slowdown、OOM、NCCL timeout,还是 loss NaN/Inf?这一步关注用户可见现象。
第二是范围定位。异常最早出现在什么时间窗口?影响了哪些 rank、节点、GPU、NIC 或通信组?这一步关注异常的时空范围。
第三是原因解释。哪些事件更可能是上游原因,哪些事件只是下游表现?这一步关注现象之间的解释关系。
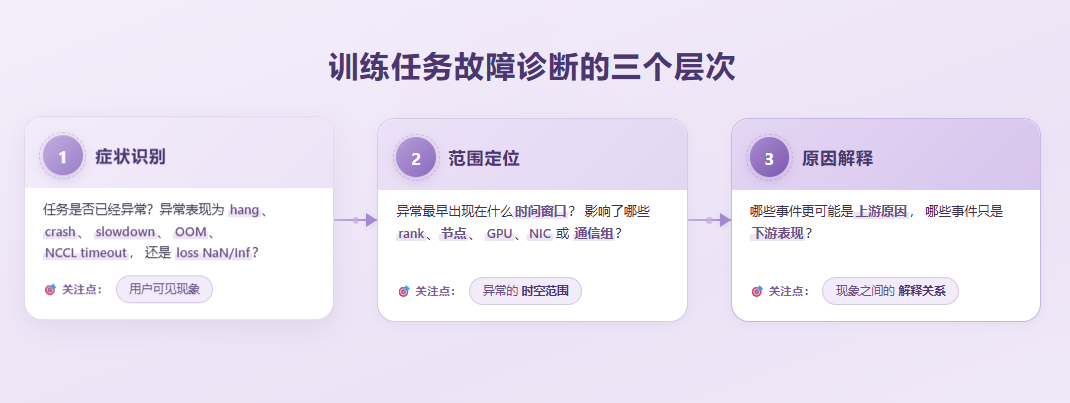
在训练任务中,这三个问题经常纠缠在一起。一个 rank 没有进入 collective,其他 rank 可能全部卡在通信等待;一个节点上的 IB 端口异常,应用层日志可能只显示 NCCL watchdog timeout;一个节点更早退出,反而可能缺少后续错误日志。因此,诊断时不能只依赖单条错误文本或单个指标尖峰,还需要把观测数据放回训练任务的执行结构中解释。
本文讨论的“对比分析”并不替代日志规则、指标阈值、profiling 或专家经验。它更像一个组织诊断线索的视角:同一角色下的 rank 在相近时间窗口内应当表现相似,同一 rank 在稳定训练阶段的相邻迭代中应当表现相似,失败任务与配置相近的成功任务相比应当存在可解释差异,异常影响范围也应尽量能被 rank、节点、设备和通信组拓扑解释。
2. 训练任务中的可比较结构
对比分析要成立,前提是对象确实可比。训练任务在并行、迭代与拓扑约束下呈现四类稳定结构,从两个角度支撑后文对比:强同步让局部异常扩散为全局等待,迫使诊断必须横向比较以区分等待者与阻塞者;同质性、周期性与拓扑则提供可比条件,分别让空间离群可被识别、时间突变可被定位、异常范围可被解释。下面将分别展开。
2.1 强同步:局部异常会扩散为全局等待
大规模训练依赖大量同步和通信点。在不同并行策略中,训练过程可能出现 AllReduce、ReduceScatter、AllGather、AllToAll、Send/Recv、barrier 等操作;一旦某个 rank 没有按预期推进,其他 rank 就可能在同一阶段进入等待。
强同步带来的诊断挑战是:故障影响范围可能远大于根因范围。例如,rank 7 因数据读取阻塞没有进入反向传播通信,其他 rank 可能全部停在 collective wait。此时,“大多数 rank 都卡在 NCCL”并不必然说明 NCCL 是根因,它也可能只是等待链条的下游表现。
因此,在强同步场景中,诊断需要区分等待者和阻塞者。这个区分很难通过单个 rank 的单次观测完成,通常需要横向比较多个 rank 的状态。
2.2 同质性:正常 rank 应该具有相似行为
在 SFT、预训练等任务中,不同 rank 通常运行相同训练代码,处理形态相近的数据 batch,经历类似的 data loading、forward、backward、communication 和 optimizer step。正常情况下,不同 rank 的日志模板、调用栈路径、迭代节奏和通信事件分布应具有较高相似性。
同质性使空间对比具有意义: 如果少数 rank 的日志、栈或耗时模式显著偏离大多数 rank,这些偏离可以作为候选异常信号。
需要注意,这里的同质性主要指“同一角色内的行为相似”,而不是所有任务都天然同质。RL 任务中的 actor、learner、reward model、replay buffer 角色不同;rank 0 可能承担额外的协调、下载或 checkpoint 逻辑;MoE 训练可能引入专家负载差异。对于这些任务,空间对比需要先识别角色或拓扑分组,否则容易把正常异构误判为异常。
2.3 周期性:稳定训练阶段存在可比较的迭代结构
训练任务按 iteration 重复执行。每个 iteration 的具体耗时会受到数据、系统负载、通信抖动和 checkpoint 等因素影响,但在稳定阶段,同一 rank 的日志序列、栈状态、profile 事件和指标变化通常具有周期性。
周期性使时间对比具有意义: 如果某个 rank 在某个 iteration 开始出现新的错误模板,或者某个阶段耗时突然偏离历史窗口,就可以把该 iteration 或时间窗口作为异常锚点。
时间锚点对诊断非常重要。一个合理的根因候选通常应早于它解释的现象。比如,RDMA error counter 突增如果发生在 NCCL timeout 之前,则可以支持通信层根因;如果发生在任务已经退出之后,它更可能只是下游结果或无关噪声。
2.4 拓扑结构:空间对比需要合理分组
rank、node、GPU、NIC、PCIe、NVLink、交换机以及并行通信组之间存在明确拓扑关系。异常影响范围如果能被拓扑解释,诊断结论会更稳固。
例如,单节点内所有 local rank 异常,可能指向主机、存储、GPU、PCIe 或本机 dataloader;多个节点异常且位于同一网络拓扑范围,可能指向交换机、链路或路由问题;某个 tensor parallel group 内 rank 同时异常,可能与该通信组的 collective 有关。
因此,诊断结果不宜只输出“某条日志可疑”,还应尽量输出异常的空间范围,例如 rank 范围、节点列表、设备标识和通信组标签。
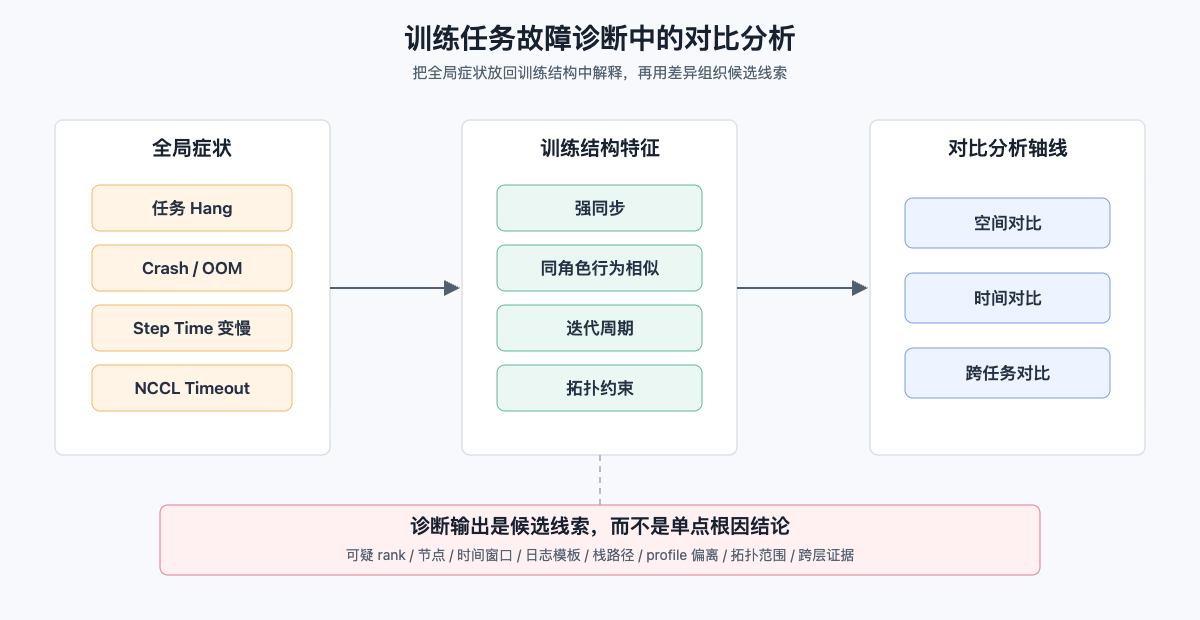
上图概括了训练任务的结构特征如何支撑后文的空间、时间和跨任务对比。
3. 训练诊断中的几类对比分析
基于强同步、同质性、周期性和拓扑结构,训练故障诊断中常见的对比分析大致可以分为三条轴线。
| 轴线 | 对比对象 | 结构前提 | 主要产出 |
|---|---|---|---|
| 空间对比 | 同一时间窗口内的不同 rank、node、device、通信组 | 同一角色内行为相似、拓扑约束 | 可疑 rank、节点、设备或拓扑范围 |
| 时间对比 | 同一 rank 或节点在不同时间窗口、不同 iteration 的状态 | 训练阶段稳定、迭代周期性 | 异常开始时间、异常 iteration、阶段突变 |
| 跨任务对比 | 失败任务与成功 baseline、历史正常窗口或反事实场景 | 配置相近、任务语义一致 | 可疑日志模板、异常阶段、性能差异或 straggler 影响 |
现有研究在三条轴线上的侧重有所不同。L4 将 LLM 训练日志中的结构性模式概括为 cross-job、spatial 和 temporal 三类,用于提取 failure-indicating information,包括 log events、nodes、stages 和 iterations [1]。EROICA 使用 online profiling 总结训练运行时行为,并通过 differential observability 定位性能问题根因 [2]。SysOM-AI 强调由 OS-level instrumentation 支撑的连续的跨层可观测性和 layered differential diagnosis,并在实现上结合 CPU stack profiling、GPU kernel tracing、NCCL event instrumentation 等手段 [3]。Minder 通过识别 distinctive metric patterns 检测故障机器 [4]。Straggler what-if analysis 通过构造无 straggler 的反事实场景并与实际轨迹对比,研究 straggler 的影响、时间/空间模式和潜在原因 [5]。C4 则利用集合通信(collective communication)的周期性同步和同质特征识别异常组件,同时利用集合通信的可预测通信模型进行流量规划和通信优化 [6]。
这些工作覆盖的数据源和目标不同,但都把差异作为重要诊断信号: 失败任务相对成功任务的差异、异常 rank 相对正常 rank 的差异、当前 iteration 相对历史 iteration 的差异、实际运行相对反事实运行的差异,或者某一层观测相对另一层观测的差异。
下面按照数据类型分别讨论:进程栈对比、日志对比和 profiling 对比。
4. 进程栈对比
进程栈可以直接反映进程在采样时刻所处的执行位置。与日志相比,栈更接近运行时状态;与完整 profiler trace 相比,栈采样更轻量,适合在线诊断。但单次栈快照的信息有限,只有放到时间和空间维度中比较,解释力才会增强。
可以把一次栈采样抽象为:
S = (timestamp, node, rank, process_type, pid, thread_id, stack_frames)
其中 timestamp 支持时间对比,node/rank/process_type 支持空间对比,stack_frames 描述执行状态。
4.1 时间对比:同一进程是否持续无进展
对同一进程进行多次栈采样,可以判断其执行位置是否长期不变。若一个训练进程在 T0、T3、T6 多个时间点的调用栈基本一致,同时对应 rank 的训练日志也没有推进,则可以作为 hang 或长时间等待的证据。
这种证据的强度取决于采样间隔和上下文。如果采样间隔过短,栈不变可能只是正常执行片段;如果该阶段本来就会长时间阻塞,例如 checkpoint 或数据下载,需要结合阶段信息判断;如果所有 rank 都同步停在同一 collective wait,仍需进一步查找未到达同步点或通信异常的上游原因。
因此,时间对比更准确的表述是:它帮助判断“进程在观察窗口内是否缺少进展”,但不单独给出根因。
4.2 空间对比:不同 rank 停在了哪里
在强同步训练中,多个 rank 同时停住并不罕见。更有价值的问题是:它们是否停在相同路径,还是存在少数 rank 处于不同状态。
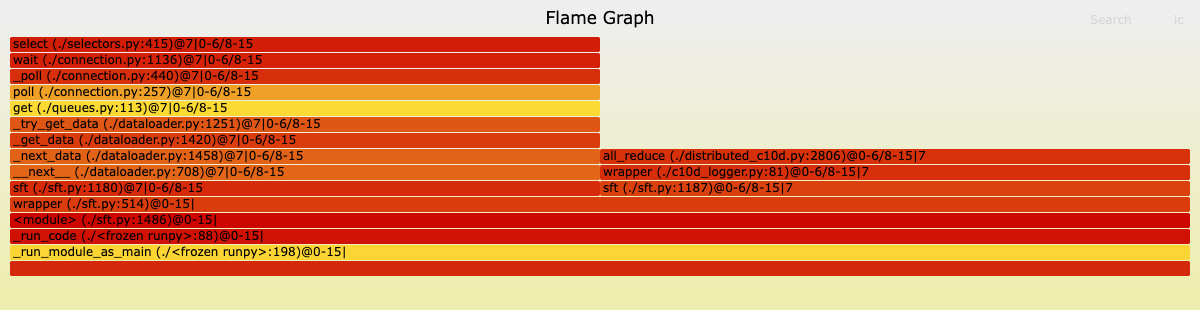
一种典型模式是,多数 rank 停在 NCCL collective wait,少数 rank 停在 dataloader、文件系统 I/O、用户 Python 逻辑或 CUDA runtime 调用。此时,多数 rank 的通信等待可能是下游表现;少数 rank 的非通信路径更值得作为上游候选。
栈的空间对比并不要求先知道根因,只需要把“哪些 rank 出现在某条调用路径上”表达清楚。这样可以把一个全局 hang 现象拆成更可解释的问题:哪些 rank 在等待,哪些 rank 没有走到同步点,trainer 和 dataloader 是否处于一致状态。
下图展示了一个跨 rank 合并栈火焰图示例,重点不是单个函数耗时,而是观察哪些调用路径覆盖多数 rank,哪些路径只出现在少数 rank 上。
5. 日志对比
日志是训练故障诊断中最常见的数据源。它覆盖范围广、采集成本低,并且保留了训练框架、用户代码、运行时库和平台系统的文本信息。但训练日志也具有噪声多、重复多、跨 rank 前缀不一致、warning 语义不稳定等特点。仅依赖关键词、日志级别或频率,往往难以稳定定位故障。
L4 基于 428 个生产 LLM 训练失败报告进行经验研究,并指出现有日志诊断方法难以直接处理 LLM 训练日志;随后将 LLM 训练日志中的结构性模式概括为 cross-job、spatial 和 temporal 三类,用于自动提取 failure-indicating information,包括 log events、nodes、stages 和 iterations [1]。
5.1 日志事件建模
为了做对比,日志需要先从文本流转换为带上下文的结构化事件。一个简化的日志事件可以表示为:
E = (timestamp, node, rank, template_id, template, phase, iteration_id)
其中 timestamp 支持时间对比,node/rank 支持空间对比,template_id/template 表示归一化后的日志模式,phase/iteration_id 将日志放回训练阶段和迭代上下文。
日志模板化通常是必要步骤。使用 Drain 等在线日志解析方法 [8],可以将具体数值、路径、rank 编号、耗时等变量归一化,避免同一类日志因为参数不同而被视为不同模式。
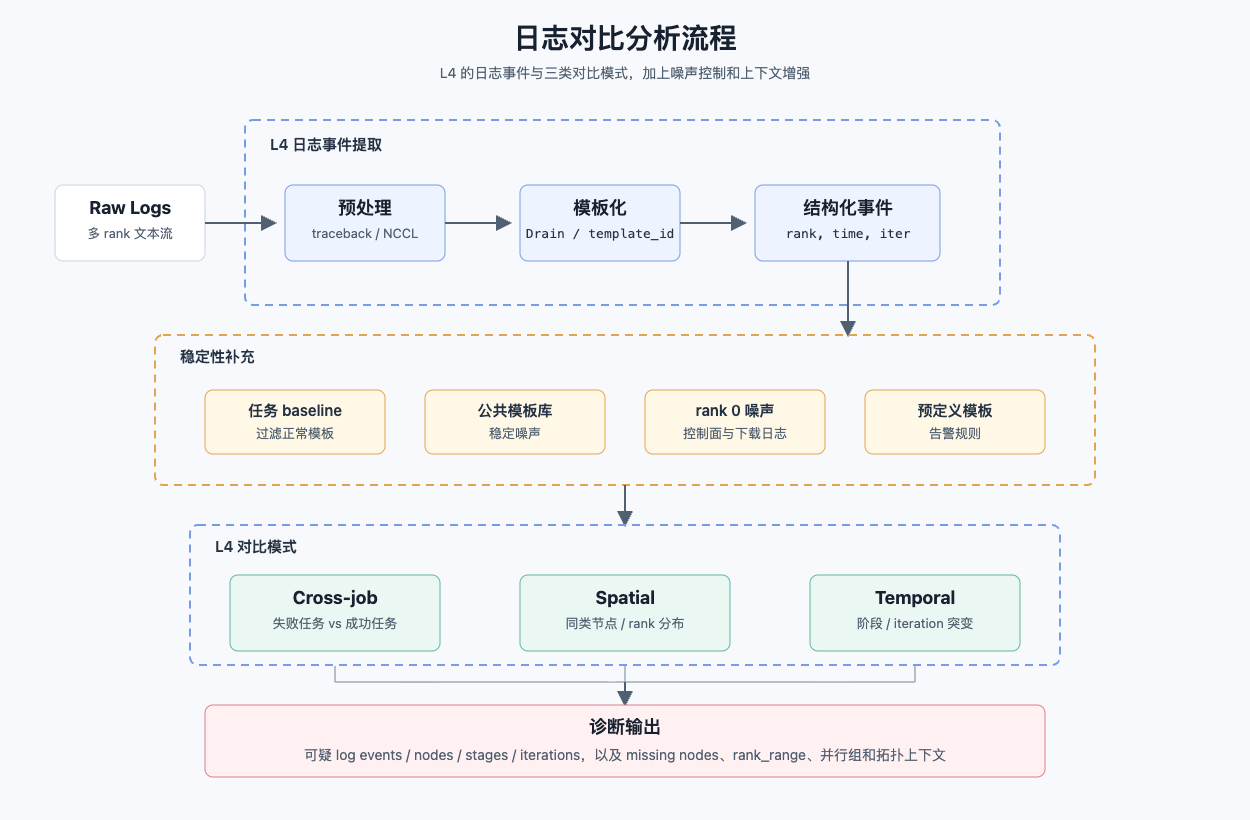
下图将日志从原始文本到模板化、噪声过滤、上下文增强和三类对比模式的处理流程串联起来。
5.2 跨任务对比:失败任务与成功 baseline
L4 的 cross-job pattern 利用不同任务之间的日志差异来帮助识别 failure-indicating log events [1]。在训练诊断场景中,一个自然做法是选择与目标任务配置相近的成功任务作为 baseline。
理想的 baseline 应满足: 模型结构一致,训练框架、代码版本和依赖版本一致,数据 pipeline、启动脚本和环境变量一致,超参数和并行配置尽量一致。如果规模不同,规模差异也应是可解释的主要差异。
在此基础上,失败任务中新增的日志模板、显著变化的模板频率或异常阶段,可以作为候选信号。这里需要强调:baseline 差异并不直接等于故障原因,它只是把分析范围从大量正常日志缩小到更值得检查的差异集合。
5.3 空间对比:同类节点之间的日志分布
L4 的 spatial pattern 关注训练日志在不同节点或设备之间的分布差异,用于定位 failure-indicating nodes [1]。这与训练任务的同质性直接相关:如果同一角色下的 rank 正常情况下应当行为相似,那么少数节点出现额外错误模板或显著不同的模板频率,就可以作为可疑信号。
空间对比可以回答“哪个节点表现异常”,但不一定回答“哪个日志模板最关键”。因此**日志诊断结果通常需要同时保留两个维度:可疑节点和可疑模板。**单节点 dataloader 卡死可能表现为某个节点的日志分布离群;全局 OOM 则可能让所有节点出现相同错误模板,仅做空间异常检测未必能发现异常节点,但可疑模板仍然有效。
5.4 时间对比:阶段和迭代中的突变
L4 的 temporal pattern 利用训练过程中的阶段和迭代信息,识别 failure-indicating stages 和 iterations [1]。这与训练任务的周期性直接相关:稳定训练阶段中,同一 rank 的日志序列、阶段持续时间和模板频率应当相对稳定。
时间对比的主要价值是提供异常开始点。 没有时间锚点,跨层归因很容易混淆原因和结果;有了时间锚点,才能进一步检查同一窗口之前是否存在 GPU、RDMA、平台告警或用户代码异常。
6. Profiling 对比
日志和栈更适合解释错误文本和运行时停顿位置,而性能问题通常还需要更细粒度的 profiling 数据。EROICA 面向大规模模型训练的在线性能排障,使用 fine-grained profiling 总结训练运行时行为,并通过 differential observability 定位性能问题根因 [2]。
从“对比分析”的角度看,EROICA 的价值在于把训练过程中的细粒度函数、Python 逻辑、GPU operation、硬件与软件交互等运行时行为变成可比较对象。它关注的问题不是“哪条错误日志最可疑”,而是 “当前运行时行为和正常行为相比,哪些部分发生了性能偏离” [2]。
这类 profiling 对比通常适合回答:
- step time 变慢主要来自 Python 函数、GPU operation,还是硬件互连。
- 某类操作在异常窗口中的耗时是否相对正常窗口明显增加。
- 异常是否集中在某些 rank、节点或设备上。
- 软硬件交互是否造成了训练吞吐下降。
EROICA 与日志对比、栈对比的侧重点不同。日志对比更适合从大量文本中提取错误线索,栈对比更适合判断 hang 时进程停在哪里,profiling 对比更适合定位 slowdown 和性能退化。三者覆盖了训练诊断中的不同观测层次。
SysOM-AI 进一步说明了跨层 profiling 的必要性:生产 AI 训练中的细微 OS-level 问题可能触发 GPU delay 和 network slowdown,单层 profiling 工具往往难以解释跨层传播。它主张以 OS-level instrumentation 支撑连续的跨层可观测性,并结合 layered differential diagnosis;在实现上,则集成 CPU stack profiling、GPU kernel tracing 和 NCCL event instrumentation 等手段定位性能问题 [3]。这说明 profiling 对比不仅可以在同一层内比较,也可以在 OS、GPU、NCCL 等层之间建立跨层关联和解释。
7. 工程实现与适用边界
前面几节更关注已有系统和分析视角。本节集中讨论把这些方法落到诊断系统中时需要处理的工程细节和适用边界。
7.1 栈的空间对比实现思路
跨 rank 的栈对比可以借鉴栈合并和火焰图中按调用层级合并的思路。FLAME 提供了一个接近的工程实现:收集多个 rank 的调用栈,将栈帧插入 Trie(前缀树,Prefix Tree),在每个栈帧节点记录覆盖的 rank 集合,并在生成的火焰图标签中标注出现和缺失的 rank 范围 [7]。
下图用一个简化例子说明 Trie 合并后的 rank 覆盖关系:诊断时关注的是少数 rank 独有的路径,或少数 rank 缺失的路径。
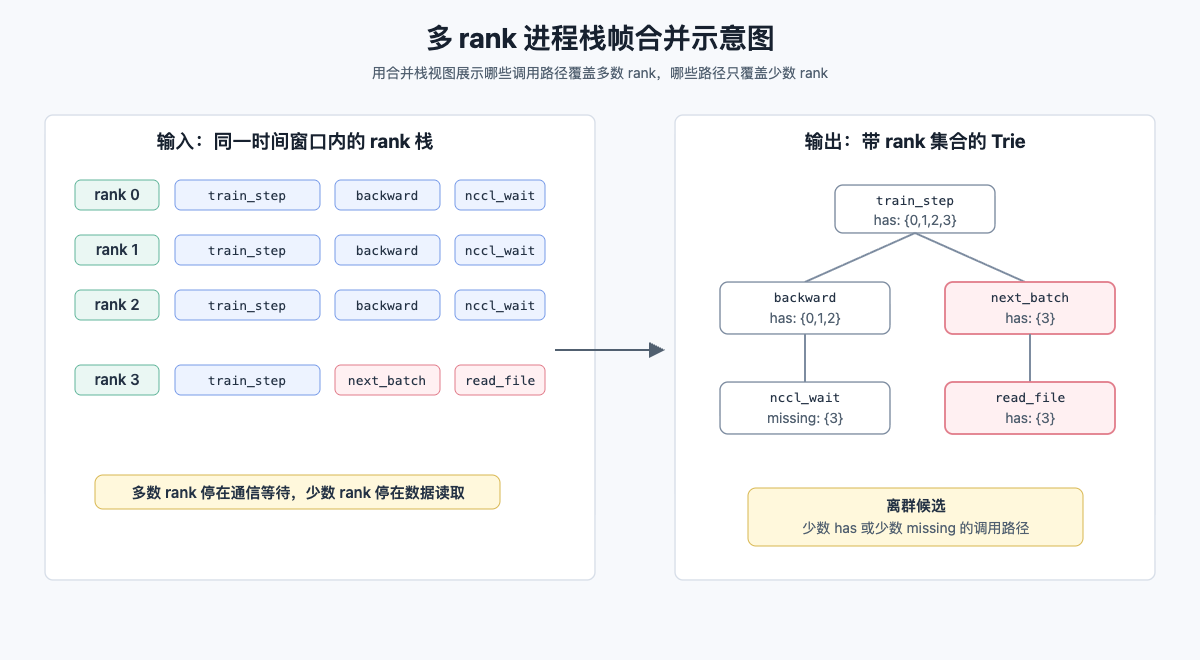
在系统实现中,可以先将栈帧规范化为稳定表示,例如 function(file:line),再按进程类型分别比较 trainer、dataloader worker 等进程。遍历合并后的 Trie 时,可以输出某条调用路径的 has_ranks 和 missing_ranks;如果一条路径只覆盖少数 rank,或只有少数 rank 缺失,就可以作为空间异常候选。这类表示的优点是可解释性强:结果不是一个黑盒分数,而是一组带 rank 覆盖范围的调用路径。局限在于,栈帧完全匹配容易受到行号、路径和运行时包装函数影响,规范化质量会直接影响结果。
栈的空间对比也需要限定比较范围。RL、异构 pipeline、launcher/worker 分离或带有特殊控制 rank 的任务中,不同进程本来就可能执行不同逻辑;rank 0 也可能承担 checkpoint、下载、日志汇总或协调逻辑。因此,工程上应优先按 process_type、训练角色、并行组或通信组分组,在角色内比较。若角色信息不可得,栈上的异常差异只能作为候选线索,而不能直接解释为故障 rank。
7.2 日志对比的实现补充
L4 把训练日志诊断抽象为日志事件提取,以及 cross-job、spatial 和 temporal 三类模式 [1]。对应到工程实现时,可以把它展开为模板化、与成功任务 baseline 对比、节点或设备之间的空间对比、阶段或 iteration 上的时间对比等步骤。这里补充一些让对比更稳定的机制。
第一是公共模板库和任务 baseline 的组合。 任务 baseline 用于过滤配置相近的成功任务中反复出现的正常模板;公共模板库则用于积累训练框架、平台组件、启动器、下载器和监控组件中跨任务稳定出现的正常模板。公共模板库可以缓解没有完全匹配 baseline 时的噪声问题。对于已知高风险模板,例如 OOM、timeout、NCCL error、GPU Xid、Exception、AssertionError 等,应单独维护告警规则。
第二是 rank 0 和控制面噪声过滤。 rank 0 或主节点经常承担协调、下载、checkpoint、HTTP 请求和元数据记录等工作,容易产生 curl/wget 进度条、HTTP/JSON 响应、checkpoint 元信息等只在 rank 0 出现的模板。若直接进行空间对比,这类模板会被误判为少数节点离群。工程上可以在模板化前过滤明显的 rank 0 噪声,也可以给 rank 0 设置特殊角色,只在同角色范围内比较。
第三是多行日志合并和预定义模板。 Python traceback、框架异常、NCCL 多行报错需要先按事件合并,再交给 Drain 等模板解析器 [8],否则模板可能只保留 Traceback 这样的头部信息,丢失异常类型和关键栈帧。对已知高噪声模式或重要模式,可以使用预定义模板固定 template_id,避免同一类事件因为路径、rank 编号或数值变化被拆成多个模板。
第四是全局错误、缺失节点和拓扑上下文。 全局配置错误、依赖错误或全局 OOM 可能不会产生空间上的离群节点,因此可疑模板应作为独立输出维度。反过来,如果某个告警模板覆盖大多数节点,少数没有出现该模板的节点也不一定正常,可能是更早退出,尚未执行到打印错误的位置。补充 rank_range、并行组标签和节点拓扑,可以帮助判断异常是否集中在某个并行维度、物理节点范围或通信组内。
7.3 适用边界
对比分析依赖“可比较性”这一前提。失败任务与成功 baseline 的配置差异越大,跨任务差分越容易混入版本、规模、数据或启动方式差异;不同 rank 的角色差异越大,空间对比越容易把角色差异误认为异常;训练阶段越不稳定,时间对比越难区分正常波动和异常突变。
时间对齐也需要按窗口解释。多节点日志可能存在时钟偏差,不同数据源的时间戳粒度也不一致。训练日志、平台告警、GPU 指标和 RDMA counter 未必能精确到同一个瞬间。因此,跨层对齐应优先使用时间窗口、iteration 或阶段边界,而不是单点时间。
最后,可疑信号不等于根因。少数 rank 的栈路径不同、某个节点日志更多、某个 profile event 耗时变长,可能是故障上游,也可能是下游等待、采样差异或正常角色差异。对比分析擅长缩小排查范围,但它输出的是候选异常和解释线索;如果缺少标注数据集和系统化评价,就不宜把这些候选线索表述成已经完成验证的根因定位结论。
7.4 对诊断系统的数据要求
从工程角度看,对比分析要求采集系统和诊断系统保留足够上下文。日志、栈、profiling 数据和指标如果缺少 rank、node、device、timestamp、iteration、process type 等字段,就很难参与时空对比。
一个较合理的数据组织方式是:
- 训练日志:按 rank 或 worker 保留,解析出 timestamp、template、phase、iteration。
- 进程栈:按 timestamp、node、rank、process type 保留多次采样。
- Profiling 数据:保留 Python 函数、GPU operation、collective event、duration 和 rank/device 映射。
- 通信数据:保留 NCCL 日志、通信拓扑、trace 中的 collective 事件。
- 硬件指标:保留 GPU、RDMA、IB 端口和平台告警,并与 node/device 关联。
- 拓扑信息:保留 rank 到 node、GPU、NIC、通信组的映射。
在此基础上,诊断模块可以分别输出日志可疑模板、栈异常路径、profiling 差异、通信异常和物理层告警。这些模块不必各自完成完整根因定位,但它们的输出应能对齐到共同的时间窗口和空间范围中。
DeepLink 内部基于 DeepTrace 将上述思路落到分布式训练诊断系统中,通过日志、进程栈、NCCL、GPU 和 RDMA数据的采集与时空分析定位异常范围、组织跨层证据,并结合 Probing 对可疑 rank、step 和时间窗口开展细粒度 profiling 采集与运行时下钻,形成任务级诊断与性能分析相互补充的链路。
- DeepTrace GitHub:https://github.com/DeepLink-org/DeepTrace
- Probing GitHub:https://github.com/DeepLink-org/probing
8. 小结
大模型训练故障诊断需要同时处理全局症状和局部原因之间的错位。强同步让局部异常扩散为全局等待,同质性和周期性又为诊断提供了可利用的结构信号。
本文讨论的时空对比是一种诊断视角:通过空间对比寻找离群 rank 或节点,通过时间对比定位异常开始窗口,通过跨任务对比过滤正常日志背景,再结合 profiling、拓扑约束和跨层观测数据组织诊断线索,可以帮助把多源观测数据组织成更可解释的形式。
对训练故障诊断系统而言,重要的不只是采集更多数据,还包括让数据具备可比较性:每条日志、每次栈采样、每个 profile event、每个指标点都应尽量带有时间、空间和训练上下文。只有这样,诊断系统才能从“发现异常文本或异常数值”进一步走向“解释异常在训练结构中的位置”。
如果你喜欢我们的内容,欢迎点赞👍、收藏 ⭐️、关注 ➕我们!
也欢迎在评论区与我们互动!
你的支持是我们持续创作的动力!
参考文献
[1] Z. Jiang, J. Huang, Z. Chen, Y. Li, G. Yu, C. Feng, Y. Yang, Z. Yang, and M. R. Lyu, “L4: Diagnosing Large-scale LLM Training Failures via Automated Log Analysis,” arXiv:2503.20263, 2025. https://arxiv.org/abs/2503.20263
[2] Y. Guan, Z. Yin, H. Chen, S. Cheng, C. Yang, K. Qian, T. Xu, P. Zhang, Y. Zhang, H. Zhao, Y. Li, W. Lin, D. Cai, and E. Zhai, “EROICA: Online Performance Troubleshooting for Large-scale Model Training,” arXiv:2506.08528, 2025. https://arxiv.org/abs/2506.08528
[3] Y. Zheng, W. Mao, S. Cheng, F. Feng, G. Li, Z. Liao, Y. Huang, Z. Xiao, Y. Li, A. Quinn, and T. Ma, “SysOM-AI: Continuous Cross-Layer Performance Diagnosis for Production AI Training,” arXiv:2603.29235, 2026. https://arxiv.org/abs/2603.29235
[4] Y. Deng, X. Shi, Z. Jiang, X. Zhang, L. Zhang, Z. Zhang, B. Li, Z. Song, H. Zhu, G. Liu, F. Li, S. Wang, H. Lin, J. Ye, and M. Yu, “Minder: Faulty Machine Detection for Large-scale Distributed Model Training,” arXiv:2411.01791, 2024. https://arxiv.org/abs/2411.01791
[5] J. Lin, Z. Jiang, Z. Song, S. Zhao, M. Yu, Z. Wang, C. Wang, Z. Shi, X. Shi, W. Jia, Z. Liu, S. Wang, H. Lin, X. Liu, A. Panda, and J. Li, “Understanding Stragglers in Large Model Training Using What-if Analysis,” arXiv:2505.05713, 2025. https://arxiv.org/abs/2505.05713
[6] J. Dong, B. Luo, J. Zhang, P. Zhang, F. Feng, Y. Zhu, A. Liu, Z. Chen, Y. Shi, H. Jiao, G. Lu, Y. Guan, E. Zhai, W. Xiao, H. Zhao, M. Yuan, S. Yang, X. Li, J. Wang, R. Men, J. Zhang, C. Zhou, D. Cai, Y. Xie, and B. Fu, “Enhancing Large-Scale AI Training Efficiency: The C4 Solution for Real-Time Anomaly Detection and Communication Optimization,” arXiv:2406.04594, 2024. https://arxiv.org/abs/2406.04594
[7] moranhhuishou1995, “FLAME: Stack merging and customized flame graph generation for multiple ranks,” GitHub repository. https://github.com/moranhhuishou1995/flame
[8] P. He, J. Zhu, P. Xu, Z. Zheng, and M. R. Lyu, “A Directed Acyclic Graph Approach to Online Log Parsing,” arXiv:1806.04356, 2018. https://arxiv.org/abs/1806.04356
更多推荐


 2
 0
- 0


 已为社区贡献2条内容

所有评论(0)