
机器学习模型特征可解释性分析:SHAP 原理、计算过程与可视化详解
在机器学习项目里,我们经常先关心:模型准不准?
不同的任务有不同的指标可以评估模型的性能,分类任务关注 Accuracy、AUC、F1,回归任务关注 MAE、RMSE、R2R^2R2。但模型性能达到要求后,我们更想要知道黑箱的模型背后的可解释性原理:
模型为什么给出这个预测?它主要依赖了哪些特征?这些特征把结果往哪个方向推了多少?
此时可以用到 SHAP(SHapley Additive exPlanations)分析。
SHAP 不是训练模型的新算法,而是一套解释模型输出的特征归因方法。它把一次预测与“基准预测”的差异,按照一套来自合作博弈论的规则分配给各个输入特征。SHAP 官方文档将它概括为:用博弈论方法解释任意机器学习模型的输出。[1]
下面这张图来自权威的 SHAP 分析实现 python 包 “SHAP” 的官方教程,是典型的单个样本预测的 waterfall plot(瀑布图):从模型的基准输出出发,不同特征分别把预测往上推或往下拉,最后走到当前样本的预测值。或者说,每个样本的每个特征都会有一个 SHAP 值,这些 SHAP 值共同造就了模型预测的结果。
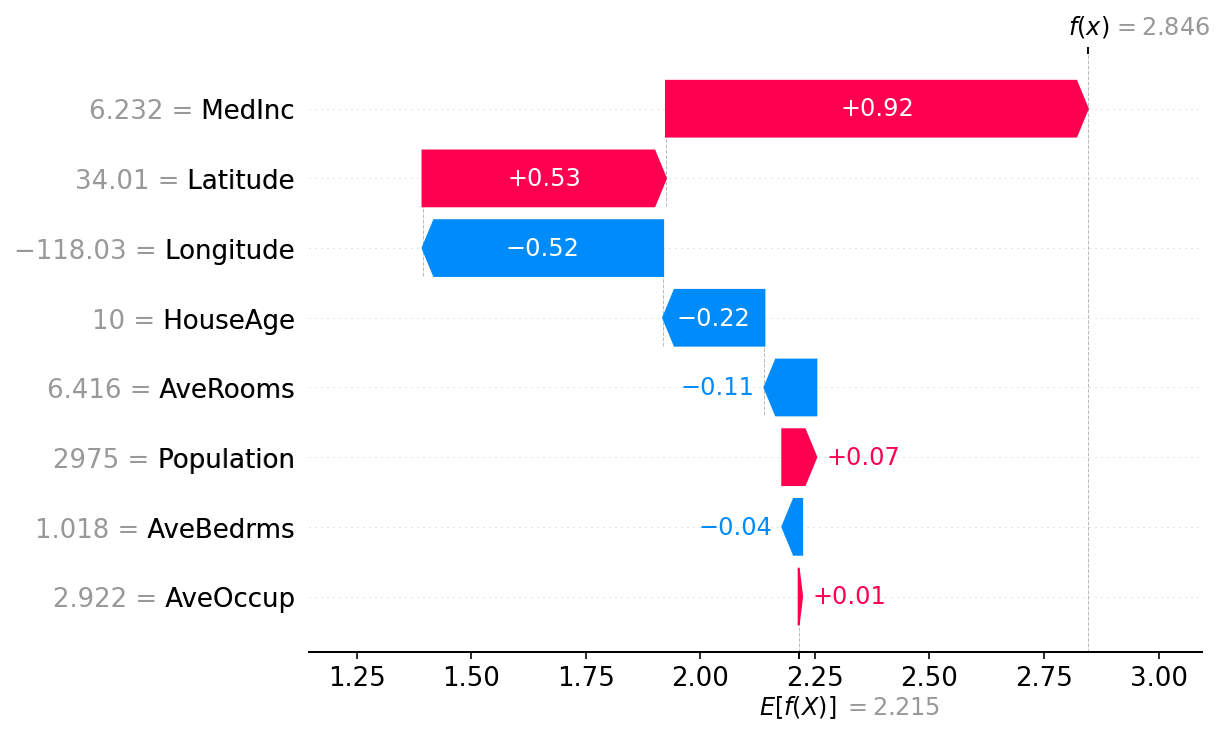
图源:SHAP python包官方文档,原图与教程见参考资料 [2]。
一、SHAP 分析基本概念与分析对象
SHAP 的全名是 SHapley Additive exPlanations,中文常译为沙普利加性解释。它是一种基于博弈论 Shapley(夏普利) 值的模型可解释性方法,由 Scott Lundberg 和 Su-In Lee 于 2017 年提出。其核心思想是将每个特征视为博弈中的“玩家”,模型预测结果视为“总收益”,计算每个特征对单个预测的边际贡献。[3]
一般的 Feature Importance(特征重要性)分析注重:
模型整体更重视哪些特征?
而 SHAP 还能进一步回答:
某个特征对某一个样本的预测贡献是多少?是推高了预测,还是压低了预测?
因此,严格来说,SHAP 从理论上更接近“特征归因(feature attribution)”。这里的“归因”可以先简单理解为:把当前预测结果拆开,看看每个特征分到了多少贡献。
我们用一个简单的例子来说明。
假设有一个贷款违约风险概率模型,输入四个特征:
| 特征 | 当前客户取值 | 直观理解 |
|---|---|---|
| 年龄 | 42 岁 | ?可能影响违约概率 |
| 年收入 | 30 万元 | ↓ 收入较高可能降低违约概率 |
| 负债率 | 75% | ↑ 负债压力较高,可能提高违约概率 |
| 历史逾期次数 | 4 次 | ↑ 可能显著提高违约概率 |
假设模型在背景人群上的违约概率的基准预测约为 10%,而对这个客户的最终预测是 35%。
“基准预测(baseline/base value)”可以先理解成:在不知道当前客户具体特征之前,模型的一个平均起点。它通常与背景数据上的模型期望输出有关,具体定义取决于 explainer 和 masker/background 的设置。[2]
SHAP 希望把从 10% 到 35% 的变化拆开,例如在一个教学化的概率尺度示意中:
| 特征 | 对当前样本预测的贡献(示意) |
|---|---|
| 年收入 | -4 个百分点 |
| 负债率 | +9 个百分点 |
| 年龄 | -2 个百分点 |
| 历史逾期次数 | +22 个百分点 |
| 合计 | +25 个百分点 |
于是:
10%−4%+9%−2%+22%=35% 10\% - 4\% + 9\% - 2\% + 22\% = 35\% 10%−4%+9%−2%+22%=35%
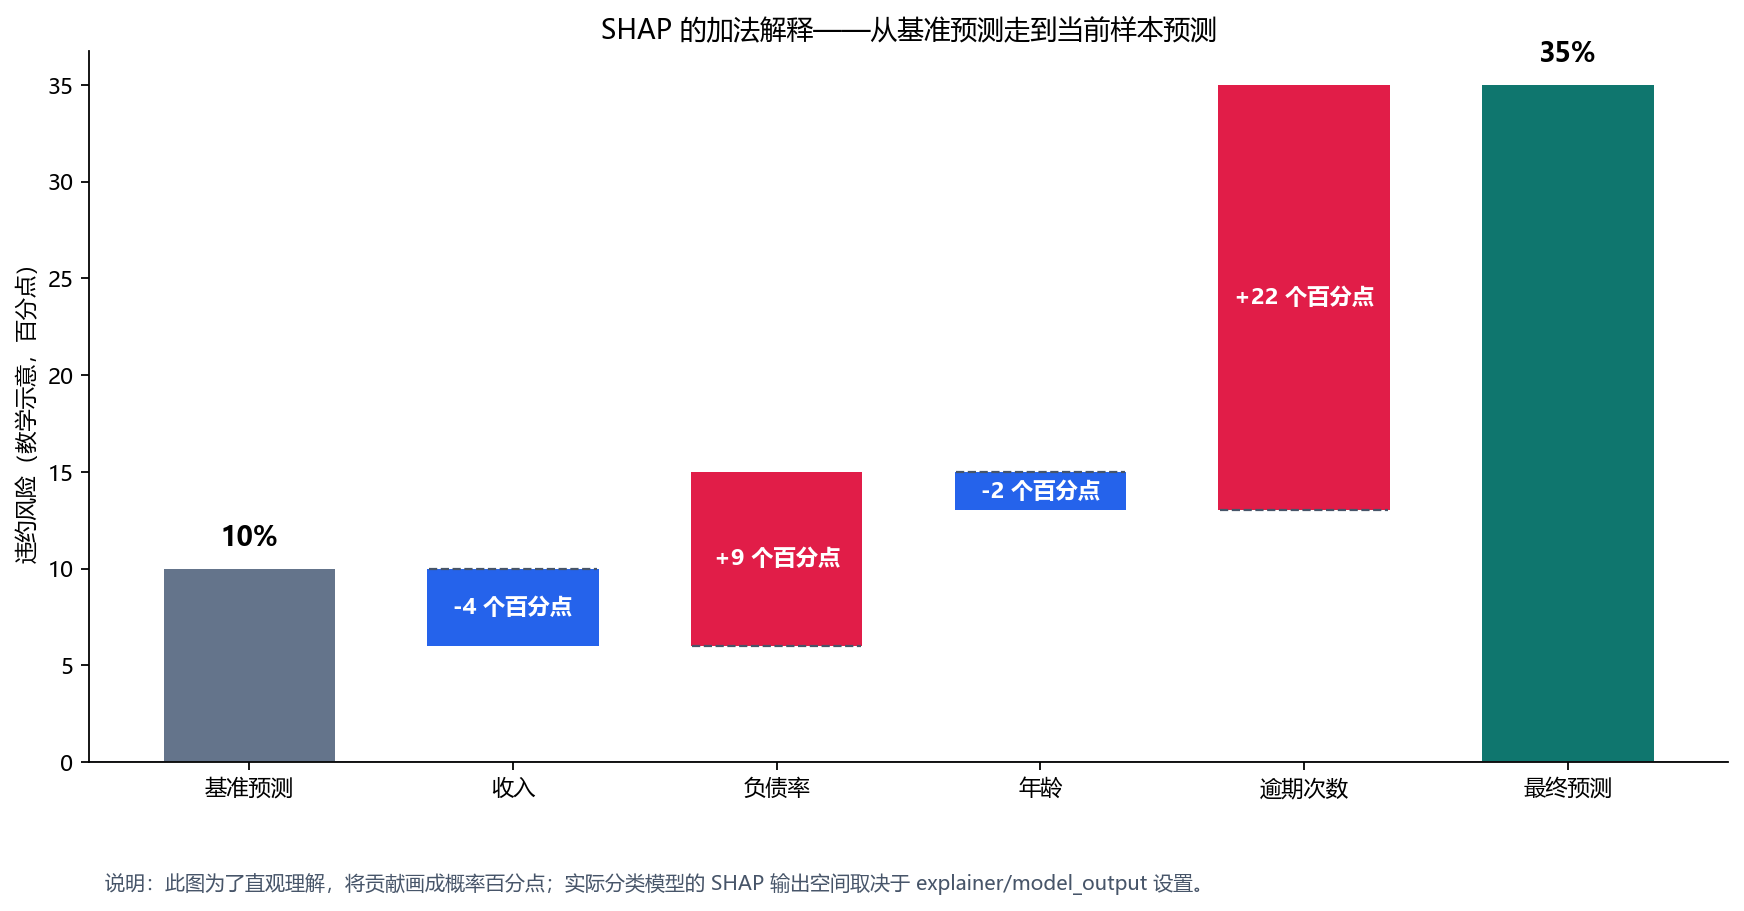
说明:为了方便解释,上图把贡献画成“概率百分点”。真实二分类模型中,SHAP 值可能解释的是 raw score、log-odds,也可以在特定 explainer 配置下解释概率。SHAP 官方教程也特别展示了逻辑回归在概率空间与 log-odds 空间的差异。[2]
二、SHAP 与 “博弈论”
前面已经提到了,SHAP 的核心思想来自合作博弈论中的 Shapley value(夏普利值)。“合作博弈”可以简单理解成:多个参与者一起完成一件事,最后要公平分配总收益。
把它映射到机器学习里:
| 博弈论中的概念 | 机器学习中的对应物 |
|---|---|
| 玩家(player) | 特征 |
| 玩家联盟(coalition) | 一组已经“加入”的特征 |
| 游戏收益(value/payoff) | 模型输出 |
| 某玩家的贡献 | 某特征对预测的边际贡献 |
SHAP 分析关注一个特征的作用可能依赖其他特征。
比如“收入”在不同客户条件下的意义可能不一样:只有收入信息时,它对模型的影响是一种情况;如果已经知道客户负债率很高,再加入收入信息,模型变化可能又是另一种情况。
SHAP 的处理方式是:
让一个特征在不同特征组合中反复“加入”,计算它每次加入后让模型输出改变多少,再按照 Shapley 规则做加权汇总。
三、SHAP 的核心数学关系:预测值可以被加法拆开
SHAP 属于加性特征归因方法。对一个样本 xxx,最常见的表达是:
f(x)=ϕ0+∑i=1Mϕi f(x)=\phi_0+\sum_{i=1}^{M}\phi_i f(x)=ϕ0+i=1∑Mϕi
其中:
- f(x)f(x)f(x):模型对当前样本的输出;
- ϕ0\phi_0ϕ0:基准值(base value);
- MMM:特征数量;
- ϕi\phi_iϕi:第 iii 个特征的 SHAP 值。
换句话说:
当前预测 = 基准预测 + 每个特征的贡献之和。
这条“加法闭合”是理解 SHAP 图表的钥匙。官方教程也用 waterfall plot 直观展示:所有输入特征的 SHAP 值之和,会连接基准模型输出与当前预测输出。[2]
这里要区分两个概念:
- 特征值:例如“负债率 = 75%”;
- SHAP 值:例如“负债率让当前模型输出增加了 +0.09(具体单位取决于输出空间)”。
特征值是输入,SHAP 值是模型对这个输入在当前上下文中的“贡献解释”。二者不是一回事。
四、SHAP 值计算方法
前面提到的贷款违约概率预测模型里有 4 个特征,为了方便计算,先把它缩小成一个只有 3 个特征的版本:
- AAA:年龄
- BBB:年收入
- CCC:负债率
现在只问一个问题:
年收入 BBB 对当前客户的预测到底贡献了多少?
4.1 先理解“边际贡献”
“边际贡献”就是:加入这个特征之前和加入之后,模型输出差了多少。
如果其他特征一个都不知道,加入收入:
v({B})−v(∅) v(\{B\})-v(\emptyset) v({B})−v(∅)
如果已经知道年龄,再加入收入:
v({A,B})−v({A}) v(\{A,B\})-v(\{A\}) v({A,B})−v({A})
如果已经知道负债率,再加入收入:
v({B,C})−v({C}) v(\{B,C\})-v(\{C\}) v({B,C})−v({C})
如果年龄和负债率都已经知道,再加入收入:
v({A,B,C})−v({A,C}) v(\{A,B,C\})-v(\{A,C\}) v({A,B,C})−v({A,C})
这里的 v(S)v(S)v(S) 可以理解成:只让特征集合 SSS 参与时,对模型输出定义出的期望价值函数。注意,没有参与的特征并不是被当成“0”进入模型来进行预测的,在4.4节会专门说明集合S的模型预测数学期望 v(S)v(S)v(S) 的理解和计算。
4.2 为什么同一个特征会有多个贡献?
表中的预测概率只用于演示计算,边际贡献等于“加入后的预测概率”减去“加入前的预测概率”。
| 待加入的特征 | 原有的特征组合 | 加入前的预测概率 | 加入后的预测概率 | 待加入特征的边际贡献 |
|---|---|---|---|---|
| 年收入 BBB | 空集合 ∅\emptyset∅ | 10% | 8% | -2 个百分点 |
| 年收入 BBB | 年龄 {A}\{A\}{A} | 12% | 6% | -6 个百分点 |
| 年收入 BBB | 负债率 {C}\{C\}{C} | 19% | 17% | -2 个百分点 |
| 年收入 BBB | 年龄、负债率 {A,C}\{A,C\}{A,C} | 17% | 11% | -6 个百分点 |
现在思路就比较清晰了,在计算某个特征对整体预测值的影响时,我们将他对所有可能特征组合的边际贡献做平均,是否就达成公平了?
这里对边际贡献的平均并不是简单的算术平均,而是加权平均。因此接下来需要确定每种情况应该占多大权重。Shapley 权重不是人为指定的,而是由特征所有可能的加入顺序决定。这里有 AAA、BBB、CCC 三个特征,共有 3!=63!=63!=6 种加入顺序。观察每种顺序中,年收入 BBB 加入之前已经有哪些特征:
| BBB 加入前已有的特征 | 对应的特征加入顺序 | 出现次数 | Shapley 权重 |
|---|---|---|---|
| 空集合 ∅\emptyset∅ | B→A→CB\to A\to CB→A→C、B→C→AB\to C\to AB→C→A | 2 | 2/6=1/32/6=1/32/6=1/3 |
| 年龄 {A}\{A\}{A} | A→B→CA\to B\to CA→B→C | 1 | 1/61/61/6 |
| 负债率 {C}\{C\}{C} | C→B→AC\to B\to AC→B→A | 1 | 1/61/61/6 |
| 年龄、负债率 {A,C}\{A,C\}{A,C} | A→C→BA\to C\to BA→C→B、C→A→BC\to A\to BC→A→B | 2 | 2/6=1/32/6=1/32/6=1/3 |
每种加入顺序被同等对待,所以某个组合的权重,就是它在全部 6 种顺序中出现的比例。因此,上述四种情况的 Shapley 权重依次是 1/31/31/3、1/61/61/6、1/61/61/6、1/31/31/3,四个权重之和为 1。
将四次边际贡献按照这些权重求和,就得到年收入对于讨论的具体样本预测的 SHAP 值:
(−2)×13+(−6)×16+(−2)×16+(−6)×13=−4 (-2)\times\frac{1}{3}+(-6)\times\frac{1}{6}+(-2)\times\frac{1}{6}+(-6)\times\frac{1}{3}=-4 (−2)×31+(−6)×61+(−2)×61+(−6)×31=−4
SHAP 不会只选某一个上下文来定义特征贡献,而是综合这个特征在各种可能特征组合中的边际贡献。
4.3 Shapley value 的正式公式
特征 iii 的 Shapley value 可以写成:
ϕi=∑S⊆N∖{i}∣S∣!(M−∣S∣−1)!M![v(S∪{i})−v(S)] \phi_i= \sum_{S\subseteq N\setminus\{i\}} \frac{|S|!(M-|S|-1)!}{M!} \left[v(S\cup\{i\})-v(S)\right] ϕi=S⊆N∖{i}∑M!∣S∣!(M−∣S∣−1)![v(S∪{i})−v(S)]
符号看起来比较多,主要包含三个简单步骤:
- 枚举不包含特征 iii 的各种特征集合 SSS;
- 计算“加入 iii 前后”的边际贡献;
- 根据特征集合大小给不同情况分配 Shapley 权重,再求和。
其中,Shapley 权重就是公式中的:
∣S∣!(M−∣S∣−1)!M! \frac{|S|!(M-|S|-1)!}{M!} M!∣S∣!(M−∣S∣−1)!
这个权重可以通过两步计数来理解:
- MMM 个特征共有 M!M!M! 种加入顺序,Shapley value 将每种顺序同等对待。
- 固定一个特征集合 SSS,要求目标特征 iii 加入前恰好已经出现 SSS。集合 SSS 中的特征在 iii 前面有 ∣S∣!|S|!∣S∣! 种排法,其余 M−∣S∣−1M-|S|-1M−∣S∣−1 个特征在 iii 后面有 (M−∣S∣−1)!(M-|S|-1)!(M−∣S∣−1)! 种排法,因此符合条件的顺序共有 ∣S∣!(M−∣S∣−1)!|S|!(M-|S|-1)!∣S∣!(M−∣S∣−1)! 种。
用符合条件的顺序数除以全部顺序数,就得到该特征组合的 Shapley 权重。
仍以前面的三个特征为例,目标特征是年收入 BBB,所以 M=3M=3M=3。将不同的特征集合 SSS 代入权重公式,可以得到:
-
当 S=∅S=\emptysetS=∅ 时,∣S∣=0|S|=0∣S∣=0:
0!×(3−0−1)!3!=0!×2!3!=26=13 \frac{0!\times(3-0-1)!}{3!} =\frac{0!\times2!}{3!} =\frac{2}{6} =\frac{1}{3} 3!0!×(3−0−1)!=3!0!×2!=62=31
-
当 S={A}S=\{A\}S={A} 或 S={C}S=\{C\}S={C} 时,∣S∣=1|S|=1∣S∣=1。这两个集合各自的权重都是:
1!×(3−1−1)!3!=1!×1!3!=16 \frac{1!\times(3-1-1)!}{3!} =\frac{1!\times1!}{3!} =\frac{1}{6} 3!1!×(3−1−1)!=3!1!×1!=61
-
当 S={A,C}S=\{A,C\}S={A,C} 时,∣S∣=2|S|=2∣S∣=2:
2!×(3−2−1)!3!=2!×0!3!=26=13 \frac{2!\times(3-2-1)!}{3!} =\frac{2!\times0!}{3!} =\frac{2}{6} =\frac{1}{3} 3!2!×(3−2−1)!=3!2!×0!=62=31
0!=10!=10!=1。因此,四个特征组合对应的权重依次为 1/31/31/3、1/61/61/6、1/61/61/6、1/31/31/3,与前面按照 6 种加入顺序统计出的结果一致。
4.4 基于已训练好的模型进行 SHAP 分析
如果我有一个已经训练好的机器学习模型,SHAP 分析的计算过程是什么?
简单理解,就是拿一个已经训练好的模型 + 一批参考数据,反复比较“有这个特征”和“没有这个特征”时模型预测的变化,从而计算每个特征对某条预测贡献了多少。
核心就是计算:
模型加入特征 i 之后的预测−模型加入特征 i 之前的预测 \text{模型加入特征 } i \text{ 之后的预测} - \text{模型加入特征 } i \text{ 之前的预测} 模型加入特征 i 之后的预测−模型加入特征 i 之前的预测
比如分析“收入”这个特征。
假设当前特征联盟中已经加入年龄,取值为:
年龄 = 35
固定当前样本的年龄为 35,并让其他特征按照背景数据分布取值,可以得到:
vx({年龄})=0.40 v_x(\{\text{年龄}\}) = 0.40 vx({年龄})=0.40
抽象地说,价值函数 vx(S)v_x(S)vx(S) 表示:对于待解释样本 xxx,只保留特征集合 SSS 在该样本中的取值 xSx_SxS 时,按照选定的“缺失特征”处理规则得到的模型输出期望。
vx({年龄})=0.40v_x(\{\text{年龄}\}) = 0.40vx({年龄})=0.40 到底怎么平均得到?
假设待解释的人:
年龄 = 35
收入 = 20万
负债率 = 0.3
现在我们只想知道:
如果把这个人的年龄固定为 35,而收入、负债率仍按照背景数据分布取值,那么模型的平均预测是多少?
假设 Background Data 有 4 个人:
| 背景样本 | 年龄 | 收入 | 负债率 |
|---|---|---|---|
| A | 20 | 8万 | 0.1 |
| B | 45 | 15万 | 0.4 |
| C | 30 | 30万 | 0.2 |
| D | 60 | 10万 | 0.5 |
因为当前计算把年龄固定为 35,所以将背景样本(通常可以从模型训练数据中抽取)中的年龄全部替换为 35:
| 构造出的样本 | 年龄 | 收入 | 负债率 | 模型预测 |
|---|---|---|---|---|
| A’ | 35 | 8万 | 0.1 | 0.20 |
| B’ | 35 | 15万 | 0.4 | 0.50 |
| C’ | 35 | 30万 | 0.2 | 0.30 |
| D’ | 35 | 10万 | 0.5 | 0.60 |
分别丢进训练好的模型:
f(35,8万,0.1)=0.20 f(35, 8\text{万}, 0.1) = 0.20 f(35,8万,0.1)=0.20
f(35,15万,0.4)=0.50 f(35, 15\text{万}, 0.4) = 0.50 f(35,15万,0.4)=0.50
f(35,30万,0.2)=0.30 f(35, 30\text{万}, 0.2) = 0.30 f(35,30万,0.2)=0.30
f(35,10万,0.5)=0.60 f(35, 10\text{万}, 0.5) = 0.60 f(35,10万,0.5)=0.60
然后平均的是模型预测值:
vx({年龄})=0.20+0.50+0.30+0.604=0.40 v_x(\{\text{年龄}\}) = \frac{0.20 + 0.50 + 0.30 + 0.60}{4} = 0.40 vx({年龄})=40.20+0.50+0.30+0.60=0.40
上述计算固定当前样本在特征集合 SSS 上的取值 xSx_SxS,再让其余特征 XSˉX_{\bar S}XSˉ 按照背景数据中的边际分布取值。对应的价值函数可以写成:
vxint(S)=EXSˉ∼P(XSˉ)[f(xS,XSˉ)] v_x^{\mathrm{int}}(S) =E_{X_{\bar S}\sim P(X_{\bar S})} \left[f(x_S,X_{\bar S})\right] vxint(S)=EXSˉ∼P(XSˉ)[f(xS,XSˉ)]
这种定义通常称为 interventional SHAP 或 marginal SHAP。这里的 interventional 表示在计算中切断 XSX_SXS 与 XSˉX_{\bar S}XSˉ 的统计依赖,不能直接解释为现实世界中的因果干预效应。[7][8]
SHAP 的联盟价值函数并不只有这一种定义。与 interventional SHAP 不同,observational SHAP(也称 conditional SHAP)将联盟价值定义为条件期望:[7][8]
vxobs(S)=E[f(X)∣XS=xS] v_x^{\mathrm{obs}}(S)=E[f(X)\mid X_S=x_S] vxobs(S)=E[f(X)∣XS=xS]
计算时,需要从背景数据中估计“在已知特征 XS=xSX_S=x_SXS=xS 的条件下,其余特征 XSˉX_{\bar S}XSˉ 的分布”,再将这些条件样本输入模型并平均预测值。对于离散特征,可以直接筛选条件相符的样本;对于连续或多维特征,通常需要使用近邻、核加权或条件分布模型近似。该方法能够保留特征之间的统计相关性,但条件分布在高维空间中较难可靠估计,因此结果会受到样本量和估计方法的影响。[9]
树模型则有自己的便捷算法,后续会介绍到。
许多 SHAP 方法可以简单理解为:按照选定的价值函数隐藏部分特征,计算相应的期望模型输出,再比较特征加入前后的变化。具体如何表示“隐藏”,取决于 explainer、背景数据和特征依赖假设。
最终得到什么?
首先计算一个基准值:
ϕ0=E[f(X)] \phi_0 = E[f(X)] ϕ0=E[f(X)]
也就是模型在背景数据上的平均预测值。
假设:
ϕ0=0.30 \phi_0 = 0.30 ϕ0=0.30
然后得到:
年龄       +0.05
收入       +0.18
负债率     +0.19
则:
0.30+0.05+0.18+0.19=0.72 0.30 + 0.05 + 0.18 + 0.19 = 0.72 0.30+0.05+0.18+0.19=0.72
也就是:
模型预测 = 基准预测 + 所有特征的 SHAP 贡献
即:
f(x)=E[f(X)]+∑iϕi f(x) = E[f(X)] + \sum_i \phi_i f(x)=E[f(X)]+i∑ϕi
所以 SHAP 值本质上的单位是“模型输出的变化量”。
例如:
收入 SHAP = +0.18
意思不是“收入重要性为 18%”,而是:
对于这个样本,相对于模型基准预测,收入这个特征把模型预测往上推了 0.18。
五、真实模型:往往不直接穷举所有特征组合
如果有 MMM 个特征,所有可能特征子集的数量会按 2M2^M2M 增长。
因为构造一个特征子集时,每个特征都有两种独立选择:
加入子集;
不加入子集。
如果有 MMM 个特征,根据乘法原理,选择方式总数为:
2×2×⋯×2⏟M 个特征=2M
\underbrace{2\times2\times\cdots\times2}_{M\text{ 个特征}}
=2^M
M 个特征2×2×⋯×2=2M
| 特征数 | 子集数量 |
|---|---|
| 5 | 32 |
| 10 | 1,024 |
| 20 | 1,048,576 |
| 30 | 约 10.7 亿 |
| 50 | 约 1.13×10151.13\times10^{15}1.13×10¹⁵ |
因此,一般情况下精确计算 Shapley value 很昂贵。原始 SHAP 工作提出了统一的加性归因框架,并给出多种估计方法;后续 TreeSHAP 又针对树模型给出了高效算法,使树模型上的 SHAP 解释具有很强的实用性。[3][4]
目前 SHAP 官方 API 中常见的 explainer 包括:[5]
| Explainer | 常见对象 | 简要理解 |
|---|---|---|
TreeExplainer | XGBoost、LightGBM、CatBoost、随机森林等树模型 | 利用树结构高效计算 |
LinearExplainer | 线性模型 | 利用线性结构计算,可处理一定的特征相关设置 |
KernelExplainer | 通用黑箱模型 | 模型无关,但通常较慢 |
DeepExplainer | 部分深度学习模型 | 对 Deep SHAP 的近似实现 |
PermutationExplainer | 通用模型 | 通过输入排列近似 Shapley 值 |
ExactExplainer | 特征较少的场景 | 优化后的精确枚举 |
TreeSHAP 保留了 Shapley value 对不同特征加入顺序进行加权汇总的规则,并利用决策树结构和动态规划提高计算效率。不过,它所计算的价值函数 vx(S)v_x(S)vx(S) 取决于采用的特征依赖假设,因此 interventional 与 tree_path_dependent 可能得到不同的基准值和特征归因。[4][5] 以 tree_path_dependent 为例,假设树的根节点是“年收入是否大于 20 万”:
- 已知年收入时,可以确定应该走左边还是右边;
- 不知道年收入时,不能直接选一边,需要根据训练样本经过左右分支的比例,对两个分支的预测进行加权。
这样得到的是在树路径统计规则下,“知道某些特征、不知道另一些特征”时的期望输出。
TreeSHAP 不会为每个特征组合单独重新遍历整棵树,而是在遍历根到叶路径时,用动态规划同时记录不同大小特征组合的累计权重。到达叶节点后,再把叶节点预测值按照这些权重分配给路径上的特征。原始论文将直接计算的复杂度大大降低了,但是 SHAP 的核心思想是没有改变的,在这里就不多做赘述。
六、SHAP 分析中的局部解释与全局解释
SHAP 分析可以从单个样本一路汇总到整个模型。
6.1 局部解释:为什么这个客户被预测为 35%?
局部解释(local explanation)就是解释一个具体样本。
在贷款违约概率预测模型的例子里,我们关心:
- 为什么这个客户比基准风险高?
- 历史逾期次数推高了多少?
- 收入是否把风险拉低?
- 哪几个特征共同形成了当前 35% 的预测?
Waterfall plot、force plot 都属于典型局部解释图。
6.2 全局解释:整个模型通常最依赖哪些特征?
如果对很多样本都计算 SHAP 值,就可以把局部解释汇总为全局规律。
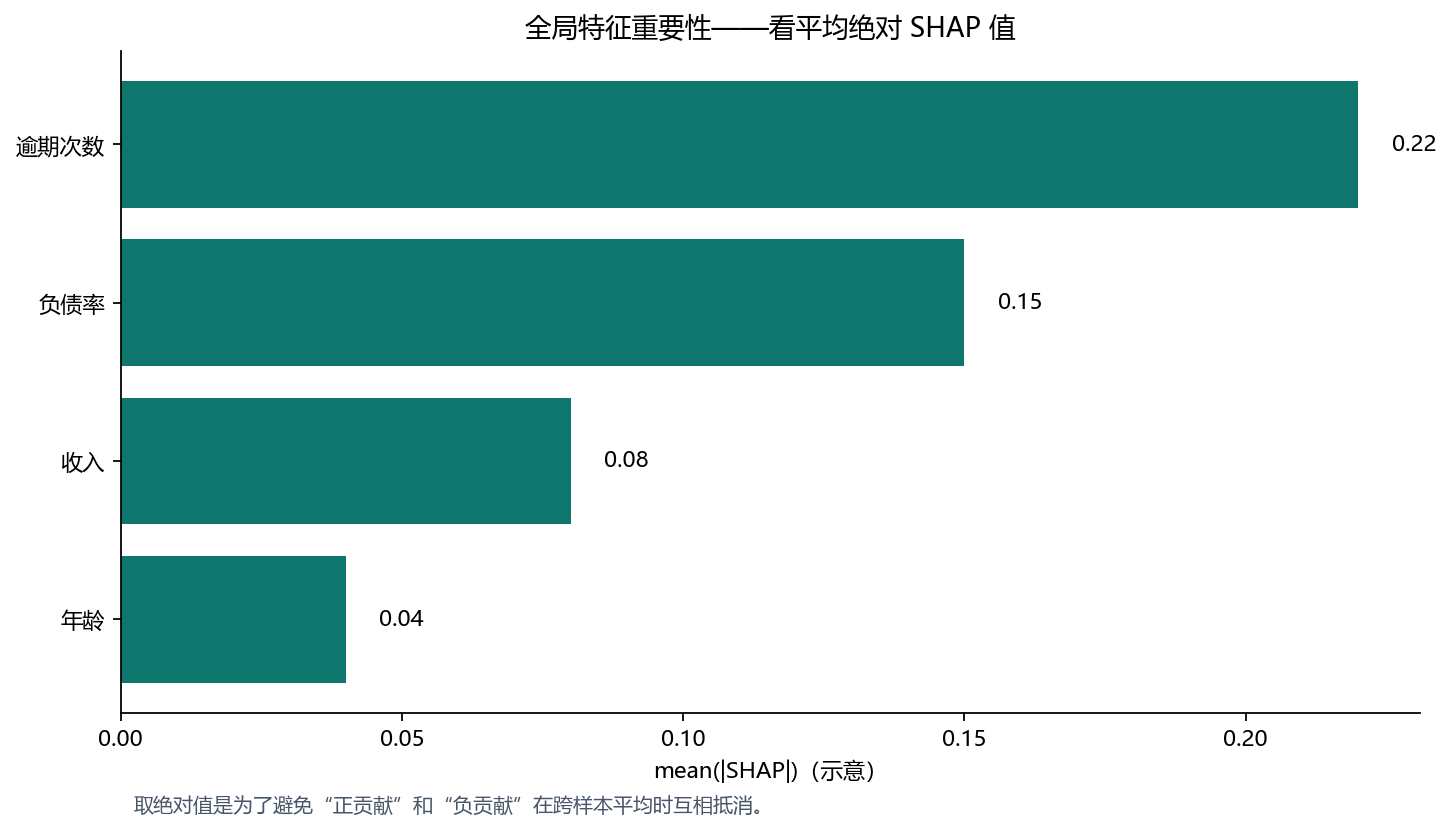
最常见的全局重要性做法之一,是计算每个特征的平均绝对 SHAP 值:
Importancei=1n∑j=1n∣ϕij∣ Importance_i=\frac{1}{n}\sum_{j=1}^{n}|\phi_{ij}| Importancei=n1j=1∑n∣ϕij∣
为什么要取绝对值?
假设某个特征对一半样本是 +0.2,对另一半样本是 -0.2。如果直接平均,结果接近 0,看起来像“没影响”;但其实它每次的影响都很大,只是方向相反。
因此,用 mean(∣SHAP∣)mean(|SHAP|)mean(∣SHAP∣) 可以衡量:
不管推高还是压低,这个特征平均能让模型输出变化多大。
七、SHAP 结果可视化评估方法
SHAP 官方 API 提供 bar、beeswarm、scatter、waterfall 等多种图。[5] 有的用于比较模型整体更依赖哪些特征,有的用于观察特征值与贡献方向的关系,还有的专门解释某一个样本。
下面继续使用贷款违约概率预测模型进行可视化展示,并将特征扩展为历史逾期次数、负债率、年收入、贷款金额、征信记录年限、工作稳定年限、近 6 个月征信查询次数和年龄。全局图共包含 600 个测试客户;图中数据是用于说明读图方法的教学化模拟结果,不来自真实信贷业务。
除特别说明外,横轴中的 SHAP 值都解释为违约概率的百分点变化:正值表示该特征把模型预测的违约概率推高,负值表示把违约概率压低。
7.1 Bar Plot:比较全局特征重要性
功能:Bar Plot 用于比较模型在一批样本上对各特征的平均依赖程度。每个特征的数值通常取测试集上的平均绝对 SHAP 值,即先对每个客户的 SHAP 值取绝对值,再求平均。这样得到的全局重要性只关心“影响有多大”,不区分推高还是压低。
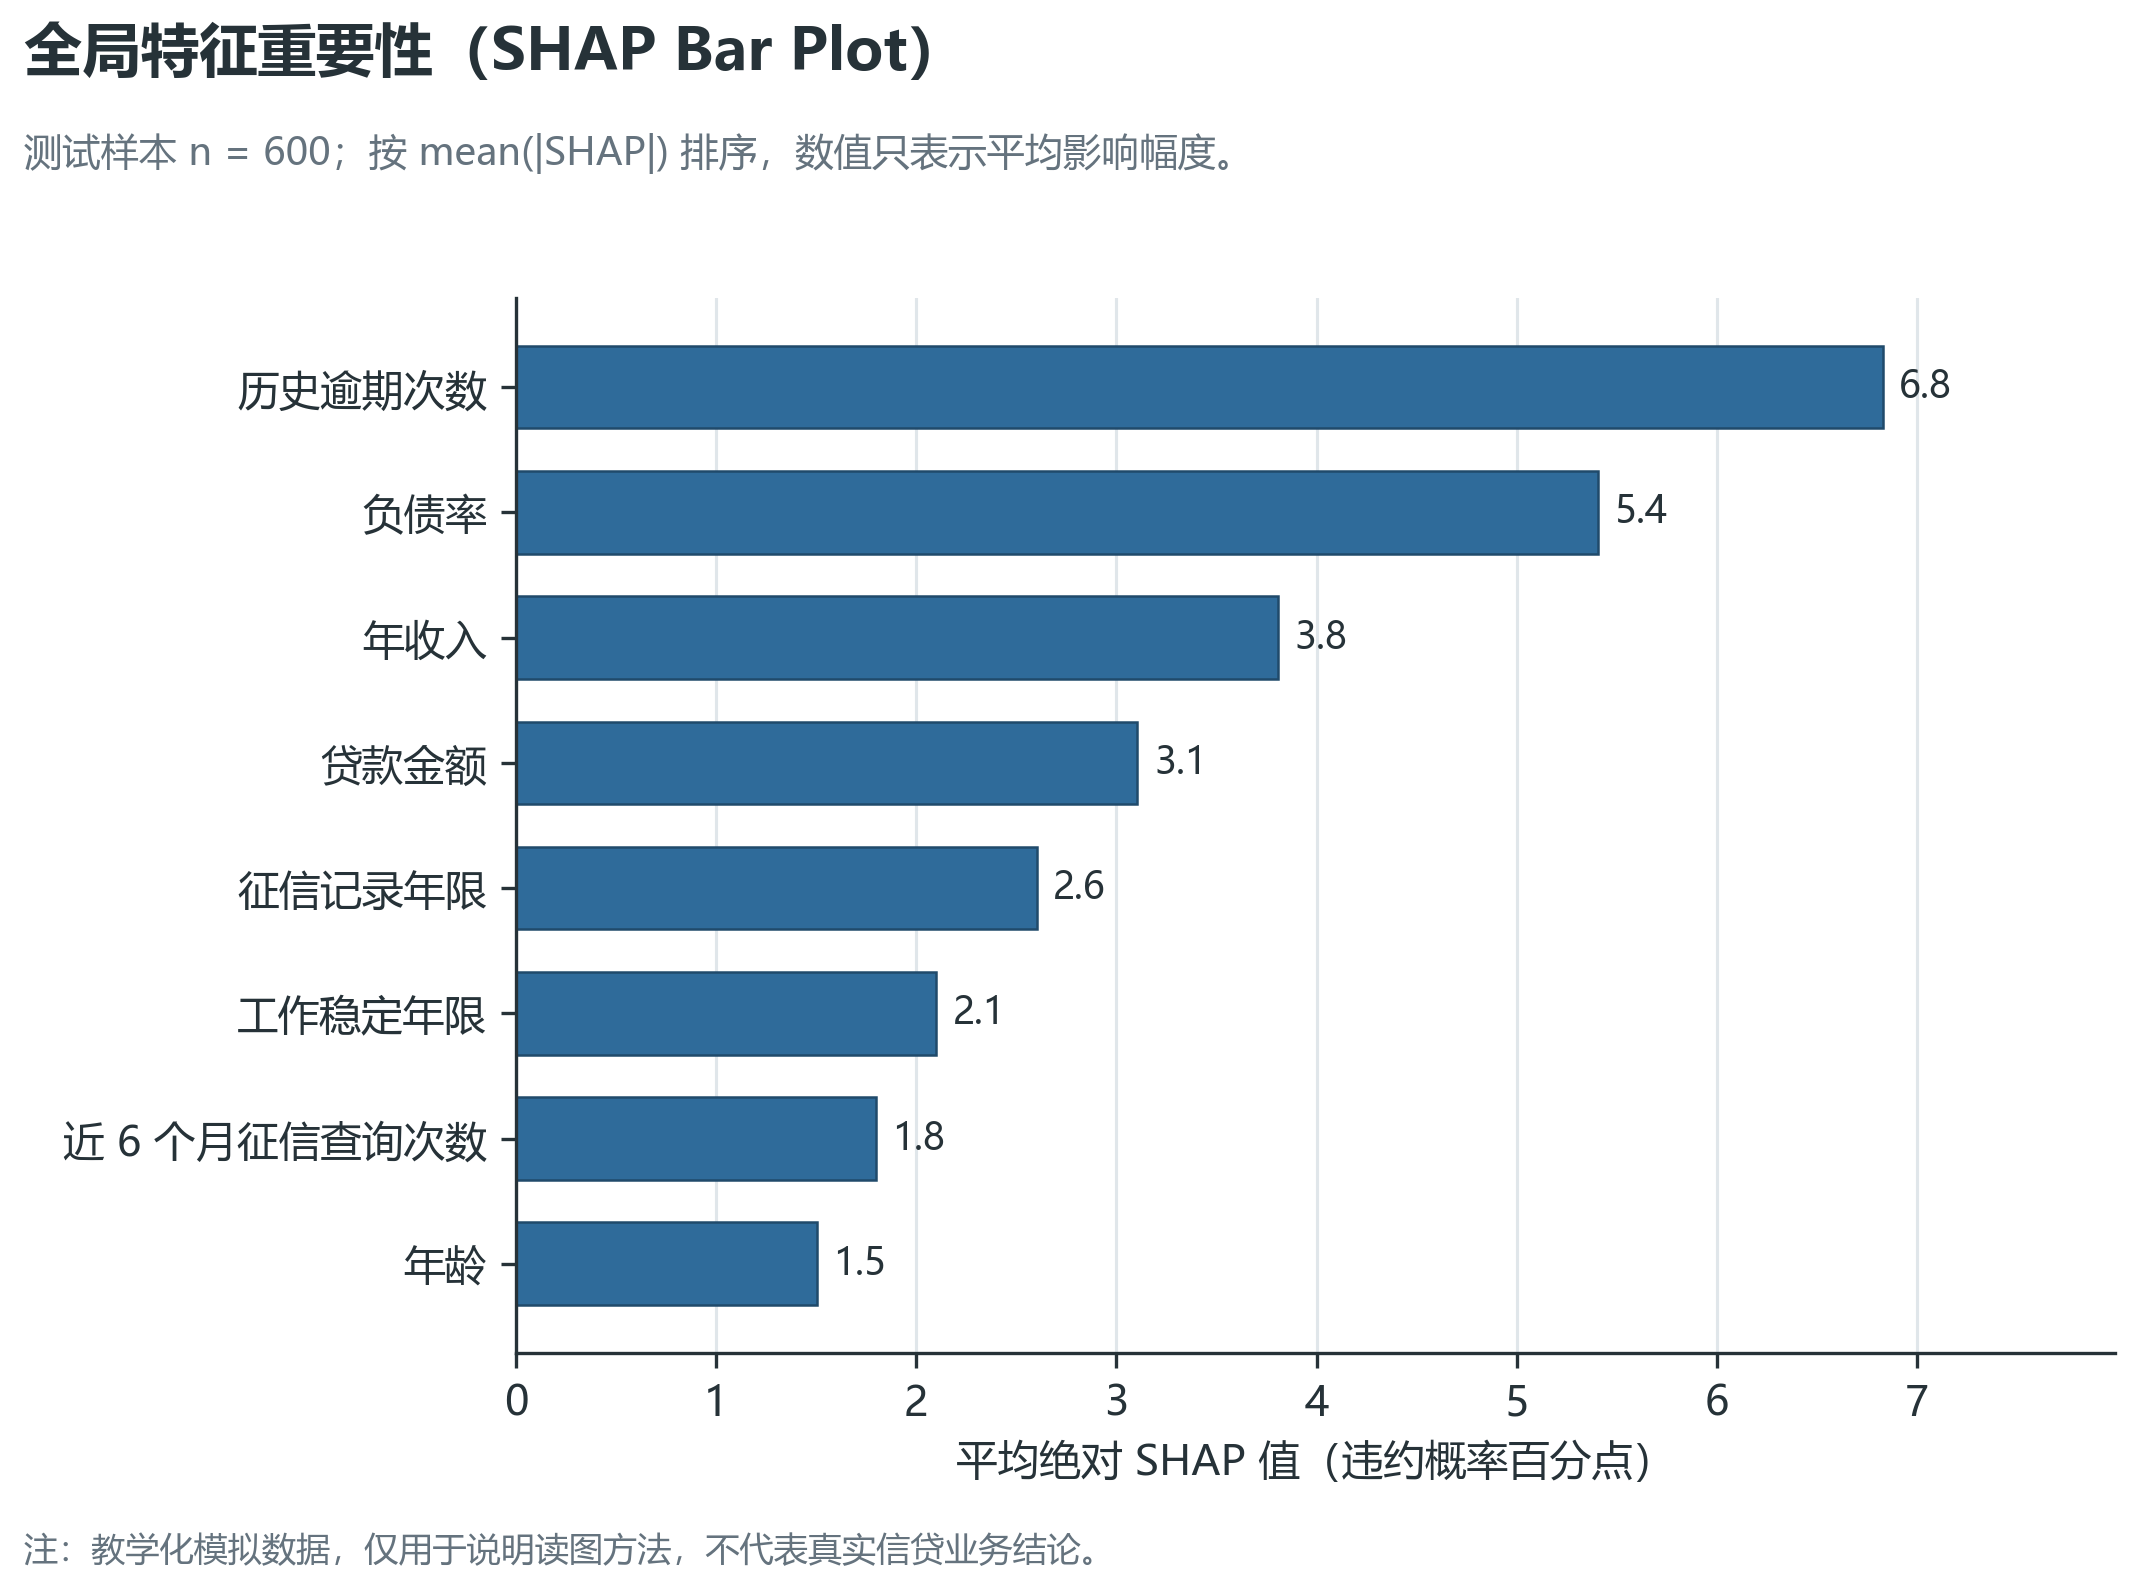
图 7-1 贷款违约模型的全局特征重要性。横轴为测试集上的平均绝对 SHAP 值,单位为违约概率百分点。
怎么读:先看纵轴排名,再看横轴长度。图中历史逾期次数的平均绝对 SHAP 值约为 6.8 个百分点,负债率约为 5.4 个百分点,说明在这 600 个客户上,它们平均引起的模型输出变化最大;年龄约为 1.5 个百分点,整体影响相对较小。
7.2 Beeswarm Plot(蜂群图):同时观察重要性、方向和样本差异
功能:Beeswarm Plot 在一张图中同时展示全局重要性、贡献方向和不同客户之间的差异。每个点表示“一个客户在一个特征上的 SHAP 值”;同一行的点越分散,说明该特征在不同客户上的影响差异越大。纵向错开只是为了显示点的密度,不表示额外的数值。
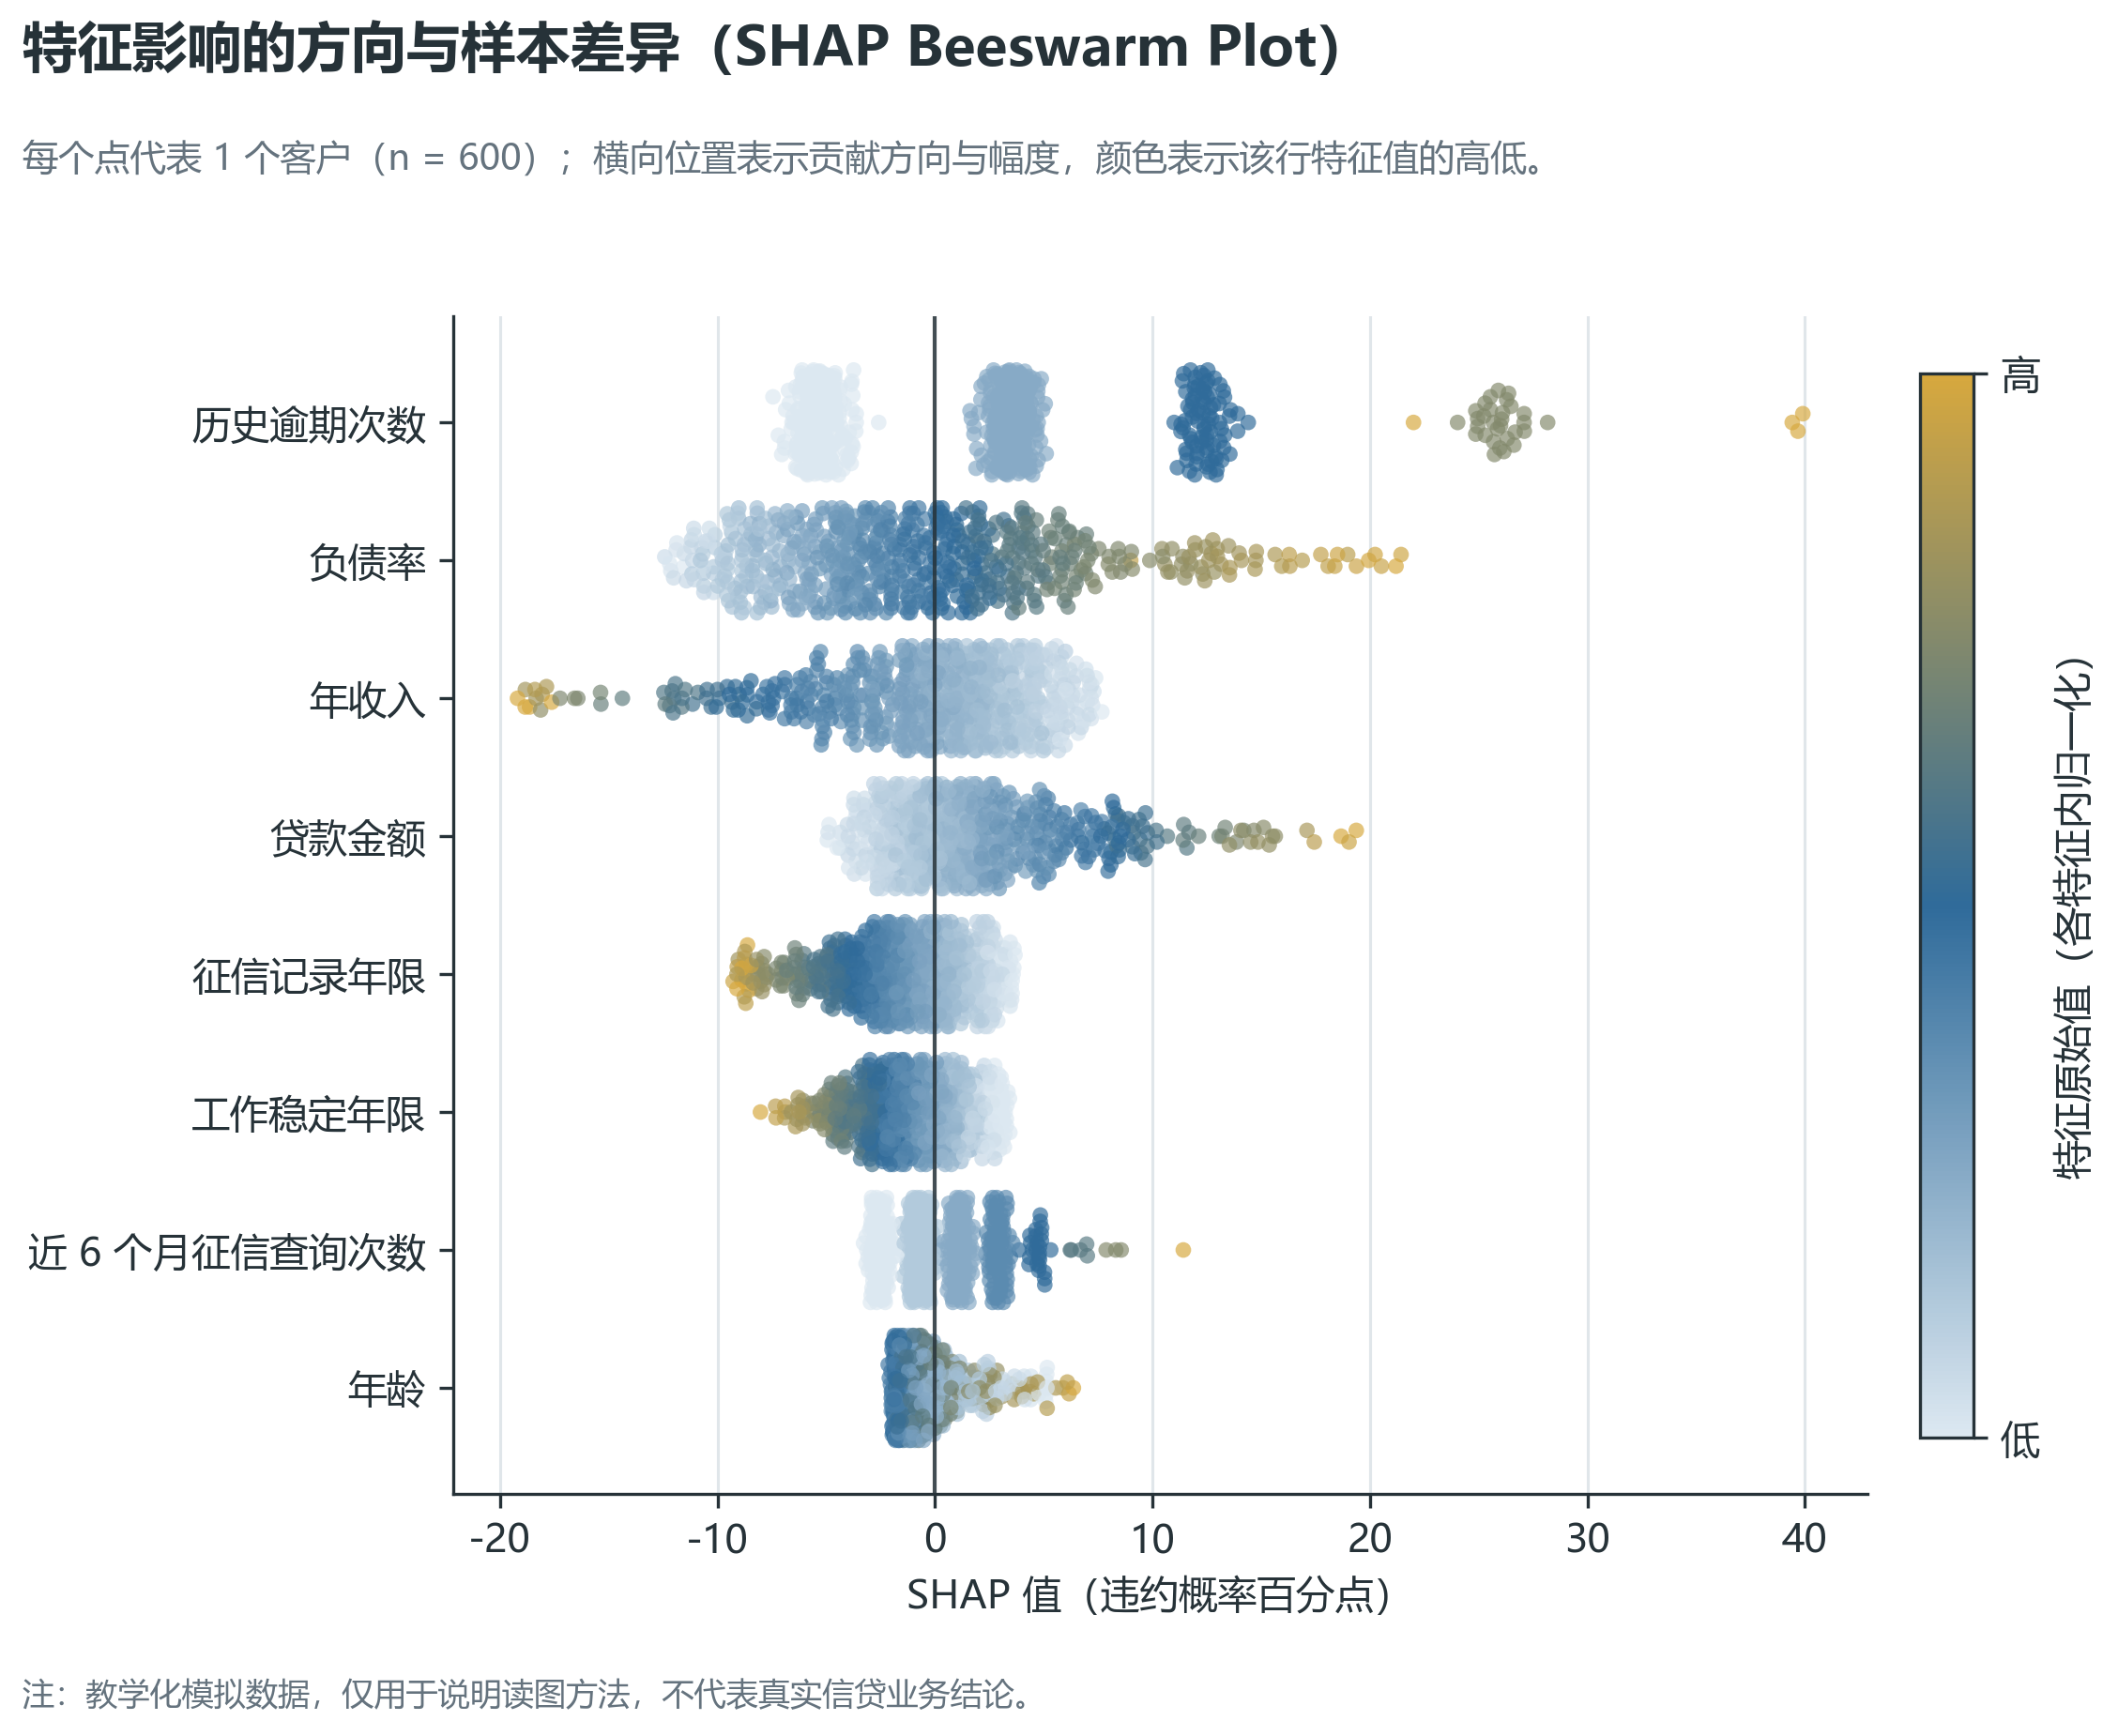
图 7-2 贷款违约模型的 SHAP 蜂群图。每个点代表一个客户;颜色表示该行特征值从低到高,不能用于比较不同行特征的数值大小。
怎么读:先以竖直零线判断方向,右侧的点推高违约概率,左侧的点压低违约概率;再看一行点云的横向跨度,跨度越大,说明该特征对不同客户的影响幅度越大;最后结合颜色判断特征值高低与贡献方向的关系。
图中,历史逾期次数和负债率的高值点主要位于右侧,表示模型通常把较多逾期和较高负债率当作提高违约概率的证据;年收入的高值点主要位于左侧,表示较高收入通常压低模型预测的违约概率。注意:这里描述的是模型学到的关联,不代表这些特征对违约存在因果作用。
7.3 Scatter Plot / Dependence plot(依赖图):观察单个特征的非线性影响
功能:Scatter Plot,也称 SHAP dependence plot,用于观察一个特征在不同取值下如何影响模型输出。横轴是该特征的原始值,纵轴是同一特征的 SHAP 值;如果点云呈曲线、平台或突变,就说明模型对这个特征的响应不是简单的线性关系。
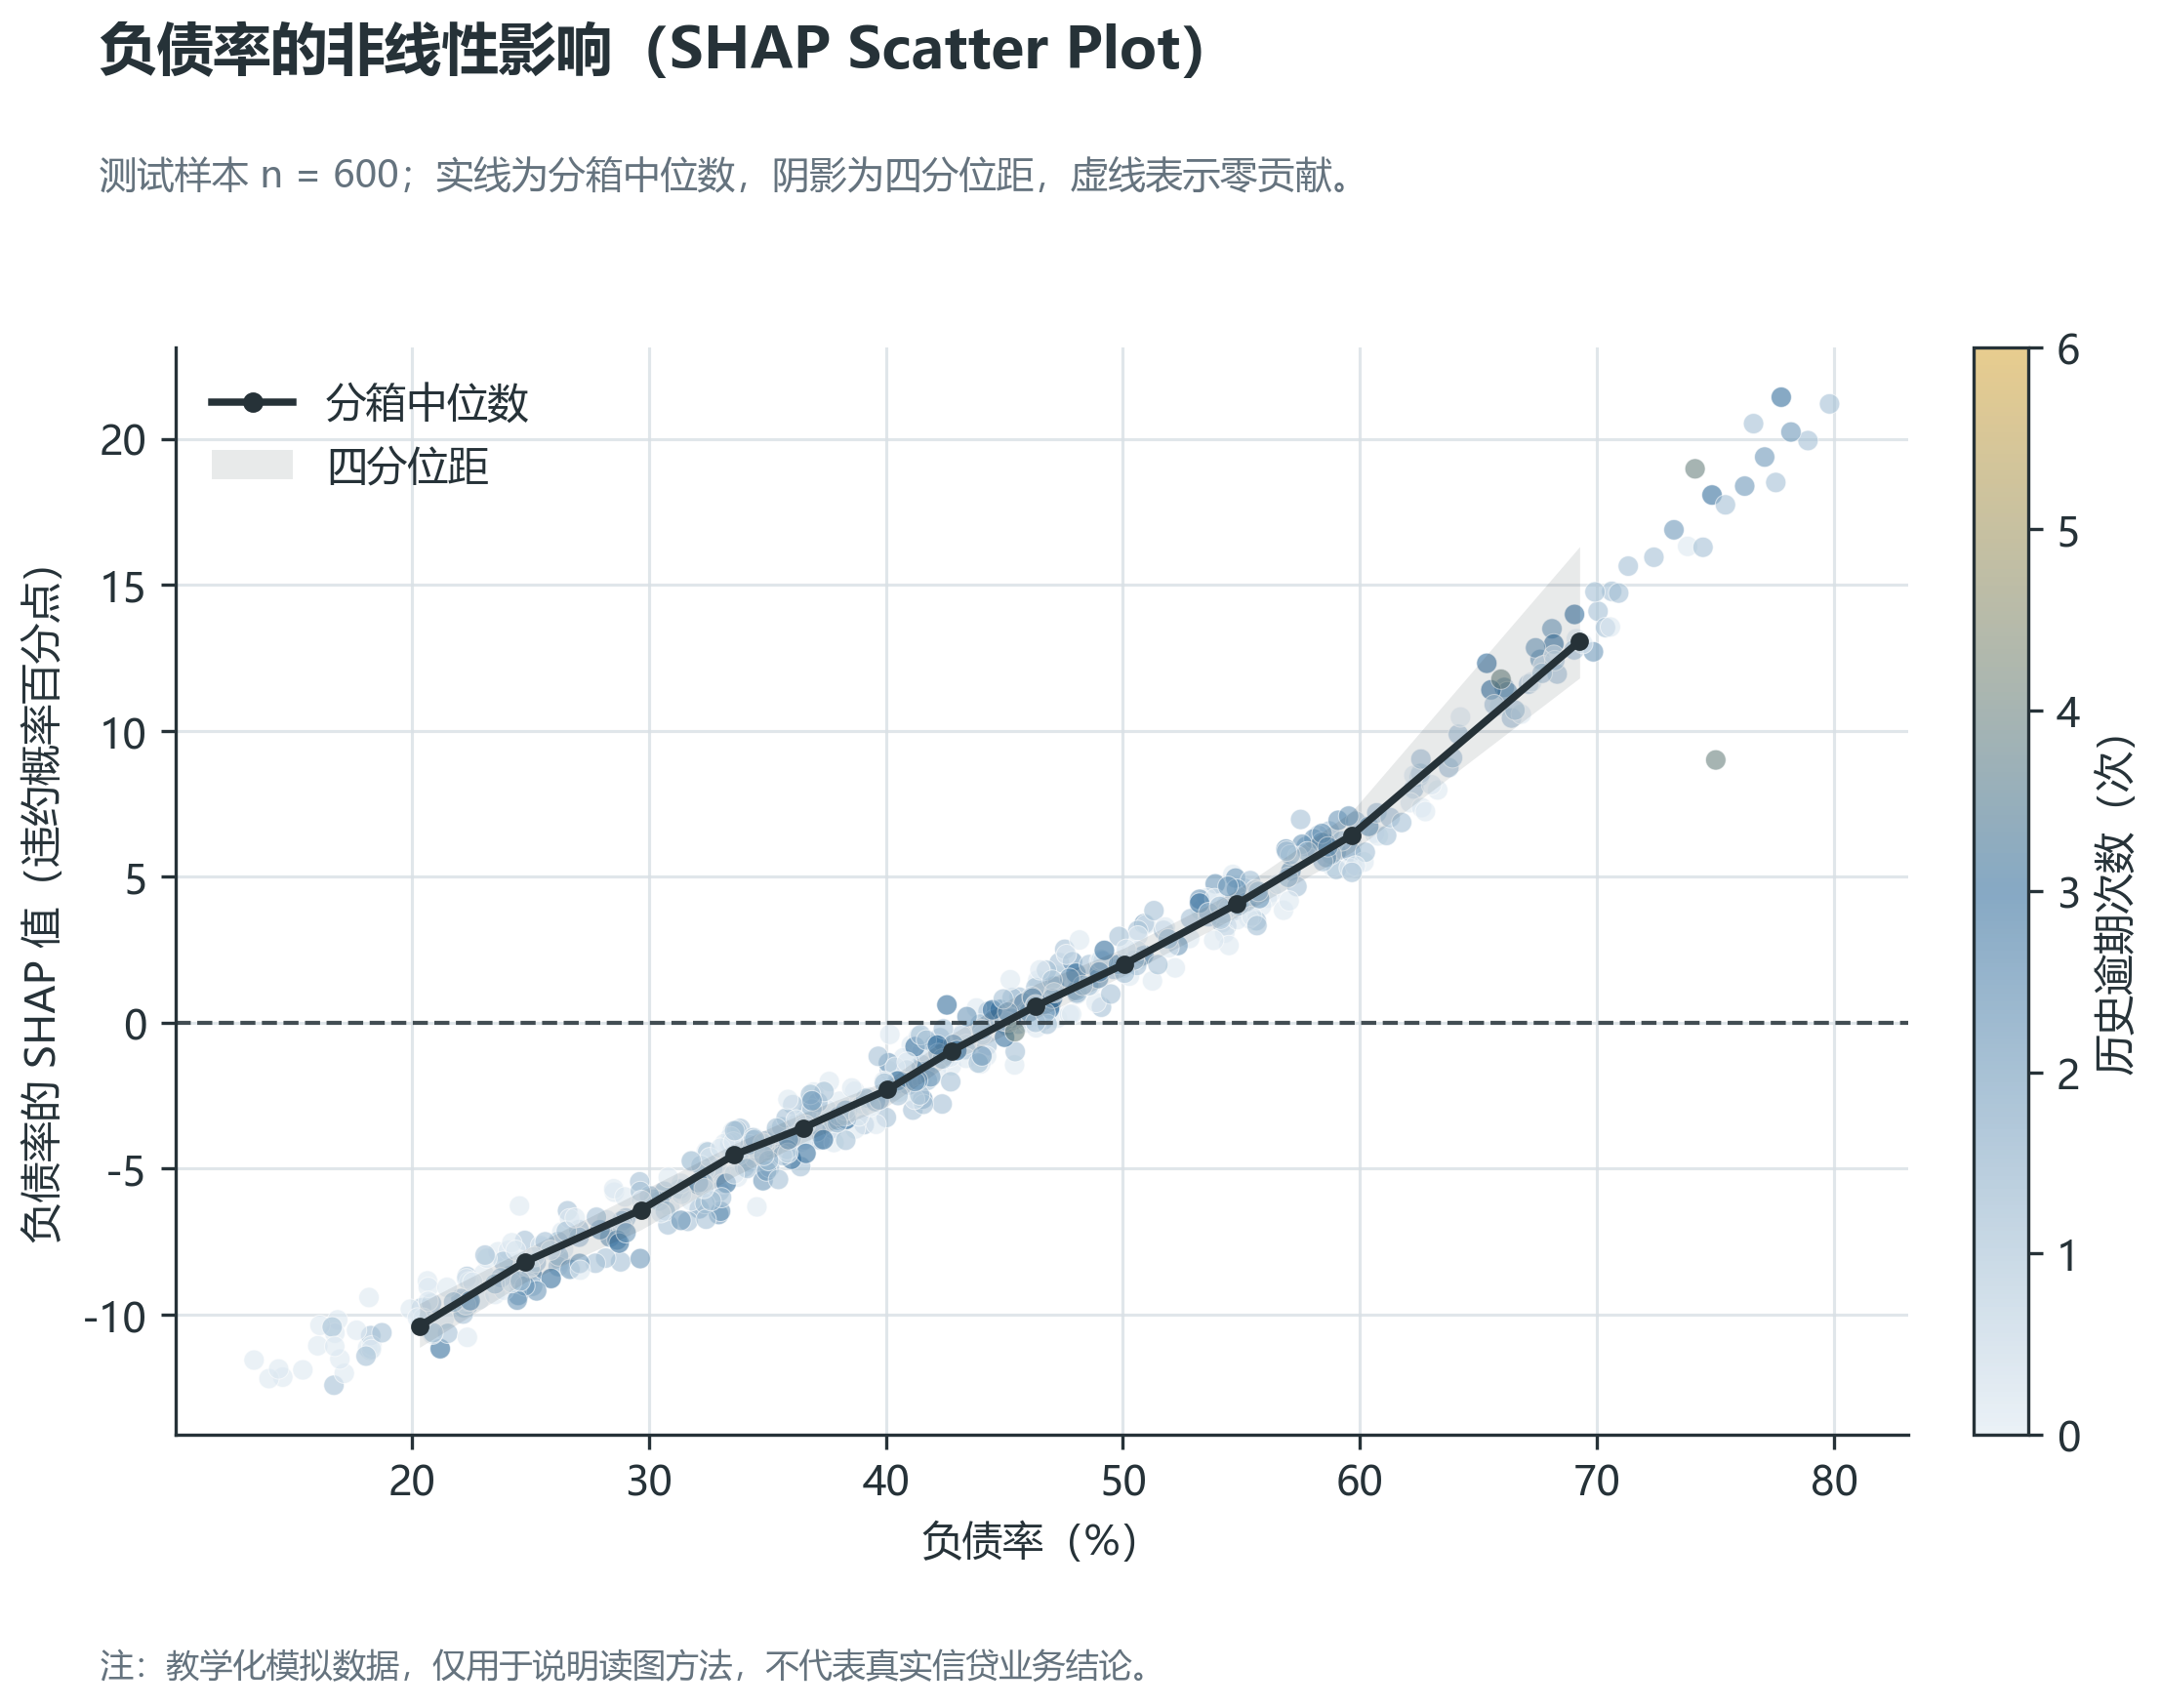
图 7-3 负债率的 SHAP 散点图。黑色实线表示分箱后的中位数,灰色带表示四分位距,点的颜色表示历史逾期次数。
怎么读:先看点位于零贡献虚线的哪一侧。图中负债率较低时,负债率对应的 SHAP 值通常为负;在 45% 左右由负贡献转为正贡献,而且在高负债率区间上升更快。这说明当前模型对负债率的响应不是固定斜率的简单线性关系。
7.4 Waterfall Plot(瀑布图):解释一个具体样本
功能:Waterfall Plot 用于解释一个具体客户的预测结果。它从基准输出 E[f(X)]E[f(X)]E[f(X)] 出发,依次叠加这个客户各特征的 SHAP 值,最后到达模型预测 f(x)f(x)f(x),直观展示预测是怎样由各项贡献累加得到的。
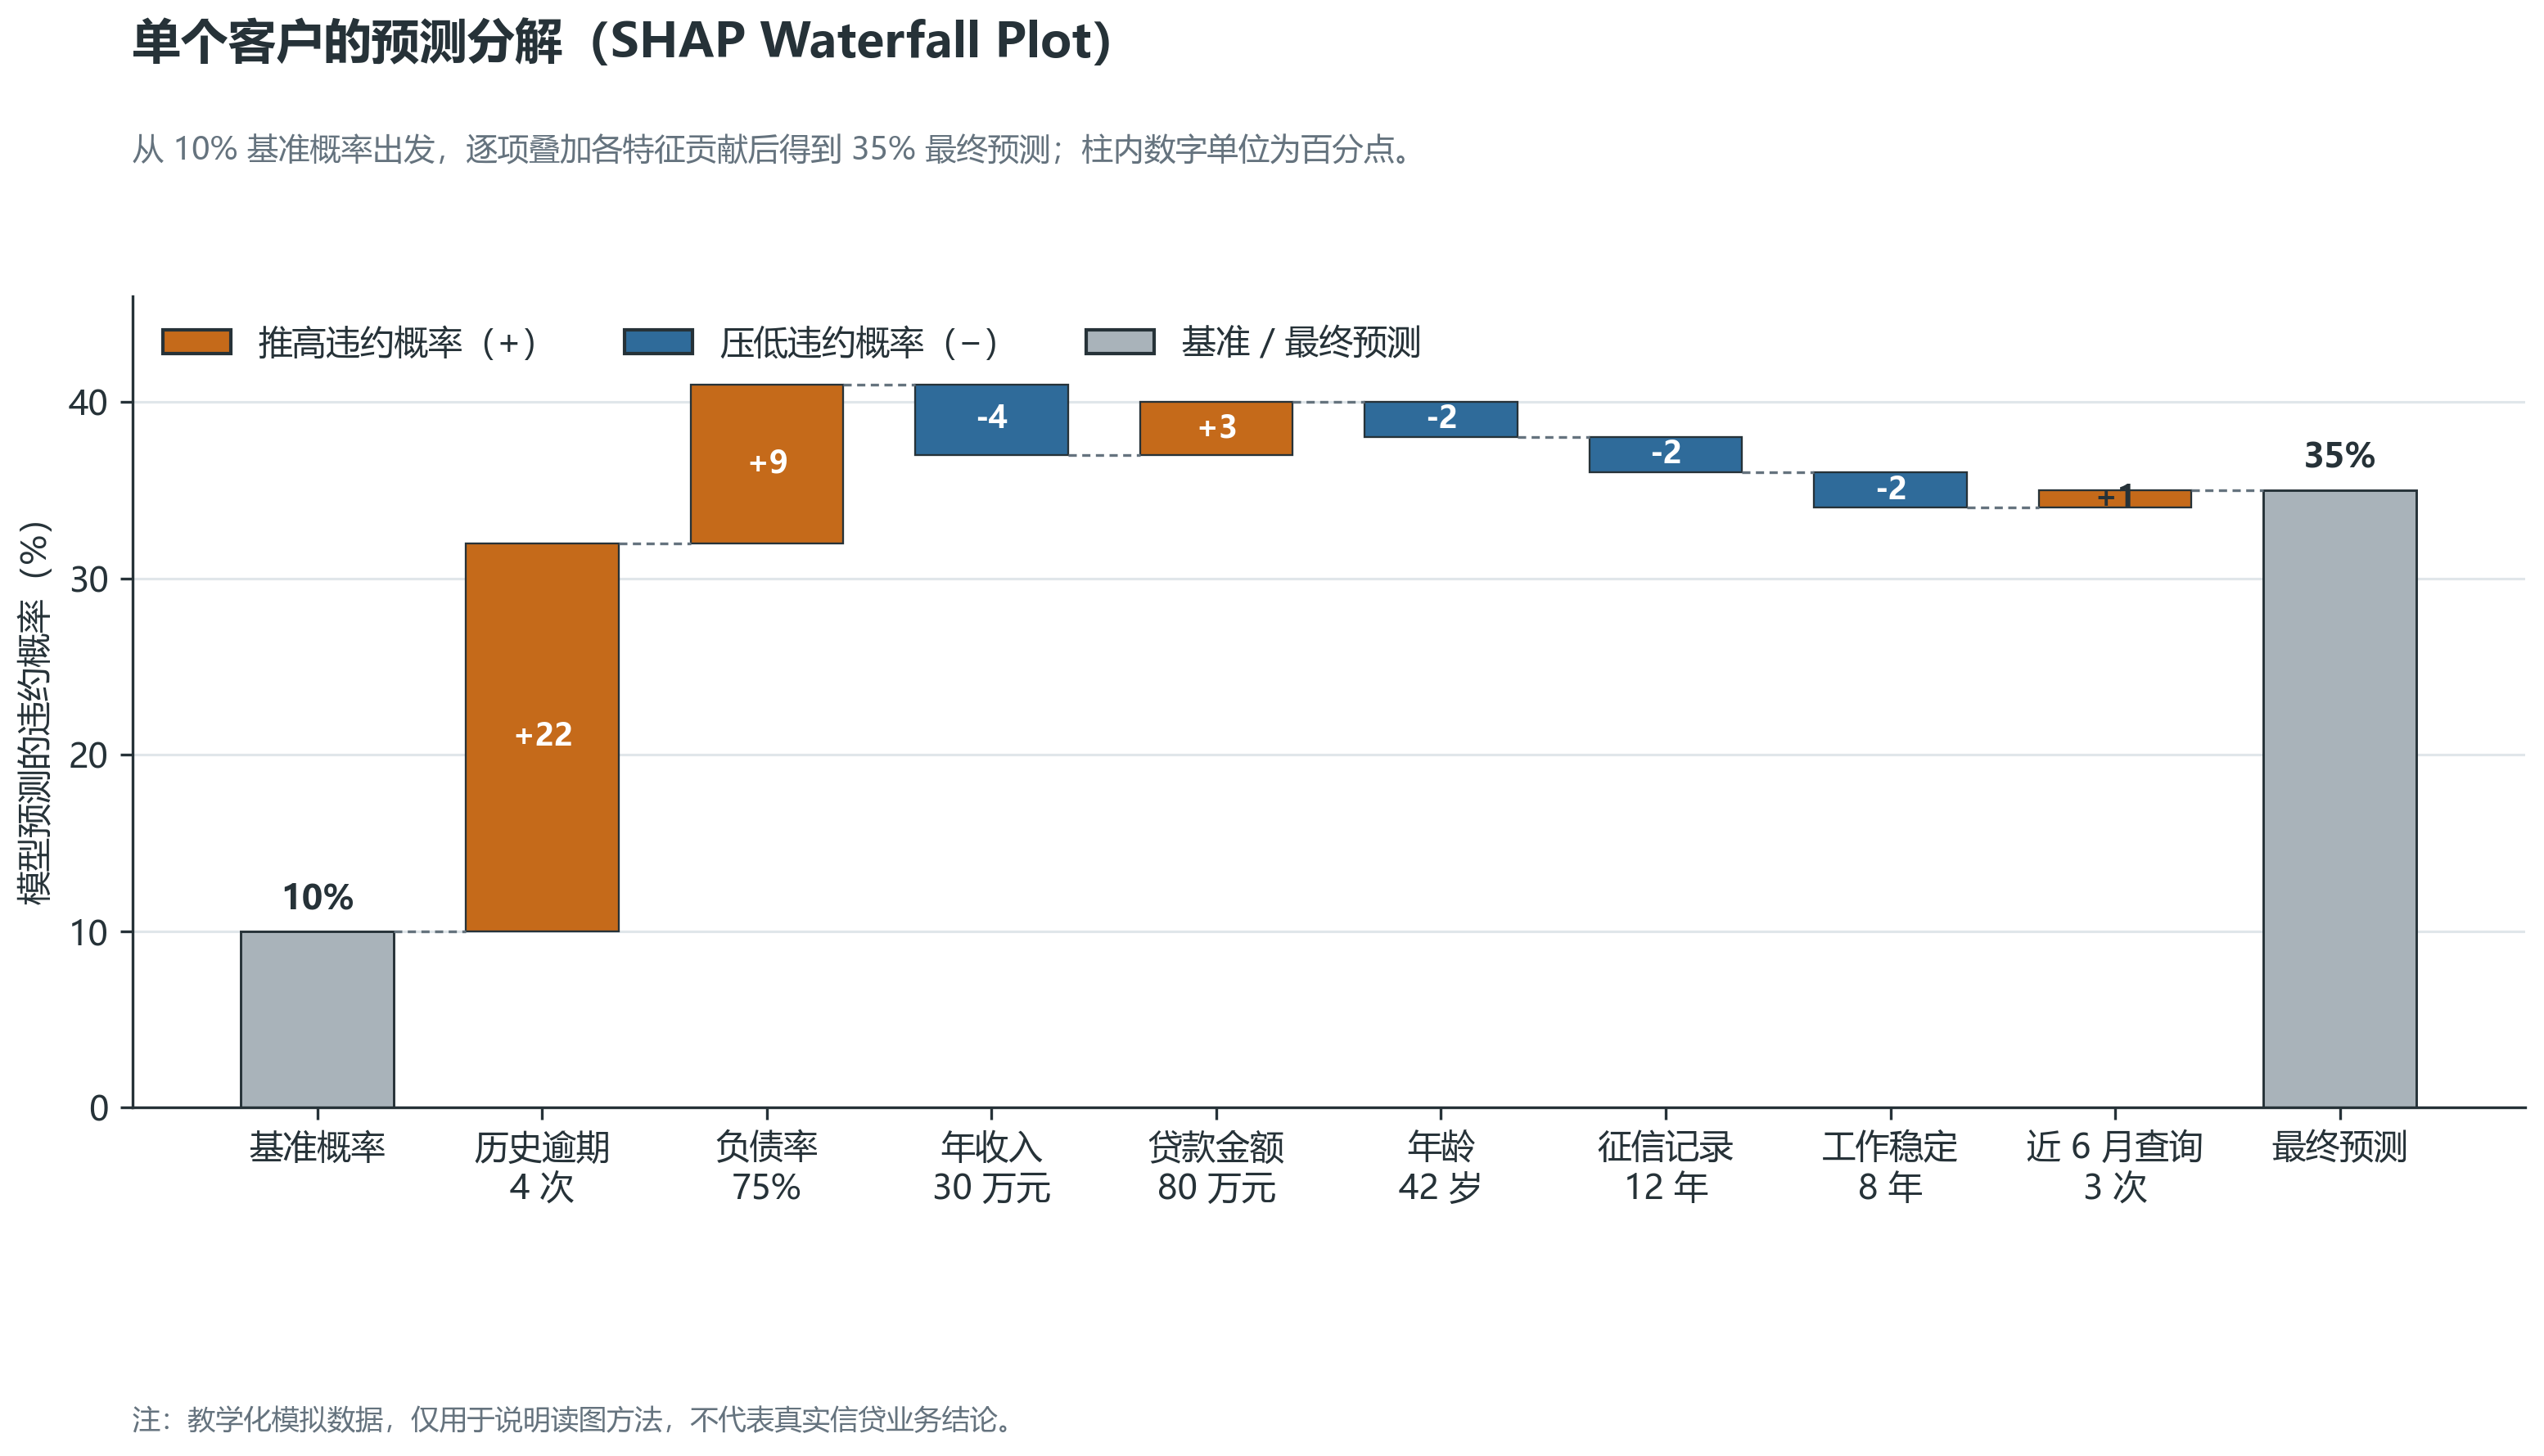
图 7-4 前文示例客户的预测分解。橙色柱表示推高违约概率,蓝色柱表示压低违约概率,柱内数字为贡献的百分点。
怎么读:从左向右沿虚线连接关系读取。该客户从 10% 的基准违约概率出发,历史逾期 4 次贡献 +22+22+22 个百分点,负债率 75% 贡献 +9+9+9 个百分点;较高年收入、42 岁、较长的征信记录和工作稳定年限产生负贡献,抵消了一部分风险,最后得到 35% 的预测违约概率。所有贡献满足:
10%+(22+9−4+3−2−2−2+1) 个百分点=35% 10\%+(22+9-4+3-2-2-2+1)\text{ 个百分点}=35\% 10%+(22+9−4+3−2−2−2+1) 个百分点=35%
Waterfall Plot 只解释这一个客户,不能用来判断模型整体最依赖哪些特征,也不能把单个客户的贡献模式直接推广到其他客户。
八、SHAP Python 实战
下面用一个完整例子展示“准备数据—训练模型—计算 SHAP 值—验证结果—生成图表”的过程。示例使用 scikit-learn 内置的 Wisconsin 乳腺癌诊断数据集,其中有 569 个样本和 30 个数值特征。[6] 为了让正类语义更直观,代码把“恶性”重新编码为 1,并解释模型输出的恶性概率。
相关依赖:
uv pip install shap scikit-learn pandas matplotlib
8.1 训练随机森林分类模型
import matplotlib.pyplot as plt
import numpy as np
import shap
from sklearn.datasets import load_breast_cancer
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, roc_auc_score
from sklearn.model_selection import train_test_split

dataset = load_breast_cancer(as_frame=True)
X = dataset.data
y = 1 - dataset.target  # 原数据中 0=恶性,这里改成 1=恶性

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.25,
    stratify=y,
    random_state=42,
)

model = RandomForestClassifier(
    n_estimators=300,
    max_depth=6,
    min_samples_leaf=3,
    class_weight="balanced",
    n_jobs=-1,
    random_state=42,
)
model.fit(X_train, y_train)

probability = model.predict_proba(X_test)[:, 1]
prediction = (probability >= 0.5).astype(int)
print("Accuracy:", accuracy_score(y_test, prediction))
print("ROC AUC:", roc_auc_score(y_test, probability))
先评估模型,再解释模型。这个固定随机种子的单次划分得到 Accuracy 约 0.972、ROC AUC 约 0.998。它足以验证代码流程,但不能代替交叉验证、外部验证或临床评估。
8.2 计算恶性类别的 SHAP 值
随机森林属于树模型,因此使用 TreeExplainer。这里选择 tree_path_dependent:当某个特征被视为未知时,算法使用训练样本经过树路径的统计信息进行加权,不需要额外提供背景数据。
explainer = shap.TreeExplainer(
    model,
    feature_perturbation="tree_path_dependent",
    model_output="raw",
)
all_class_shap = explainer(X_test, check_additivity=False)

# 二分类模型可能同时返回两个类别的解释。
# 形状为“样本 × 特征 × 类别”时,取类别 1,即恶性类别。
if all_class_shap.values.ndim == 3:
    shap_values = all_class_shap[:, :, 1]
else:
    shap_values = all_class_shap

print(shap_values.shape)  # (143, 30)
不同 SHAP 版本、模型类型和输出数量可能产生不同形状,因此不要不检查维度就直接写 [:, :, 1]。本例得到 143 个测试样本、30 个特征的 shap.Explanation。
8.3 可加和性检查
在生成图表前,可以主动检查“基准值 + 全部 SHAP 值”能否还原模型输出:
reconstructed = (
    np.asarray(shap_values.base_values)
    + np.asarray(shap_values.values).sum(axis=1)
)
max_error = np.max(np.abs(probability - reconstructed))
print("最大加法闭合误差:", max_error)
本次运行的最大误差约为 1×10−151\times10^{-15}1×10⁻¹⁵,可以视为浮点数精度范围内的闭合。这一步还能帮助发现选错类别、混淆输出尺度或数组维度处理错误等问题。
8.4 生成并解读图表
得到 shap_values 后,就可以调用相应的绘图函数,生成第七部分介绍的四类图:
shap.plots.bar(shap_values)
shap.plots.beeswarm(shap_values)
shap.plots.scatter(shap_values[:, "worst radius"])
shap.plots.waterfall(shap_values[0])
九、参考资料
[1] SHAP 官方文档:Welcome to the SHAP documentation
https://shap.readthedocs.io/en/stable/
[2] SHAP 官方教程:An introduction to explainable AI with Shapley values
https://shap.readthedocs.io/en/stable/example_notebooks/overviews/An%20introduction%20to%20explainable%20AI%20with%20Shapley%20values.html
[3] Lundberg, S. M., & Lee, S.-I. (2017). A Unified Approach to Interpreting Model Predictions. NeurIPS 2017.
https://proceedings.neurips.cc/paper/2017/hash/8a20a8621978632d76c43dfd28b67767-Abstract.html
[4] Lundberg, S. M., Erion, G., Chen, H., et al. (2020). From local explanations to global understanding with explainable AI for trees. Nature Machine Intelligence, 2, 56–67.
https://doi.org/10.1038/s42256-019-0138-9
[5] SHAP API Reference(Explainers 与 Plots)
https://shap.readthedocs.io/en/stable/api.html
[6] scikit-learn 官方文档:Breast cancer Wisconsin dataset
https://scikit-learn.org/stable/modules/generated/sklearn.datasets.load_breast_cancer.html
[7] Janzing, D., Minorics, L., & Blöbaum, P. (2020). Feature relevance quantification in explainable AI: A causal problem. AISTATS 2020, PMLR 108, 2907–2916.
https://proceedings.mlr.press/v108/janzing20a.html
[8] Chen, H., Janizek, J. D., Lundberg, S. M., & Lee, S.-I. (2020). True to the Model or True to the Data? arXiv:2006.16234.
https://arxiv.org/abs/2006.16234
[9] Aas, K., Jullum, M., & Løland, A. (2021). Explaining individual predictions when features are dependent: More accurate approximations to Shapley values. Artificial Intelligence, 298, 103502.
https://doi.org/10.1016/j.artint.2021.103502
更多推荐



 13
 0
- 0


 已为社区贡献5条内容

所有评论(0)