
企业知识库搭建全流程:从文档导入到检索调优,让大模型基于私有数据精准回答
企业知识库搭建全流程:从文档导入到检索调优,让大模型基于私有数据精准回答
关键词:企业知识库、RAG、智能客服、文档检索、语义检索、成都硅基边界
适合人群:企业技术 / 产品 / 运营,想把公司私域资料变成"会回答的 AI"的团队。
一、为什么通用大模型答不好企业问题?
你一定遇到过:把公司产品手册、内部制度丢给通用大模型,它要么"一本正经胡说八道",要么干脆答不上来。根本原因有两点:
- 没有领域私货:通用大模型训练数据里没有你们公司的产品参数、售后政策、内部流程。
- 输出不稳定:同一个问题问两遍,答案可能都不一样,企业场景根本不敢用。
解决办法不是换更大的模型,而是给模型接一个企业知识库(RAG)——把私有数据喂给它,让它"基于资料回答"。
本文以硅基边界知识库模块为例,拆解企业知识库从导入、解析、分段到检索调优的完整流程,帮助你把通用大模型变成"领域专家"。
二、知识库能解决什么?
| 项目 | 说明 |
|---|---|
| 功能前提 | 知识库需与智能体绑定,或在工作流知识库节点中引用 |
| 核心价值 | 基于私有数据精准问答,缓解通用大模型领域知识不足、输出不稳定 |
| 应用场景 | 产品手册 → 智能客服;简历 → 数字分身;小说 → 角色塑造 |
典型落地例子:上传产品手册做智能客服,上传简历做数字分身,上传小说做角色塑造。一份私域资料,生成一个懂它的 AI。
三、4 种导入方式,现有资料直接"上车"
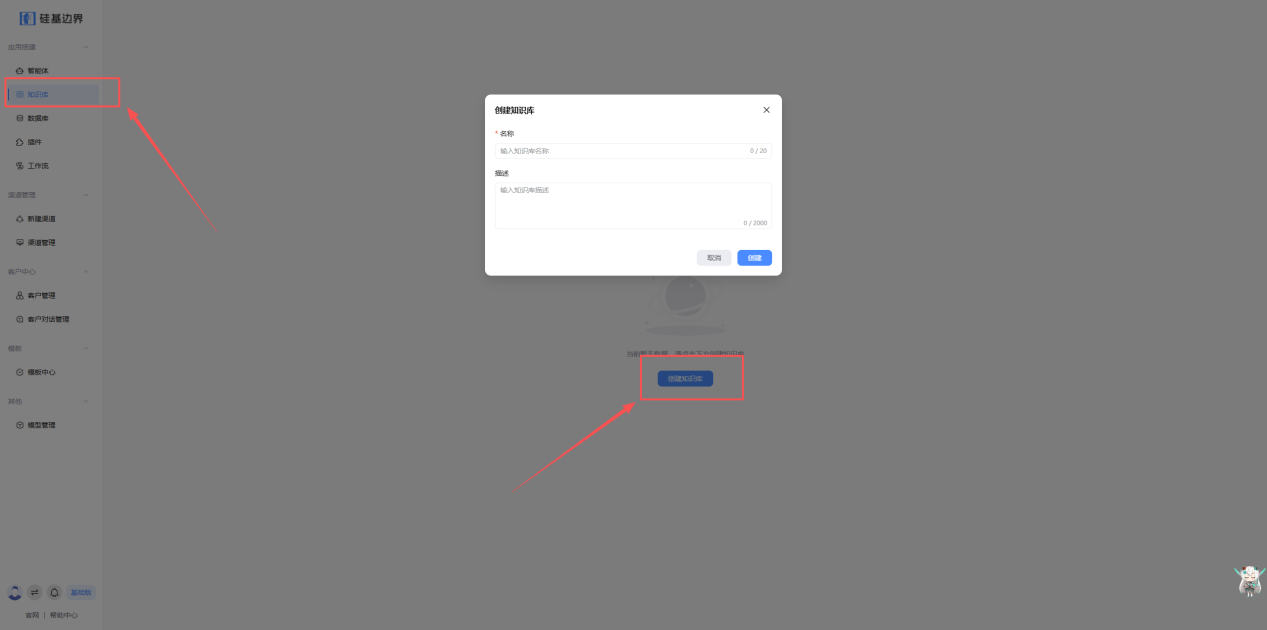
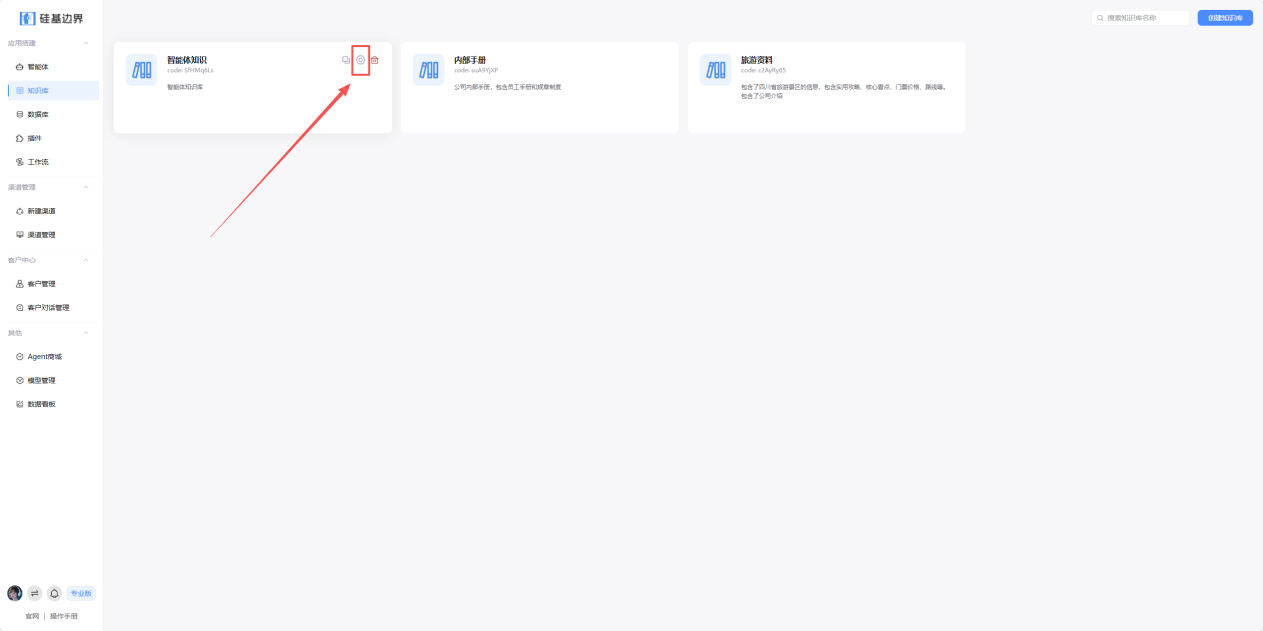
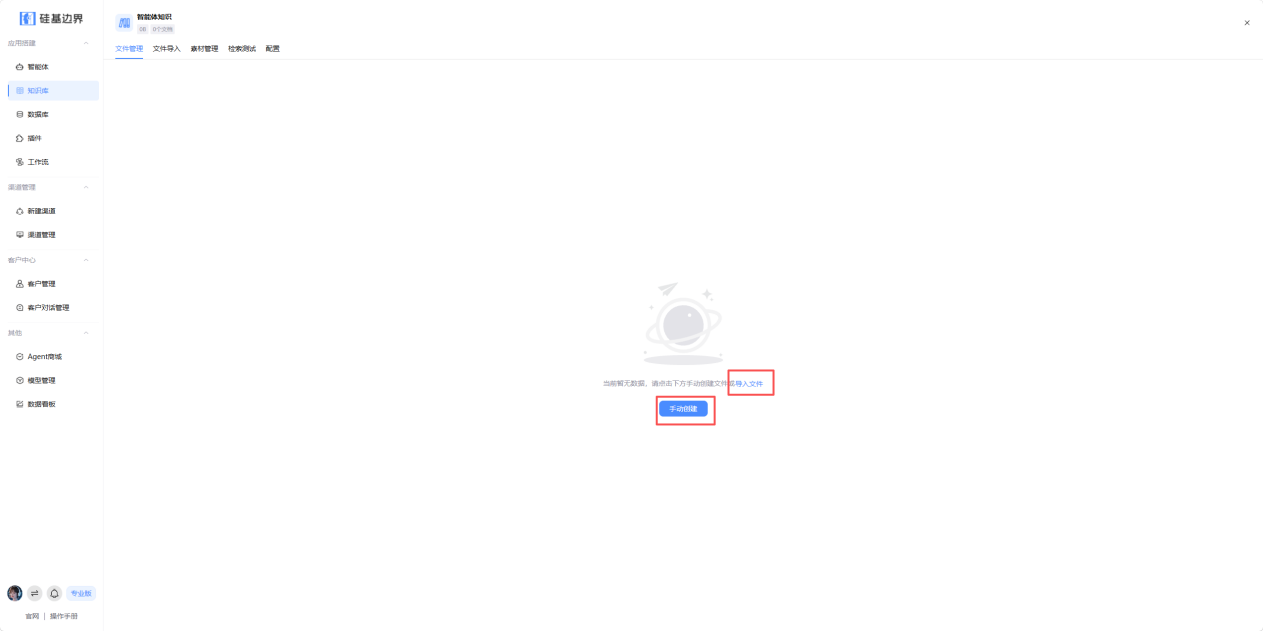
添加文件有手动创建和导入文件两种方式。导入支持四种类型,且同一知识库可同时混用文档、问答、表格、网页四类内容。
| 导入方式 | 适用场景 | 特点 |
|---|---|---|
| 文档导入 | 通用无结构素材首选 | 直接上传 PDF、Word、Markdown、TXT、单列 CSV,系统自动拆分加工 |
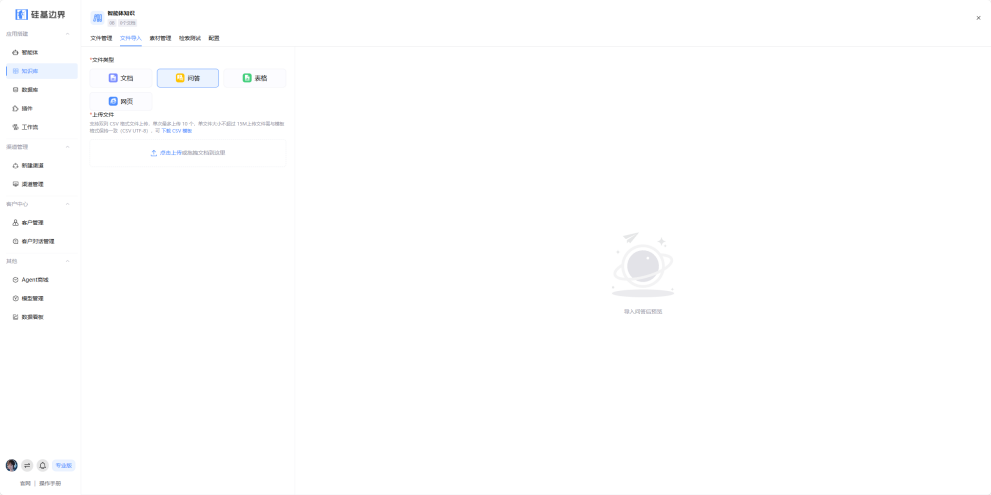
| 问答导入 | 追求回答精准度优先 | 一问一答结构化语料,需按模板整理成双列 CSV |
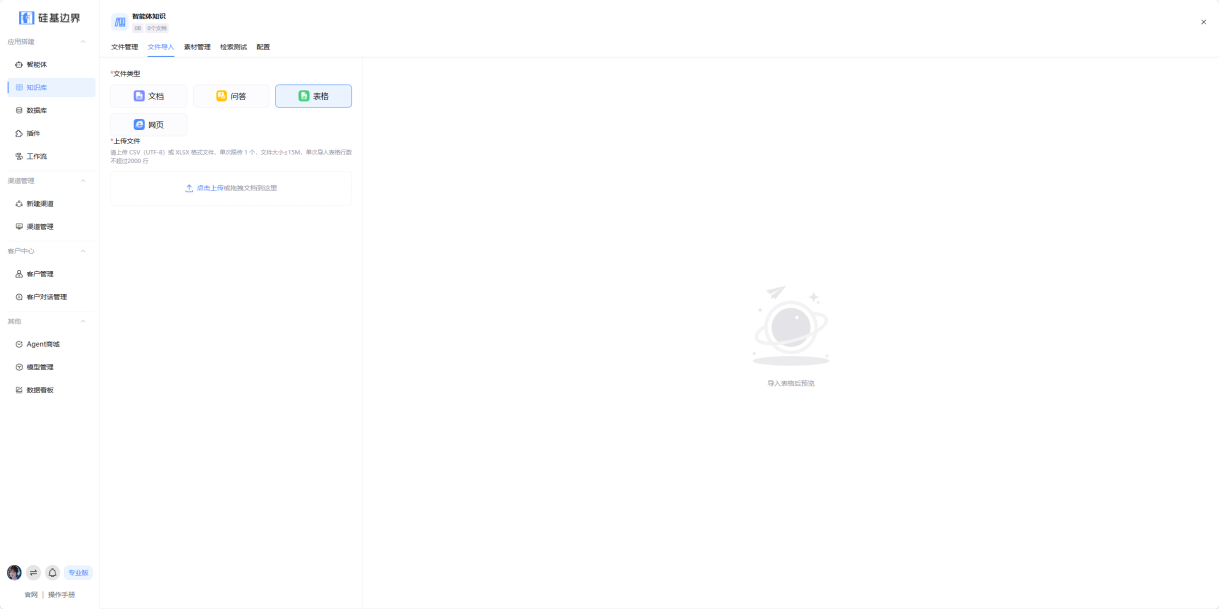
| 表格导入 | 多属性结构化业务数据专用 | 多列 Excel / CSV,可自定义检索索引列 |
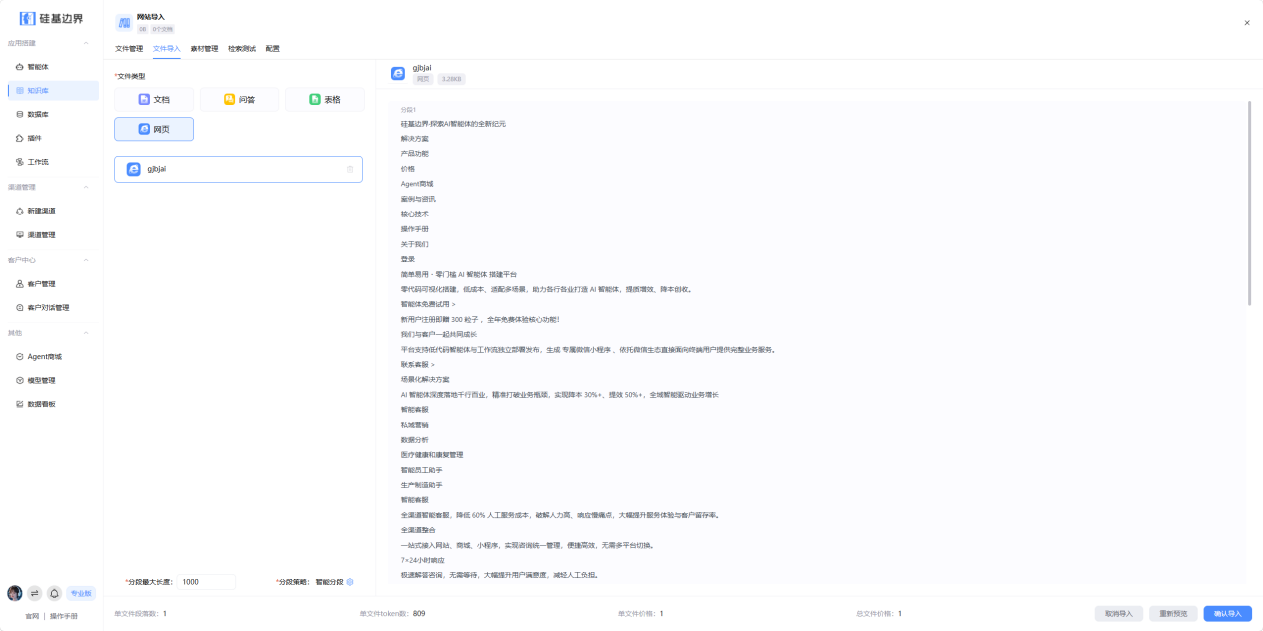
| 网站导入 | 线上网页内容批量收录 | 填链接,系统自动抓取解析全文入库 |
怎么选?
| 数据形态 | 推荐导入方式 |
|---|---|
| 公司简介、产品手册、使用教程、公告 | 文档导入 |
| 客服高频 FAQ、标准固定答复 | 问答导入 |
| 多 SKU 商品参数、设备规格、业务台账 | 表格导入 |
| 官网资讯、博客、线上产品说明、公众号网页 | 网站导入 |
四、文档导入的两大关键:解析策略 + 分段策略
这是知识库效果的命门。
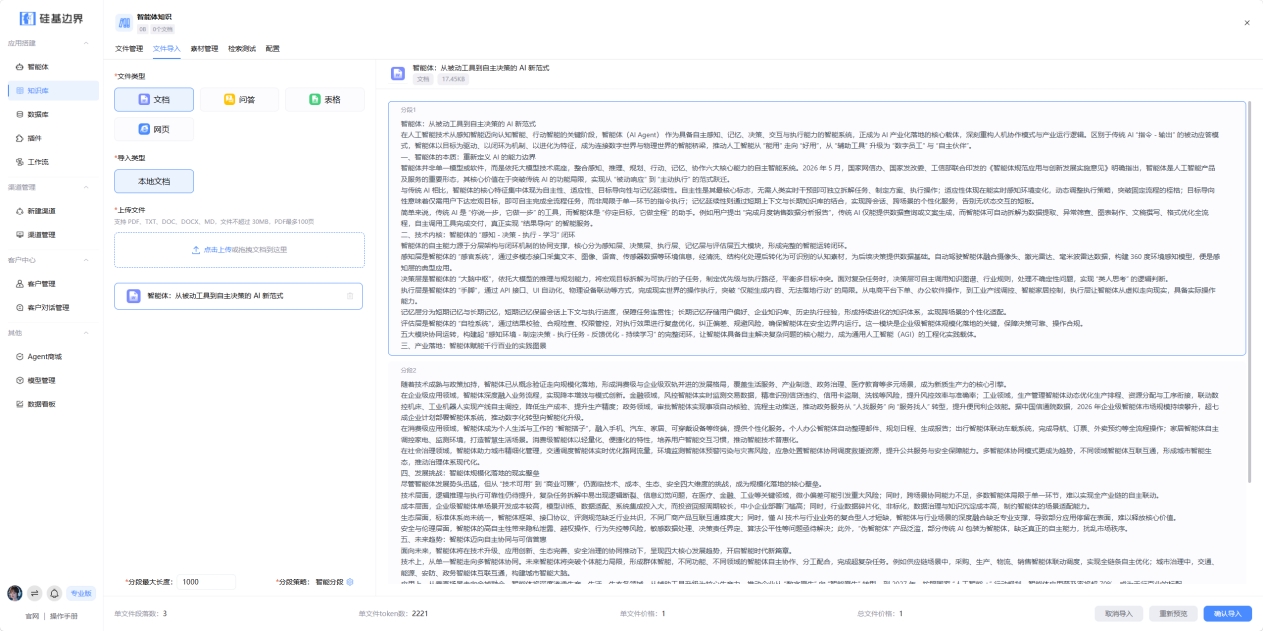
上传无结构文档后,系统会综合参考分段长度、标点符号自动切割长文本,右侧面板可实时预览拆分结果,页面左下方还会显示当前文件总 Token 数与预估粒子。
4.1 三种解析模式
| 解析模式 | 说明 |
|---|---|
| 文本解析 | 仅提取纯文字,速度快、资源省 |
| 增强解析 | 同步提取文字、内嵌图片与表格,兼顾图文表 |
| 智能解析 | 适配复杂表格、模糊扫描版 PDF,效果最优,但资源消耗更高 |
4.2 三种分段模式
检索调用的基本单位是分段而非整篇文档,分段质量直接决定检索效果。
① 智能分段(默认)
系统自动切割,每段不超过设定长度,保持语句完整、上下文连贯。
- 分段长度范围:1 ~ 5000 字符
- 推荐配置:
| 文档类型 | 推荐分段长度 |
|---|---|
| 产品手册 / 技术文档 | 800 - 1500 字符 |
| FAQ / 短文本 | 300 - 600 字符 |
| 长篇章节式文档 | 1500 - 3000 字符 |
② 自定义分段
按自定义分隔符拆分,适合有明确分隔规律的结构化文档。
- 分段最大长度:1 ~ 5000 字符
- 分隔符支持多组:如
\n\n、。、!、? - 分段重叠度:0 ~ 50%,建议 10-25% 以维持上下文连贯
③ 层级分段
按文档原有标题层级切分,保留完整章节结构。
- 分段层级:1 ~ 6 级标题
- 适用格式:Markdown(
#)、网站 HTML、Word / PDF(自动识别标题)
五、问答 / 表格 / 网站的导入要点
5.1 问答导入(双列 CSV:question + answer)
| 检索模式 | 说明 |
|---|---|
| 同时检索问题和答案(默认) | 覆盖范围广,相似度相对偏低 |
| 只检索问题 | 仅按问题匹配,精准度更高,适合标准 FAQ |
举例:问答"硅基边界有哪些版本?/ 基础版、标准版、专业版、旗舰版"。
- 选「只检索问题」时,用户问"基础版是什么",因为关键词只在答案里,大概率命中不到。
- 选「同时检索」则能命中。
标准 FAQ 用「只检索问题」最稳。
5.2 表格导入
- 多列 CSV / Excel(优先 UTF-8 编码防乱码)
- 导入后可改列名、配置检索列
- 默认全列参与检索
5.3 网站导入
- 单条 / 批量粘贴链接
- 常规格式:
站点根域名/sitemap.xml,可一键抓取全站子页面 - 适合:博客、公众号、文字类官网、产品文档等静态站点
- 不支持:需登录页面或纯在线文档
六、检索策略:让"答对"成为默认结果
⚠️ 注意:知识库无法独立生效,需绑定至智能体。单个智能体可绑多个知识库,同一知识库也可被多个智能体复用。
绑定后可在配置中选择 语义检索 / 增强检索:
| 检索策略 | 说明 |
|---|---|
| 语义检索 | 靠语义相似度匹配,设置相似度阈值 + 返回条数,仅高于阈值的高相似内容被召回 |
| 增强检索 | 语义 + 全文关键词检索结合,额外配置关键词检索条数,适配型号、数字、人名等精确信息 |
关键参数
| 参数 | 说明 |
|---|---|
| 相似度阈值 | 高于阈值才参与回复。0.8 以上精准但易漏;0.7 以下范围大但易混入无关内容,建议用检索测试调参 |
| 语义检索条数 | 默认 3 条,过大会超上下文、增加 Token 消耗 |
| 全文检索条数 | 增强检索专用,默认 1 条;语义 + 全文总数建议不超过 10 |
未命中怎么办?
未命中策略三选一:
| 策略 | 适用场景 |
|---|---|
| AI 自由作答 | 允许一定灵活性的场景 |
| 固定话术回复 | 需要严格控制输出的场景 |
| 自动转人工 | 高敏感或高价值咨询场景 |
可结合业务场景配置转人工规则。
三个"提分开关"
开关一:展示知识库引用来源
回复附带文件 / 网页来源,可单独设置来源相似度阈值,全渠道兼容。
开关二:查询改写(Query Rewriting)
结合上下文自动补全问题,解决多轮对话"指代缺失"。
例如:
- 首轮:“介绍下硅基边界知识库”
- 次轮:“支持哪些文件类型”
不开启时直接用第二句检索,容易因缺主体失配;开启后自动补全为"硅基边界知识库支持哪些文件类型"再检索。
⚠️ 注意:该功能只额外用于检索,不改变用户原问题,但会增加响应耗时,按需开启。
开关三:结果重排(Rerank)
用专业重排算法对召回候选重新打分排序,把真正相关的内容前置,提升匹配精准度。
七、检索测试 + 定时同步:省心又好用
检索测试
在知识库配置内「检索测试」页模拟用户提问,直观查看完整返回结果,兼容语义 / 增强两种模式。
上线前必做调参。
定时同步(网页素材)
- 开启后每日自动同步,页面有变化才重新切片向量化,无变化不处理,可节省粒子消耗
- 同步会用最新内容覆盖原数据
- ⚠️ 开启后请勿手动编辑网页类语料
八、选型参考:以硅基边界为例的能力清单
如果正在评估企业知识库方案,可以把以下能力作为参考维度:
| 能力维度 | 说明 |
|---|---|
| 4 合 1 导入 | 文档 / 问答 / 表格 / 网站同库混用,现有资料零改造上车 |
| 解析 + 分段双可控 | 三种解析、三种分段,配合预览核对,把检索质量握在手里 |
| 检索可调可测 | 语义 / 增强双策略,阈值、条数、查询改写、结果重排一应俱全,还有检索测试兜底 |
| 企业级运维能力 | 引用溯源、未命中转人工、网页定时同步,适合长期运营 |
| 服务支持 | 团队位于成都,本地化沟通成本相对较低,响应速度快 |
写在最后
企业知识库不是"上传文档就能用",核心在于:
- 导入方式要匹配数据形态
- 分段策略要匹配内容结构
- 检索策略要匹配业务场景
建议上线前一定多做检索测试,用真实问题反复调参。
本文以硅基边界知识库为例,相关功能细节可能随版本更新。如需了解最新文档,可搜索"硅基边界技术文档中心";如果你正在规划企业知识库,欢迎在评论区聊聊你准备沉淀哪类资料。
如果这篇对你有帮助,欢迎点赞 / 收藏 / 关注。后续会带来 RAG 与企业智能体更多实战拆解,包括智能体搭建、工作流编排、私有化部署等。
延伸阅读
本文以硅基边界知识库模块为例,更多配置细节(检索策略参数、
分段模式对比、未命中策略)可查阅官方技术文档:
📖 完整技术文档:
docs.gjbjai.com/docs/intro/
官网链接:https://gjbjai.com/
后续计划继续拆解 RAG 检索调优的实测数据、多智能体工作流编排、
私有化部署方案,欢迎关注更新。
如需商务合作,请通过 CSDN 官方私信或个人主页渠道联系。
说明:本文为技术分享,内容基于公开产品功能整理,不构成商业推广。如需商务合作,请通过官方渠道或平台私信联系。
更多推荐

 3
 0
- 0


 已为社区贡献3条内容

所有评论(0)