
Linux学习20-hadoop大数据平台部署
hadoop
简介
由 Apache 基金会开发和维护的一个开源分布式计算框架,最初由 Doug Cutting 于 2006 年基于 Google 发表的三篇经典论文(GFS、MapReduce、BigTable)的思想实现
它解决的核心问题是:如何在廉价的普通服务器上,存储和处理海量数据
Hadoop 由以下四大核心模块组成:
HDFS(Hadoop Distributed File System)
分布式文件系统,负责数据的存储
将大文件切分成固定大小的数据块(默认 128MB),分散存储在多台机器上
每个数据块默认保存 3 个副本,保证高可靠性
采用主从(Master/Slave)架构:
NameNode(主节点):管理文件系统的元数据(目录结构、文件与数据块的映射关系等)
DataNode(从节点):实际存储数据块,并定期向 NameNode 汇报状态
MapReduce
分布式计算框架,负责数据的处理
将计算任务拆分为两个阶段:
Map(映射):将输入数据拆分成键值对,并行处理
Reduce(归约):将 Map 的输出结果进行汇总聚合,得出最终结果
计算逻辑向数据靠拢(数据本地化),减少网络传输开销
YARN(Yet Another Resource Negotiator)
集群资源管理和调度框架
负责给各个应用分配 CPU、内存等资源
核心组件:
ResourceManager:全局资源管理器,负责整个集群的资源分配
NodeManager:单节点资源管理器,负责管理每台机器上的资源
Hadoop Common
公共基础库,提供其他模块依赖的工具类、通用接口和启动脚本
部署
官网下载

之后所有的操作应该是在新建用户中进行的
再配置Java环境

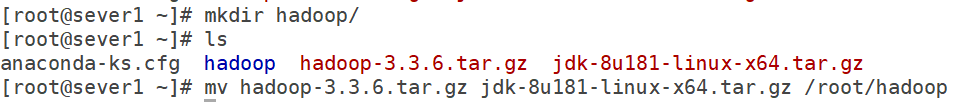
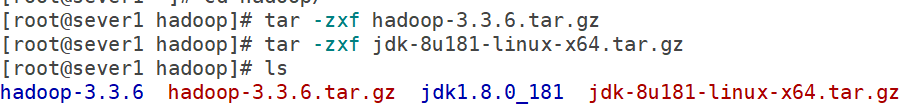
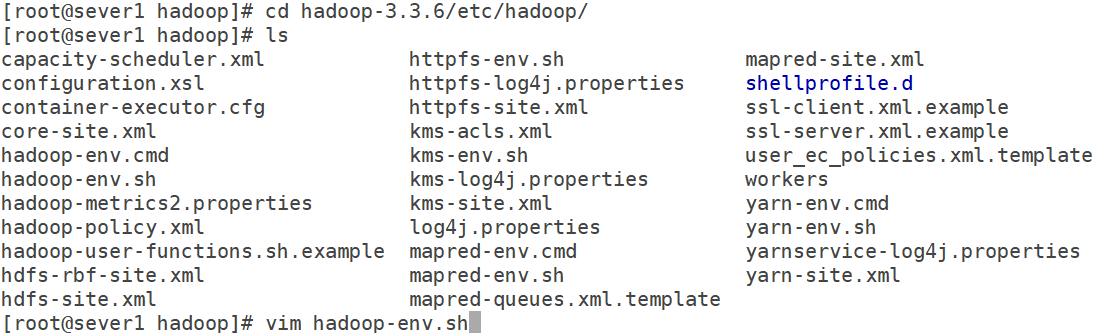
修改Java路径

配置核心配置文件
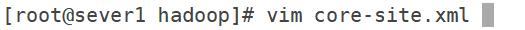
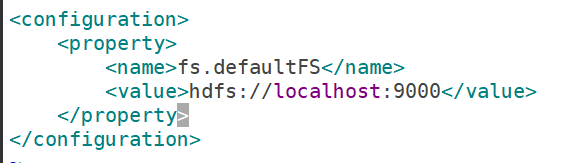
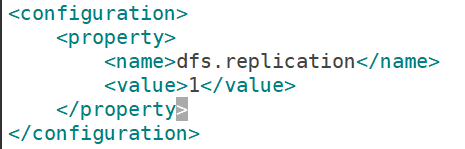
修改副本数
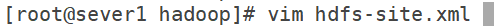
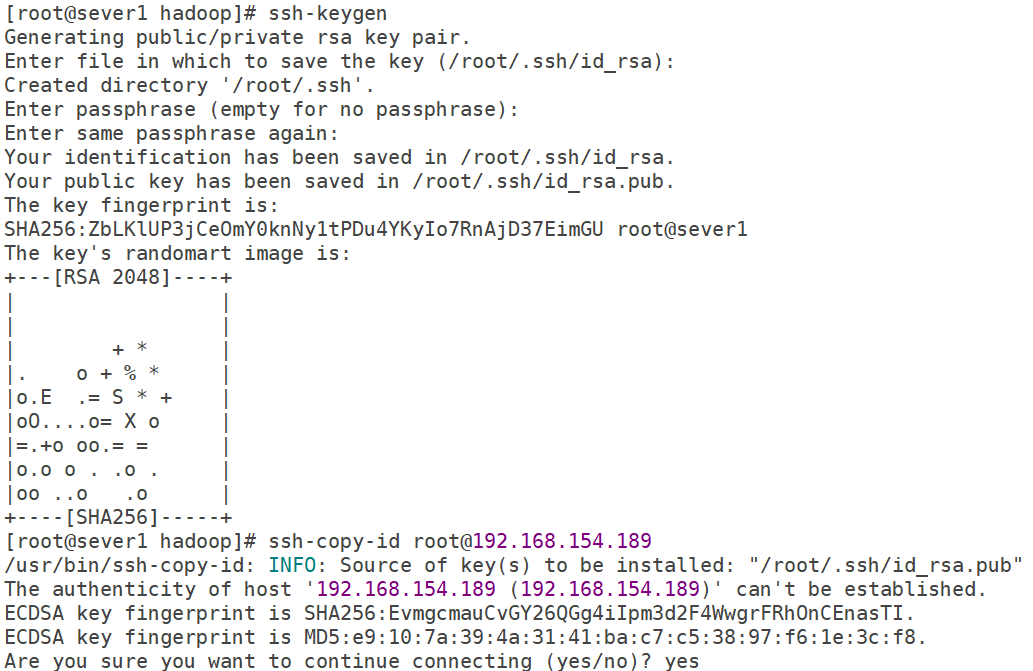
本机做ssh免密
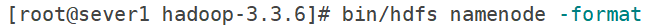
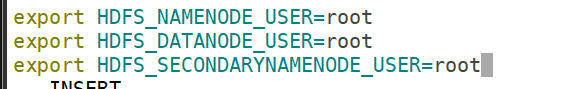
如果要以root身份启动,需要在hadoop-env.sh的末尾添加
启动
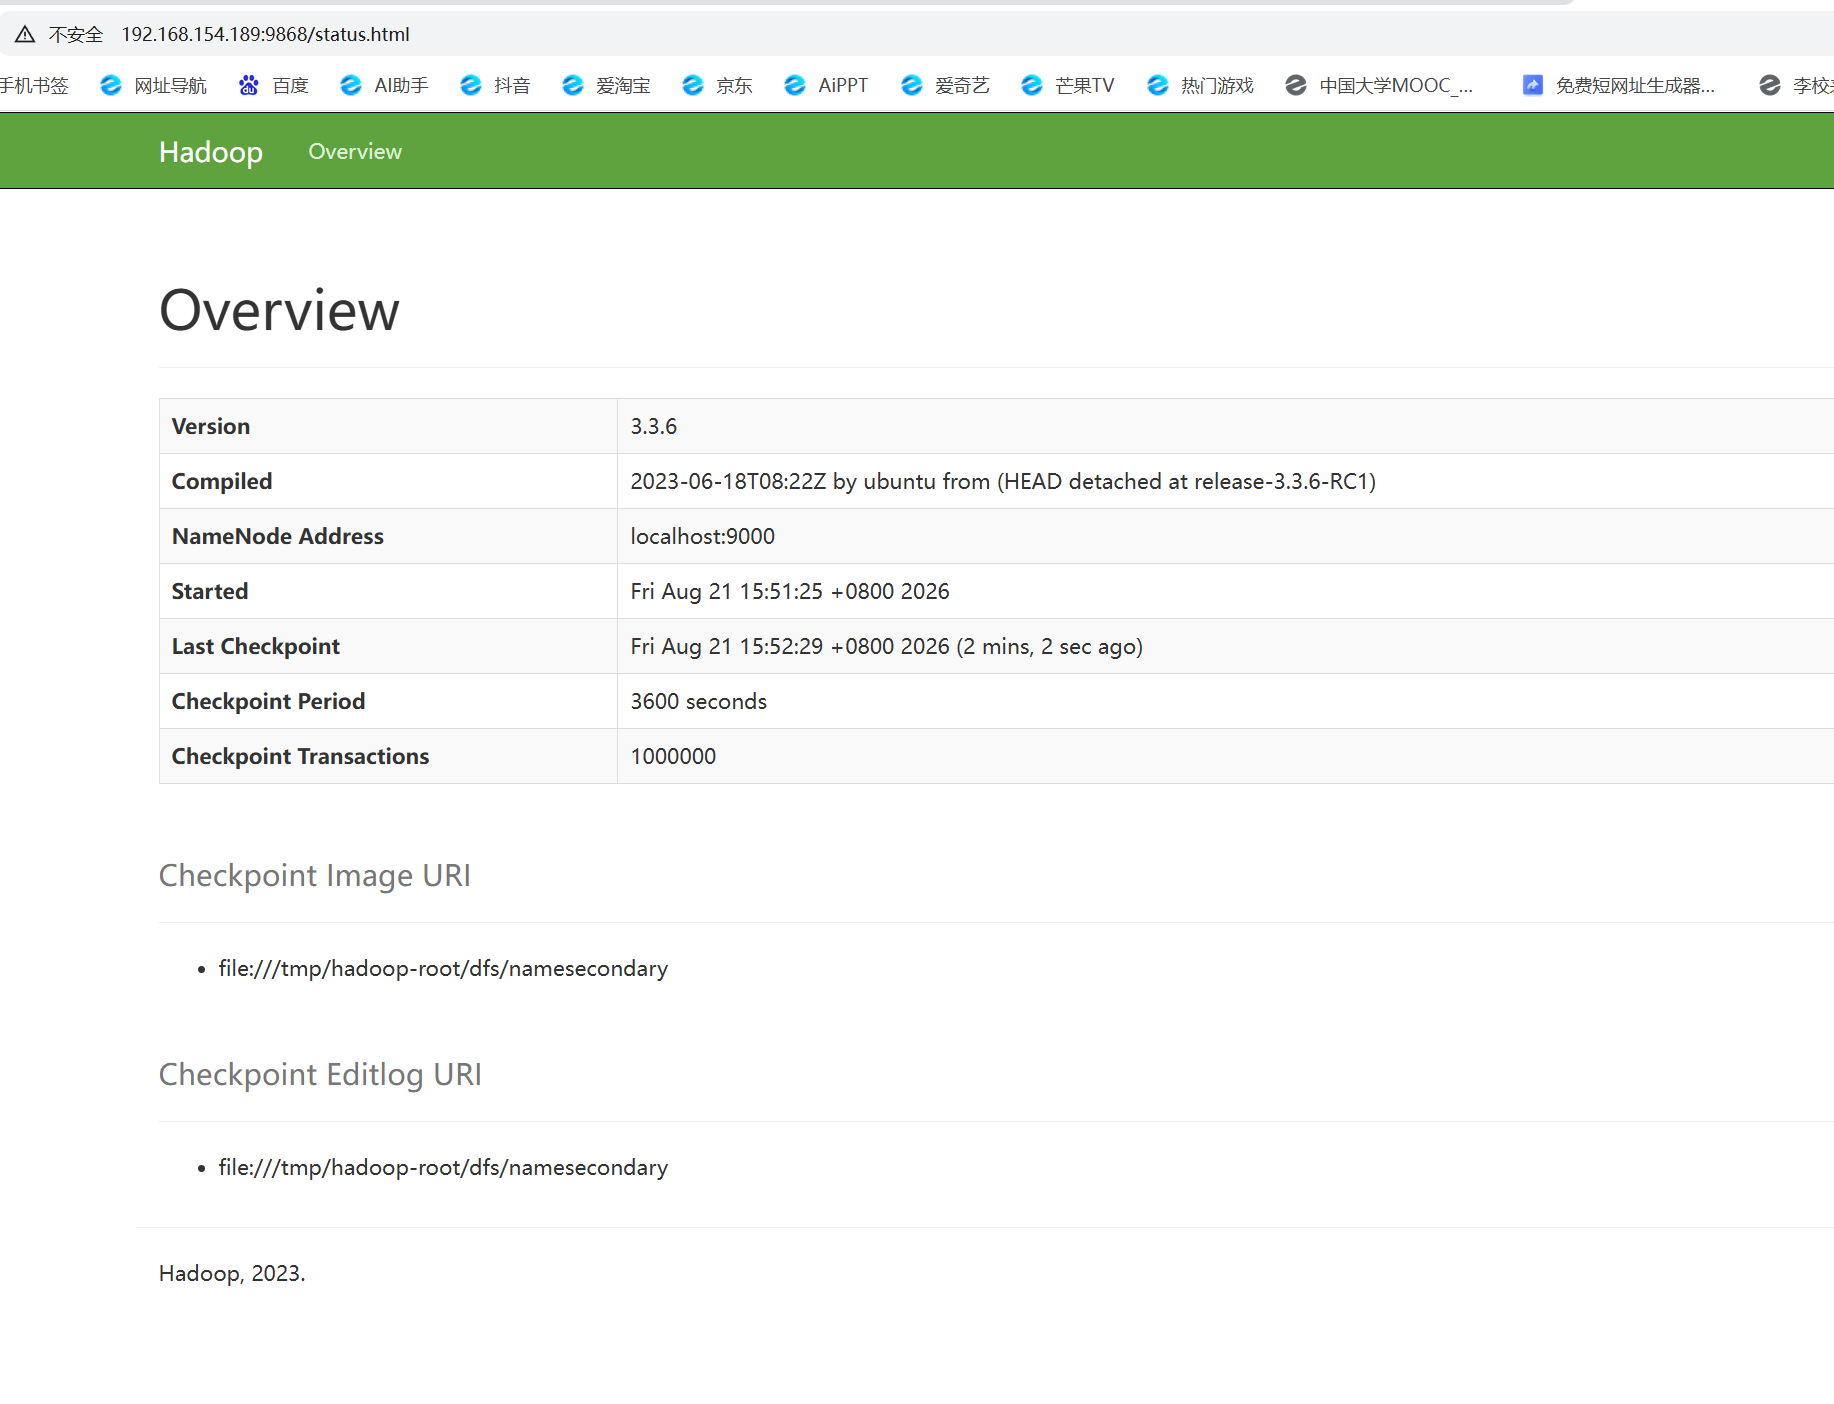
浏览器访问(端口如果9000不正确那么就在9866到9870之间)
创建 HDFS 用户目录
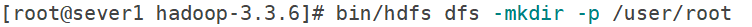
创建 input 目录并上传配置文件

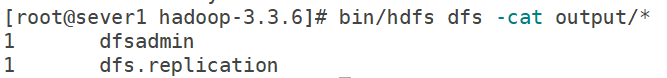
运行自带的 WordCount/Grep 示例

查看结果,成功
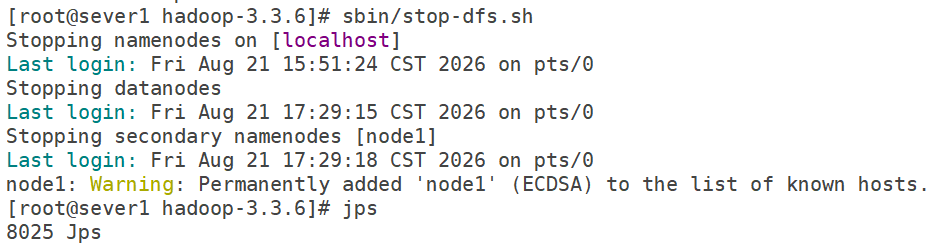
停止服务,查看是否停止成功
分布式文件系统
介绍
HDFS(Hadoop Distributed File System)分布式文件系统,负责数据的存储将大文件切分成固定大小的数据块(默认 128MB),分散存储在多台机器上
每个数据块默认保存 3 个副本,保证高可靠性
采用主从(Master/Slave)架构:
NameNode(主节点):管理文件系统的元数据(目录结构、文件与数据块的映射关系等)
DataNode(从节点):实际存储数据块,并定期向 NameNode 汇报状态
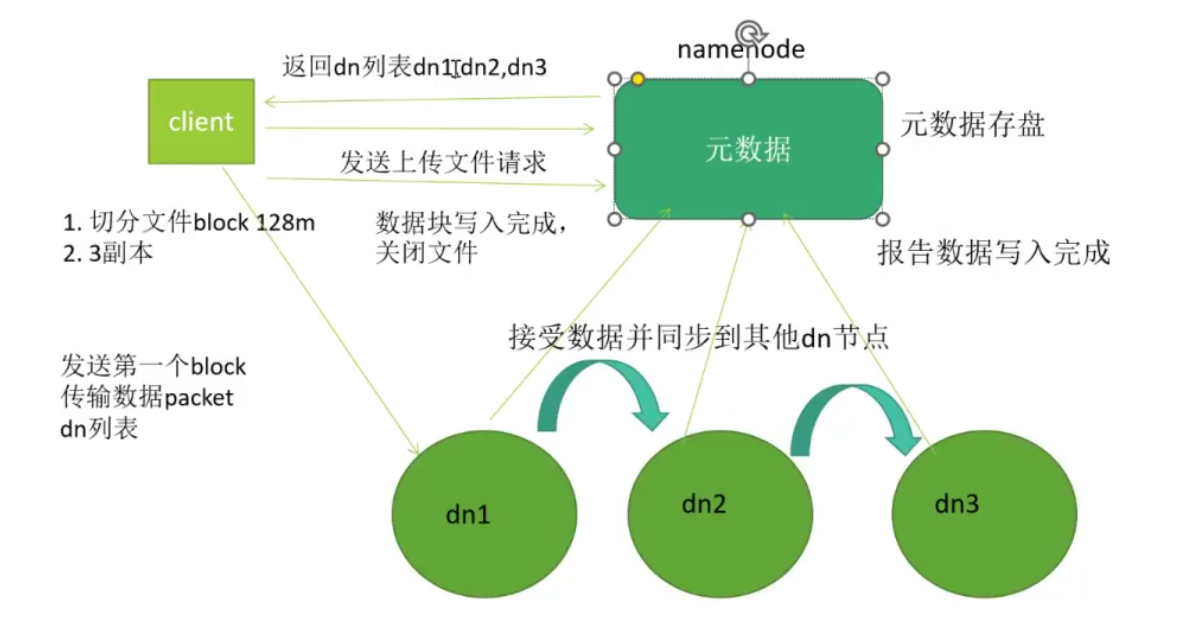
HDFS 写数据流程
1.client 向 NameNode 发送上传文件请求
2.NameNode 检查权限和目录结构后,返回一组 DataNode 列表(dn1、dn2、dn3)
3.client 将文件切分为多个 block(默认 128MB),以 packet 为单位发送第一个 block 到 dn1
4.三个 DataNode 之间形成流水线(Pipeline)复制:dn1 → dn2 → dn3,实现 3 副本存储
5.所有副本写入完成后,逐层向上确认,最终报告给 NameNode
6.NameNode 将元数据持久化存盘
HDFS 机架感知(Rack Awareness)
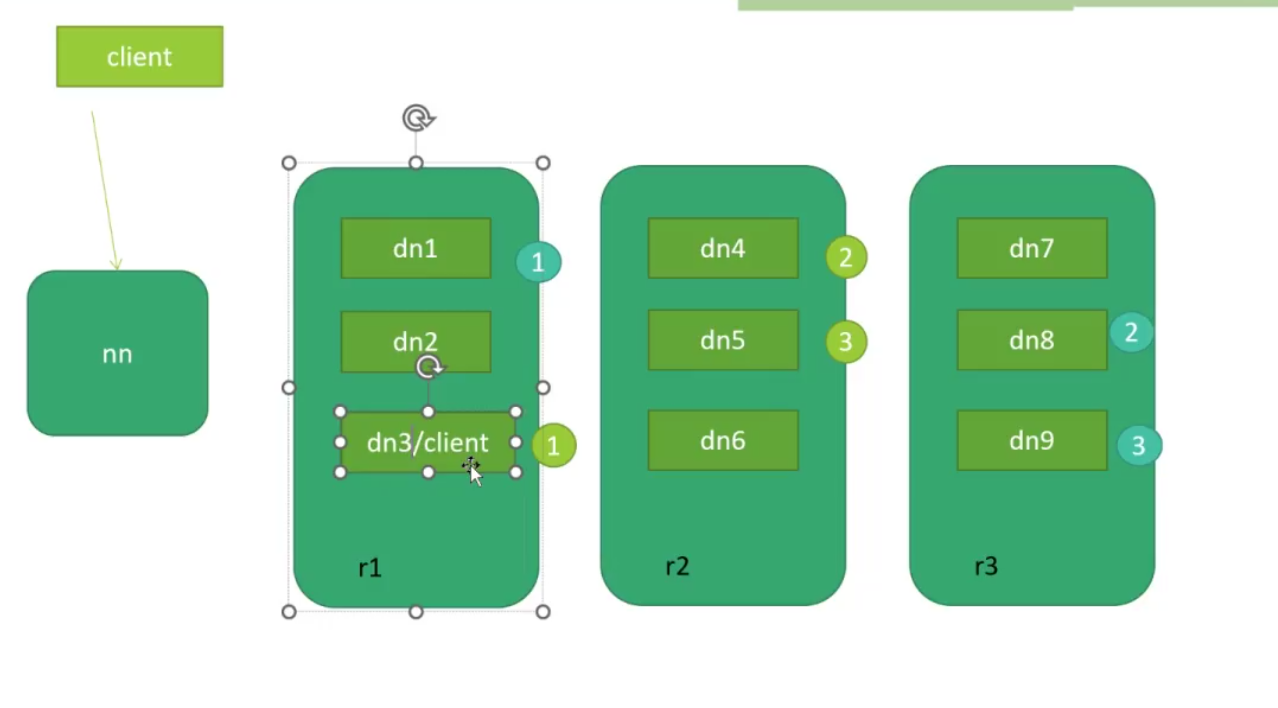
集群分为三个机架 r1、r2、r3
当 client 本身就是 dn3(位于 r1 机架)时,3 副本的放置策略为:
第 1 副本:放在 client 所在节点 dn3(本地写入,减少网络传输)
第 2 副本:放在不同机架 r2 的某个节点上(跨机架容灾)
第 3 副本:放在与第 2 副本相同机架 r2 的另一个节点上(平衡带宽和可靠性)
HDFS 心跳机制与故障检测
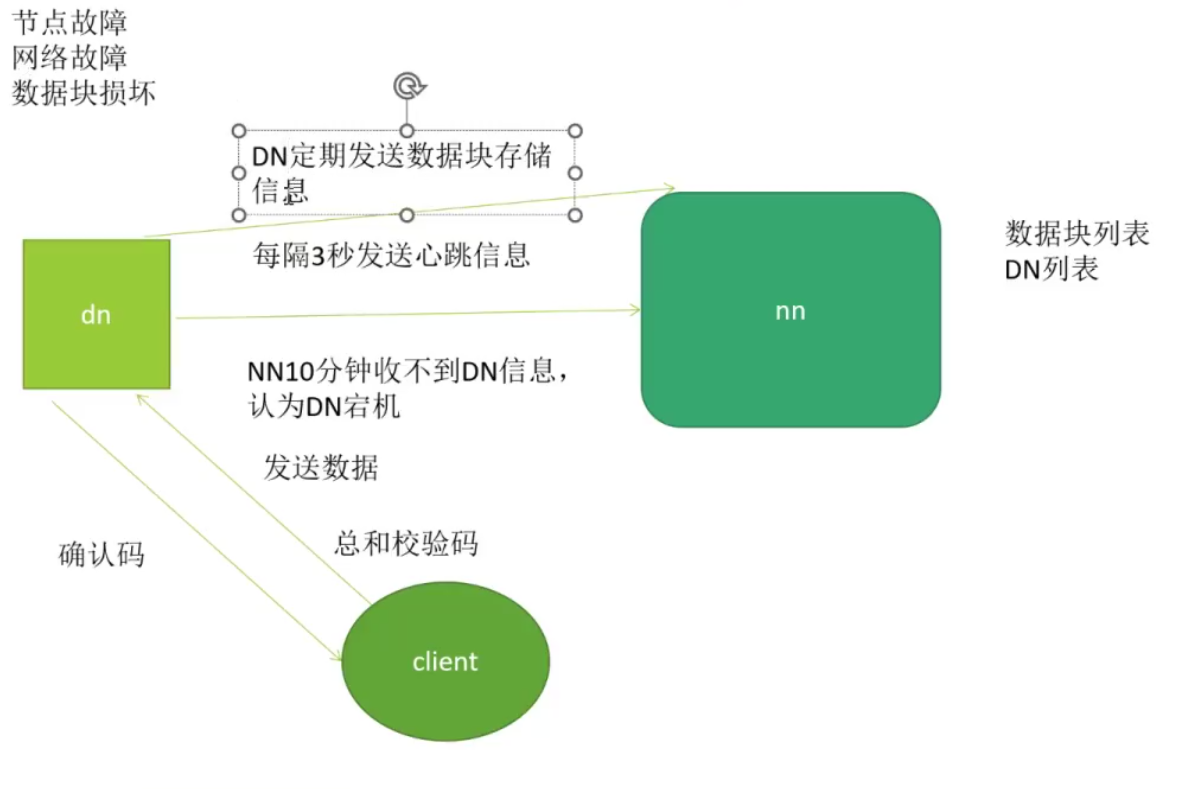
心跳(Heartbeat) DataNode 每隔 3 秒向 NameNode 发送一次心跳
数据块报告(Block Report) DataNode 定期向 NameNode 汇报自己存储了哪些数据块
故障判定 NameNode 10 分钟收不到某 DataNode 的心跳,就判定该节点宕机
数据校验 Client 读取数据时,DataNode 会发送校验和(Checksum),Client 验证后返回确认码
部署流程
新建两台虚拟机,node2,3,做好基础配置
设置共享目录

三台node下载nfs
node1启动nfs
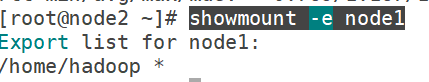
node2,3查看
之后创建挂载点并挂载

配置一下java的路径
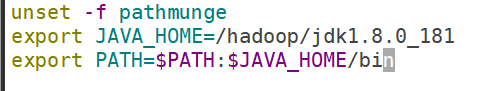
查看到版本号即为成功
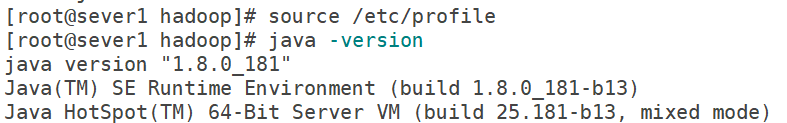
node之间做一下免密
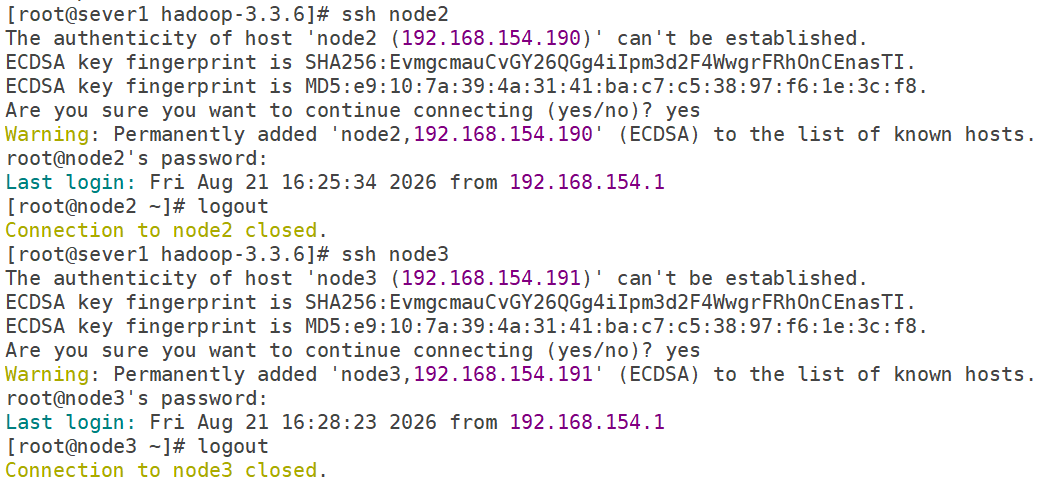
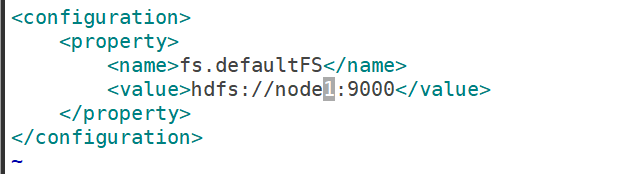
配置 Hadoop 的核心配置文件,用来告知整个集群HDFS(分布式文件系统)的管理员(NameNode)的位置
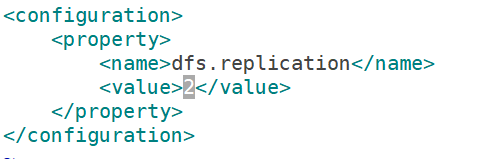
设置 HDFS 的数据备份副本数为2
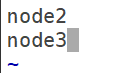
配置 Hadoop 集群的工作节点(DataNode)列表

初始化(格式化)HDFS 的 NameNode 元数据目录,选项选择Y
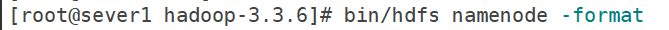
启动整个 HDFS 分布式存储集群
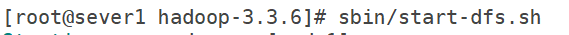
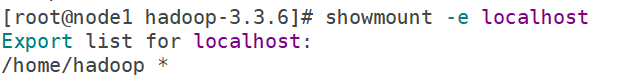
如果在node2,3找不到目录,检查nfs服务是否正常,2,3是否挂载

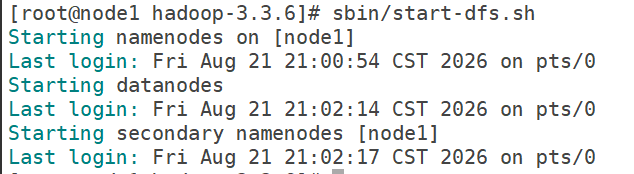
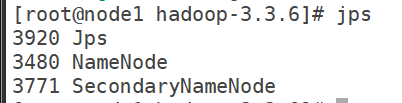
启动成功
查看,node1上是namenode
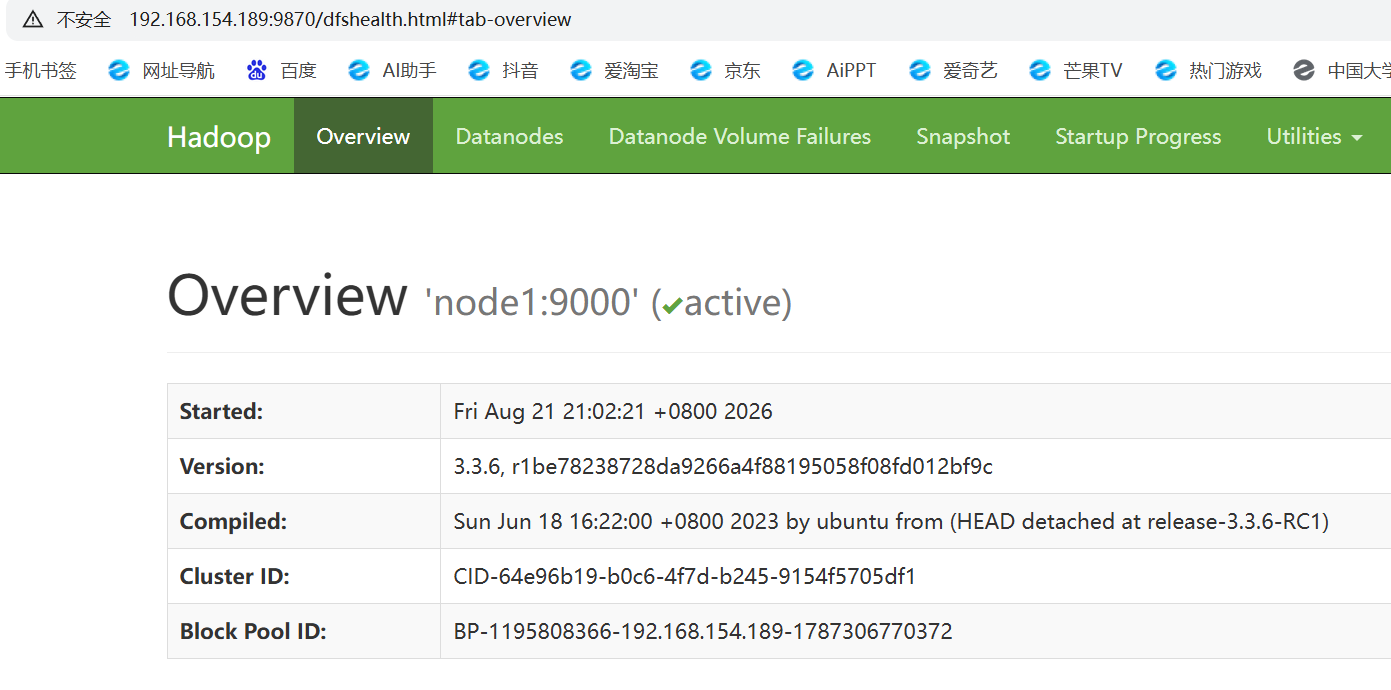
浏览器访问node1的9870端口查看
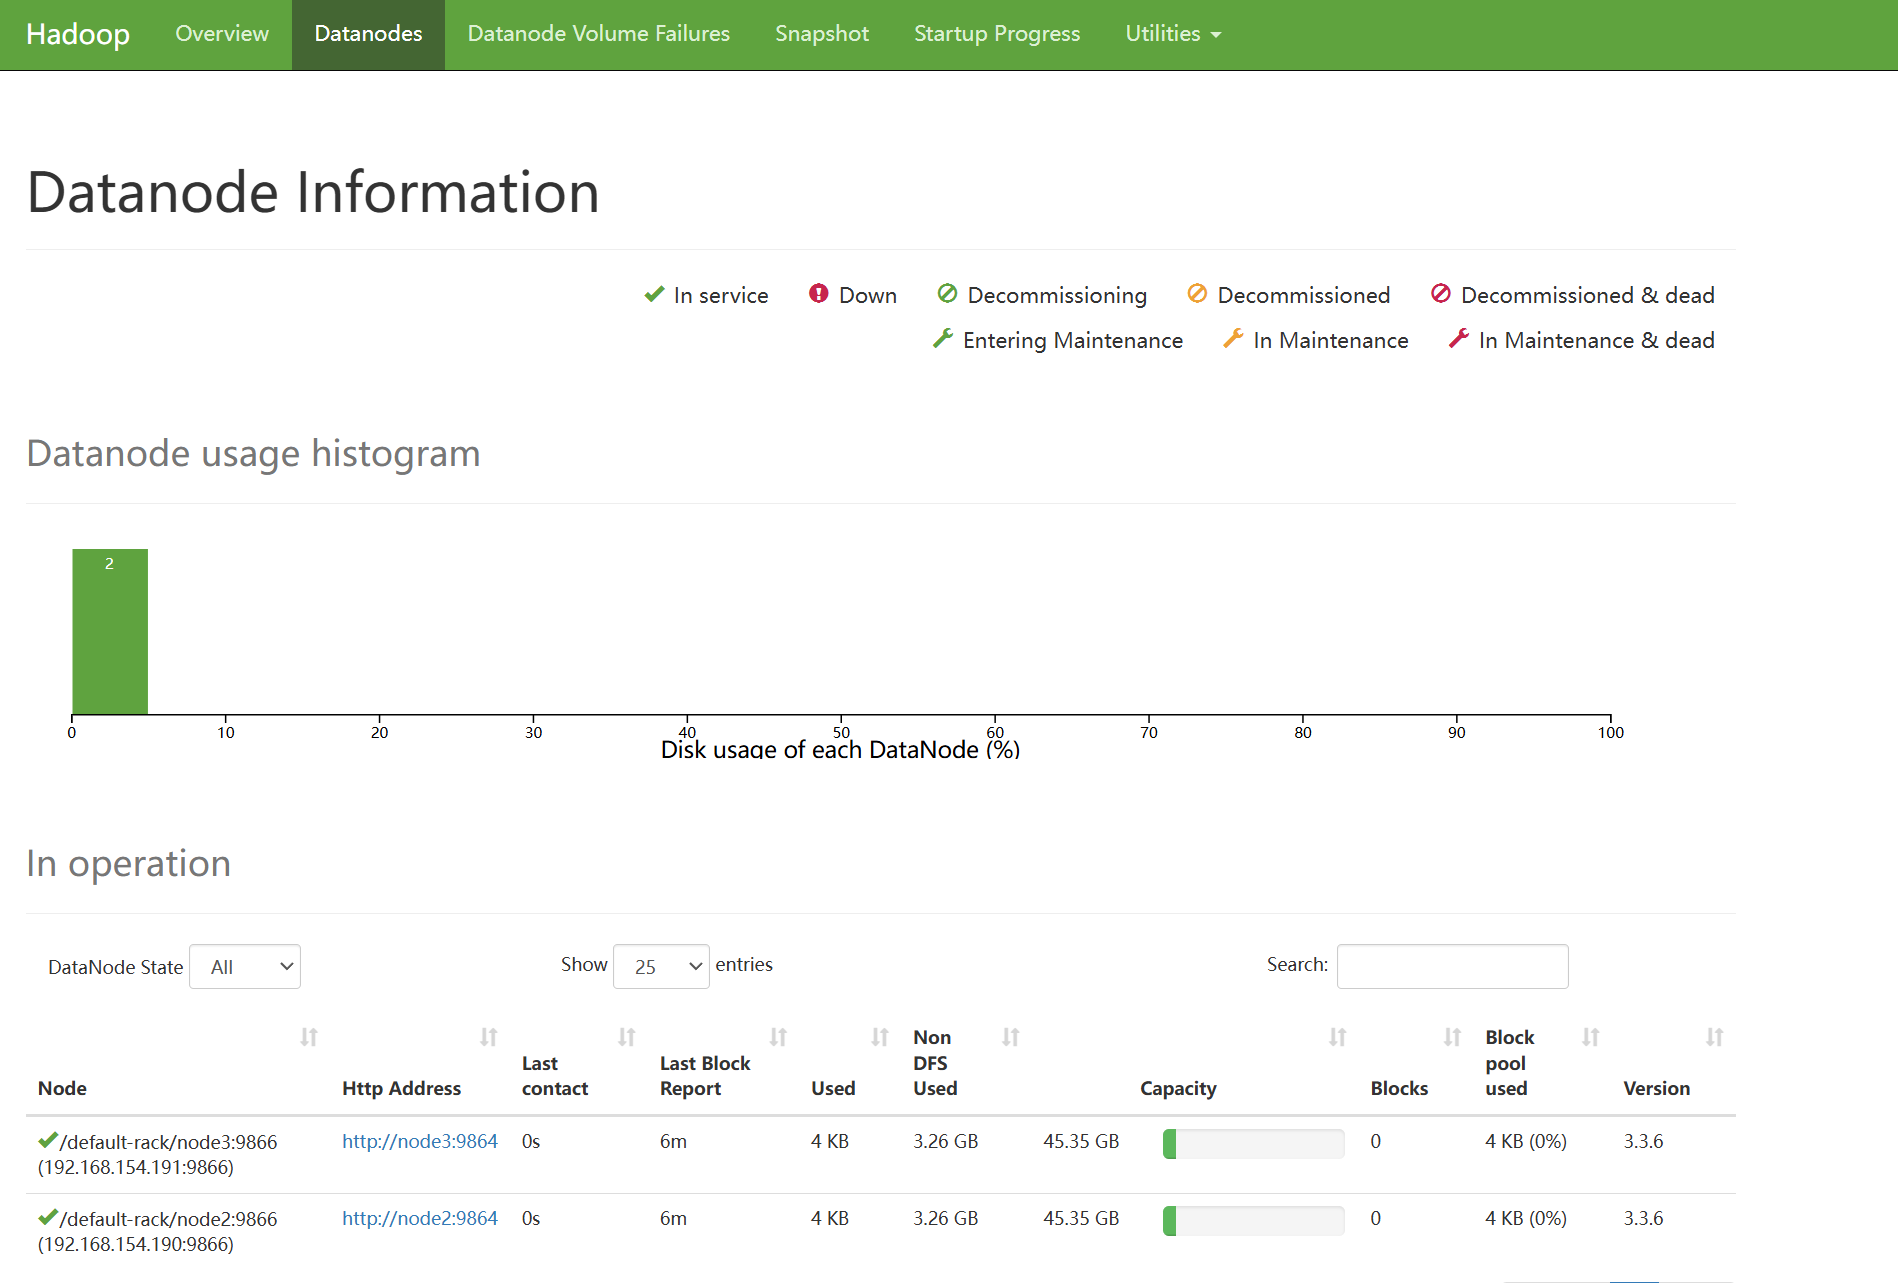
进入datanode下,看到node2,3
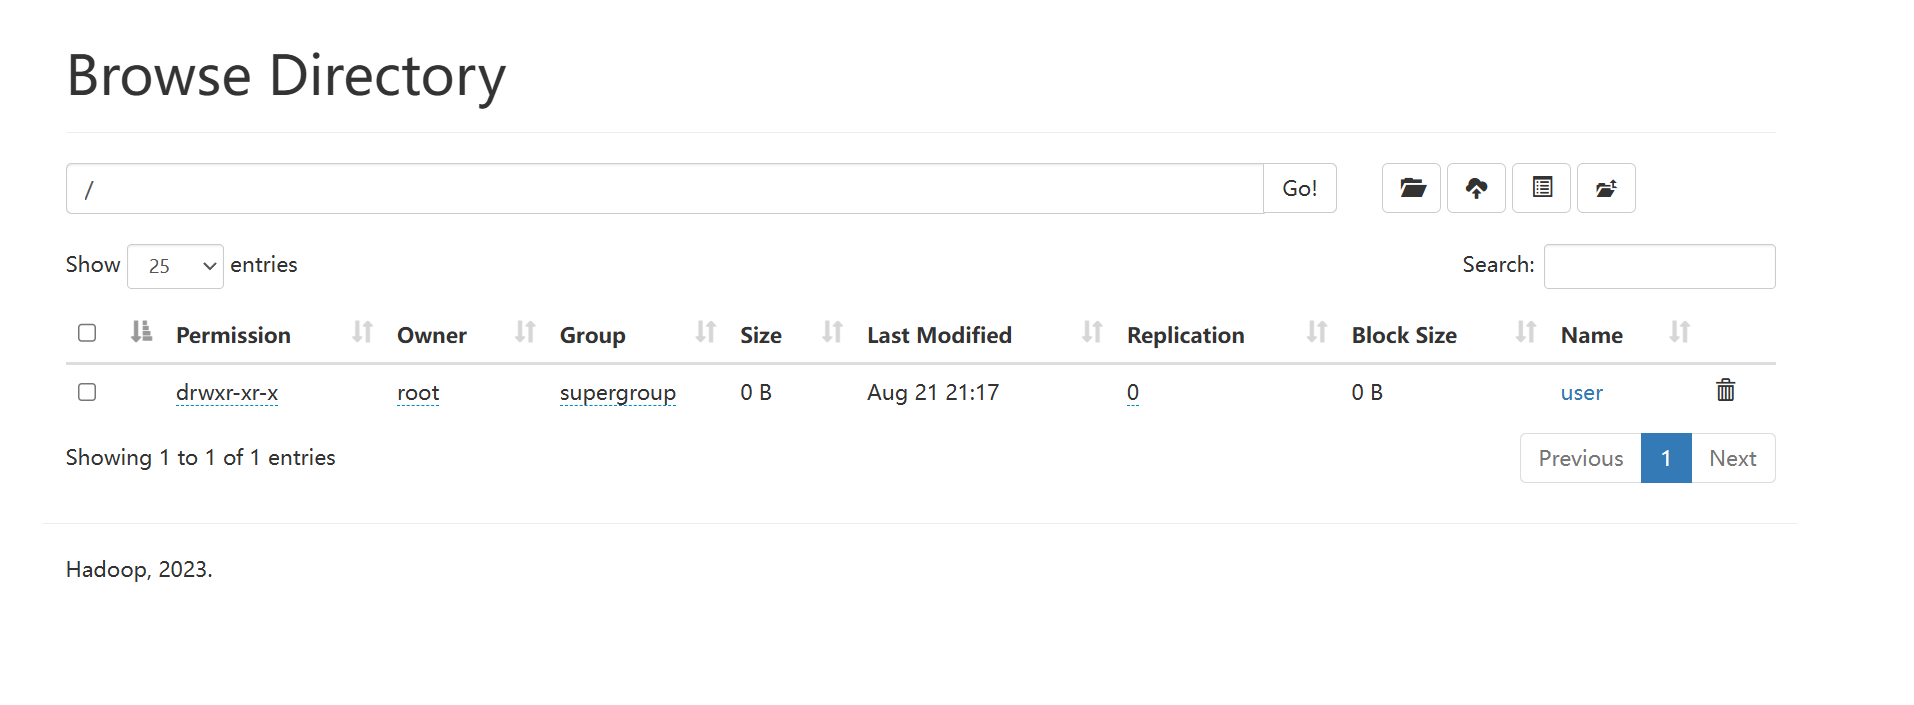
创建用户,上传.xml文件作为测试


浏览器进入utils下的browse directory,可以看到上传的文件
Hadoop MapReduce
介绍
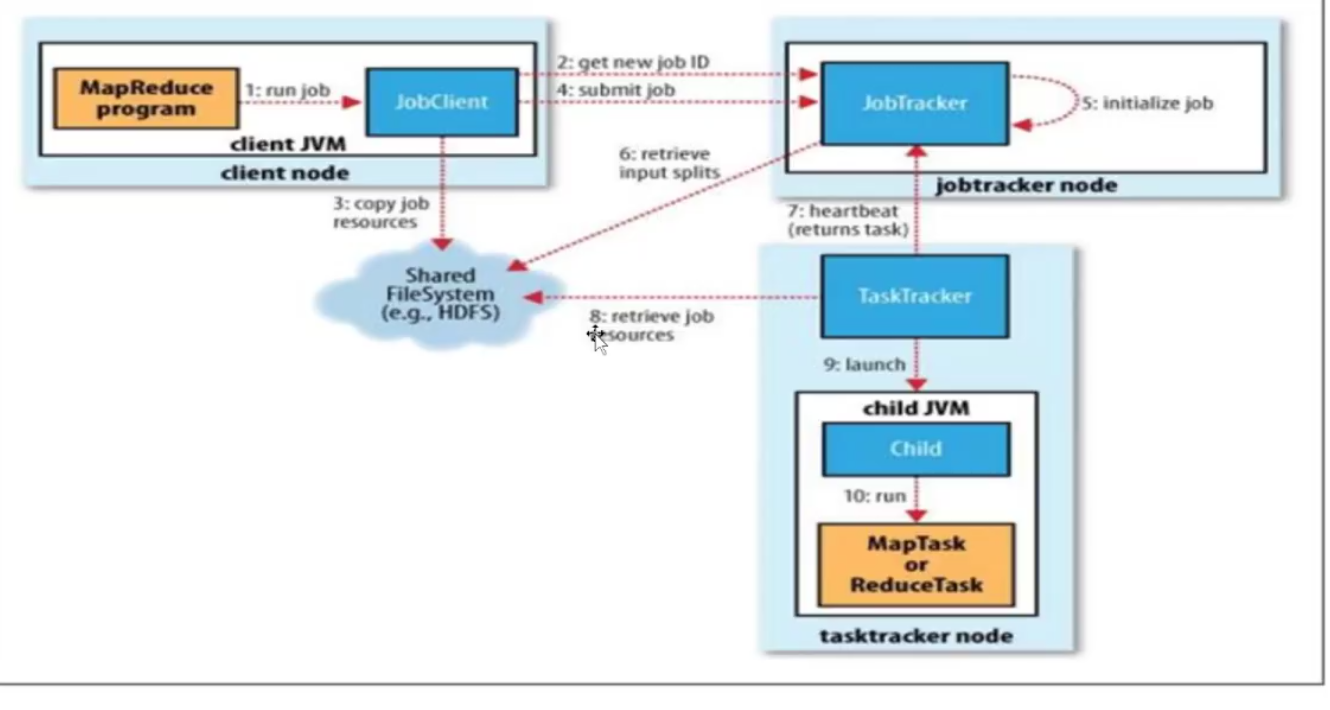
Hadoop 1.x 时代的旧架构(MapReduce v1)
早期的单体架构,核心组件只有两个:
JobTracker 既是资源调度器,又是作业控制器,权力高度集中
TaskTracker 执行具体任务的"工人",定期向 JobTracker 发送心跳
工作流程:
1.客户端运行 MapReduce 程序,向 JobTracker 申请新的 Job ID
2.客户端将作业资源(jar、配置等)拷贝到 HDFS
3.客户端向 JobTracker 提交作业
4.JobTracker 初始化作业,读取 HDFS 上的输入分片(input splits)
5.TaskTracker 通过心跳向 JobTracker 领取任务
6.TaskTracker 启动子 JVM 进程运行 MapTask 或 ReduceTask
核心问题: JobTracker 既是裁判又是运动员,既要管资源调度又要管作业执行,集群规模大了就成瓶颈,且不支持其他计算框架(如 Spark、Flink)接入
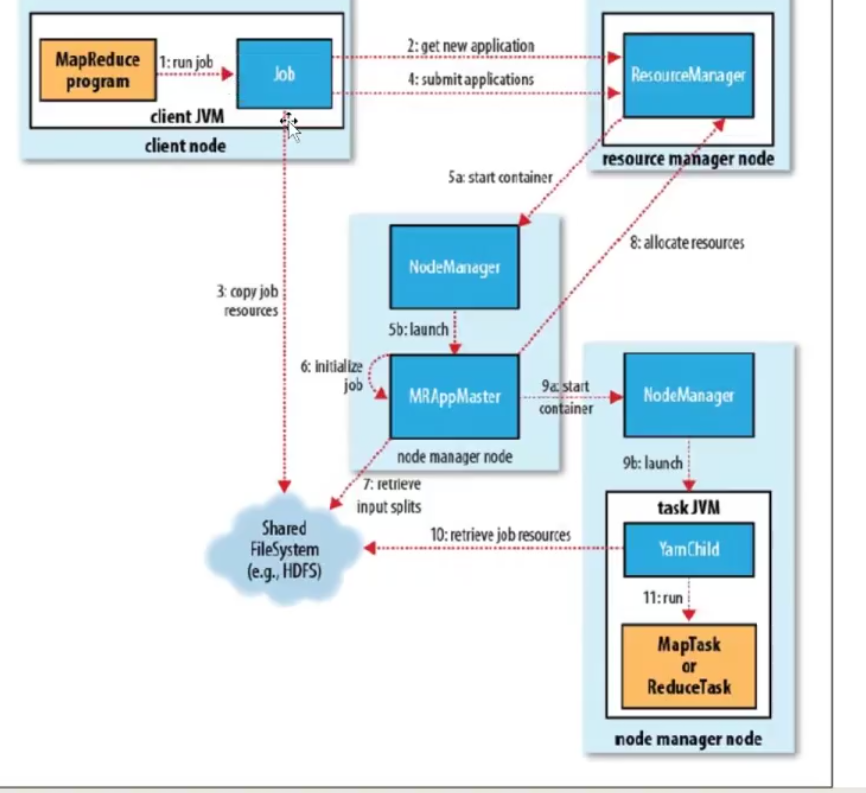
Hadoop 2.x 时代的新架构(MapReduce v2/YARN)
YARN 框架:
ResourceManager(RM) 全局资源管理器,只负责分配资源,不管具体计算
NodeManager(NM) 单节点资源管理器,管理本机的 CPU、内存
MRAppMaster 每个作业专属的"管家",负责向 RM 申请资源、启动和监控任务
工作流程:
1.客户端向 ResourceManager 申请新应用,获取 Application ID
2.客户端将作业资源拷贝到 HDFS
3.客户端向 RM 提交应用
4.RM 在某个 NodeManager 上启动容器,运行 MRAppMaster
5.MRAppMaster 初始化作业,从 HDFS 读取输入分片
6.MRAppMaster 向 RM 申请运行 Task 所需的资源
7.RM 分配资源后,MRAppMaster 通知对应节点的 NodeManager 启动容器
8.NodeManager 启动子 JVM 运行 MapTask 或 ReduceTask
之后会详细介绍yarn
Hadoop YARN
介绍
YARN 采用主从(Master/Slave)架构,由三大核心组件组成:
ResourceManager(RM)
整个集群只有一个,负责全局资源的统一管理和分配
接收客户端提交的作业申请
接收 NodeManager 的心跳汇报,掌握集群资源状况
不关心具体计算逻辑,只管资源
NodeManager(NM)
每个物理节点上运行一个,负责管理本机资源(CPU、内存)
接收 RM 的指令,启动/停止容器(Container)
定期向 RM 发送心跳,汇报节点健康和资源使用情况
ApplicationMaster(AM)
每个作业独享一个,随作业启动而创建,作业结束而销毁
负责向 RM 申请资源、与 NM 协作启动和监控任务
理解具体计算框架的业务逻辑(MapReduce 的 AM 和 Spark 的 AM 是不同的)
Container(容器)
YARN 对资源的抽象封装,包含内存 + CPU + 环境变量
是资源的分配单位,Task 运行在 Container 内部
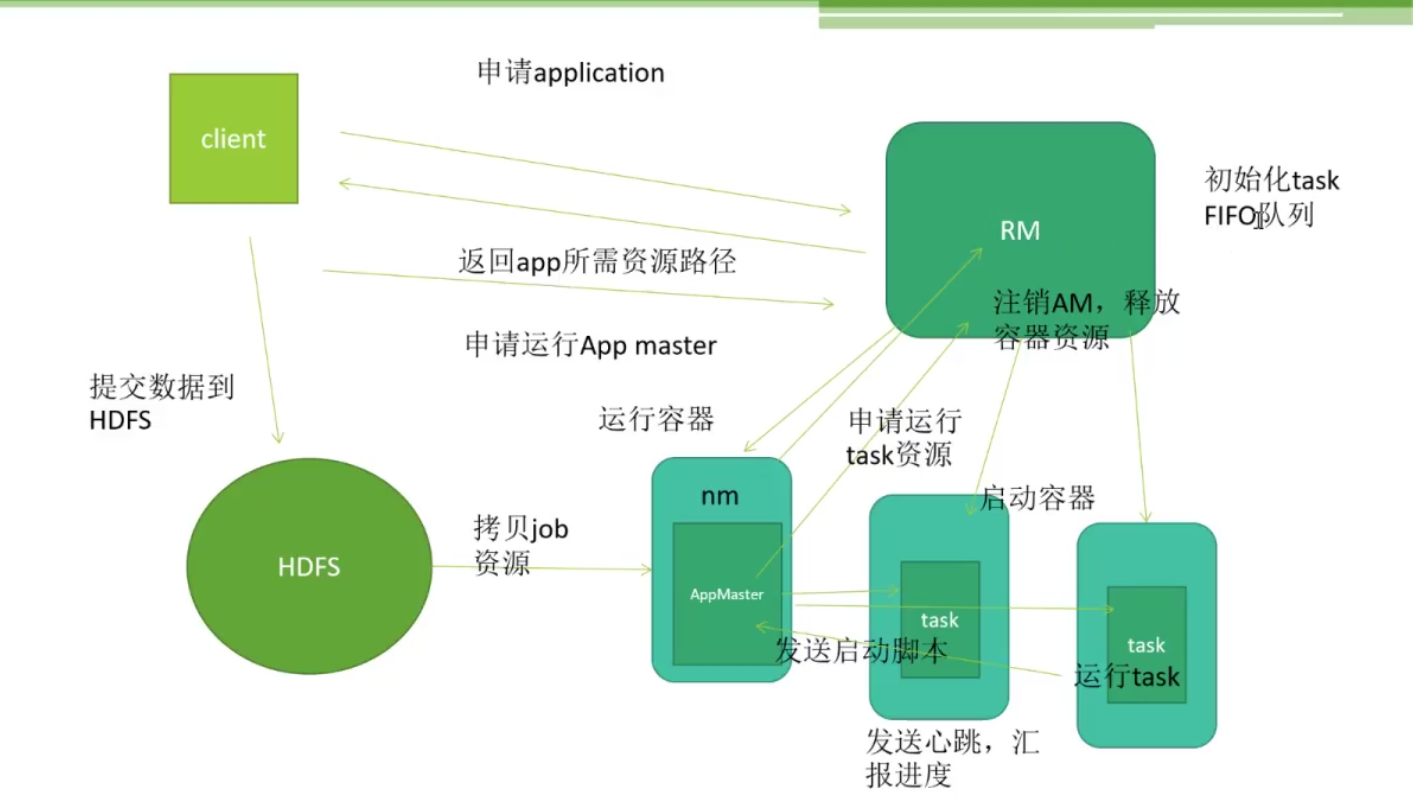
计算作业(Application)的完整工作流程
1. 提交数据 client 把数据上传到 HDFS
2. 申请资源 client 向 RM 申请运行 AppMaster,RM 返回资源路径并分配容器
3. 运行任务 AppMaster 从 HDFS 拷贝作业资源,再向 RM 申请资源来启动各个 task 容器;nm 节点发送心跳汇报进度
4. 清理释放 所有 task 完成后,AppMaster 向 RM 注销并释放容器资源
更多推荐

 4
 0
- 0


 已为社区贡献2条内容

所有评论(0)