
CS336,作业一,GPT-2 XL Transformer 资源开销分析
GPT-2 XL Transformer 资源开销分析
题目:
模型算力与参数量统计(资源核算)
矩阵乘法算力公式:矩阵 A(m×n)⋅B(n×p)A(m\times n)\cdot B(n\times p)A(m×n)⋅B(n×p),总浮点运算量
FLOPs=2mnp\boldsymbol{\text{FLOPs}=2mnp}FLOPs=2mnp
习题(transformer_accounting):Transformer资源开销计算(5分)
给定GPT‑2‑XL配置:词汇量50257、上下文长度1024、层数48、dmodel=1600\boldsymbol{d_\text{model}=1600}dmodel=1600、头数25、dff=4288\boldsymbol{d_\text{ff}=4288}dff=4288(a) 计算总可训练参数量;FP32精度存储模型权重需要多少内存?
(b) 罗列前向传播所有矩阵乘法,计算总FLOPs
© 模型哪一部分算力消耗最高?
(d) 依次计算GPT2 Small/Medium/Large三套尺寸的算力占比;分析模型扩容时各模块算力占比变化趋势
(e) 将上下文长度提升至16384,总算力与各模块占比如何改变?
统一假设
- batch size = 1
- 只统计矩阵乘法 FLOPs
- 使用 RoPE + SwiGLU
- 无 bias
- embedding 和 LM Head 参数共享,但前向仍要计算 LM Head 矩阵乘法
- 矩阵乘法 (m×n)(n×p)(m\times n)(n\times p)(m×n)(n×p) 的 FLOPs 取 2mnp2mnp2mnp
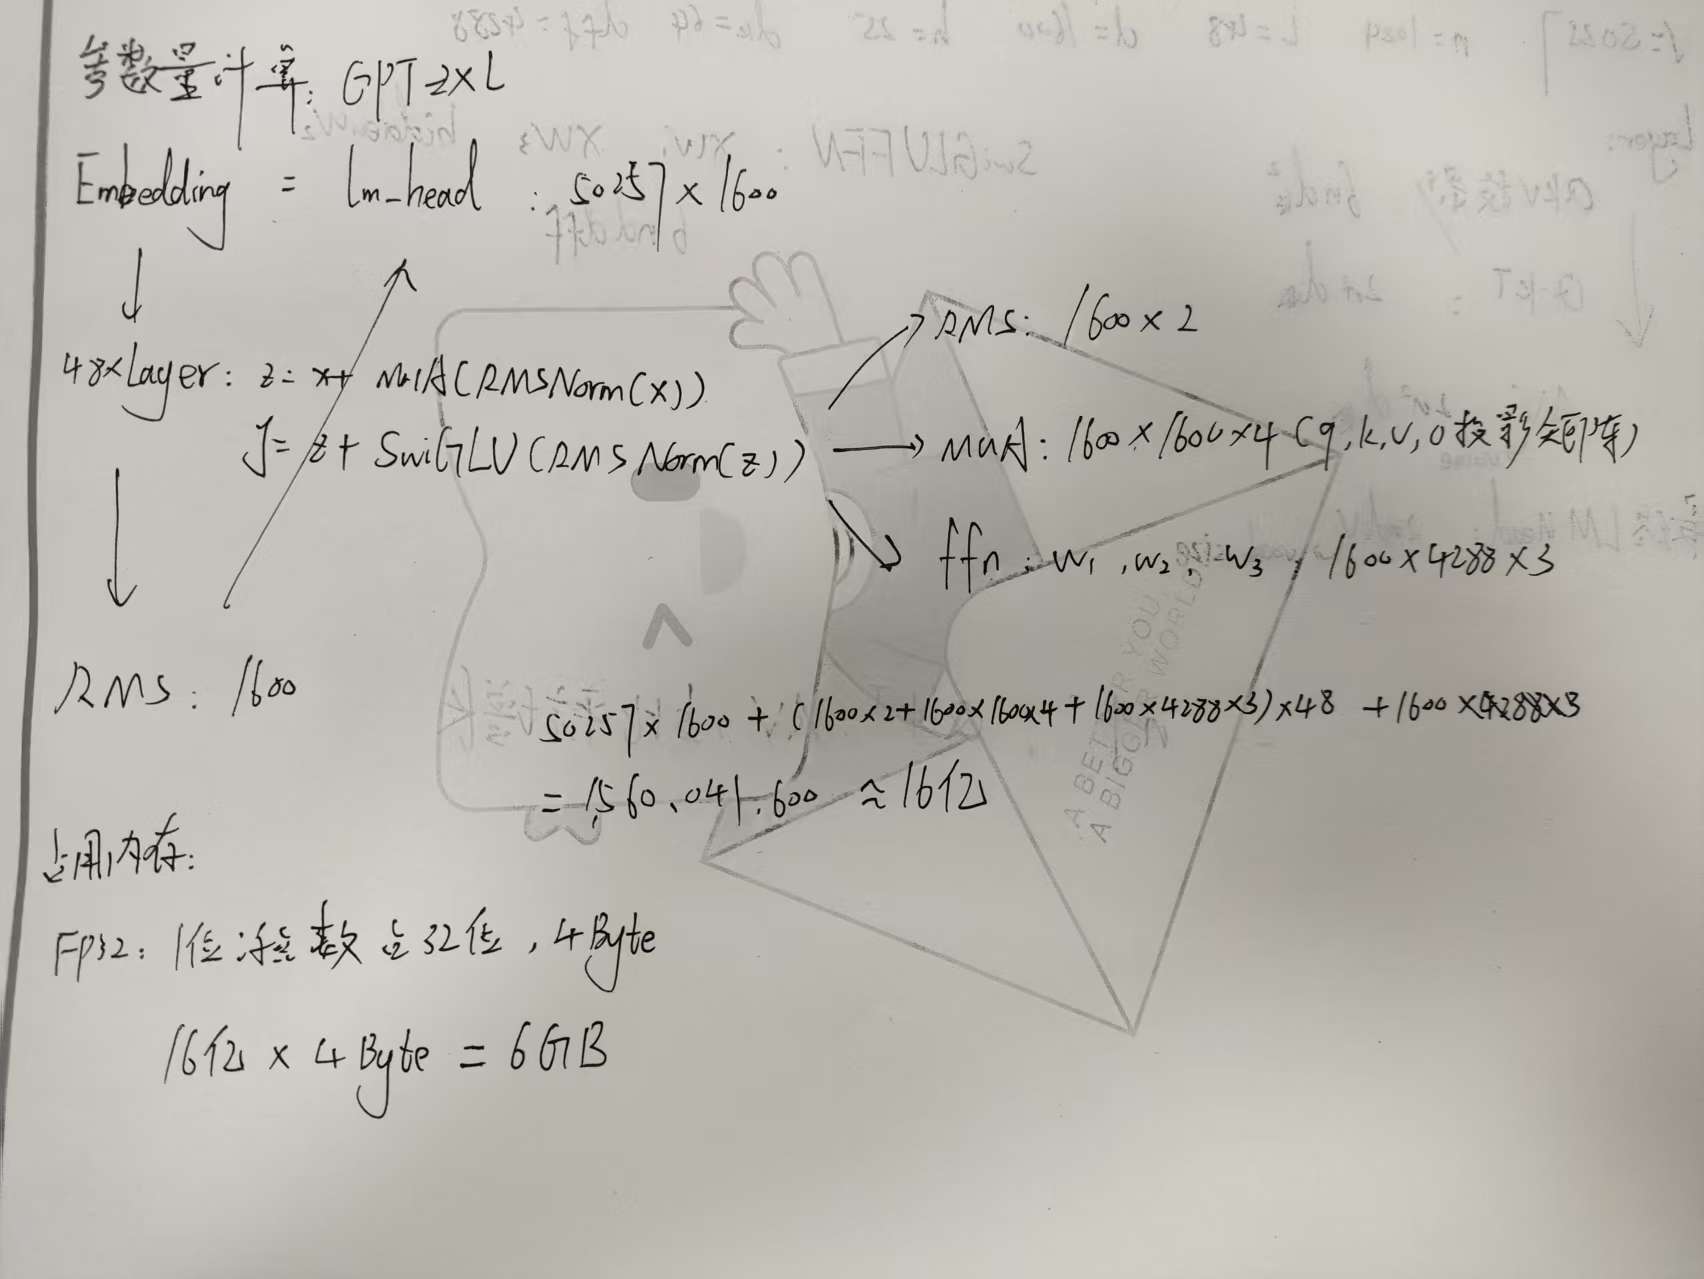
(a) 参数量与 FP32 存储
GPT-2 XL 配置:
V=50257,n=1024,L=48,d=1600,h=25,dff=4288 V=50257,\quad n=1024,\quad L=48,\quad d=1600,\quad h=25,\quad d_{ff}=4288 V=50257,n=1024,L=48,d=1600,h=25,dff=4288
单层参数来源
| 模块 | 参数形式 | 参数量 |
|---|---|---|
| QKV 投影 | 3×d×d3\times d\times d3×d×d | 7,680,000 |
| 输出投影 | d×dd\times dd×d | 2,560,000 |
| SwiGLU FFN | 3×d×dff3\times d\times d_{ff}3×d×dff | 20,582,400 |
| 两个 RMSNorm | 2×d2\times d2×d | 3,200 |
所以单层参数量:
Pblock=4d2+3ddff+2d=30,825,600 P_{\text{block}}=4d^2+3dd_{ff}+2d=30,825,600 Pblock=4d2+3ddff+2d=30,825,600
48 层参数量:
48Pblock=1,479,628,800 48P_{\text{block}}=1,479,628,800 48Pblock=1,479,628,800
共享 embedding / LM Head 参数:
Pemb=Vd=50257×1600=80,411,200 P_{\text{emb}}=Vd=50257\times1600=80,411,200 Pemb=Vd=50257×1600=80,411,200
最终 RMSNorm 参数:
Pfinal norm=1600 P_{\text{final norm}}=1600 Pfinal norm=1600
总参数量:
P=1,479,628,800+80,411,200+1600=1,560,041,600 P=1,479,628,800+80,411,200+1600=1,560,041,600 P=1,479,628,800+80,411,200+1600=1,560,041,600
即约 1.56B 参数。
FP32 存储:
1,560,041,600×4=6,240,166,400 bytes 1,560,041,600\times4=6,240,166,400\text{ bytes} 1,560,041,600×4=6,240,166,400 bytes
约 6.24 GB,即 5.81 GiB。
(b) 前向传播矩阵乘法 FLOPs
单层 Transformer block
| 模块 | 矩阵乘法 | FLOPs |
|---|---|---|
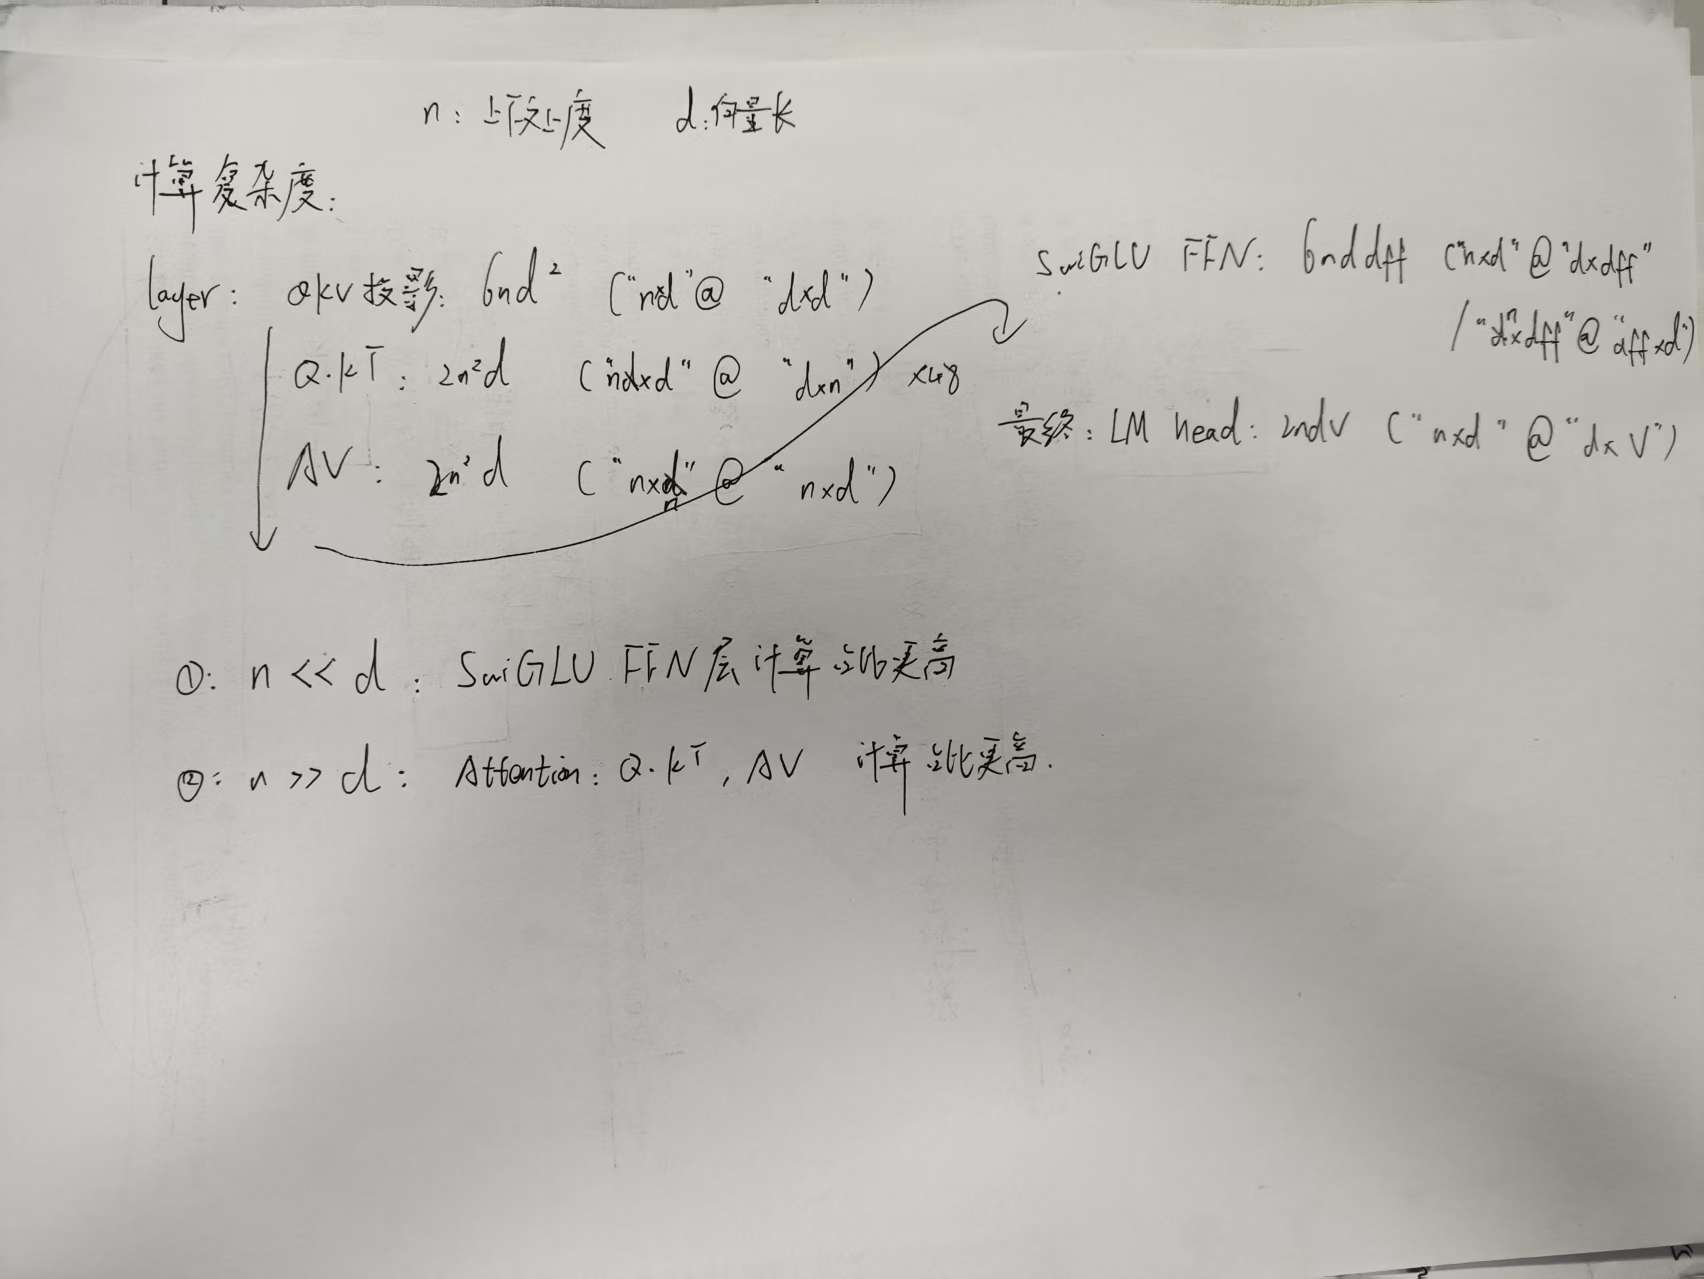
| QKV 投影 | X(n×d)WQKV(d×3d)X(n\times d)W_{QKV}(d\times 3d)X(n×d)WQKV(d×3d) | 6nd26nd^26nd2 |
| QK⊤QK^\topQK⊤ | 每头 (n×dk)(dk×n)(n\times d_k)(d_k\times n)(n×dk)(dk×n) | 2n2d2n^2d2n2d |
| AVAVAV | 每头 (n×n)(n×dk)(n\times n)(n\times d_k)(n×n)(n×dk) | 2n2d2n^2d2n2d |
| 输出投影 | (n×d)(d×d)(n\times d)(d\times d)(n×d)(d×d) | 2nd22nd^22nd2 |
| SwiGLU FFN | (n×d)(d×dff)(n\times d)(d\times d_{ff})(n×d)(d×dff) 三次 | 6nddff6ndd_{ff}6nddff |
因此单层总 FLOPs:
Fblock=6nd2+4n2d+6nddff F_{\text{block}}=6nd^2+4n^2d+6ndd_{ff} Fblock=6nd2+4n2d+6nddff
代入 GPT-2 XL:
- QKV 投影:15.73 GFLOPs
- QK⊤QK^\topQK⊤:3.36 GFLOPs
- AVAVAV:3.36 GFLOPs
- 输出投影:5.24 GFLOPs
- SwiGLU FFN:42.15 GFLOPs
单层合计:
69.84 GFLOPs 69.84\text{ GFLOPs} 69.84 GFLOPs
48 层:
48×69.84=3352.09 GFLOPs=3.35 TFLOPs 48\times69.84=3352.09\text{ GFLOPs}=3.35\text{ TFLOPs} 48×69.84=3352.09 GFLOPs=3.35 TFLOPs
最终 LM Head:
H(n×d)Wlm(d×V)→(n×V) H(n\times d)W_{\text{lm}}(d\times V)\rightarrow(n\times V) H(n×d)Wlm(d×V)→(n×V)
FLM Head=2ndV=164.68 GFLOPs F_{\text{LM Head}}=2ndV=164.68\text{ GFLOPs} FLM Head=2ndV=164.68 GFLOPs
总前向矩阵乘法 FLOPs:
3.35+0.165=3.52 TFLOPs 3.35+0.165=3.52\text{ TFLOPs} 3.35+0.165=3.52 TFLOPs
© 算力消耗最高部分
在 n=1024n=1024n=1024 时,最高的是 SwiGLU FFN。
48 层 FFN 总算力:
48×42.15=2023.33 GFLOPs 48\times42.15=2023.33\text{ GFLOPs} 48×42.15=2023.33 GFLOPs
占总前向矩阵乘法约:
57.53% 57.53\% 57.53%
所以短上下文下主要瓶颈是 FFN。
(d) GPT-2 Small / Medium / Large 占比
这里按同一 SwiGLU 口径估算,仅看趋势对比。
模型配置
| 模型 | 层数 L | d_model | d_ff | 总 FLOPs |
|---|---|---|---|---|
| Small | 12 | 768 | 2048 | 291.65 GFLOPs |
| Medium | 24 | 1024 | 2752 | 830.17 GFLOPs |
| Large | 36 | 1280 | 3456 | 1786.65 GFLOPs |
各模块占比
| 模型 | QKV | QK^T | AV | 输出投影 | SwiGLU | LM Head |
|---|---|---|---|---|---|---|
| Small | 14.91% | 6.63% | 6.63% | 4.97% | 39.76% | 27.10% |
| Medium | 18.62% | 6.21% | 6.21% | 6.21% | 50.05% | 12.70% |
| Large | 20.28% | 5.41% | 5.41% | 6.76% | 54.76% | 7.37% |
趋势分析
- 模型变大时,SwiGLU 占比上升。
- LM Head 只做一次,所以占比明显下降。
- 序列长度固定时,QK⊤QK^\topQK⊤ 和 AVAVAV 是 O(n2d)O(n^2d)O(n2d),而投影和 FFN 是 O(nd2)O(nd^2)O(nd2),所以随着 ddd 增大,矩阵投影和 FFN 更占主导。
(e) 上下文长度提升到 16384
令:
n=16384 n=16384 n=16384
GPT-2 XL 总 FLOPs:
F≈133.58 TFLOPs F\approx133.58\text{ TFLOPs} F≈133.58 TFLOPs
相比 n=1024n=1024n=1024 的 3.52 TFLOPs3.52\text{ TFLOPs}3.52 TFLOPs,增长约:
38.0× 38.0\times 38.0×
各模块占比
| 模块 | FLOPs | 占比 |
|---|---|---|
| QKV 投影 | 12.08 TFLOPs | 9.04% |
| QK^T | 41.23 TFLOPs | 30.87% |
| AV | 41.23 TFLOPs | 30.87% |
| 输出投影 | 4.03 TFLOPs | 3.01% |
| SwiGLU FFN | 32.37 TFLOPs | 24.24% |
| LM Head | 2.63 TFLOPs | 1.97% |
结论
- 长度提升 16 倍,但总算力提升约 38 倍。
- 原因是 attention 中 QK⊤QK^\topQK⊤ 和 AVAVAV 是 O(n2d)O(n^2d)O(n2d)。
- 长上下文下,主要瓶颈从 FFN 转为 attention 的二次项。
- QK⊤+AVQK^\top + AVQK⊤+AV 合计占比约 61.73%。
更多推荐


 6
 0
- 0


 已为社区贡献10条内容

所有评论(0)