
Hadoop 分布式集群实战 1—— 集群搭建与在线扩容
1 简介
Apache Hadoop 是开源分布式存储 + 分布式计算大数据框架,核心由 HDFS、YARN、MapReduce 三大组件构成,面向海量离线批处理场景,适合 TB/PB 级 “一次写入、多次读取” 的数据处理。
1.HDFS(分布式文件系统):NameNode 管理元数据,DataNode 存放真实数据。
- NameNode(NN,管理节点)
保存元数据:目录树、文件名、权限、文件与 Block 映射;不存储真实业务数据。
单点版本存在单点故障;HA 模式搭配 Standby NameNode、ZKFC、JournalNode 实现故障自动切换Apache Had…。 - DataNode(DN,工作节点)
存放切分后的真实数据块 Block(默认 128MB);定期上报心跳与块信息,执行读写、副本复制。 - Client 客户端
先访问 NameNode 获取元数据,直接和 DataNode 传输真实数据。 - SecondaryNameNode
辅助做元数据合并、Checkpoint,不能热切换顶替 NameNode。
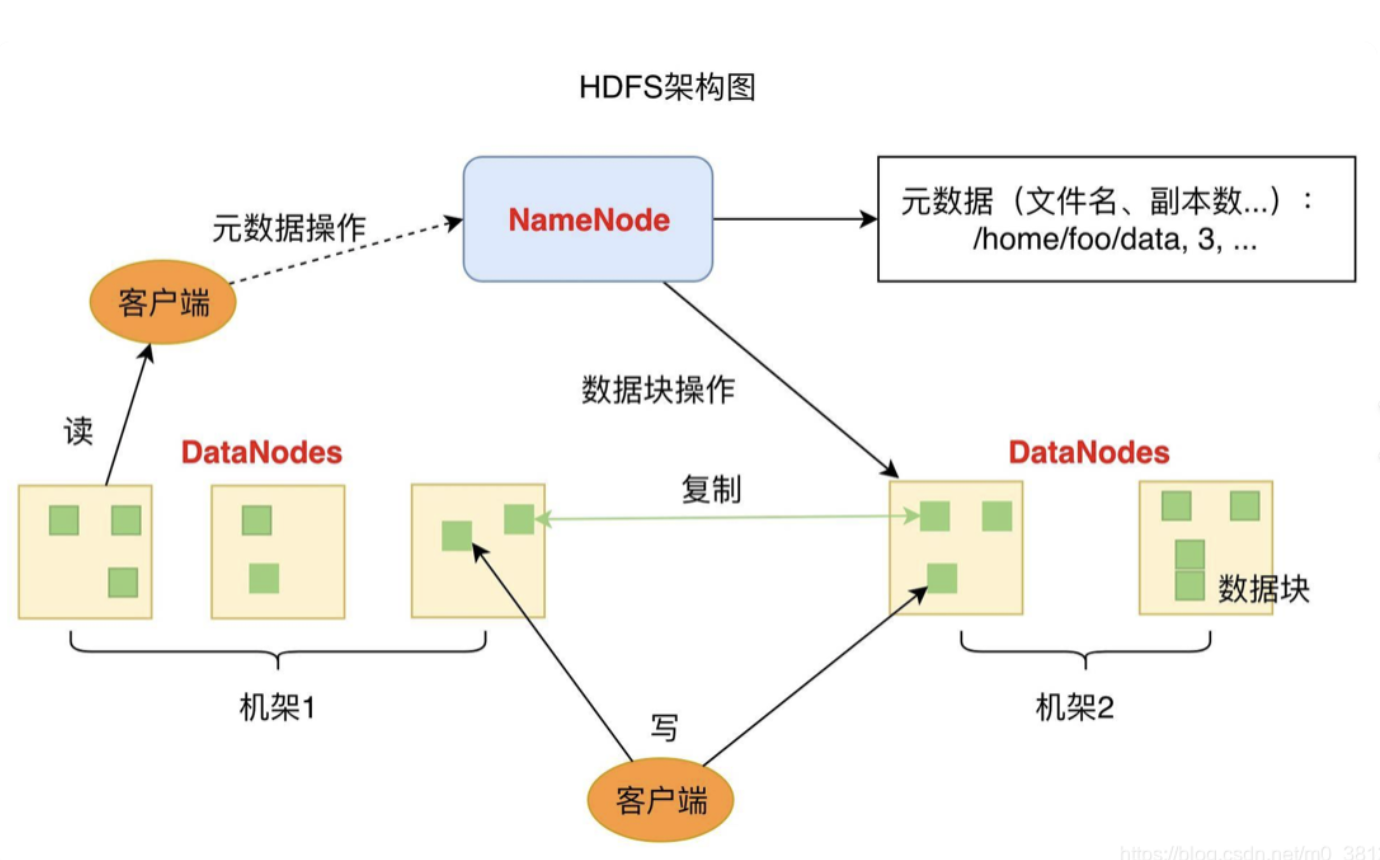
✅ 写入流程(Write)
- Client 请求 NameNode 创建文件、分配 Block 存储位置
- Client 直连目标 DataNode 写入数据块
- DataNode 之间完成副本同步 Replication
✅ 读取流程(Read)
- Client 请求 NameNode,查询文件各个 Block 存放在哪些 DataNode
- Client 直接连接对应 DataNode 获取真实数据 Read
2.YARN:集群资源调度管理器,统一分配 CPU、内存,支持 Spark、Flink、MapReduce 多种计算引擎混跑。
- ResourceManager(RM,全局主管理器)
整个集群唯一的资源总调度中心:接收客户端任务提交、管理所有 NodeManager、分配资源、调度队列。
普通版本存在单点故障;HA 模式配置 Active / Standby RM 实现高可用。 - NodeManager(NM,节点代理,每台机器一个)
每个计算节点上运行,负责本机资源管理:监控本机 CPU、内存;启动 / 销毁容器 Container;和 ResourceManager 保持心跳。 - ApplicationMaster(AM,应用管理器)
每个任务(Application)单独生成一个 AM。向 RM 申请资源,和 NM 通信启动执行容器,管控本任务运行、容错。 - Container(资源容器)
YARN 最小资源分配单元,封装 CPU、内存资源,真正运行计算任务。
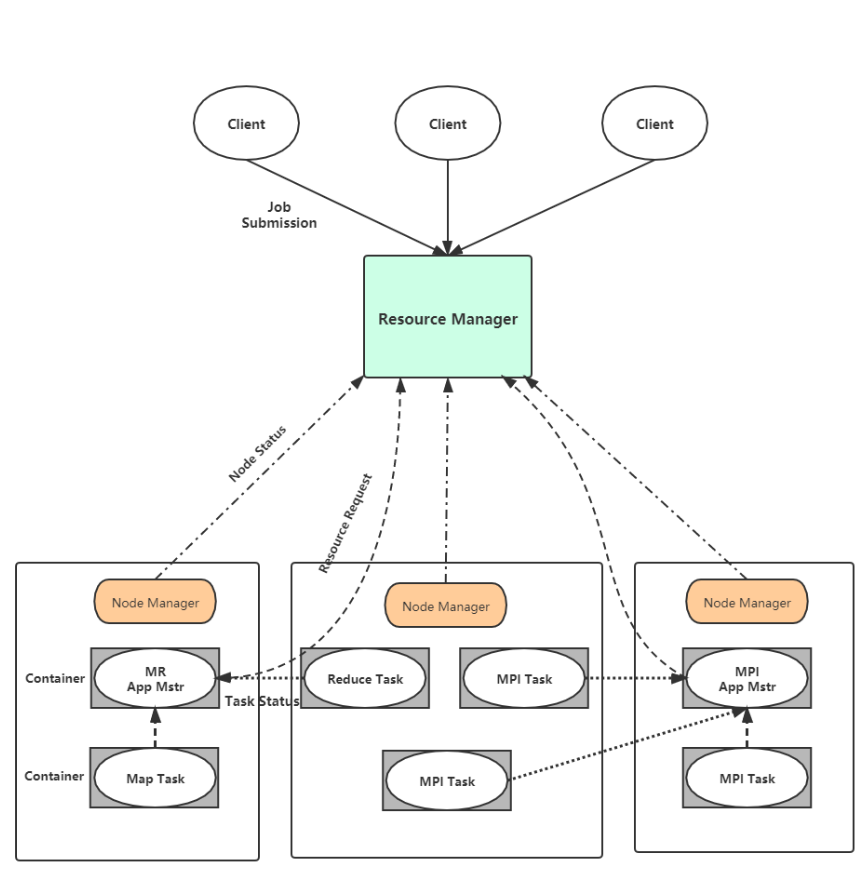
✅ 工作流程
- Client 向 ResourceManager 提交作业
- ResourceManager 分配容器,启动 ApplicationMaster
- ApplicationMaster 向 ResourceManager 申请运行任务所需资源
- ResourceManager 根据各 NodeManager 上报的节点状态分配资源
- NodeManager 使用容器启动 MapTask、ReduceTask 等任务
- 任务运行期间持续上报任务状态,NodeManager 持续上报节点状态
- 作业全部任务执行完成,ApplicationMaster 释放占用资源
3.MapReduce:离线批计算编程模型,分为 Map 并行处理、Reduce 聚合结果两个阶段。
- Input 输入分片:HDFS 上的文件按 Block 逻辑切分为输入分片,一个分片对应一个 Map 任务。
- Map 阶段(映射)
读取分片数据,自定义逻辑处理,输出<key,value>键值对;
输出数据先写入本地磁盘(不是 HDFS),经过分区、排序、归并。 - Shuffle 洗牌(Map → Reduce 中间过程,重中之重)
分区数据通过网络传输到对应 Reduce 节点,完成分组排序,保证相同 key 的数据交给同一个 Reduce。 - Reduce 阶段(归约)
接收一组相同 key 的数据集,自定义聚合逻辑(求和、计数、去重等)。 - Output 输出:最终结果写入 HDFS。
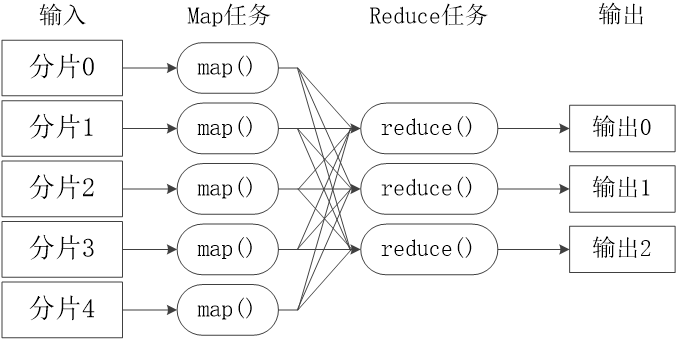
✅ 工作流程
- 输入文件进行分片,每个分片交由一个 map () 函数执行 Map 任务,输出键值对
- 对 Map 输出数据进行分区、排序、归并,相同 key 的数据分发至同一个 reduce ()
- reduce () 函数聚合处理分组数据,执行 Reduce 任务,最终产生输出文件
Hadoop VS MooseFS
| 特性 | MooseFS(MFS) | Hadoop(HDFS) |
|---|---|---|
| 接口 | FUSE,完整 POSIX,可直接 mount 挂载,普通程序无需改造 | 非标准 POSIX,Java API/Shell 访问,不能直接挂载 |
| 核心定位 | 通用分布式文件存储 | 大数据配套存储,和计算引擎深度绑定 |
| 适用场景 | 中小集群、小文件、共享存储、虚拟机镜像、媒体素材 | 超大文件、离线日志分析、数据仓库、海量批计算 |
| 高可用 | Community 版单 Master,依赖 Pacemaker+SBD 实现 HA | 原生支持双 NameNode HA、Zookeeper 故障转移 |
2 单机伪分布式部署
官方文档:https://hadoop.apache.org/docs/stable/hadoop-project-dist/hadoop-common/SingleCluster.html#Download
新建专用运行用户,部署 JDK 和 Hadoop 安装包、配置环境变量
[root@server1 ~]# useradd hadoop
[root@server1 ~]# passwd hadoop
[root@server1 ~]# mv hadoop-3.3.6.tar.gz jdk-8u181-linux-x64.tar.gz /home/hadoop/
[root@server1 ~]# su - hadoop
[hadoop@server1 ~]$ tar zxf hadoop-3.3.6.tar.gz
[hadoop@server1 ~]$ tar zxf jdk-8u181-linux-x64.tar.gz
[hadoop@server1 ~]$ ln -s hadoop-3.3.6 hadoop
[hadoop@server1 ~]$ ln -s jdk1.8.0_181 jdk
[hadoop@server1 ~]$ vim .bash_profile
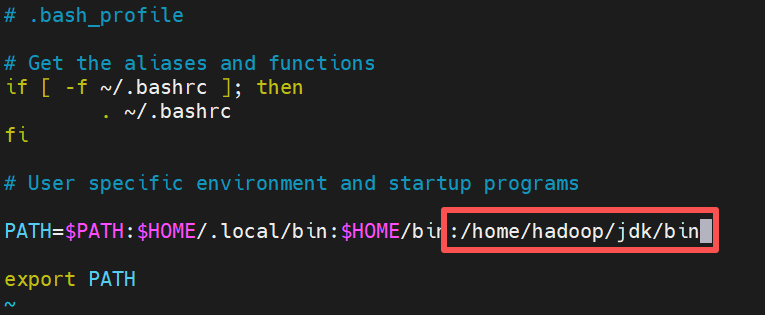
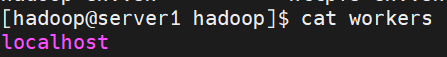
workers 文件用来定义 DataNode 节点列表,伪分布式为 localhost
[hadoop@server1 ~]$ source .bash_profile
[hadoop@server1 ~]$ cd hadoop
[hadoop@server1 hadoop]$ cd etc/
[hadoop@server1 etc]$ cd hadoop/
[hadoop@server1 hadoop]$ cat workers
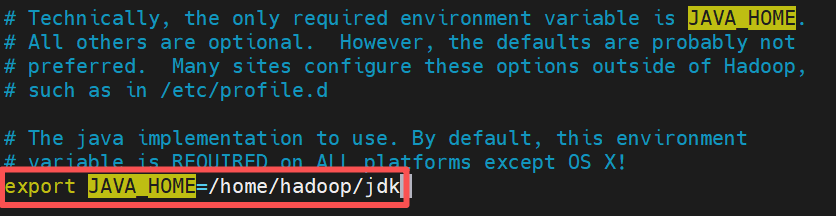
Hadoop 启动脚本必须知道 Java 路径,否则无法运行
[hadoop@server1 hadoop]$ vim hadoop-env.sh
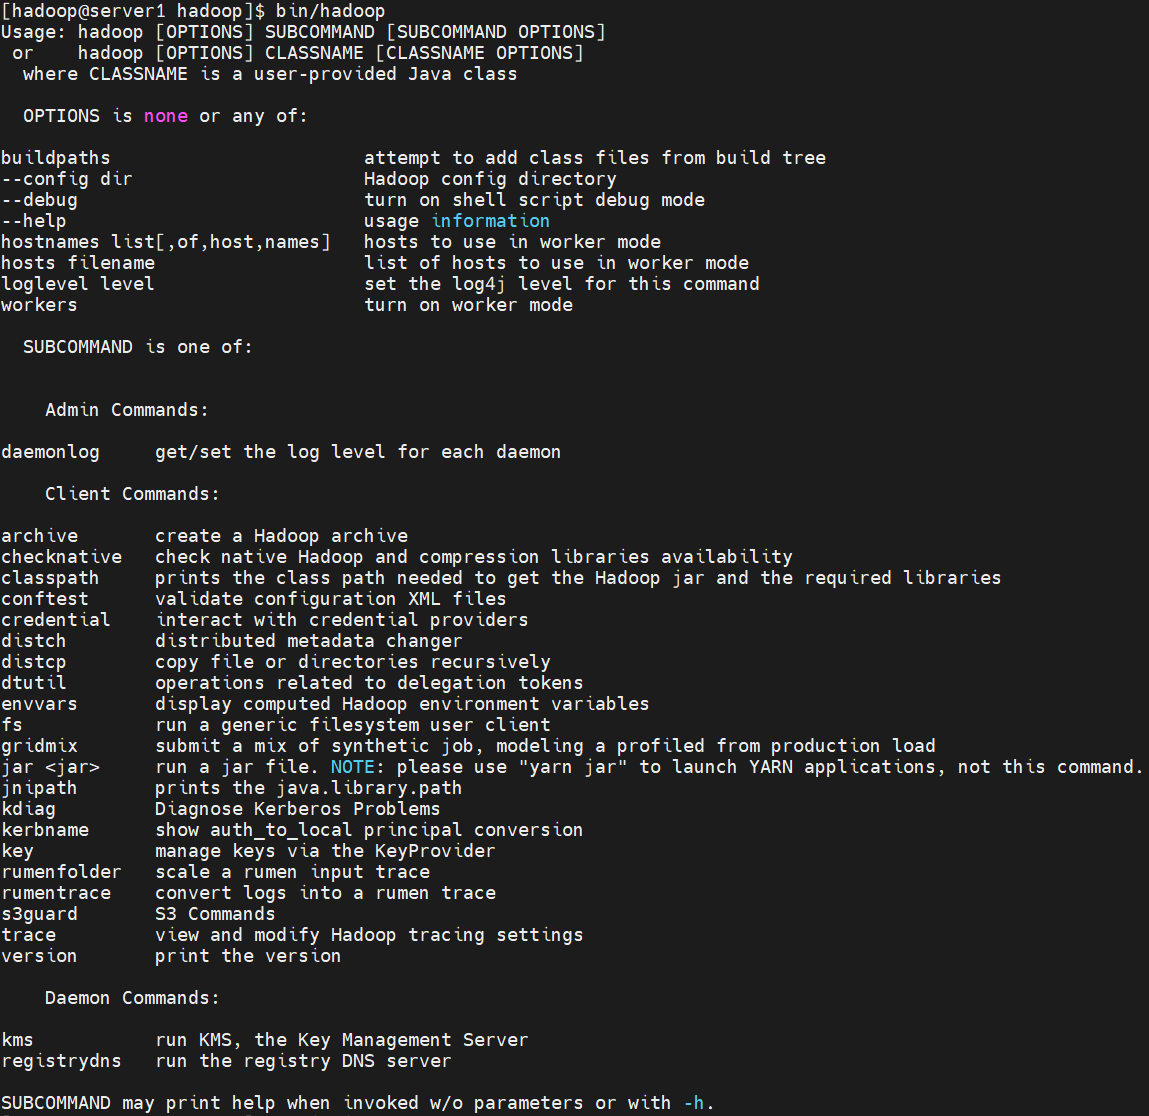
bin/hadoop 是 Hadoop 的主入口命令脚本,整个 Hadoop 绝大多数功能都靠它调用
[hadoop@server1 hadoop]$ cd
[hadoop@server1 ~]$ cd hadoop
[hadoop@server1 hadoop]$ bin/hadoop
执行命令后显示bin/hadoop 命令的完整用法帮助说明
本地模式测试:不启动 HDFS,直接在单机本地跑 MapReduce,验证 jar 包、Java 环境是否正常
运行MapReduce官方示例
[hadoop@server1 hadoop]$ mkdir input
[hadoop@server1 hadoop]$ cp etc/hadoop/*.xml input
[hadoop@server1 hadoop]$ bin/hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-examples-3.3.6.jar grep input output 'dfs[a-z.]+'
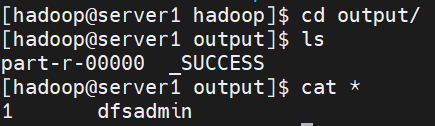
# 使用 Hadoop 自带的 grep MapReduce 示例程序,读取 input 目录里的配置文件,检索匹配 dfs[a-z.]+ 的字段,统计每个匹配词汇出现次数,最终结果自动生成到 output 目录
[hadoop@server1 hadoop]$ cd output/
[hadoop@server1 output]$ ls
[hadoop@server1 output]$ cat *
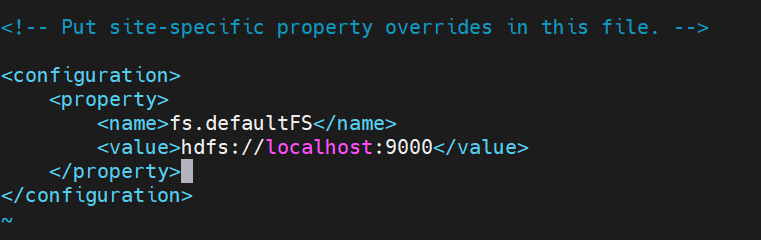
配置默认文件系统地址 hdfs://localhost:9000
[hadoop@server1 output]$ cd ..
[hadoop@server1 hadoop]$ cd etc/hadoop/
[hadoop@server1 hadoop]$ pwd
/home/hadoop/hadoop/etc/hadoop
[hadoop@server1 hadoop]$ vim core-site.xml
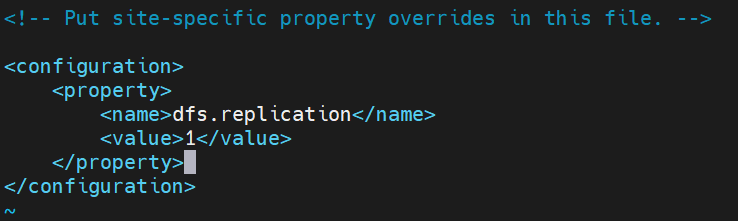
配置文件副本数 dfs.replication=1(单机只能1副本)
[hadoop@server1 hadoop]$ vim hdfs-site.xml
配置免密
[hadoop@server1 hadoop]$ ssh-keygen
[hadoop@server1 hadoop]$ ssh-copy-id localhost
[hadoop@server1 hadoop]$ ssh localhost
# 切记 ctrl+d 退出!
初始化HDFS元数据,仅首次部署执行
[hadoop@server1 hadoop]$ cd ../..
[hadoop@server1 hadoop]$ pwd
/home/hadoop/hadoop
[hadoop@server1 hadoop]$ bin/hdfs namenode -format
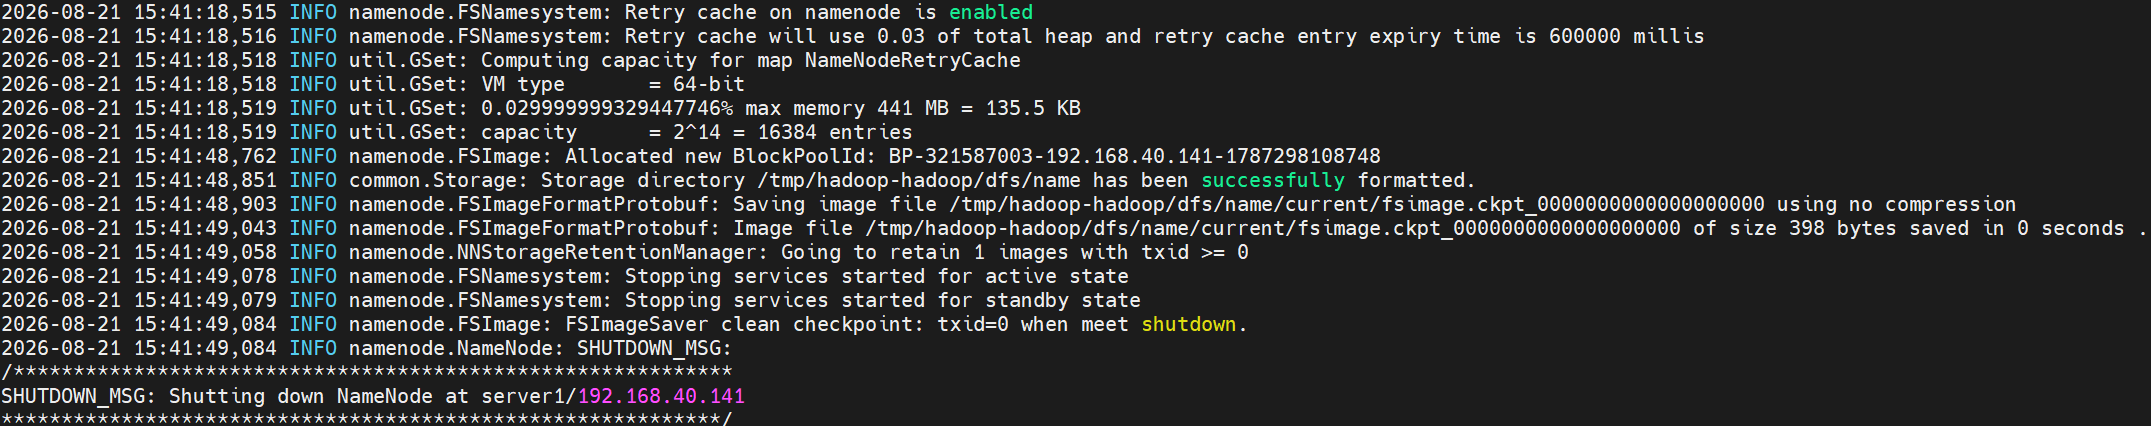
一键启动 NameNode + DataNode,拉起HDFS分布式文件系统
[hadoop@server1 hadoop]$ sbin/start-dfs.sh

有警告,只需远程连接一下 server1 即可
[hadoop@server1 hadoop]$ ssh server1
[hadoop@server1 ~]$ logout
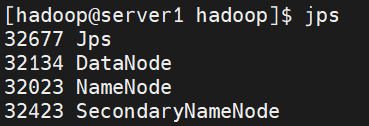
查看正在运行的 Java 进程
[hadoop@server1 hadoop]$ jps
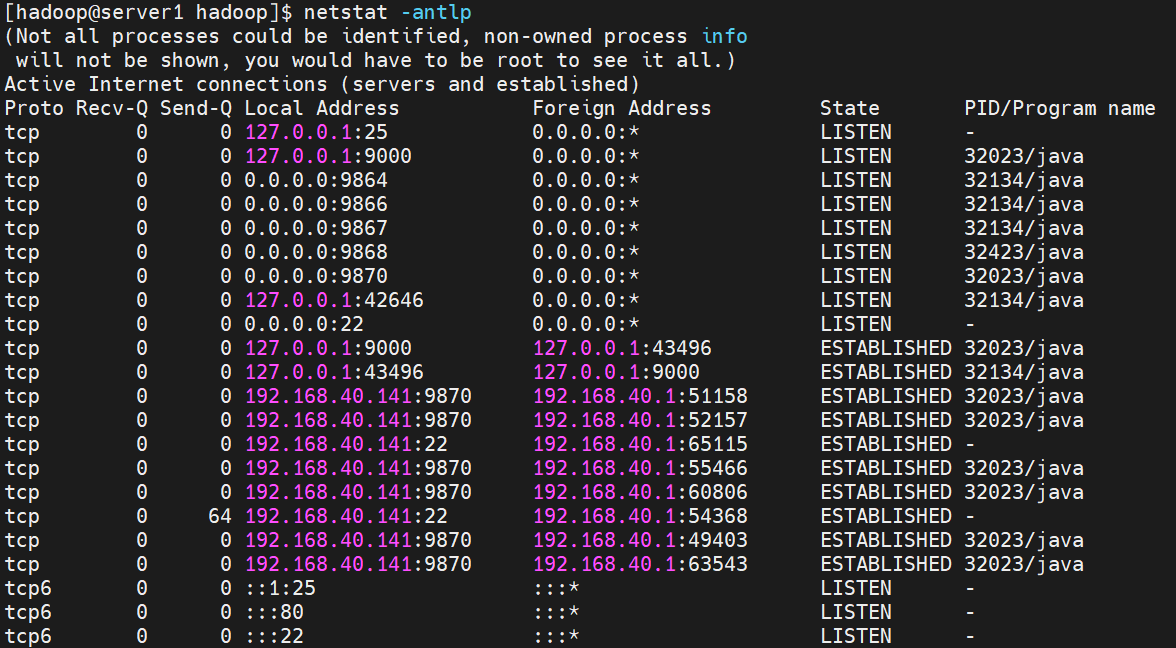
查看本机 TCP 端口监听情况,均正常
[hadoop@server1 hadoop]$ netstat -antlp
- 9000(tcp 127.0.0.1:9000) → PID 32023 NameNode
HDFS 默认通信端口(fs.defaultFS 使用的端口,客户端、DataNode 和 NameNode 交互) - 9864 / 9866 → DataNode 内置监听端口
- 9867 / 9868 → SecondaryNameNode 端口
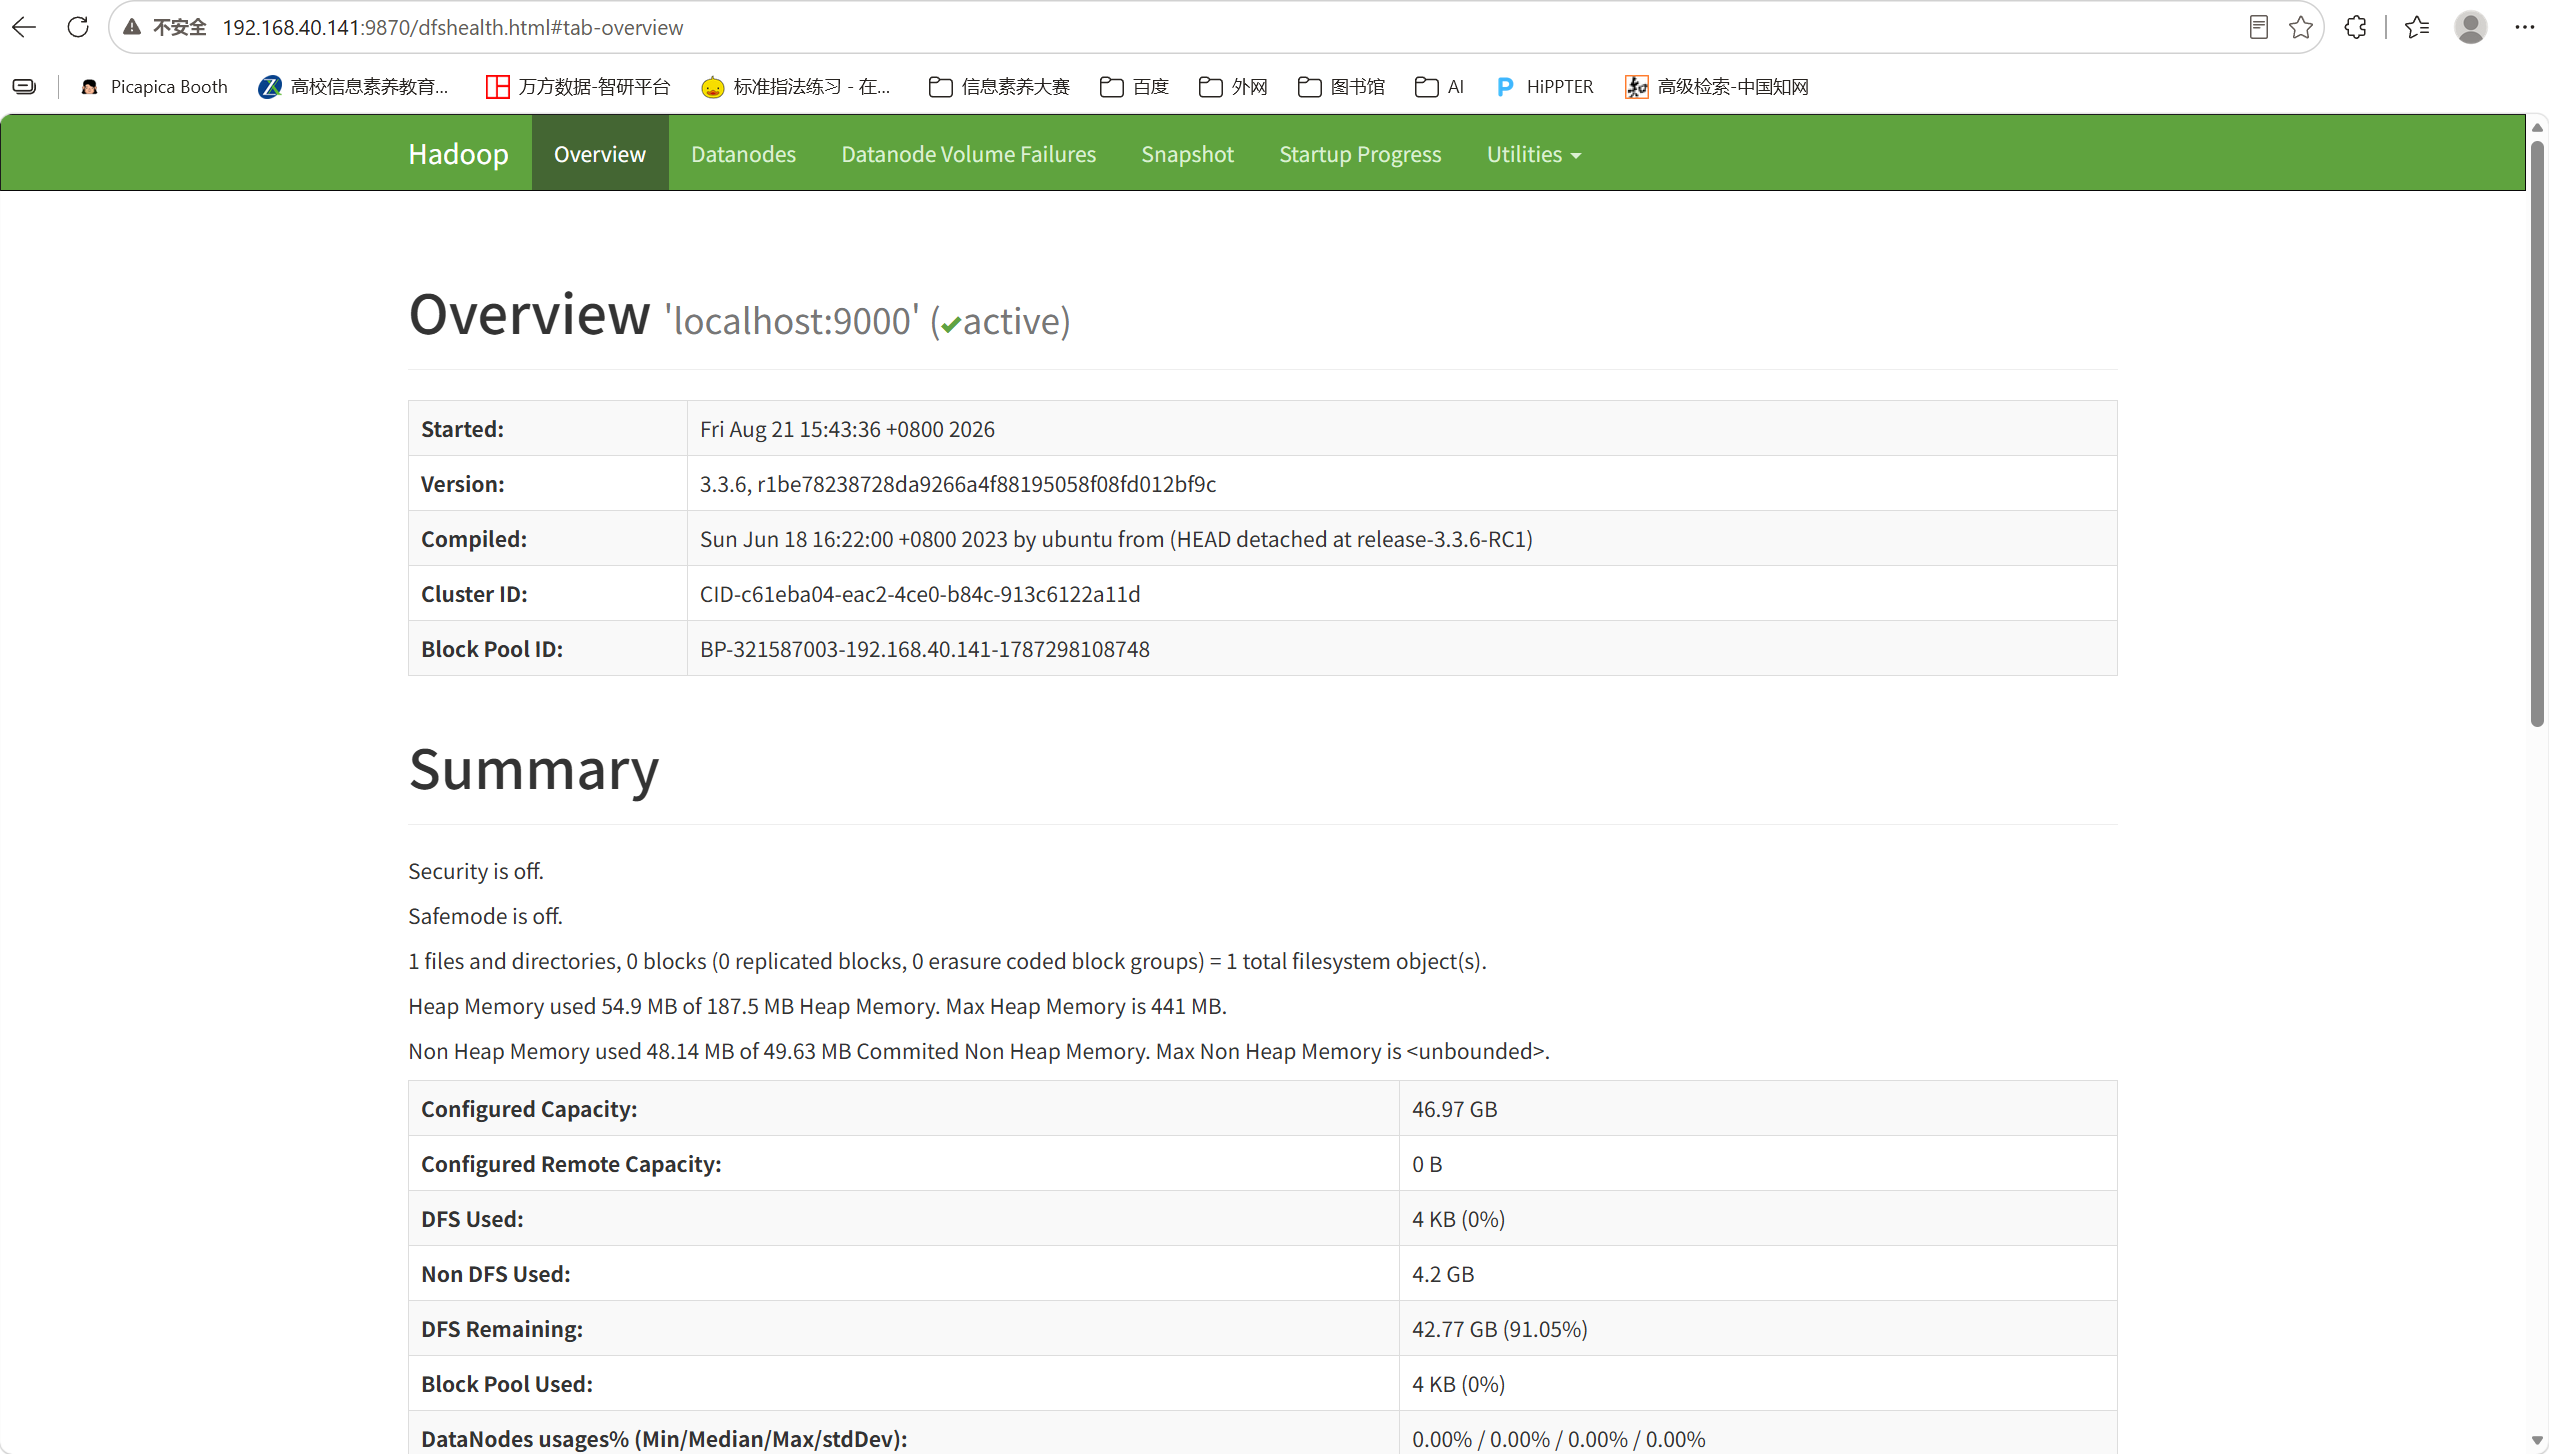
- 9870 → NameNode WebUI 端口(浏览器访问:http://server1:9870 查看 HDFS 管理页面)
访问前端网页
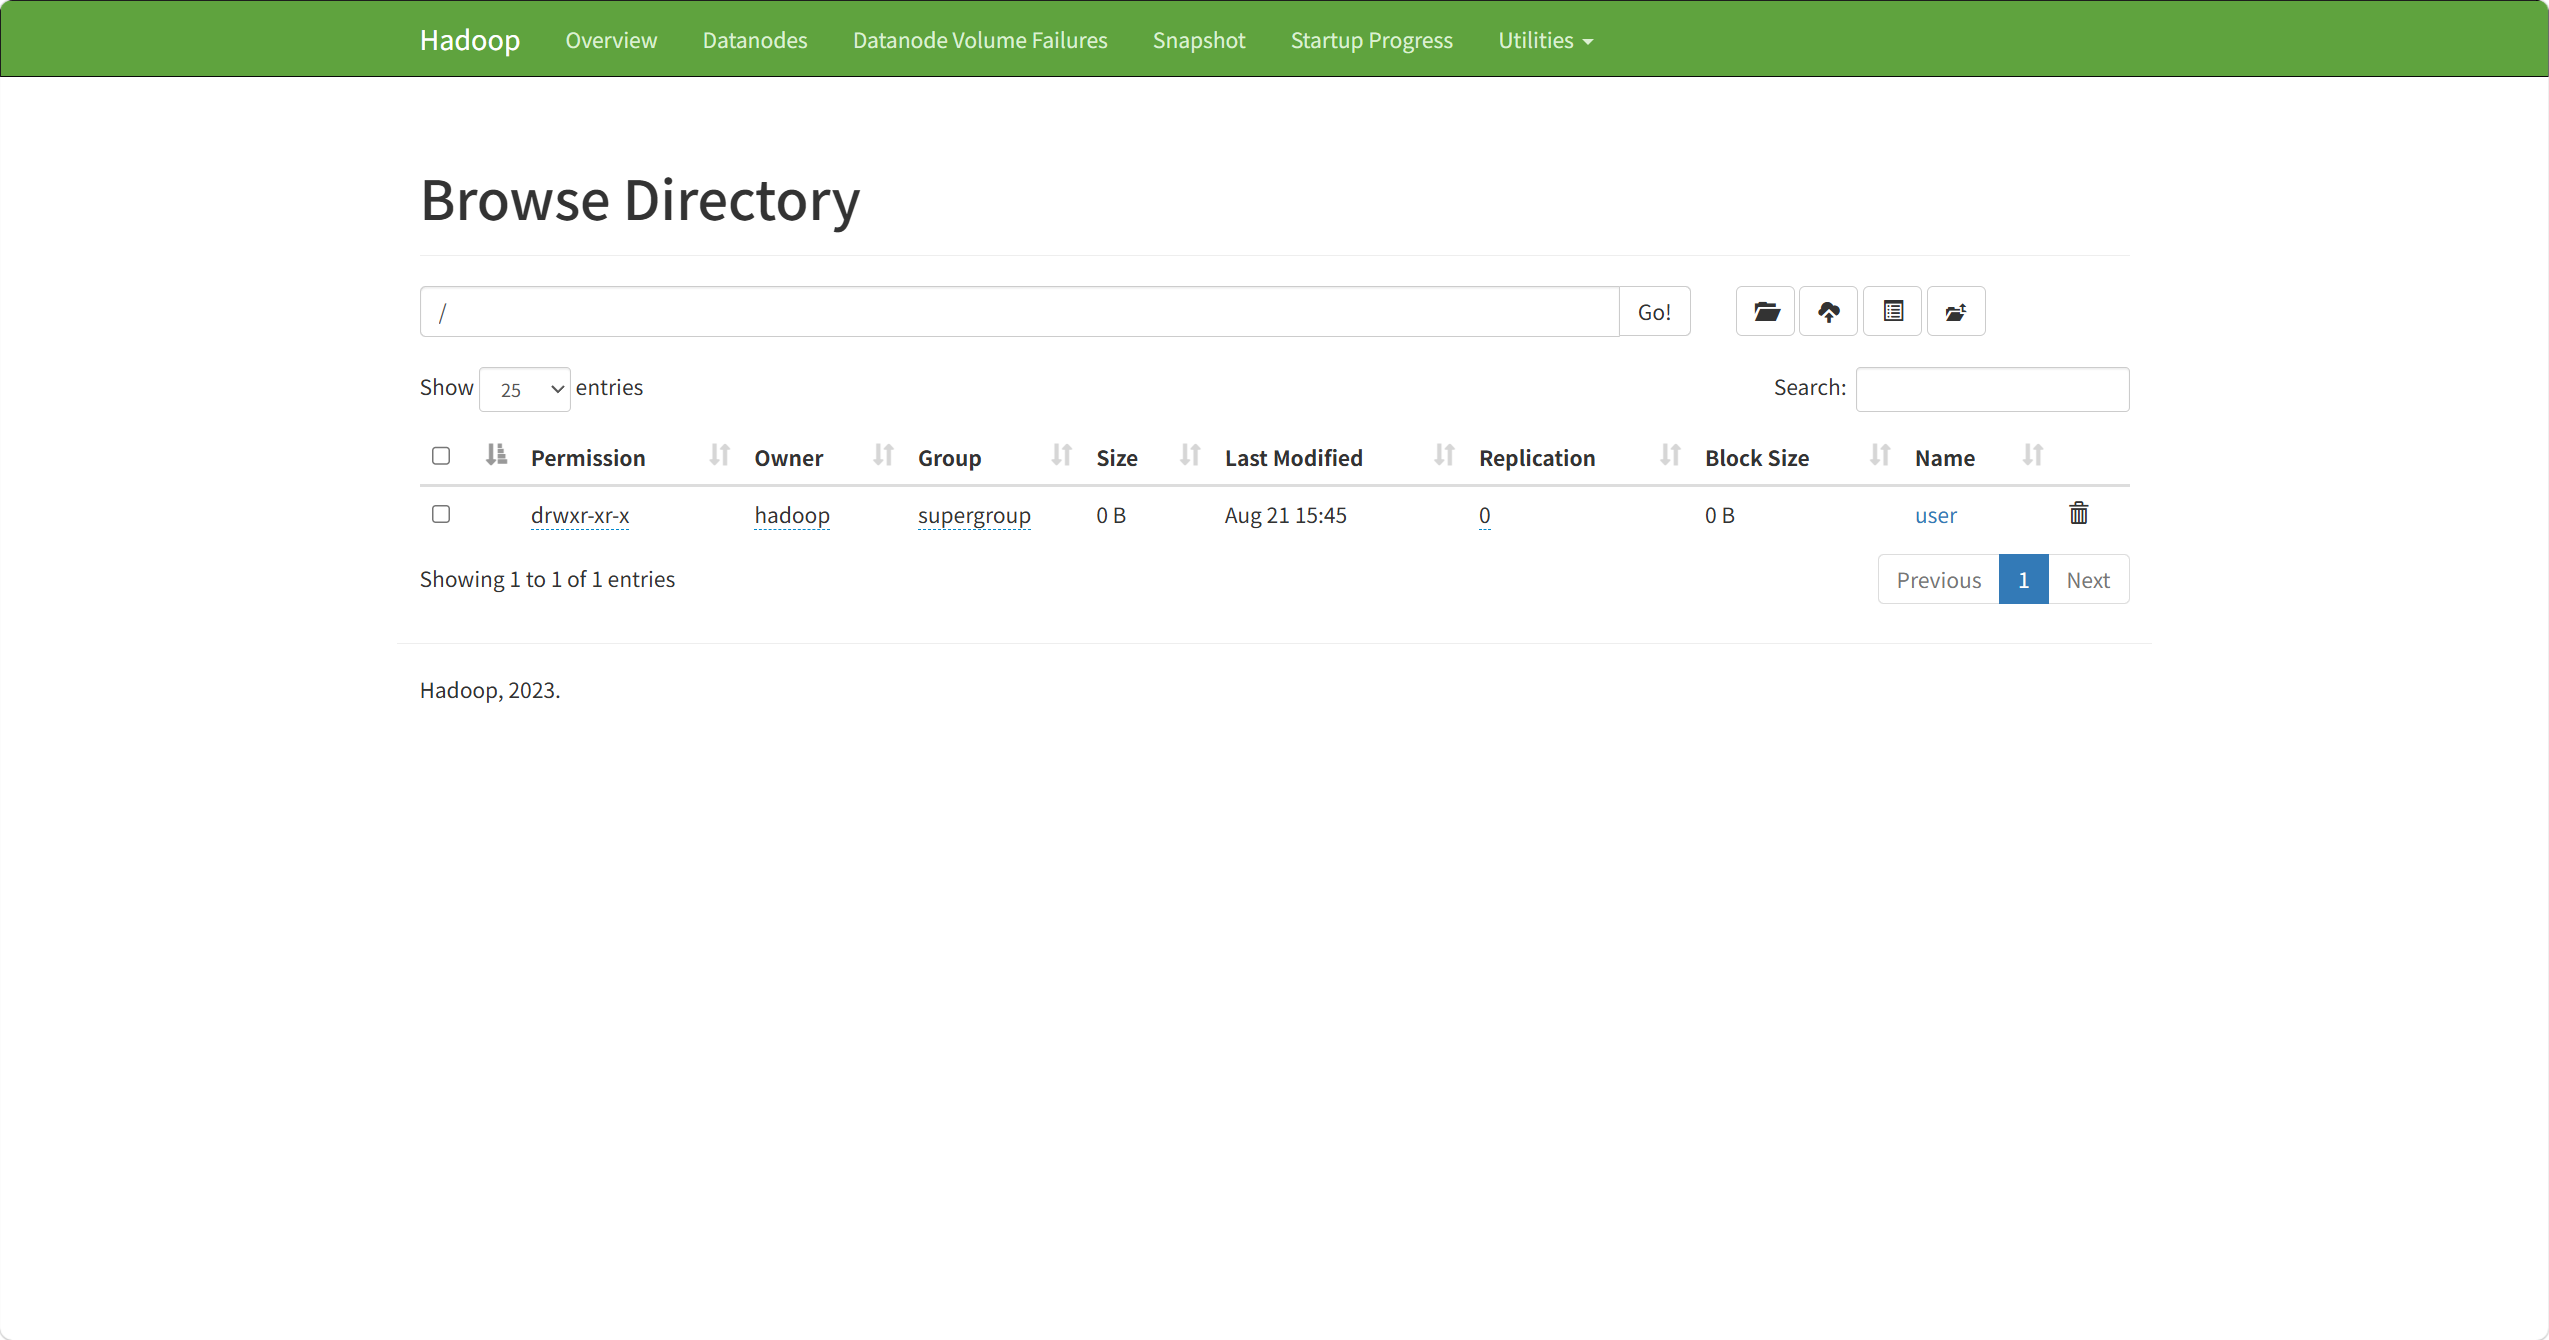
创建目录/user在分布式 HDFS 上,不是本地磁盘
[hadoop@server1 hadoop]$ pwd
/home/hadoop/hadoop
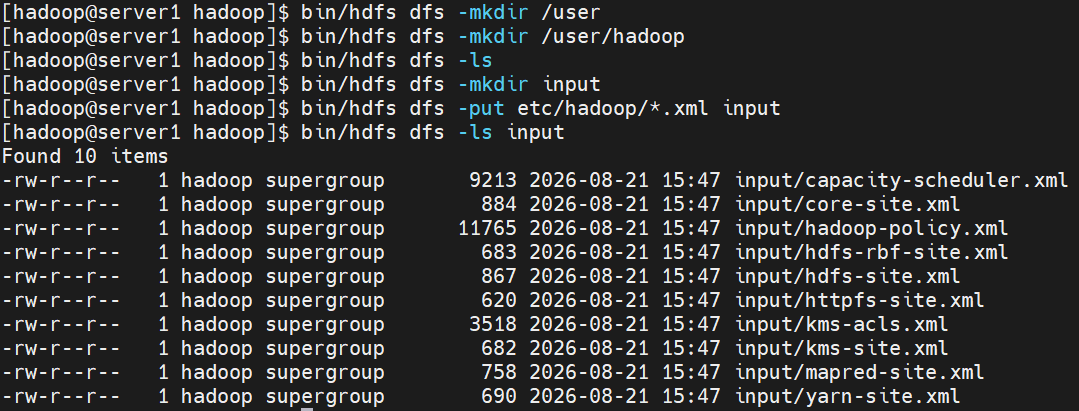
[hadoop@server1 hadoop]$ bin/hdfs dfs -mkdir /user
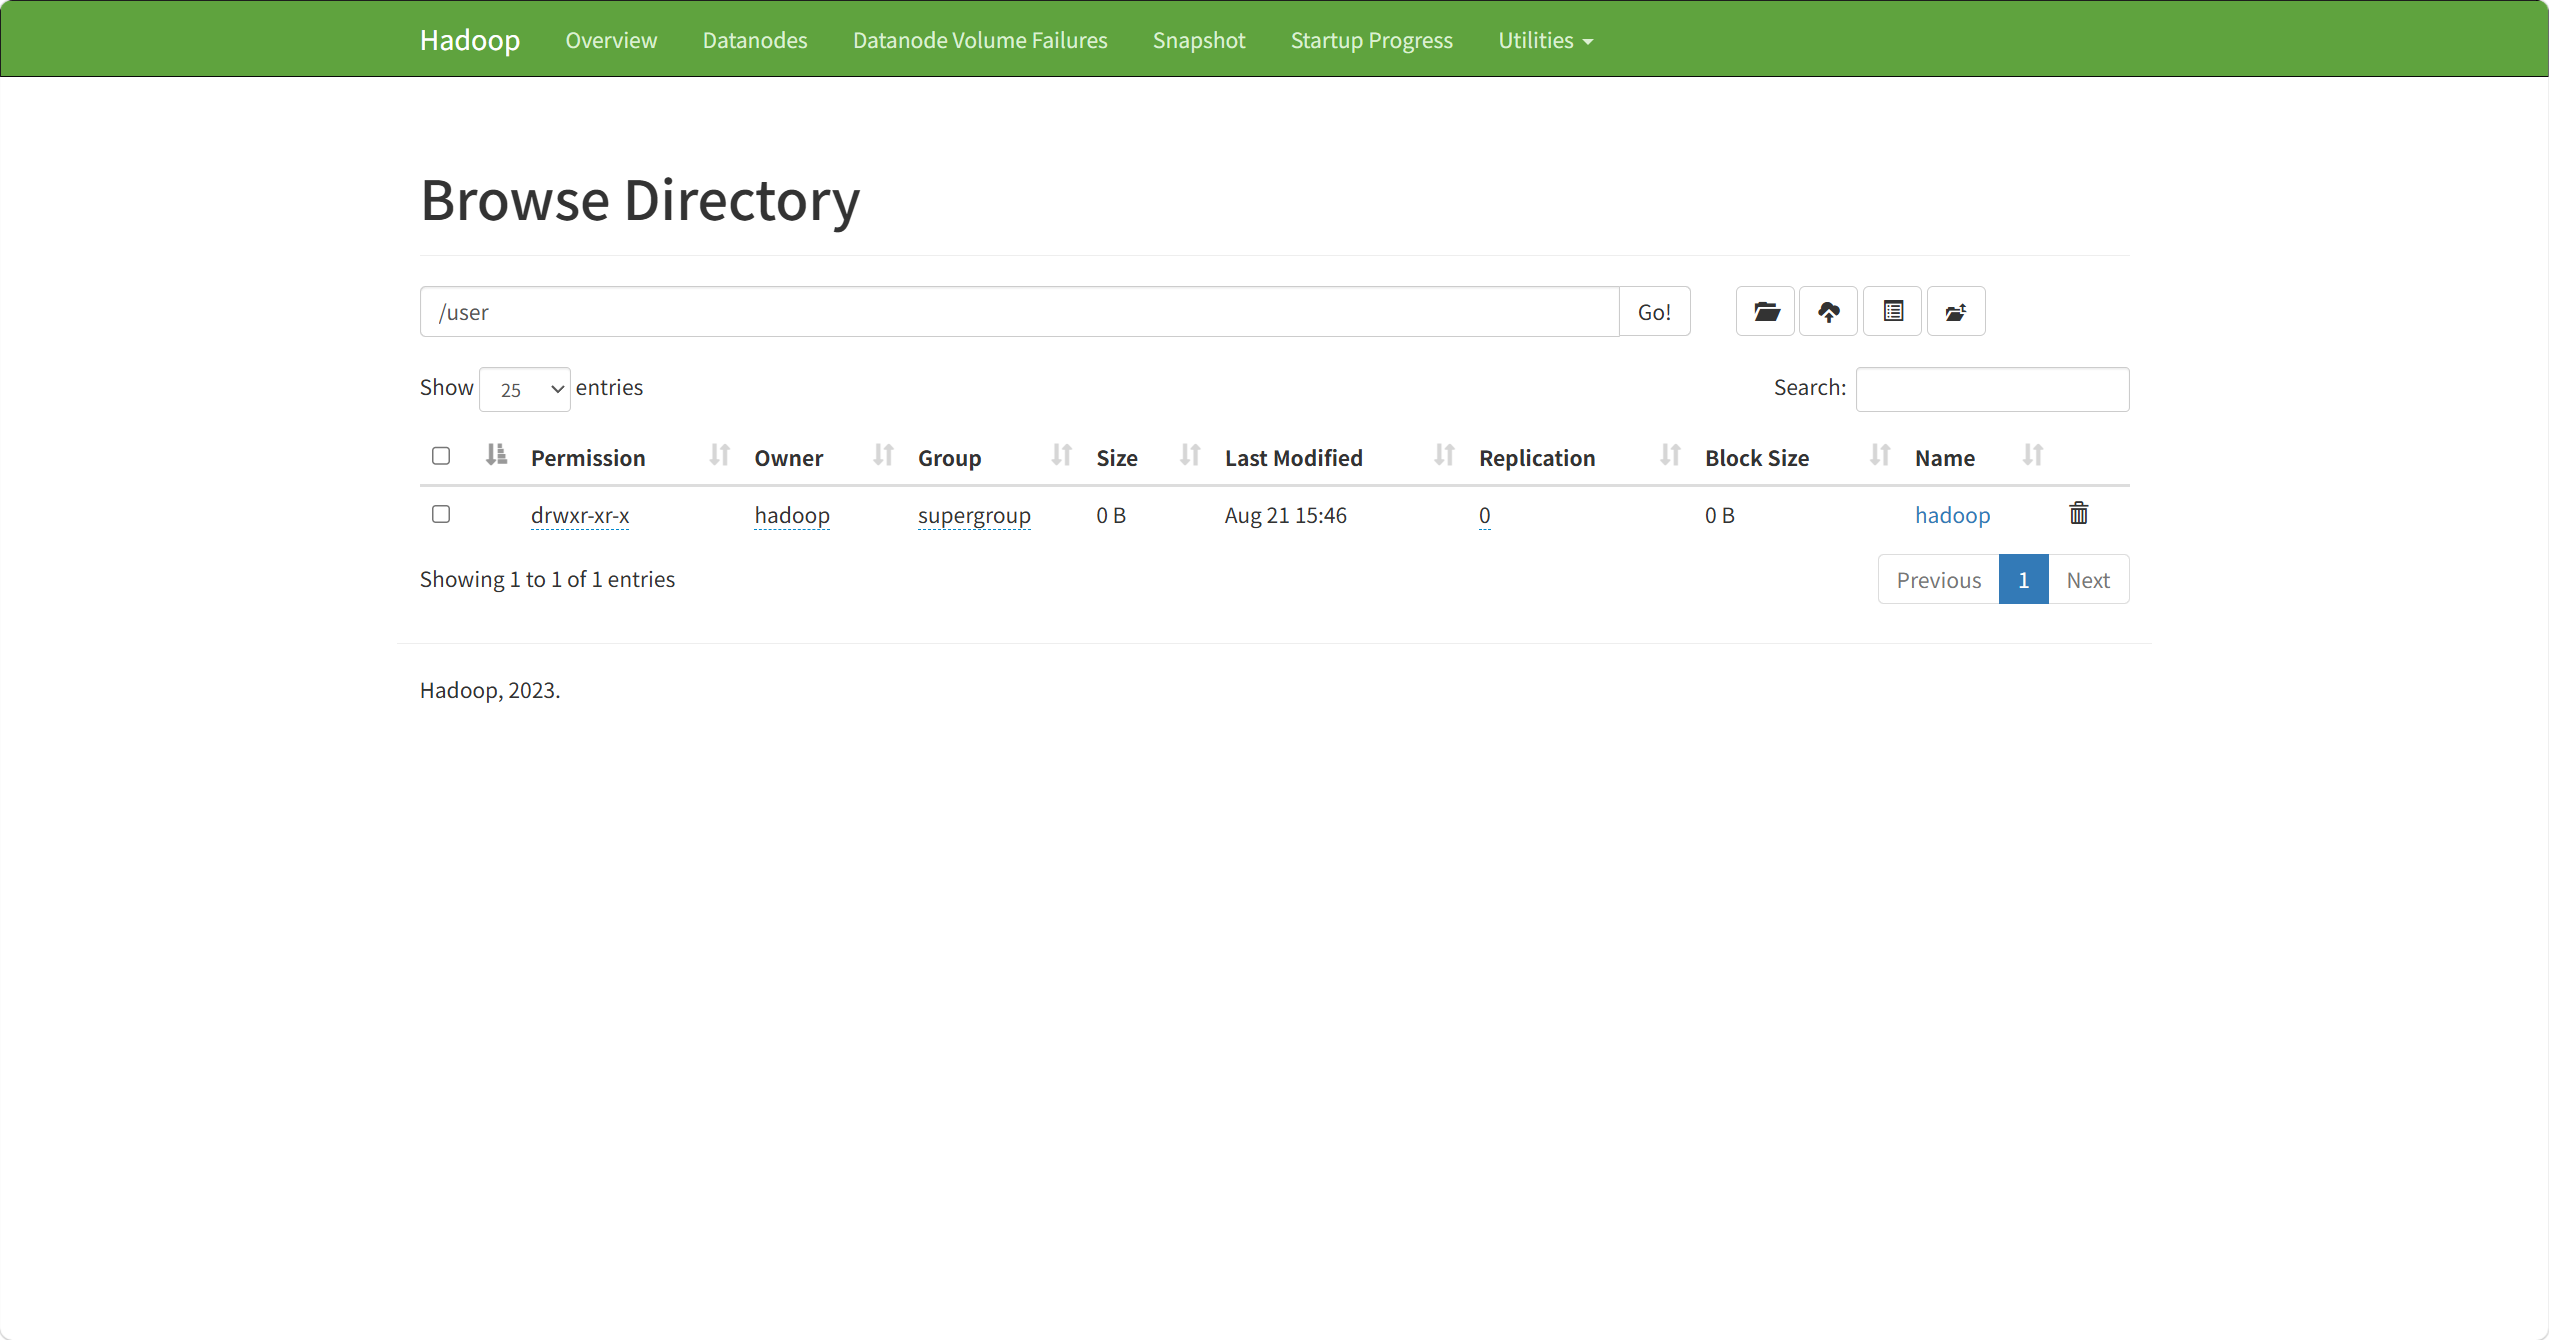
在刚才建好的 /user 下,继续创建 /user/hadoop 目录
[hadoop@server1 hadoop]$ bin/hdfs dfs -mkdir /user/hadoop
点击 user 即可看见
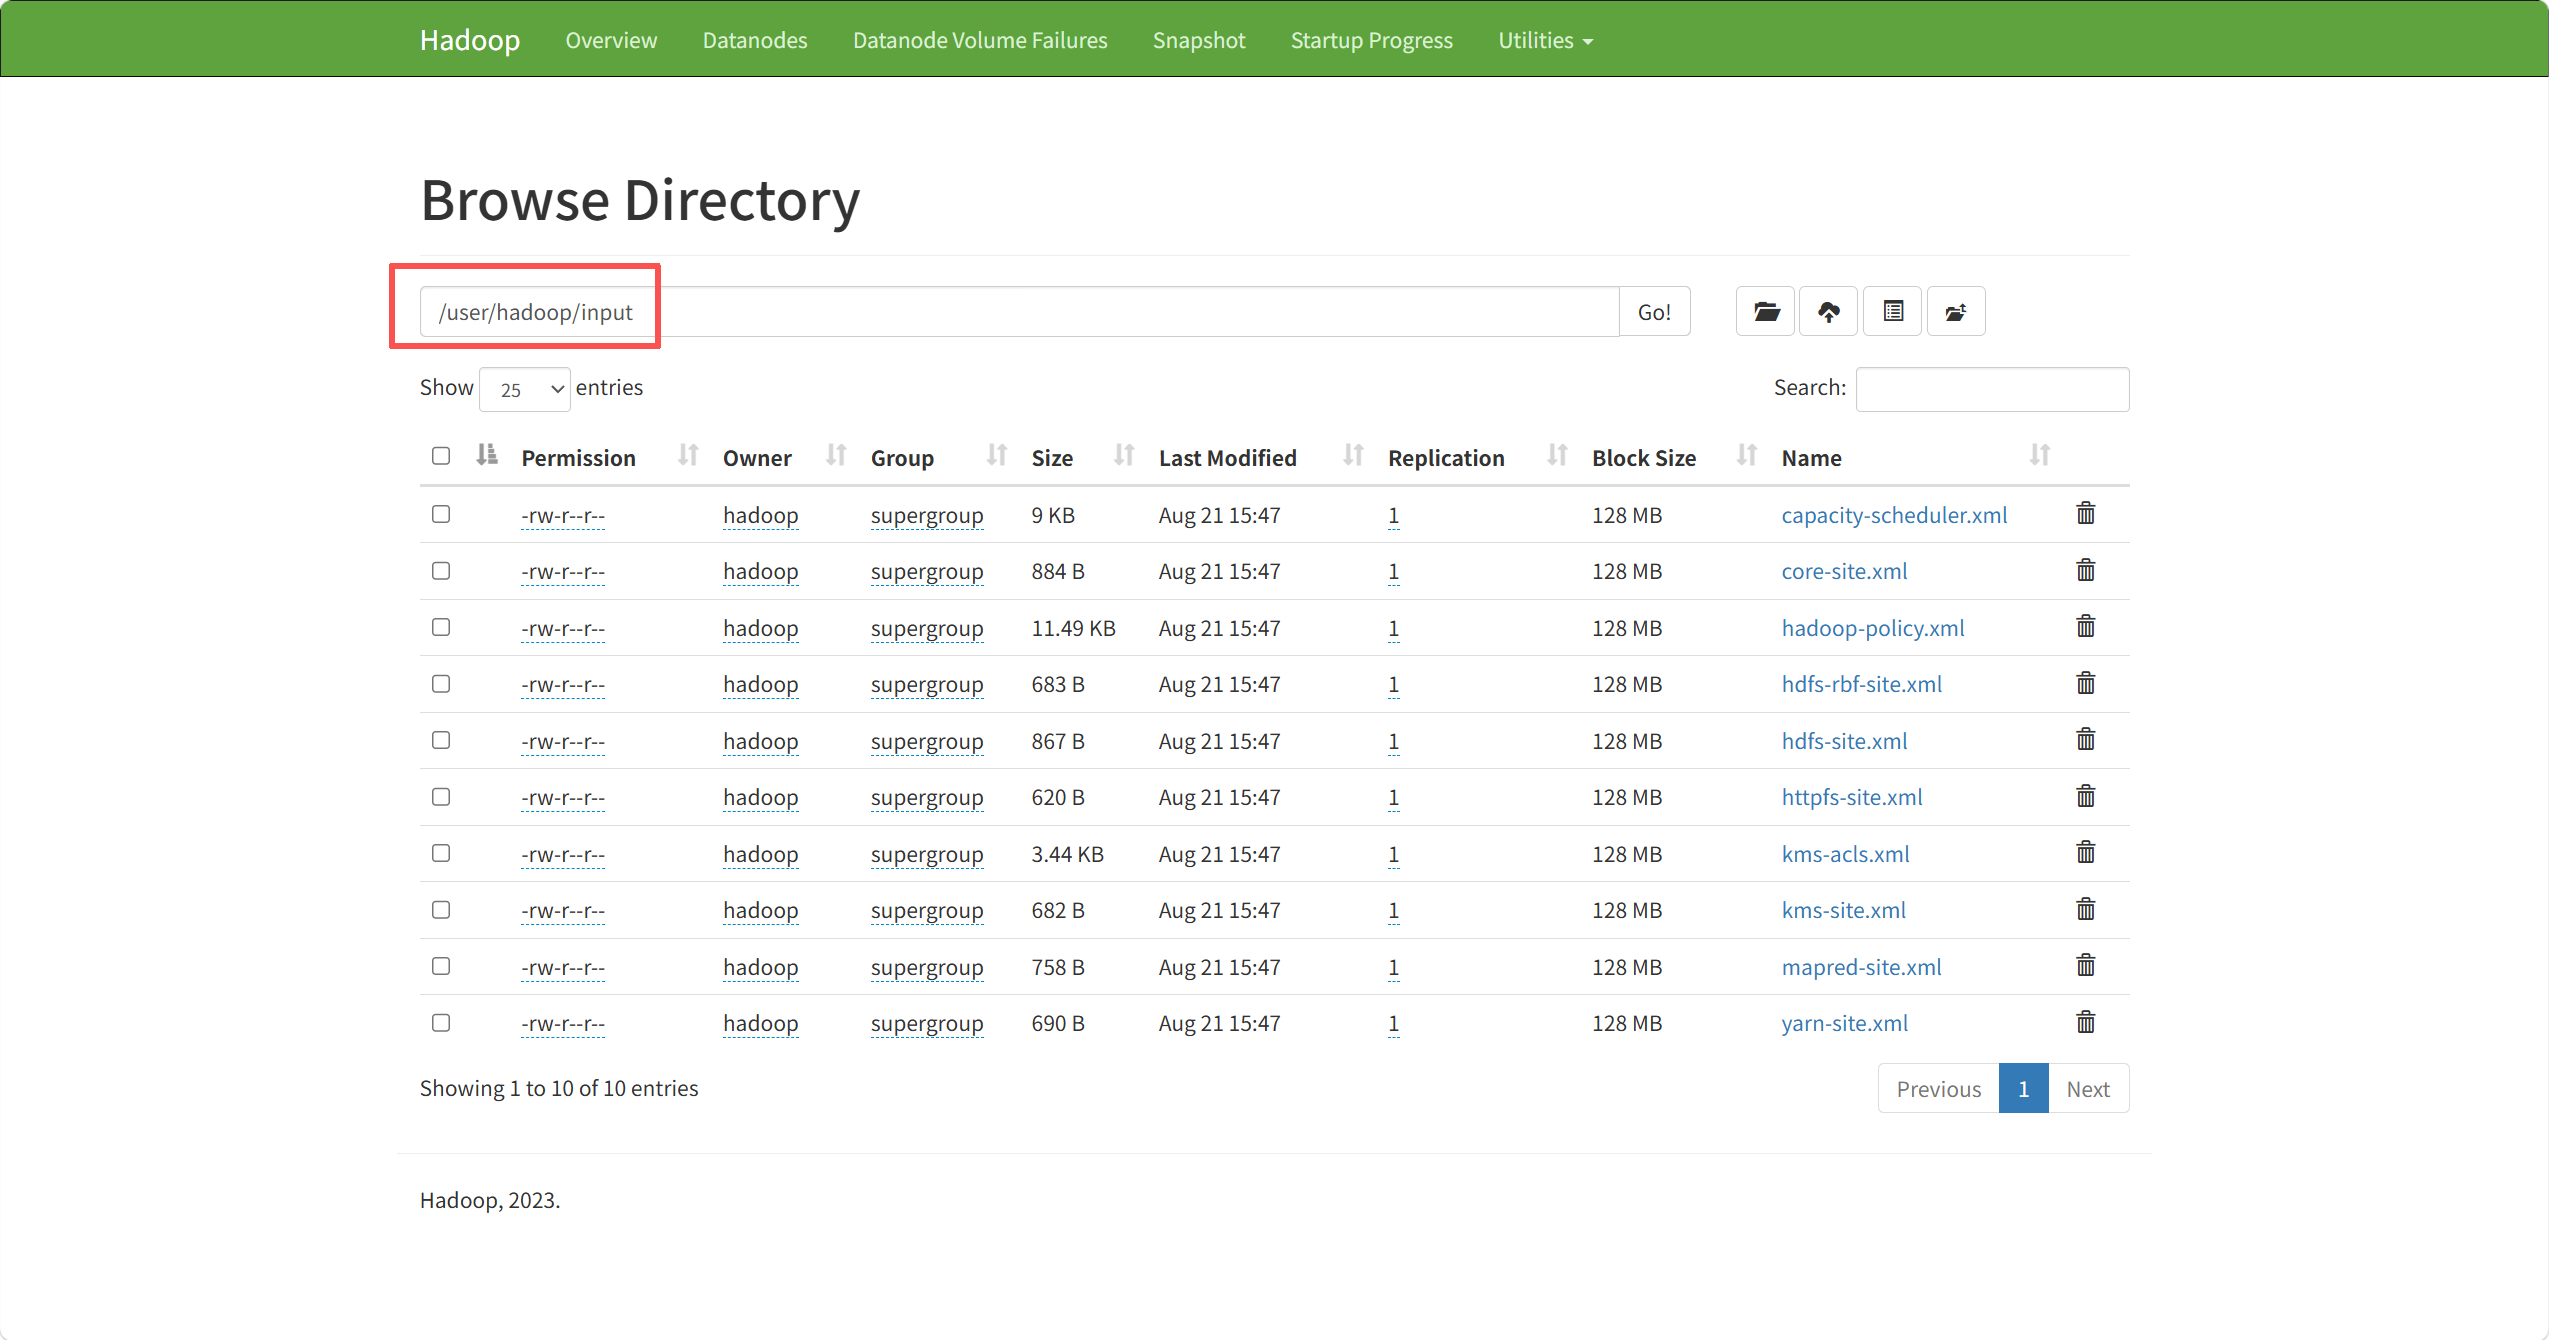
创建目录 /user/hadoop/input,用来存放 MR 任务的输入数据源,上传文件
[hadoop@server1 hadoop]$ bin/hdfs dfs -mkdir input
[hadoop@server1 hadoop]$ bin/hdfs dfs -put etc/hadoop/*.xml input
# 本地 etc/hadoop/ 下所有 .xml 配置文件,上传到 HDFS 的 /user/hadoop/input 目录里
[hadoop@server1 hadoop]$ bin/hdfs dfs -ls input
前端可以看见此目录
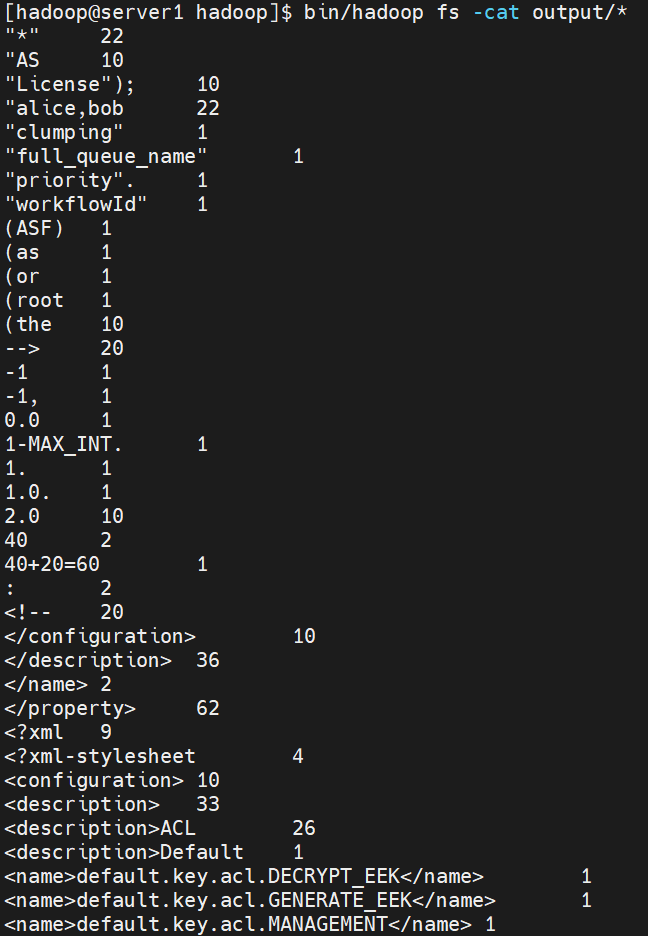
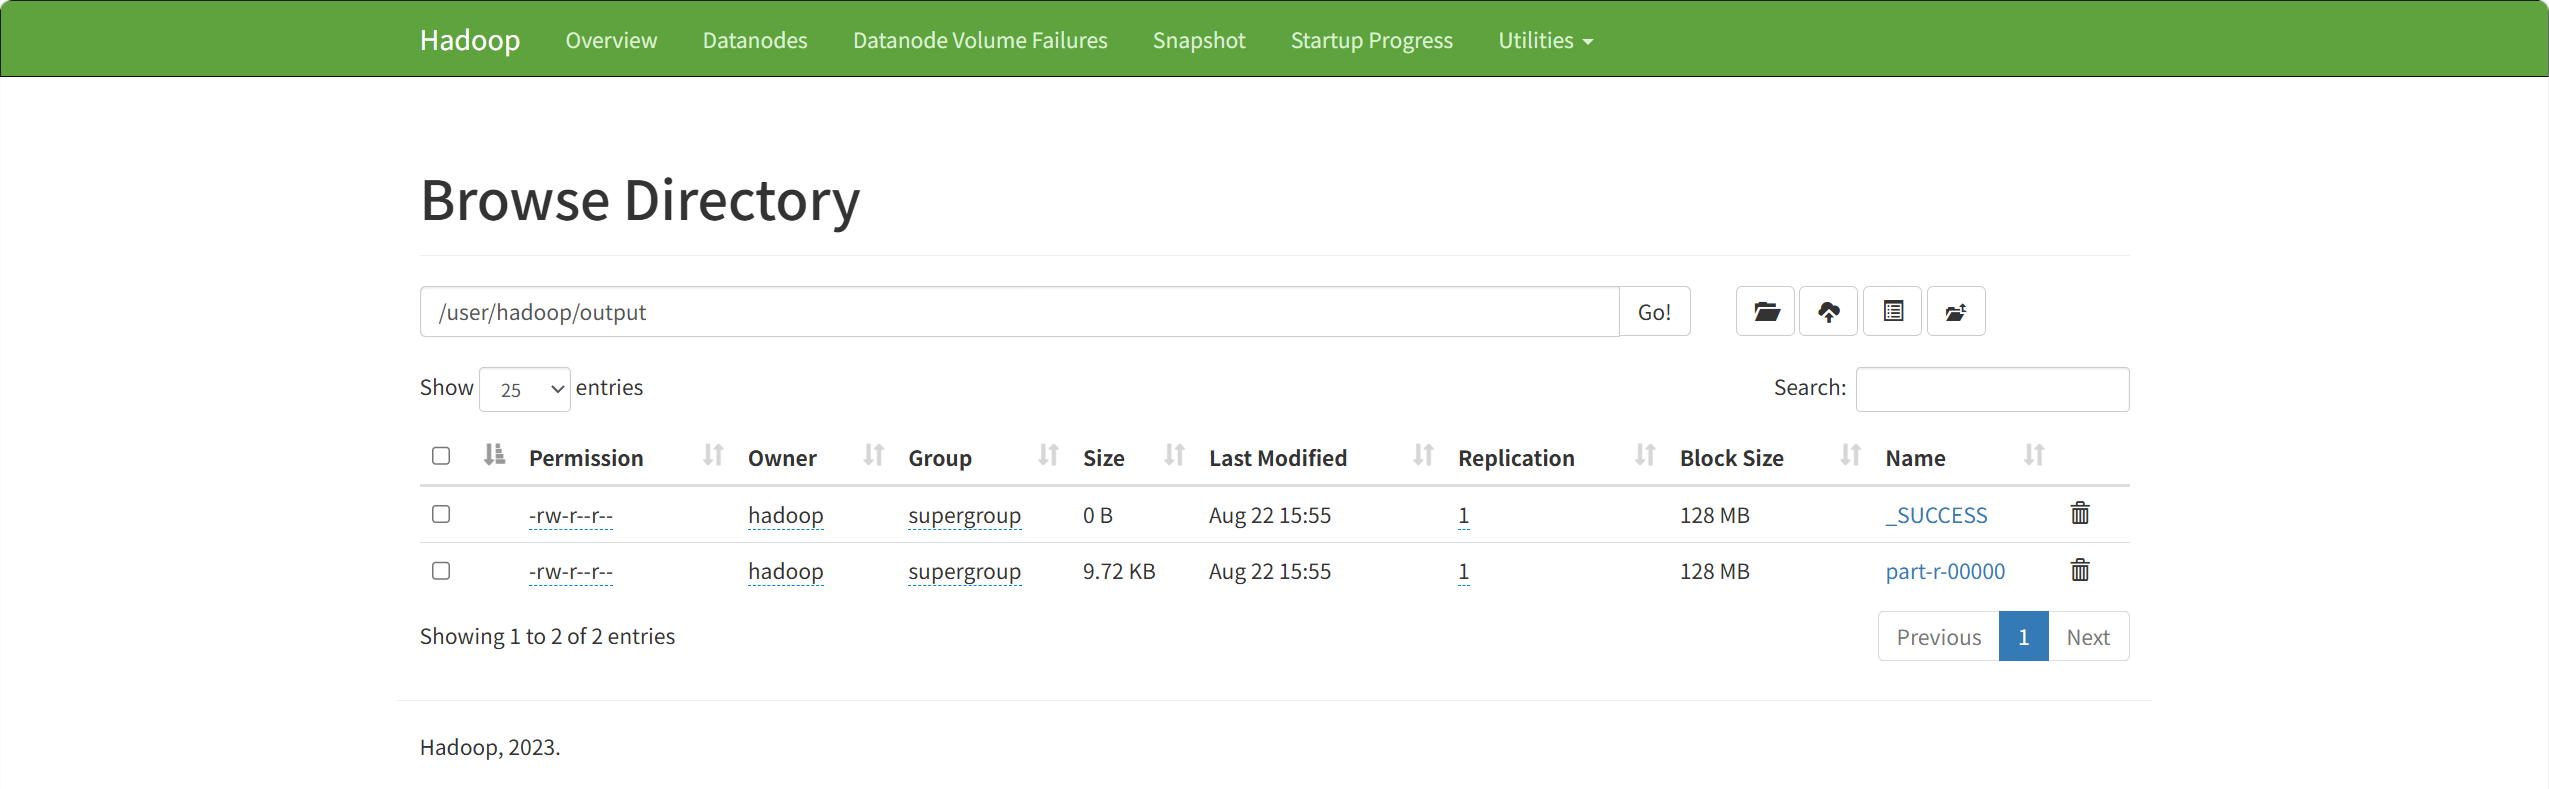
调用 hadoop 自带示例 jar,运行 WordCount 单词统计 MapReduce 程序:读取 HDFS /user/hadoop/input 里所有文件,分词统计每个单词出现次数,结果输出到 HDFS /user/hadoop/output
[hadoop@server1 hadoop]$ bin/hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-examples-3.3.6.jar wordcount input output
[hadoop@server1 hadoop]$ bin/hadoop fs -cat output/*
区分:
- 本地模式测试的
input、output:在 Linux 本机磁盘(hadoop安装目录下,本地文件夹),不需要启动 HDFS,ls本地目录就能看见 - 伪分布式的
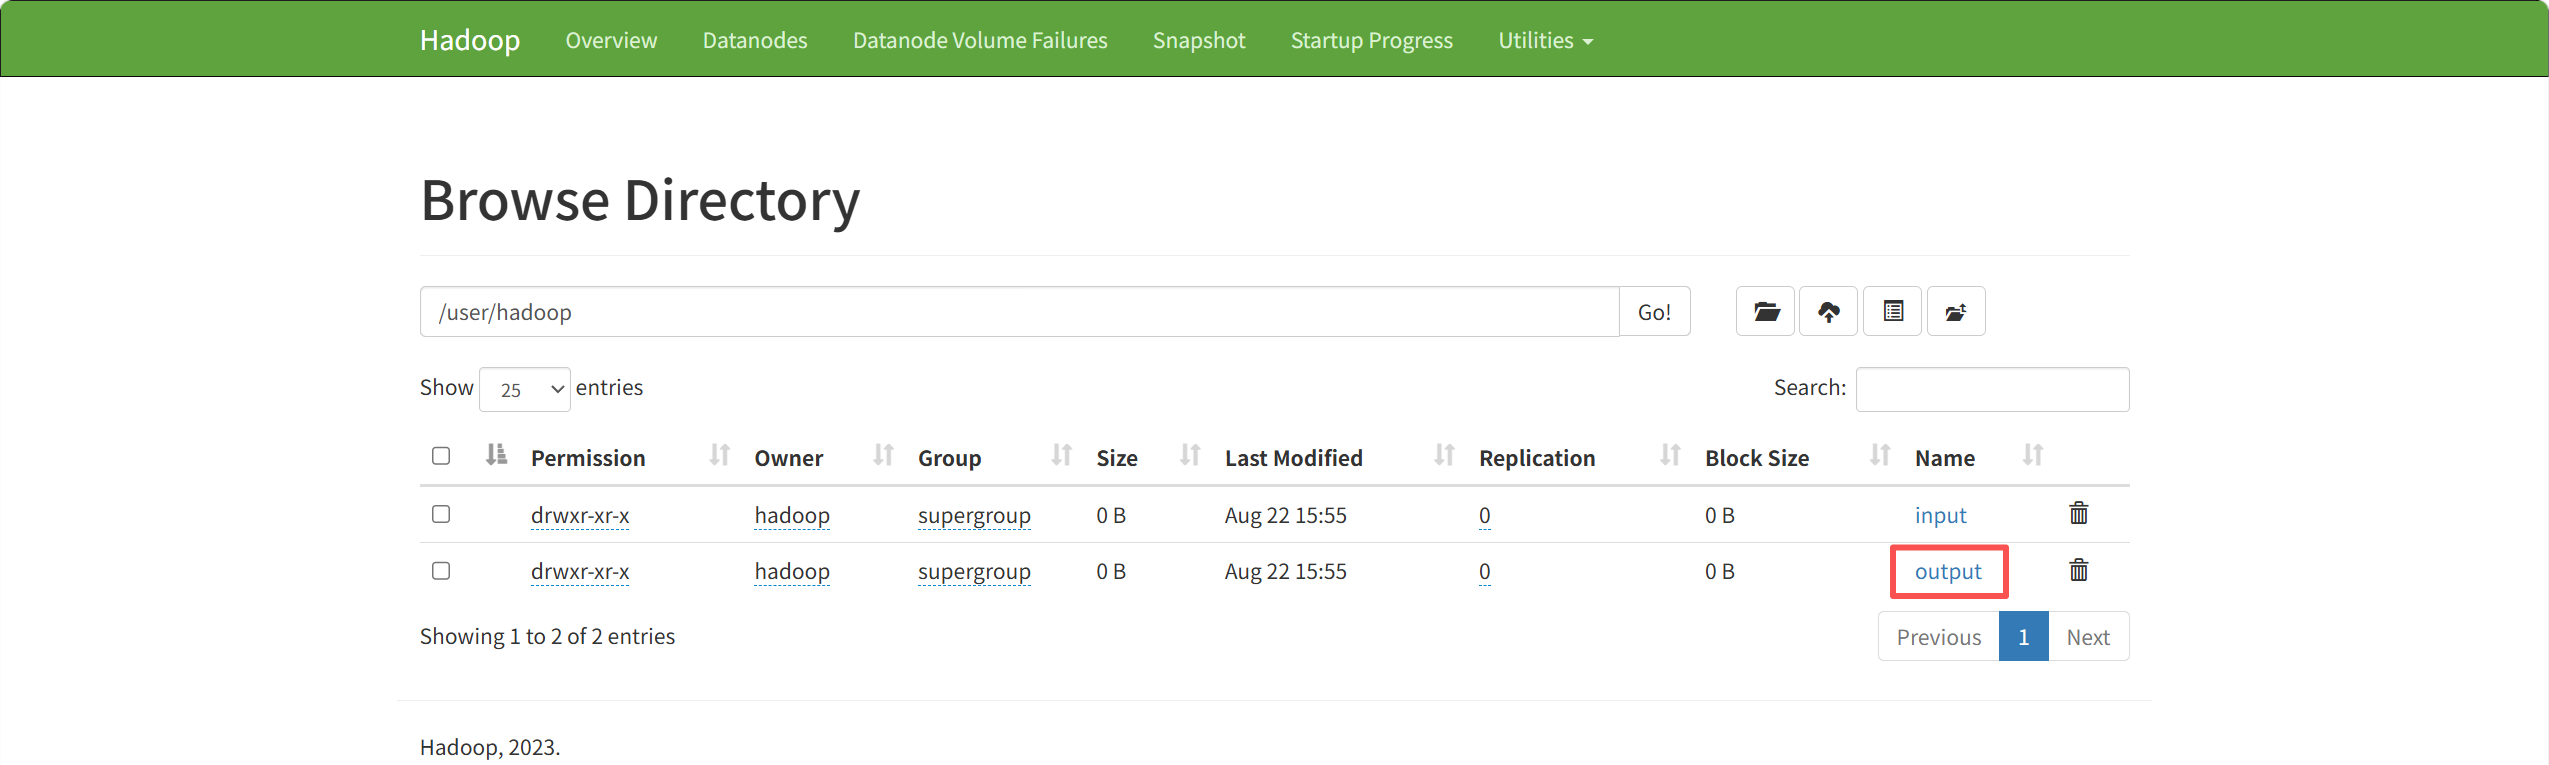
input、output: 在 HDFS 分布式文件系统,完整路径/user/hadoop/input、/user/hadoop/output,只能用bin/hdfs dfs -ls查看,在服务器本地直接 ls 看不到这个 output 文件夹,在前端网页可以查看
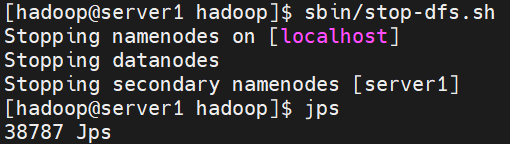
关闭 HDFS 整个集群,依次停止三个进程
[hadoop@server1 hadoop]$ sbin/stop-dfs.sh
[hadoop@server1 hadoop]$ jps
2 多节点完全分布式部署
官方文档:https://hadoop.apache.org/docs/stable/hadoop-project-dist/hadoop-common/SingleCluster.html#Download
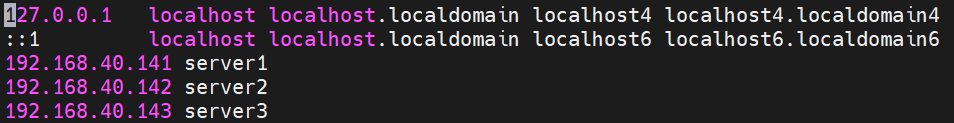
新开虚拟机 server2 和 server3 ,添加解析,并进行时间同步
vim /etc/hosts
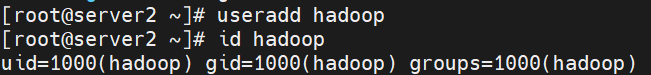
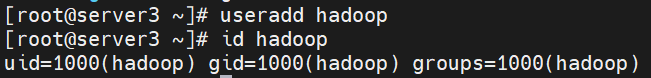
三个节点需要有相同的用户,uid 和 gid 都要相同
注意:不要随便修改用户的 uid 和 gid,会出现权限失效、看不见文件、读写报错、程序找不到数据的情况

三台机器均安装 nfs 用于共享数据
yum install -y nfs-utils
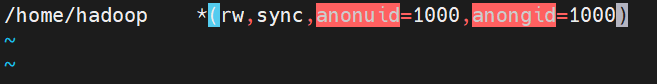
配置NFS共享目录,把远端访问权限映射为 hadoop,多节点挂载 /home/hadoop 共享目录时,客户端操作文件,归属人自动映射为服务端 hadoop 用户(uid=1000)
避免挂载后文件属主变成 nobody,出现权限报错、Hadoop 读写失败
[root@server1 ~]# vim /etc/exports
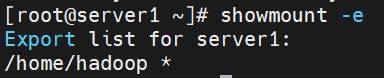
启动并开机自启NFS服务,查看本机对外发布的NFS共享目录
[root@server1 ~]# systemctl enable --now nfs
[root@server1 ~]# showmount -e
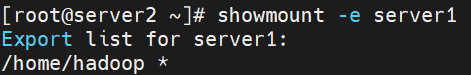
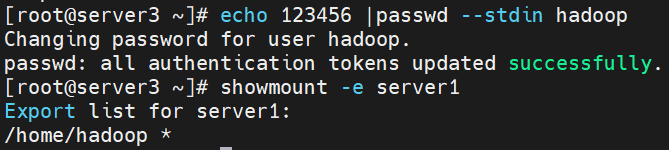
在 server2 查询 server1 上发布了哪些 NFS 共享目录
[root@server2 ~]# echo 123456 |passwd --stdin hadoop
# 最好每个节点密码相同
[root@server2 ~]# showmount -e server1
server3
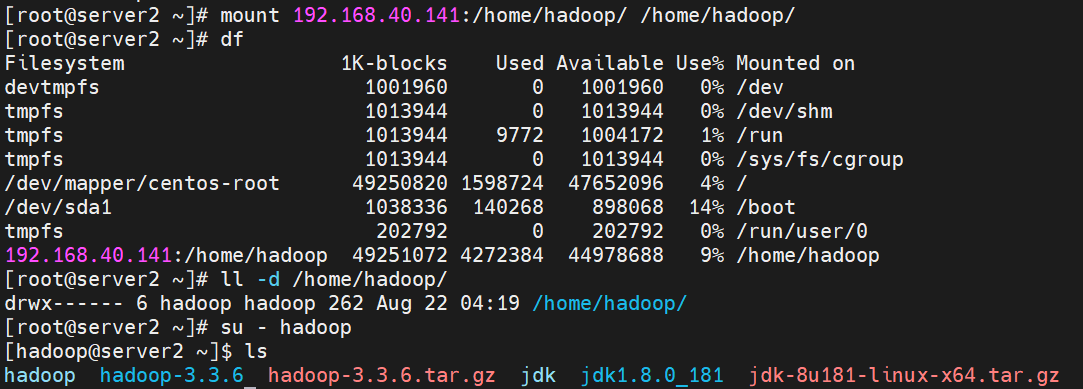
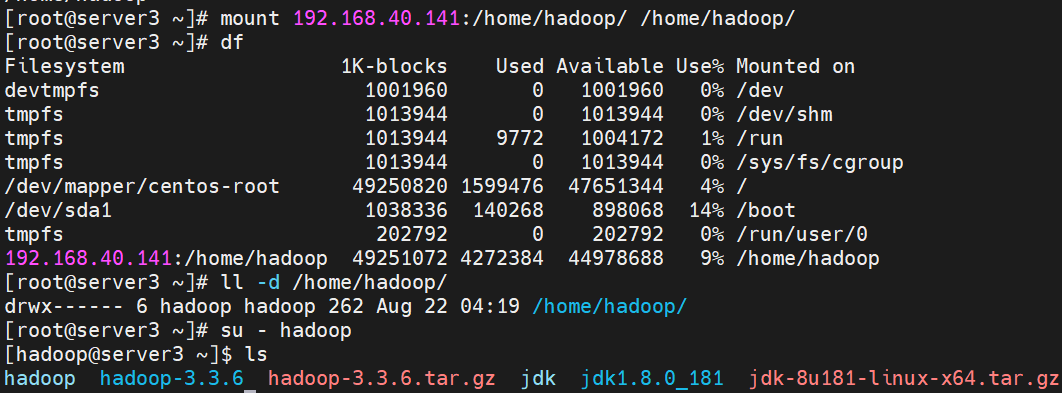
server2 和 server3 挂载,共享文件
mount 192.168.40.141:/home/hadoop/ /home/hadoop/
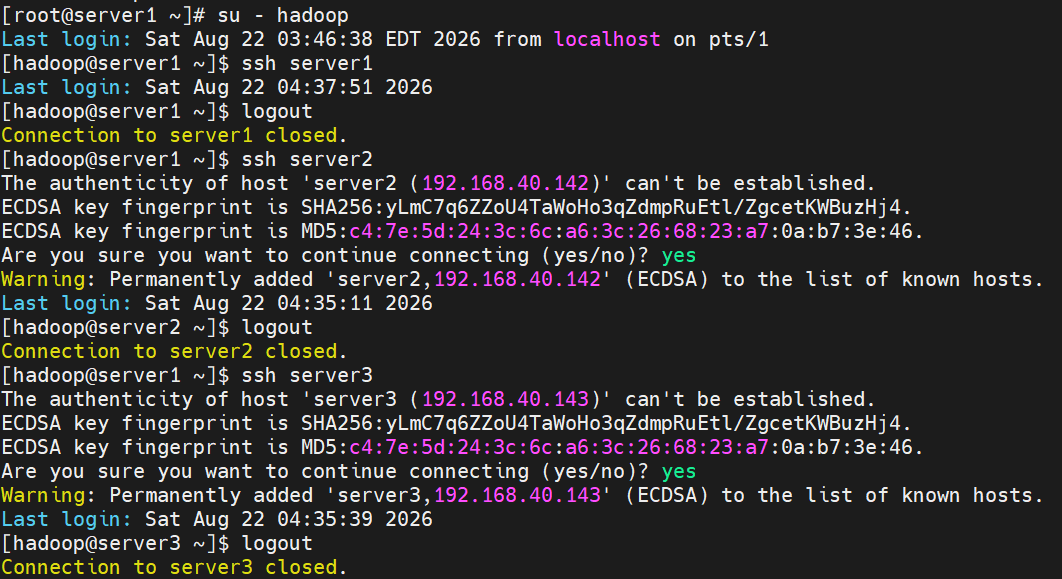
server1 远程连接各节点,保证/etc/hosts解析正常,ssh 端口互通,所有节点 hadoop 用户密码有效,可以正常登录
指定整个集群默认文件系统为 server1 上端口 9000 的 HDFS
[hadoop@server1 ~]$ cd hadoop/etc/hadoop/
[hadoop@server1 hadoop]$ vim core-site.xml
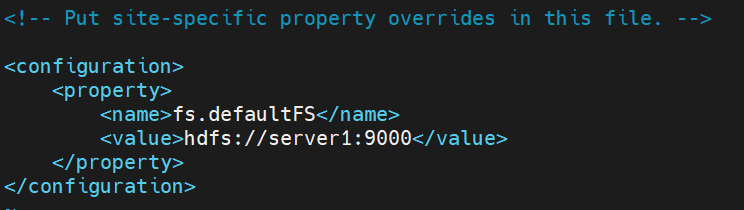
存 2 份副本
[hadoop@server1 hadoop]$ vim hdfs-site.xml
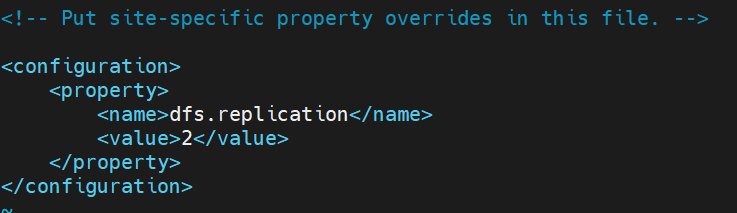
定义集群中所有 DataNode(数据节点)主机名,启动脚本会远程在这些机器拉起 DataNode 进程
[hadoop@server1 hadoop]$ vim workers
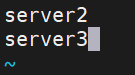
初始化 HDFS 文件系统,生成 NameNode 元数据,仅首次搭建执行
[hadoop@server1 hadoop]$ cd ../..
[hadoop@server1 hadoop]$ bin/hdfs namenode -format
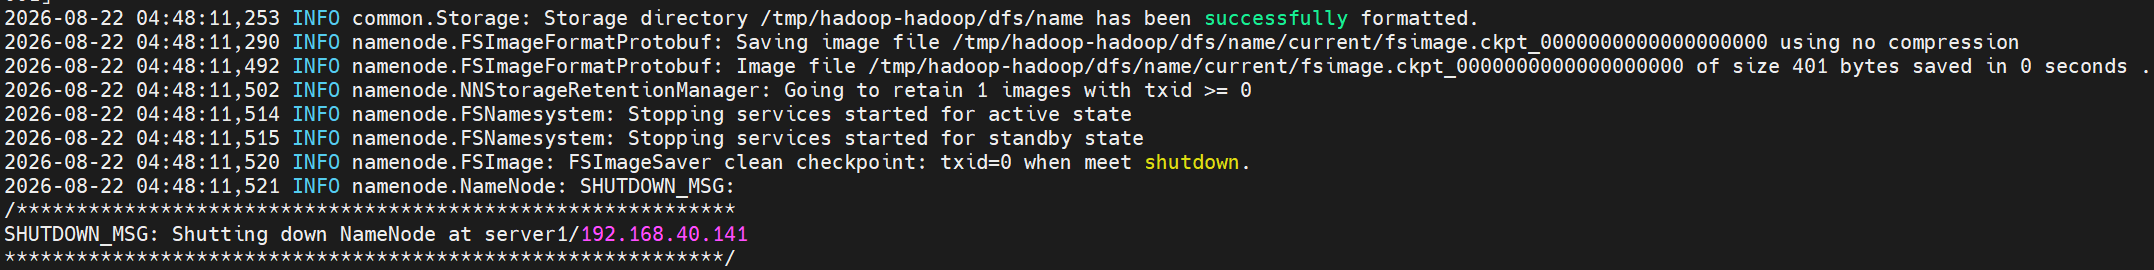
执行脚本一键启动 HDFS 集群(NameNode + 所有 workers 里配置的 DataNode)
[hadoop@server1 hadoop]$ sbin/start-dfs.sh
在前端可看到两个存活的节点
依旧使用官方示例测试
[hadoop@server1 hadoop]$ bin/hdfs dfs -mkdir /user
[hadoop@server1 hadoop]$ bin/hdfs dfs -mkdir /user/hadoop
[hadoop@server1 hadoop]$ bin/hdfs dfs -mkdir input
[hadoop@server1 hadoop]$ bin/hdfs dfs -put etc/hadoop/*.xml input
文件的数据块(Block 0)一共有 2 个副本,分别保存在 server2、server3 两台数据节点上
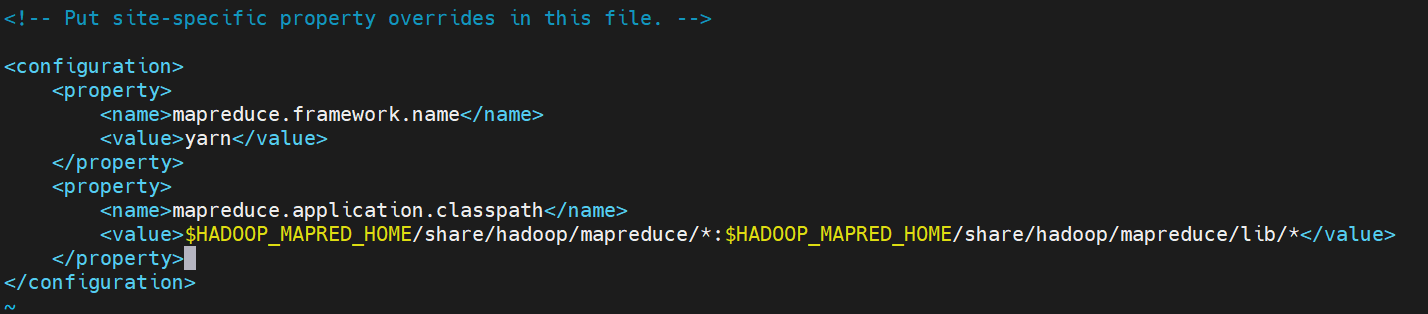
配置 MapReduce 运行调度框架为 YARN,并指定任务运行所需类库路径
[hadoop@server1 hadoop]$ vim etc/hadoop/mapred-site.xml
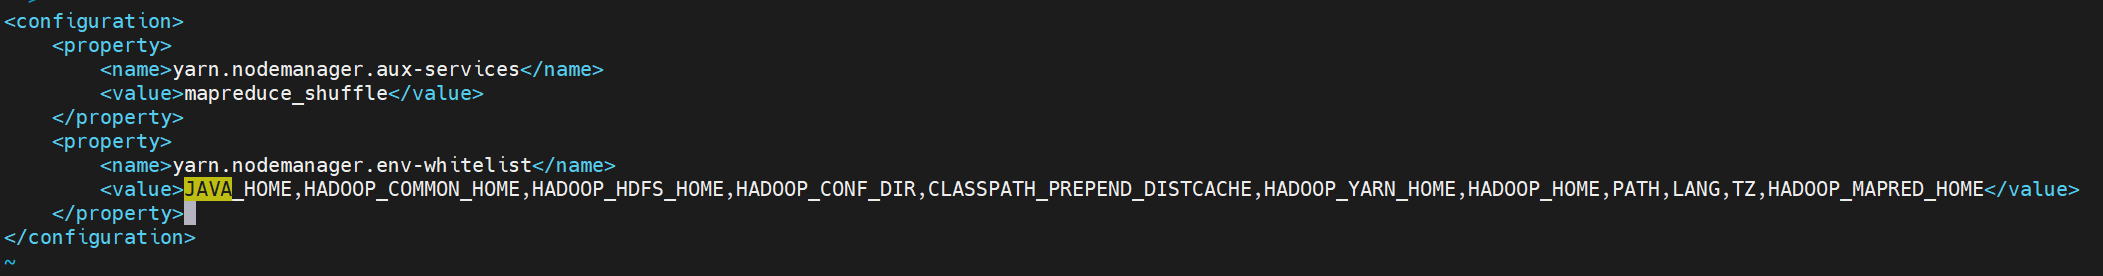
开启 MapReduce 所需的 shuffle 服务,配置 NodeManager 可传递至任务容器的环境变量白名单
[hadoop@server1 hadoop]$ vim etc/hadoop/yarn-site.xml
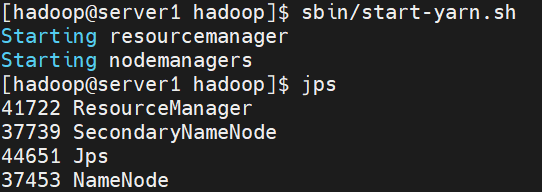
一键启动 YARN 集群(ResourceManager + 各节点 NodeManager)
[hadoop@server1 hadoop]$ sbin/start-yarn.sh
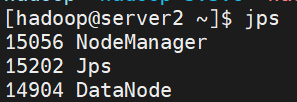
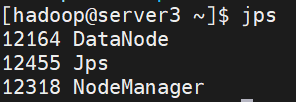
server2 和 server3 上也会开启 NodeManager
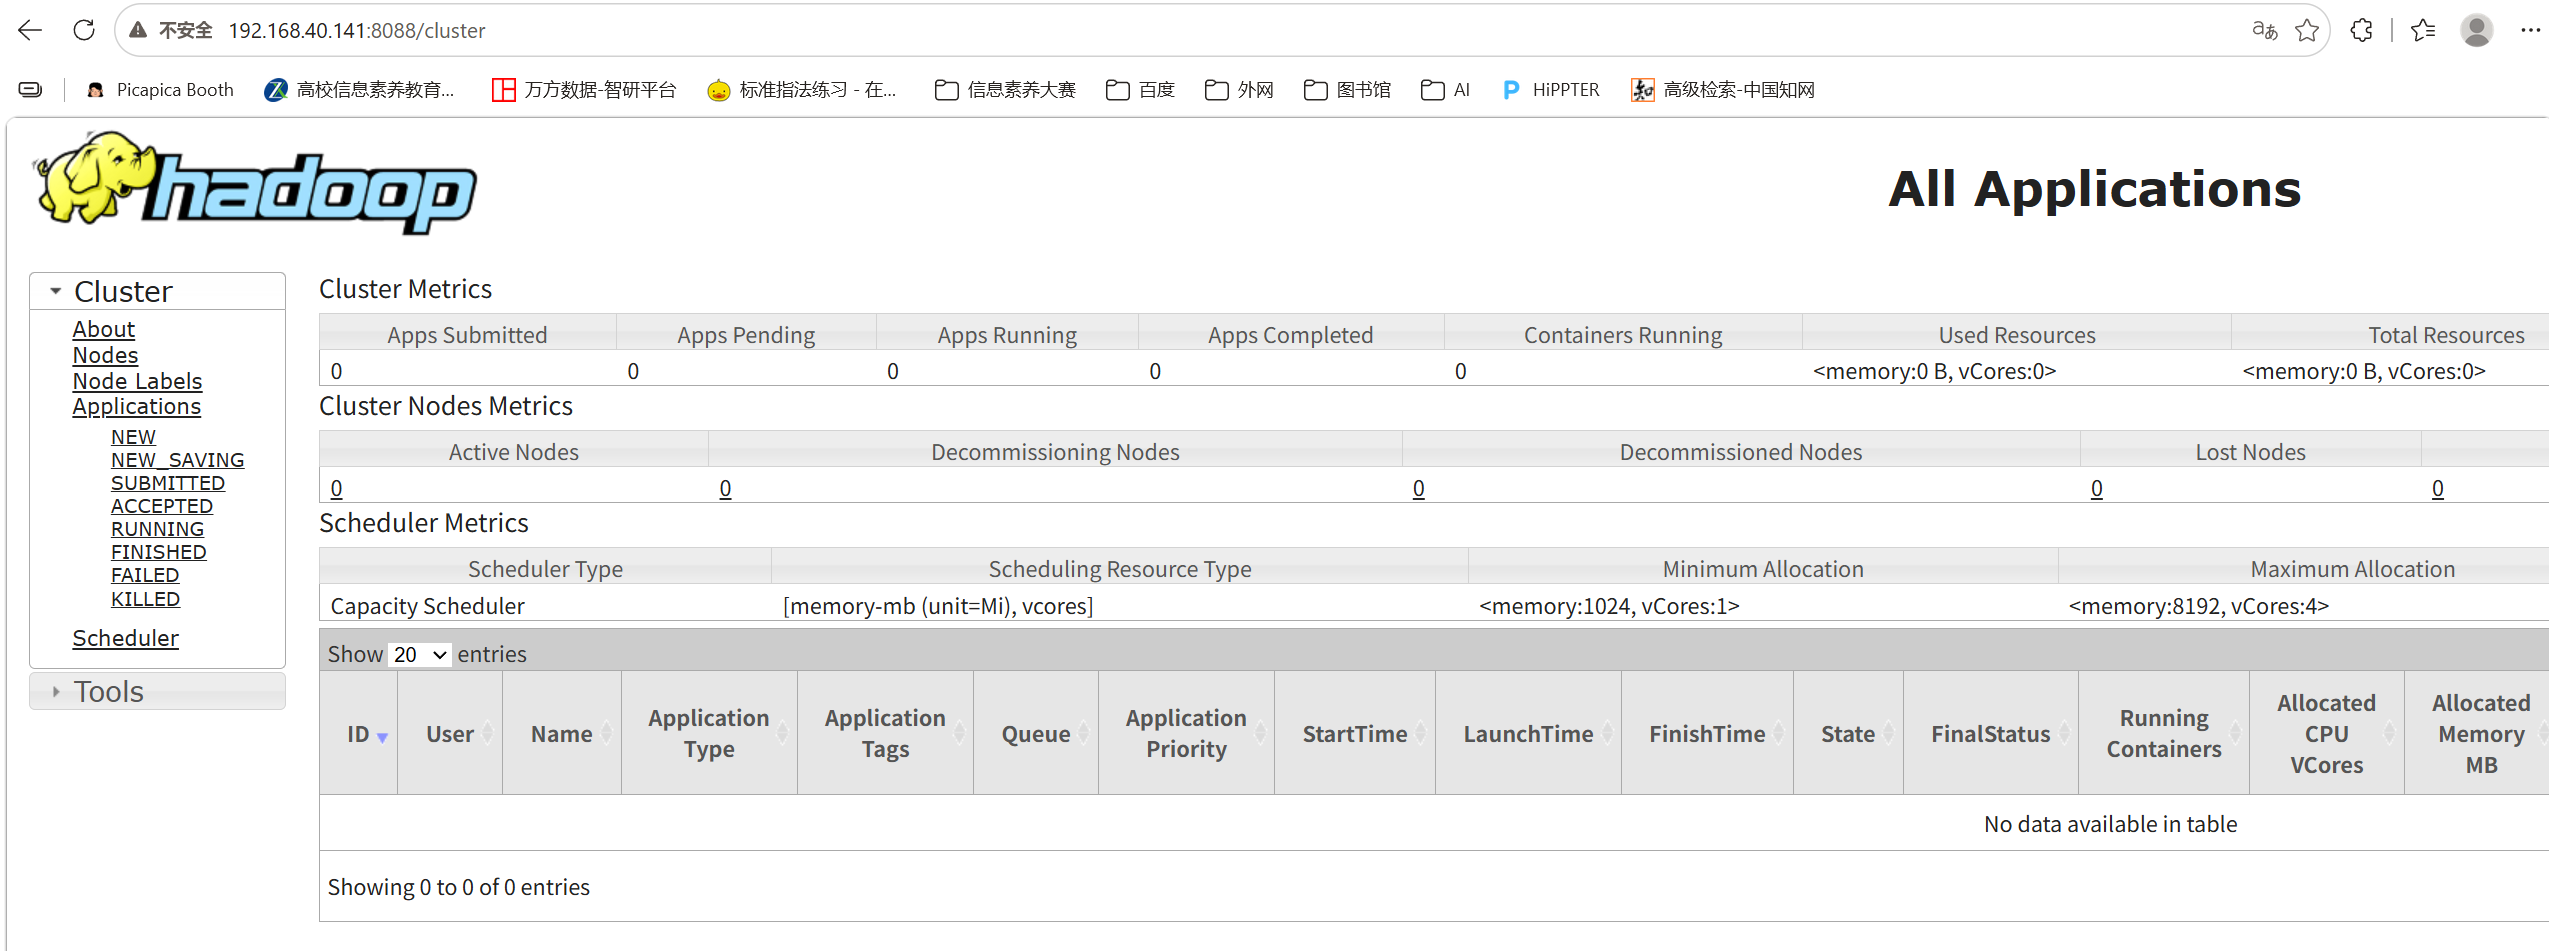
访问http://192.168.40.141:8088/ ResourceManager 前端监控界面,查看任务、节点资源
3 在线扩容
新开虚拟机 server4,各个节点同步解析,并进行时间同步
[root@server4 ~]# useradd hadoop
# 还是要保证 uid 和 gid 与其他节点相同
[root@server4 ~]# yum install -y nfs-utils
[root@server4 ~]# mount 192.168.40.141:/home/hadoop/ /home/hadoop/
所有节点之间相互免密
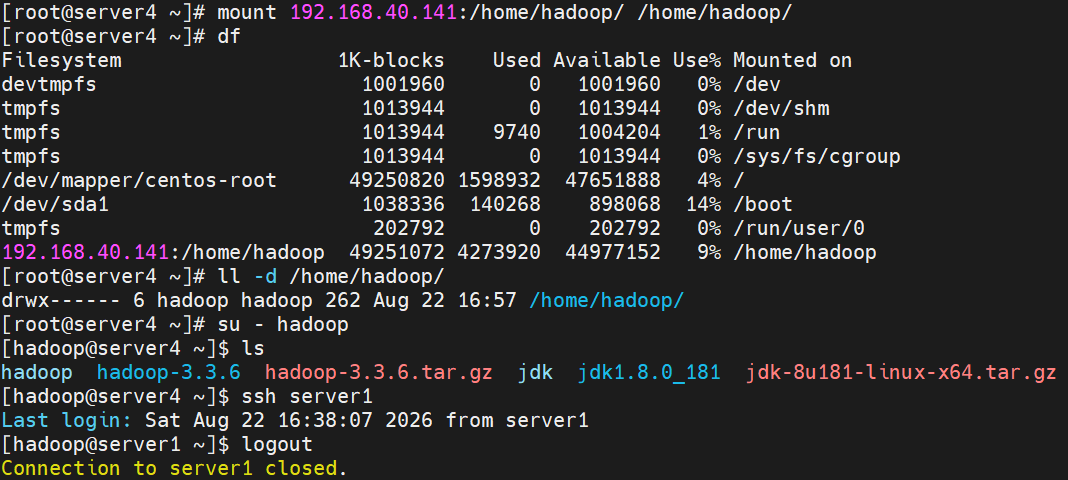
[root@server4 ~]# su - hadoop
[hadoop@server4 ~]$ cd hadoop
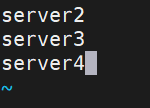
[hadoop@server4 hadoop]$ vim etc/hadoop/workers
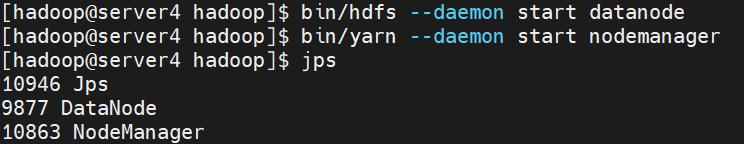
后台独立启动当前节点的 DataNode 数据存储进程和 NodeManager 资源管理进程
[hadoop@server4 hadoop]$ bin/hdfs --daemon start datanode
[hadoop@server4 hadoop]$ bin/yarn --daemon start nodemanager
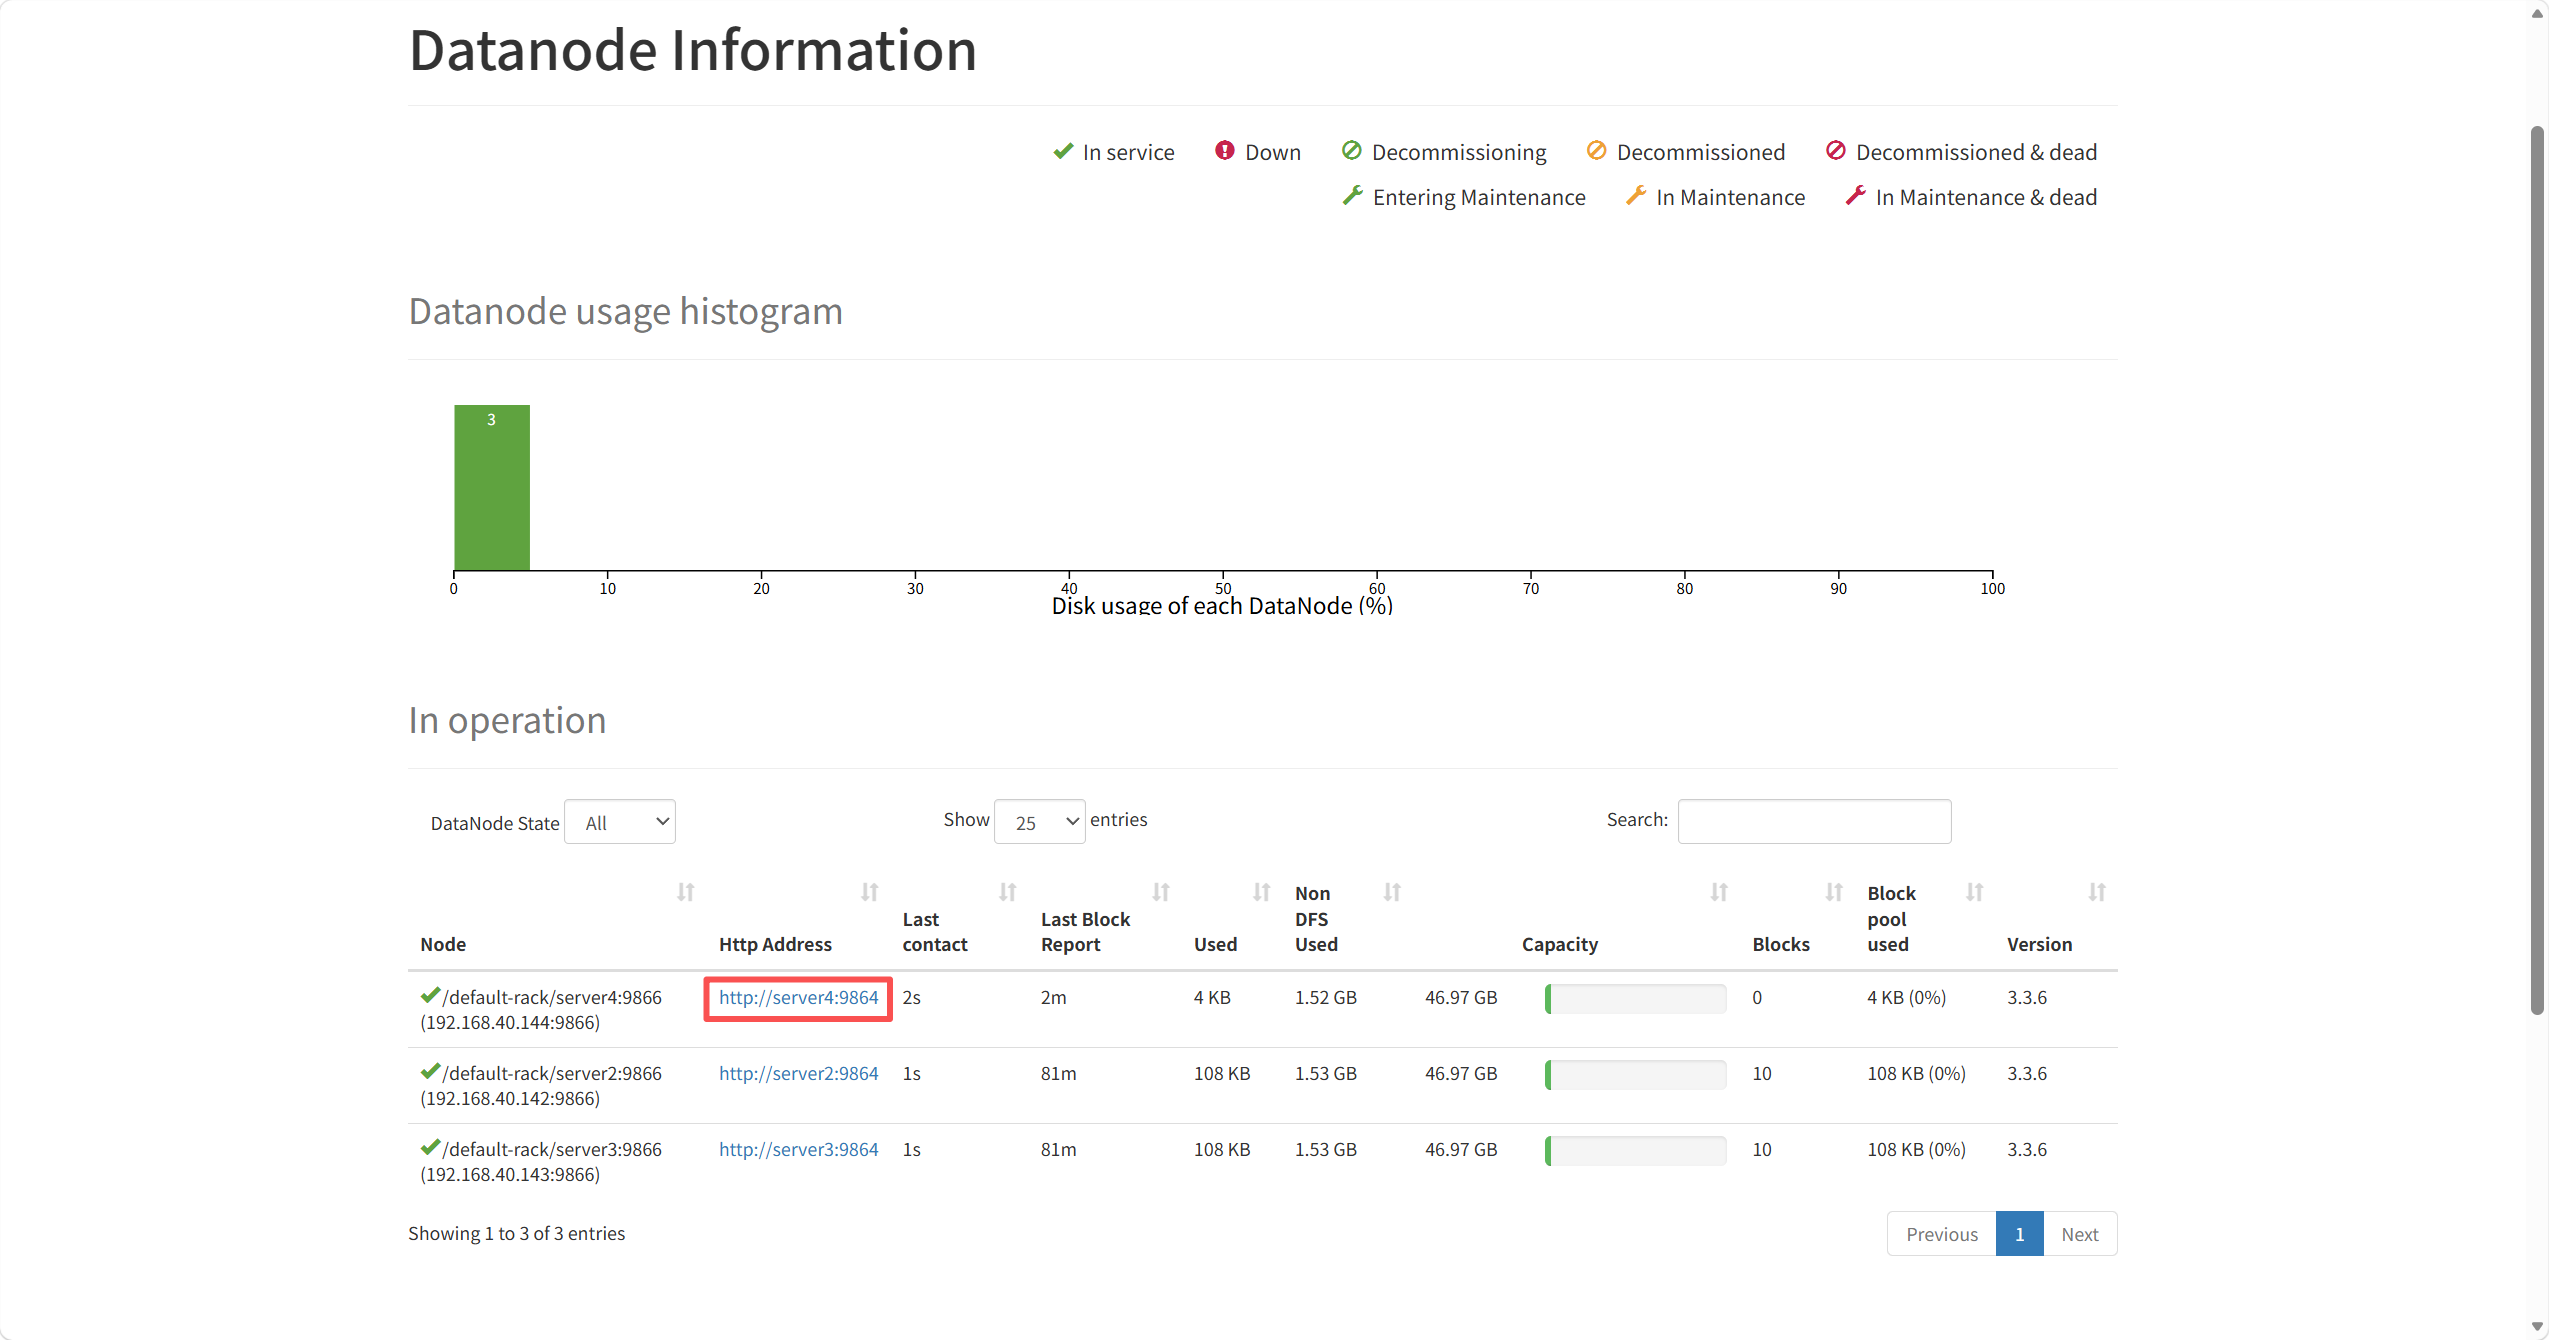
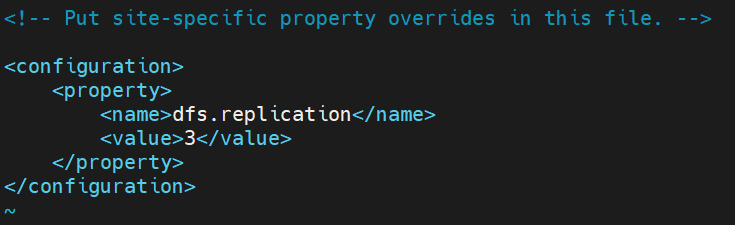
HDFS 文件副本数量改为3
[hadoop@server4 hadoop]$ vim etc/hadoop/hdfs-site.xml
更多推荐

 10
 0
- 0


 已为社区贡献5条内容

所有评论(0)