
Flink CDC 学习指南
Flink CDC 从零到一:数据开发工程师的实时数据集成入门指南
写在前面:如果你是一名刚接触实时数据同步的数据开发工程师,一定听过"CDC"这个词。也许你正在为业务库到数仓的 T+1 同步延迟而烦恼,也许你被 Canal + Kafka + 自己写消费者的复杂链路折腾得焦头烂额。这篇博客将带你从零开始,系统学习 Flink CDC 这一当前最流行的开源实时数据集成框架,从原理到实战,从 SQL 到 YAML Pipeline,从单机 Demo 到生产调优,帮你建立完整的知识体系。
目录
- CDC 概述
- Flink CDC 简介
- 核心原理与架构
- 环境搭建
- Flink CDC SQL 方式(重点)
- DataStream API 方式
- Sink 集成(重点实战)
- 整库同步与数据集成(3.x 核心)
- 实时数仓典型架构
- 性能调优
- 常见问题与踩坑
- Flink CDC 3.x 新特性深度解析
- 端到端实战项目
- 学习路线与资源
- 总结
1. CDC 概述
1.1 什么是 CDC
CDC(Change Data Capture,变更数据捕获) 是一种用于捕获数据库中数据变更(INSERT / UPDATE / DELETE)的技术。它能够监测并捕获源数据库的变动记录,将这些变更按发生顺序完整地传递给下游系统。
与传统的批量数据抽取不同,CDC 是事件驱动的——数据一变,即刻捕获,实时性可达毫秒到秒级。这使它成为构建实时数据管道的基石。
1.2 CDC 与传统 ETL 方式的对比
| 对比维度 | 轮询查询(Polling) | 触发器(Trigger) | 双写(Dual Write) | 日志解析(Log-based CDC) |
|---|---|---|---|---|
| 实时性 | 低(分钟/小时级) | 高 | 高 | 高(毫秒/秒级) |
| 性能影响 | 频繁查询增加 DB 压力 | 触发器开销大 | 业务侵入强 | 几乎无影响 |
| 能否捕获删除 | 困难(软删除可行) | 能 | 需业务保证 | 能 |
| 数据完整性 | 可能丢失中间状态 | 完整 | 易不一致 | 完整 |
| 业务侵入 | 无 | 高(建触发器) | 高(改代码) | 无 |
| 架构复杂度 | 低 | 中 | 高(分布式事务) | 中 |
| 典型工具 | Sqoop、DataX、Kafka JDBC Source | 自研存储过程 | 业务代码中实现 | Canal、Debezium、Flink CDC |
日志解析方案在实时性、性能和完整性上优势明显,是目前工业界的主流选择。
1.3 CDC 的两种模式
- 查询式 CDC(Query-based):通过定时执行 SQL 查询获取变更数据,通常需要时间戳或版本号字段。实现简单但延迟高、无法捕获删除和中间状态。
- 日志式 CDC(Log-based):直接解析数据库的事务日志(如 MySQL Binlog、PostgreSQL WAL、Oracle Redo Log),实时获取所有变更事件。实现复杂但实时性高、对业务无侵入。
Flink CDC 属于日志式 CDC,底层基于 Debezium 引擎进行日志解析。
1.4 CDC 典型应用场景
- 实时数仓建设:业务库数据实时同步到 Kafka / Doris / StarRocks / 数据湖
- 异构数据同步:MySQL → PostgreSQL、Oracle → MySQL 等跨库迁移
- 缓存更新:数据库变更自动刷新 Redis 缓存,避免 Cache Aside 模式的一致性问题
- 审计与合规:完整记录每次数据变更的前后值和时间戳
- 异地多活:跨数据中心的数据复制与同步
- CQRS(命令查询职责分离):将写模型的变更同步到读模型,支撑高并发查询
- 数据分发:一份变更数据实时推送到多个下游存储(ES、Redis、OLAP 引擎等)
2. Flink CDC 简介
2.1 Flink CDC 是什么
Flink CDC 是 Apache Flink 社区开源的实时数据集成框架,它提供了一组 Source Connector,能够直接从 MySQL、PostgreSQL、Oracle 等数据库中全量读取历史数据 + 持续读取增量变更,无需借助 Kafka 等中间件中转。
Flink CDC 底层封装了 Debezium 引擎进行日志解析,但在上层做了大量增强:与 Flink 的 Checkpoint 机制深度集成、支持并行快照、提供 SQL 和 YAML 两种声明式 API。
据《Apache Flink CDC 3.2.0 Release Announcement》介绍,截至 3.2 版本,Flink CDC 已支持 MySQL、PostgreSQL、Oracle、SQL Server、MongoDB、DB2、OceanBase、TiDB、Vitess 等数据源。
2.2 发展历史
| 版本 | 时间 | 核心特性 |
|---|---|---|
| 1.x | 2020-2021 | DataStream API;单表读取;基于 Debezium Embedded Engine;SourceFunction 单并发;全量阶段需加锁 |
| 2.x | 2021-2023 | Flink SQL 支持;增量快照算法(无锁、并行、Checkpoint);整库同步雏形;无锁快照;支持 Oracle / MongoDB / SQL Server 等多数据源;动态加表 |
| 3.0 | 2023.11 | 架构重构:Pipeline Connector + YAML 声明式整库同步;Schema Evolution 自动同步;Source Coordinator + Split Assigner;分库分表合并;自动缩容 |
| 3.1 | 2024.05 | Transform 数据变换(投影/计算/过滤);表合并路由;新增 Kafka / Paimon Pipeline Sink;MySQL tables.exclude 选项 |
| 3.2 | 2024.09 | 可定制 Schema Evolution(Lenient/TryEvolve 模式 + 事件类型级控制);Transform UDF 支持;复杂路由(一对多广播/模式替换);新增 Elasticsearch Pipeline Sink;K8s 部署模式 |
| 3.2.1 | 2024.11 | Bug 修复版本,修复事务泄漏、Schema Evolution 失败、Paimon 重复提交等关键问题 |
2.3 Flink CDC 核心能力
- 全量 + 增量一体化:先快照读取存量数据,无缝切换到 Binlog 增量消费
- 无锁并行快照:增量快照算法无需
FLUSH TABLES WITH READ LOCK,支持多并发读取 - 断点续传:基于 Flink Checkpoint,chunk 级别容错,故障后从上次完成位置恢复
- Exactly-Once 语义:与 Flink Checkpoint 协同,保证端到端精确一次
- 整库同步:YAML 配置一行命令完成整库级数据同步
- Schema Evolution:上游 DDL 变更自动同步到下游
- 数据变换与路由:Transform 投影/过滤/计算,Route 支持分库分表合并
- 丰富的生态:支持写入 Kafka、Doris、StarRocks、Paimon、Iceberg、Hudi、Elasticsearch 等
2.4 支持的数据源
| 数据源 | 类型 | 支持版本 | Pipeline Source | SQL Source |
|---|---|---|---|---|
| MySQL | 关系型 | 5.6, 5.7, 8.0.x | ✅ | ✅ |
| PostgreSQL | 关系型 | 9.6+ | ✅ (3.5+) | ✅ |
| Oracle | 关系型 | 11g+ | ✅ (3.6+) | ✅ |
| SQL Server | 关系型 | 2012+ | — | ✅ |
| MongoDB | 文档型 | 3.6+ | — | ✅ |
| DB2 | 关系型 | 11.5+ | — | ✅ |
| OceanBase | 关系型 | 3.1.x+ | — | ✅ |
| TiDB | 关系型 | 5.1+ | — | ✅ |
| Vitess | 关系型 | — | — | ✅ |
Pipeline Sink 方面,3.x 已支持 Doris、StarRocks、Kafka、Paimon、Elasticsearch、Iceberg、Hudi(3.6+)、Fluss(3.5+)。
2.5 Flink CDC vs Debezium vs Canal vs Maxwell
| 对比维度 | Flink CDC | Debezium | Canal | Maxwell |
|---|---|---|---|---|
| 定位 | 分布式实时数据集成框架 | Kafka Connect 上的 CDC 插件 | MySQL Binlog 订阅组件 | MySQL Binlog 订阅守护进程 |
| 全量同步 | ✅ 内置并行无锁快照 | ✅ 但单线程加锁 | ❌ 需 DataX 等辅助 | ✅ 单表初始化 |
| 增量同步 | ✅ | ✅ | ✅ | ✅ |
| 并行度 | 快照阶段可水平扩展 | 单 Task(快照可多线程) | 单线程 | 单线程 |
| 锁表 | ❌ 无需锁(3.x 增量快照) | ⚠️ 全量阶段需锁 | — | — |
| 数据源 | 10+ 种 | 10+ 种 | 仅 MySQL | 仅 MySQL |
| 计算能力 | ✅ Flink SQL/DataStream 强大 ETL | ❌ 仅捕获+投递 | ❌ | ❌ |
| Schema Evolution | ✅ 自动同步 | ⚠️ 有限支持 | ❌ | ❌ |
| 整库同步 | ✅ YAML 声明式 | ⚠️ 需配置多 Connector | ❌ | ❌ |
| 依赖 | Flink 集群 | Kafka Connect 集群 | ZooKeeper | 无 |
| 高可用 | Flink HA | Kafka Connect HA | ZooKeeper HA | 无 |
| 断点续传 | Flink Checkpoint | Kafka Offset | 本地/ZK | Binlog 位点 |
| 社区活跃度 | 最高(Apache 顶级子项目) | 高(Red Hat 维护) | 中(阿里巴巴) | 低 |
小结:如果你需要"捕获 + 计算 + 写入"一体化方案,Flink CDC 是最佳选择;如果只需要简单地把 Binlog 投递到 Kafka 且不想引入 Flink,Canal / Maxwell 也够用;Debezium 适合已有 Kafka Connect 生态的团队。
3. 核心原理与架构
3.1 基于数据库日志的解析原理
以 MySQL 为例,Binlog(二进制日志)记录了所有对数据库进行修改的事件(INSERT/UPDATE/DELETE/DDL)。MySQL 主从复制正是依赖 Binlog 实现的。
Flink CDC 伪装成 MySQL 的一个从节点(Slave),向主库发送 COM_BINLOG_DUMP 命令,持续接收 Binlog 事件流,然后通过 Debezium 的解析器将二进制事件解码为结构化的变更记录。
关键前提:
- Binlog 格式必须为 ROW:STATEMENT 格式记录的是原始 SQL,无法准确获取每行变更前后的数据
binlog_row_image=FULL:确保 Binlog 中同时包含变更前和变更后的完整行镜像
PostgreSQL 使用逻辑解码(Logical Decoding)输出 WAL,Oracle 使用 LogMiner 或 XStream,原理类似。
3.2 全量快照 + 增量同步两阶段流程
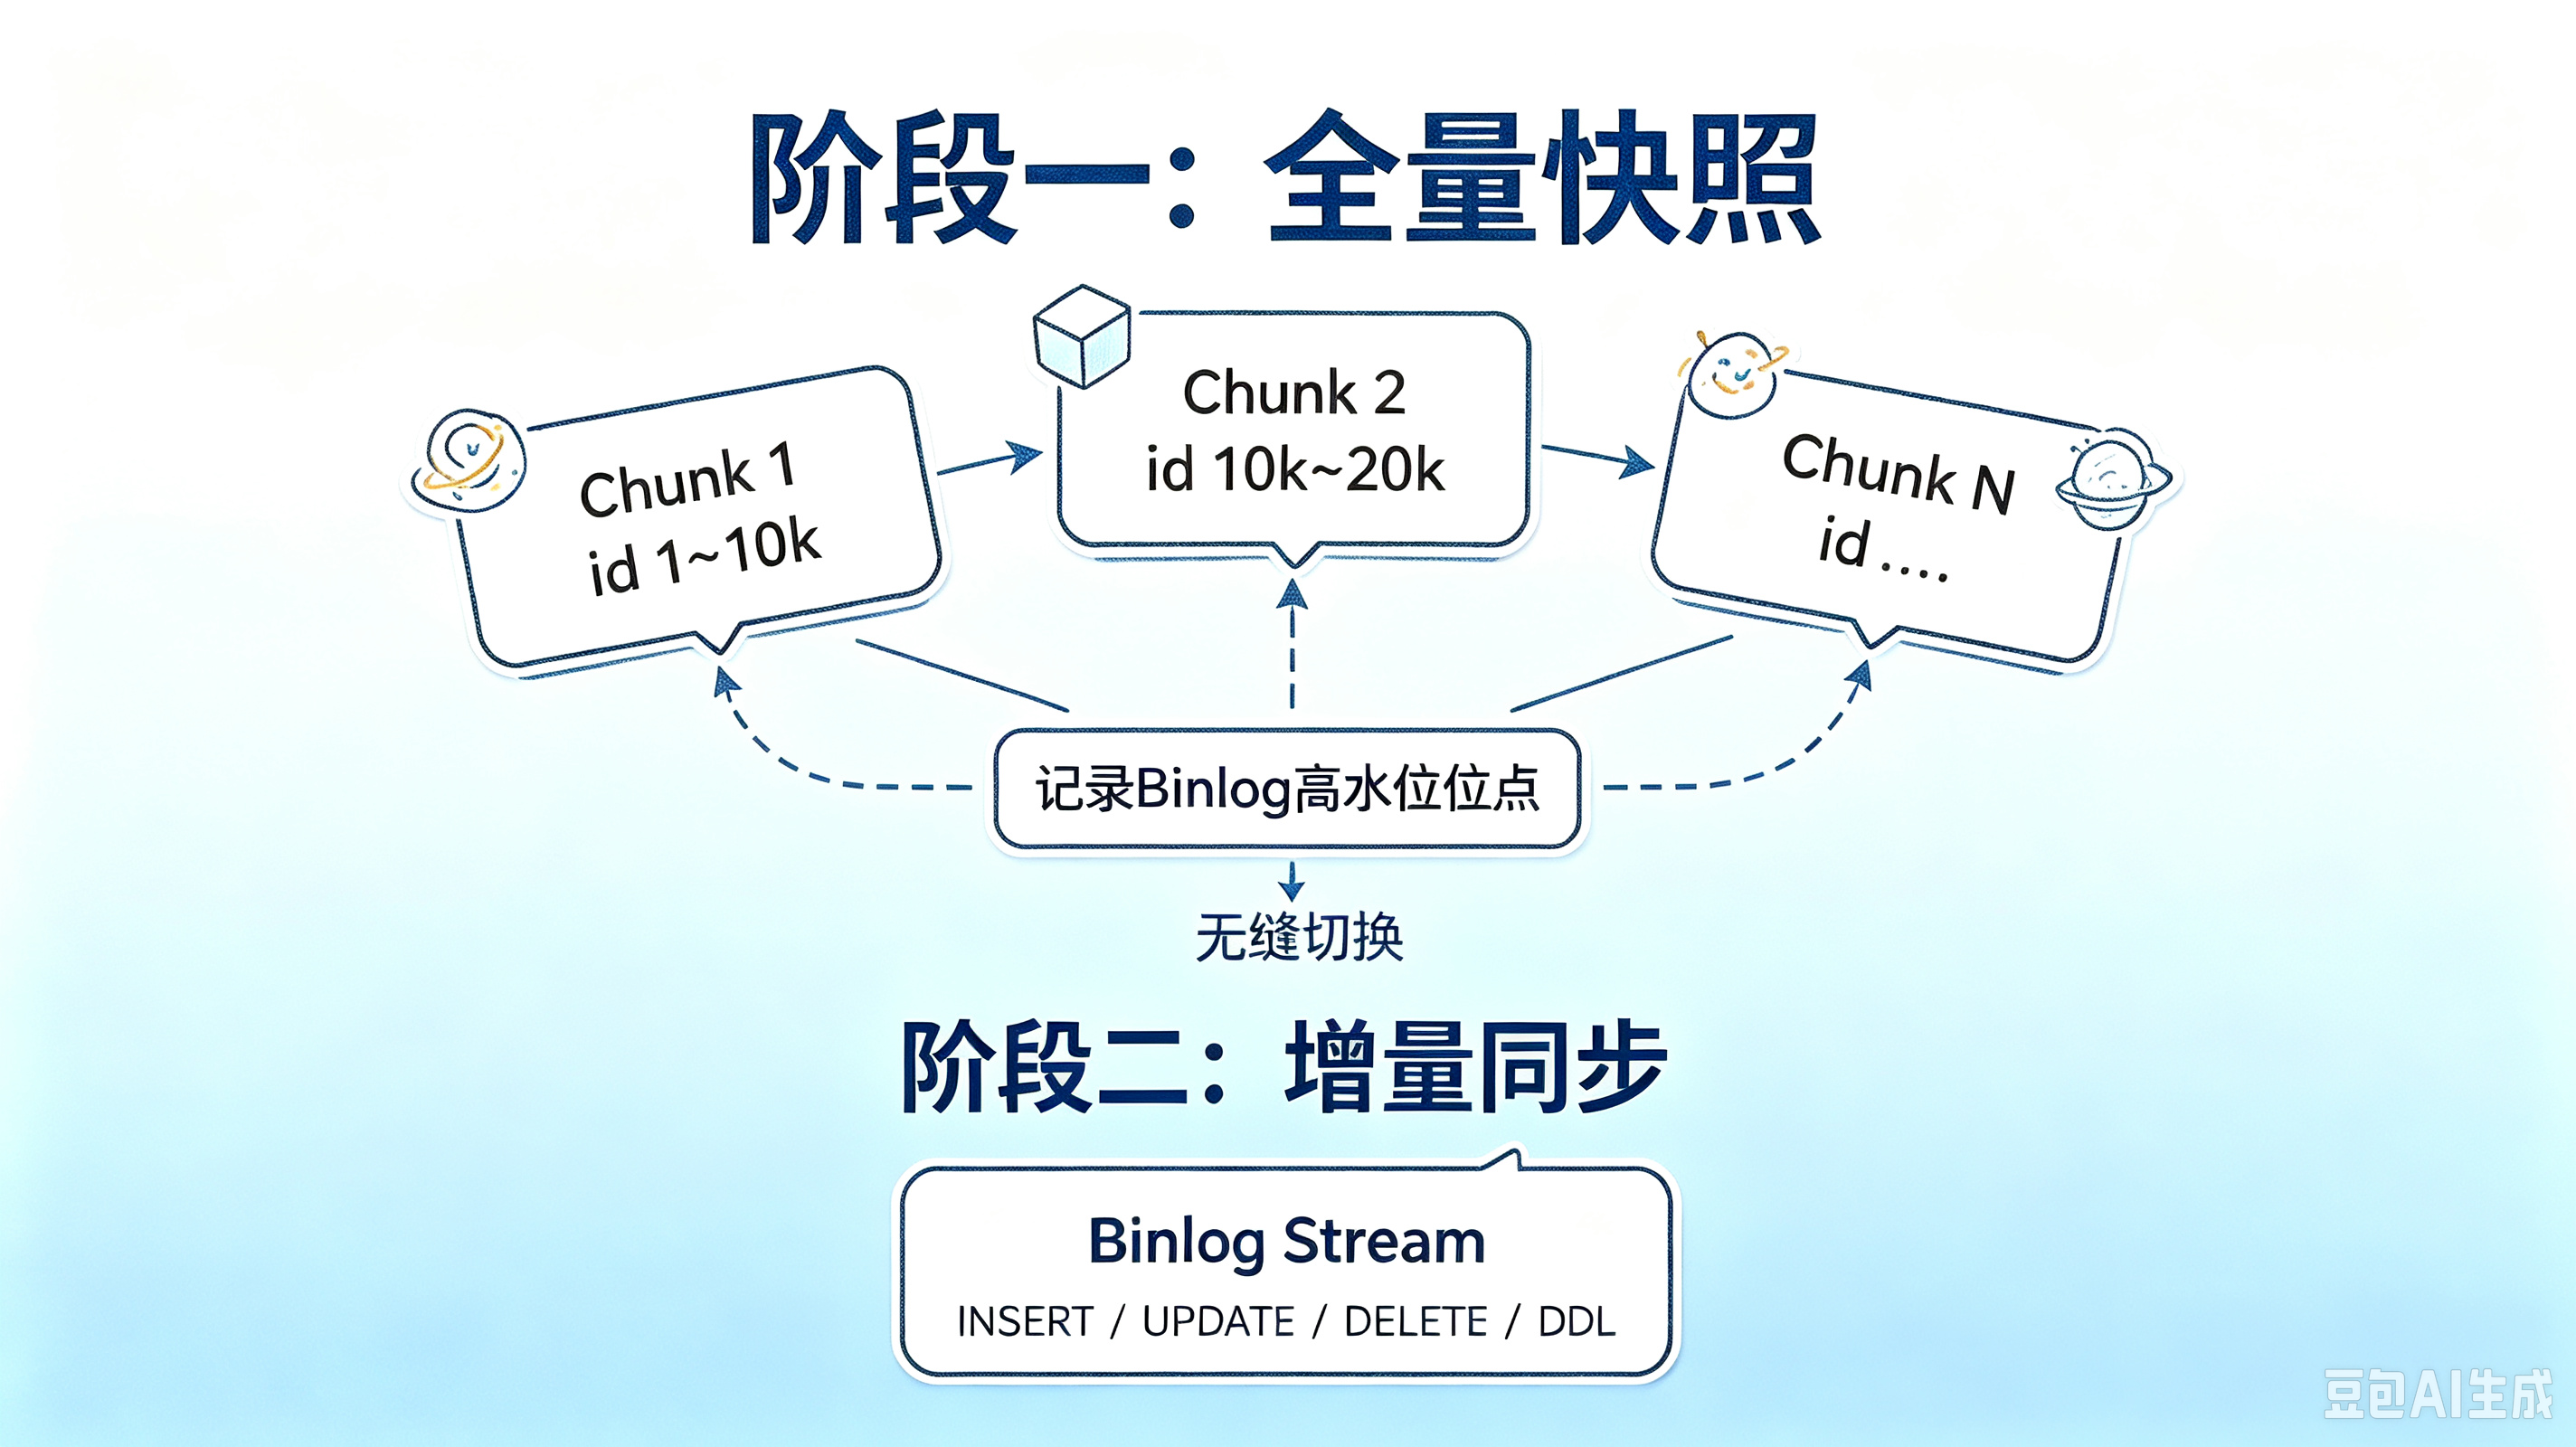
两阶段切换的关键:在所有 Chunk 快照读取完成后,Source 会等待一次完整的 Checkpoint 完成(确保所有快照数据已被下游消费),然后从快照结束时记录的 Binlog 位点开始持续消费增量日志,保证数据不丢不重。
3.3 Flink CDC 2.x 架构
2.x 版本基于 Flink 的 FLIP-27 Source API 重构,引入了增量快照框架:
- MySqlSourceEnumerator(运行在 JobManager):负责将表按主键切分为 Chunk,并将 Chunk 分配给 Reader
- MySqlSourceReader(运行在 TaskManager):并行读取分配到的 Chunk 数据
- 快照阶段多 Reader 并行,增量阶段单 Reader 读取 Binlog 保证顺序
- 底层仍使用 Debezium Embedded Engine 解析 Binlog
但 2.x 仍有局限:只面向单表 SQL Source,缺乏端到端整库同步能力,Schema 变更处理薄弱。
3.4 Flink CDC 3.x 架构重构
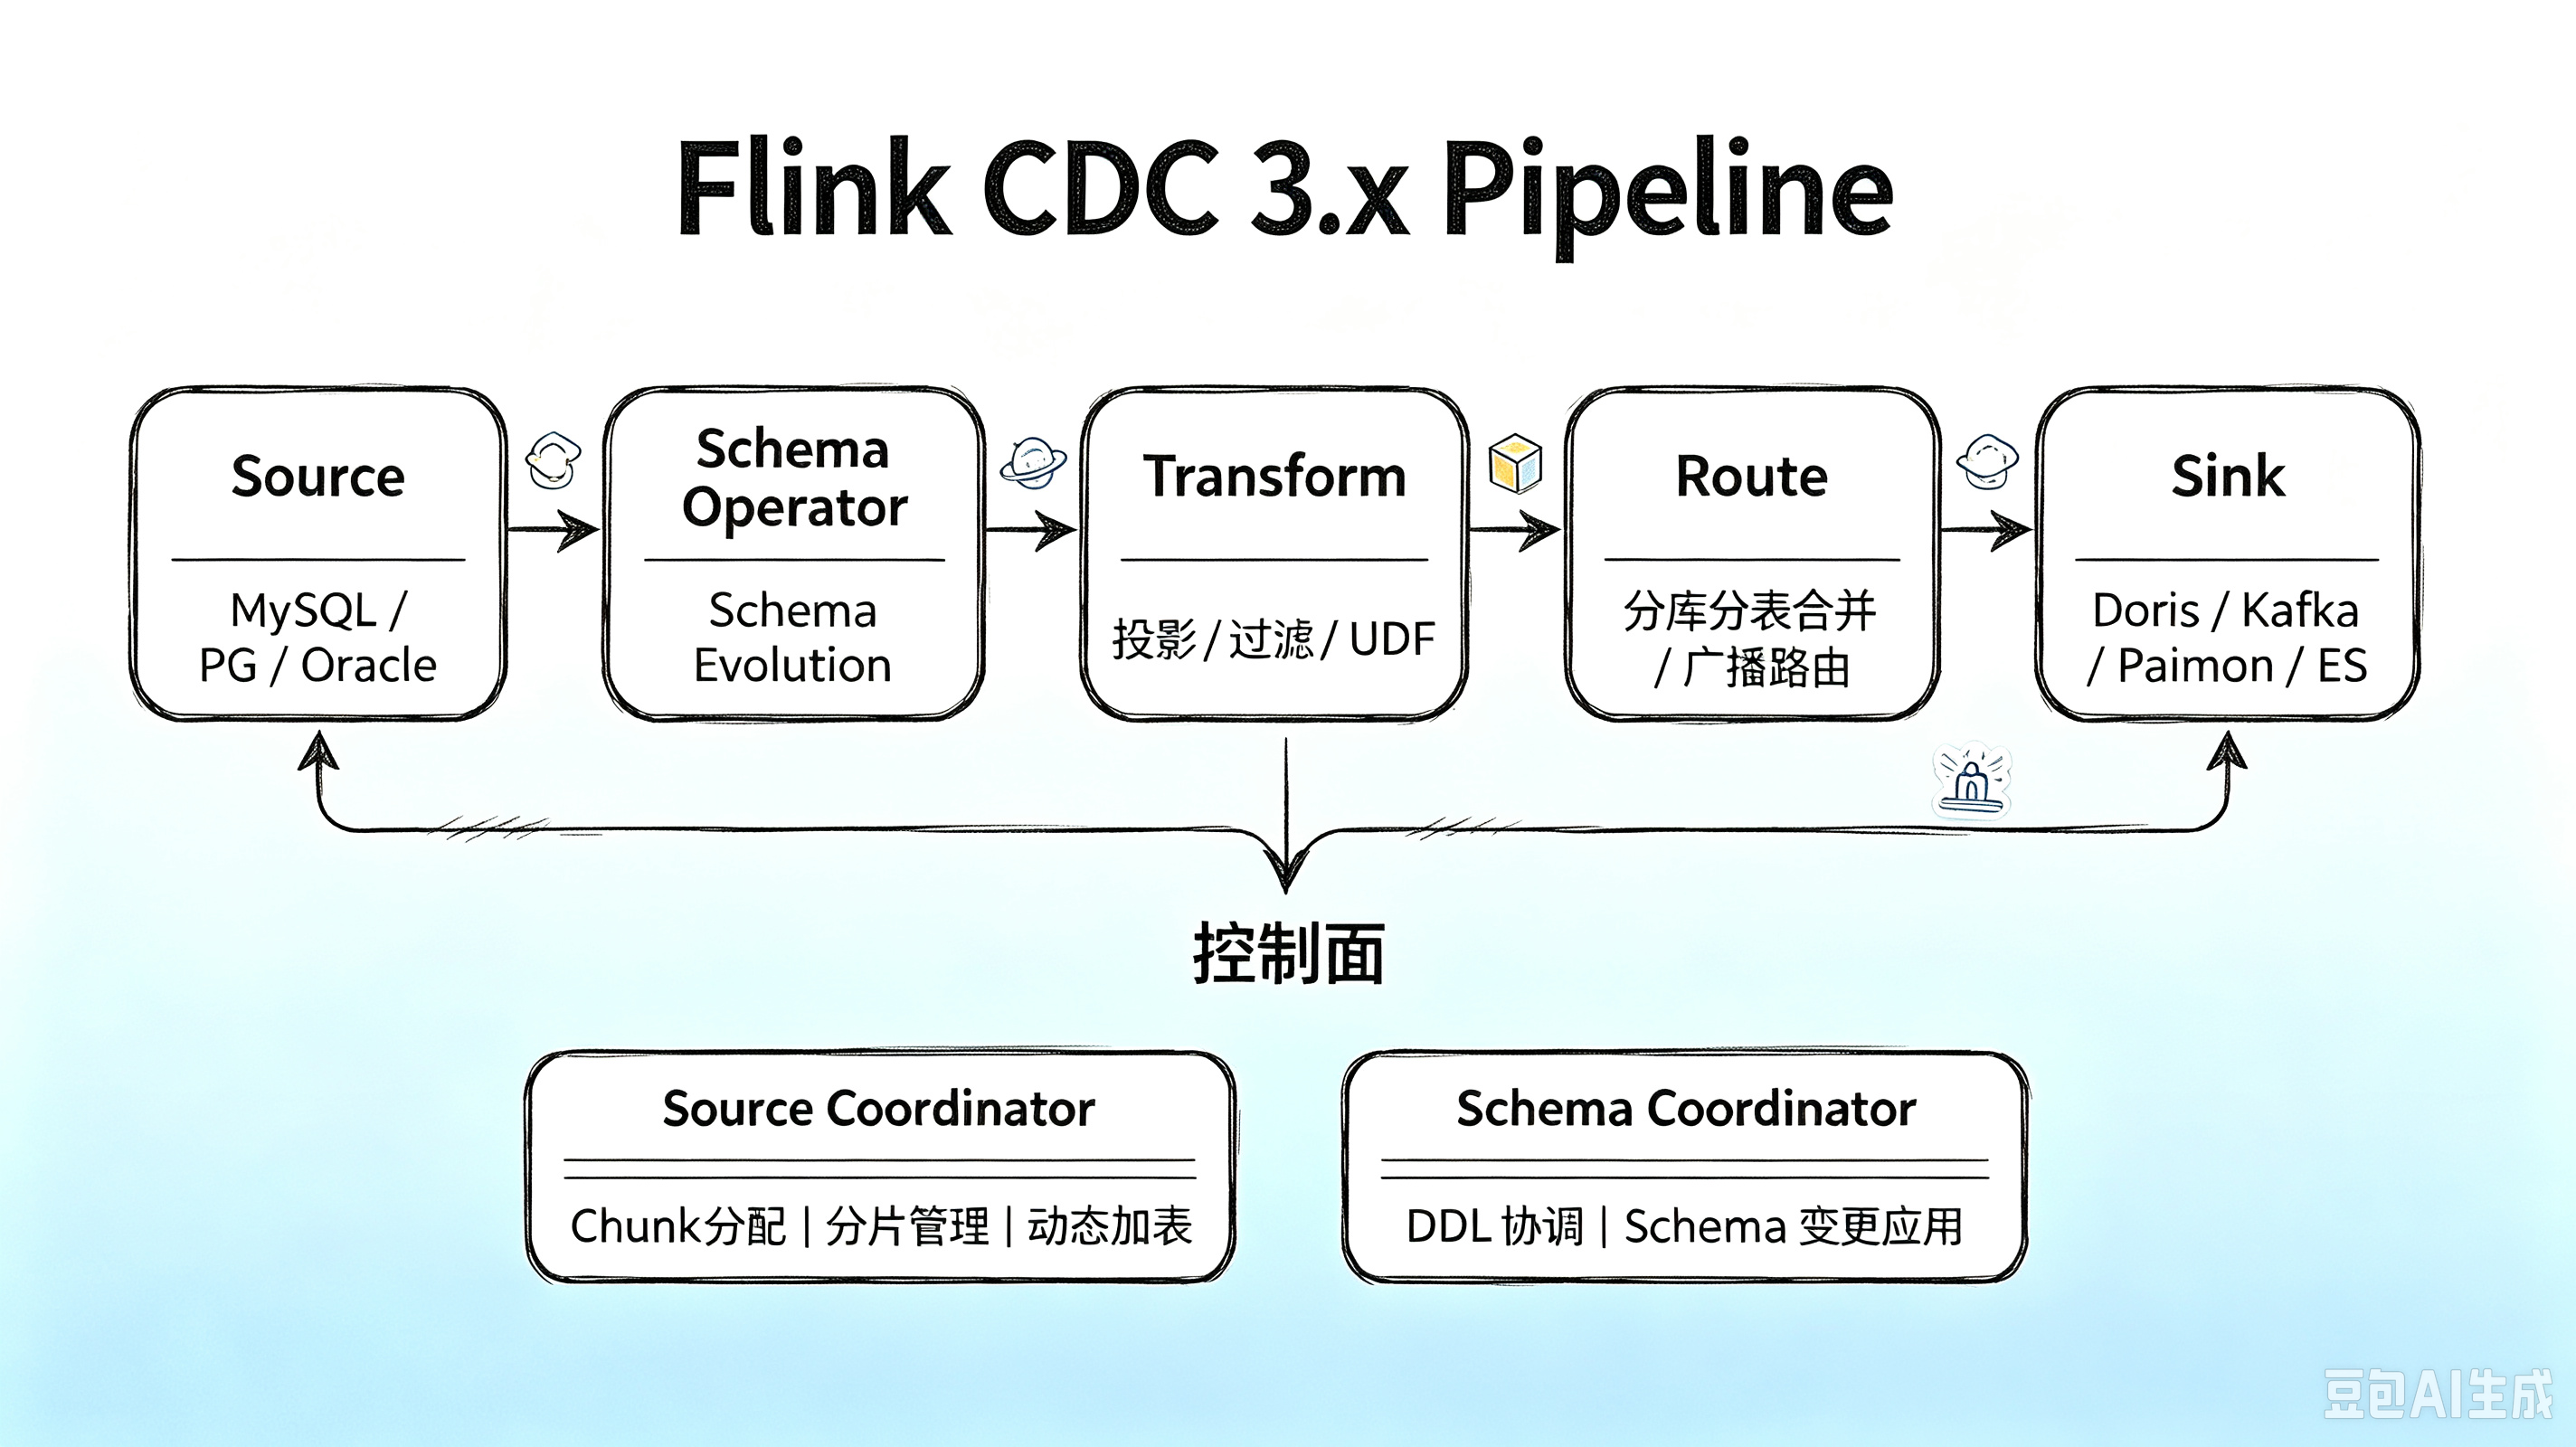
3.x 是一次重大架构升级,定位从"CDC Connector 集合"升级为端到端实时数据集成框架。
3.4.1 分片(Chunk)并行快照
表按 Chunk Key(默认为主键的第一列)切分为多个 Chunk,每个 Chunk 是一个独立的数据分片。Enumerator 将 Chunk 分发给多个 Reader 并行读取,水平扩展快照吞吐量。
3.2 版本起支持将任意列指定为 Chunk Key(scan.incremental.snapshot.chunk.key-column),不再局限于主键列,但非主键列可能导致查询性能下降。
3.4.2 增量快照算法(Offset Signal Algorithm)
Flink CDC 的增量快照算法受 Netflix DBLog 论文启发,核心步骤如下(以单个 Chunk 为例):
- 记录当前 Binlog 位点为 LOW 位点
- 执行
SELECT * FROM table WHERE pk > chunk_low AND pk <= chunk_high读取该 Chunk 的快照数据并缓存 - 记录当前 Binlog 位点为 HIGH 位点
- 读取 LOW 到 HIGH 之间属于该 Chunk 的 Binlog 变更记录
- 将 Binlog 变更 Upsert 到缓存的快照数据中(以最新状态为准)
- 将最终结果全部作为 INSERT 事件发出
- HIGH 位点之后的 Binlog 记录在增量阶段由单 Reader 继续读取
该算法的三大优势:
- 无锁:不需要
FLUSH TABLES WITH READ LOCK - 支持断点续传:Chunk 粒度 Checkpoint,故障后从最后完成的 Chunk 恢复
- 并发读取:多个 Chunk 可由不同 Reader 并行处理
3.4.3 Source Coordinator + Split Assigner
3.x 在 Pipeline 层面引入了统一的 Source Coordinator,负责:
- 管理所有表的 Chunk 切分与分配
- 协调快照阶段到增量阶段的切换
- 支持动态新增表(运行中添加监控表,自动触发该表快照并接入 Binlog 流)
- 自动缩容(快照完成后释放多余 Reader 资源)
3.4.4 数据变更 Event 模型
3.x 定义了统一的事件模型:
- DataChangeEvent:数据变更事件,包含 before(变更前行数据)、after(变更后行数据)、op 操作类型(INSERT/UPDATE/DELETE)、元数据(时间戳、表名等)
- SchemaChangeEvent:结构变更事件,包括 CreateTableEvent、AddColumnEvent、DropColumnEvent、RenameColumnEvent、AlterColumnTypeEvent、AlterTableCommentEvent、AlterColumnCommentEvent 等
Schema Operator 在收到 SchemaChangeEvent 时,会先向下游发送 FlushEvent 等待 Sink 将旧 Schema 的数据全部落盘,再通过 MetadataApplier 将 DDL 应用到下游,保证数据与 Schema 的一致性。
3.5 水位线与 Checkpoint 协同
Flink CDC 与 Flink 的 Checkpoint 机制深度集成:
- 快照阶段:以 Chunk 为粒度做 Checkpoint,每个 Chunk 读取完成后记录进度
- 增量阶段:以行为粒度记录 Binlog 消费位点到 State
- 两阶段切换屏障:所有 Chunk 完成后,等待一次成功的 Checkpoint,确保快照数据全部被下游消费,再切换到 Binlog 读取
- 故障恢复:从最近一次成功 Checkpoint 的 State 恢复,重新分配未完成的 Chunk,重置 Binlog 位点,保证 Exactly-Once
4. 环境搭建
4.1 前置条件
| 组件 | 版本要求 |
|---|---|
| JDK | 11+(3.6+ 强制 JDK 11) |
| Flink | 1.17+(3.x),推荐 1.18 / 1.20 |
| MySQL | 5.6 / 5.7 / 8.0.x |
| 内存 | 开发环境至少 4GB,生产按需 |
4.2 MySQL Binlog 配置
编辑 MySQL 配置文件 my.cnf(Linux)或 my.ini(Windows):
[mysqld]
# 开启 Binlog
log-bin=mysql-bin
# Binlog 格式必须为 ROW
binlog_format=ROW
# 记录完整行镜像(前后镜像都有)
binlog_row_image=FULL
# server-id 必须唯一
server-id=1
# Binlog 过期时间(天),根据磁盘容量调整
expire_logs_days=7
#(可选)开启 GTID,方便主从切换和位点管理
gtid_mode=ON
enforce_gtid_consistency=ON
重启 MySQL 后验证:
-- 检查 Binlog 是否开启
SHOW VARIABLES LIKE 'log_bin';
-- 应为 ROW
SHOW VARIABLES LIKE 'binlog_format';
-- 应为 FULL
SHOW VARIABLES LIKE 'binlog_row_image';
创建 CDC 专用账号并授权:
CREATE USER 'flinkcdc'@'%' IDENTIFIED BY 'FlinkCDC@123';
GRANT SELECT, SHOW DATABASES, REPLICATION SLAVE, REPLICATION CLIENT ON *.* TO 'flinkcdc'@'%';
FLUSH PRIVILEGES;
注意:3.x 增量快照算法无需
RELOAD权限(旧版本加锁快照需要),权限更小更安全。
4.3 Flink Standalone 本地环境
# 下载 Flink(以 1.18.1 为例)
wget https://archive.apache.org/dist/flink/flink-1.18.1/flink-1.18.1-bin-scala_2.12.tgz
tar -xzf flink-1.18.1-bin-scala_2.12.tgz
cd flink-1.18.1

# 启动集群
./bin/start-cluster.sh

# 访问 http://localhost:8081 查看 Web UI
4.4 Flink CDC 依赖下载
从 Flink CDC Releases 下载对应版本的 Connector JAR:
# 以 3.2.1 为例
cd $FLINK_HOME/lib

# SQL Connector(Flink SQL 方式使用)
wget https://repo1.maven.org/maven2/org/apache/flink/flink-sql-connector-mysql-cdc/3.2.1/flink-sql-connector-mysql-cdc-3.2.1.jar

# Pipeline Connector(YAML 整库同步方式使用)
wget https://repo1.maven.org/maven2/org/apache/flink/flink-cdc-pipeline-connector-mysql/3.2.1/flink-cdc-pipeline-connector-mysql-3.2.1.jar
wget https://repo1.maven.org/maven2/org/apache/flink/flink-cdc-pipeline-connector-doris/3.2.1/flink-cdc-pipeline-connector-doris-3.2.1.jar
重要:MySQL / Oracle / OceanBase / DB2 连接器因许可证原因不包含 JDBC 驱动,需手动将驱动 JAR 放入
$FLINK_HOME/lib/。MySQL 推荐使用mysql-connector-java-8.0.27.jar。
4.5 Flink SQL Client 快速验证
# 启动 SQL Client
./bin/sql-client.sh
在 SQL Client 中执行:
-- 创建 MySQL CDC 源表
CREATE TABLE mysql_users (
    id INT,
    name STRING,
    email STRING,
    created_at TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'mysql-cdc',
    'hostname' = '127.0.0.1',
    'port' = '3306',
    'username' = 'flinkcdc',
    'password' = 'FlinkCDC@123',
    'database-name' = 'demo',
    'table-name' = 'users',
    'server-id' = '5400-5404'
);

-- 查询(先全量读取已有数据,然后持续输出增量变更)
SELECT * FROM mysql_users;
在 MySQL 中插入或更新一条数据,SQL Client 中应该能实时看到变更。
4.6 Docker Compose 一键启动
创建 docker-compose.yml:
version: '3.8'
services:
  mysql:
    image: mysql:8.0
    container_name: mysql-cdc
    environment:
      MYSQL_ROOT_PASSWORD: root
      MYSQL_DATABASE: demo
    ports:
      - "3306:3306"
    command:
      - --server-id=1
      - --log-bin=mysql-bin
      - --binlog_format=ROW
      - --binlog_row_image=FULL
    volumes:
      - ./init.sql:/docker-entrypoint-initdb.d/init.sql

  flink-jobmanager:
    image: flink:1.18.1-java11
    container_name: flink-jm
    ports:
      - "8081:8081"
    command: jobmanager
    environment:
      FLINK_PROPERTIES: |
        jobmanager.rpc.address: flink-jobmanager
    volumes:
      - ./lib:/opt/flink/lib

  flink-taskmanager:
    image: flink:1.18.1-java11
    container_name: flink-tm
    depends_on:
      - flink-jobmanager
    command: taskmanager
    environment:
      FLINK_PROPERTIES: |
        jobmanager.rpc.address: flink-jobmanager
        taskmanager.numberOfTaskSlots: 4
    volumes:
      - ./lib:/opt/flink/lib
创建 init.sql:
CREATE DATABASE IF NOT EXISTS demo;
USE demo;
CREATE TABLE users (
    id INT AUTO_INCREMENT PRIMARY KEY,
    name VARCHAR(100),
    email VARCHAR(200),
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);
INSERT INTO users (name, email) VALUES ('Alice', 'alice@example.com'), ('Bob', 'bob@example.com');
启动:
docker-compose up -d
4.7 常见启动问题排查
| 问题 | 原因 | 解决方案 |
|---|---|---|
Cannot read binlog | Binlog 未开启或格式不对 | 确认 log_bin=ON、binlog_format=ROW |
Access denied | 账号权限不足 | 授予 REPLICATION SLAVE / CLIENT 权限 |
server-id conflict | 多个 CDC 任务使用了相同 server-id | 为每个任务配置不同的 server-id 范围 |
ClassNotFoundException: com.mysql.cj.jdbc.Driver | 缺少 MySQL 驱动 | 将 mysql-connector-java JAR 放入 lib/ |
Timezone mismatch | 未配置时区 | 添加 'server-time-zone' = 'Asia/Shanghai' |
OutOfMemoryError | 快照数据量过大 | 增大 TaskManager 内存或调小 chunk.size |
5. Flink CDC SQL 方式(重点)
Flink SQL 是最常用、最易上手的方式。只需通过 DDL 定义源表和目标表,然后用 INSERT INTO 语句启动同步。
5.1 MySQL CDC Source DDL 详解
CREATE TABLE mysql_source (
    id INT,
    name STRING,
    age INT,
    email STRING,
    created_at TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    -- ========== 必选参数 ==========
    'connector' = 'mysql-cdc',
    'hostname' = '127.0.0.1',
    'port' = '3306',
    'username' = 'flinkcdc',
    'password' = 'FlinkCDC@123',
    'database-name' = 'demo',
    'table-name' = 'users',

    -- ========== 连接与身份 ==========
    'server-id' = '5400-5404',
    'server-time-zone' = 'Asia/Shanghai',

    -- ========== 快照配置 ==========
    'scan.incremental.snapshot.enabled' = 'true',
    'scan.incremental.snapshot.chunk.size' = '8096',
    'scan.incremental.snapshot.chunk.key-column' = 'id',
    'scan.snapshot.fetch.size' = '1024',

    -- ========== 启动模式 ==========
    'scan.startup.mode' = 'initial',

    -- ========== 连接池 ==========
    'connection.pool.size' = '20',
    'connect.timeout' = '30s',
    'heartbeat.interval' = '30s'
);
核心 WITH 参数速查表:
| 参数 | 必填 | 默认值 | 说明 |
|---|---|---|---|
| connector | ✅ | — | 固定为 mysql-cdc |
| hostname | ✅ | — | MySQL 主机地址 |
| port | ❌ | 3306 | MySQL 端口 |
| username | ✅ | — | 数据库用户名 |
| password | ✅ | — | 数据库密码 |
| database-name | ✅ | — | 数据库名,支持正则 |
| table-name | ✅ | — | 表名,支持正则 |
| server-id | ❌ | 随机 5400-6400 | MySQL 从节点 ID,并行时需配置范围 |
| server-time-zone | ❌ | 会话时区 | 数据库会话时区,如 Asia/Shanghai |
| scan.incremental.snapshot.enabled | ❌ | true | 是否启用增量快照(并行无锁) |
| scan.incremental.snapshot.chunk.size | ❌ | 8096 | 每个 Chunk 的行数 |
| scan.incremental.snapshot.chunk.key-column | ❌ | 主键第一列 | Chunk 切分列 |
| scan.snapshot.fetch.size | ❌ | 1024 | 每次轮询获取的最大行数 |
| scan.startup.mode | ❌ | initial | 启动模式(见 5.2) |
| connection.pool.size | ❌ | 20 | JDBC 连接池大小 |
| heartbeat.interval | ❌ | 30s | 心跳间隔,防止连接超时 |
注意:
PRIMARY KEY声明是必须的(用于 Upsert 和 Chunk 切分),Flink CDC 中使用NOT ENFORCED表示不强制校验。
5.2 启动模式
| 模式 | 说明 | 适用场景 |
|---|---|---|
initial(默认) | 首次启动先全量快照,再从快照结束位点读取增量 | 首次同步,需要历史数据 |
latest-offset | 跳过快照,仅从 Binlog 末尾开始读取 | 只关心启动后的新变更 |
earliest-offset | 跳过快照,从 Binlog 最早位点开始读取 | 需要回放所有历史 Binlog |
specific-offset | 从指定 Binlog 文件和位置或 GTID 集合开始 | 精确恢复位点 |
timestamp | 从指定时间戳对应的 Binlog 位点开始 | 按时间点恢复 |
specific-offset 模式额外参数:
'scan.startup.mode' = 'specific-offset',
'scan.startup.specific-offset.file' = 'mysql-bin.000003',
'scan.startup.specific-offset.pos' = '4',
-- 或使用 GTID
'scan.startup.specific-offset.gtid-set' = '24DA167-0C0C-11E8-8442-00059A3C7B00:1-19'
timestamp 模式:
'scan.startup.mode' = 'timestamp',
'scan.startup.timestamp-millis' = '1700000000000'
5.3 全量 + 增量同步完整 SQL 示例
-- ============================================
-- 1. 创建 MySQL CDC 源表
-- ============================================
CREATE TABLE orders_source (
    id BIGINT,
    user_id BIGINT,
    product_id BIGINT,
    quantity INT,
    amount DECIMAL(10,2),
    status STRING,
    order_time TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'mysql-cdc',
    'hostname' = '127.0.0.1',
    'port' = '3306',
    'username' = 'flinkcdc',
    'password' = 'FlinkCDC@123',
    'database-name' = 'ecommerce',
    'table-name' = 'orders',
    'server-id' = '5400-5404',
    'server-time-zone' = 'Asia/Shanghai',
    'scan.startup.mode' = 'initial'
);

-- ============================================
-- 2. 创建目标表(以 Doris 为例)
-- ============================================
CREATE TABLE orders_sink (
    id BIGINT,
    user_id BIGINT,
    product_id BIGINT,
    quantity INT,
    amount DECIMAL(10,2),
    status STRING,
    order_time TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'table.identifier' = 'ecommerce.orders',
    'username' = 'root',
    'password' = '',
    'sink.label-prefix' = 'orders_sync',
    'sink.properties.format' = 'json',
    'sink.properties.read_json_by_line' = 'true'
);

-- ============================================
-- 3. 启动同步
-- ============================================
INSERT INTO orders_sink
SELECT * FROM orders_source;
提交后,Flink 会先全量读取 orders 表中的存量数据写入 Doris,然后持续监听 Binlog 将增量变更实时写入。
5.4 增量同步(只从 Binlog 开始)
如果历史数据已经通过其他方式(如 DataX)同步完毕,只需增量同步:
CREATE TABLE orders_cdc (
    id BIGINT,
    user_id BIGINT,
    amount DECIMAL(10,2),
    status STRING,
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'mysql-cdc',
    'hostname' = '127.0.0.1',
    'port' = '3306',
    'username' = 'flinkcdc',
    'password' = 'FlinkCDC@123',
    'database-name' = 'ecommerce',
    'table-name' = 'orders',
    'server-id' = '5400',
    'scan.startup.mode' = 'latest-offset'
);
5.5 表名正则匹配多表
table-name 支持正则表达式,可以同时监听多张表:
CREATE TABLE multi_table_source (
    id INT,
    name STRING,
    -- 元数据列:标识数据来自哪张表
    table_name STRING METADATA FROM 'table_name' VIRTUAL,
    db_name STRING METADATA FROM 'database_name' VIRTUAL,
    op_ts TIMESTAMP_LTZ(3) METADATA FROM 'op_ts' VIRTUAL,
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'mysql-cdc',
    'hostname' = '127.0.0.1',
    'port' = '3306',
    'username' = 'flinkcdc',
    'password' = 'FlinkCDC@123',
    'database-name' = 'ecommerce',
    -- 匹配 order_0, order_1, order_2 ...
    'table-name' = 'order_[0-9]+',
    'server-id' = '5400-5408'
);
注意:使用正则匹配多表时,所有匹配的表必须具有相同的 Schema 结构(列名和类型一致)。如果表结构不同,应使用 3.x 的 YAML Pipeline 整库同步方式。
5.6 整库同步(3.x):YAML Pipeline 方式
3.x 引入了 YAML 声明式整库同步,这是对 SQL 方式的重大升级。详见第 8 章。这里先给出一个最简示例:
source:
  type: mysql
  hostname: 127.0.0.1
  port: 3306
  username: flinkcdc
  password: FlinkCDC@123
  tables: ecommerce.\.*
  server-id: 5401-5404

sink:
  type: doris
  fenodes: 127.0.0.1:8030
  username: root
  password: ""

pipeline:
  name: MySQL-to-Doris-Sync
  parallelism: 4
bash flink-cdc.sh mysql-to-doris.yaml
5.7 Schema Evolution(3.x)
3.x 支持在 YAML Pipeline 中自动同步上游 Schema 变更。当上游 MySQL 执行 DDL 时,Flink CDC 会捕获 SchemaChangeEvent 并自动在下游执行对应 DDL。
source:
  type: mysql
  hostname: 127.0.0.1
  # ...
  schema-change.enabled: true

sink:
  type: doris
  # ...
  # Schema Evolution 行为配置
  include.schema.changes: [create_table, add_column, alter_column_type]
  exclude.schema.changes: [drop_column]

pipeline:
  name: Schema-Evolution-Demo
  parallelism: 2
Schema Evolution 支持以下行为模式(通过 pipeline.schema.change.behavior 配置):
| 模式 | 说明 |
|---|---|
lenient(3.2+ 默认) | 宽容模式:忽略删列操作,新增列追加到末尾,故障恢复时无损 |
try_evolve | 尝试演化:尽力应用 Schema 变更,失败则容忍(可能丢数据) |
evolve | 严格演化:应用所有 Schema 变更,失败则终止任务 |
ignore | 忽略:忽略所有 Schema 变更,仅传播未变更列的数据 |
exception | 异常模式:禁止任何 Schema 变更,发生即终止任务 |
5.8 元数据列
Flink CDC 支持通过 METADATA FROM 语法读取变更事件的元数据:
CREATE TABLE orders_with_meta (
    id BIGINT,
    amount DECIMAL(10,2),
    status STRING,
    -- 元数据列
    op_ts TIMESTAMP_LTZ(3) METADATA FROM 'op_ts' VIRTUAL,        -- 变更时间
    table_name STRING METADATA FROM 'table_name' VIRTUAL,         -- 表名
    database_name STRING METADATA FROM 'database_name' VIRTUAL,  -- 库名
    op STRING METADATA FROM 'op' VIRTUAL,                        -- 操作类型(INSERT/UPDATE/DELETE)
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'mysql-cdc',
    'hostname' = '127.0.0.1',
    'port' = '3306',
    'username' = 'flinkcdc',
    'password' = 'FlinkCDC@123',
    'database-name' = 'ecommerce',
    'table-name' = 'orders'
);
常用元数据键:
op_ts:变更发生的时间戳table_name:源表名database_name:源库名op:操作类型(INSERT/UPDATE/DELETE)meta.table_name:多表场景中的完整表标识
6. DataStream API 方式
虽然 SQL 方式最常用,但在需要高度定制化逻辑(如自定义反序列化、复杂的多表合并、精细的并行度控制)时,DataStream API 提供了更强的灵活性。
6.1 SourceFunction 方式(2.x 旧 API)
2.x 时代使用 MySqlSource.Builder 构建 Source(注意:这是 FLIP-27 的新 Source API,不是旧的 SourceFunction):
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.cdc.connectors.mysql.source.MySqlSource;
import org.apache.flink.cdc.debezium.JsonDebeziumDeserializationSchema;

public class OldApiExample {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.enableCheckpointing(5000);

        MySqlSource<String> mySqlSource = MySqlSource.<String>builder()
                .hostname("127.0.0.1")
                .port(3306)
                .databaseList("ecommerce")
                .tableList("ecommerce.orders")
                .username("flinkcdc")
                .password("FlinkCDC@123")
                .deserializer(new JsonDebeziumDeserializationSchema())
                .serverId("5400-5404")
                .build();

        DataStream<String> stream = env.fromSource(
                mySqlSource,
                WatermarkStrategy.noWatermarks(),
                "MySQL CDC Source"
        );

        stream.print();
        env.execute("Flink CDC Old API Example");
    }
}
注意:
JsonDebeziumDeserializationSchema输出的是 Debezium 标准 JSON 格式字符串,包含 before / after / source / op / ts_ms 字段。
6.2 3.x 新 Source API
3.x 的 DataStream API 保持了与 2.x 类似的 Source 构建方式,主要变化在于 Pipeline 层面的 API。对于纯 Source 读取,API 基本一致:
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.cdc.connectors.mysql.source.MySqlSource;
import org.apache.flink.cdc.debezium.JsonDebeziumDeserializationSchema;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class Cdc3Example {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.enableCheckpointing(10000); // 10秒一次 Checkpoint
        env.setParallelism(4);

        MySqlSource<String> source = MySqlSource.<String>builder()
                .hostname("127.0.0.1")
                .port(3306)
                .username("flinkcdc")
                .password("FlinkCDC@123")
                .databaseList("ecommerce")
                .tableList("ecommerce.orders", "ecommerce.users")
                .serverId("5400-5408")
                .deserializer(new JsonDebeziumDeserializationSchema())
                .startupOptions(StartupOptions.initial())
                // 增量快照配置
                .splitSize(8096)
                .fetchSize(1024)
                .serverTimeZone("Asia/Shanghai")
                .build();

        env.fromSource(source, WatermarkStrategy.noWatermarks(), "MySQL CDC")
           .setParallelism(4)
           .print()
           .setParallelism(1);

        env.execute("Flink CDC 3.x DataStream Example");
    }
}
Maven 依赖:
<dependency>
    <groupId>org.apache.flink</groupId>
    <artifactId>flink-connector-mysql-cdc</artifactId>
    <version>3.2.1</version>
</dependency>
6.3 全量 + 增量 Java 代码示例
以下示例演示从 MySQL 读取订单变更,做简单的 ETL 处理后写入 Kafka:
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.cdc.connectors.mysql.source.MySqlSource;
import org.apache.flink.cdc.debezium.JsonDebeziumDeserializationSchema;
import org.apache.flink.connector.kafka.sink.KafkaRecordSerializationSchema;
import org.apache.flink.connector.kafka.sink.KafkaSink;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class FullIncrementalSync {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.enableCheckpointing(10000);
        env.setParallelism(4);

        // 1. MySQL CDC Source
        MySqlSource<String> source = MySqlSource.<String>builder()
                .hostname("127.0.0.1")
                .port(3306)
                .username("flinkcdc")
                .password("FlinkCDC@123")
                .databaseList("ecommerce")
                .tableList("ecommerce.orders")
                .deserializer(new JsonDebeziumDeserializationSchema())
                .serverId("5400-5408")
                .startupOptions(StartupOptions.initial())
                .serverTimeZone("Asia/Shanghai")
                .build();

        // 2. Kafka Sink
        KafkaSink<String> kafkaSink = KafkaSink.<String>builder()
                .setBootstrapServers("127.0.0.1:9092")
                .setRecordSerializer(
                        KafkaRecordSerializationSchema.<String>builder()
                                .setTopic("ods_orders_binlog")
                                .setValueSerializationSchema(new SimpleStringSchema())
                                .build()
                )
                .build();

        // 3. 读取 CDC 数据并写入 Kafka
        env.fromSource(source, WatermarkStrategy.noWatermarks(), "MySQL CDC")
           .sinkTo(kafkaSink);

        env.execute("MySQL CDC -> Kafka");
    }
}
6.4 自定义反序列化(DebeziumDeserializationSchema)
默认的 JsonDebeziumDeserializationSchema 输出 Debezium 原生 JSON,可能不符合下游需求。可以实现 DebeziumDeserializationSchema 自定义输出格式:
import org.apache.flink.cdc.debezium.DebeziumDeserializationSchema;
import org.apache.flink.api.common.typeinfo.TypeInformation;
import org.apache.flink.util.Collector;
import org.apache.kafka.connect.data.Field;
import org.apache.kafka.connect.data.Struct;
import org.apache.kafka.connect.source.SourceRecord;
import com.fasterxml.jackson.databind.ObjectMapper;
import com.fasterxml.jackson.databind.node.ObjectNode;

public class CustomDebeziumDeserializer
        implements DebeziumDeserializationSchema<String> {

    private static final ObjectMapper MAPPER = new ObjectMapper();

    @Override
    public void deserialize(SourceRecord record, Collector<String> out)
            throws Exception {
        Struct value = (Struct) record.value();
        String op = value.getString("op"); // c=insert, u=update, d=delete
        Struct after = value.getStruct("after");
        Struct before = value.getStruct("before");
        Struct source = value.getStruct("source");

        ObjectNode result = MAPPER.createObjectNode();
        result.put("table", source.getString("table"));
        result.put("database", source.getString("db"));
        result.put("op", mapOp(op));
        result.put("ts_ms", value.getInt64("ts_ms"));

        // 解析 after 数据
        if (after != null) {
            ObjectNode afterNode = MAPPER.createObjectNode();
            for (Field field : after.schema().fields()) {
                Object fieldValue = after.get(field);
                afterNode.put(field.name(),
                        fieldValue == null ? null : fieldValue.toString());
            }
            result.set("after", afterNode);
        }

        // 解析 before 数据(UPDATE/DELETE 时有值)
        if (before != null) {
            ObjectNode beforeNode = MAPPER.createObjectNode();
            for (Field field : before.schema().fields()) {
                Object fieldValue = before.get(field);
                beforeNode.put(field.name(),
                        fieldValue == null ? null : fieldValue.toString());
            }
            result.set("before", beforeNode);
        }

        out.collect(MAPPER.writeValueAsString(result));
    }

    private String mapOp(String op) {
        switch (op) {
            case "c": return "INSERT";
            case "u": return "UPDATE";
            case "d": return "DELETE";
            default:  return op;
        }
    }

    @Override
    public TypeInformation<String> getProducedType() {
        return TypeInformation.of(String.class);
    }
}
使用自定义反序列化器:
MySqlSource<String> source = MySqlSource.<String>builder()
        .hostname("127.0.0.1")
        .port(3306)
        .username("flinkcdc")
        .password("FlinkCDC@123")
        .databaseList("ecommerce")
        .tableList("ecommerce.orders")
        .deserializer(new CustomDebeziumDeserializer())
        .serverId("5400-5408")
        .build();
6.5 多表合并与路由
DataStream API 可以通过 tableList 指定多张表,在反序列化器中根据表名分发处理:
MySqlSource<String> source = MySqlSource.<String>builder()
        // ...
        .tableList(
            "ecommerce.orders",
            "ecommerce.order_items",
            "ecommerce.users"
        )
        .deserializer(new CustomDebeziumDeserializer())
        .build();

DataStream<String> stream = env.fromSource(source,
        WatermarkStrategy.noWatermarks(), "MySQL CDC");

// 根据表名分流
stream.filter(json -> json.contains("\"table\":\"orders\""))
      .sinkTo(ordersKafkaSink);

stream.filter(json -> json.contains("\"table\":\"users\""))
      .sinkTo(usersKafkaSink);
提示:对于多表合并和路由场景,3.x 的 YAML Pipeline Route 功能更加简洁,详见第 8 章。
6.6 并行度与分片配置
MySqlSource<String> source = MySqlSource.<String>builder()
        // ...
        .serverId("5400-5410")  // server-id 范围必须大于并行度
        .splitSize(10000)       // 每个 Chunk 10000 行
        .fetchSize(2000)        // 每次 fetch 2000 行
        .build();

env.setParallelism(8);  // 快照阶段 8 并发读取
关键规则:
server-id范围大小必须大于 Source 的并行度(每个 Reader 需要一个唯一 server-id)- 并行度通过
env.setParallelism()或SET 'parallelism.default'设置 - 增量阶段(Binlog 读取)始终为单并发,以保证事件的全局顺序
7. Sink 集成(重点实战)
Flink CDC 的数据可以写入多种下游系统。以下介绍常用 Sink 的配置方法和注意事项。
7.1 Kafka Sink
Kafka 是最常用的 CDC 数据落地目标,通常作为 ODS 层的实时数据接入层。
-- Kafka Sink 表(使用 Canal-JSON 格式)
CREATE TABLE kafka_orders (
    id BIGINT,
    user_id BIGINT,
    amount DECIMAL(10,2),
    status STRING,
    order_time TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'kafka',
    'topic' = 'ods_orders_binlog',
    'properties.bootstrap.servers' = '127.0.0.1:9092',
    'properties.group.id' = 'flink-cdc-group',
    -- Canal-JSON 格式:包含 UPDATE 前后镜像
    'format' = 'canal-json',
    -- 或使用 Debezium-JSON
    -- 'format' = 'debezium-json',
    'scan.startup.mode' = 'earliest-offset'
);

-- 启动同步
INSERT INTO kafka_orders
SELECT * FROM orders_source;
格式选择建议:
| 格式 | 特点 | 适用场景 |
|---|---|---|
canal-json | 包含 old 字段(变更前数据),国内生态友好 | 国内数仓体系,下游 Flink/Spark 消费 |
debezium-json | Debezium 标准格式,包含 before/after/source | 国际化生态,与 Debezium 兼容 |
avro-confluent | Schema Registry + Avro,紧凑高效 | 大规模数据,Schema 治理严格 |
raw | 仅原始字节 | 自定义格式透传 |
Exactly-Once:Kafka Sink 支持两阶段提交(2PC),配合 Flink Checkpoint 可实现端到端精确一次。需设置:
'sink.delivery-guarantee' = 'exactly-once',
'sink.transactional-id-prefix' = 'cdc-txn-'
7.2 Doris Sink
Doris 是国内非常流行的实时分析型数据库,Flink Doris Connector 通过 Stream Load 实现高效写入。
CREATE TABLE doris_orders (
    id BIGINT,
    user_id BIGINT,
    amount DECIMAL(10,2),
    status STRING,
    order_time TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'table.identifier' = 'ecommerce.orders',
    'username' = 'root',
    'password' = '',
    'sink.label-prefix' = 'orders_cdc',
    -- Stream Load 属性
    'sink.properties.format' = 'json',
    'sink.properties.read_json_by_line' = 'true',
    -- 写入参数
    'sink.buffer-flush.max-rows' = '100000',
    'sink.buffer-flush.max-bytes' = '104857600',
    'sink.buffer-flush.interval' = '10s',
    'sink.max-retries' = '3'
);

INSERT INTO doris_orders
SELECT * FROM orders_source;
幂等说明:Doris Unique Key 模型通过主键实现 Upsert,Stream Load 的 Label 机制保证请求幂等,可达到 Exactly-Once 效果。
7.3 StarRocks Sink
StarRocks Sink 配置与 Doris 类似:
CREATE TABLE sr_orders (
    id BIGINT,
    user_id BIGINT,
    amount DECIMAL(10,2),
    status STRING,
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'starrocks',
    'jdbc-url' = 'jdbc:mysql://127.0.0.1:9030',
    'load-url' = '127.0.0.1:8030',
    'database-name' = 'ecommerce',
    'table-name' = 'orders',
    'username' = 'root',
    'password' = '',
    'sink.properties.format' = 'json',
    'sink.properties.strip_outer_array' = 'true',
    'sink.buffer-flush.interval-ms' = '10000',
    'sink.buffer-flush.max-bytes' = '104857600'
);

INSERT INTO sr_orders
SELECT * FROM orders_source;
StarRocks 同样通过主键模型实现 Upsert 幂等写入。3.2 版本起 StarRocks Pipeline Sink 支持列重命名和列类型变更 DDL。
7.4 Paimon Sink
Apache Paimon 是流批一体的湖存储格式,Flink CDC 3.1 起提供原生 Pipeline Sink 支持。
YAML Pipeline 方式(推荐):
source:
  type: mysql
  hostname: 127.0.0.1
  port: 3306
  username: flinkcdc
  password: FlinkCDC@123
  tables: ecommerce.\.*
  server-id: 5401-5404

sink:
  type: paimon
  name: Paimon Sink
  catalog.properties.metastore: filesystem
  catalog.properties.warehouse: /data/paimon/warehouse

pipeline:
  name: MySQL-to-Paimon
  parallelism: 4
Flink SQL 方式:
-- 创建 Paimon Catalog
CREATE CATALOG paimon_catalog WITH (
    'type' = 'paimon',
    'warehouse' = '/data/paimon/warehouse'
);

-- 在 Paimon 中创建表
CREATE TABLE paimon_catalog.ecommerce.orders (
    id BIGINT,
    user_id BIGINT,
    amount DECIMAL(10,2),
    status STRING,
    order_time TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'bucket' = '4',
    'changelog-producer' = 'input'  -- 直接使用 CDC 输入作为 changelog
);

-- 写入
INSERT INTO paimon_catalog.ecommerce.orders
SELECT * FROM orders_source;
Exactly-Once:Paimon 基于 Snapshot 和两阶段提交,原生支持 Exactly-Once。changelog-producer = 'input' 表示直接保留 CDC 的 changelog 语义(INSERT/UPDATE_BEFORE/UPDATE_AFTER/DELETE)。
7.5 Iceberg Sink
CREATE CATALOG iceberg_catalog WITH (
    'type' = 'iceberg',
    'catalog-type' = 'hive',
    'uri' = 'thrift://127.0.0.1:9083',
    'warehouse' = 'hdfs:///user/hive/warehouse'
);

CREATE TABLE iceberg_catalog.ecommerce.orders (
    id BIGINT,
    user_id BIGINT,
    amount DECIMAL(10,2),
    status STRING,
    order_time TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'format-version' = '2',
    'write.upsert.enabled' = 'true'
);

INSERT INTO iceberg_catalog.ecommerce.orders
SELECT * FROM orders_source;
Iceberg v2 表格式支持行级删除(Row-Level Delete),通过 Upsert 实现 CDC 数据写入。Flink CDC 3.x Pipeline 也提供了 Iceberg Sink Connector。
7.6 Hudi Sink
CREATE TABLE hudi_orders (
    id BIGINT,
    user_id BIGINT,
    amount DECIMAL(10,2),
    status STRING,
    order_time TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'hudi',
    'path' = 'hdfs:///user/hudi/orders',
    'table.type' = 'MERGE_ON_READ',
    'hoodie.datasource.write.recordkey.field' = 'id',
    'hoodie.datasource.write.precombine.field' = 'order_time',
    'write.operation' = 'upsert',
    'write.tasks' = '4'
);

INSERT INTO hudi_orders
SELECT * FROM orders_source;
Hudi MOR 表通过 Compaction 合并增量数据,适合高频更新场景。Flink CDC 3.6 新增了 Hudi Pipeline Sink Connector。
7.7 JDBC Sink(MySQL/PostgreSQL)
CREATE TABLE jdbc_orders (
    id BIGINT,
    user_id BIGINT,
    amount DECIMAL(10,2),
    status STRING,
    order_time TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'jdbc',
    'url' = 'jdbc:mysql://127.0.0.1:3306/ecommerce_dwd',
    'table-name' = 'orders',
    'username' = 'root',
    'password' = 'root',
    'driver' = 'com.mysql.cj.jdbc.Driver',
    -- Upsert 模式
    'sink.buffer-flush.max-rows' = '1000',
    'sink.buffer-flush.interval' = '2s',
    'sink.max-retries' = '3'
);
注意:Flink JDBC Sink 在处理 UPDATE / DELETE 时需要目标表有主键约束。对于 MySQL,会自动生成
INSERT ... ON DUPLICATE KEY UPDATE语句实现 Upsert。
7.8 Redis Sink
Redis 通常作为缓存层或实时指标存储:
CREATE TABLE redis_orders (
    id BIGINT,
    user_id BIGINT,
    amount DECIMAL(10,2),

    status STRING,
    order_time TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'redis',
    'redis-mode' = 'single',
    'host' = '127.0.0.1',
    'port' = '6379',
    'password' = '',
    'command' = 'SET',
    'ttl' = '86400'
);
Redis 写入是幂等的(SET 覆盖写),但无法表达 DELETE 语义,需要通过 TTL 或特殊值处理。
7.9 Elasticsearch Sink
CREATE TABLE es_orders (
    id BIGINT,
    user_id BIGINT,
    amount DECIMAL(10,2),
    status STRING,
    order_time TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'elasticsearch-7',
    'hosts' = 'http://127.0.0.1:9200',
    'index' = 'orders',
    'document-id.key-delimiter' = '_',
    'sink.bulk-flush.max-actions' = '1000',
    'sink.bulk-flush.interval' = '5s',
    'sink.bulk-flush.backoff.strategy' = 'EXPONENTIAL',
    'sink.bulk-flush.backoff.max-retries' = '3'
);

INSERT INTO es_orders
SELECT * FROM orders_source;
Flink CDC 3.2 新增了 Elasticsearch Pipeline Sink Connector,支持在 ES 6.8 / 7.10 / 8.12 上验证通过。ES 的文档 ID 为主键,写入天然幂等。
7.10 各 Sink 语义对比
| Sink | 写入方式 | Upsert 支持 | Delete 支持 | Exactly-Once |
|---|---|---|---|---|
| Kafka | Producer 发送 | ❌(追加) | ✅(消息中携带) | ✅(2PC 事务) |
| Doris | Stream Load | ✅(Unique Key) | ✅ | ✅(Label 幂等) |
| StarRocks | Stream Load | ✅(Primary Key) | ✅ | ✅(Label 幂等) |
| Paimon | Snapshot Commit | ✅ | ✅ | ✅ |
| Iceberg | Snapshot Commit | ✅(v2) | ✅(v2) | ✅ |
| Hudi | CoW / MoR | ✅ | ✅ | ✅ |
| JDBC | INSERT/UPSERT | ✅(主键) | ⚠️(需配置) | ⚠️(需幂等键) |
| Redis | SET/HSET | ✅ | ⚠️(特殊处理) | ❌(At-Least-Once) |
| Elasticsearch | Bulk API | ✅(doc ID) | ✅ | ⚠️(At-Least-Once) |
8. 整库同步与数据集成(3.x 核心)
3.x 最大的变革是引入了 YAML Pipeline 作为端到端整库同步的声明式方式,将数据集成从"写代码"简化为"写配置"。
8.1 整库同步架构
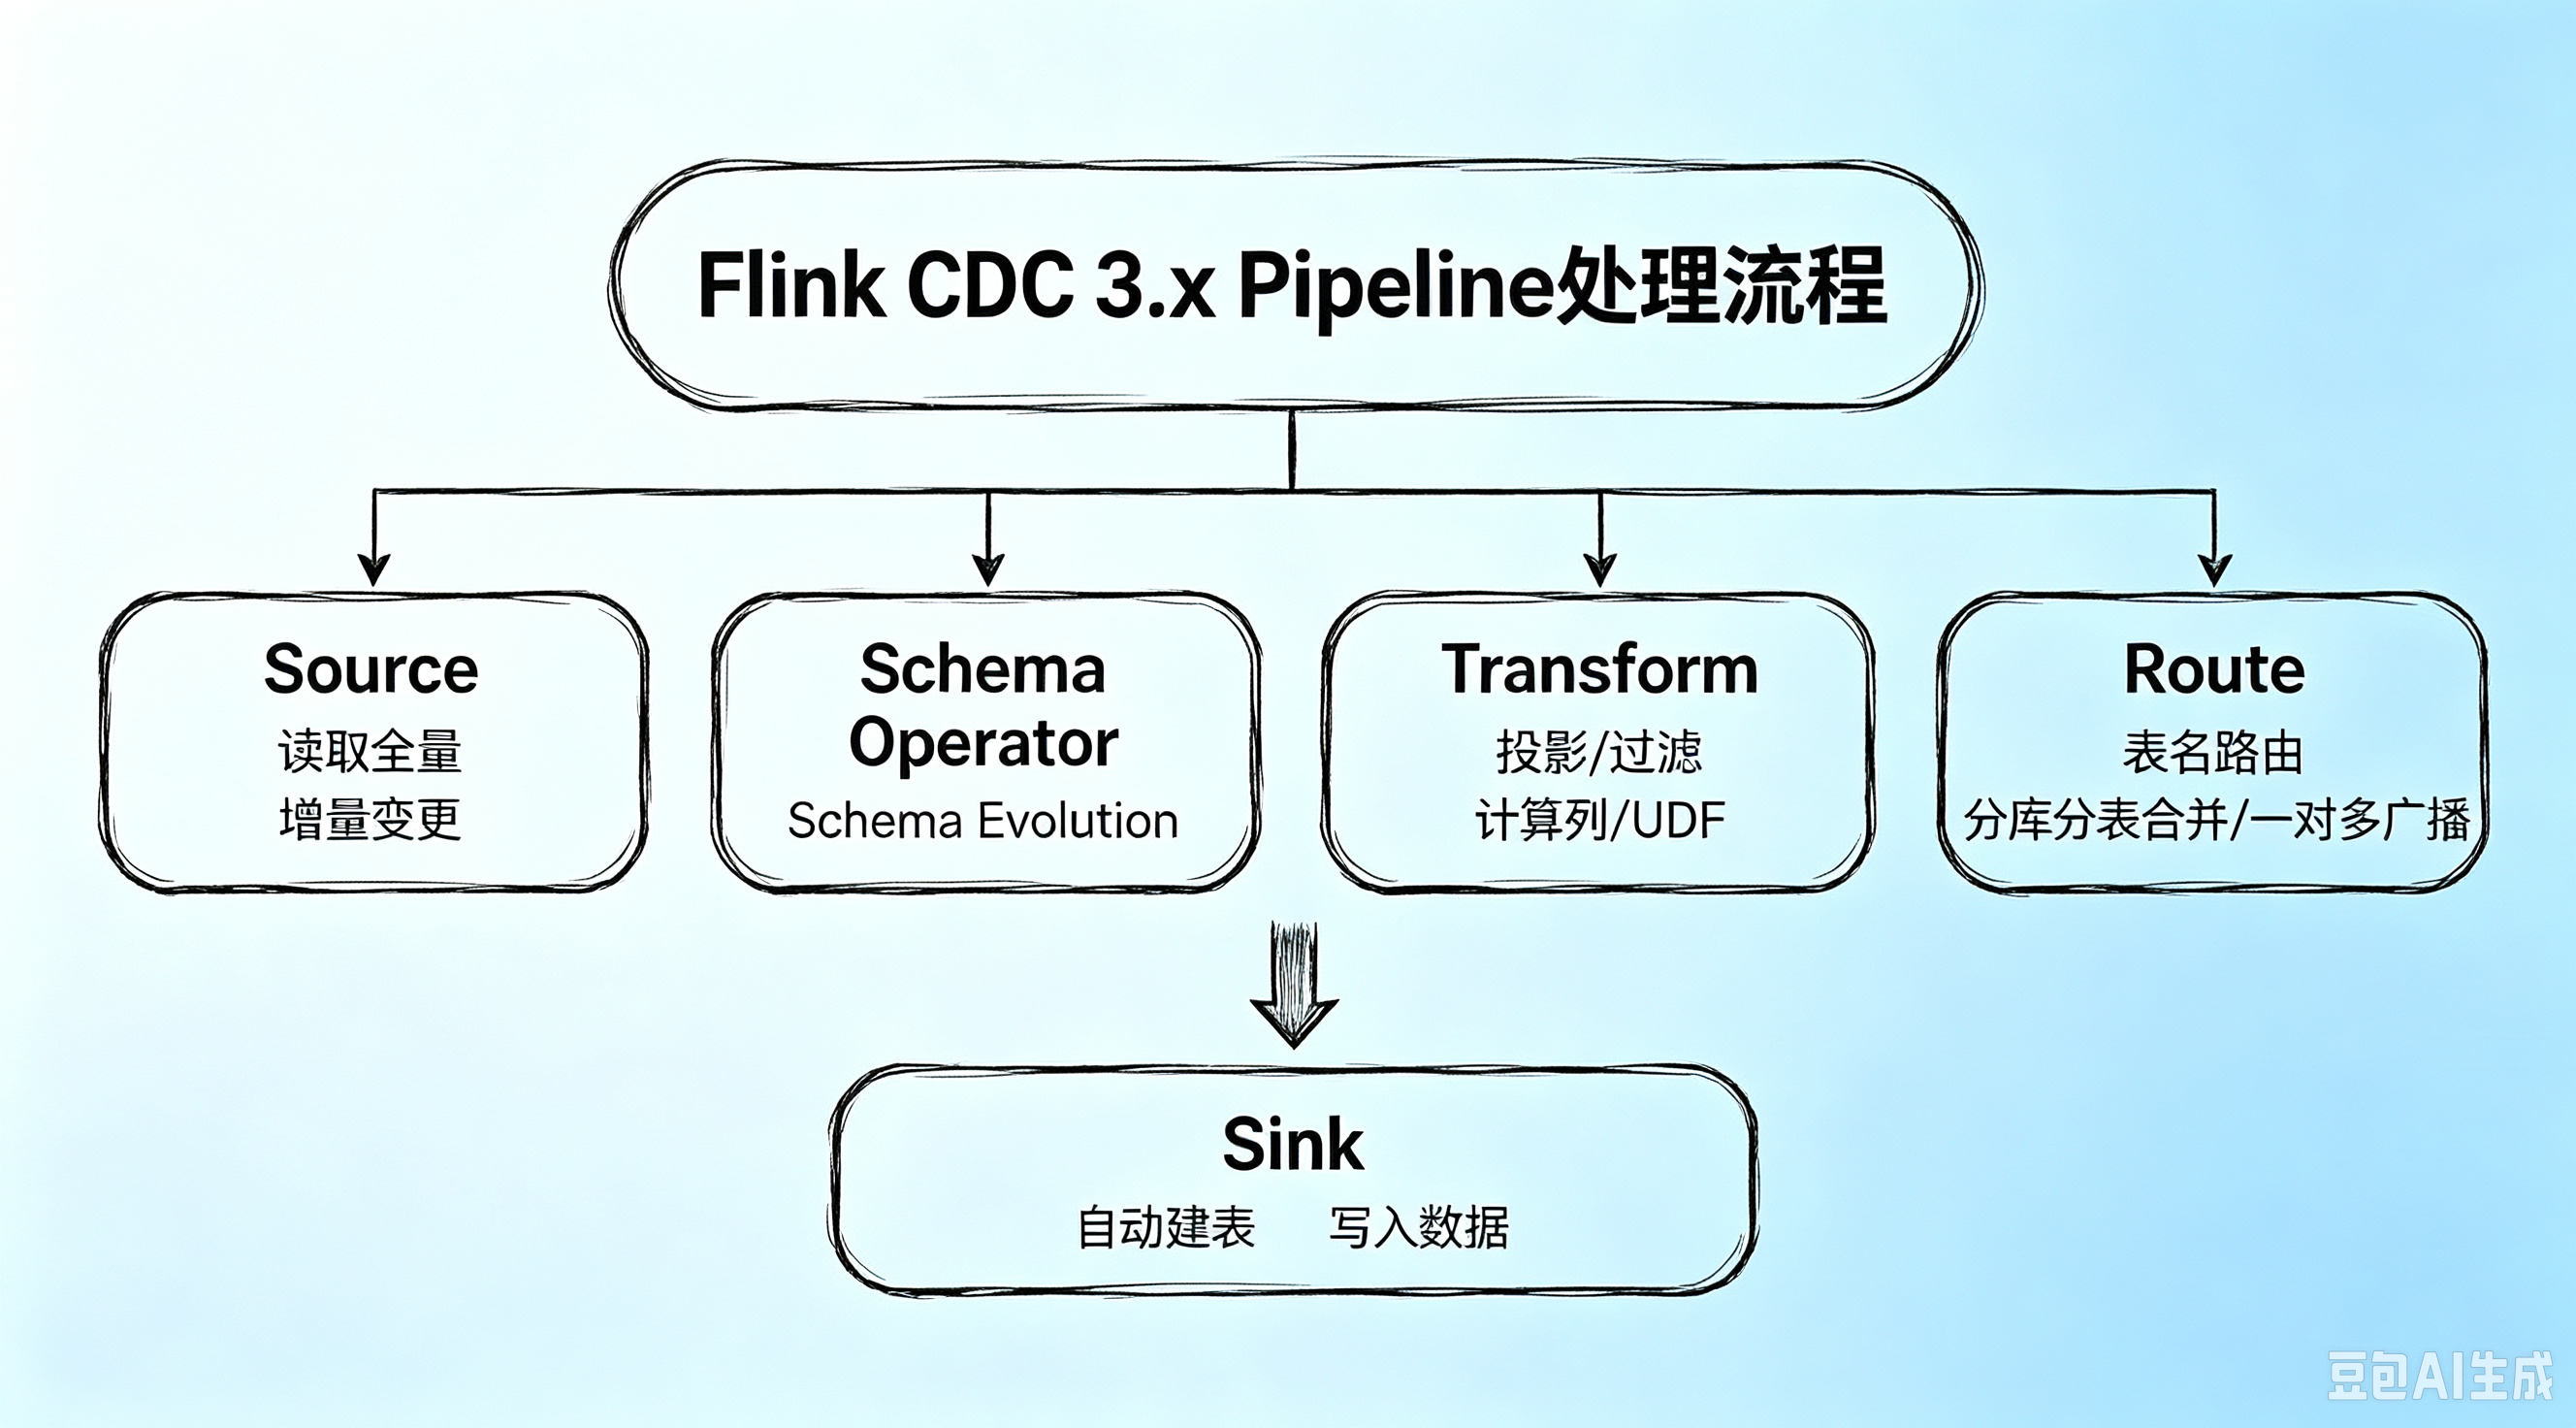
四大核心组件:
- Source:配置数据源连接信息和监控的表
- Transform:数据变换(投影列、过滤行、计算列、UDF)
- Route:路由规则(表名映射、分库分表合并、一对多广播)
- Sink:目标端配置
8.2 YAML 整库同步配置完整示例
# ============================================
# MySQL 整库同步到 Doris 完整配置
# ============================================

pipeline:
  name: MySQL-to-Doris-Full-Sync
  parallelism: 4
  schema.change.behavior: lenient

source:
  type: mysql
  name: MySQL Source
  hostname: 127.0.0.1
  port: 3306
  username: flinkcdc
  password: FlinkCDC@123
  # 监控 ecommerce 库下所有表
  tables: ecommerce.\.*
  # 排除不需要的表
  tables.exclude: ecommerce.temp_.*, ecommerce.log_.*
  server-id: 5401-5408
  server-time-zone: Asia/Shanghai
  scan.startup.mode: initial
  scan.incremental.snapshot.chunk.size: 8096
  schema-change.enabled: true

sink:
  type: doris
  name: Doris Sink
  fenodes: 127.0.0.1:8030
  username: root
  password: ""
  table.create.properties.light_schema_change: true
  table.create.properties.replication_num: 1
  sink.buffer-flush.interval: 1s
  sink.buffer-flush.max-rows: 10000
  sink.buffer-flush.max-bytes: 10485760

# ============================================
# Transform:数据变换
# ============================================
transform:
  - source-table: ecommerce.orders
    projection: id, user_id, product_id, quantity, amount, status, order_time,
                UPPER(status) AS status_upper,
                amount * quantity AS total_amount
    filter: status IS NOT NULL AND amount > 0

  - source-table: ecommerce.users
    projection: id, name, email, created_at,
                CONCAT(name, '_', id) AS user_key
    filter: id > 0

# ============================================
# Route:表名路由与分库分表合并
# ============================================
route:
  # 分表合并:order_0, order_1, ... → merged_orders
  - source-table: ecommerce.order_[0-9]+
    sink-table: ecommerce.merged_orders

  # 模式替换:所有源表名加 ods_ 前缀
  - source-table: ecommerce.\.*
    sink-table: ods_ecommerce.<>
    replace-symbol: "<>"

  # 一对多广播:将重要配置表同步到多个目标
  - source-table: ecommerce.config
    sink-table:
      - ecommerce.config_backup
      - ecommerce.config_archive
8.3 表名/库名路由规则
基础路由:
route:
  - source-table: ecommerce.orders
    sink-table: dwd.dwd_orders
正则匹配 + 模式替换(3.2+):
route:
  # 所有 ecommerce 库的表同步到 dwd 库,表名加 dwd_ 前缀
  - source-table: ecommerce.\.*
    sink-table: dwd.dwd_<>
    replace-symbol: "<>"
    description: "将 ecommerce.* 路由到 dwd.dwd_*"
上述规则会自动将 ecommerce.orders 路由到 dwd.dwd_orders,ecommerce.users 路由到 dwd.dwd_users。
多库合并:
route:
  - source-table: db0.\.*
    sink-table: merged.<>
    replace-symbol: "<>"
  - source-table: db1.\.*
    sink-table: merged.<>
    replace-symbol: "<>"
8.4 列裁剪与类型转换
Transform 支持:
transform:
  - source-table: ecommerce.orders
    # 列裁剪 + 计算列 + 类型转换
    projection: |
      id,
      CAST(user_id AS STRING) AS user_id_str,
      amount,
      quantity,
      amount * quantity AS total_amount,
      CASE
        WHEN status = '1' THEN 'pending'
        WHEN status = '2' THEN 'paid'
        WHEN status = '3' THEN 'shipped'
        ELSE 'unknown'
      END AS status_desc,
      CURRENT_TIMESTAMP AS sync_time
    filter: amount > 0 AND status IS NOT NULL
3.1 版本支持投影、计算列、常量列;3.2 版本新增 CAST ... AS ... 内置函数,支持 Transform UDF。
8.5 多对一、一对多路由
多对一(分库分表合并):
route:
  # 将多个分表合并到一张表
  - source-table: ecommerce.order_0
    sink-table: ecommerce.all_orders
  - source-table: ecommerce.order_1
    sink-table: ecommerce.all_orders
  - source-table: ecommerce.order_2
    sink-table: ecommerce.all_orders
  # 或使用正则
  - source-table: ecommerce.order_[0-2]
    sink-table: ecommerce.all_orders
当多张分表的 Schema 不完全一致时(如某张表新增了列),Flink CDC 会:
- 自动将新增列同步到合并表
- 其他没有该列的表对应字段填充 NULL
- 类型不一致时尝试推导协变类型(如 FLOAT → DOUBLE,SMALLINT → BIGINT)
- 无法无损转换时抛出错误停止任务
一对多(广播)(3.2+):
route:
  - source-table: ecommerce.config
    sink-table:
      - ecommerce.config_backup
      - ecommerce.config_archive
      - reporting.config_report
8.6 提交整库同步任务
# 基本提交
bash $FLINK_CDC_HOME/bin/flink-cdc.sh /path/to/mysql-to-doris.yaml

# 指定额外 JAR(如 JDBC 驱动)
bash $FLINK_CDC_HOME/bin/flink-cdc.sh /path/to/pipeline.yaml \
  --jar /path/to/mysql-connector-java-8.0.27.jar

# 从 Savepoint 恢复
bash $FLINK_CDC_HOME/bin/flink-cdc.sh /path/to/pipeline.yaml \
  --from-savepoint /path/to/savepoint

# 提交到 YARN 集群
bash $FLINK_CDC_HOME/bin/flink-cdc.sh /path/to/pipeline.yaml \
  --target yarn-per-job

# 提交到 Kubernetes(3.2+)
bash $FLINK_CDC_HOME/bin/flink-cdc.sh /path/to/pipeline.yaml \
  --target kubernetes-application
8.7 Schema 变更自动同步演示
- 初始状态:MySQL
orders表有id, user_id, amount三列 - 提交 YAML Pipeline 任务,Doris 自动创建对应结构的表
- 在 MySQL 中执行 DDL:
-- 新增列
ALTER TABLE orders ADD COLUMN discount DECIMAL(5,2) DEFAULT 0;

-- 修改列类型
ALTER TABLE orders MODIFY COLUMN amount DECIMAL(12,2);

-- 重命名列
ALTER TABLE orders CHANGE COLUMN status order_status VARCHAR(20);
- Flink CDC 自动捕获这些 SchemaChangeEvent,在 Doris 中执行对应的 DDL,并继续同步数据,无需重启任务。
注意:Schema Evolution 的效果取决于 Sink 的支持程度。Doris、StarRocks、Paimon 支持较好;Kafka 作为消息队列本身无 Schema 概念,但 Pipeline 会更新内部 Schema 信息。
9. 实时数仓典型架构
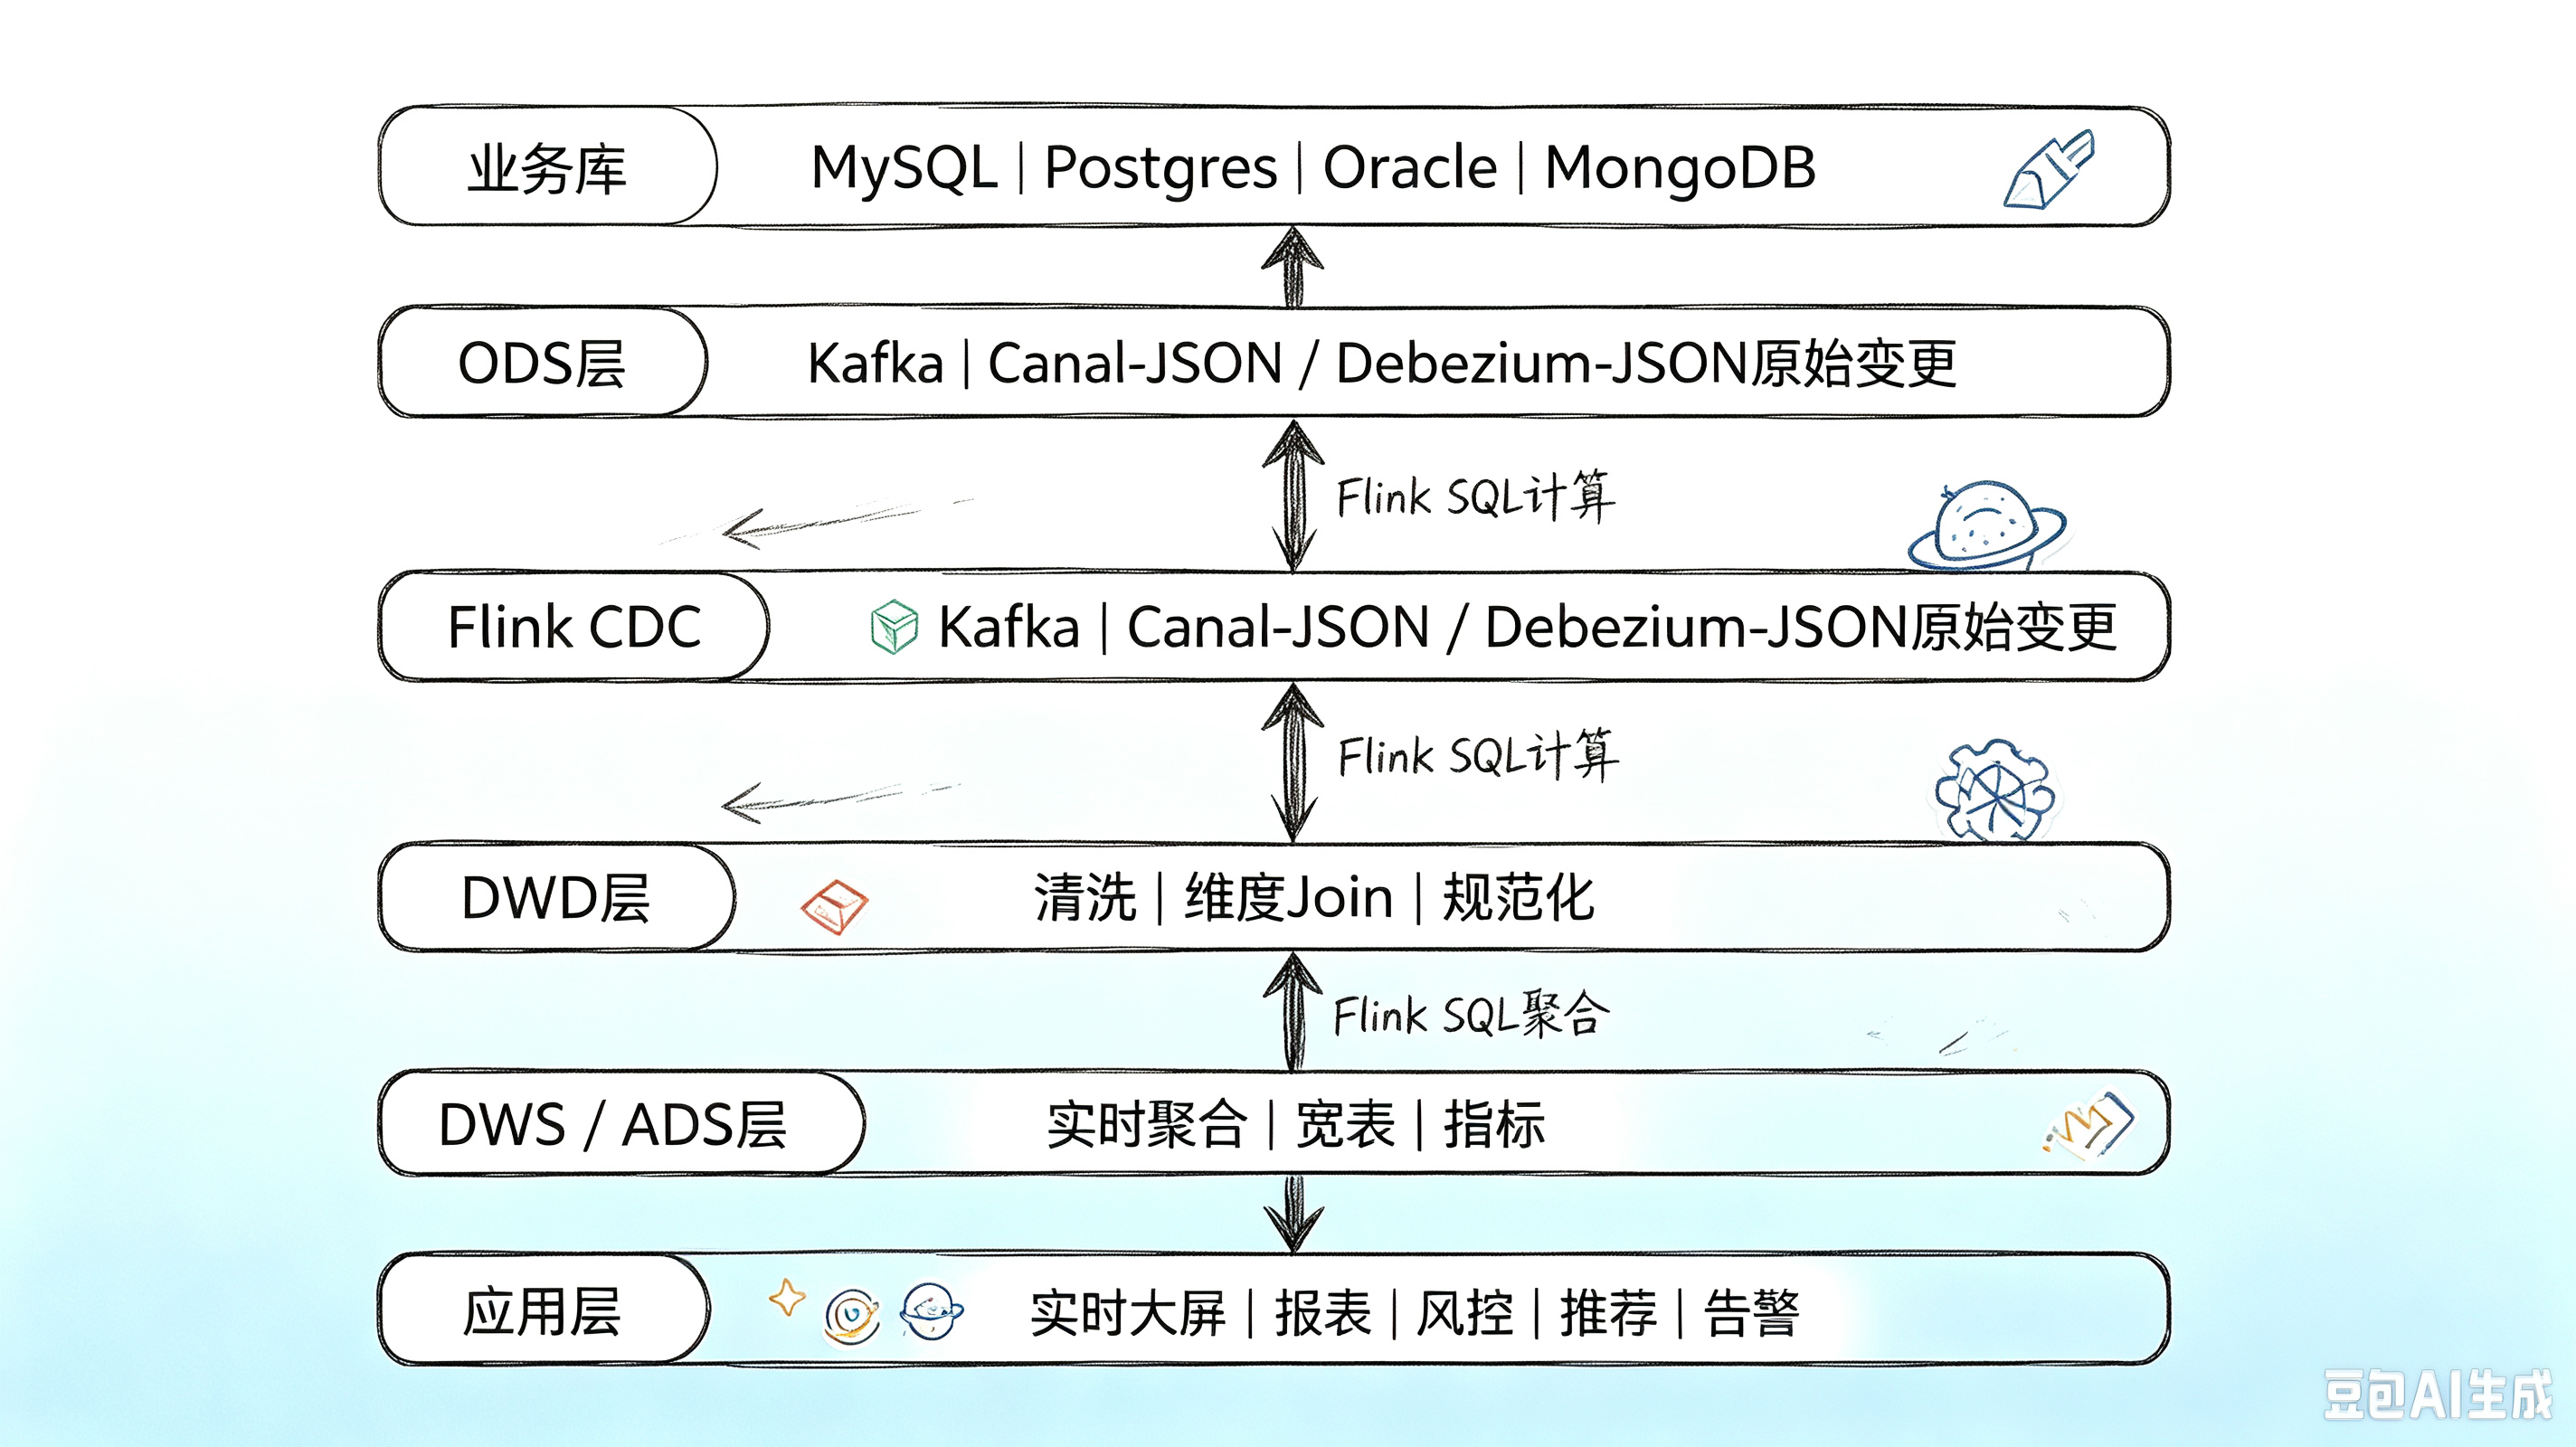
9.1 分层架构
基于 Flink CDC 构建实时数仓的典型分层:
9.2 ODS 层:MySQL CDC → Kafka
ODS 层直接将业务库 Binlog 投递到 Kafka,保留原始变更记录:
-- MySQL CDC Source
CREATE TABLE ods_orders_source (
    id BIGINT,
    user_id BIGINT,
    product_id BIGINT,
    quantity INT,
    amount DECIMAL(10,2),
    status STRING,
    order_time TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'mysql-cdc',
    'hostname' = 'mysql',
    'port' = '3306',
    'username' = 'flinkcdc',
    'password' = 'FlinkCDC@123',
    'database-name' = 'ecommerce',
    'table-name' = 'orders',
    'server-id' = '5400-5404',
    'scan.startup.mode' = 'initial'
);

-- Kafka Sink
CREATE TABLE ods_orders_kafka (
    id BIGINT,
    user_id BIGINT,
    product_id BIGINT,
    quantity INT,
    amount DECIMAL(10,2),
    status STRING,
    order_time TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'kafka',
    'topic' = 'ods_orders',
    'properties.bootstrap.servers' = 'kafka:9092',
    'format' = 'canal-json'
);

INSERT INTO ods_orders_kafka SELECT * FROM ods_orders_source;
9.3 DWD 层:Kafka → Flink SQL 清洗 → Doris
-- 从 Kafka 读取 ODS 数据
CREATE TABLE dwd_orders_source (
    id BIGINT,
    user_id BIGINT,
    product_id BIGINT,
    quantity INT,
    amount DECIMAL(10,2),
    status STRING,
    order_time TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'kafka',
    'topic' = 'ods_orders',
    'properties.bootstrap.servers' = 'kafka:9092',
    'properties.group.id' = 'dwd-group',
    'format' = 'canal-json',
    'scan.startup.mode' = 'earliest-offset'
);

-- 维度表:用户信息(CDC 实时更新)
CREATE TABLE dim_users (
    id BIGINT,
    name STRING,
    level STRING,
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'mysql-cdc',
    'hostname' = 'mysql',
    'port' = '3306',
    'username' = 'flinkcdc',
    'password' = 'FlinkCDC@123',
    'database-name' = 'ecommerce',
    'table-name' = 'users',
    'server-id' = '5410-5414'
);

-- DWD 明细宽表写入 Doris
CREATE TABLE dwd_orders_detail (
    order_id BIGINT,
    user_id BIGINT,
    user_name STRING,
    user_level STRING,
    product_id BIGINT,
    quantity INT,
    amount DECIMAL(10,2),
    status STRING,
    order_time TIMESTAMP(3),
    PRIMARY KEY (order_id) NOT ENFORCED
) WITH (
    'connector' = 'doris',
    'fenodes' = 'doris:8030',
    'table.identifier' = 'dwd.orders_detail',
    'username' = 'root',
    'password' = ''
);

-- 实时维度关联(Lookup Join 或 Regular Join)
INSERT INTO dwd_orders_detail
SELECT
    o.id AS order_id,
    o.user_id,
    u.name AS user_name,
    u.level AS user_level,
    o.product_id,
    o.quantity,
    o.amount,
    o.status,
    o.order_time
FROM dwd_orders_source AS o
LEFT JOIN dim_users FOR SYSTEM_TIME AS OF o.order_time AS u
ON o.user_id = u.id;
9.4 DWS 层:实时聚合
CREATE TABLE dws_sales_summary (
    dt STRING,
    hour_str STRING,
    total_orders BIGINT,
    total_amount DECIMAL(18,2),
    avg_amount DECIMAL(10,2),
    PRIMARY KEY (dt, hour_str) NOT ENFORCED
) WITH (
    'connector' = 'doris',
    'fenodes' = 'doris:8030',
    'table.identifier' = 'dws.sales_hourly',
    'username' = 'root',
    'password' = ''
);

INSERT INTO dws_sales_summary
SELECT
    DATE_FORMAT(order_time, 'yyyy-MM-dd') AS dt,
    DATE_FORMAT(order_time, 'HH') AS hour_str,
    COUNT(DISTINCT id) AS total_orders,
    SUM(amount) AS total_amount,
    AVG(amount) AS avg_amount
FROM dwd_orders_detail
GROUP BY
    DATE_FORMAT(order_time, 'yyyy-MM-dd'),
    DATE_FORMAT(order_time, 'HH');
9.5 Lambda vs Kappa 在 CDC 场景
| 架构 | 描述 | CDC 场景适用性 |
|---|---|---|
| Lambda | 批处理层(T+1 全量修正)+ 速度层(实时增量)双链路 | 早期方案,维护两套代码成本高 |
| Kappa | 统一流处理,Kafka 保留全量变更日志,重放即可回溯 | ✅ 更适合 CDC,Flink CDC 天然支持全量+增量一体化 |
Flink CDC 的全量快照 + 增量读取能力使得 Kappa 架构在数据同步场景变得切实可行——无需额外的批处理链路,一套流式代码同时处理历史数据和实时变更。
9.6 CDC 构建实时数仓的优势与挑战
优势:
- 数据实时性从 T+1 提升到秒级
- 解耦业务系统与数据系统,业务代码无需改造
- 一套代码同时处理全量和增量,降低维护成本
- Flink 强大的 SQL/CEP/窗口能力支撑复杂实时计算
挑战:
- 业务库的 DDL 变更需要妥善处理(Schema Evolution)
- 大事务可能导致消费延迟和内存压力
- 数据质量监控比批处理更难
- 多表 Join 的状态管理可能成为瓶颈
- 需要完善的监控和告警体系
10. 性能调优
10.1 全量快照并行度调优
Chunk Key 选择:
- 优先选择分布均匀的自增主键
- 复合主键时注意第一列的基数(Cardinality),如果第一列重复值多会导致 Chunk 大小不均
- 3.2+ 支持指定非主键列作为 Chunk Key,但需确保该列有索引
分片大小调整:
'scan.incremental.snapshot.chunk.size' = '10000' -- 默认 8096
| chunk.size 增大 | chunk.size 减小 |
|---|---|
| Chunk 数量减少,JM 内存压力小 | Chunk 数量多,JM 元数据开销大 |
| 单 Chunk 数据量大,TM 内存压力大 | 单 Chunk 数据量小,TM 内存压力小 |
| 吞吐高,但故障恢复粒度粗 | 吞吐略低,但故障恢复粒度细 |
经验值:
- 小表(< 100 万行):默认 8096 即可
- 大表(> 1 亿行):调大到 20000-50000,减少 Chunk 总数
- 出现 JM OOM:增大 chunk.size 或增大
jobmanager.memory.heap.size - 出现 TM OOM:减小 chunk.size 或增大
taskmanager.memory.framework.heap.size
并行度设置:
SET 'parallelism.default' = '8';
并行度应根据以下因素调整:
- 数据源的读能力(MySQL 连接数、IO 负载)
- 下游 Sink 的写入能力
- 可用的 TaskManager Slot 数量
server-id范围必须大于并行度
10.2 增量阶段 Binlog 消费优化
增量阶段为单并发读取 Binlog,优化方向:
- 增大 Debezium 内部队列和批次:
'debezium.max.queue.size' = '162580',   -- 默认 8192
'debezium.max.batch.size' = '40960',    -- 默认 2048
'debezium.poll.interval.ms' = '50'      -- 默认 1000
- 心跳保活:
'heartbeat.interval' = '30s'
心跳事件可以:
- 防止长时间无变更时连接被防火墙/数据库断开
- 更新低位水印(Low Watermark),避免大事务期间 Checkpoint 超时
- 仅解析需要的表(VVR 8.0.7+):
'scan.only.deserialize.captured.tables.changelog.enabled' = 'true'
10.3 服务端 ID 管理与冲突避免
- 每个运行中的 CDC 任务必须拥有唯一的
server-id - 并行读取时
server-id配置为范围(如5400-5408),范围大小需大于并行度 - 不同任务之间不要使用重叠的 server-id 范围
- 在 MySQL 中查看当前连接的从节点:
SHOW SLAVE HOSTS;
10.4 心跳事件与连接保活
当数据库长时间没有变更时,Binlog 连接可能因空闲超时而断开。配置心跳:
'heartbeat.interval' = '30s' -- 每 30 秒发送一次心跳
心跳事件的作用:
- 保持数据库连接活跃
- 在有未提交大事务时,定期推送位点信息推进 Checkpoint
- 避免因长时间无数据导致的 Checkpoint 超时
10.5 内存管理
| 阶段 | 内存消耗点 | 优化建议 |
|---|---|---|
| 快照阶段 | 每个 Chunk 的数据缓存 | 控制 chunk.size,避免单 Chunk 过大 |
| 快照阶段 | JM 中所有 Chunk 元数据 | 大表增大 chunk.size 减少 Chunk 数 |
| 增量阶段 | Binlog 解析队列 | 调整 debezium.max.queue.size |
| 增量阶段 | 大事务事件缓存 | 监控大事务,拆分事务或增大 TM 内存 |
| 下游 Join | Flink 状态后端 | 使用 RocksDB 状态后端,增大状态 TTL |
Flink 配置建议:
# flink-conf.yaml
jobmanager.memory.process.size: 2048m
taskmanager.memory.process.size: 4096m
taskmanager.memory.framework.heap.size: 512m
state.backend: rocksdb
state.checkpoints.dir: hdfs:///flink/checkpoints
state.savepoints.dir: hdfs:///flink/savepoints
execution.checkpointing.interval: 60000
execution.checkpointing.timeout: 600000
10.6 反压处理
反压信号:在 Flink Web UI 中,Source 或中间算子出现红色 Backpressure 标识。
常见原因与解决方案:
| 原因 | 表现 | 解决方案 |
|---|---|---|
| Sink 写入慢 | Sink 算子反压 | 增大 Sink 并行度、批量写入、优化 Sink 连接 |
| 大事务 | Binlog 阶段突然延迟 | 拆分上游大事务、增大 TM 内存、心跳推进 Checkpoint |
| 数据倾斜 | 某个 Subtask 负载高 | 调整 Chunk Key、重分区、Salting |
| GC 问题 | 反压与 GC 停顿同时出现 | 增大 JVM 堆、调优 GC 参数、使用 G1GC |
| 下游存储瓶颈 | Sink 写入延迟高 | 检查目标库负载、增大批量、读写分离 |
10.7 关键配置参数速查表
| 参数 | 默认值 | 推荐值 | 说明 |
|---|---|---|---|
scan.incremental.snapshot.enabled | true | true | 启用并行无锁快照 |
scan.incremental.snapshot.chunk.size | 8096 | 8096-50000 | Chunk 行数 |
scan.snapshot.fetch.size | 1024 | 2000-5000 | 每次 fetch 行数 |
server-id | 随机 | 显式范围 | 必须全局唯一 |
heartbeat.interval | 30s | 30s | 心跳间隔 |
connection.pool.size | 20 | 20-30 | JDBC 连接池 |
debezium.max.queue.size | 8192 | 162580 | Debezium 内部队列 |
debezium.max.batch.size | 2048 | 40960 | 每批最大事件数 |
debezium.poll.interval.ms | 1000 | 50 | 轮询间隔 |
connect.timeout | 30s | 30s | 连接超时 |
parallelism.default | 1 | 4-16 | 作业并行度 |
| Checkpoint 间隔 | — | 60s | 生产建议 |
11. 常见问题与踩坑
11.1 Binlog 格式不对
现象:启动报错 The MySQL server is not configured with binlog_format=ROW 或数据中 UPDATE 事件缺少变更前数据。
原因:binlog_format 设置为 STATEMENT 或 MIXED。
解决:
binlog_format=ROW
binlog_row_image=FULL
动态修改(无需重启,但新连接才生效):
SET GLOBAL binlog_format = 'ROW';
SET GLOBAL binlog_row_image = 'FULL';
11.2 server-id 冲突/重复
现象:报错 A slave with the same server_uuid/server_id as this slave has connected to the master 或数据异常中断。
原因:多个 CDC 任务或 MySQL 从库使用了相同的 server-id。
解决:
- 为每个 Flink CDC 任务分配不同的 server-id 范围
- 范围大小大于并行度
- 记录所有 CDC 任务的 server-id 分配,避免冲突
11.3 全量快照慢/锁表
现象:2.x 版本全量阶段数据库卡住,业务写入阻塞。
原因:旧版快照算法使用 FLUSH TABLES WITH READ LOCK 获取全局读锁。
解决:3.x 默认启用增量快照(scan.incremental.snapshot.enabled=true),无需加锁。如果仍在使用 2.x,升级到 3.x 或确保使用增量快照模式。
11.4 大事务导致延迟/OOM
现象:MySQL 执行一个百万行的大 UPDATE/DELETE 后,Flink CDC 消费延迟飙升甚至 OOM。
原因:Debezium 会将整个事务缓存在内存中,直到事务 COMMIT 才向下游发送。大事务占用大量内存。
解决:
- 与业务方沟通,将大事务拆分为小批次
- 增大 TaskManager 内存
- 配置心跳事件推进 Checkpoint
- 监控 MySQL 长事务:
SELECT * FROM information_schema.innodb_trx
11.5 时区问题
现象:TIMESTAMP / DATETIME 字段时间相差 8 小时。
原因:Flink 集群时区与 MySQL 会话时区不一致。
解决:
'server-time-zone' = 'Asia/Shanghai'
或在 Flink 配置中设置:
env.java.opts: "-Duser.timezone=Asia/Shanghai"
11.6 类型不支持/精度丢失
常见问题:
- MySQL
UNSIGNED BIGINT超出 Java Long 范围 → 使用 DECIMAL BINARY/VARBINARY→ 映射为 BYTESJSON类型 → 映射为 STRINGDECIMAL精度不一致 → 显式指定 Flink DECIMAL 精度
建议:建表时仔细对照类型映射表,对于特殊类型使用自定义反序列化器处理。
11.7 Schema 变更导致任务失败
现象:上游执行 ALTER TABLE ADD COLUMN 后任务报错。
原因:
- 2.x 不支持 Schema Evolution
- 3.x Sink 不支持对应 DDL(如 Kafka Sink 无表结构概念)
- Schema Evolution 行为模式设置为
exception
解决:
- 升级到 3.x 并配置
lenient或try_evolve模式 - 对于 SQL 方式,需要手动在 Flink 表和下游表中添加列后重启任务
11.8 Kafka Connect/Debezium 与 Flink CDC 混用问题
现象:同时使用 Debezium Kafka Connect 和 Flink CDC 读取同一个 MySQL 实例,出现 server-id 冲突或数据重复。
解决:
- 确保两者使用不同的 server-id
- 不要将 Flink CDC 与 Kafka Connect Debezium 指向同一个 MySQL server-id
- 理解两者的定位差异:Flink CDC 是一体化方案,不需要 Kafka Connect 中转
11.9 Exactly-Once 端到端注意事项
端到端 Exactly-Once 需要三个环节同时满足:
- Source 端:Flink CDC 基于 Checkpoint 保证 Exactly-Once(✅)
- Flink 计算:Checkpoint + State Backend 保证(✅)
- Sink 端:需要 Sink 支持事务或幂等写入
| Sink 类型 | Exactly-Once 方式 |
|---|---|
| Kafka | 两阶段提交(事务) |
| Doris/StarRocks | Stream Load Label 幂等 |
| Paimon/Iceberg/Hudi | Snapshot 两阶段提交 |
| JDBC | 依赖主键 Upsert 幂等 |
| Redis | 仅 At-Least-Once |
11.10 快照期间 DDL 处理
现象:在全量快照进行期间,上游执行了 DDL,导致快照数据与 Binlog 数据 Schema 不一致。
解决:3.x 的增量快照算法通过 Offset Signal Algorithm 处理快照期间的变更——在 LOW 和 HIGH 水位之间的 Binlog 变更会被 Upsert 到快照结果中,DDL 事件也会被正确处理。但建议尽量避免在全量同步高峰期执行 DDL。
11.11 Checkpoint 失败/状态过大
现象:Checkpoint 频繁超时或失败,State 大小持续增长。
原因与解决:
- 大事务期间 Checkpoint 超时:配置心跳事件,增大
execution.checkpointing.timeout - 状态过大(Join/Aggregation):使用 RocksDB 状态后端,设置 State TTL
- 快照阶段 Chunk 进度状态过多:增大 chunk.size 减少 Chunk 数量
- 反压导致 Barrier 对齐慢:解决反压问题,或启用 Unguarded Checkpoint
12. Flink CDC 3.x 新特性深度解析
12.1 增量快照算法演进
Flink CDC 2.0 引入增量快照算法,3.x 持续增强:
- lock-free:无需
FLUSH TABLES WITH READ LOCK - parallel:多 Reader 并行读取不同 Chunk
- backfill:Chunk 读取完成后,回填 LOW 到 HIGH 水位间的 Binlog 变更
- checkpoint at chunk granularity:Chunk 级 Checkpoint,故障恢复更高效
- 3.2 增强:支持任意列作为 Chunk Key(不再局限于主键列)
- 自动缩容:快照完成后自动减少增量阶段的 Reader 数量,释放资源
12.2 数据源生态扩展
3.x 版本 Pipeline Connector 生态扩展路线:
| 版本 | 新增 Pipeline Connector |
|---|---|
| 3.0 | MySQL Source, Doris Sink, StarRocks Sink |
| 3.1 | Kafka Sink, Paimon Sink |
| 3.2 | Elasticsearch Sink |
| 3.5 | Fluss Sink, PostgreSQL Source |
| 3.6 | Oracle Source, Hudi Sink |
SQL Source Connector 已覆盖 10+ 种数据库。
12.3 Pipeline Connector 与整库同步 YAML
YAML Pipeline 是 3.x 的核心创新:
- 声明式配置:无需写 Java/Scala 代码
- 自动建表:下游表自动创建,无需手动 DDL
- 端到端集成:Source → Transform → Route → Sink 全链路
- CLI 提交:
flink-cdc.sh一行命令 - 多部署模式:Standalone、YARN、Kubernetes(3.2+)
12.4 Schema Evolution 演进
| 版本 | Schema Evolution 能力 |
|---|---|
| 3.0 | 基础 AddColumn / DropColumn 支持 |
| 3.1 | Transform 与 Schema Evolution 协同 |
| 3.2 | 五种行为模式(Lenient / TryEvolve / Evolve / Ignore / Exception)+ 事件类型级控制 |
| 3.5 | 故障恢复时重新下发 Schema 信息;大小写敏感处理 |
| 3.6 | PostgreSQL Schema Evolution 支持;AlterTableComment / AlterColumnComment 事件;投影更新时 Schema 差异检测 |
12.5 动态新增表同步
3.x 支持在作业运行过程中动态添加监控表:
- 修改 YAML 配置中的
tables规则 - 从 Savepoint 恢复任务
- 新添加的表会自动触发全量快照并接入增量 Binlog 流
- 不影响已有表的同步进度
12.6 Flink 版本兼容性
| Flink CDC 版本 | 支持的 Flink 版本 | JDK 要求 |
|---|---|---|
| 3.0.x | 1.14 - 1.18 | JDK 8+ |
| 3.1.x | 1.14 - 1.18 | JDK 8+ |
| 3.2.x | 1.17 - 1.20 | JDK 8+ |
| 3.5.x | 1.18 - 1.20 | JDK 8+ |
| 3.6.x | 1.20.x / 2.x | JDK 11(强制) |
12.7 未来路线图
根据 Flink CDC 社区的公开讨论,未来方向包括:
- 更多 Pipeline Connector(如更多 Sink 支持)
- Transform 能力增强(更多内置函数、复杂类型支持)
- 3.6 已引入 VARIANT 类型和
PARSE_JSON函数,增强半结构化数据处理 - 正则路由(3.6+)和首个匹配路由规则
- 更完善的 Schema Evolution(如 PostgreSQL 已在 3.6 支持)
- 性能持续优化(Binlog 读取、Chunk 切分、并行解析)
13. 端到端实战项目
13.1 项目背景
某电商平台业务库(MySQL)包含订单、用户、商品三张核心表,需要实时同步到 Doris 数仓,支撑实时大屏和经营分析。
13.2 技术栈
MySQL → Flink CDC (YAML Pipeline) → Kafka (ODS)
                                      ↓
                               Flink SQL (DWD/DWS)
                                      ↓
                               Doris (ADS)
13.3 表结构准备
-- MySQL 建表
CREATE DATABASE ecommerce;
USE ecommerce;

CREATE TABLE users (
    id BIGINT AUTO_INCREMENT PRIMARY KEY,
    name VARCHAR(100) NOT NULL,
    email VARCHAR(200),
    level VARCHAR(20) DEFAULT 'bronze',
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE TABLE products (
    id BIGINT AUTO_INCREMENT PRIMARY KEY,
    name VARCHAR(200) NOT NULL,
    category VARCHAR(50),
    price DECIMAL(10,2),
    stock INT DEFAULT 0,
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE TABLE orders (
    id BIGINT AUTO_INCREMENT PRIMARY KEY,
    user_id BIGINT NOT NULL,
    product_id BIGINT NOT NULL,
    quantity INT NOT NULL,
    amount DECIMAL(10,2) NOT NULL,
    status VARCHAR(20) DEFAULT 'pending',
    order_time TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    INDEX idx_user (user_id),
    INDEX idx_product (product_id)
);

-- 插入测试数据
INSERT INTO users (name, email, level) VALUES
('Alice', 'alice@example.com', 'gold'),
('Bob', 'bob@example.com', 'silver'),
('Carol', 'carol@example.com', 'bronze');

INSERT INTO products (name, category, price, stock) VALUES
('iPhone 15', 'electronics', 6999.00, 100),
('AirPods Pro', 'electronics', 1899.00, 200),
('Python Book', 'books', 89.00, 500);

INSERT INTO orders (user_id, product_id, quantity, amount, status) VALUES
(1, 1, 1, 6999.00, 'paid'),
(2, 2, 2, 3798.00, 'shipped'),
(1, 3, 3, 267.00, 'pending');
13.4 整库同步 MySQL 到 Kafka(ODS)
创建 mysql-to-kafka.yaml:
pipeline:
  name: Ecommerce-ODS-Sync
  parallelism: 3
  schema.change.behavior: lenient

source:
  type: mysql
  hostname: 127.0.0.1
  port: 3306
  username: flinkcdc
  password: FlinkCDC@123
  tables: ecommerce.\.*
  server-id: 5400-5406
  server-time-zone: Asia/Shanghai
  scan.startup.mode: initial

sink:
  type: kafka
  properties.bootstrap.servers: 127.0.0.1:9092
  topic: ods_ecommerce
  key.format: json
  value.format: debezium-json
  partition.strategy: hash-by-key

route:
  - source-table: ecommerce.\.*
    sink-table: ods_ecommerce
提交:
bash flink-cdc.sh mysql-to-kafka.yaml
13.5 Flink SQL 清洗写入 Doris DWD
-- ============================================
-- DWD:订单明细宽表
-- ============================================
CREATE TABLE kafka_ods_orders (
    id BIGINT,
    user_id BIGINT,
    product_id BIGINT,
    quantity INT,
    amount DECIMAL(10,2),
    status STRING,
    order_time TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'kafka',
    'topic' = 'ods_ecommerce',
    'properties.bootstrap.servers' = '127.0.0.1:9092',
    'properties.group.id' = 'dwd-orders',
    'format' = 'debezium-json',
    'scan.startup.mode' = 'earliest-offset'
);

CREATE TABLE kafka_dim_users (
    id BIGINT,
    name STRING,
    level STRING,
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'kafka',
    'topic' = 'ods_ecommerce',
    'properties.bootstrap.servers' = '127.0.0.1:9092',
    'properties.group.id' = 'dwd-users',
    'format' = 'debezium-json',
    'scan.startup.mode' = 'earliest-offset'
);

CREATE TABLE doris_dwd_order_detail (
    order_id BIGINT,
    user_id BIGINT,
    user_name STRING,
    user_level STRING,
    product_id BIGINT,
    product_name STRING,
    product_category STRING,
    quantity INT,
    order_amount DECIMAL(10,2),
    status STRING,
    order_time TIMESTAMP(3),
    PRIMARY KEY (order_id) NOT ENFORCED
) WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'table.identifier' = 'dwd.order_detail',
    'username' = 'root',
    'password' = '',
    'sink.label-prefix' = 'dwd_order'
);

INSERT INTO doris_dwd_order_detail
SELECT
    o.id,
    o.user_id,
    u.name,
    u.level,
    o.product_id,
    p.name,
    p.category,
    o.quantity,
    o.amount,
    o.status,
    o.order_time
FROM kafka_ods_orders o
LEFT JOIN kafka_dim_users FOR SYSTEM_TIME AS OF o.order_time u
    ON o.user_id = u.id
LEFT JOIN kafka_dim_products FOR SYSTEM_TIME AS OF o.order_time p
    ON o.product_id = p.id;
13.6 实时聚合写入 Doris DWS
CREATE TABLE doris_dws_hourly_sales (
    stat_hour STRING,
    category STRING,
    order_count BIGINT,
    total_quantity BIGINT,
    total_amount DECIMAL(18,2),
    PRIMARY KEY (stat_hour, category) NOT ENFORCED
) WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'table.identifier' = 'dws.hourly_sales',
    'username' = 'root',
    'password' = '',
    'sink.label-prefix' = 'dws_sales'
);

INSERT INTO doris_dws_hourly_sales
SELECT
    DATE_FORMAT(order_time, 'yyyy-MM-dd-HH') AS stat_hour,
    product_category AS category,
    COUNT(DISTINCT order_id) AS order_count,
    SUM(quantity) AS total_quantity,
    SUM(order_amount) AS total_amount
FROM doris_dwd_order_detail
GROUP BY
    DATE_FORMAT(order_time, 'yyyy-MM-dd-HH'),
    product_category;
13.7 数据验证与监控
数据一致性验证:
-- MySQL 端订单总数
SELECT COUNT(*) FROM ecommerce.orders;

-- Doris 端订单总数
SELECT COUNT(*) FROM dwd.order_detail;

-- 对比金额
SELECT SUM(amount) FROM ecommerce.orders;
SELECT SUM(order_amount) FROM dwd.order_detail;
监控指标:
- Flink Web UI:Checkpoint 成功率、反压、消费延迟
- 自定义指标:Source 端
recordsConsumed、Sink 端recordsWritten - Doris:Stream Load 成功率、延迟
- 消费延迟:
MysqlSourceEventFetchDelay或通过 Binlog 位点与当前时间差计算
13.8 完整 YAML 一键整库同步(更简洁的替代方案)
实际上,3.x 的 YAML Pipeline 可以直接完成 MySQL → Doris 的整库同步,无需上面的中间 Kafka 步骤:
pipeline:
  name: Ecommerce-Full-Sync
  parallelism: 4
  schema.change.behavior: lenient

source:
  type: mysql
  hostname: 127.0.0.1
  port: 3306
  username: flinkcdc
  password: FlinkCDC@123
  tables: ecommerce.\.*
  server-id: 5400-5408
  server-time-zone: Asia/Shanghai

sink:
  type: doris
  fenodes: 127.0.0.1:8030
  username: root
  password: ""
  table.create.properties.light_schema_change: "true"
  table.create.properties.replication_num: "1"

transform:
  - source-table: ecommerce.orders
    projection: id, user_id, product_id, quantity, amount, status, order_time,
                amount * quantity AS total_amount
    filter: status IS NOT NULL

route:
  - source-table: ecommerce.\.*
    sink-table: dwd.<>
    replace-symbol: "<>"
bash flink-cdc.sh ecommerce-full-sync.yaml
一行命令完成:全量快照 → 增量同步 → Schema Evolution → 自动建表 → 数据变换 → 表名路由。这就是 3.x YAML Pipeline 的威力。
14. 学习路线与资源
14.1 学习阶段
阶段一:入门(1-2 周)
├── 理解 CDC 概念和 Binlog 原理
├── 搭建本地环境(Docker Compose)
├── 运行第一个 Flink SQL CDC Demo
└── 掌握 MySQL CDC Source DDL 参数

阶段二:进阶(2-4 周)
├── DataStream API 自定义反序列化
├── 配置多种 Sink(Kafka/Doris/Paimon)
├── 理解增量快照算法原理
├── Checkpoint 和 Exactly-Once 机制
└── 性能调优基础

阶段三:实战(4-8 周)
├── YAML Pipeline 整库同步
├── Transform 和 Route 配置
├── Schema Evolution 实践
├── 实时数仓分层建设
└── 生产问题排查

阶段四:源码(持续)
├── Flink CDC 源码编译与调试
├── 增量快照算法源码阅读
├── 自定义 Connector 开发
└── 社区贡献
14.2 官方资源
| 资源 | 链接 |
|---|---|
| 官方文档 | https://nightlies.apache.org/flink/flink-cdc-docs-stable/ |
| GitHub 仓库 | https://github.com/apache/flink-cdc |
| Release 下载 | https://github.com/apache/flink-cdc/releases |
| Flink 官网 | https://flink.apache.org/ |
| Debezium 文档 | https://debezium.io/documentation/ |
| DBLog 论文 | https://arxiv.org/abs/2610.01724 |
| Issue 跟踪 | https://issues.apache.org/jira/projects/FLINK/summary |
14.3 面试高频考点
1. Flink CDC 的全量和增量阶段是如何切换的?
所有 Chunk 快照读取完成后,等待一次完整 Checkpoint 成功(确保快照数据全部被下游消费),然后从快照结束时记录的 Binlog 高水位位点开始增量读取。
2. 增量快照算法为什么不需要加锁?
它使用 Offset Signal Algorithm:先记录 LOW 位点,读取 Chunk 数据,再记录 HIGH 位点,然后读取 LOW-HIGH 之间的 Binlog 变更并 Upsert 到快照结果中。整个过程通过 Binlog 回填保证一致性,无需全局读锁。
3. server-id 的作用和配置注意事项?
server-id 是 MySQL 复制协议中从节点的唯一标识。每个 CDC 任务必须使用唯一的 server-id;并行读取时需配置为范围,范围大小要大于并行度。
4. Flink CDC 如何保证 Exactly-Once?
Source 端基于 Chunk 级 Checkpoint 和 Binlog 位点 State 保证不丢不重;Flink 引擎通过 Checkpoint 和两阶段提交保证计算一致性;Sink 端需要支持事务或幂等写入。
5. 增量阶段为什么是单并发?
Binlog 是有序的事件日志,必须按顺序消费才能保证数据一致性。多并发消费会导致事件乱序,产生错误的最终状态。
6. 2.x 和 3.x 的主要区别?
3.x 引入了 YAML Pipeline 整库同步、Schema Evolution、Transform/Route、Pipeline Connector 生态、自动缩容、动态加表等端到端数据集成能力,定位从 Connector 集合升级为数据集成框架。
7. 如何处理 Schema 变更?
3.x 使用 Schema Operator + Schema Coordinator,在 DDL 事件到达时先 Flush 下游数据,再通过 MetadataApplier 应用 DDL。支持 lenient/try_evolve/evolve/ignore/exception 五种行为模式。
8. Chunk Key 如何选择?
优先选择分布均匀的自增主键。复合主键注意第一列的基数。3.2+ 支持非主键列但需有索引。无主键表必须指定 chunk.key-column。
9. 大事务导致 OOM 怎么处理?
拆分上游大事务;增大 TM 内存;配置心跳推进 Checkpoint;监控长事务。
10. Flink CDC vs Debezium 的区别?
Flink CDC 底层用 Debezium 解析 Binlog,但增强了并行快照、Checkpoint 集成、SQL/YAML API、整库同步、Schema Evolution、端到端 ETL 能力。Debezium 依赖 Kafka Connect,单 Task 限制明显。
11. 全量快照慢如何优化?
增大并行度和 chunk.size;优化 Chunk Key 选择;增大 fetch.size 和连接池;检查 MySQL 负载和索引。
12. Canal-JSON 和 Debezium-JSON 格式区别?
Canal-JSON 是阿里巴巴 Canal 的格式,使用 data/old/type 字段,国内生态友好;Debezium-JSON 使用 before/after/op/source 字段,是 Debezium 标准格式,国际通用。
13. 动态加表的原理?
修改监控表配置后从 Savepoint 恢复,Enumerator 发现新表后为其切分 Chunk 并执行快照,同时在 Binlog 流中过滤该表的变更,快照完成后接入增量流。
14. 分库分表合并时 Schema 不一致怎么办?
Flink CDC 自动合并 Schema:新增列同步到下游,缺失列填 NULL;类型不一致时尝试协变类型(无损转换);无法无损处理时报错停止。
15. Flink CDC 支持哪些数据源和目标端?
Source 支持 MySQL、PostgreSQL、Oracle、SQL Server、MongoDB、DB2、OceanBase、TiDB、Vitess;Pipeline Sink 支持 Doris、StarRocks、Kafka、Paimon、Elasticsearch、Iceberg、Hudi、Fluss。
14.4 实战练习建议
- 基础练习:用 Docker Compose 搭建 MySQL + Flink,用 SQL Client 实现单表 CDC 到 MySQL
- 进阶练习:配置 MySQL CDC → Kafka → Flink SQL → Doris 的完整链路
- YAML 练习:用 YAML Pipeline 实现 MySQL 整库同步到 Doris,体验自动建表
- Schema Evolution 练习:在同步过程中对 MySQL 表执行 ADD COLUMN / MODIFY COLUMN,观察下游自动变更
- 分库分表练习:创建 order_0/order_1/order_2,配置 Route 合并到一张表
- 性能练习:构造千万级数据表,调整并行度和 chunk.size,观察吞吐量变化
- 容错练习:同步过程中手动 kill TaskManager,观察 Checkpoint 恢复和数据一致性
15. 总结
Flink CDC 已经从一个简单的 MySQL Binlog 读取工具,演进为功能完备的分布式实时数据集成框架。它的核心价值可以概括为:
- 全量增量一体化:无需在 DataX(全量)和 Canal(增量)之间切换,一套代码搞定
- 无锁并行快照:对生产业务库零侵入,水平扩展快照吞吐量
- SQL + YAML 双 API:SQL 适合单表精细 ETL,YAML 适合整库快速同步
- Schema Evolution:上游 DDL 自动同步,不再因加列改类型而重启任务
- 丰富生态:10+ Source,8+ Sink,覆盖主流数据库和数据湖/数仓
- 生产可靠:Checkpoint 容错、Exactly-Once、动态扩缩容
对于数据开发工程师来说,掌握 Flink CDC 不仅是学会一个工具,更是理解实时数据集成范式转变的关键——从 T+1 批量到秒级流式,从代码硬编码到声明式配置,从手动 Schema 管理到自动演化。
希望这篇博客能成为你学习 Flink CDC 的起点。建议按照第 14 章的学习路线,先在本地跑通 Demo,再逐步深入原理和生产实践。遇到问题时,官方文档和 GitHub Issue 是最好的朋友。
最后的话:技术在快速演进,Flink CDC 3.2 不是终点,3.5、3.6 已经带来更多连接器和能力。保持学习,关注社区,动手实践——这是每个优秀数据工程师的成长之路。
本文基于 Flink CDC 3.2.1 版本撰写,部分内容参考 3.5/3.6 版本特性。由于开源项目迭代迅速,具体参数和行为请以对应版本的官方文档为准。
更多推荐

 14
 0
- 0


 已为社区贡献6条内容

所有评论(0)