
Nature子刊 IF=15.1 | AI辅助ICD编码的真实世界部署与评估:基于大模型与临床文档标准化
引言
国际疾病分类(ICD)编码是医院运营的基石,但手动编码过程耗时费力且易出错,已成为全球医疗机构的沉重负担。尽管人工智能(AI)技术为自动化编码带来了希望,但现有模型往往难以适应真实世界中复杂多变的临床文档结构,其实际工作流程中的性能和用户接受度更是鲜有验证。
近日,一项发表在《npj Digital Medicine》上的研究带来了突破。来自台湾多所大学和医院的研究团队开发并部署了一套模块化、基于临床实际的人工智能编码系统。该系统不仅通过创新的模型选择框架确定了高性能的基础大语言模型,还利用HL7临床文档架构(CDA)标准化的章节信息进行训练,并在为期13周的随机对照试验(RCT)中证明,该AI辅助工作流能显著提升编码效率,同时揭示了不同背景的编码专家对AI工具的接受度差异,为AI在真实临床环境中的落地提供了关键证据。
基本信息
• 文章标题:Evaluating real-world deployment of an HL7-CDA-aligned LLM for ICD-10-CM coding
• 期刊:npj Digital Medicine
• 影响因子:15.1
• 发表时间:2026年3月3日
• 研究单位:台湾高雄医学大学及其附设医院联合岛内多所高校、研究院与医疗机构,并协同越南高校组成的跨地域、跨学科医疗科研合作网络
• 论文地址:https://doi.org/10.1038/s41746-026-02541-5
研究内容与方法
数据集构建与预处理
- 数据来源:选取两家合作医院的HL7-CDAR2标准格式匿名临床数据集,包含5个与ICD编码高度相关的核心章节:出院诊断(DischgDiag)、病史(MedHist)、手术记录(OpNote)、病理报告(PathRep)、治疗过程(TreatCous)
- 数据清洗:执行统一清洗流程,包括重复记录移除、ICD标签一致性检查、文本标准化
- 数据集划分:采用多标签分层采样(8:1:1)策略,在训练、验证、测试集中保留ICD-10标签的原始分布
- 文本截断策略:受模型2048-token输入限制,依据编码专家推荐的章节优先级,优先截断低优先级章节内容,确保诊断关键信息被保留
【模块化ICD-10-CM编码系统框架与传统流程对比】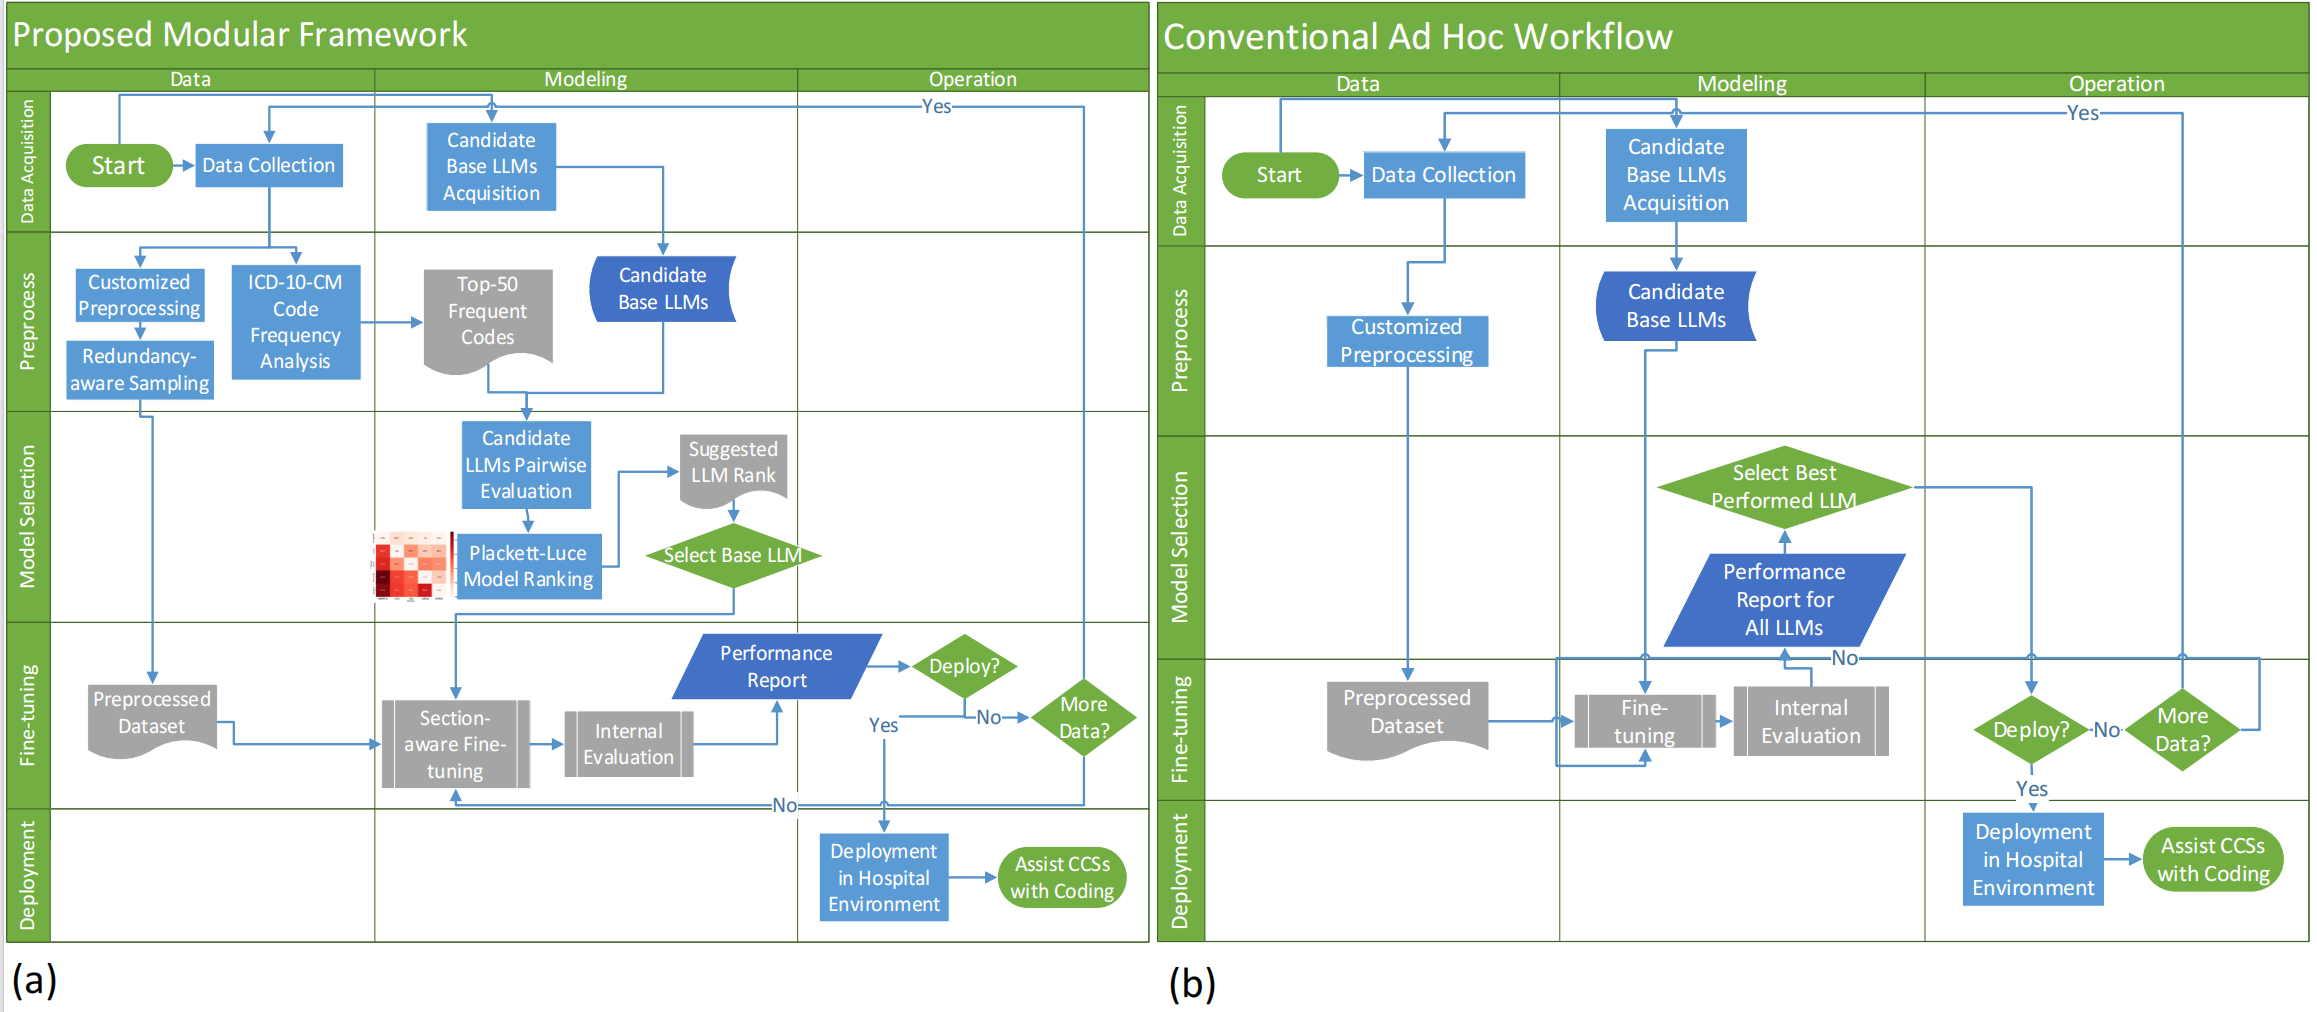
注:图(a)展示本文提出的结构化工作流,涵盖数据采集、冗余感知采样、LLM-as-judge评估、分段微调与临床部署;图(b)展示传统非结构化开发流程,缺乏原则性模型选择导致资源浪费与低效。
冗余感知采样策略
- 语义冗余识别:
- 使用预训练的all-MiniLM-L6-v2句子编码器将每条出院小结编码为语义向量
- 构建FAISS索引实现近似最近邻搜索,计算向量间L2距离作为语义相似度指标
- 当两条记录的ICD-10-CM代码完全一致且语义相似度超过阈值τ\tauτ(默认设为0.9)时,标记为语义冗余样本对
- 冗余样本保留规则:
- 计算冗余样本对的困惑度(PPL),公式如下:
PPL=e−1N∑i=1Nlogp(xi∣x<i,θ) PPL = e^{-\frac{1}{N}\sum_{i=1}^N \log p(x_i | x_{<i}, \theta)} PPL=e−N1∑i=1Nlogp(xi∣x<i,θ)
其中NNN为文本序列长度,p(xi∣x<i,θ)p(x_i | x_{<i}, \theta)p(xi∣x<i,θ)为基础模型在参数θ\thetaθ下对第iii个token的预测概率 - 保留PPL差异≥5%的样本中PPL更高的样本;若PPL差异<5%,保留长度更长的样本以保留更多上下文信息
- 计算冗余样本对的困惑度(PPL),公式如下:
【冗余感知采样前后ICD-10-CM章节分布对比】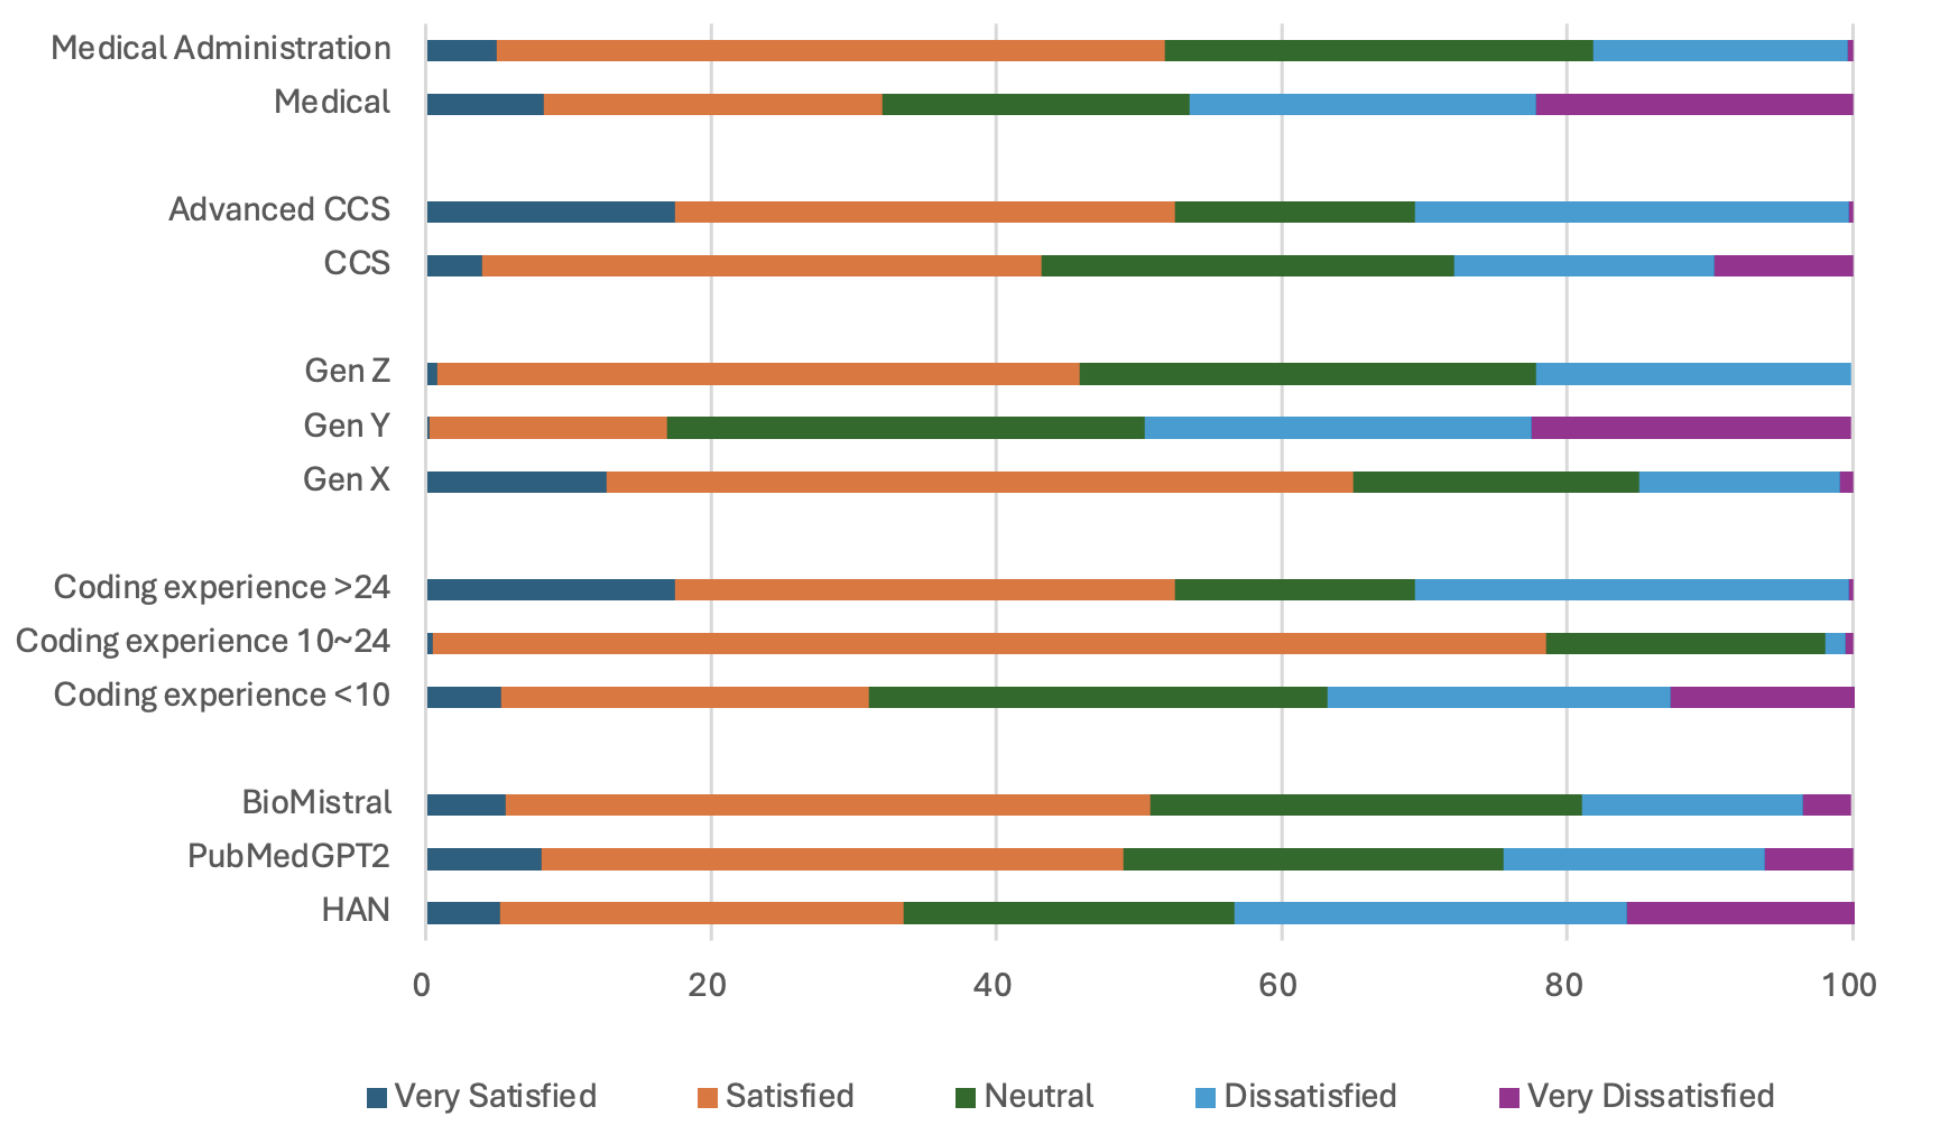
注:展示高雄医学大学医院训练集在冗余移除前后,各ICD-10-CM章节的样本数量分布变化。
预训练基础模型选择方法
- 候选模型范围:筛选5个参数规模≤70亿的Decoder-only LLM,包括PubMedGPT-2、Llama2-7B、Mistral-7B instruct,及其领域适配变体MedLlama2、BioMistral-7B
- LLM-as-judge pairwise评估:
- 针对训练集中Top50高频ICD-10-CM代码,让候选模型生成对应的临床定义文本
- 采用Atla Selene Mini作为自动化评判模型,对每对候选模型的输出进行语义保真度与临床适用性比较,无明确偏好的案例标记为平局
- Plackett-Luce模型全局偏好排序:
- 基于pairwise比较结果构建有向对比图,节点代表候选模型,有向边表示模型间的胜负关系,无向边表示平局
- 依据Luce选择公理,通过迭代Luce谱排序算法估算模型的全局偏好权重,计算每个模型的选择概率:
P(Mk)=αk∑j=1mαj P(M_k) = \frac{\alpha_k}{\sum_{j=1}^m \alpha_j} P(Mk)=∑j=1mαjαk
其中αk\alpha_kαk为模型MkM_kMk的偏好权重,mmm为候选模型总数,选择概率最高的模型作为下游微调的基础模型
【基于LLM-as-judge的基础模型选择结果可视化】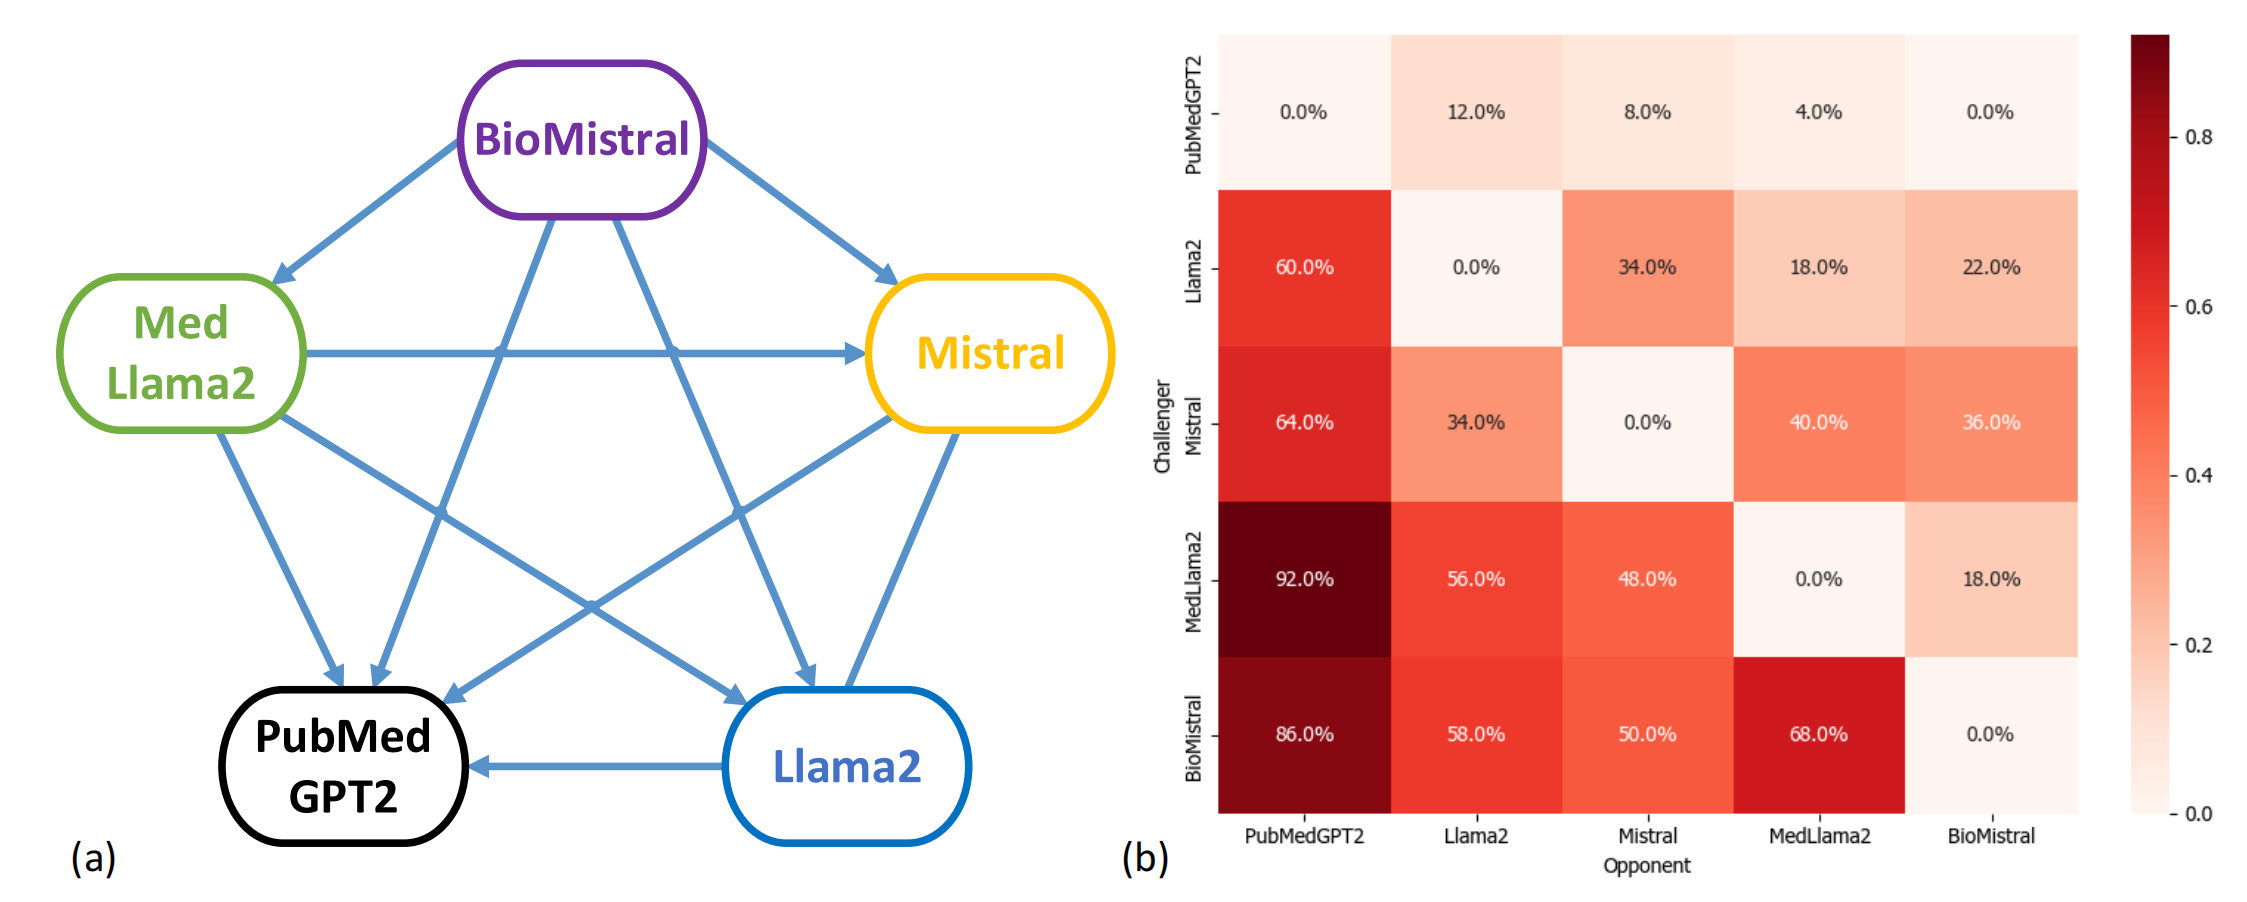
注:(a)为模型间胜负关系混合有向图,有向边表示模型偏好,无向边表示平局;(b)为胜率矩阵热力图,展示候选模型相对各对手的胜率。
分段指令调优方法
- 分段指令模板设计:采用HL7-CDAR2对齐的指令式模板,每个临床章节以“###”+章节名作为前缀,内容填充对应临床文本;缺失章节显式标记为“Nil”,统一输入输出结构
- 两类模型训练策略:
- 通用分段感知模型:使用完整模板训练,支持处理异质文档结构,训练与推理阶段均对缺失章节标记“Nil”
- 固定分段组合模型:针对特定章节组合(如仅DischgDiag、DischgDiag+MedHist等)训练,仅处理与训练时结构匹配的输入
- 微调目标:采用监督参数级微调,以自回归训练损失更新模型参数,学习ICD-10-CM编码任务,输出区分主诊断与其他诊断的结构化代码
【基于HL7-CDAR2的ICD-10-CM编码指令调优模板】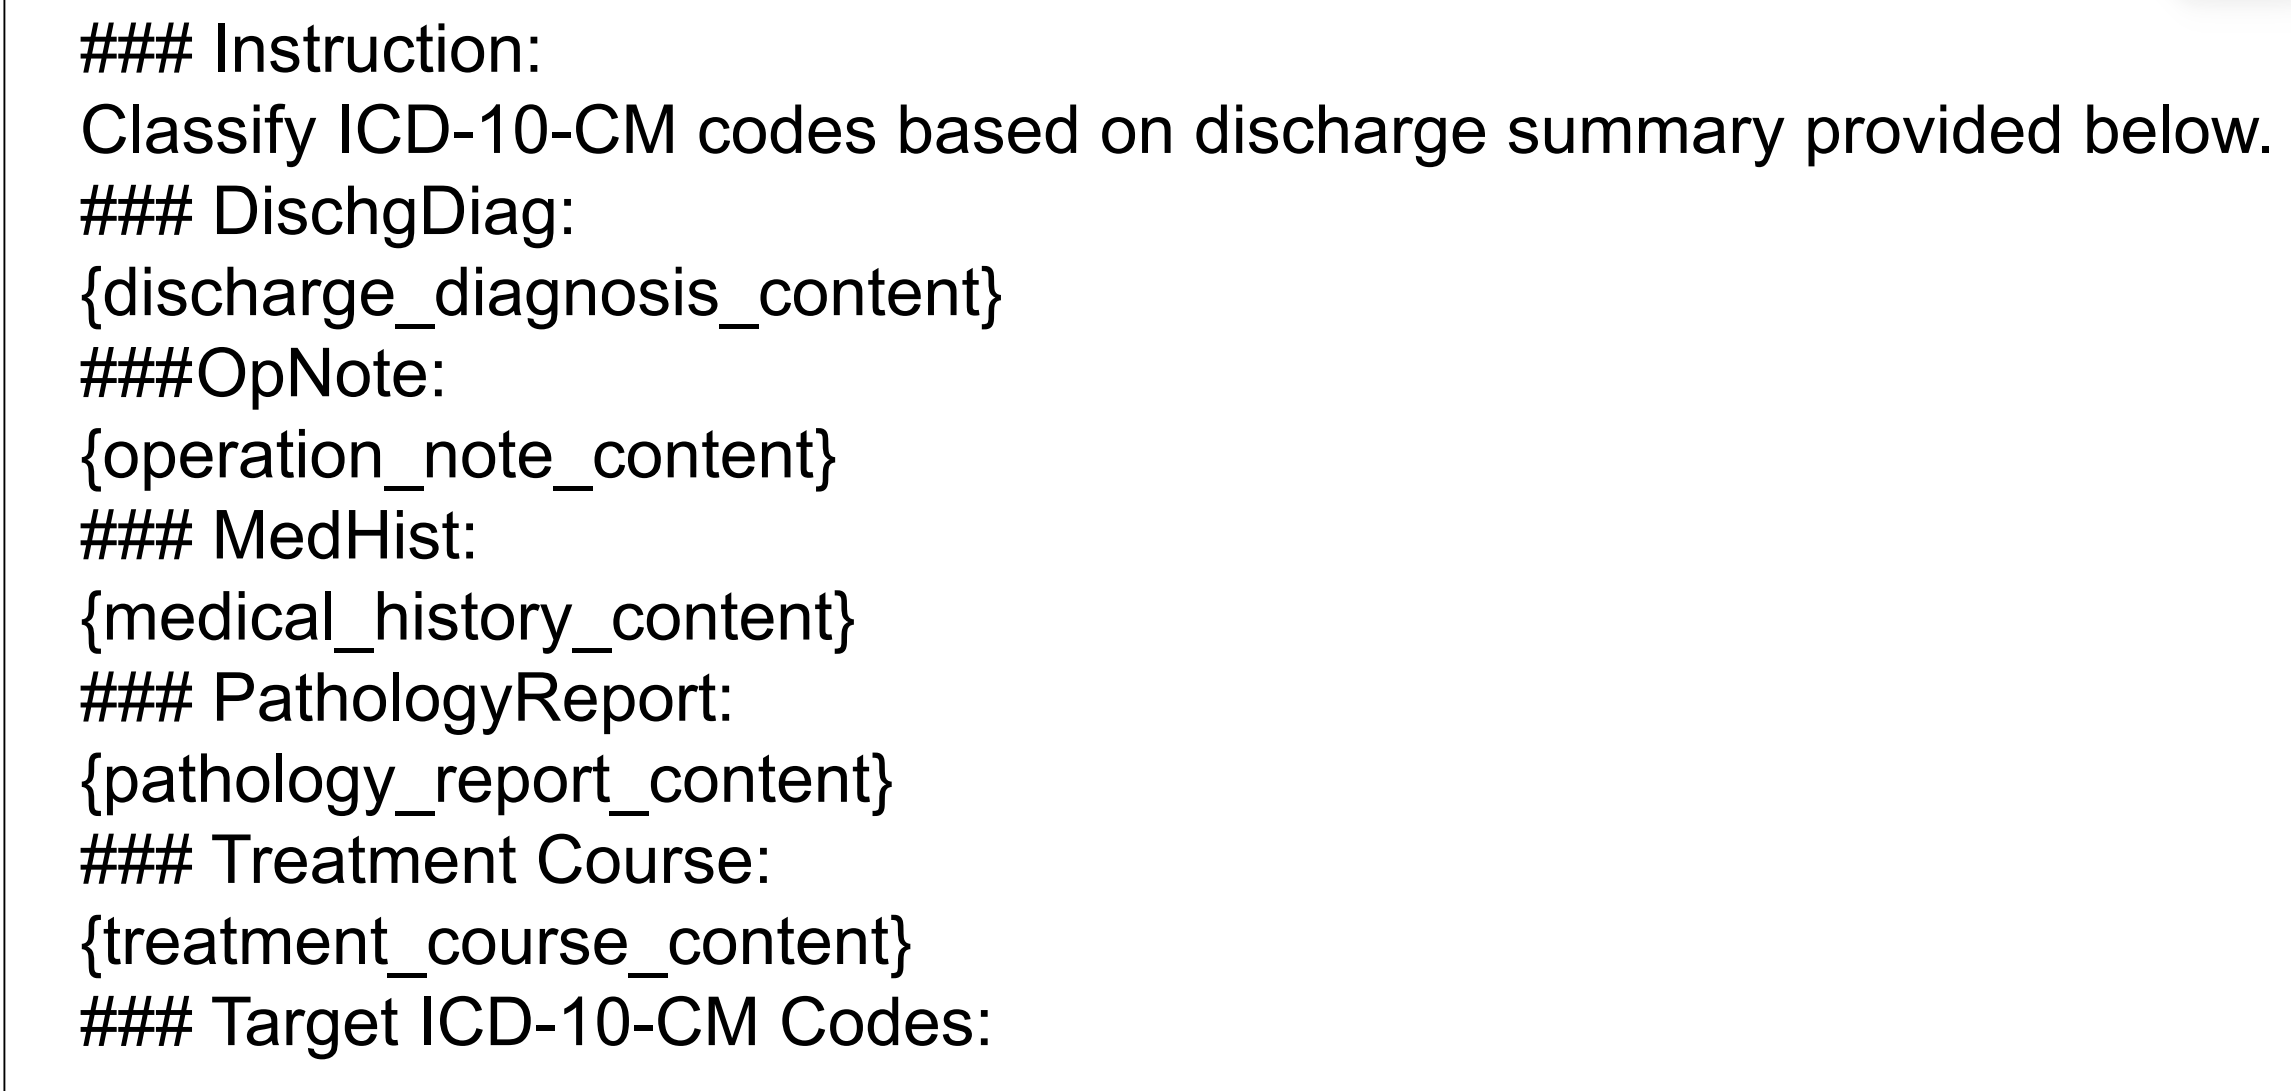
注:展示包含各核心临床章节的指令调优模板,花括号为章节内容占位符。
人类在环的RCT研究设计方法
- 研究对象:招募认证编码专家(CCSs)作为研究参与者
- 随机化与工作流分配:采用每周轮换的随机调度方案,将每个CCSs分配到4种工作流:无AI辅助(对照组)、3种AI辅助工作流(HAN、PubMedGPT-2、BioMistral),所有参与者需轮换所有工作流
- 数据采集方法:
- 自动记录从AI编码界面激活到任务完成(点击保存按钮)的编码时间
- 随机触发5点Likert满意度调查,调查与对应工作流关联,采用匿名方式收集
- 统计分析方法:
- 编码时间分析:剔除上下2.5%的异常值,采用Welch’s ANOVA与Games–Howell事后检验比较不同工作流的编码时间差异
- 满意度分析:采用多项逻辑回归分析模型类型与编码专家背景特征(从业年限、认证等级、教育背景、世代 cohort)对满意度的影响,显著性阈值设为p<0.05p<0.05p<0.05
实验结果分析
模块化ICD-10-CM编码系统开发流程
本研究提出的用于开发ICD-10-CM编码系统的模块化框架强调一种基于数据驱动的原则性方法,以替代传统的、依赖直觉的流程。其核心步骤包括数据采集、冗余感知采样、基于LLM-as-Judge的成对模型评估与Plackett-Luce排名、基于HL7-CDA章节的指令微调,以及最终的临床部署。该流程旨在通过系统性的模型筛选和训练,实现资源高效且可扩展的编码系统开发,为后续的真实世界评估奠定了基础。
基于内在语义评估的模型选择
研究评估了五个参数量在70亿以下的解码器模型对ICD-10-CM代码定义的理解能力。
- BioMistral在与其他模型的成对比较中获得了最高的总体胜率。
- 通过Plackett-Luce模型聚合所有比较结果后,BioMistral获得了44.1%的选择概率,被确定为最适合进行下游微调的基础模型。
- 这一内在评估作为一种低成本的启发式方法,有效缩小了候选模型范围,其得出的排名与下游微调后的编码性能排名保持一致,验证了该筛选策略的实用性。
真实世界部署效果:编码效率与用户满意度
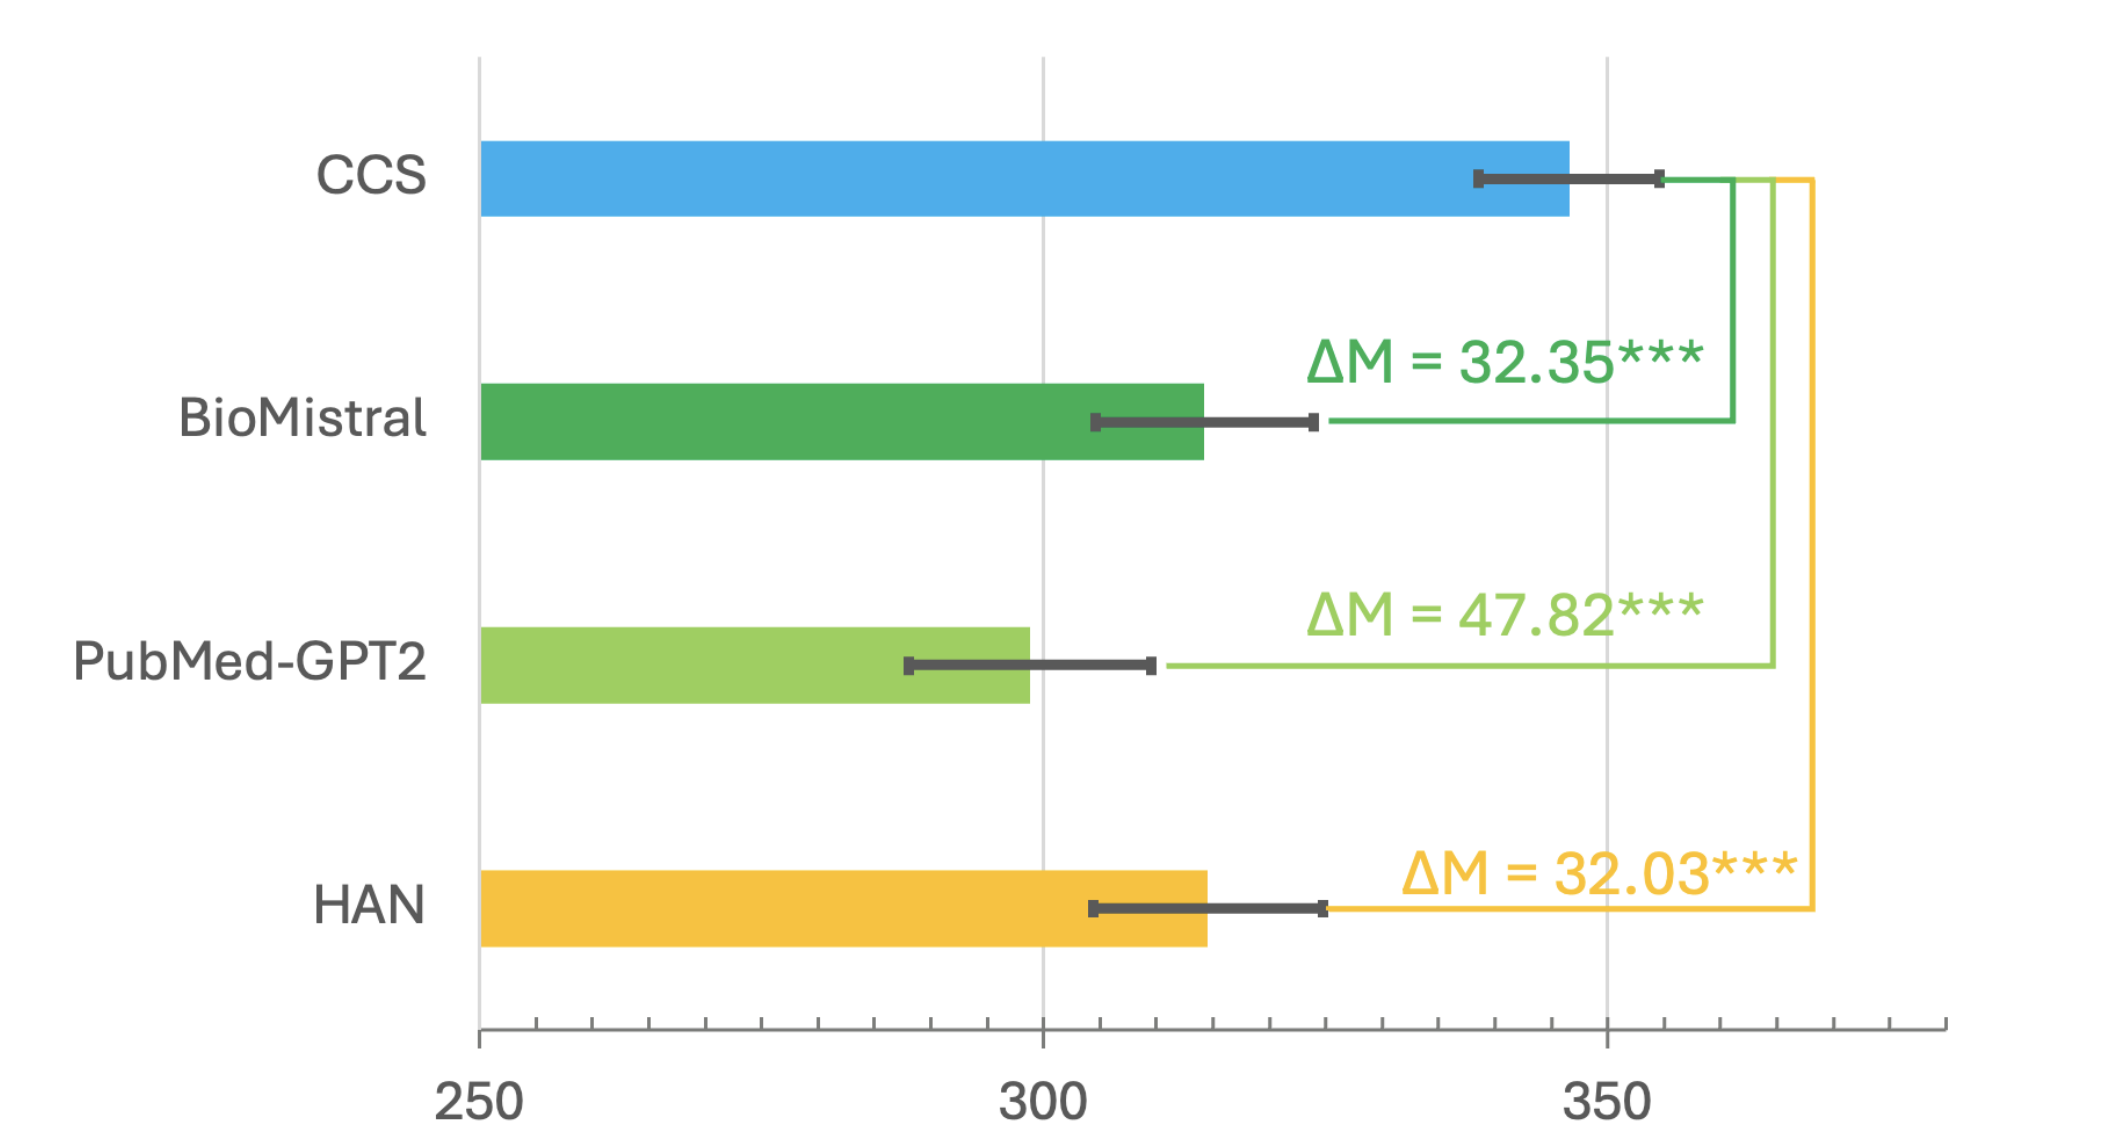
上图展示了在为期13周的人机协同随机对照试验中,不同工作流程下的平均编码时间。结果验证了AI辅助工作流程能显著提升效率。
- 与完全手动编码相比,所有三种AI辅助工作流程(HAN、PubMedGPT-2、BioMistral)都显著减少了单份病历的编码时间。
- 其中,PubMedGPT-2带来的时间减少幅度最大,其次是BioMistral和HAN。
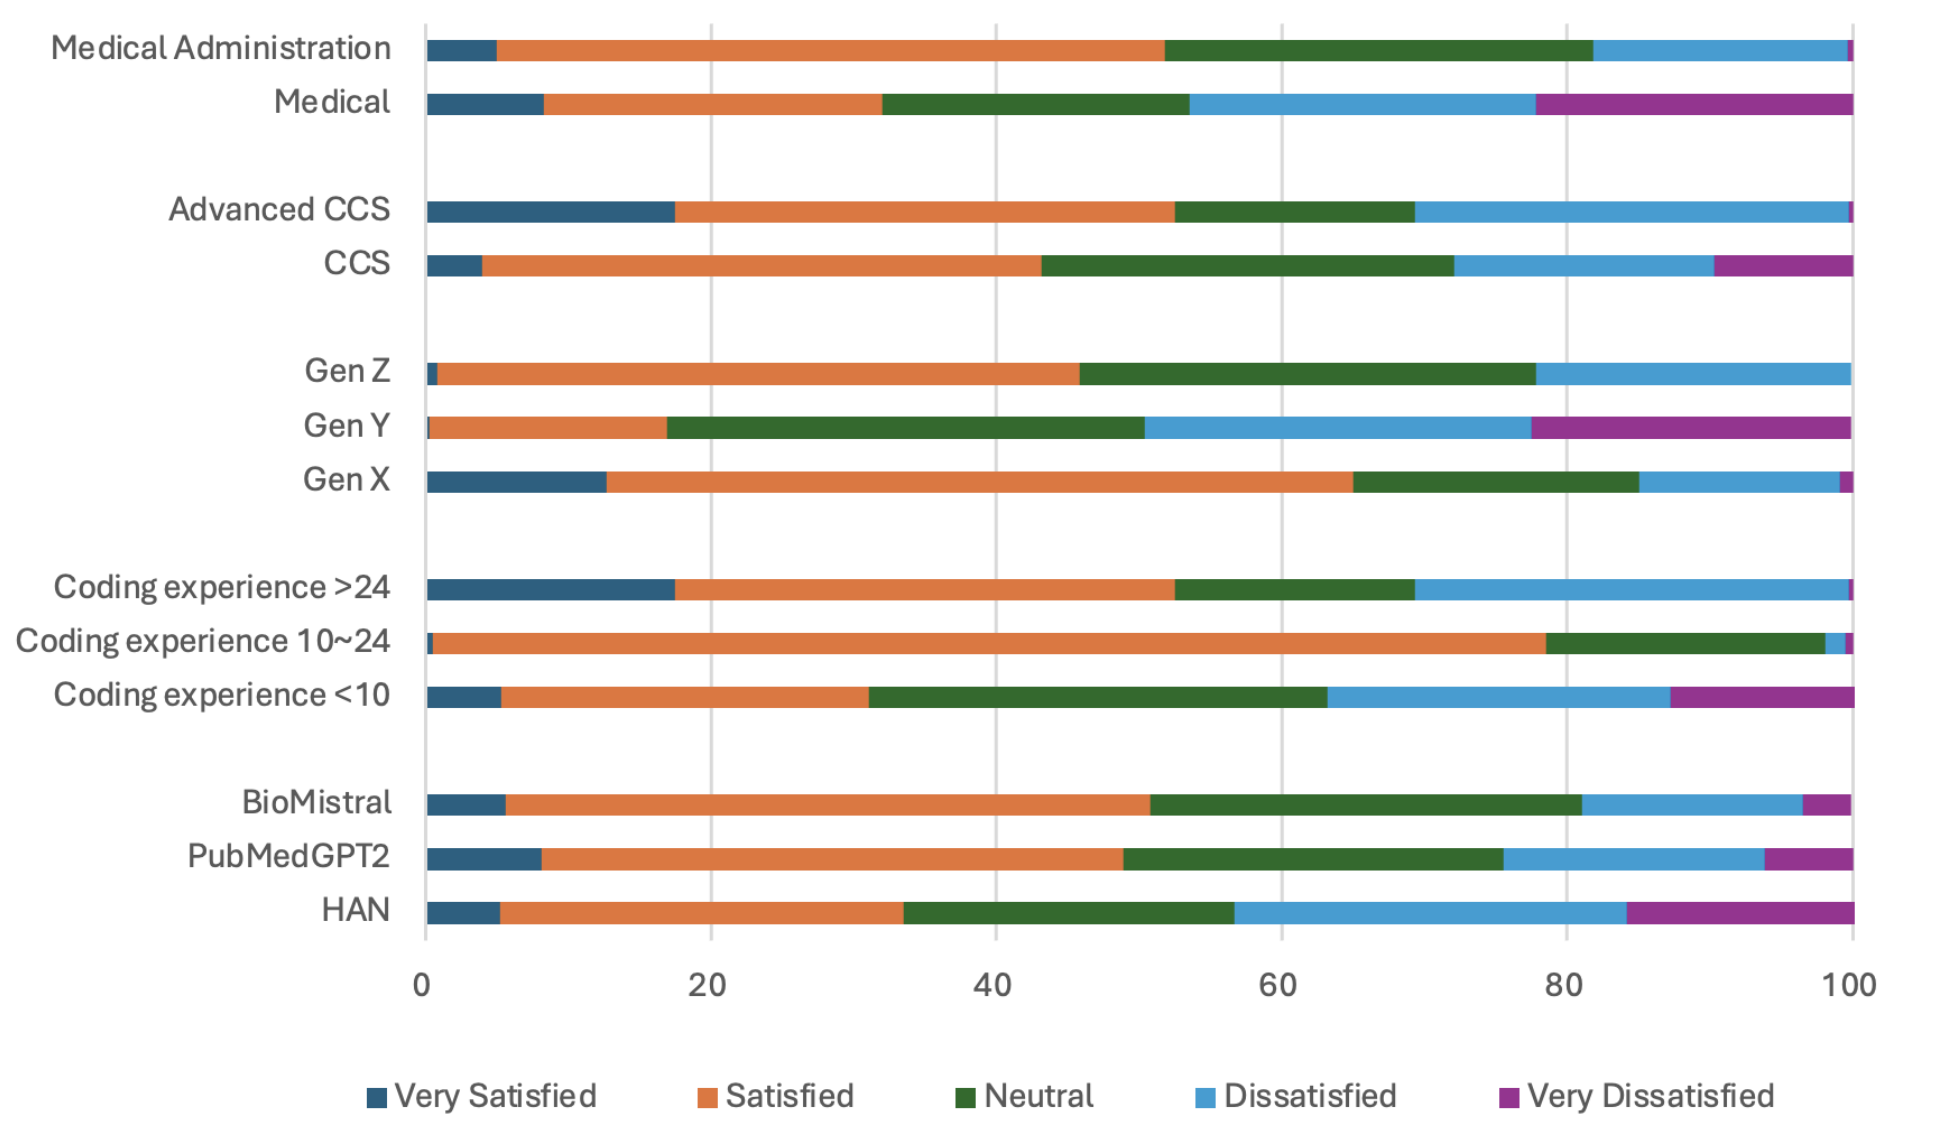
上图进一步分析了认证编码专家对不同AI模型及工作流程的满意度,揭示了用户接受的异质性。
- 在模型类型上,技术性能更优的BioMistral获得了最高比例的正面满意度评价。
- 用户满意度显著受到编码员背景特征的影响:拥有医疗管理背景、高级认证、10-24年工作经验以及属于X世代的编码员满意度更高;而具有医学相关学术背景、工作经验少于10年以及属于Y世代的编码员满意度相对较低。
- 这表明,AI在真实工作流程中的成功整合,不仅取决于模型准确性,还深刻依赖于工作流程适配性和个体用户的接受度。
优势与局限
优势
• 模块化与可扩展性强:提出包含数据去冗余、基于LLM-as-judge的模型选择、HL7-CDA对齐的章节感知微调在内的完整、模块化流水线,支持在异构文档环境中进行可扩展的ICD-10-CM编码。
• 真实世界验证充分:通过为期13周、涉及10名认证编码专家的随机对照试验,在真实临床工作流中验证了AI辅助编码能显著减少编码时间,并系统评估了用户满意度与接受度。
• 模型选择方法高效:结合成对LLM-as-judge评估与Plackett-Luce排序,提供了一种资源高效的基础模型筛选启发式方法,避免了对所有候选模型进行穷举微调。
局限
• 模型选择依赖自动化评判:基础模型筛选依赖于LLM-as-judge,评判模型本身可能存在偏见,且内在定义生成能力与下游编码性能的关联性仅在有限候选模型集中得到验证。
• 真实世界部署面临动态挑战:研究因全国性ICD-10-CM版本更新而提前终止,凸显了临床AI系统需适应不断演变的编码标准与政策,这在受控基准研究中很少被考虑。
• 用户接受度存在异质性:编码专家的满意度因经验、认证、代际 cohort 等因素存在显著差异,表明成功的人机协同不仅取决于模型性能,还需考虑角色敏感性的工作流设计。
参考文献
- Dong, H., Suárez-Paniagua, V., Whiteley, W. & Wu, H. Explainable automated coding of clinical notes using hierarchical label-wise attention networks (HAN) and label embedding initialisation. Journal of biomedical informatics 116, 103728 (2021). 该论文提出了用于临床笔记自动编码的分层标签注意力网络(HAN),是本研究用于对比的经典深度学习方法之一,为评估大语言模型在ICD编码任务上的性能提供了重要基准。
- Ji, S., Hölttä, M. & Marttinen, P. Does the magic of BERT apply to medical code assignment? A quantitative study. Computers in biology and medicine 139, 104998 (2021). 本文系统评估了BERT等编码器模型在医疗编码任务上的表现,指出了其在处理长文档和全编码集时的局限性,为本研究选择解码器架构的大语言模型提供了关键背景和对比依据。
- Zheng, L. et al. Judging llm-as-a-judge with mt-bench and chatbot arena. Advances in neural information processing systems 36, 46595-46623 (2023). 该研究提出了LLM-as-a-Judge的评估框架,为本研究采用成对LLM比较和Plackett-Luce模型进行基础模型筛选提供了核心方法论支持。
- Labrak, Y. et al. BioMistral: A Collection of Open-Source Pretrained Large Language Models for Medical Domains. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (ACL’24). 本文介绍了在生物医学领域预训练的大语言模型BioMistral,该模型在本研究中被筛选为最优基础模型,并在后续微调和真实世界部署中展现出最一致的性能。
- Venkatesh, K. P., Raza, M. M. & Kvedar, J. C. Automating the overburdened clinical coding system: challenges and next steps. npj Digital Medicine 6, 16 (2023). 该综述探讨了自动化临床编码系统面临的挑战与未来方向,强调了模型准确性之外的工作流适配和用户接受度问题,为本研究设计包含人机交互的随机对照试验和评估多层面采纳指标提供了理论框架。
更多推荐

 18
 0
- 0


 已为社区贡献7条内容

所有评论(0)