
Flink快速入门
·
依赖配置
 <properties>
    <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
    <maven.compiler.source>1.8</maven.compiler.source>
    <maven.compiler.target>1.8</maven.compiler.target>
    <flink.version>1.16.0</flink.version>
    <slf4j.version>1.7.36</slf4j.version>
    <log4j.version>2.17.2</log4j.version>
  </properties>

  <dependencies>
    <!-- Flink批和流开发依赖包 -->
    <dependency>
      <groupId>org.apache.flink</groupId>
      <artifactId>flink-clients</artifactId>
      <version>${flink.version}</version>
    </dependency>

    <!-- slf4j&log4j 日志相关包 -->
    <dependency>
      <groupId>org.slf4j</groupId>
      <artifactId>slf4j-log4j12</artifactId>
      <version>${slf4j.version}</version>
    </dependency>
    <dependency>
      <groupId>org.apache.logging.log4j</groupId>
      <artifactId>log4j-to-slf4j</artifactId>
      <version>${log4j.version}</version>
    </dependency>

  </dependencies>
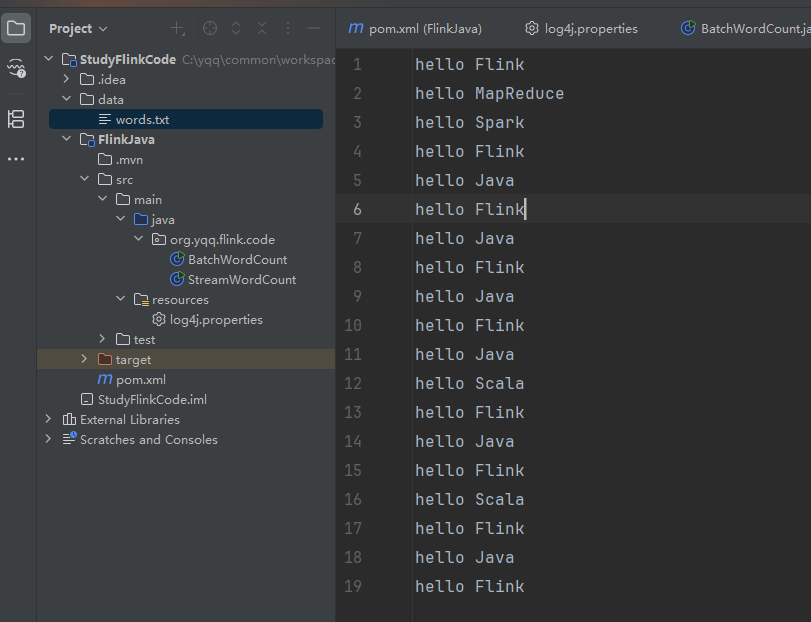
单词文件
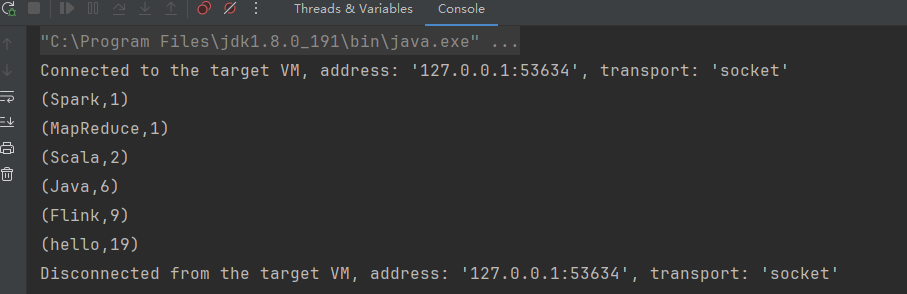
批量处理
public class BatchWordCount {
    public static void main(String[] args) throws Exception {
        // 1. 准备环境
        ExecutionEnvironment env = ExecutionEnvironment.getExecutionEnvironment();

        // 2. 从文件读取数据
        DataSource<String> lineDS = env.readTextFile("./data/words.txt");

        // 3. 对数据进行切分操作
        FlatMapOperator<String, String> wordsDS = lineDS
                .flatMap((FlatMapFunction<String, String>) (line, out) -> {
            for (String word : line.split(" ")) {
                out.collect(word);
            }
        }).returns(Types.STRING);

        // 5. 对单词进行计数
        MapOperator<String, Tuple2<String, Long>> kvWordsDS = wordsDS
                .map(word -> Tuple2.of(word, 1L))
                .returns(Types.TUPLE(Types.STRING, Types.LONG));

        // 6. 对单词进行分组
        kvWordsDS.groupBy(0).sum(1).print();


    }
}
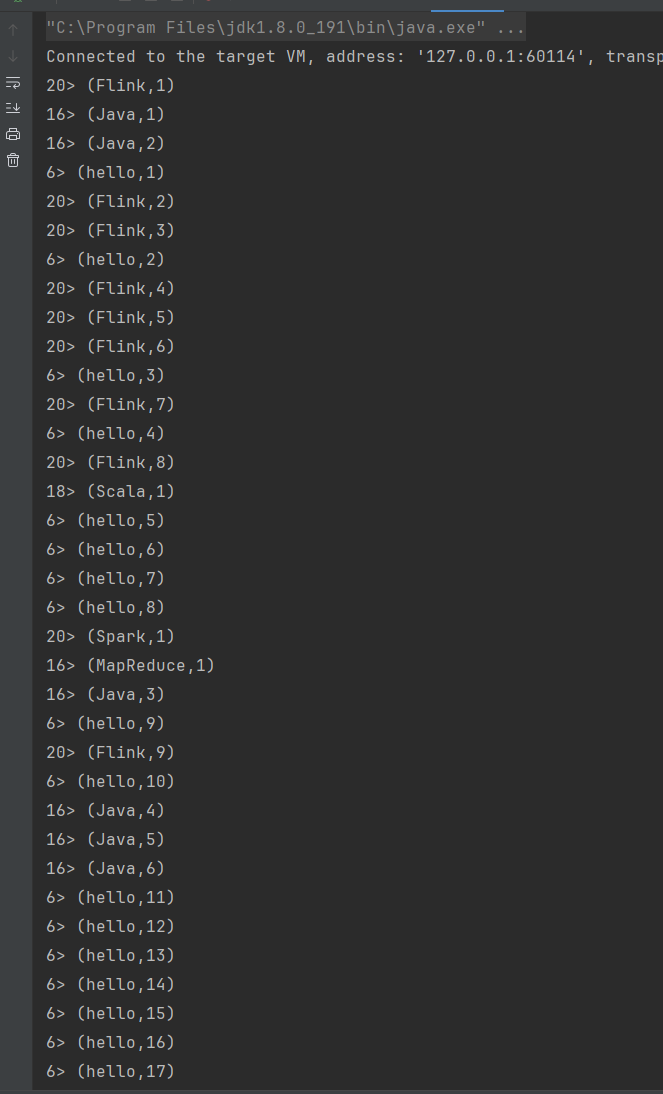
流式处理
public class StreamWordCount {
    public static void main(String[] args) throws Exception {
        // 1. 准备环境
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

        // 在DataStream中设置batch处理模式
//        env.setRuntimeMode(RuntimeExecutionMode.BATCH);
        // 2. 实时读取数据
        DataStreamSource<String> lineDS = env.readTextFile("./data/words.txt");

        // 3. 对数据进行切分操作
        SingleOutputStreamOperator<String> wordsDS = lineDS.flatMap((FlatMapFunction<String, String>) (line, out) -> {
            for (String word : line.split(" ")) {
                out.collect(word);
            }
        }).returns(Types.STRING);

        // 4. 对单词进行计数
        SingleOutputStreamOperator<Tuple2<String, Long>> kvWordsDS = wordsDS
                .map(word -> Tuple2.of(word, 1L))
                .returns(Types.TUPLE(Types.STRING, Types.LONG));

        // 5. 分区,聚合统计
        KeyedStream<Tuple2<String, Long>, String> value = kvWordsDS
                .keyBy( value1 -> value1.f0);
        value.sum(1).print();

        // 6. 执行任务
        env.execute();

    }
}
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)