
Apache Flink 学习指南
Apache Flink 学习指南
写在前面:如果你是一名刚接触 Flink 的数据开发工程师,面对流处理、状态管理、Checkpoint、Watermark 等概念感到迷茫,这篇文章就是为你准备的。我们将从"什么是 Flink"一路讲到性能调优与实时数仓架构,配合大量代码示例和对比表格,帮你建立完整的知识体系。本文基于 Flink 1.18/1.19/1.20 版本,并展望 Flink 2.0 方向。
目录
- Flink 概述
- Flink 架构与运行原理
- 环境搭建
- DataStream API
- 时间语义与 Window
- 状态管理
- 容错机制
- Flink SQL
- 8.9 Flink SQL 性能调优
- 8.10 常用 Connector 详解
- Flink CDC
- Flink CEP
- Flink 性能调优
- 11.7 反压深度原理
- 11.8 Watermark Alignment(1.16+)
- 11.9 Metrics 与监控
- Flink 常见问题与踩坑
- Flink 1.18-1.20 新特性与 2.0 展望
- 13.6 Flink + Paimon 深度集成
- Flink 在实时数仓中的典型架构
- 14.4 端到端实时数仓实战项目
- 学习路线与实战建议
1. Flink 概述
1.1 什么是 Flink
Apache Flink 是一个分布式流处理引擎,同时支持批处理(流批一体)。它的核心定位是:有状态的实时计算,即在无限数据流上进行低延迟、高吞吐、精确一次(Exactly-Once)的计算。
有限数据集(批)          无限数据流(流)
┌──────────┐           ─ ─ ─ ─ ─ ─ ─ ─ ▶
│ 数据有边界 │         │ 数据无边界,持续到达 │
└──────────┘           ─ ─ ─ ─ ─ ─ ─ ─ ▶
   Flink 批处理              Flink 流处理(核心)
1.2 发展历史
| 时间 | 里程碑 |
|---|---|
| 2010 | 德国柏林理工大学研究项目 “Stratosphere” |
| 2014 | 捐赠 Apache,更名为 Flink,成为顶级项目 |
| 2016 | Flink 1.0 发布,引入 Event Time & CEP |
| 2019 | Flink 1.9 合并 Table API,流批一体雏形 |
| 2021 | Flink 1.13/1.14,State Backend 重构,Unaligned Checkpoint |
| 2023 | Flink 1.18,Flink CDC 3.0,Lakehouse 集成 |
| 2024 | Flink 1.19/1.20,自适应执行,Flink 2.0 路线图 |
1.3 为什么选 Flink
- 流批一体:同一套 API 同时处理流和批,无需维护两套系统。
- Exactly-Once:基于 Checkpoint 机制保证状态一致性。
- 高性能低延迟:纯流处理,毫秒级延迟;JVM + 内存计算,高吞吐。
- 强大的状态管理:支持超大状态(TB 级),RocksDB 后端。
- 丰富的时间语义:Event Time + Watermark,完美处理乱序数据。
- 完善的生态:Flink SQL、CDC、CEP、ML、Paimon 等。
1.4 Flink vs Spark Streaming
| 对比维度 | Flink | Spark Streaming |
|---|---|---|
| 处理模型 | 真流处理(事件驱动,逐条处理) | 微批处理(将流切分成小批次) |
| 延迟 | 毫秒级 | 秒级(批次间隔决定) |
| 吞吐 | 高 | 高 |
| 时间语义 | 原生 Event Time + Watermark | 微批时间窗口,Event Time 支持较弱 |
| 状态管理 | 原生支持,Checkpoint/Savepoint | DStream 状态管理较繁琐 |
| Exactly-Once | 端到端精确一次 | 至少一次(需手动保证精确一次) |
| SQL 支持 | Flink SQL(成熟) | Spark SQL(更成熟于批) |
| 适用场景 | 实时风控、实时监控、实时数仓 | 近实时 ETL、批流混合 |
一句话总结:Flink 是"来一条处理一条",Spark Streaming 是"攒一批处理一批"。
1.5 典型应用场景
- 实时数仓:Kafka → Flink ETL → Doris/StarRocks/ClickHouse
- 实时监控告警:日志/指标流 → CEP 规则匹配 → 告警
- 实时风控:交易流 → 模式检测 → 拦截可疑交易
- CEP 复杂事件处理:从事件流中检测特定模式
- 机器学习:Flink ML 在线学习/实时特征工程
- 实时推荐:用户行为流 → 实时特征更新 → 推荐系统
2. Flink 架构与运行原理
2.1 整体架构
Flink 运行时由主从架构组成:
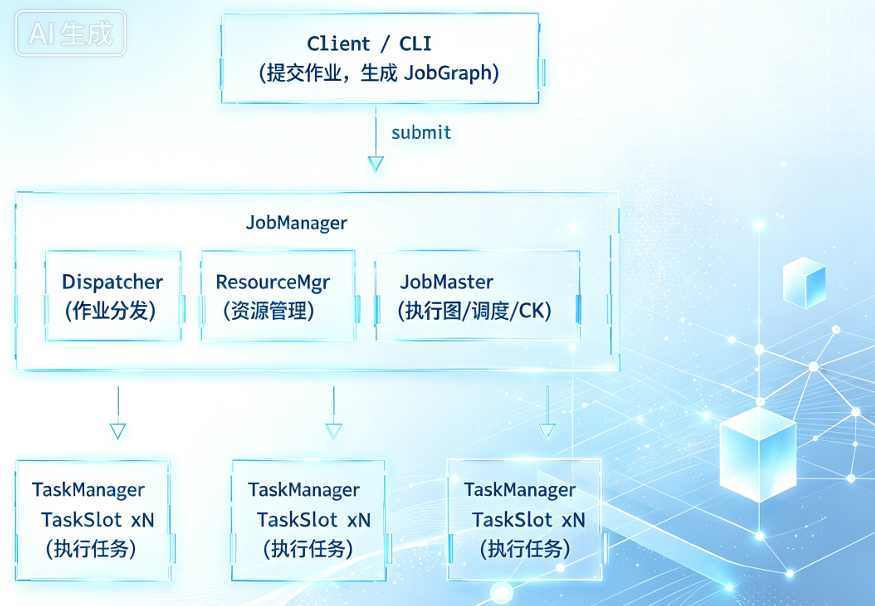
2.2 核心组件
| 组件 | 职责 |
|---|---|
| JobManager | 主节点,负责作业调度、Checkpoint 协调、故障恢复。包含 Dispatcher、ResourceManager、JobMaster |
| TaskManager | 工作节点,执行具体的 Task,提供 Slot 资源,缓存和交换数据 |
| ResourceManager | 管理 TaskManager 的 Slot 分配,支持 YARN/K8s/Standalone |
| Dispatcher | 提供 REST 接口,接收作业提交,启动 JobMaster |
| Client | 编译代码生成 JobGraph,提交给集群(不参与运行时) |
2.3 TaskSlot 与 SlotSharing
TaskSlot 是 TaskManager 中的资源单位,每个 Slot 独占一份内存(主要是 Managed Memory),但共享 CPU。
TaskManager (3 Slots)
┌─────────────────────────────────┐
│  Slot 0    │  Slot 1   │ Slot 2 │
│  (并行度1)  │ (并行度1)  │(并行度1)│
│            │           │        │
│  source    │  source   │ source │
│    map     │    map    │   map  │
│   sink     │   sink    │  sink  │  ← SlotSharing:不同算子的子任务可共享同一Slot
└─────────────────────────────────┘
SlotSharing 允许同一个 Job 的不同算子的子任务共享同一个 Slot,好处:
- 资源均衡:每个 Slot 持有完整的 Pipeline
- 减少数据网络传输
- 默认开启,可通过
slotSharingGroup()控制
2.4 ExecutionGraph 生成
用户代码经过四层图转换:
StreamGraph (用户代码)
    │  优化(算子链合并)
    ▼
JobGraph (提交给集群)
    │  并行化展开
    ▼
ExecutionGraph (JobMaster 生成,并行执行版本)
    │  部署到 TaskManager
    ▼
物理执行图 (实际 Task 运行)
2.5 数据交换与 Buffer
TaskManager 之间通过 Network Buffer 传输数据:
- 基于 Netty 的 TCP 长连接
- BufferPool 管理,每个 Channel 有独占 Buffer + 浮动 Buffer
- 反压机制:下游 Buffer 满 → 上游无法写入 → 逐级反压
2.6 部署模式
| 模式 | 说明 | 适用场景 |
|---|---|---|
| Session | 集群预先启动,多个作业共享集群 | 小规模作业、调试 |
| Per-Job | 每个作业启动独立集群,作业结束集群释放 | 生产环境(Flink 1.15 前主流) |
| Application | 每个作业独立 JobManager,main() 在集群执行 | 生产推荐,资源隔离好 |
2.7 资源调度平台
- Standalone:独立集群,手动管理
- YARN:Hadoop 生态,经典企业级部署
- Kubernetes:云原生方向,Flink 1.18+ 原生 Operator 支持,自动扩缩容
2.8 TaskManager 内存模型详解
Flink TaskManager 进程的内存配置直接影响作业稳定性和性能,理解内存模型是生产调优的基础。
内存全景图:
┌──────────────────────── TaskManager Process Memory ────────────────────────┐
│                                                                            │
│  ┌─────────────────────── Total Flink Memory ──────────────────────────┐   │
│  │                                                                     │   │
│  │  ┌── Framework Heap ──┐  ┌── Task Heap ────────────────────────┐    │   │
│  │  │  (Flink框架本身)    │  │  (用户代码/算子对象)                  │   │   │
│  │  │  默认 128MB         │  │  Managed Memory - 上述部分           │   │   │
│  │  └────────────────────┘  └──────────────────────────────────────┘   │   │
│  │                                                                     │   │
│  │  ┌── Framework Off-Heap ─┐  ┌── Task Off-Heap ─────────────────┐    │   │
│  │  │  (框架堆外,默认128MB)  │  │  (用户堆外内存,默认0)             │   │   │
│  │  └───────────────────────┘  └───────────────────────────────────┘   │   │
│  │                                                                     │   │
│  │  ┌── Network Memory ─────────────────────────────────────────────┐  │   │
│  │  │  (网络缓冲,Shuffle数据交换,默认占Total Flink 10%)             │  │   │
│  │  └──────────────────────────────────────────────────────────────┘  │   │
│  │                                                                     │   │
│  │  ┌── Managed Memory ────────────────────────────────────────────┐  │   │
│  │  │  (RocksDB状态/Python/排序/哈希表,默认占Total Flink 40%)       │  │   │
│  │  └──────────────────────────────────────────────────────────────┘  │   │
│  │                                                                     │   │
│  └─────────────────────────────────────────────────────────────────────┘   │
│                                                                            │
│  ┌── JVM Metaspace ──┐  ┌── JVM Overhead ──────────────────────────┐     │
│  │  (类元数据,默认256MB)│  │  (线程栈/IO/编译等,默认占总内存10%)     │     │
│  └────────────────────┘  └──────────────────────────────────────────┘     │
│                                                                            │
└────────────────────────────────────────────────────────────────────────────┘
各内存区域说明:
| 内存区域 | 作用 | 默认配置 |
|---|---|---|
| Framework Heap | Flink 框架本身使用的堆内存(不计入 Slot) | 128MB |
| Task Heap | 用户算子代码、对象分配的堆内存 | 剩余自动推算 |
| Framework Off-Heap | Flink 框架堆外内存 | 128MB |
| Task Off-Heap | 用户代码申请的堆外内存(如 Netty/NIO) | 0 bytes |
| Network Memory | 网络 Shuffle 缓冲池,每个 InputGate/ResultPartition 使用 | 10% of Total Flink Memory |
| Managed Memory | RocksDB 状态后端、Python 进程、批处理排序/哈希表 | 40% of Total Flink Memory |
| JVM Metaspace | JVM 类加载元数据 | 256MB |
| JVM Overhead | JVM 其他开销(线程栈、GC 结构、IO 缓冲区) | 10% of Process Memory |
关键配置参数:
# flink-conf.yaml

# ===== 进程总内存(推荐直接配置此项,Flink自动推算各部分)=====
taskmanager.memory.process.size: 4096m    # TM 进程总内存(含JVM开销)
# 或配置 Flink 总内存(不含JVM开销),Flink 自动加 JVM 部分:
# taskmanager.memory.flink.size: 4096m

# ===== Framework 内存 =====
taskmanager.memory.framework.heap.size: 128mb
taskmanager.memory.framework.off-heap.size: 128mb

# ===== Task 内存 =====
taskmanager.memory.task.heap.size: 4096m       # 不设则自动推算
taskmanager.memory.task.off-heap.size: 0 bytes

# ===== Managed Memory =====
taskmanager.memory.managed.fraction: 0.4       # 占 Total Flink Memory 比例
taskmanager.memory.managed.size: 1024m         # 也可直接指定绝对值
# RocksDB 状态后端下,Managed Memory 全部用于 RocksDB 的块缓存和写缓冲区

# ===== Network Memory =====
taskmanager.memory.network.fraction: 0.10      # 占 Total Flink Memory 比例
taskmanager.memory.network.min: 64mb
taskmanager.memory.network.max: 1gb

# ===== JVM 部分 =====
taskmanager.memory.jvm-metaspace.size: 256mb
taskmanager.memory.jvm-overhead.fraction: 0.10
taskmanager.memory.jvm-overhead.min: 192mb
taskmanager.memory.jvm-overhead.max: 1gb
配置优先级:显式配置绝对值 > fraction 比例推算。配置
process.size后,Flink 按 fraction 自动划分各区域;若某区域显式配置了绝对值,则从剩余部分中再按比例分配。
RocksDB 状态后端下 Managed Memory 的分配:
使用 RocksDB 时,Managed Memory 被划分为每个 Slot 独占的份额,用于:
- Block Cache:RocksDB 读缓存(默认占 Managed Memory 的约 1/3)
- Write Buffer Manager:控制 RocksDB MemTable 内存(默认约占 2/3)
Managed Memory (per TM)
├── Slot 0 Share
│   ├── RocksDB Block Cache (~1/3)
│   └── Write Buffer / MemTables (~2/3)
├── Slot 1 Share
│   ├── Block Cache
│   └── Write Buffer
└── ...
Flink 自动将 Managed Memory 转化为 RocksDB 的 write_buffer_manager 和 cache 配置,避免手动调参。可通过以下参数微调:
state.backend.rocksdb.memory.managed: true        # 默认开启,使用Managed Memory
state.backend.rocksdb.memory.write-buffer-ratio: 0.5  # 写缓冲占比
state.backend.rocksdb.memory.high-prio-pool-ratio: 0.1 # 高优先级池占比
常见内存问题与排查:
| 问题 | 现象 | 原因 | 解决 |
|---|---|---|---|
| 容器 OOM Killed | Pod/Container 被 YARN/K8s 杀死,exit code 137 | JVM Overhead/Direct Memory 超出容器限制 | 增大 jvm-overhead.fraction;检查用户代码是否有堆外泄漏;适当降低 process.size 留出余量 |
| Managed Memory 不足 | RocksDB 频繁刷盘,Checkpoint 慢,吞吐下降 | Managed Memory fraction 太小 | 增大 managed.fraction(大状态场景可设 0.5~0.6);减少每个 TM 的 Slot 数 |
| Network Buffer 不足 | Insufficient number of network buffers 异常 | 高并行度下网络缓冲不够 | 增大 network.max;检查 taskmanager.network.memory.buffers-per-channel |
| Heap OOM | java.lang.OutOfMemoryError: Java heap space | 用户代码对象过多/状态过大 | 增大 Task Heap;大状态切换 RocksDB 后端;优化代码减少对象 |
| Direct Memory OOM | OutOfMemoryError: Direct buffer memory | 堆外内存不足 | 增大 task.off-heap.size 或 jvm-overhead |
内存调优建议:
# ===== 流式作业(大状态 RocksDB)=====
taskmanager.memory.process.size: 8192m
taskmanager.memory.managed.fraction: 0.5     # 大状态给更多 Managed Memory
taskmanager.memory.network.fraction: 0.10
taskmanager.numberOfTaskSlots: 2             # 大状态场景减少 Slot,增加每 Slot 内存

# ===== 批式作业(排序/哈希密集)=====
taskmanager.memory.process.size: 8192m
taskmanager.memory.managed.fraction: 0.6     # 批处理 Managed Memory 用于排序/哈希
taskmanager.memory.network.fraction: 0.15    # 批 Shuffle 数据量大
taskmanager.numberOfTaskSlots: 4

# ===== 小状态流作业(HashMap 后端)=====
taskmanager.memory.process.size: 4096m
taskmanager.memory.managed.fraction: 0.2     # HashMap 不需要太多 Managed Memory
taskmanager.memory.network.fraction: 0.10
taskmanager.numberOfTaskSlots: 4
黄金法则:容器环境务必设置
taskmanager.memory.process.size,且该值应略小于容器内存限制(留 10%~15% 余量给 JVM 自身开销),否则容易被 OOM Killed。
3. 环境搭建
3.1 Local 模式(快速体验)
# 下载 Flink
wget https://archive.apache.org/dist/flink/flink-1.18.1/flink-1.18.1-bin-scala_2.12.tgz
tar -xzf flink-1.18.1-bin-scala_2.12.tgz
cd flink-1.18.1

# 启动本地集群
./bin/start-cluster.sh

# 访问 Web UI: http://localhost:8081
3.2 Standalone 集群
# conf/flink-conf.yaml
jobmanager.rpc.address: flink-master
jobmanager.memory.process.size: 1600m
taskmanager.memory.process.size: 4096m
taskmanager.numberOfTaskSlots: 4
parallelism.default: 4

# conf/workers
flink-worker1
flink-worker2
flink-worker3

# 分发到所有节点后启动
./bin/start-cluster.sh
3.3 On YARN
# Session 模式
./bin/yarn-session.sh -nm flink-session -n 4 -s 4 -jm 1024m -tm 4096m

# Application 模式(推荐)
./bin/flink run-application -t yarn-application \
  -Djobmanager.memory.process.size=1024m \
  -Dtaskmanager.memory.process.size=4096m \
  -Dtaskmanager.numberOfTaskSlots=4 \
  ./examples/streaming/TopSpeedWindowing.jar
3.4 Flink SQL Client
./bin/sql-client.sh

# 在 SQL Client 中
SET 'sql-client.execution.result-mode' = 'tableau';

CREATE TABLE kafka_source (
  id BIGINT,
  name STRING,
  ts TIMESTAMP(3),
  WATERMARK FOR ts AS ts - INTERVAL '5' SECOND
) WITH (
  'connector' = 'kafka',
  'topic' = 'test',
  'properties.bootstrap.servers' = 'localhost:9092',
  'format' = 'json',
  'scan.startup.mode' = 'latest-offset'
);

SELECT * FROM kafka_source;
3.5 PyFlink 环境
# 安装 PyFlink
pip install apache-flink==1.18.1

# 验证
python -c "from pyflink.datastream import StreamExecutionEnvironment; print('OK')"
# PyFlink 快速示例
from pyflink.datastream import StreamExecutionEnvironment

env = StreamExecutionEnvironment.get_execution_environment()
ds = env.from_collection([1, 2, 3, 4, 5])
ds.map(lambda x: x * 2).print()
env.execute("pyflink_demo")
3.6 Flink on Kubernetes
随着云原生普及,Kubernetes 已成为 Flink 生产部署的主流选择。Flink 原生支持在 K8s 上运行,JobManager 和 TaskManager 均以 Pod 形式调度。
Native K8s 部署模式原理:
┌─────────────────────────── Kubernetes Cluster ───────────────────────────┐
│                                                                          │
│  ┌─── Flink Client (kubectl/flink) ───┐                                  │
│  │  解析 flink-conf.yaml → 调用 K8s API│                                  │
│  └────────────────┬────────────────────┘                                 │
│                   │ 创建                                                  │
│                   ▼                                                       │
│  ┌─── JobManager Pod ──────────────────────────────────────────────┐     │
│  │  JM Container                                                   │     │
│  │  ┌──────────┐ ┌──────────────┐ ┌────────────┐                  │     │
│  │  │Dispatcher│ │ResourceManager│ │  JobMaster │                  │     │
│  │  └──────────┘ └──────┬───────┘ └────────────┘                  │     │
│  └──────────────────────┼──────────────────────────────────────────┘     │
│                         │ 申请Slot → 动态创建TM Pod                        │
│         ┌───────────────┼───────────────┐                                │
│         ▼               ▼               ▼                                │
│  ┌─── TM Pod ───┐ ┌─── TM Pod ───┐ ┌─── TM Pod ───┐                     │
│  │ TaskManager  │ │ TaskManager  │ │ TaskManager  │                     │
│  │ Slot ×N      │ │ Slot ×N      │ │ Slot ×N      │                     │
│  └──────────────┘ └──────────────┘ └──────────────┘                     │
│                                                                          │
└──────────────────────────────────────────────────────────────────────────┘
Flink 直接与 K8s API Server 交互:ResourceManager 按需申请/归还 Pod,无需预先部署 TaskManager。
三种部署模式对比(K8s 下):
| 模式 | Session | Application | Per-Job |
|---|---|---|---|
| 集群生命周期 | 长运行,多作业共享 | 每作业独立集群,作业结束销毁 | 每作业独立集群(1.15 已废弃) |
| main() 执行位置 | Client 端 | JobManager 端(集群内) | Client 端 |
| 资源隔离 | 差(多作业共享 JM/TM) | 好(独立 JM) | 好 |
| 适用场景 | 短期调试、小规模作业 | 生产推荐 | 已废弃,使用 Application 替代 |
| JM 故障影响 | 所有作业失败 | 仅当前作业 | 仅当前作业 |
Application 模式提交命令:
# Native K8s Application 模式
./bin/flink run-application \
  --target kubernetes-application \
  -Dkubernetes.cluster-id=flink-streaming-job \
  -Dkubernetes.container.image=flink:1.18.1-java17 \
  -Dkubernetes.namespace=flink-prod \
  -Djobmanager.memory.process.size=1024m \
  -Dtaskmanager.memory.process.size=4096m \
  -Dtaskmanager.numberOfTaskSlots=4 \
  -Dkubernetes.taskmanager.cpu=2.0 \
  -Dkubernetes.jobmanager.cpu=1.0 \
  -Dkubernetes.rest-service.exposed.type=LoadBalancer \
  local:///opt/flink/usrlib/my-streaming-job.jar

# 查看作业
./bin/flink list --target kubernetes-application \
  -Dkubernetes.cluster-id=flink-streaming-job

# 取消作业
./bin/flink cancel --target kubernetes-application \
  -Dkubernetes.cluster-id=flink-streaming-job <jobId>
Docker 镜像构建:
# Dockerfile - 基于官方镜像叠加业务依赖
FROM flink:1.18.1-java17

# 复制用户 JAR 包(SQL Connector/UDX 等)
COPY ./lib/flink-sql-connector-kafka-3.1.0-1.18.jar /opt/flink/lib/
COPY ./lib/flink-connector-jdbc-3.2.0-1.18.jar /opt/flink/lib/
COPY ./lib/mysql-connector-j-8.0.33.jar /opt/flink/lib/
COPY ./lib/flink-sql-connector-mysql-cdc-3.0.1.jar /opt/flink/lib/
COPY ./target/my-streaming-job.jar /opt/flink/usrlib/

# 自定义日志配置
COPY ./conf/log4j2.xml /opt/flink/conf/log4j2.xml

# 设置时区
ENV TZ=Asia/Shanghai
RUN ln -snf /usr/share/zoneinfo/$TZ /etc/localtime && echo $TZ > /etc/timezone
# 构建并推送镜像
docker build -t my-registry/flink:1.18.1-myjob .
docker push my-registry/flink:1.18.1-myjob
K8s 关键配置参数:
| 参数 | 说明 | 示例 |
|---|---|---|
kubernetes.cluster-id | 集群唯一标识,用于资源命名 | flink-streaming-job |
kubernetes.container.image | Docker 镜像 | flink:1.18.1-java17 |
kubernetes.container.image.pull-policy | 镜像拉取策略 | IfNotPresent / Always |
kubernetes.namespace | K8s 命名空间 | flink-prod |
kubernetes.service-account | RBAC 服务账号 | flink-service-account |
kubernetes.taskmanager.cpu | TM CPU 请求 | 2.0 |
kubernetes.jobmanager.cpu | JM CPU 请求 | 1.0 |
taskmanager.memory.process.size | TM 进程内存 | 4096m |
jobmanager.memory.process.size | JM 进程内存 | 1024m |
taskmanager.numberOfTaskSlots | 每 TM Slot 数 | 4 |
kubernetes.rest-service.exposed.type | REST 暴露方式 | ClusterIP / NodePort / LoadBalancer |
kubernetes.pod-template-file | Pod 模板文件(高级配置) | /etc/flink/pod-template.yaml |
Pod Template 示例(高级配置):
# pod-template.yaml - 挂载 ConfigMap/Secret/卷
apiVersion: v1
kind: Pod
metadata:
  name: pod-template
spec:
  containers:
    - name: flink-main-container
      volumeMounts:
        - name: flink-config-volume
          mountPath: /opt/flink/conf
        - name: hdfs-config
          mountPath: /etc/hadoop/conf
      env:
        - name: TZ
          value: Asia/Shanghai
  volumes:
    - name: flink-config-volume
      configMap:
        name: flink-config
    - name: hdfs-config
      configMap:
        name: hdfs-config
Flink K8s Operator 简介:
Flink K8s Operator 是 Apache 官方项目,通过 CRD(Custom Resource Definition)以声明式方式管理 Flink 作业,支持自动扩缩容、滚动升级、Savepoint 管理。
# 使用 Helm 安装 Flink K8s Operator
helm repo add flink-operator-repo https://downloads.apache.org/flink/flink-kubernetes-operator-1.9.0/
helm install flink-kubernetes-operator flink-operator-repo/flink-kubernetes-operator \
  --namespace flink-system \
  --create-namespace
# flinkdeployment.yaml - 声明式定义 Flink 作业
apiVersion: flink.apache.org/v1beta1
kind: FlinkDeployment
metadata:
  name: flink-streaming-job
  namespace: flink-prod
spec:
  image: my-registry/flink:1.18.1-myjob
  flinkVersion: v1_18
  flinkConfiguration:
    taskmanager.numberOfTaskSlots: "4"
    state.backend: rocksdb
    state.checkpoints.dir: s3://flink/checkpoints
    state.savepoints.dir: s3://flink/savepoints
    execution.checkpointing.interval: "60s"
  jobManager:
    resource:
      memory: "1024m"
      cpu: 1
  taskManager:
    resource:
      memory: "4096m"
      cpu: 2
  podTemplate:
    spec:
      containers:
        - name: flink-main-container
          env:
            - name: TZ
              value: Asia/Shanghai
  job:
    jarURI: local:///opt/flink/usrlib/my-streaming-job.jar
    parallelism: 8
    upgradeMode: savepoint          # 升级时自动做 Savepoint
    state: running
# 部署
kubectl apply -f flinkdeployment.yaml

# 查看状态
kubectl get flinkdeployment -n flink-prod
kubectl describe flinkdeployment flink-streaming-job -n flink-prod
K8s vs YARN 对比:
| 对比维度 | Kubernetes | YARN |
|---|---|---|
| 资源模型 | 容器化(Pod),CPU/Memory 显式声明 | Container(Slot),内存为主 |
| 弹性扩缩 | 原生 HPA/Operator Autoscaler,秒级伸缩 | 需配置 NodeManager,弹性较弱 |
| 多租户 | Namespace + RBAC + ResourceQuota 隔离完善 | Queue 隔离,粒度较粗 |
| 镜像管理 | Docker 镜像版本化,依赖打包一致性好 | 依赖散落在节点,易出现环境不一致 |
| 运维生态 | kubectl/Helm/Prometheus 原生集成 | YARN UI + ResourceManager |
| 存储集成 | PVC/HostPath/S3/OSS,CSI 插件丰富 | HDFS 深度集成,外部存储需额外配置 |
| 启动速度 | Pod 拉起较快(镜像缓存后秒级) | Container 启动较慢 |
| 学习成本 | 需掌握 K8s 概念(Pod/Service/Ingress) | Hadoop 生态团队上手快 |
| 适用场景 | 云原生/混合云/新建集群 | 已有 Hadoop 生态的企业 |
4. DataStream API
4.1 执行环境
// Java
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
env.setParallelism(4);
env.enableCheckpointing(60000); // 60秒一次Checkpoint
# PyFlink
from pyflink.datastream import StreamExecutionEnvironment
env = StreamExecutionEnvironment.get_execution_environment()
env.set_parallelism(4)
4.2 Source
Kafka Source(Flink 1.14+ 推荐使用 KafkaSource):
KafkaSource<String> source = KafkaSource.<String>builder()
    .setBootstrapServers("localhost:9092")
    .setTopics("orders")
    .setGroupId("flink-group")
    .setStartingOffsets(OffsetsInitializer.latest())
    .setValueOnlyDeserializer(new SimpleStringSchema())
    .build();

DataStream<String> stream = env.fromSource(
    source, WatermarkStrategy.noWatermarks(), "Kafka Source");
File Source:
FileSource<String> fileSource = FileSource.forRecordStreamFormat(
    new TextLineInputFormat(), new Path("/data/input/"))
    .monitorContinuously(Duration.ofSeconds(10)) // 流式监控新文件
    .build();

DataStream<String> lines = env.fromSource(
    fileSource, WatermarkStrategy.noWatermarks(), "File Source");
Socket Source:
DataStream<String> socketStream = env.socketTextStream("localhost", 9999);
自定义 Source:
public class CustomSource implements SourceFunction<Order> {
    private volatile boolean running = true;

    @Override
    public void run(SourceContext<Order> ctx) throws Exception {
        Random random = new Random();
        while (running) {
            Order order = new Order(
                random.nextLong(),
                "item_" + random.nextInt(100),
                random.nextDouble() * 1000,
                System.currentTimeMillis()
            );
            ctx.collect(order);
            Thread.sleep(100);
        }
    }

    @Override
    public void cancel() {
        running = false;
    }
}

DataStream<Order> customStream = env.addSource(new CustomSource());
注意:Flink 推荐使用新的
Source接口(FLIP-27),旧的SourceFunction仍可用但逐渐被取代。
4.3 Transformation
// map: 一对一转换
DataStream<Order> enriched = orders.map(order -> {
    order.setDiscounted(order.getAmount() * 0.9);
    return order;
});

// flatMap: 一对多展开
DataStream<String> words = lines.flatMap((String line, Collector<String> out) -> {
    for (String word : line.split(" ")) {
        out.collect(word);
    }
}).returns(Types.STRING);

// filter: 过滤
DataStream<Order> largeOrders = orders.filter(o -> o.getAmount() > 1000);

// keyBy: 按 key 分区(注意:返回 KeyedStream)
KeyedStream<Order, String> keyedByItem = orders.keyBy(Order::getItemId);

// reduce: 增量聚合
DataStream<Order> maxOrder = keyedByItem
    .reduce((a, b) -> a.getAmount() > b.getAmount() ? a : b);

// aggregations: sum/min/max
DataStream<Order> sumByItem = keyedByItem
    .sum("amount")  // 按字段名聚合
    .name("sum-by-item");

// window: 在 keyBy 后开窗
WindowedStream<Order, String, TimeWindow> tumblingWindow = keyedByItem
    .window(TumblingProcessingTimeWindows.of(Time.seconds(10)));

// connect: 合流(保留各自类型)
DataStream<OrderA> streamA = ...;
DataStream<OrderB> streamB = ...;
ConnectedStreams<OrderA, OrderB> connected = streamA.connect(streamB);
DataStream<String> result = connected.map(
    new CoMapFunction<OrderA, OrderB, String>() {
        @Override
        public String map1(OrderA value) { return "A:" + value; }
        @Override
        public String map2(OrderB value) { return "B:" + value; }
    });

// union: 合流(相同类型,可多个流合并)
DataStream<Order> allOrders = streamA.union(streamB, streamC);

// side outputs: 侧输出(处理迟到数据等)
final OutputTag<Order> lateTag = new OutputTag<Order>("late-events"){};
SingleOutputStreamOperator<Order> mainStream = orders
    .process(new ProcessFunction<Order, Order>() {
        @Override
        public void processElement(Order order, Context ctx, Collector<Order> out) {
            if (order.getAmount() < 0) {
                ctx.output(lateTag, order); // 侧输出
            } else {
                out.collect(order);
            }
        }
    });
DataStream<Order> lateStream = mainStream.getSideOutput(lateTag);
4.4 Sink
Kafka Sink:
KafkaSink<String> kafkaSink = KafkaSink.<String>builder()
    .setBootstrapServers("localhost:9092")
    .setRecordSerializer(KafkaRecordSerializationSchema.builder()
        .setTopic("output-topic")
        .setValueSerializationSchema(new SimpleStringSchema())
        .build())
    .setDeliveryGuarantee(DeliveryGuarantee.EXACTLY_ONCE)
    .setTransactionalIdPrefix("flink-txn-")
    .build();

stream.sinkTo(kafkaSink);
JDBC Sink:
JdbcSink.sink(
    "INSERT INTO orders (id, item_id, amount) VALUES (?, ?, ?)",
    (ps, order) -> {
        ps.setLong(1, order.getId());
        ps.setString(2, order.getItemId());
        ps.setDouble(3, order.getAmount());
    },
    JdbcExecutionOptions.builder()
        .withBatchSize(1000)
        .withBatchIntervalMs(200)
        .build(),
    new JdbcConnectionOptions.JdbcConnectionOptionsBuilder()
        .withUrl("jdbc:mysql://localhost:3306/analytics")
        .withDriverName("com.mysql.cj.jdbc.Driver")
        .withUsername("root")
        .withPassword("password")
        .build()
);
文件 Sink(StreamingFileSink → FileSink):
FileSink<String> fileSink = FileSink.forRowFormat(
    new Path("/data/output/"),
    new SimpleStringEncoder<String>("UTF-8"))
    .withRollingPolicy(DefaultRollingPolicy.builder()
        .withRolloverInterval(Duration.ofMinutes(5))
        .withInactivityInterval(Duration.ofMinutes(2))
        .withMaxPartSize(MemorySize.parse("128MB"))
        .build())
    .build();

stream.sinkTo(fileSink);
4.5 并行度设置
并行度优先级(从高到低):
- 算子级别:
.setParallelism(8) - 执行环境级别:
env.setParallelism(4) - 提交参数:
-p 4 - 配置文件:
parallelism.default: 1
4.6 异步 I/O(AsyncDataStream)
在流处理中,经常需要与外部系统交互(如查询 Redis/MySQL 维表、调用 HTTP 接口)。同步请求会阻塞算子线程,导致吞吐极低。异步 I/O 允许并发处理多个请求,大幅提升吞吐。
为什么需要异步 I/O:
同步请求(串行,瓶颈明显):        异步请求(并发,吞吐倍增):
───[查询DB]──▶───[查询DB]──▶      ┌──[查询DB]──┐
   等待...     等待...             ├──[查询DB]──┤──▶ 批量回调
   10ms/条    10ms/条             ├──[查询DB]──┤
   100条/秒                       └──[查询DB]──┘
                                   1000条/秒+
前提:外部系统客户端必须支持异步 API(如 Lettuce(Redis)、Async MySQL Driver、AsyncHttpClient)。若客户端仅支持同步,可使用线程池模拟异步,但效果有限。
AsyncFunction 实现:
// 异步查询 Redis 维表(使用 Lettuce 异步客户端)
public class AsyncRedisDimFunction extends RichAsyncFunction<Order, Order> {

    private transient RedisAsyncCommands<String, String> asyncCommands;
    private transient ExecutorService executor;

    @Override
    public void open(Configuration parameters) {
        RedisClient redisClient = RedisClient.create("redis://localhost:6379");
        StatefulRedisConnection<String, String> connection =
            redisClient.connect();
        asyncCommands = connection.async();

        // 对于仅支持同步的客户端,用线程池模拟
        executor = Executors.newFixedThreadPool(20);
    }

    @Override
    public void asyncInvoke(Order order, ResultFuture<Order> resultFuture) {
        // 异步查询 Redis
        RedisFuture<String> future = asyncCommands.hget(
            "dim:item", order.getItemId());

        future.thenAccept(dimJson -> {
            if (dimJson != null) {
                ItemDim dim = parseJson(dimJson);
                order.setItemName(dim.getName());
                order.setCategory(dim.getCategory());
            }
            // 完成回调,输出结果
            resultFuture.complete(Collections.singletonList(order));
        }).exceptionally(ex -> {
            // 异常处理:记录日志,原样输出或发送侧输出
            LOG.warn("Async Redis query failed for item: {}",
                order.getItemId(), ex);
            resultFuture.complete(Collections.singletonList(order));
            return null;
        });
    }

    @Override
    public void timeout(Order order, ResultFuture<Order> resultFuture) {
        // 超时处理:可输出默认值或侧输出
        LOG.warn("Async query timed out for order: {}", order.getId());
        resultFuture.complete(Collections.singletonList(order));
    }

    @Override
    public void close() {
        if (executor != null) executor.shutdown();
    }
}
使用 AsyncDataStream 调用:
DataStream<Order> enrichedStream = AsyncDataStream
    .unorderedWait(
        orders,                          // 输入流
        new AsyncRedisDimFunction(),     // AsyncFunction
        5000,                            // 超时时间 5s
        TimeUnit.MILLISECONDS,
        100                              // 最大并发请求数 capacity
    )
    .name("async-redis-dim-lookup")
    .setParallelism(4);

// 有序输出版本(保证事件顺序,吞吐略低)
DataStream<Order> orderedStream = AsyncDataStream
    .orderedWait(
        orders,
        new AsyncMysqlDimFunction(),
        3, TimeUnit.SECONDS,
        50
    );
orderedWait vs unorderedWait:
| 模式 | 顺序保证 | 吞吐 | 延迟 | 适用场景 |
|---|---|---|---|---|
| unorderedWait | 不保证顺序,先完成先输出 | 高 | 低 | 大部分维表关联场景 |
| orderedWait | 严格按输入顺序输出 | 较低 | 较高(需等待前面的完成) | 需要严格顺序的业务 |
注意:使用 EventTime 时,
unorderedWait会在 Watermark 处保序,即先完成的记录可以先输出,但不会越过 Watermark;orderedWait则完全按输入顺序。
关键参数:
| 参数 | 说明 | 建议 |
|---|---|---|
timeout | 单个异步请求最大等待时间,超时触发 timeout() | 根据下游 SLA 设置,通常 3~10s |
capacity | 最大并发异步请求数(同时 in-flight 的请求数) | 根据外部系统承载能力,通常 50~200 |
backpressure | 当并发请求达到 capacity 时,自动反压上游 | 自动机制,无需手动配置 |
生产注意事项:
- 连接池管理:AsyncFunction 中使用连接池,避免每条请求新建连接
- 超时与重试:设置合理的超时;失败重试需注意幂等性,建议最多重试 2~3 次
- 缓存:在 AsyncFunction 中加本地缓存(Caffeine/Guava Cache),减少对外部系统的请求
- 降级:查询失败时使用默认值或侧输出,避免作业失败
- 监控:关注异步请求延迟、成功率、超时率
// 带 Caffeine 缓存的 AsyncFunction 示例
public class CachedAsyncDimFunction extends RichAsyncFunction<Order, Order> {
    private transient Cache<String, ItemDim> cache;
    private transient AsyncHttpClient httpClient;

    @Override
    public void open(Configuration parameters) {
        cache = Caffeine.newBuilder()
            .maximumSize(10_000)
            .expireAfterWrite(Duration.ofMinutes(10))
            .build();
        httpClient = Dsl.asyncHttpClient();
    }

    @Override
    public void asyncInvoke(Order order, ResultFuture<Order> resultFuture) {
        ItemDim cached = cache.getIfPresent(order.getItemId());
        if (cached != null) {
            order.setItemName(cached.getName());
            resultFuture.complete(Collections.singletonList(order));
            return;
        }

        // 异步 HTTP 查询
        httpClient.prepareGet("http://dim-service/item/" + order.getItemId())
            .execute()
            .toCompletableFuture()
            .thenApply(resp -> parseJson(resp.getResponseBody()))
            .thenAccept(dim -> {
                cache.put(order.getItemId(), dim);
                order.setItemName(dim.getName());
                resultFuture.complete(Collections.singletonList(order));
            })
            .exceptionally(ex -> {
                resultFuture.complete(Collections.singletonList(order));
                return null;
            });
    }
}
同步 vs 异步性能对比(参考):
| 维度 | 同步查询 | 异步 I/O |
|---|---|---|
| 请求模型 | 串行阻塞 | 并发非阻塞 |
| 单并行度吞吐 | 100500 QPS(取决于 RT) | 500020000 QPS |
| CPU 利用率 | 低(大量等待) | 高(I/O 等待期间处理其他请求) |
| 外部系统压力 | 低(请求慢但并发低) | 需控制 capacity 防止打挂下游 |
| 代码复杂度 | 简单 | 需异步客户端 + 回调 |
5. 时间语义与 Window
5.1 三种时间语义
事件发生 ──── 进入Flink ──── 被处理
   │              │              │
   ▼              ▼              ▼
Event Time   Ingestion Time  Processing Time
(事件时间)    (摄入时间)       (处理时间)
| 时间类型 | 说明 | 适用场景 |
|---|---|---|
| Event Time | 事件自身携带的时间戳 | 生产推荐,正确处理乱序数据 |
| Ingestion Time | 事件进入 Flink Source 的时间 | 较少使用 |
| Processing Time | 算子处理事件的系统时间 | 无需正确性保证的低延迟场景 |
5.2 Watermark 机制
Watermark 是一种衡量事件时间进展的机制,它告诉算子"小于这个时间戳的事件应该都已经到了"。
事件流(乱序):
  10:01  10:03  10:02  10:05  10:04  10:07  10:06
    │      │      │      │      │      │      │
    ▼      ▼      ▼      ▼      ▼      ▼      ▼
Watermark: W(10:00:55) → W(10:02:55) → W(10:04:55) → W(10:06:55)
                     (maxEventTime - 5s 允许延迟)
生成 Watermark:
// 方式一:forBoundedOutOfOrderness(固定延迟)
WatermarkStrategy<Order> strategy = WatermarkStrategy
    .<Order>forBoundedOutOfOrderness(Duration.ofSeconds(5))
    .withTimestampAssigner((order, ts) -> order.getEventTime())
    .withIdleness(Duration.ofMinutes(1)); // 空闲源检测

DataStream<Order> withTimestamps = orders
    .assignTimestampsAndWatermarks(strategy);

// 方式二:Kafka Source 中直接指定
KafkaSource<Order> kafkaSource = KafkaSource.<Order>builder()
    // ...
    .build();
DataStream<Order> stream = env.fromSource(
    kafkaSource,
    WatermarkStrategy.forBoundedOutOfOrderness(Duration.ofSeconds(5)),
    "Kafka Source");
Watermark 传递:
- 多输入算子(如 keyBy 后 union)取所有输入 Watermark 的最小值
- Watermark 周期性生成(默认 200ms,由
pipeline.auto-watermark-interval控制) - 空闲分区/源用
withIdleness()防止 Watermark 不推进
5.3 Window 类型
Tumbling Window(滚动窗口,无重叠)
│──────│──────│──────│──────│
0     10     20     30     40

Sliding Window(滑动窗口,有重叠)
│──────│
  │──────│
    │──────│
      │──────│
0     10     20     30     40
(窗口大小10s,滑动步长5s)

Session Window(会话窗口,间隙触发)
│───│    │────│        │──│
     gap  gap           gap
(相邻事件间隔超过gap则开新窗口)

Global Window(全局窗口,需自定义Trigger)
│──────────────────────────────│
(所有数据到同一个窗口,由Trigger决定何时触发)
// 滚动事件时间窗口
.window(TumblingEventTimeWindows.of(Time.seconds(10)))

// 滑动事件时间窗口
.window(SlidingEventTimeWindows.of(Time.seconds(10), Time.seconds(5)))

// 会话窗口
.window(EventTimeSessionWindows.withGap(Time.minutes(1)))

// 全局窗口
.window(GlobalWindows.create())
.trigger(CountTrigger.of(100)) // 每100条触发
5.4 Window Function
增量聚合(效率高,窗口内只存中间结果):
// ReduceFunction
DataStream<Order> result = keyedOrders
    .window(TumblingEventTimeWindows.of(Time.seconds(10)))
    .reduce((a, b) -> {
        a.setAmount(a.getAmount() + b.getAmount());
        return a;
    });

// AggregateFunction
DataStream<Double> avg = keyedOrders
    .window(TumblingEventTimeWindows.of(Time.seconds(10)))
    .aggregate(new AggregateFunction<Order, Tuple2<Double, Integer>, Double>() {
        @Override
        public Tuple2<Double, Integer> createAccumulator() {
            return Tuple2.of(0.0, 0);
        }
        @Override
        public Tuple2<Double, Integer> add(Order value, Tuple2<Double, Integer> acc) {
            return Tuple2.of(acc.f0 + value.getAmount(), acc.f1 + 1);
        }
        @Override
        public Double getResult(Tuple2<Double, Integer> acc) {
            return acc.f0 / acc.f1;
        }
        @Override
        public Tuple2<Double, Integer> merge(Tuple2<Double, Integer> a,
                                              Tuple2<Double, Integer> b) {
            return Tuple2.of(a.f0 + b.f0, a.f1 + b.f1);
        }
    });
全量聚合(ProcessWindowFunction,可访问窗口元数据):
DataStream<String> result = keyedOrders
    .window(TumblingEventTimeWindows.of(Time.seconds(10)))
    .process(new ProcessWindowFunction<Order, String, String, TimeWindow>() {
        @Override
        public void process(String key, Context ctx,
                            Iterable<Order> values,
                            Collector<String> out) {
            long count = 0;
            double sum = 0;
            for (Order o : values) {
                count++;
                sum += o.getAmount();
            }
            out.collect(String.format("Window [%d - %d] key=%s count=%d avg=%.2f",
                ctx.window().getStart(), ctx.window().getEnd(),
                key, count, sum / count));
        }
    });
最佳实践:增量聚合 + 全量窗口函数结合使用,兼顾性能和灵活性:
.reduce(new MyReduceFunction(), new MyProcessWindowFunction());
5.5 Allowed Lateness 与侧输出迟到数据
OutputTag<Order> lateTag = new OutputTag<Order>("late-orders"){};

SingleOutputStreamOperator<Order> result = keyedOrders
    .window(TumblingEventTimeWindows.of(Time.seconds(10)))
    .allowedLateness(Time.seconds(30))  // 窗口触发后再等30秒
    .sideOutputLateData(lateTag)        // 仍然迟到的数据进入侧输出
    .reduce(new MyReduceFunction());

DataStream<Order> lateData = result.getSideOutput(lateTag);
lateData.addSink(new LateDataSink()); // 单独处理迟到数据
6. 状态管理
6.1 状态的分类
Flink State
├── Keyed State(按 key 分区,只能在 KeyedStream 上使用)
│   ├── ValueState<T>        单个值
│   ├── ListState<T>         列表
│   ├── MapState<K,V>        Map(推荐,性能好)
│   ├── ReducingState<T>     增量聚合
│   └── AggregatingState<I,O> 聚合
├── Operator State(算子级别,与 key 无关)
│   └── ListState<T>
└── Broadcast State(广播状态,动态配置/规则下发)
6.2 Keyed State 示例
public class CountWithKeyedState extends RichFlatMapFunction<Order, String> {
    private transient ValueState<Long> countState;
    private transient MapState<String, Double> amountByItem;

    @Override
    public void open(Configuration parameters) {
        // ValueState
        ValueStateDescriptor<Long> countDesc = new ValueStateDescriptor<>(
            "count", Long.class);
        countState = getRuntimeContext().getState(countDesc);

        // MapState(推荐替代 ListState 做分类统计)
        MapStateDescriptor<String, Double> mapDesc = new MapStateDescriptor<>(
            "amount-by-item", String.class, Double.class);
        amountByItem = getRuntimeContext().getMapState(mapDesc);
    }

    @Override
    public void flatMap(Order order, Collector<String> out) throws Exception {
        Long count = countState.value();
        if (count == null) count = 0L;
        count++;
        countState.update(count);

        Double current = amountByItem.get(order.getItemId());
        if (current == null) current = 0.0;
        amountByItem.put(order.getItemId(), current + order.getAmount());

        out.collect("Total orders: " + count);
    }
}
6.3 State Backend
| State Backend | 特点 | 适用场景 |
|---|---|---|
| HashMapStateBackend | 状态存堆内存,读写快,Checkpoint 到文件 | 小状态(GB 级以内),低延迟 |
| RocksDBStateBackend | 状态存本地 RocksDB(磁盘),支持超大状态 | 大状态(TB 级),生产推荐 |
| EmbeddedRocksDBStateBackend | Flink 1.18+ 官方推荐配置名 | 同上 |
// Flink 1.18+ 配置方式
Configuration config = new Configuration();
config.set(StateBackendOptions.STATE_BACKEND, "hashmap");
// 或 RocksDB:
config.set(StateBackendOptions.STATE_BACKEND, "rocksdb");
config.set(CheckpointingOptions.CHECKPOINT_STORAGE, "filesystem");
config.set(CheckpointingOptions.CHECKPOINTS_DIRECTORY,
    "hdfs:///flink/checkpoints");

env.configure(config);
6.4 状态 TTL
状态 TTL 可以自动清理过期状态,防止状态无限增长:
StateTtlConfig ttlConfig = StateTtlConfig
    .newBuilder(Time.hours(24))              // 24小时过期
    .setUpdateType(StateTtlConfig.UpdateType.OnCreateAndWrite) // 写入时刷新
    .setStateVisibility(StateTtlConfig.StateVisibility.NeverReturnExpired)
    .cleanupInRocksdbCompactFilter(1000)      // RocksDB 压缩时清理
    .build();

ValueStateDescriptor<Long> desc = new ValueStateDescriptor<>("count", Long.class);
desc.enableTimeToLive(ttlConfig);
6.5 Broadcast State
用于低吞吐量的规则流广播到所有 Task:
// 规则流(如风控规则更新)
MapStateDescriptor<String, Rule> ruleStateDesc = new MapStateDescriptor<>(
    "rules", String.class, Rule.class);

BroadcastStream<Rule> ruleBroadcastStream = rules
    .broadcast(ruleStateDesc);

// 连接主流和广播流
BroadcastConnectedStream<Order, Rule> connected = orders
    .connect(ruleBroadcastStream);

connected.process(new BroadcastProcessFunction<Order, Rule, Alert>() {
    @Override
    public void processElement(Order order, ReadOnlyContext ctx,
                                Collector<Alert> out) throws Exception {
        ReadOnlyBroadcastState<String, Rule> state =
            ctx.getBroadcastState(ruleStateDesc);
        // 只读访问规则,进行匹配
        Rule rule = state.get(order.getItemId());
        if (rule != null && rule.matches(order)) {
            out.collect(new Alert(order));
        }
    }

    @Override
    public void processBroadcastElement(Rule rule, Context ctx,
                                         Collector<Alert> out) throws Exception {
        BroadcastState<String, Rule> state = ctx.getBroadcastState(ruleStateDesc);
        state.put(rule.getId(), rule); // 更新规则
    }
});
6.6 状态原语选择建议
| 需求 | 推荐 | 原因 |
|---|---|---|
| 存单个值 | ValueState | 最简单 |
| 按类别累加 | MapState | 比 ListState 遍历高效 |
| 窗口内累加 | ReducingState/AggregatingState | 增量计算,不存原始数据 |
| 大状态 | RocksDB + MapState | 磁盘存储,增量 Checkpoint |
7. 容错机制
7.1 Checkpoint 原理
Checkpoint 是 Flink 实现容错的核心机制,基于 Chandy-Lamport 分布式快照算法:
Source 注入 Barrier
    │
    ▼
┌─────┐ Barrier_n
│Task1│─────────▶┌─────┐ Barrier_n
└─────┘           │Task2│─────────▶ Sink
                  └─────┘
每个 Task 收到 Barrier 后:
1. 对当前状态做快照(异步)
2. 将 Barrier 转发给下游
3. 快照完成后向 JobManager 确认
所有 Task 确认 → Checkpoint 完成
配置:
env.enableCheckpointing(60000); // 间隔60秒

CheckpointConfig ckConfig = env.getCheckpointConfig();
ckConfig.setCheckpointingMode(CheckpointingMode.EXACTLY_ONCE);
ckConfig.setCheckpointTimeout(120000);        // 超时2分钟
ckConfig.setMinPauseBetweenCheckpoints(30000); // 两次CK最小间隔30秒
ckConfig.setMaxConcurrentCheckpoints(1);       // 最大并发1
ckConfig.setTolerableCheckpointFailureNumber(3); // 容忍3次失败
ckConfig.enableExternalizedCheckpoints(
    CheckpointConfig.ExternalizedCheckpointCleanup.RETAIN_ON_CANCELLATION);
7.2 Checkpoint vs Savepoint
| 维度 | Checkpoint | Savepoint |
|---|---|---|
| 触发方式 | 自动(定时) | 手动 |
| 用途 | 故障恢复 | 升级/迁移/扩缩容 |
| 格式 | 可能增量(RocksDB) | 全量标准格式 |
| 生命周期 | 作业运行时自动管理 | 手动管理,永久保留 |
| 状态兼容 | 严格 | 支持重命名/删除等 |
| 性能 | 轻量,频繁 | 重量,偶尔 |
7.3 Barrier 对齐与非对齐检查点
对齐检查点(Aligned Checkpoint):
- 算子收到第一个 Barrier 后,阻塞该 Channel,等待其他 Channel 的 Barrier 到达
- 问题:反压时对齐时间长,Checkpoint 超时
非对齐检查点(Unaligned Checkpoint, UC):
- Barrier 直接穿越缓冲区,不等齐
- 将 in-flight 数据一起做快照
- 优势:反压场景下 Checkpoint 更快
- 代价:Checkpoint 更大(包含缓冲数据),恢复时间可能更长
// 启用非对齐检查点
ckConfig.enableUnalignedCheckpoints();
// UC 触发超时(反压超过此时间后自动使用 UC)
ckConfig.setAlignedCheckpointTimeout(Duration.ofSeconds(30));
7.4 Exactly-Once vs At-Least-Once
| 语义 | 说明 | 代价 |
|---|---|---|
| Exactly-Once | 每条数据恰好处理一次,不重不漏 | Checkpoint 对齐,延迟略高 |
| At-Least-Once | 至少处理一次,可能重复 | 不等 Barrier 对齐,延迟低 |
7.5 两阶段提交(2PC)与端到端 Exactly-Once
Flink 的端到端 Exactly-Once 需要 Source、Flink 引擎、Sink 三者配合:
阶段一(Pre-commit):
  Checkpoint Barrier 到达 Sink → Sink 开启事务写入外部系统
  → 提交事务预提交 → 通知 JobManager

阶段二(Commit):
  JobManager 收到所有 Task 的 CK 确认 → 通知所有 Task CK 完成
  → Sink 正式提交事务 → 数据对外可见

若失败:
  → Sink 回滚事务 → 从上一个 Checkpoint 恢复
支持 2PC 的 Sink: Kafka(事务写入)、MySQL(XA)、FileSink(原子重命名)、Paimon/Iceberg/Hudi。
// Kafka Sink 端到端 Exactly-Once
KafkaSink<String> sink = KafkaSink.<String>builder()
    .setDeliveryGuarantee(DeliveryGuarantee.EXACTLY_ONCE)
    .setTransactionalIdPrefix("flink-e2e-")
    // ...
    .build();
8. Flink SQL
8.1 Table API & SQL 简介
Flink SQL 基于 Apache Calcite,将 SQL 查询编译为 DataStream/DataSet 程序:
-- 纯 SQL 方式
CREATE TABLE orders (
  order_id BIGINT,
  item_id STRING,
  amount DECIMAL(10,2),
  order_time TIMESTAMP(3),
  WATERMARK FOR order_time AS order_time - INTERVAL '5' SECOND
) WITH (
  'connector' = 'kafka',
  'topic' = 'orders',
  'properties.bootstrap.servers' = 'kafka:9092',
  'format' = 'json'
);

-- 每10秒滚动窗口统计每个商品的GMV
SELECT
  window_start,
  window_end,
  item_id,
  SUM(amount) AS gmv,
  COUNT(*) AS order_cnt
FROM TABLE(
  TUMBLE(TABLE orders, DESCRIPTOR(order_time), INTERVAL '10' SECONDS)
)
GROUP BY window_start, window_end, item_id;
8.2 动态表与持续查询
Flink SQL 的核心抽象是动态表(Dynamic Table):流 → 动态表 → 持续查询 → 动态表 → 流。
Kafka Stream
    │
    ▼
┌──────────────┐
│  Dynamic Table│  (持续追加/更新)
└──────┬───────┘
       │ Continuous Query
       ▼
┌──────────────┐
│ Result Table │  (持续变化)
└──────┬───────┘
       │ toChangelogStream
       ▼
  Kafka/MySQL/ES Sink
8.3 时间属性
-- 处理时间(系统时间,无需 WATERMARK)
CREATE TABLE orders (
  order_id BIGINT,
  item_id STRING,
  amount DECIMAL(10,2),
  proc_time AS PROCTIME()  -- 计算列
) WITH (...);

-- 事件时间(需 WATERMARK)
CREATE TABLE orders (
  order_id BIGINT,
  item_id STRING,
  amount DECIMAL(10,2),
  order_time TIMESTAMP(3),
  WATERMARK FOR order_time AS order_time - INTERVAL '5' SECOND
) WITH (...);
8.4 Window TVF(Flink 1.13+ 推荐)
-- 滚动窗口
SELECT window_start, window_end, item_id, SUM(amount)
FROM TABLE(TUMBLE(TABLE orders, DESCRIPTOR(order_time), INTERVAL '10' SECONDS))
GROUP BY window_start, window_end, item_id;

-- 滑动窗口
SELECT window_start, window_end, item_id, SUM(amount)
FROM TABLE(HOP(TABLE orders, DESCRIPTOR(order_time),
               INTERVAL '5' SECONDS, INTERVAL '10' SECONDS))
GROUP BY window_start, window_end, item_id;

-- 累计窗口(Cumulate,Flink 1.13+)
SELECT window_start, window_end, item_id, SUM(amount)
FROM TABLE(CUMULATE(TABLE orders, DESCRIPTOR(order_time),
                    INTERVAL '1' MINUTES, INTERVAL '1' HOURS))
GROUP BY window_start, window_end, item_id;

-- 会话窗口(TVF 暂不支持,使用旧语法)
SELECT item_id, SESSION_START(order_time, INTERVAL '1' MINUTE), SUM(amount)
FROM orders
GROUP BY item_id, SESSION(order_time, INTERVAL '1' MINUTE);
8.5 Join 类型
| Join 类型 | 说明 | 典型场景 |
|---|---|---|
| Regular Join | 双流 Join,两边状态持续保留 | 双流关联(需注意状态大小) |
| Interval Join | 时间区间内 Join,自动清理状态 | 订单+支付关联 |
| Temporal Join | 关联版本表(随时间变化的维表) | 汇率/费率历史关联 |
| Lookup Join | 查询外部数据库维表 | MySQL/Redis 维度关联 |
| Lateral Join | 表函数展开 | 数组/JSON 展开 |
-- Interval Join
SELECT o.order_id, o.amount, p.pay_time
FROM orders o, payments p
WHERE o.order_id = p.order_id
  AND p.pay_time BETWEEN o.order_time AND o.order_time + INTERVAL '30' MINUTE;

-- Temporal Join(版本表)
SELECT o.order_id, o.amount, r.rate, o.amount * r.rate AS usd_amount
FROM orders o
JOIN rates FOR SYSTEM_TIME AS OF o.order_time AS r
  ON o.currency = r.currency;

-- Lookup Join(MySQL 维表)
CREATE TABLE dim_user (
  user_id BIGINT,
  user_name STRING,
  PRIMARY KEY (user_id) NOT ENFORCED
) WITH (
  'connector' = 'jdbc',
  'url' = 'jdbc:mysql://localhost:3306/dim',
  'table-name' = 'user',
  'username' = 'root',
  'password' = 'xxx'
);

SELECT o.order_id, u.user_name, o.amount
FROM orders o
LEFT JOIN dim_user FOR SYSTEM_TIME AS OF o.proc_time AS u
  ON o.user_id = u.user_id;
8.6 Top-N 与去重
-- Top-N(每组取前N)
SELECT * FROM (
  SELECT *,
    ROW_NUMBER() OVER (
      PARTITION BY window_start, window_end
      ORDER BY gmv DESC
    ) AS rn
  FROM window_gmv
) WHERE rn <= 10;

-- 去重(保留最新一条)
SELECT * FROM (
  SELECT *,
    ROW_NUMBER() OVER (
      PARTITION BY order_id
      ORDER BY update_time DESC
    ) AS rn
  FROM orders
) WHERE rn = 1;
8.7 CDC 入湖
-- MySQL CDC Source
CREATE TABLE mysql_orders (
  id BIGINT,
  item_id STRING,
  amount DECIMAL(10,2),
  updated_at TIMESTAMP(3),
  PRIMARY KEY (id) NOT ENFORCED
) WITH (
  'connector' = 'mysql-cdc',
  'hostname' = 'mysql',
  'port' = '3306',
  'username' = 'root',
  'password' = 'xxx',
  'database-name' = 'shop',
  'table-name' = 'orders',
  'server-time-zone' = 'Asia/Shanghai'
);

-- Paimon/Iceberg Sink(入湖)
CREATE TABLE lake_orders (
  id BIGINT,
  item_id STRING,
  amount DECIMAL(10,2),
  updated_at TIMESTAMP(3),
  PRIMARY KEY (id) NOT ENFORCED
) WITH (
  'connector' = 'paimon',
  'warehouse' = 'hdfs:///lake/paimon',
  'database' = 'ods',
  'table' = 'orders',
  'primary-key' = 'id'
);

INSERT INTO lake_orders SELECT * FROM mysql_orders;
8.8 Catalog
-- Hive Catalog(持久化元数据)
CREATE CATALOG my_hive WITH (
  'type' = 'hive',
  'hive-conf-dir' = '/etc/hive/conf'
);

USE CATALOG my_hive;
SHOW DATABASES;
USE my_db;
SHOW TABLES;
8.9 Flink SQL 性能调优
Flink SQL 作业在生产中常遇到数据倾斜、状态过大、维表 Join 慢等问题。以下是系统化的调优手段。
8.9.1 MiniBatch 聚合
MiniBatch 将一批数据缓存后再触发聚合,大幅减少 State 访问次数,显著提升吞吐。
SET 'table.exec.mini-batch.enabled' = 'true';
SET 'table.exec.mini-batch.allow-latency' = '5 s';   -- 最多等待5秒
SET 'table.exec.mini-batch.size' = '5000';            -- 最多缓存5000条
MiniBatch 会引入最多
allow-latency的延迟,需在吞吐和延迟间权衡。
8.9.2 Local-Global 聚合(两阶段预聚合)
Local-Global 在 MiniBatch 基础上自动实现 MapReduce 式两阶段聚合,解决数据倾斜:
原始数据(key分布不均)
    │
    ▼
┌─────────────────┐
│  Local Aggregate │  每个并行度局部预聚合(加局部缓冲)
│  (Map端Combiner) │  输出: (key+localSalt, partialSum)
└────────┬────────┘
         │ Shuffle by key
         ▼
┌─────────────────┐
│ Global Aggregate │  全局最终聚合
│  (Reduce端)      │  输出: (key, finalSum)
└─────────────────┘
SET 'table.exec.mini-batch.enabled' = 'true';
SET 'table.exec.mini-batch.allow-latency' = '5 s';
SET 'table.exec.mini-batch.size' = '5000';
SET 'table.optimizer.agg-phase-strategy' = 'TWO_PHASE';  -- 强制两阶段
-- AUTO: 自动选择; ONE_PHASE: 仅一阶段; TWO_PHASE: 强制两阶段
8.9.3 Split Distinct Aggregation
针对 COUNT(DISTINCT) 场景,将去重聚合拆分为两层,解决热点 key 倾斜:
-- 原始写法(热点 key 时单个 subtask 压力大)
SELECT item_id, COUNT(DISTINCT user_id) AS uv
FROM orders
GROUP BY item_id;

-- 开启 Split Distinct(自动改写为两阶段)
SET 'table.optimizer.distinct-agg.split.enabled' = 'true';
SET 'table.optimizer.distinct-agg.split.bucket-num' = '1024';
-- 第一层:按 item_id + (user_id % bucket) 分组去重
-- 第二层:按 item_id 聚合 SUM(distinct_count)
8.9.4 自动去重重写(Filtering Distinct Agg)
当聚合中同时包含 COUNT(*) 和 COUNT(DISTINCT) 且有相同过滤条件时,Flink 自动优化:
SET 'table.optimizer.filter-merge-acc.enabled' = 'true';
8.9.5 Top-N 缓存优化
-- 开启 Rank 重写优化,减少状态大小
SET 'table.optimizer.rank-rewrite.enabled' = 'true';
对 Top-N 查询,Flink 会优化状态访问策略:对排名靠后的数据不存入状态(因为几乎不会进入 Top-N),显著减少状态量。
8.9.6 维表 Join 优化
-- 异步 I/O Lookup Join(需 Connector 支持异步)
CREATE TABLE dim_user (
  user_id BIGINT,
  user_name STRING,
  PRIMARY KEY (user_id) NOT ENFORCED
) WITH (
  'connector' = 'jdbc',
  'url' = 'jdbc:mysql://localhost:3306/dim',
  'table-name' = 'user',
  'username' = 'root',
  'password' = 'xxx',
  'lookup.async' = 'true',                    -- 开启异步查询
  'lookup.cache' = 'PARTIAL',                 -- 启用缓存
  'lookup.partial-cache.max-rows' = '10000',  -- 最大缓存行数
  'lookup.partial-cache.expire-after-write' = '10 min',  -- 写入后过期
  'lookup.partial-cache.expire-after-access' = '5 min',  -- 访问后过期
  'lookup.max-retries' = '3'                  -- 查询失败重试次数
);

-- Lookup Join 自动使用异步+缓存
SELECT o.order_id, u.user_name, o.amount
FROM orders AS o
LEFT JOIN dim_user FOR SYSTEM_TIME AS OF o.proc_time AS u
  ON o.user_id = u.user_id;
8.9.7 聚合下发(Projection Pushdown / Partition Prune)
-- Source Connector 支持谓词下推和投影下推时,自动减少读取量
SET 'table.optimizer.source.predicate-pushdown-enabled' = 'true';
SET 'table.optimizer.source.aggregate-pushdown-enabled' = 'true';
8.9.8 SQL 作业关键配置参数表
| 参数 | 默认值 | 说明 |
|---|---|---|
table.local-time-zone | default | 本地时区,国内设为 Asia/Shanghai |
table.exec.state.ttl | 0(不过期) | 聚合/Join 状态保留时间,如 24 h |
table.exec.idle-state-retention | 0 | 空闲状态保留时间(防止空闲 key 状态泄漏) |
table.exec.mini-batch.enabled | false | 是否开启 MiniBatch |
table.exec.mini-batch.allow-latency | 0 | MiniBatch 延迟 |
table.exec.mini-batch.size | -1 | MiniBatch 最大条数 |
table.optimizer.agg-phase-strategy | AUTO | 聚合策略(AUTO/ONE_PHASE/TWO_PHASE) |
table.optimizer.distinct-agg.split.enabled | false | 拆分 COUNT(DISTINCT) |
table.exec.resource.default-parallelism | -1 | SQL 作业默认并行度 |
table.exec.sink.upsert-materialize | AUTO | Upsert Sink 是否物化(TABLE/SCAN/NONE/AUTO) |
pipeline.name | - | 作业名称 |
-- 生产环境推荐的基础配置
SET 'table.local-time-zone' = 'Asia/Shanghai';
SET 'table.exec.state.ttl' = '24 h';
SET 'table.exec.idle-state-retention' = '30 min';
SET 'table.exec.mini-batch.enabled' = 'true';
SET 'table.exec.mini-batch.allow-latency' = '5 s';
SET 'table.exec.mini-batch.size' = '5000';
SET 'table.optimizer.agg-phase-strategy' = 'TWO_PHASE';
8.10 常用 Connector 详解
Flink SQL 通过 Connector 与外部系统交互,以下是生产常用 Connector 对比。
8.10.1 Connector 特性对比
| Connector | Source | Sink | Exactly-Once | CDC | 流批一体 | 特点 |
|---|---|---|---|---|---|---|
| Kafka | ✅ | ✅ | ✅ (2PC) | ❌ | 流为主 | 高吞吐消息队列,流处理标配 |
| MySQL CDC | ✅ | ❌ | ✅ | ✅ | 流为主 | 基于 Binlog,全量+增量 |
| JDBC | ✅(Lookup) | ✅ | ⚠️ 幂等/XA | ❌ | 批为主 | 通用关系库,批量写入 |
| FileSystem | ✅ | ✅ | ✅ (原子提交) | ❌ | ✅ | 本地/HDFS/S3/OSS |
| Hive | ✅ | ✅ | ⚠️ | ❌ | ✅ | 数仓迁移,批为主 |
| Elasticsearch | ❌ | ✅ | ⚠️ 幂等 | ❌ | 流为主 | 全文检索,幂等 Upsert |
| Redis | ✅(Lookup) | ✅ | ❌ (At-Least-Once) | ❌ | 流为主 | 低延迟 KV 缓存/查询 |
| Doris | ✅ | ✅ | ✅ (Stream Load 2PC) | ✅ | 流+批 | MPP OLAP,实时导入 |
| StarRocks | ✅ | ✅ | ✅ (Stream Load 2PC) | ✅ | 流+批 | MPP OLAP,主键模型 |
| ClickHouse | ❌ | ✅ | ⚠️ 幂等 | ❌ | 批为主 | 列式 OLAP,分析性能强 |
| Paimon | ✅ | ✅ | ✅ | ✅ | ✅ | 流式数据湖,Flink 子项目 |
| Iceberg | ✅ | ✅ | ✅ | ⚠️ | ✅ | 数据湖格式,Schema 演进强 |
8.10.2 Flink CDC 入 Doris 完整示例
-- ODS: MySQL CDC Source
CREATE TABLE ods_orders (
  id BIGINT,
  order_no STRING,
  user_id BIGINT,
  item_id BIGINT,
  amount DECIMAL(10,2),
  order_status INT,
  create_time TIMESTAMP(3),
  update_time TIMESTAMP(3),
  PRIMARY KEY (id) NOT ENFORCED
) WITH (
  'connector' = 'mysql-cdc',
  'hostname' = 'mysql',
  'port' = '3306',
  'username' = 'root',
  'password' = 'xxx',
  'database-name' = 'shop',
  'table-name' = 'orders',
  'server-time-zone' = 'Asia/Shanghai'
);

-- DWS: Doris Sink(Stream Load 2PC 精确一次)
CREATE TABLE dws_order_summary (
  item_id BIGINT,
  dt DATE,
  gmv DECIMAL(18,2),
  order_cnt BIGINT,
  PRIMARY KEY (item_id, dt) NOT ENFORCED
) WITH (
  'connector' = 'doris',
  'fenodes' = 'doris-fe:8030',
  'table.identifier' = 'dws.order_summary',
  'username' = 'root',
  'password' = 'xxx',
  'sink.label-prefix' = 'flink-doris',
  'sink.enable-2pc' = 'true',        -- 开启两阶段提交
  'sink.properties.format' = 'json',
  'sink.properties.read_json_by_line' = 'true'
);

-- 实时聚合写入 Doris
INSERT INTO dws_order_summary
SELECT
  item_id,
  DATE(create_time) AS dt,
  SUM(amount) AS gmv,
  COUNT(*) AS order_cnt
FROM ods_orders
WHERE order_status = 1
GROUP BY item_id, DATE(create_time);
8.10.3 Flink 写 StarRocks
CREATE TABLE dws_user_stats (
  user_id BIGINT,
  dt DATE,
  total_amount DECIMAL(18,2),
  order_count BIGINT,
  PRIMARY KEY (user_id, dt) NOT ENFORCED
) WITH (
  'connector' = 'starrocks',
  'jdbc-url' = 'jdbc:mysql://starrocks-fe:9030',
  'load-url' = 'starrocks-fe:8030;starrocks-be:8040',
  'database-name' = 'dws',
  'table-name' = 'user_stats',
  'username' = 'root',
  'password' = 'xxx',
  'sink.version' = 'V2',             -- V2 使用 Stream Load
  'sink.properties.format' = 'json',
  'sink.properties.strip_outer_array' = 'true'
);
8.10.4 Flink 写 ClickHouse
-- 方式一:通过 JDBC Connector 写入
CREATE TABLE ck_sink (
  event_date Date,
  item_id String,
  pv UInt64,
  uv UInt64
) WITH (
  'connector' = 'jdbc',
  'url' = 'jdbc:clickhouse://clickhouse:8123/analytics',
  'table-name' = 'item_stats',
  'username' = 'default',
  'password' = 'xxx',
  'sink.buffer-flush.max-rows' = '10000',
  'sink.buffer-flush.interval' = '5s',
  'sink.max-retries' = '3'
);

-- 方式二:使用官方 ClickHouse Connector(支持 Sink)
CREATE TABLE ck_sink_v2 (
  event_date Date,
  item_id String,
  pv UInt64,
  uv UInt64
) WITH (
  'connector' = 'clickhouse',
  'url' = 'clickhouse:8123',
  'database-name' = 'analytics',
  'table-name' = 'item_stats',
  'username' = 'default',
  'password' = 'xxx',
  'sink.batch-size' = '10000',
  'sink.flush-interval' = '5s'
);
8.10.5 Flink 写 Redis
-- Redis Sink
CREATE TABLE redis_sink (
  item_id STRING,
  item_name STRING,
  category STRING,
  PRIMARY KEY (item_id) NOT ENFORCED
) WITH (
  'connector' = 'redis',
  'mode' = 'single',                -- single / cluster / sentinel
  'host' = 'redis',
  'port' = '6379',
  'password' = 'xxx',
  'command' = 'HMSET',              -- 写入命令: SET/HSET/ LPUSH 等
  'redis.value.data-type' = 'hash'  -- string / hash / list / set / zset
);

-- Redis Lookup Source(维表关联)
CREATE TABLE redis_dim (
  item_id STRING,
  item_name STRING,
  category STRING,
  PRIMARY KEY (item_id) NOT ENFORCED
) WITH (
  'connector' = 'redis',
  'mode' = 'single',
  'host' = 'redis',
  'port' = '6379',
  'command' = 'HGETALL',
  'lookup.cache.max-rows' = '5000',
  'lookup.cache.ttl' = '300s'
);
8.10.6 Flink 写 Elasticsearch
CREATE TABLE es_sink (
  order_id STRING,
  user_id BIGINT,
  item_name STRING,
  amount DECIMAL(10,2),
  order_time TIMESTAMP(3),
  PRIMARY KEY (order_id) NOT ENFORCED
) WITH (
  'connector' = 'elasticsearch-7',
  'hosts' = 'http://es-node1:9200;http://es-node2:9200',
  'index' = 'orders',
  'document-id.key-delimiter' = '_',
  'sink.bulk-flush.max-actions' = '1000',
  'sink.bulk-flush.max-size' = '5mb',
  'sink.bulk-flush.interval' = '2s',
  'sink.bulk-flush.backoff.strategy' = 'EXPONENTIAL',
  'sink.bulk-flush.backoff.max-retries' = '5',
  'connection.username' = 'elastic',
  'connection.password' = 'xxx'
);
8.10.7 Sink Exactly-Once 支持情况
| Sink | 一致性保证 | 机制 |
|---|---|---|
| Kafka | Exactly-Once | 事务(Kafka 0.11+),2PC 提交 |
| Doris | Exactly-Once | Stream Load 2PC,Checkpoint 时预提交,完成时正式提交 |
| StarRocks | Exactly-Once | Stream Load 事务标签(label),2PC 模式 |
| Paimon/Iceberg/Hudi | Exactly-Once | 数据湖原子提交(Snapshot 提交) |
| FileSystem | Exactly-Once | Pending 文件 → Finished 文件的原子重命名 |
| Elasticsearch | At-Least-Once | 幂等 Upsert(按文档 ID),失败重试不产生重复 |
| JDBC(MySQL) | At-Least-Once | 幂等 Upsert(INSERT ... ON DUPLICATE KEY UPDATE)或 XA 事务 |
| Redis | At-Least-Once | 无事务,需业务层保证幂等(如 SET 覆盖写) |
| ClickHouse | At-Least-Once | ReplacingMergeTree 去重或幂等批量写入 |
关键结论:端到端 Exactly-Once 需要 Source 支持重放、Flink 引擎 Checkpoint、Sink 支持 2PC 或幂等写入三者配合。
9. Flink CDC
9.1 什么是 CDC
CDC(Change Data Capture) 即变更数据捕获,实时捕获数据库的增删改操作,用于数据同步、缓存失效、实时数仓等。
| CDC 方案 | 原理 | 代表 |
|---|---|---|
| 基于查询 | 定时 SELECT,无法捕获删除,延迟高 | DataX 离线同步 |
| 基于日志 | 解析 Binlog/WAL,实时、可靠 | Debezium、Flink CDC、Canal |
9.2 Flink CDC 演进
| 版本 | 核心特性 |
|---|---|
| 1.x | 基于 Debezium,单并发,全量锁表 |
| 2.x | 无锁算法、并行读取、断点续传、整库同步 |
| 3.x | 架构升级(Pipeline 连接器)、Schema Evolution 支持、增量快照框架、整库同步到 Kafka/Paimon |
9.3 全量 + 增量同步
Flink CDC 2.x 的增量快照算法:
- 全量阶段:按主键分片(Chunk),并行读取,无锁(使用可重复读事务 + Binlog 位点位)
- 增量阶段:全量完成后,无缝切换到 Binlog 流式读取
- 断点续传:Chunk 粒度的 Checkpoint,失败可从上次位置恢复
全量阶段(并行)              增量阶段(单并发)
┌────┬────┬────┬────┐        Binlog Stream
│ C1 │ C2 │ C3 │ C4 │  ───▶  INSERT/UPDATE/DELETE
└────┴────┴────┴────┘        (实时流)
  无锁,并行读取,CK记录已完成Chunk
9.4 整库同步(Flink CDC 3.x)
# pipeline.yaml(Flink CDC 3.x)
source:
  type: mysql
  name: MySQL Source
  hostname: localhost
  port: 3306
  username: root
  password: xxx
  tables: shop\..*

sink:
  type: paimon
  name: Paimon Sink
  warehouse: hdfs:///lake/paimon

pipeline:
  name: Sync MySQL to Paimon
  parallelism: 4
# 提交整库同步任务
./bin/flink-cdc.sh pipeline.yaml
10. Flink CEP
10.1 CEP 概念
CEP(Complex Event Processing) 复杂事件处理,在事件流中检测满足特定模式的事件序列,广泛用于风控、监控、欺诈检测。
10.2 Pattern API
// 场景:10秒内同一用户连续两次大额交易(>10000)触发告警
Pattern<Order, ?> pattern = Pattern.<Order>begin("first")
    .where(new SimpleCondition<Order>() {
        @Override
        public boolean filter(Order order) {
            return order.getAmount() > 10000;
        }
    })
    .next("second")  // 严格紧邻(使用 followedBy 为非紧邻)
    .where(new SimpleCondition<Order>() {
        @Override
        public boolean filter(Order order) {
            return order.getAmount() > 10000;
        }
    })
    .within(Time.seconds(10)); // 10秒内

PatternStream<Order> patternStream = CEP.pattern(
    orders.keyBy(Order::getUserId), pattern);

patternStream.select(new PatternSelectFunction<Order, Alert>() {
    @Override
    public Alert select(Map<String, List<Order>> pattern) {
        Order first = pattern.get("first").get(0);
        Order second = pattern.get("second").get(0);
        return new Alert("可疑交易: 用户 " + first.getUserId()
            + " 在10秒内两次大额交易");
    }
}).addSink(new AlertSink());
10.3 Pattern 量词与循环
// times: 出现 N 次
pattern.times(3);                    // 恰好3次
pattern.timesOrMore(3);              // 3次或更多
pattern.times(2, 4);                 // 2-4次

// 连续性
pattern.begin("a").where(...)
    .next("b")        // 严格紧邻:a 和 b 之间不能有其他事件
    .followedBy("c")  // 宽松紧邻:a 和 b 之间可以有其他事件
    .followedByAny("d") // 更宽松,允许跳过已匹配事件
    .notNext("e")     // 不出现(严格)
    .notFollowedBy("f"); // 不出现(宽松)

// within: 时间约束
pattern.within(Time.minutes(5));
10.4 超时事件处理
PatternStream<Order> patternStream = CEP.pattern(keyedOrders, pattern);

OutputTag<String> timeoutTag = new OutputTag<String>("timeout"){};

SingleOutputStreamOperator<Alert> result = patternStream
    .flatSelect(
        timeoutTag,
        new PatternFlatTimeoutFunction<Order, String>() {
            @Override
            public void timeout(Map<String, List<Order>> pattern,
                                long timeoutTimestamp,
                                Collector<String> out) {
                Order first = pattern.get("first").get(0);
                out.collect("用户 " + first.getUserId() + " 交易模式超时未完成");
            }
        },
        new PatternFlatSelectFunction<Order, Alert>() {
            @Override
            public void flatSelect(Map<String, List<Order>> pattern,
                                   Collector<Alert> out) {
                // 正常匹配
            }
        }
    );

DataStream<String> timeoutAlerts = result.getSideOutput(timeoutTag);
11. Flink 性能调优
11.1 反压定位与处理
什么是反压: 下游处理速度跟不上上游,导致 Buffer 填满,逐级向上传播。
定位手段:
| 手段 | 方法 |
|---|---|
| Web UI | 查看每个算子的 BackPressured 和 Busy 指标,红色为反压 |
| Metrics | outPoolUsage、inPoolUsage、numRecordsInPerSecond |
| 线程栈 | jstack <TaskManager PID>,查看线程在做什么(GC?锁?慢方法?) |
| 火焰图 | jfr 或 async-profiler 生成火焰图定位热点方法 |
处理方法:
- 提高慢算子并行度
- 优化慢算子逻辑(数据库查询、外部 HTTP 调用异步化)
- 使用异步 I/O(
AsyncDataStream) - 增加网络 Buffer
- 数据倾斜处理
11.2 并行度设置
Source 并行度 = Kafka Partition 数(或其约数)
算子并行度 = 根据吞吐和单并行度处理能力调整
Sink 并行度 = 根据下游写入能力
经验公式: 并行度 = 总数据量 / (单并行度处理速率 × 时间窗口)
建议 Source 并行度与 Kafka Partition 数一致,避免消费不均。
11.3 Slot 配置
# flink-conf.yaml
taskmanager.numberOfTaskSlots: 4          # 每个 TM 的 Slot 数
taskmanager.memory.process.size: 4096m    # TM 总内存
taskmanager.memory.managed.fraction: 0.4  # Managed Memory 占比
taskmanager.memory.network.fraction: 0.15 # Network Memory 占比
Slot 数一般设为 CPU 核数;大状态场景可适当减少 Slot 数以增加每 Slot 内存。
11.4 Checkpoint 调优
ckConfig.setCheckpointInterval(60000);  // 不要太短,1-5分钟
ckConfig.setMinPauseBetweenCheckpoints(30000);
ckConfig.enableUnalignedCheckpoints();   // 反压场景开启
ckConfig.setAlignedCheckpointTimeout(Duration.ofSeconds(30));

// RocksDB 增量 Checkpoint
config.set(CheckpointingOptions.INCREMENTAL_CHECKPOINTS, true);
// RocksDB 压缩过滤清理 TTL
config.set(StateBackendOptions.ROCKSDB_COMPRESSION, "zstd");
11.5 数据倾斜处理
现象: 某些 SubTask 的数据量远大于其他,导致整体吞吐瓶颈。
方案一:加随机前缀两阶段聚合
// 第一阶段:加随机前缀,局部聚合
DataStream<Tuple2<String, Double>> withSalt = keyedStream
    .map(order -> {
        int salt = new Random().nextInt(10); // 0-9 随机前缀
        return Tuple2.of(salt + "_" + order.getItemId(), order.getAmount());
    })
    .keyBy(t -> t.f0)
    .window(TumblingEventTimeWindows.of(Time.seconds(10)))
    .reduce((a, b) -> Tuple2.of(a.f0, a.f1 + b.f1));

// 第二阶段:去掉前缀,全局聚合
DataStream<Tuple2<String, Double>> result = withSalt
    .map(t -> {
        String key = t.f0.substring(t.f0.indexOf("_") + 1);
        return Tuple2.of(key, t.f1);
    })
    .keyBy(t -> t.f0)
    .window(TumblingEventTimeWindows.of(Time.seconds(10)))
    .reduce((a, b) -> Tuple2.of(a.f0, a.f1 + b.f1));
方案二:Local-Global 聚合(Flink SQL 内置)
SET 'table.exec.mini-batch.enabled' = 'true';
SET 'table.exec.mini-batch.allow-latency' = '5s';
SET 'table.exec.mini-batch.size' = '5000';
SET 'table.optimizer.agg-phase-strategy' = 'TWO_PHASE';
-- 自动启用 Local-Global 两阶段聚合
方案三:MiniBatch
-- 开启 MiniBatch,减少 State 访问次数
SET 'table.exec.mini-batch.enabled' = 'true';
SET 'table.exec.mini-batch.allow-latency' = '1 s';
SET 'table.exec.mini-batch.size' = '5000';
11.6 JVM 调优
# flink-conf.yaml
env.java.opts.taskmanager: >
  -XX:+UseG1GC
  -XX:MaxGCPauseMillis=200
  -XX:InitiatingHeapOccupancyPercent=45
  -XX:+ParallelRefProcEnabled
  -XX:+UnlockExperimentalVMOptions
  -XX:G1NewSizePercent=10
  -XX:G1MaxNewSizePercent=20
大状态 + RocksDB 场景,关注堆外内存配置,避免 Direct Memory OOM。
11.7 反压深度原理
反压(Backpressure)是流处理系统中最常见的问题之一。当某个算子处理速度跟不上上游发送速度时,反压会沿数据流图向上传播,最终导致整条链路吞吐下降。
Credit-based 流控机制:
Flink 1.5+ 引入 Credit-based 流控,替代了原来的纯 TCP 反压,实现更精细的缓冲区管理:
上游 Task (ResultSubpartition)          下游 Task (InputChannel)
┌──────────────────────┐              ┌──────────────────────┐
│  Buffer Pool         │   1. 发送     │  Buffer Pool         │
│  ┌──┐┌──┐┌──┐       │  Credit(n)   │  ┌──┐┌──┐           │
│  │B1││B2││B3│  ─────┼─────────────▶│  │  ││  │ (有n个空闲  │
│  └──┘└──┘└──┘       │              │  └──┘└──┘  Buffer)   │
│  等待Credit...       │   2. 消费完  │                      │
│         ▲            │◀─────────────│  归还 Credit + 反馈   │
│         │            │   Credit(n)  │  可用Buffer数         │
│  有Credit才发送Buffer│              │                      │
└──────────────────────┘              └──────────────────────┘
核心流程:
- 下游 InputChannel 有空闲 Buffer 时,向上游发送 Credit(表示"我能接收 n 个 Buffer")
- 上游只有收到 Credit 后才发送数据 Buffer;Credit 用完则停止发送
- 下游消费完 Buffer 后归还 Buffer 到 BufferPool,并发送新的 Credit
- 如果下游处理慢,Credit 长期不归还,上游自然停止发送 → 反压逐级传播
反压传播链路:
Sink (慢,写DB瓶颈)
  │ Buffer满,不发Credit
  ▼
Map/Window (无法往下写,Buffer满)
  │ Buffer满,不发Credit
  ▼
KeyBy/Shuffle (无法往下写)
  │ Buffer满,不发Credit
  ▼
Source (无法往下写,消费Kafka变慢)
  │ Kafka Consumer.poll() 阻塞或暂停
  ▼
Kafka Lag 增长
反压从最下游瓶颈点开始,沿拓扑反向传播至 Source。
Web UI 定位反压:
在 Flink Web UI 的 Job 页面,点击任意算子顶点查看 BackPressure 标签:
| 状态 | 含义 | 阈值 |
|---|---|---|
| OK | 无反压,运行正常 | 反压时间 < 10% |
| LOW | 轻微反压 | 10% ~ 50% |
| HIGH | 严重反压 | > 50% |
Web UI 还展示每个 SubTask 的 backPressured / busy / idle 时间占比,快速定位瓶颈 SubTask。
Metrics 定位:
| Metric | 类型 | 说明 |
|---|---|---|
outputQueueLength | Gauge | 输出缓冲区队列长度,持续高说明下游反压 |
inputQueueLength | Gauge | 输入缓冲区队列长度 |
backPressuredTimeMsPerSecond | Meter | 每秒反压时间(ms),接近 1000 表示完全反压 |
busyTimeMsPerSecond | Meter | 每秒繁忙时间,接近 1000 表示算子满负荷 |
idleTimeMsPerSecond | Meter | 每秒空闲时间 |
credit (Flink 1.15+) | Gauge | 可用 Credit 数,为 0 表示被反压 |
availableMemorySegments | Gauge | 可用网络内存段数 |
numRecordsInPerSecond | Meter | 每秒输入记录数 |
numRecordsOutPerSecond | Meter | 每秒输出记录数 |
Flink 1.15+ Buffer Pool 反压指标:
Flink 1.15 重构了网络栈指标,新增基于 Buffer Pool 的细粒度监控:
outputBufferPoolUsage:输出缓冲池使用率inputBufferPoolUsage:输入缓冲池使用率floatingBuffersUsage/exclusiveBuffersUsage:浮动/独占 Buffer 使用情况
常见原因与解决:
| 原因 | 识别特征 | 解决方法 |
|---|---|---|
| 数据倾斜 | 个别 SubTask busy=100%,其他空闲 | Local-Global 聚合、加随机前缀两阶段聚合、Key 重分布 |
| GC 问题 | 周期性反压,GC 日志停顿时间长 | 调优 G1GC、增大堆内存、切换 RocksDB 减少堆内存 |
| 慢 Sink | Sink 算子 busy=100%,反压从 Sink 开始 | 批量写入、异步写入、增加 Sink 并行度、优化下游系统 |
| Checkpoint 对齐 | CK 期间出现周期性反压 | 开启 Unaligned Checkpoint、增大 CK 间隔 |
| 资源不足 | 所有 SubTask 都 busy=100% | 增加并行度、扩容 TaskManager |
| 外部系统慢 | 维表查询/HTTP 调用延迟高 | 异步 I/O + 缓存、连接池、降级 |
11.8 Watermark Alignment(1.16+)
在多源或多分区场景中,不同 Source/分区的 Watermark 推进速度可能差异巨大,导致算子需要缓存大量"等慢源"的状态,造成状态膨胀和内存压力。Watermark Alignment 通过对齐各源的 Watermark 来解决此问题。
问题场景:
Source A (快): WM = 10:30:00  ──────────────────────▶
                                              Union/Join
Source B (慢): WM = 10:00:00  ──────────────────────▶

结果:全局 WM = min(10:30, 10:00) = 10:00
问题:A 已到达 10:30 的数据需要在状态中缓存30分钟等待B
      → 状态膨胀、Checkpoint 增大、内存压力
对齐原理:
Watermark Alignment 会暂停消费"过快"的 Source/分区,等待慢 Source 追上来,使各源的 Watermark 偏差控制在阈值内:
Source A: WM=10:05  暂停读取(等待B)     ▶ 等待...
Source B: WM=10:00  正常读取追赶        ▶ WM=10:04 → 10:05
                                      对齐!
Source A: 恢复读取  ──────────────────▶ WM=10:06
Source B: 正常读取  ──────────────────▶ WM=10:06
DataStream API 配置:
WatermarkStrategy<Order> strategy = WatermarkStrategy
    .<Order>forBoundedOutOfOrderness(Duration.ofSeconds(5))
    .withTimestampAssigner((order, ts) -> order.getEventTime())
    .withWatermarkAlignment(
        "alignment-group-1",            // 对齐组名(同组内对齐)
        Duration.ofSeconds(20),          // maxAllowedWatermarkDrift: 最大允许偏差
        Duration.ofSeconds(5)            // updateInterval: 检查间隔(默认1s)
    );

DataStream<Order> stream = env.fromSource(kafkaSource, strategy, "Kafka Source");
参数说明:
| 参数 | 说明 | 建议 |
|---|---|---|
maxAllowedWatermarkDrift | 各源/分区之间 Watermark 的最大允许偏差 | 根据业务延迟容忍度,通常 10~60s |
updateInterval | 对齐检查和调整的频率 | 默认 1s,通常无需修改 |
不同 Source 配置相同的 alignment group 名称即可跨源对齐;同一 Kafka Source 的不同分区也会自动对齐。
SQL 中的配置:
-- 表级别配置 Watermark Alignment
CREATE TABLE orders (
  order_id BIGINT,
  order_time TIMESTAMP(3),
  WATERMARK FOR order_time AS order_time - INTERVAL '5' SECOND
) WITH (
  'connector' = 'kafka',
  'topic' = 'orders',
  'properties.bootstrap.servers' = 'kafka:9092',
  'format' = 'json',
  'scan.watermark.alignment.group' = 'alignment-group-1',
  'scan.watermark.alignment.max-drift' = '20 s',
  'scan.watermark.alignment.update-interval' = '5 s'
);

-- 全局默认配置(flink-conf.yaml)
# table.exec.source.watermark-alignment.group: default-group
# table.exec.source.watermark-alignment.max-drift: 20 s
适用场景与注意事项:
- ✅ 多源 Join / Union 时各源延迟差异大
- ✅ Kafka 分区数据倾斜(部分分区数据量远大于其他)
- ✅ 状态膨胀严重且与 Watermark 不同步直接相关
- ⚠️ 会降低快源的吞吐量(暂停消费),需权衡
- ⚠️ 不适合各源本身延迟差异就应该存在的场景(如事实流 + 慢维表流)
11.9 Metrics 与监控
完善的监控是生产 Flink 作业稳定运行的保障。Flink 提供了丰富的 Metrics 体系,可对接 Prometheus + Grafana 实现可视化和告警。
Metric 类型:
| 类型 | 说明 | 示例 |
|---|---|---|
| Counter | 计数器,单调递增/递减 | numRecordsIn、numRecordsOut |
| Gauge | 瞬时值,任意时刻的数值 | outputQueueLength、currentInputWatermark |
| Histogram | 分布统计(均值/分位数/最大值) | 记录处理延迟分布 |
| Meter | 速率统计(每秒平均值) | numRecordsInPerSecond、numRecordsOutPerSecond |
关键 Metrics 列表:
| 分类 | Metric | 说明 |
|---|---|---|
| 吞吐 | numRecordsInPerSecond | 每秒输入记录数 |
numRecordsOutPerSecond | 每秒输出记录数 | |
numBytesInPerSecond | 每秒输入字节数(Kafka Source) | |
| 反压 | backPressuredTimeMsPerSecond | 每秒反压时间(ms) |
busyTimeMsPerSecond | 每秒繁忙时间 | |
outputQueueLength | 输出队列长度 | |
| Checkpoint | lastCheckpointDuration | 最近一次 CK 耗时(ms) |
lastCheckpointSize | 最近一次 CK 大小(字节) | |
numberOfCompletedCheckpoints | 已完成 CK 数 | |
numberOfFailedCheckpoints | 失败 CK 数 | |
lastCheckpointRestoreTimestamp | 最近恢复时间 | |
| 状态 | stateSize (RocksDB) | 状态大小 |
rocksdb.block-cache-usage | RocksDB 块缓存使用量 | |
rocksdb.mem-table-flush-pending | 待刷新 MemTable 数 | |
| 资源 | Status.JVM.Memory.Heap.Used | 堆内存使用量 |
Status.JVM.Memory.NonHeap.Used | 非堆内存使用量 | |
Status.JVM.GarbageCollector.*.Time | GC 时间 | |
outOfMemoryError | OOM 计数器 | |
| Kafka 消费 | consumer-lag | Kafka 消费积压(消息数) |
consumer-records-lag-max | 最大消费延迟 | |
| Watermark | currentInputWatermark | 当前输入 Watermark |
currentOutputWatermark | 当前输出 Watermark |
Prometheus + Grafana 集成:
# flink-conf.yaml - Prometheus Reporter 配置
metrics.reporter.prom.factory.class: org.apache.flink.metrics.prometheus.PrometheusReporterFactory
metrics.reporter.prom.port: 9999
metrics.reporter.prom.filterLabelValueCharacters: true

# 或使用 Prometheus PushGateway(主动推送)
metrics.reporter.promgateway.factory.class: org.apache.flink.metrics.prometheus.PrometheusPushGatewayReporterFactory
metrics.reporter.promgateway.host: pushgateway
metrics.reporter.promgateway.port: 9091
metrics.reporter.promgateway.jobName: flink-job
metrics.reporter.promgateway.interval: 15 SECONDS
# prometheus.yml - Prometheus 抓取配置
scrape_configs:
  - job_name: 'flink-taskmanager'
    kubernetes_sd_configs:
      - role: pod
    relabel_configs:
      - source_labels: [__meta_kubernetes_pod_label_app]
        regex: flink-taskmanager
        action: keep
      - source_labels: [__address__]
        regex: '([^:]+):(\d+)'
        target_label: __address__
        replacement: '${1}:9999'

  - job_name: 'flink-jobmanager'
    static_configs:
      - targets: ['flink-jobmanager:9999']
推荐监控大盘面板(Grafana):
| 面板 | 指标 | 展示方式 |
|---|---|---|
| 作业概览 | 作业状态、运行时长、并行度 | 状态卡片 |
| 吞吐量 | numRecordsInPerSecond / numRecordsOutPerSecond | 折线图 |
| 反压 | backPressuredTimeMsPerSecond / busyTimeMsPerSecond | 热力图/折线图 |
| Checkpoint | CK 时长、CK 大小、成功/失败次数 | 柱状图+状态 |
| 状态大小 | stateSize / RocksDB 指标 | 折线图 |
| 内存 | Heap/NonHeap/Managed/Direct 使用率 | 面积图 |
| GC | GC 时间/次数 | 折线图 |
| Kafka Lag | consumer-lag | 折线图 |
| Watermark 延迟 | System.time() - currentInputWatermark | 折线图 |
| 容器资源 | CPU/内存使用率(K8s 指标) | 面积图 |
告警规则建议:
# Prometheus AlertManager 规则示例
groups:
  - name: flink-alerts
    rules:
      # Checkpoint 连续失败
      - alert: FlinkCheckpointFailure
        expr: increase(flink_jobmanager_job_numberOfFailedCheckpoints[5m]) > 3
        for: 2m
        labels:
          severity: critical
        annotations:
          summary: "Flink作业 {{ $labels.job_name }} Checkpoint连续失败"

      # 反压严重
      - alert: FlinkBackpressureHigh
        expr: flink_taskmanager_job_task_backPressuredTimeMsPerSecond > 800
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "Flink任务 {{ $labels.task_name }} 反压严重"

      # Kafka 消费积压
      - alert: FlinkKafkaLagHigh
        expr: flink_taskmanager_job_task_operator_kafka_consumer_lag > 100000
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "Kafka消费积压超过10万条"

      # GC 时间过长
      - alert: FlinkGCHigh
        expr: rate(jvm_gc_collection_seconds_sum[5m]) > 0.3
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "TaskManager GC时间占比超过30%"

      # 容器内存使用率高
      - alert: FlinkContainerMemoryHigh
        expr: container_memory_working_set_bytes / container_spec_memory_limit_bytes > 0.85
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "TaskManager内存使用率超过85%"

      # 作业失败
      - alert: FlinkJobFailed
        expr: flink_jobmanager_job_status == 0
        for: 1m
        labels:
          severity: critical
        annotations:
          summary: "Flink作业 {{ $labels.job_name }} 已失败"
Flink Web UI 监控要点:
- Overview 页:查看作业状态、并行度、运行时长
- Vertices 页:每个算子的
Records Received/Sent、Bytes Received/Sent、BackPressured、Busy - BackPressure 页:查看每个 SubTask 的反压状态(OK/LOW/HIGH)
- Checkpoints 页:CK 历史、时长、大小、对齐时间;检查 Savepoint 路径
- Task Managers 页:每个 TM 的 Slot 使用、内存、GC 情况
- Metrics 页:可直接在 Web UI 添加自定义 Metric 图表,无需 Grafana 也能快速排查
12. Flink 常见问题与踩坑
12.1 Watermark 不推进
原因:
- 某个 Source 分区/SubTask 长时间无数据(空闲源)
- 多输入取最小值,一个慢输入拖慢全局
解决:
WatermarkStrategy.<Order>forBoundedOutOfOrderness(Duration.ofSeconds(5))
    .withIdleness(Duration.ofMinutes(1)); // 检测空闲源
12.2 Checkpoint 超时/失败
排查方向:
- 反压导致 Barrier 对齐慢 → 开启 Unaligned Checkpoint
- 状态太大,快照时间长 → 增量 Checkpoint、RocksDB、调大超时
- 存储(HDFS/S3)写入慢 → 检查存储性能
- 数据倾斜导致个别 Task 状态过大 → 解决倾斜
12.3 状态过大 OOM
- 使用 RocksDB 替代 HashMap 后端
- 配置状态 TTL,自动清理
- 减少 Keyed State 中的字段
- Regular Join 设置状态 TTL(Flink SQL)
SET 'table.exec.state.ttl' = '24 h';
12.4 Kafka 消费积压
- 提高 Source 并行度(不超过 Partition 数)
- 增加 Partition 数
- 优化下游处理逻辑
- 检查是否有数据倾斜
- 临时扩容 TaskManager
12.5 时区问题
-- Flink SQL 中统一使用 UTC 还是北京时间?
-- 建议在 Source 中指定时区
CREATE TABLE kafka_source (
  ts TIMESTAMP(3)
) WITH (
  'connector' = 'kafka',
  ...
  'properties.server-time-zone' = 'Asia/Shanghai'  -- MySQL CDC
);

-- 时间转换
SELECT
  TO_TIMESTAMP_LTZ(UNIX_TIMESTAMP(ts) * 1000, 3) AS bj_time
FROM source;
12.6 序列化问题
Flink 优先使用 POJO 序列化(高效、支持 Schema 演进),否则回退到 Kryo(慢、不支持状态迁移)。
POJO 规则:
- Public 类
- 无参构造函数
- 所有字段 Public 或有 getter/setter
- 字段类型均受 Flink 支持
// ✅ 正确的 POJO
public class Order {
    public long id;
    public String itemId;
    public double amount;
    public long eventTime;

    public Order() {} // 必须有无参构造

    // getters/setters...
}

// ❌ 避免使用匿名类、Lambda 中的复杂捕获
12.7 并行度变化状态不兼容
- 使用
uid()为算子显式指定 UID,确保 Savepoint 恢复时能匹配
stream.keyBy(...).window(...).reduce(...).uid("window-reducer");
- 改变并行度时,RocksDB 后端支持 Rescale(自动重新分配 KeyGroup)
- HashMap 后端在 1.18+ 也支持 Rescale
13. Flink 1.18-1.20 新特性与 2.0 展望
13.1 Flink 1.18 新特性
| 特性 | 说明 |
|---|---|
| Flink CDC 3.0 | Pipeline 架构、Schema Evolution、整库同步 |
| Lakehouse 集成 | Paimon/Iceberg/Hudi 原生支持增强 |
| Runtime | 非对齐检查点改进,Watermark 优化 |
| SQL | Window TVF 增强,Top-N 优化 |
| Python API | PyFlink 性能提升,更多 SQL 功能 |
13.2 Flink 1.19 新特性
| 特性 | 说明 |
|---|---|
| 自适应查询执行(AQE) | 运行时根据数据量动态调整 Join 策略、聚合策略 |
| 动态表配置 | 运行时动态修改参数,无需重启 |
| RocksDB 优化 | 内存管理改进,Checkpoint 更快 |
| SQL 增强 | 更多函数、NOT NULL 约束、Materialized Table |
| Kubernetes Operator | 自动扩缩容、滚动更新改进 |
13.3 Flink 1.20 新特性
| 特性 | 说明 |
|---|---|
| Disaggregated State Management 预览 | 状态与计算分离,状态存远端存储(ForSt DB) |
| 流式数仓增强 | Paimon 深度集成,增量物化视图 |
| Python API 增强 | PyFlink 与 SQL 功能对齐 |
| 性能优化 | 向量化计算、JVM 优化 |
13.4 Flink 2.0 方向
┌─────────────────────────────────────────────────┐
│                 Flink 2.0 愿景                   │
├─────────────────────────────────────────────────┤
│  1. Flink SQL 成为一等公民                       │
│     - Streaming Lakehouse 统一 API               │
│     - 批流一体在 SQL 层完全融合                   │
│                                                 │
│  2. Disaggregated State Management              │
│     - 计算与状态分离,状态存分布式存储             │
│     - 秒级扩缩容,不再依赖本地磁盘                │
│                                                 │
│  3. 动态扩缩容(Autoscaling)                    │
│     - 根据负载自动调整并行度                      │
│     - K8s Operator 原生支持                      │
│                                                 │
│  4. 流式数仓(Streaming Lakehouse)              │
│     - Flink + Paimon 构建实时湖仓               │
│     - 增量物化视图、CDC 入湖一体                 │
│                                                 │
│  5. 性能与稳定性                                 │
│     - 向量化执行引擎                             │
│     - 更好的资源利用率                           │
└─────────────────────────────────────────────────┘
13.5 Lakehouse 集成
Flink 与三大数据湖格式的集成:
| 格式 | Flink 集成 | 特点 |
|---|---|---|
| Paimon | 原生深度集成(Flink 子项目) | 流批一体、主键表、CDC 入湖、LSM 架构 |
| Iceberg | Flink Connector 完善 | Schema 演进强、ACID、适合批为主 |
| Hudi | Flink Connector 支持 | 增量视图、主键更新成熟、MoR 表 |
13.6 Flink + Paimon 深度集成
Apache Paimon(原 Flink Table Store)是 Flink 官方子项目,定位为流式数据湖存储,将湖存储的流批一体能力发挥到极致。
Paimon 核心定位:
┌──────────────────────────────────────────────────┐
│                  Paimon 定位                      │
├──────────────────────────────────────────────────┤
│  流式数据湖存储(Streaming Lakehouse)            │
│  - 主键表实时 Upsert(LSM 架构,毫秒级可见)       │
│  - 原生 Changelog 产出(支持 CDC 入湖/出湖)      │
│  - 流批一体读写(流式写入 + 批量查询)             │
│  - Lookup Join 高性能点查(主键索引)              │
│  - 与 Flink SQL 深度集成                          │
└──────────────────────────────────────────────────┘
核心概念:
| 概念 | 说明 |
|---|---|
| Primary Key Table | 主键表,支持 Upsert/Delete,底层 LSM Tree,支持 Changelog 产出 |
| Append Table | 追加表,仅支持追加写入,适合日志/事件类数据,无主键 |
| Bucket | 数据分桶,主键表按 Bucket 分布(类似分区+哈希),每个 Bucket 是一个 LSM 引擎 |
| Changelog Producer | Changelog 生成方式:none(仅写入)、input(依赖输入 Changelog)、lookup(Lookup 补全)、full-compaction(全量压缩产出) |
| Snapshot | 快照,每次提交生成一个 Snapshot,支持 Time Travel 和增量读取 |
| Compaction | LSM 压缩,合并 Sorted Run,产生 Changelog,支持异步/Full Compaction |
Flink SQL 建表/写入/查询示例:
-- 创建 Catalog
CREATE CATALOG paimon_catalog WITH (
  'type' = 'paimon',
  'warehouse' = 'hdfs:///lake/paimon'
);
USE CATALOG paimon_catalog;

-- 创建数据库
CREATE DATABASE IF NOT EXISTS ods;

-- 1. 创建主键表(支持 CDC Upsert)
CREATE TABLE IF NOT EXISTS ods.orders (
  id BIGINT,
  order_no STRING,
  user_id BIGINT,
  item_id BIGINT,
  amount DECIMAL(10,2),
  order_status INT,
  create_time TIMESTAMP(3),
  update_time TIMESTAMP(3),
  dt STRING,
  PRIMARY KEY (id, dt) NOT ENFORCED
) PARTITIONED BY (dt) WITH (
  'bucket' = '4',
  'changelog-producer' = 'lookup',   -- 产出完整 Changelog
  'snapshot.time-retained' = '24 h',
  'compaction.min.file-num' = '5',
  'compaction.max.file-num' = '50'
);

-- 2. 从 Kafka 流式写入(CDC Changelog 自动传播)
INSERT INTO ods.orders
SELECT id, order_no, user_id, item_id, amount, order_status,
       create_time, update_time, DATE_FORMAT(create_time, 'yyyy-MM-dd') AS dt
FROM kafka_orders;

-- 3. 从 MySQL CDC 整库同步写入
INSERT INTO paimon_catalog.ods.orders
SELECT * FROM mysql_cdc_orders;

-- 4. 流式读取(消费 Changelog)
SELECT * FROM paimon_catalog.ods.orders /*+ OPTIONS('scan.mode'='latest') */;

-- 5. 批量查询(Time Travel)
SELECT * FROM paimon_catalog.ods.orders
/*+ OPTIONS('scan.snapshot-id'='10') */;

SELECT * FROM paimon_catalog.ods.orders
FOR SYSTEM_TIME AS OF TIMESTAMP '2024-01-15 10:00:00';

-- 6. 聚合写入(批流一体)
CREATE TABLE dws.item_gmv (
  item_id BIGINT,
  dt STRING,
  gmv DECIMAL(18,2),
  order_cnt BIGINT,
  PRIMARY KEY (item_id, dt) NOT ENFORCED
) PARTITIONED BY (dt) WITH (
  'bucket' = '2',
  'changelog-producer' = 'full-compaction',
  'full-compaction.delta-commits' = '10'
);

INSERT INTO dws.item_gmv
SELECT item_id, dt, SUM(amount) AS gmv, COUNT(*) AS order_cnt
FROM ods.orders
WHERE order_status = 1
GROUP BY item_id, dt;

-- 7. Lookup Join(Paimon 高性能点查)
SELECT o.order_id, i.item_name, o.amount
FROM kafka_orders AS o
LEFT JOIN paimon_catalog.dim.item FOR SYSTEM_TIME AS OF o.proc_time AS i
  ON o.item_id = i.id;
Paimon vs Iceberg vs Hudi 对比:
| 维度 | Paimon | Iceberg | Hudi |
|---|---|---|---|
| 定位 | 流式数据湖 | 通用表格式 | 流式数据湖 |
| 主键更新 | ✅ LSM 原生,毫秒级 | ⚠️ 需 Merge-on-Read,延迟较高 | ✅ MoR/CoW 支持 |
| Changelog 产出 | ✅ 原生支持(lookup/full-compaction) | ❌ 不支持 | ⚠️ 部分支持(增量视图) |
| Lookup Join | ✅ 高性能主键索引 | ❌ 不支持 | ⚠️ 有限支持 |
| CDC 入湖 | ✅ 原生 CDC Pipeline | ⚠️ 需额外处理 | ✅ 支持 Delta Streamer |
| 流批一体 | ✅ 深度优化 | ⚠️ 批为主,流支持弱 | ⚠️ 流支持较好 |
| Schema 演进 | ✅ | ✅ 最强 | ✅ |
| Flink 集成 | ✅ 官方子项目,最深 | ✅ Connector 完善 | ✅ Connector 支持 |
| 引擎支持 | Flink(最强)、Spark/Trino | Spark/Flink/Trino/Hive 全面 | Spark/Flink/Hive/Trino |
| 写入吞吐 | 高(LSM 批量写) | 高(CoW)/中(MoR) | 中(索引开销) |
典型架构:Kafka → Flink → Paimon → StarRocks/Doris
┌──────────┐     ┌──────────┐     ┌──────────────┐     ┌──────────────┐
│  MySQL   │     │  Kafka   │     │    Paimon    │     │  StarRocks/  │
│  业务库   │────▶│  日志/  │────▶│  (湖存储)    │────▶│  Doris       │
│  (CDC)   │     │  埋点    │     │ ODS/DWD/DWS  │     │  (OLAP查询)   │
└──────────┘     └──────────┘     └──────┬───────┘     └──────────────┘
      │                     ▲            │                    ▲
      │                     │            │ 批读/流读           │
      └─────────────────────┘            ▼                    │
   Flink CDC整库同步           ┌──────────────────┐           │
                              │  Flink SQL       │───────────┘
                              │  ETL/聚合/Join   │  实时导入
                              └──────────────────┘
- ODS 层:Flink CDC → Paimon 主键表,保留原始 Changelog
- DWD 层:Flink SQL ETL 清洗、维表 Lookup Join → Paimon
- DWS 层:Flink SQL 聚合 → Paimon 主键表
- ADS 层:Paimon → StarRocks/Doris(批量/实时导入),或直接查询 Paimon
Compaction 与 Expire Snapshot 配置:
-- 建表时配置 Compaction
CREATE TABLE dws.orders (
  ...
) WITH (
  -- 异步 Compaction(写入时自动触发)
  'compaction.min.file-num' = '5',
  'compaction.max.file-num' = '50',
  'compaction.target-file-size' = '128mb',

  -- Full Compaction(定期全量压缩,产出完整 Changelog)
  'changelog-producer' = 'full-compaction',
  'full-compaction.delta-commits' = '10',  -- 每10次提交触发一次

  -- Snapshot 过期(控制存储大小)
  'snapshot.time-retained' = '24 h',       -- 保留最近24小时快照
  'snapshot.num-retained.max' = '100',     -- 最多保留100个快照

  -- 分区过期(自动删除旧分区)
  'partition.expiration-time' = '7 d',
  'partition.expiration-check-interval' = '1 h',
  'partition.timestamp-formatter' = 'yyyy-MM-dd',
  'partition.timestamp-pattern' = '$dt'
);

-- 手动触发 Compaction
CALL sys.compact('paimon_catalog.dws.orders');

-- 手动触发 Full Compaction
CALL sys.compact('paimon_catalog.dws.orders', 'pt=2024-01-15');

-- 手动过期 Snapshot
CALL sys.expire_snapshots('paimon_catalog.dws.orders', '2024-01-14 00:00:00');

-- 删除分区
ALTER TABLE dws.orders DROP PARTITION (dt = '2024-01-01');
14. Flink 在实时数仓中的典型架构
14.1 经典分层架构
┌─────────────────────────────────────────────────────────────┐
│                        数据源                                │
│   MySQL/PostgreSQL  │  Kafka  │  日志  │  API  │  IoT       │
└──────────┬──────────────────────────────────────────────────┘
           │ CDC / Flume / Logstash
           ▼
┌──────────────────────────────────────────────────────────────┐
│  ODS 层(原始数据层)  ── Kafka / Paimon                      │
│  保留原始数据,不做修改                                        │
└──────────┬───────────────────────────────────────────────────┘
           │ Flink ETL(清洗、脱敏、维度关联)
           ▼
┌──────────────────────────────────────────────────────────────┐
│  DWD 层(明细数据层)  ── Kafka / Paimon                      │
│  标准化明细事实数据,统一维度                                   │
└──────────┬───────────────────────────────────────────────────┘
           │ Flink 聚合
           ▼
┌──────────────────────────────────────────────────────────────┐
│  DWS 层(汇总数据层)  ── Paimon / Doris                      │
│  轻度聚合(按天/小时/分钟),公共汇总                           │
└──────────┬───────────────────────────────────────────────────┘
           │ 导入/查询
           ▼
┌──────────────────────────────────────────────────────────────┐
│  ADS 层(应用数据层)  ── Doris / StarRocks / ClickHouse      │
│  面向业务的指标、报表、推荐特征                                 │
└──────────┬───────────────────────────────────────────────────┘
           │
           ▼
┌──────────────────────────────────────────────────────────────┐
│  应用层:BI 报表 / 实时大屏 / 风控 / 推荐 / 告警               │
└──────────────────────────────────────────────────────────────┘
14.2 Lambda vs Kappa
| 维度 | Lambda 架构 | Kappa 架构 |
|---|---|---|
| 核心思想 | 批处理层(全量)+ 速度层(实时)+ 服务层 | 一切皆流,用流处理统一批和实时 |
| 技术栈 | Hadoop/Spark(批)+ Storm/Flink(流) | Flink(流批一体) |
| 代码维护 | 两套代码(批+流),需保持逻辑一致 | 一套代码 |
| 数据一致性 | 批和流结果可能不一致 | 天然一致 |
| 历史数据重算 | 批处理层重跑 | 消费 Kafka 历史数据重跑 |
| 适用场景 | 早期大数据平台 | Flink 时代的推荐架构 |
14.3 流批一体实践
-- 同一 SQL,既可流执行也可批执行
SET 'execution.runtime-mode' = 'streaming';  -- 流式
-- SET 'execution.runtime-mode' = 'batch';   -- 批式

INSERT INTO dws_order_summary
SELECT
  item_id,
  DATE(order_time) AS dt,
  SUM(amount) AS gmv,
  COUNT(*) AS cnt
FROM dwd_orders
GROUP BY item_id, DATE(order_time);
- Paimon 作为流批一体存储层:流写批读、批写流读
- Flink SQL 统一计算层:同一 SQL 切换运行模式
- 历史数据回刷用批模式,实时增量用流模式
14.4 端到端实时数仓实战项目
项目背景
以电商实时数仓为场景,构建从业务库 CDC 到实时大屏的端到端数据管道,覆盖订单、用户、商品三大核心域,实现秒级延迟的实时指标。
数据源
| 数据源 | 类型 | 表/Topic | 说明 |
|---|---|---|---|
| MySQL | 业务库 CDC | orders / order_detail / user / item / category | 订单/用户/商品,Binlog 实时采集 |
| Kafka | 日志/埋点 | page_view / click_event / cart_event | 用户行为日志,JSON 格式 |
| Kafka | 业务事件 | pay_success / refund | 支付成功/退款事件 |
技术栈
Flink CDC 3.x + Kafka 3.x + Flink 1.18 SQL + Paimon 0.8 + Doris 2.0 + Redis
分层架构
┌─────────────────────────────────────────────────────────────────────┐
│                           数据源层                                   │
│   MySQL(订单/用户/商品)          Kafka(埋点/支付/退款日志)           │
└───────────┬──────────────────────────────┬──────────────────────────┘
            │ Flink CDC                    │ Flink Kafka Source
            ▼                              ▼
┌─────────────────────────────────────────────────────────────────────┐
│  ODS 层(贴源层)  ── Paimon 主键表 / Kafka Topic                    │
│  ods_orders / ods_order_detail / ods_user / ods_item                │
│  ods_page_view / ods_pay_success / ods_refund                       │
│  保留原始 CDC Changelog(+I/-U/+U/-D)                               │
└───────────┬─────────────────────────────────────────────────────────┘
            │ Flink SQL ETL(清洗/脱敏/维度关联/时间统一)
            ▼
┌─────────────────────────────────────────────────────────────────────┐
│  DWD 层(明细层)  ── Paimon 主键表 / Kafka Topic                    │
│  dwd_order_detail(订单宽表,关联用户/商品维度)                      │
│  dwd_page_view(标准化行为日志)                                      │
│  dwd_pay_success(支付明细,Interval Join 订单关联)                  │
│  dwd_refund(退款明细)                                              │
└───────────┬─────────────────────────────────────────────────────────┘
            │ Flink SQL 实时聚合(TUMBLE/HOP/CUMULATE 窗口)
            ▼
┌─────────────────────────────────────────────────────────────────────┐
│  DWS 层(汇总层)  ── Paimon / Doris                                 │
│  dws_item_gmv_min(商品分钟级GMV)                                    │
│  dws_user_order_hour(用户小时级订单汇总)                            │
│  dws_category_gmv_day(品类天级GMV)                                  │
│  dws_trade_overview(交易总览:GMV/订单量/客单价/UV)                  │
└───────────┬─────────────────────────────────────────────────────────┘
            │ 实时写入 / 批量导入
            ▼
┌─────────────────────────────────────────────────────────────────────┐
│  ADS 层(应用层)  ── Doris / Redis                                  │
│  ads_realtime_dashboard(大屏查询:实时GMV/TopN/趋势)                │
│  ads_user_profile(用户画像标签 → Redis)                             │
│  ads_item_recommend(商品推荐特征 → Redis)                           │
└───────────┬─────────────────────────────────────────────────────────┘
            │
            ▼
┌─────────────────────────────────────────────────────────────────────┐
│  应用:实时大屏 / BI报表 / 风控告警 / 推荐系统                        │
└─────────────────────────────────────────────────────────────────────┘
核心代码
1. ODS:Flink CDC 整库同步 MySQL → Kafka(Paimon)
-- ODS: MySQL CDC Source(订单表)
CREATE TABLE ods_orders_source (
  id BIGINT,
  order_no STRING,
  user_id BIGINT,
  item_id BIGINT,
  category_id BIGINT,
  amount DECIMAL(10,2),
  order_status INT,
  create_time TIMESTAMP(3),
  update_time TIMESTAMP(3),
  PRIMARY KEY (id) NOT ENFORCED
) WITH (
  'connector' = 'mysql-cdc',
  'hostname' = 'mysql',
  'port' = '3306',
  'username' = 'root',
  'password' = 'xxx',
  'database-name' = 'shop',
  'table-name' = 'orders',
  'server-time-zone' = 'Asia/Shanghai',
  'scan.incremental.snapshot.enabled' = 'true',
  'scan.incremental.snapshot.chunk.size' = '8096'
);

-- ODS: Paimon Sink
CREATE TABLE ods_orders (
  id BIGINT,
  order_no STRING,
  user_id BIGINT,
  item_id BIGINT,
  category_id BIGINT,
  amount DECIMAL(10,2),
  order_status INT,
  create_time TIMESTAMP(3),
  update_time TIMESTAMP(3),
  dt STRING,
  PRIMARY KEY (id, dt) NOT ENFORCED
) PARTITIONED BY (dt) WITH (
  'connector' = 'paimon',
  'warehouse' = 'hdfs:///lake/paimon',
  'database' = 'ods',
  'table' = 'orders',
  'bucket' = '4',
  'changelog-producer' = 'input',
  'snapshot.time-retained' = '24 h'
);

-- 整库同步(CDC Changelog 直接传播到 Paimon)
INSERT INTO ods_orders
SELECT id, order_no, user_id, item_id, category_id, amount,
       order_status, create_time, update_time,
       DATE_FORMAT(create_time, 'yyyy-MM-dd') AS dt
FROM ods_orders_source;
2. DWD:Flink SQL ETL 清洗 + 维表 Lookup Join
-- DWD: 订单明细宽表(关联用户/商品/品类维度)
CREATE TABLE dwd_order_detail (
  order_id BIGINT,
  order_no STRING,
  user_id BIGINT,
  user_name STRING,
  user_level INT,
  item_id BIGINT,
  item_name STRING,
  category_id BIGINT,
  category_name STRING,
  amount DECIMAL(10,2),
  order_status INT,
  order_status_name STRING,
  create_time TIMESTAMP(3),
  WATERMARK FOR create_time AS create_time - INTERVAL '5' SECOND,
  PRIMARY KEY (order_id) NOT ENFORCED
) WITH (
  'connector' = 'paimon',
  'warehouse' = 'hdfs:///lake/paimon',
  'database' = 'dwd',
  'table' = 'order_detail',
  'bucket' = '4',
  'changelog-producer' = 'lookup'
);

INSERT INTO dwd_order_detail
SELECT
  o.id AS order_id,
  o.order_no,
  o.user_id,
  u.user_name,
  u.user_level,
  o.item_id,
  i.item_name,
  o.category_id,
  c.category_name,
  o.amount,
  o.order_status,
  CASE o.order_status
    WHEN 1 THEN '待支付'
    WHEN 2 THEN '已支付'
    WHEN 3 THEN '已发货'
    WHEN 4 THEN '已完成'
    WHEN 5 THEN '已取消'
    WHEN 6 THEN '已退款'
  END AS order_status_name,
  o.create_time
FROM ods_orders AS o
LEFT JOIN dim_user FOR SYSTEM_TIME AS OF o.proc_time AS u
  ON o.user_id = u.id
LEFT JOIN dim_item FOR SYSTEM_TIME AS OF o.proc_time AS i
  ON o.item_id = i.id
LEFT JOIN dim_category FOR SYSTEM_TIME AS OF o.proc_time AS c
  ON o.category_id = c.id;
3. DWS:实时聚合写入 Paimon/Doris
-- DWS: 商品分钟级 GMV(滑动/滚动窗口聚合)
CREATE TABLE dws_item_gmv_min (
  item_id BIGINT,
  item_name STRING,
  window_start TIMESTAMP(3),
  window_end TIMESTAMP(3),
  gmv DECIMAL(18,2),
  order_cnt BIGINT,
  user_cnt BIGINT,
  PRIMARY KEY (item_id, window_start) NOT ENFORCED
) WITH (
  'connector' = 'doris',
  'fenodes' = 'doris-fe:8030',
  'table.identifier' = 'dws.item_gmv_min',
  'username' = 'root',
  'password' = 'xxx',
  'sink.label-prefix' = 'dws-gmv',
  'sink.enable-2pc' = 'true',
  'sink.properties.format' = 'json'
);

INSERT INTO dws_item_gmv_min
SELECT
  item_id,
  item_name,
  window_start,
  window_end,
  SUM(amount) AS gmv,
  COUNT(*) AS order_cnt,
  COUNT(DISTINCT user_id) AS user_cnt
FROM TABLE(
  TUMBLE(TABLE dwd_order_detail, DESCRIPTOR(create_time), INTERVAL '1' MINUTE)
)
WHERE order_status IN (2, 3, 4)
GROUP BY item_id, item_name, window_start, window_end;

-- DWS: 交易总览(累计指标)
CREATE TABLE dws_trade_overview (
  stat_date DATE,
  total_gmv DECIMAL(18,2),
  total_orders BIGINT,
  total_users BIGINT,
  avg_order_amount DECIMAL(10,2),
  PRIMARY KEY (stat_date) NOT ENFORCED
) WITH (
  'connector' = 'doris',
  'fenodes' = 'doris-fe:8030',
  'table.identifier' = 'dws.trade_overview',
  'username' = 'root',
  'password' = 'xxx',
  'sink.enable-2pc' = 'true'
);

INSERT INTO dws_trade_overview
SELECT
  DATE(create_time) AS stat_date,
  SUM(amount) AS total_gmv,
  COUNT(*) AS total_orders,
  COUNT(DISTINCT user_id) AS total_users,
  AVG(amount) AS avg_order_amount
FROM dwd_order_detail
WHERE order_status IN (2, 3, 4)
GROUP BY DATE(create_time);
4. ADS:结果输出到 Redis 供大屏查询
-- ADS: 实时大屏 TopN 商品 → Redis
CREATE TABLE ads_topn_items (
  rank_key STRING,
  item_info STRING,
  PRIMARY KEY (rank_key) NOT ENFORCED
) WITH (
  'connector' = 'redis',
  'mode' = 'single',
  'host' = 'redis',
  'port' = '6379',
  'command' = 'SET',
  'redis.value.data-type' = 'string'
);

INSERT INTO ads_topn_items
SELECT
  CONCAT('topn:item:', CAST(window_start AS STRING)) AS rank_key,
  item_name AS item_info
FROM (
  SELECT *,
    ROW_NUMBER() OVER (
      PARTITION BY window_start
      ORDER BY gmv DESC
    ) AS rn
  FROM dws_item_gmv_min
) WHERE rn <= 10;
关键设计
数据流向与 CDC Changelog 传播:
MySQL Binlog (+I/-U/+U/-D)
    │ Flink CDC 解析为 RowData
    ▼
Paimon ODS 主键表(保留完整 Changelog)
    │ 流式读取(changelog-producer=input 直接传播)
    ▼
DWD 宽表(Lookup Join 补全维度,CDC 语义保持)
    │ 聚合(+I 产生新结果,-U/+U 更新之前结果)
    ▼
DWS/ADS(Upsert Sink 幂等写入)
关键:Flink SQL 原生支持 Changelog 传播,CDC 的 UPDATE/DELETE 会在整个管道中正确传递,最终通过 Upsert Sink 写入外部系统。
状态 TTL 与 Idle State Retention:
-- 生产环境必须配置,防止状态无限增长
SET 'table.exec.state.ttl' = '24 h';
SET 'table.exec.idle-state-retention' = '1 h';
- Regular Join 的两侧状态在 TTL 后自动清理
- 空闲超过
idle-state-retention的 key 状态会被清理 - 窗口状态在窗口结束 + Allowed Lateness 后自动清理
多流 Join:
-- Interval Join:订单流 + 支付流(30分钟内支付)
SELECT o.order_id, o.amount, p.pay_time, p.pay_channel
FROM dwd_order_detail AS o, dwd_pay_success AS p
WHERE o.order_id = p.order_id
  AND p.pay_time BETWEEN o.create_time AND o.create_time + INTERVAL '30' MINUTE;

-- Temporal Join:关联历史版本汇率
SELECT o.order_id, o.amount * r.rate AS usd_amount
FROM dwd_order_detail AS o
JOIN dim_exchange_rate FOR SYSTEM_TIME AS OF o.create_time AS r
  ON o.currency = r.currency;
幂等写入与 Exactly-Once:
| 层 | Sink | 一致性机制 |
|---|---|---|
| ODS | Paimon | 原子 Snapshot 提交(2PC) |
| DWD | Paimon | 原子 Snapshot 提交(2PC) |
| DWS | Doris | Stream Load 2PC |
| ADS | Redis | 幂等 SET 覆盖写(At-Least-Once,结果一致) |
时区统一:
-- 全局配置
SET 'table.local-time-zone' = 'Asia/Shanghai';

-- MySQL CDC 必须指定时区
'server-time-zone' = 'Asia/Shanghai'

-- Kafka 时间戳统一转换
CREATE TABLE kafka_source (
  event_time BIGINT,
  ts AS TO_TIMESTAMP_LTZ(event_time, 3),
  WATERMARK FOR ts AS ts - INTERVAL '5' SECOND
) WITH (...);
数据质量监控:
- Flink DataStream 中添加校验算子(Null 值/异常范围/枚举校验),异常数据发侧输出
- 接入 Great Expectations 或 Apache Griffin 做离线数据质量校验
- 监控核心指标:空值率、主键重复率、数值异常率
离线补数与版本切换:
-- 批模式回刷历史数据
SET 'execution.runtime-mode' = 'batch';

INSERT INTO dws_item_gmv_min
SELECT ... FROM ods_orders WHERE dt BETWEEN '2024-01-01' AND '2024-01-31';

-- 使用 Savepoint 升级作业(状态兼容)
./bin/flink stop --savepointPath hdfs:///flink/savepoints <jobId>
./bin/flink run -s hdfs:///flink/savepoints/savepoint-xxx ./new-job.jar
监控告警:
- Checkpoint:成功率、时长、大小(参见 11.9 节)
- Kafka Lag:各 Source 消费积压
- 反压:
backPressuredTimeMsPerSecond告警 - 数据延迟:
System.time() - currentOutputWatermark - 资源:CPU/内存/GC
资源隔离与多租户:
- K8s Namespace 隔离不同业务线
- Flink K8s Operator 的
FlinkDeployment按团队独立部署 - Paimon Database 级权限控制
- Kafka Topic 前缀隔离 + ACL
- Doris Database/Table 级 RBAC
15. 学习路线与实战建议
15.1 学习阶段划分
阶段一(1-2周):基础入门
├── Flink 概念与架构
├── Local/Standalone 环境搭建
├── DataStream API 基础
└── 简单 WordCount / Kafka 消费

阶段二(2-4周):核心概念
├── 时间语义与 Watermark
├── Window 机制
├── 状态管理
├── Checkpoint 与容错
├── TaskManager 内存模型(Framework/Task/Network/Managed/JVM)
└── Flink SQL 基础

阶段三(4-8周):进阶实战
├── Flink SQL 高级(Join/Top-N/CDC/性能调优)
├── 异步 I/O(AsyncDataStream 维表关联)
├── Flink CDC 整库同步
├── CEP 复杂事件处理
├── 性能调优与问题排查(反压/数据倾斜/Checkpoint)
├── Metrics 与 Prometheus + Grafana 监控
└── 实时数仓项目实战

阶段四(持续):生产深耕
├── Flink on K8s(Native/Operator)
├── Paimon 流式数据湖深度集成
├── Watermark Alignment 与高级调优
├── 源码阅读(JobManager/TaskManager/Checkpoint/网络栈)
└── Flink 2.0 新技术(Disaggregated State/Autoscaling)
15.2 推荐资源
书籍:
- 《Flink 基础教程》(Stream Processing with Apache Flink)
- 《Flink 内核原理与实现》
- 《Flink SQL 实战》
官方资源:
- Flink 官方文档:https://flink.apache.org/docs/
- Flink CDC:https://nightlies.apache.org/flink/flink-cdc-docs-stable/
- Paimon:https://paimon.apache.org/
- Flink 中文社区:https://flink-learning.org.cn/
视频:
- 尚硅谷 Flink 教程(入门推荐)
- Apache Flink 官方 YouTube 频道
- Flink Forward 大会演讲
源码:
- GitHub:https://github.com/apache/flink
- 从
StreamExecutionEnvironment.execute()入口阅读
15.3 项目练习建议
- WordCount(入门必做):Socket + 文件 + Kafka
- 实时热门商品:Kafka 订单流 → 滑动窗口 TopN → Redis/MySQL
- 实时风控告警:CEP 检测可疑交易模式
- 实时数仓搭建:MySQL CDC → Kafka → Flink SQL → Doris
- 整库同步到湖仓:Flink CDC → Paimon → Trino/Presto 查询
15.4 面试高频考点
| 主题 | 高频问题 |
|---|---|
| 架构 | JobManager/TaskManager 作用?Slot 与并行度关系?Flink on K8s 有哪些部署模式? |
| 时间 | Watermark 原理?乱序数据如何处理?Watermark Alignment 解决什么问题? |
| 窗口 | 窗口触发时机?Allowed Lateness 机制? |
| 状态 | Keyed State 与 Operator State 区别?State Backend 选择? |
| 内存模型 | TaskManager 内存分哪几个区域?Managed Memory 做什么用?容器 OOM Killed 怎么排查? |
| 容错 | Checkpoint 流程?Barrier 对齐 vs 非对齐?2PC 如何保证端到端 Exactly-Once? |
| 反压 | Credit-based 反压机制原理?如何通过 Web UI/Metrics 定位反压? |
| 异步 I/O | Async I/O 原理?orderedWait 和 unorderedWait 区别?生产注意什么? |
| SQL | 动态表概念?各种 Join 区别?Top-N 实现?数据倾斜三板斧(MiniBatch/Local-Global/Split Distinct)? |
| SQL 调优 | MiniBatch 原理?Local-Global 两阶段聚合?COUNT(DISTINCT) 怎么优化?维表 Join 如何加速? |
| CDC | 全量+增量如何无缝切换?无锁原理?Flink CDC 3.x Pipeline 有什么优势? |
| Connector | 各 Sink 的 Exactly-Once 支持情况?Kafka 事务如何实现?Doris/StarRocks 如何保证 EOS? |
| 数据湖 | Paimon vs Iceberg vs Hudi 对比?Paimon Changelog Producer 有哪些模式? |
| 监控 | Flink Metrics 有哪些类型?关键监控指标有哪些?如何集成 Prometheus + Grafana? |
| 调优 | 数据倾斜怎么处理?Checkpoint 超时怎么办?Managed Memory 如何配置? |
| 对比 | Flink vs Spark Streaming?Lambda vs Kappa?Flink on K8s vs YARN? |
总结
Flink 作为当前最主流的流处理引擎,其知识体系涵盖API 使用、核心原理、生态集成、生产调优四大维度。学习 Flink 的关键路径是:
- 先跑起来:搭建环境,写通第一个 DataStream 程序
- 理解核心:时间、窗口、状态、Checkpoint 四大基石
- 掌握 SQL:Flink SQL 是生产效率的关键,也是 2.0 方向
- 实战驱动:在真实项目中踩坑、调优、深入
- 关注前沿:流批一体、湖仓一体、Disaggregated State、Flink 2.0
最后一句话: 流处理的世界里,Flink 不是工具,而是一种思维方式——用流的视角看待数据,用状态的思维构建应用,用 Checkpoint 的信念保证可靠。祝你在 Flink 的学习之路上越走越远!
本文基于 Apache Flink 1.18/1.19/1.20 版本撰写,部分内容参考 Flink 官方文档。Flink 2.0 特性为社区路线图预览,具体以官方发布为准。
更多推荐

 14
 0
- 0


 已为社区贡献6条内容

所有评论(0)