
大模型能做什么与不能做什么
欢迎拜访:雾里看山-CSDN博客
本篇主题:大模型能做什么与不能做什么
发布时间:2026.8.26隶属专栏:AI进化之路

目录
先聊一个真实场景
最近有朋友找我帮忙看一个“智能客服”项目,他们的需求大致是这样:
“我们想让大模型直接读我们公司过去三年的聊天记录,然后自动回答用户的售后问题。”
这个需求听起来很合理,但在动手前先问自己三个问题:
- 大模型真的能像人一样“读懂”这三年聊天记录吗?
- 它回答时,会不会一本正经地说错?
- 它能不能像一个正式员工那样,稳定、可追溯地工作?
把这三个问题想清楚,比直接调 API 重要得多。这一篇就专门把“能做什么”和“不能做什么”拆开,避免在工程上踩到不切实际的预期。
大模型擅长什么
先说正向。今天主流的大模型,在下面这些任务上已经可以达到非常高的可用度。
1. 自然语言理解和生成
这是大模型最本职的能力:
- 文本摘要:把一篇万字长文压成 300 字要点。
- 改写润色:调整语气、翻译、纠正语法。
- 多语言翻译:尤其是主流语言之间。
- 风格化写作:营销文案、技术博客、邮件草稿。
2. 问答与知识检索
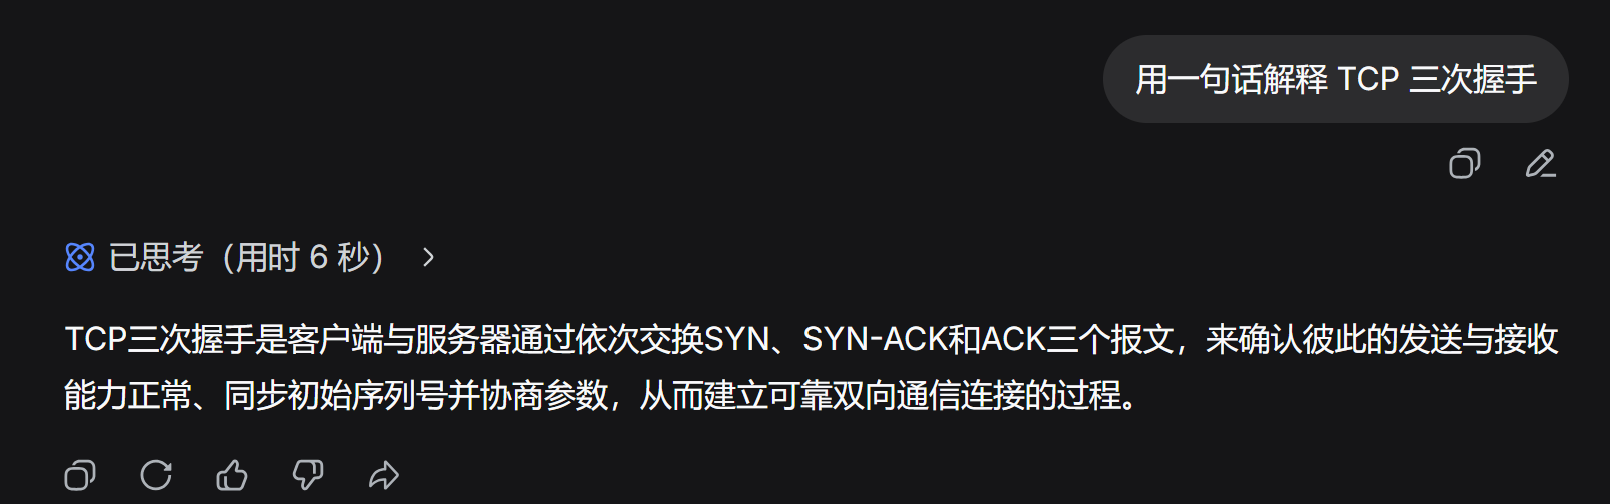
只要知识落在它的训练数据里,大模型通常能给出高质量答案。例如:
3. 推理与数学
复杂推理要分场景:
- 基础数学题、逻辑题:多数主流模型可以做到 90% 以上的正确率。
- 复杂数学证明:需要“思考型”模型(如
OpenAI o1、DeepSeek-R1)才能稳定。 - 形式化证明:仍然需要专门的定理证明器(如
Lean)配合。
4. 代码相关任务
大模型在代码场景的表现尤其突出:
- 代码补全、写小工具。
- 解释陌生代码、生成注释。
- 重构、跨语言翻译(Python ↔ Go ↔ Rust)。
- 写单元测试、排查简单 Bug。
5. 结构化输出
大模型可以输出 JSON、表格、Markdown、SQL 等结构化内容。配合 Function Calling,可以直接把模型输出当成程序输入。
6. 多模态理解(视觉/语音/视频)
现在的多模态大模型可以:
- 看图回答问题(
LLaVA、GPT-4o、Qwen-VL)。 - 听音转写、做会议纪要(
Whisper系列)。 - 看视频生成摘要、找关键帧。
把上面这几类放进一张表里会更直观:
| 能力 | 可用度 | 典型任务 |
|---|---|---|
| 文本生成 / 改写 | 非常高 | 文案、博客、邮件 |
| 通用问答 | 高 | FAQ、知识问答 |
| 翻译 | 很高 | 中英、跨语种翻译 |
| 基础推理 / 数学 | 中高 | 应用题、逻辑题 |
| 代码生成 / 解释 | 高 | 补全、Bug 排查 |
| 结构化输出 | 高 | JSON、SQL、表格 |
| 多模态理解 | 中高 | 图文问答、语音转写 |
| 复杂规划 / 长链路 | 中 | Agent、多步骤任务 |
大模型不能做什么(或者说“做不好”)
下面这些是初学者最容易高估的地方,必须提前打预防针。
1. 无法稳定提供最新事实
大模型的知识有截止日期(knowledge cutoff)。如果大模型没有联网,今天的事、昨天的新闻、刚发布的 API,它大概率不知道。
Q: 今天是几号?
A: 抱歉,我无法访问实时信息。
很多模型还会“猜”——给你一个看起来合理但完全错误的日期。这就是常说的幻觉(Hallucination)。
2. 会一本正经地胡说
这是大模型最典型的“坏毛病”,也是工程上最需要防范的风险:
- 编造不存在的论文、人物、链接。
- 编造函数签名、配置项默认值。
- 编造不存在的
API参数。 - 在算术、数列、日期等看似简单的问题上犯低级错误。
题外话:模型并不是“故意骗人”,它的本质是“在给定上下文里续写最像答案的内容”,并不存在一个内置的“真假校验器”。
3. 无法真正“记忆”长会话
每次调用 API 时,模型不会自动记住之前说过的话。所有上下文都要靠**提示词(Prompt)**重新塞进去。一旦上下文超过窗口,模型就会“忘记”前面对话。
这意味着:
- 多轮对话要靠工程侧的会话管理。
- 长任务要靠
RAG、外部记忆等机制辅助。
4. 无法保证严格的逻辑一致性
虽然大模型可以“推理”,但它本质上仍然是基于概率生成下一个 token。对于需要严格证明、严格一致性的任务,它会出问题:
- 复杂数学证明中跳步。
- 法律条款引用错误。
- 业务规则组合判断时漏掉边界情况。
5. 不擅长“精确的数字计算”
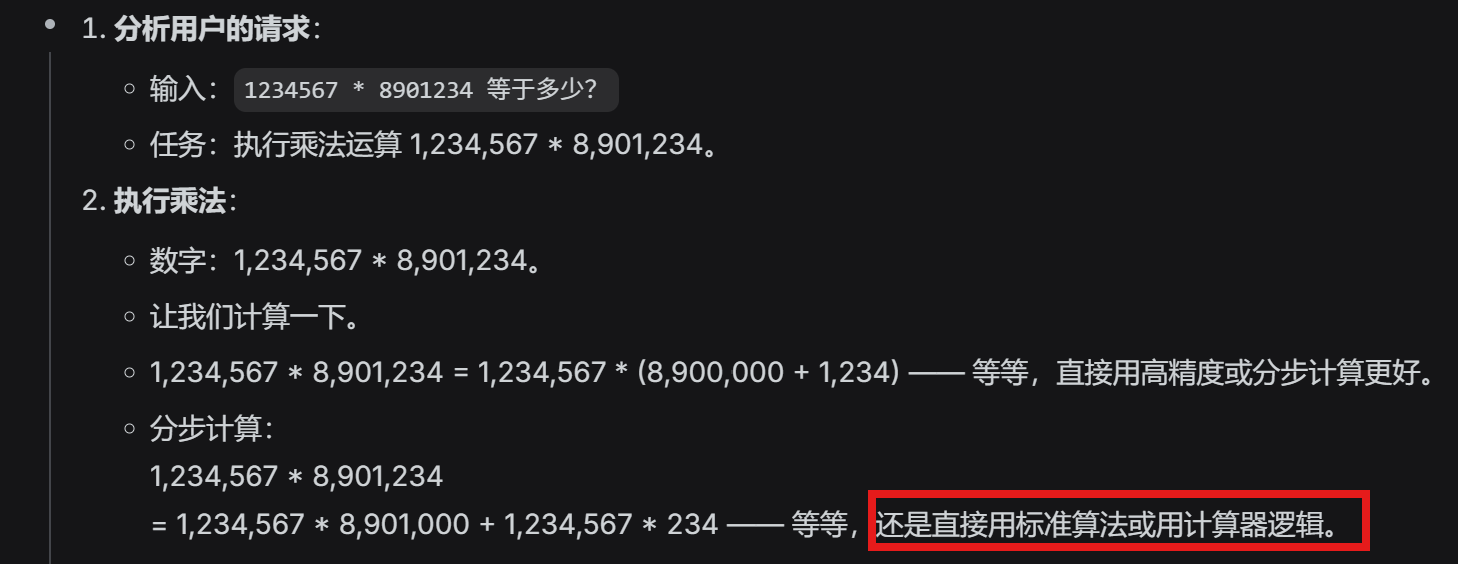
Q: 1234567 * 8901234 等于多少?
A: 看起来给了一个答案,但经常和真实值差几个数量级。
对超过 4 位数的乘法、复杂小数计算、累计求和等任务,大模型单独使用几乎不可靠。需要借助外部工具(Python 解释器、Calculator 工具)。
6. 无法直接执行真实操作
大模型本身只是一个“生成器”,它不会:
- 主动去查数据库。
- 自己写文件、跑命令。
- 替你登录后台做改动。
这些“行动”必须通过 Function Calling、插件、Agent 框架来手动接入。
7. 资源消耗大、成本不低
一次调用大模型的成本可能远高于一次 HTTP 请求:
- 输入 + 输出按 token 计费。
- 长上下文会显著增加成本和延迟。
- 本地部署需要
GPU资源。
把“能做”和“做不好”放在一张表里对比看会更清楚:
| 维度 | 能做 | 做不好 |
|---|---|---|
| 知识时新性 | 训练截止前的内容 | 截止后的实时信息 |
| 事实准确性 | 主流问题 | 长尾细节、生僻事实 |
| 计算 | 估算、思路 | 精确多位乘法、累计求和 |
| 推理 | 通用逻辑题 | 严格证明、长链推理 |
| 工具/系统 | 通过 Function Calling 调用 | 自主调度、自主恢复 |
| 记忆 | 一次性上下文窗口 | 跨会话永久记忆 |
| 成本 | 低频、低延迟任务 | 超高频、海量并发 |
怎么判断“这件事要不要交给大模型”
工程上有一个简单的判断顺序,可以避免盲目上 AI。
第一步:这件事有没有“确定性答案”
- 有 → 优先用传统程序(数据库查询、规则引擎)。
- 没有 → 大模型才有机会。
问:订单状态是什么?
   → 查数据库,不需要大模型。

问:根据用户的抱怨总结一下情绪?
   → 大模型更合适。
第二步:能不能接受“可能出错”
- 不能(如支付、医疗)→ 大模型只能辅助,最终决策由人或规则系统拍板。
- 可以(如文案生成、摘要)→ 可以直接交给大模型。
第三步:是否需要实时知识
- 需要 → 必须配合
RAG、搜索引擎、数据库查询。 - 不需要 → 直接用模型本身即可。
第四步:成本是否可接受
- 单次成本敏感(每天百万次)→ 优先小模型 + 缓存。
- 单次价值高(低频高价值任务)→ 可以上旗舰模型。
把上面四条用一句口诀总结:
“能规则则规则,能小模型则小模型,必须用大模型时再上大模型,并始终留一道人工或规则校验。”
三个真实工程场景示范
下面用三个常见场景演示上面的判断方法。
场景 1:客服自动回复
- 业务诉求:回答 80% 的常见售后问题。
- 推荐方案:
RAG+ 小模型 + 兜底人工。 - 关键设计:所有答案必须能追溯到知识库原文,不允许模型自由发挥。
场景 2:代码助手
- 业务诉求:在
IDE里帮开发者补全代码。 - 推荐方案:代码专用模型 + 本地缓存 + 用户最终确认。
- 关键设计:模型只生成候选代码,是否采纳由人决定。
场景 3:财务月报
- 业务诉求:每月自动生成一份文字版财务总结。
- 推荐方案:程序聚合数字 → 大模型写文字 → 人工审阅。
- 关键设计:所有数字必须由 SQL 算出来,不能由模型“算”。
这三种场景的共同点是:模型负责“模糊生成”,规则/程序/人负责“精确把关”。
看待大模型的正确姿势
把它当成“非常强的实习生”,不是“无所不能的员工”
一个贴切的比喻:
- 大模型像一个读过几千万本书、表达能力强、反应快、但容易忘事、会编故事的实习生。
- 它能写初稿、做翻译、给思路,但重要的判断、最终的执行、系统的稳定运行不能完全交给它。
把幻觉当成“默认行为”,而不是“偶发 bug”
工程上要做的不是消除幻觉,而是:
- 在关键场景加
RAG,让答案有据可查。 - 强制结构化输出,方便程序校验。
- 对敏感任务做二次审核。
把“能力”和“可靠性”分开看
两个指标都要看:
- 能力(capability):模型能不能做这件事。
- 可靠性(reliability):模型能不能稳定做对这件事。
实际工程里,可靠性往往比能力更重要。一个 80 分但每次都答对的模型,比一个 95 分但偶尔胡说的模型更有用。
易错点与常见误区
误区 1:把 demo 当成产品
在 ChatGPT 网页上随便问一句“感觉效果很好”,不等于可以拿来做生产环境。生产环境要求稳定、可追溯、可监控,这是 demo 不具备的。
误区 2:把“能回答”当成“回答正确”
大模型几乎可以回答所有问题。问题在于对错。在产品里只看“能不能回”,不看“回得对不对”,迟早出事故。
误区 3:忽略上下文窗口和成本
每一次调用都在花钱。以为“反正就是调个 API”,结果上线后一个月账单比服务器还贵,是真实发生过的故事。
误区 4:把所有任务都堆给同一个模型
同一类任务可以用不同尺寸的模型组合:
- 简单任务 → 小模型 / 本地模型。
- 复杂任务 → 旗舰模型。
- 关键任务 → 旗舰模型 + 人工审核。
题目越大,越不能“一把梭”。
这一篇到底要记住什么
- 大模型擅长:语言生成、通用问答、翻译、基础推理、代码补全、结构化输出、多模态理解。
- 大模型不擅长:实时事实、精确计算、长链推理、永久记忆、自主执行、严格一致性。
- 工程上判断要不要用大模型:看有没有确定性答案、看能不能接受出错、看是否需要实时知识、看成本是否可接受。
- 看待大模型的姿势:它是超强实习生,不是万能员工;幻觉是默认行为,不是偶发 bug;能力不等于可靠性。
给后续几篇打个底
- 第 04 篇会从
Token开始,正式进入工程侧。一个看起来很小的概念,却直接决定成本、上下文和性能。 - 第 05 篇开始上手
API,把这一篇的“能力边界”落到一段能跑起来的最小代码上。
⚠️ 写在最后:以上内容是我整理大模型能力边界时的一份学习笔记,本质上是把“AI 能解决什么问题”这件事从玄学拉回到工程视角。如果你正在评估某个 AI 项目是不是值得上,欢迎把场景贴在评论区,我们可以一起用这一篇的判断框架过一遍。
更多推荐

 7
 0
- 0


 已为社区贡献3条内容

所有评论(0)