
大模型部署要买几张 GPU?先算模型权重、KV Cache 和运行开销
大模型部署要买几张 GPU,先别看参数量,先看显存。正确的计算顺序是:模型权重 + KV Cache + 运行开销,再结合真实并发和上下文上限,最后再定卡数。
一、场景背景
部署大模型时,最常见的问题是:一个模型到底需要几张 4090、H200 或 B200 才能跑起来。这个问题不能只靠参数量回答,因为显存消耗会随着并发和上下文长度变化。
配置估算错了,代价很直接:
- GPU 买多了,预算浪费;
- GPU 买少了,模型上线后可能直接 OOM;
- 低并发测试能跑,不代表真实线上并发也能跑。
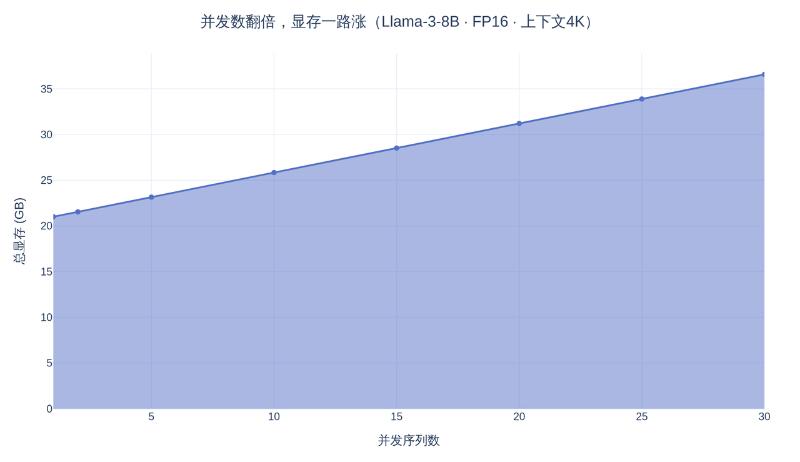
真正容易被低估的不是模型权重,而是 KV Cache。长文档问答、长对话、代码理解、知识库问答等场景,尤其要按真实上下文上限和并发去算。
二、技术方案
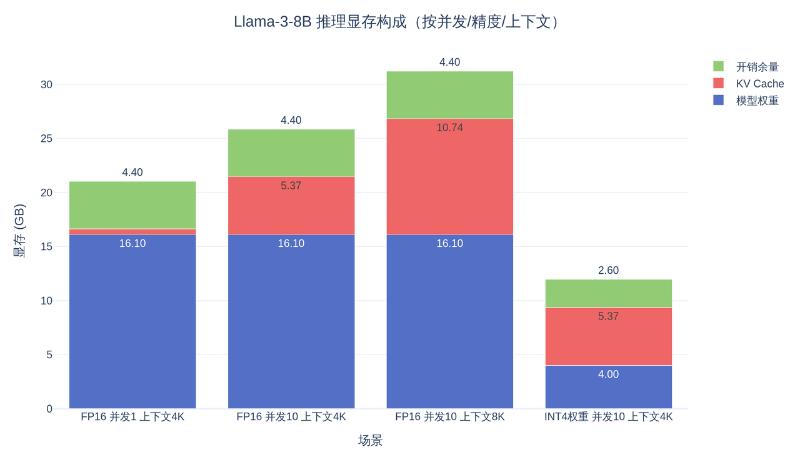
大模型推理显存可以拆成三部分:模型权重、KV Cache 和运行开销。这个拆分方式适用于多数 Transformer 架构大语言模型的推理部署。
| 显存组成 | 含义 | 是否随并发变化 | 主要影响因素 |
|---|---|---|---|
| 模型权重 | 模型参数本身占用的显存 | 否 | 参数量、精度类型 |
| KV Cache | 推理过程中保存的 Key/Value 缓存 | 是 | 上下文长度、并发数、模型结构 |
| 运行开销 | 激活、中间状态、CUDA 上下文、显存碎片等 | 部分相关 | 推理框架、batch size、硬件与调度方式 |
1)先算模型权重
模型权重是固定成本,计算方式是参数量乘以每个参数占用的字节数。它与并发请求数没有直接关系。
以 7B 模型为例:
- FP16 大约占 14 GB;
- INT8 大约占 7 GB;
- INT4 大约占 3.5 GB。
量化可以显著降低权重占用,但不能消除 KV Cache 带来的并发压力。
2)再算 KV Cache
KV Cache 是推理阶段保存注意力计算中 Key 和 Value 的缓存。每生成或处理一个 token,系统都要保存对应的 K 和 V 信息,以便后续 token 复用上下文。
KV Cache 的总量可以理解为:
单 token 的 KV 占用 × 上下文长度 × 并发请求数
并发翻一倍,KV Cache 也会翻一倍;上下文翻一倍,KV Cache 同样翻一倍。
这就是“低并发测试可运行,上线后突然 OOM”的根因。
3)最后预留运行开销
运行开销包括中间激活、CUDA 上下文、显存碎片和推理框架自身占用。经验上,可以预留模型权重的 15% 到 20%,再额外预留 1 到 2 GB。
这个值适合作为初步估算的安全边界,但不是绝对值。不同推理框架、batch size、并行策略和 GPU 型号,都会改变实际开销。
4)手算最容易踩的三个坑
坑 1:只算权重,忘算 KV Cache
只看模型参数量,会低估线上显存需求。一个模型在单请求、短上下文下能跑,不代表它能承受真实并发。
坑 2:上下文长度按 demo 估算
上下文长度不能按演示环境里的 2K 或 4K 估算。长文档、长对话和 RAG 场景,可能需要按 32K、100K 甚至更长上下文规划。
坑 3:把量化当成唯一解法
INT4、INT8 等量化方式可以降低模型权重显存,但高并发下,KV Cache 仍会继续增长。量化能省下固定成本,不能单独解决并发和长上下文带来的缓存压力。
三、核心指标
1)7B 模型的权重显存
7B 模型在不同精度下的显存大致如下:
- FP16:约 14 GB
- INT8:约 7 GB
- INT4:约 3.5 GB
这组数值说明,量化能明显降低权重成本,但部署时仍要把 KV Cache 和运行开销算进去。
2)101B 模型的 KV Cache 放大效应
工具实测显示,101B 模型在并发 50、100 万 token 上下文下:
- KV Cache 达到 5,231 GB;
- 模型权重为 325 GB;
- 总显存达到 6,025 GB。
这意味着 KV Cache 约为权重的 16 倍。真实部署不能只看模型大小,并发和上下文长度一旦进入生产级规模,KV Cache 往往会成为决定 GPU 数量的核心因素。
3)753B 模型的配置建议
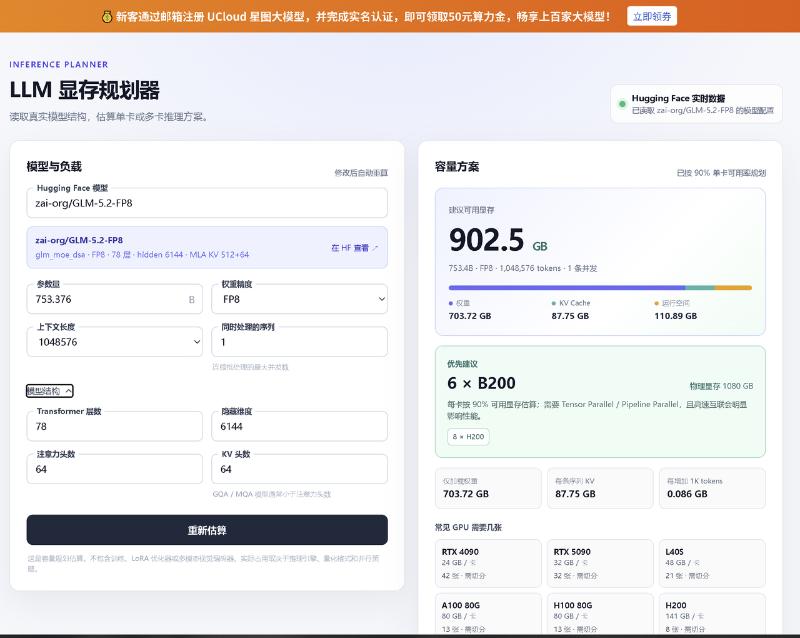
另一个场景里,753B 大模型在 FP8 精度、100 万 token 上下文条件下:
- 总显存需求为 902 GB;
- 推荐配置为 6 张 B200 或 8 张 H200;
- 计算结果里也会给出 4090、5090、L40S、A100、H100、H200、B200 等 GPU 的所需数量。
4)决策时该看什么
真正要看的不是“模型多大”,而是下面这些变量:
- 模型名称和参数量;
- 精度类型(FP16、FP8、INT8、INT4);
- 最大上下文长度;
- 真实并发请求数;
- batch size;
- 推理框架和硬件型号。
四、优刻得相关能力
UCloud 提供了免费的 LLM 显存计算器,入口是:https://playground.ucloud.cn/#apps 。适合在模型选型、GPU 采购、上线前容量评估和成本测算阶段使用。
这个工具的价值在于,不需要手工查模型参数再代入公式,直接选择实际模型,就能按模型结构计算权重和 KV Cache。并发、上下文长度、batch size 都可以调整,参数变化对显存的影响会直接展示出来。
典型使用步骤
- 打开 UCloud LLM 显存计算器:https://playground.ucloud.cn/#apps 。
- 选择要部署的大模型。
- 设置精度类型,例如 FP16、FP8、INT8 或 INT4。
- 按真实业务输入上下文长度、并发数和 batch size。
- 查看模型权重、KV Cache、总显存占用和 GPU 配置建议。
- 对比 4090、5090、L40S、A100、H100、H200、B200 等硬件方案。
工具会输出什么
| 输出项 | 作用 |
|---|---|
| 权重显存 | 判断模型固定显存成本 |
| KV Cache 显存 | 判断并发和上下文带来的动态压力 |
| 总显存 | 评估部署是否会 OOM |
| GPU 张数建议 | 辅助采购和部署规划 |
| 模型下载量与提交信息 | 辅助判断模型热度与来源 |
| 优化信息 | 辅助判断模型是否适合实际部署 |
五、适用/不适用场景
适用场景
- GPU 采购评估
- 模型上线前容量规划
- 多模型选型比较
- 长上下文能力评估
- 推理成本预算
- 研发、算法、运维、采购协同决策
不适用场景
显存计算结果不等于最终吞吐性能。实际部署还会受到推理框架、并行策略、网络、CPU、存储、调度策略和请求分布影响。
所以,显存估算只能作为容量规划的第一步,不能替代压测。
六、FAQ
Q1:为什么 7B 模型看起来很小,上线后还是可能 OOM?
因为 7B 的权重只是固定成本。上线后,KV Cache 会随着并发数和上下文长度增长。并发越高、上下文越长,KV Cache 越容易成为主要显存消耗。
Q2:INT4 量化能不能解决显存不足?
INT4 能降低模型权重占用,但不能单独解决 KV Cache 增长。高并发或长上下文场景下,仍然要把 KV Cache 和运行开销算进去。
Q3:为什么要按真实线上上下文长度计算?
因为 KV Cache 与上下文长度线性相关。用 2K 上下文估算 32K 或 100 万 token 场景,会明显低估显存需求。
Q4:UCloud LLM 显存计算器适合哪些人使用?
适合大模型部署工程师、算法工程师、架构师、运维团队和 GPU 采购决策人员。它可以帮助团队在上线前快速评估显存需求和 GPU 配置。
Q5:显存够了是否代表部署一定成功?
不一定。显存够用只是部署成功的前提之一。真实生产环境还要验证吞吐、延迟、稳定性、并行策略和推理框架效率。
结论
大模型部署的 GPU 数量,不能只靠参数量或经验判断。模型权重、KV Cache 和运行开销都要进入显存预算,其中 KV Cache 会被并发和上下文长度快速放大。
先按真实业务参数算显存,再看 GPU 数量,通常比上线后 OOM 再返工更可靠,也更省成本。
更多推荐


 5
 0
- 0


 已为社区贡献11条内容

所有评论(0)