
LangChain+Ollama+Chroma 本地 RAG|对接 SpringAI 实现 Java/Python 异构数据融合实战
Java SpringAI对接Python FastAPI RAG服务,MySQL+Chroma向量库纯本地私有化部署,无需API密钥,直接复用已有业务向量数据
本人长期以 Java 后端开发为主,前期基于 SpringAI 完成了企业私有化 RAG 原型,为验证多技术栈适配性、实现存量业务数据库复用,基于 Python LangChain 重构一套可独立部署、可对接 Java 服务的本地问答系统,完整工程代码已开源。
一、为什么做这个项目?
之前我用 Spring AI + Ollama 搭建过一套智能助手,这次用 Python 生态(LangChain + FastAPI)重新实现,并打通了之前 Spring AI 项目里的 MySQL 数据。
核心诉求:
-
全本地化部署:不依赖任何云端 API,满足企业数据安全要求
-
多源异构数据融合:MySQL 结构化数据 + 文档类非结构化数据统一检索
-
对外可集成:通过 FastAPI 封装成标准 HTTP 接口,供外部系统调用
二、项目能做什么?
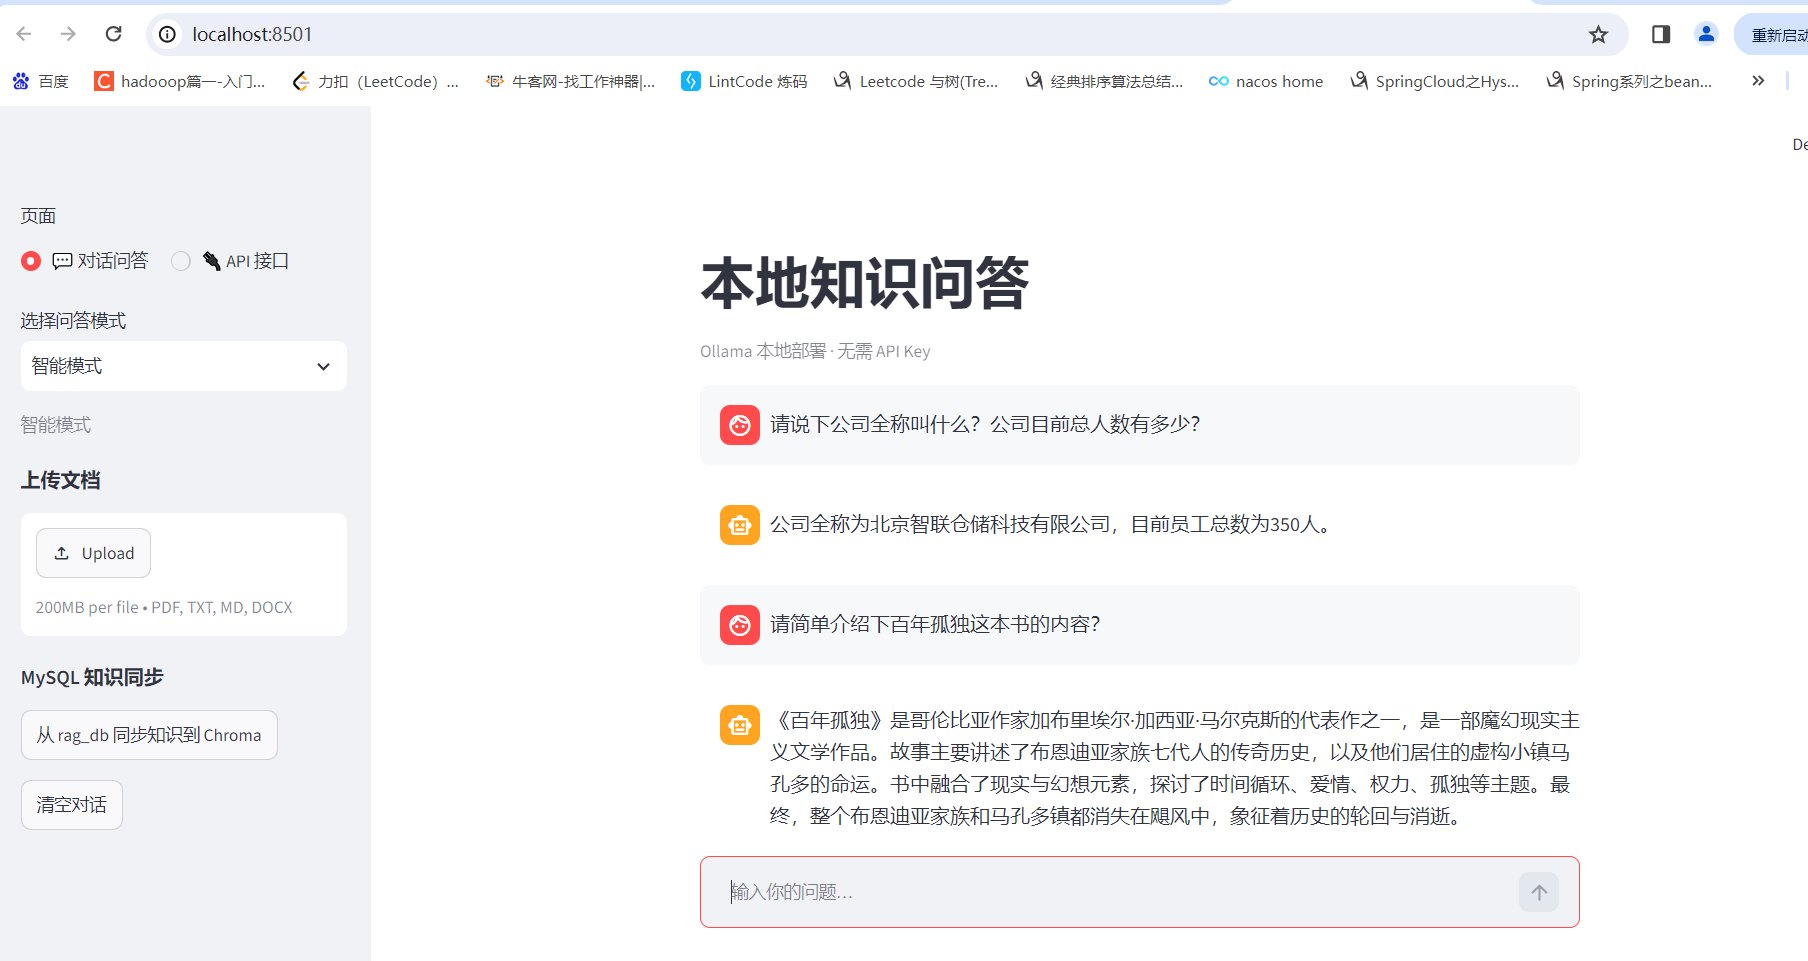
| 能力 | 说明 | 数据来源 |
|---|---|---|
| 纯对话 | 带系统提示词的通用对话 | 模型自身知识 |
| 文档问答(RAG) | 上传 PDF/TXT/MD/DOCX,做向量检索 | 本地文档 → Chroma |
| 业财 SQL | 自然语言转 SQL,实时查业务库 | MySQL 直连(Text-to-SQL) |
| 智能路由 | 自动判断问题类型,选择走哪条链路 | 组合判断 + 工具调用 |
| 对外 API | 供 Java/其他系统 HTTP 调用 | FastAPI 封装 |
核心架构设计亮点:向量库 Chroma 与业务 MySQL 独立部署、不做全量向量转换 文档类非结构化文件存入 Chroma 做 RAG 检索;业务结构化数据直接通过 Text-to-SQL 直连 MySQL 查询,避免业务库全量向量化带来的冗余、更新滞后、存储成本过高问题。
三、技术栈
| 组件 | 选型 | 说明 |
|---|---|---|
| 大模型引擎 | Ollama + llama3.1:8b / qwen2.5:7b | 本地推理,可离线运行 |
| 向量数据库 | Chroma | 轻量、零配置、持久化 |
| 应用框架 | LangChain | RAG 链路编排 |
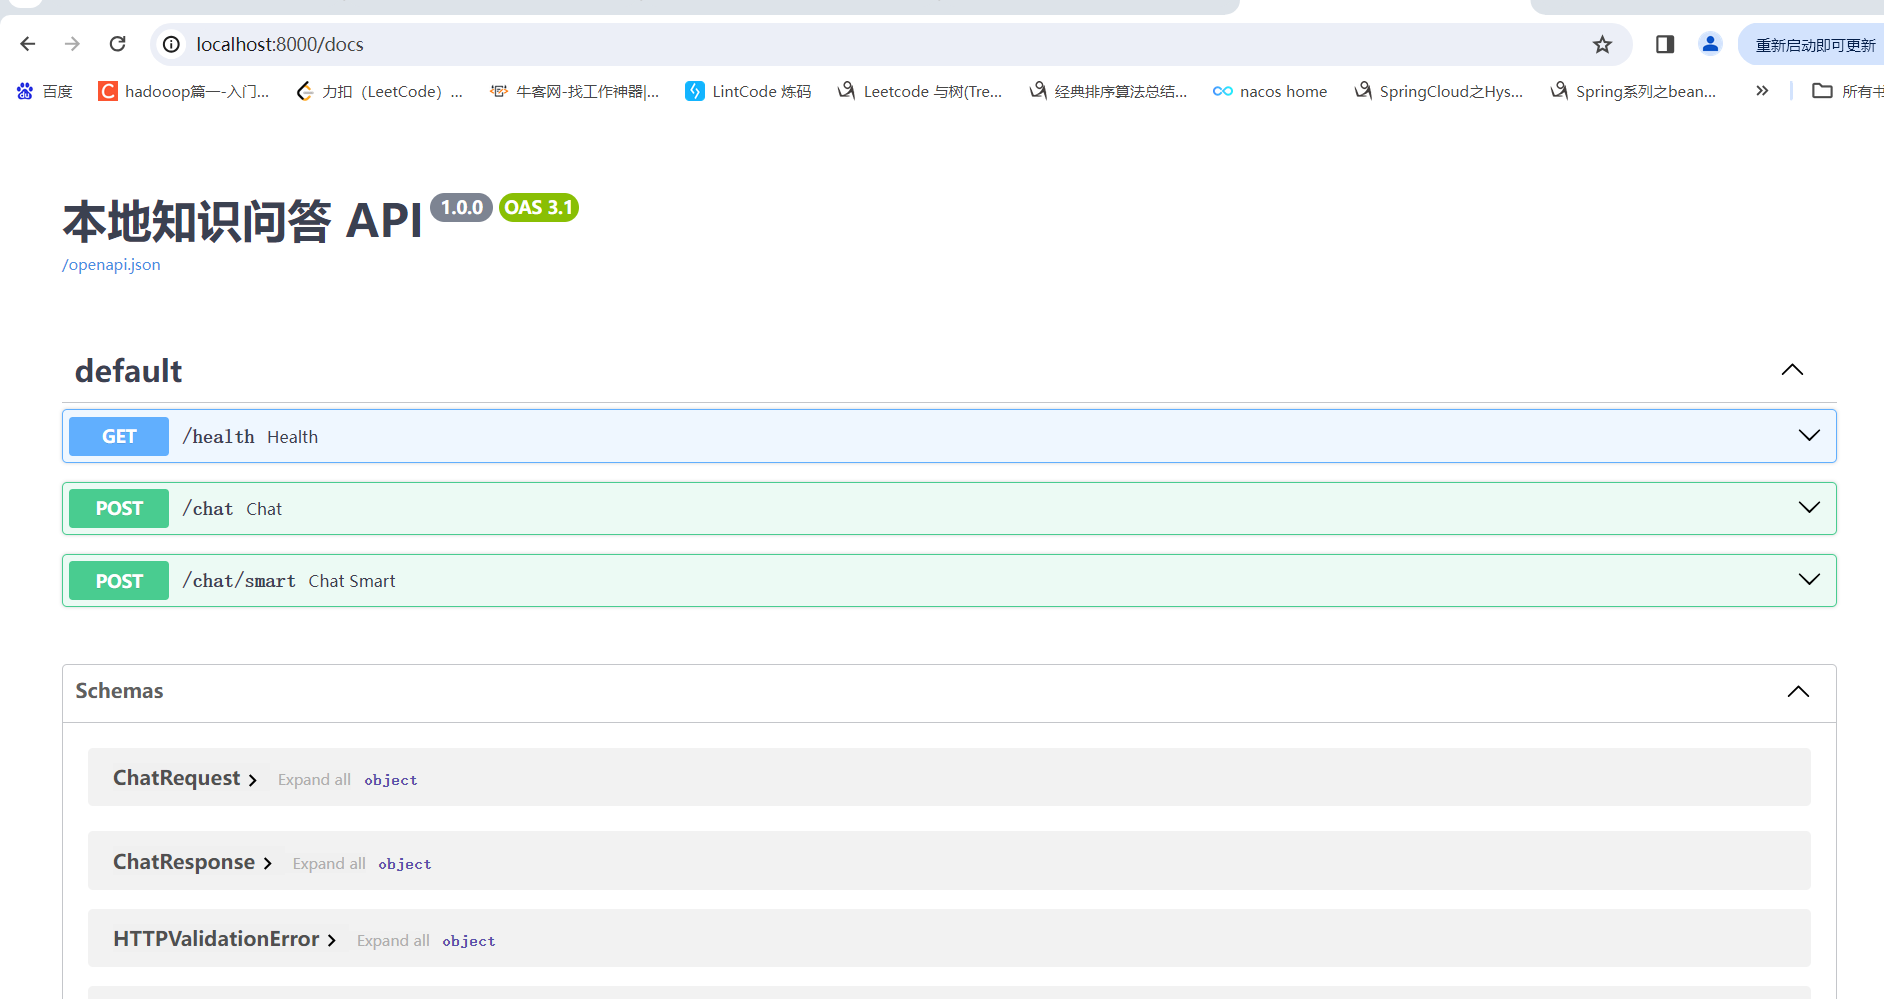
| API 服务 | FastAPI | 对外接口 + Swagger 文档 |
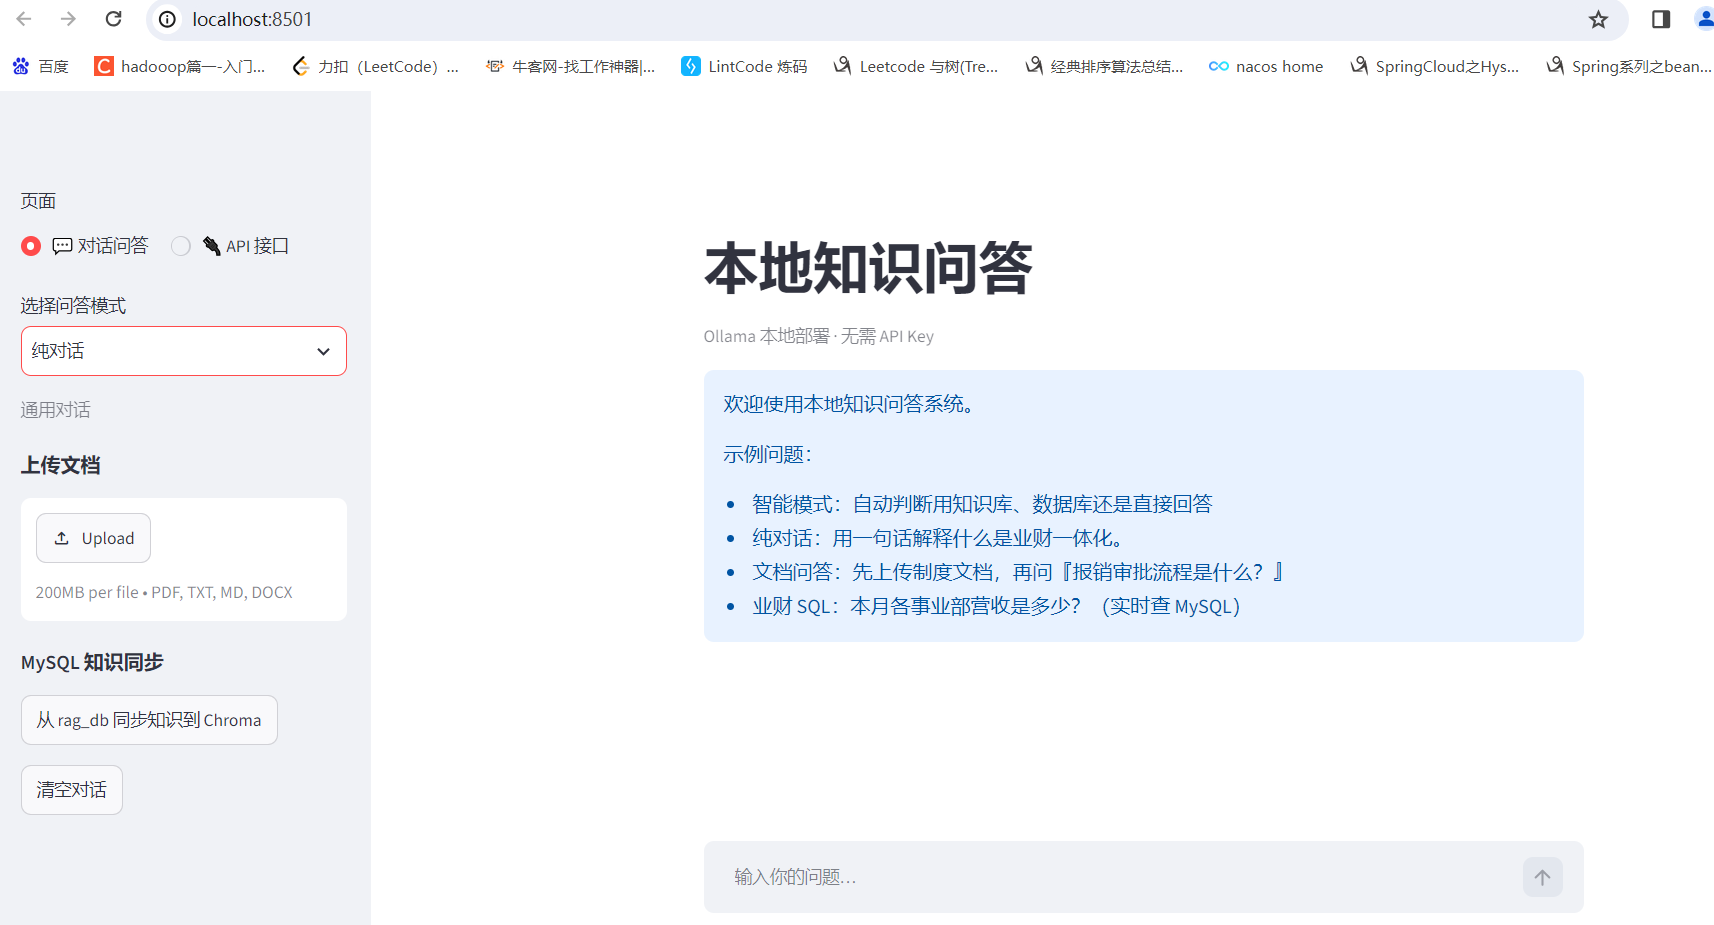
| 前端演示 | Streamlit | 快速验证界面 |
| Embedding 模型 | nomic-embed-text | 中文友好,Ollama 可直接拉取 |
四、环境准备与安装
1. 安装 Ollama(大模型运行环境)
Ollama 是本地运行大模型的核心工具,支持 macOS / Linux / Windows。
-
官网下载:https://ollama.com
安装完成后,在终端确认服务已启动:
ollama --version# 默认服务地址:
http://localhost:114342. 拉取所需模型
# 大模型(二选一即可)
ollama pull llama3.1:8b        # Meta 模型,英文能力强
ollama pull qwen2.5:7b         # 通义千问,中文理解更好

# Embedding 模型(必须)
ollama pull nomic-embed-text
3. 安装 Chroma(向量数据库)
Chroma 是一个轻量级向量数据库,通过 Python 包直接安装即可,无需单独部署服务。
pip install chromadb4. Python 环境与依赖
# 克隆项目
git clone https://github.com/316959108/langchain-ollama-rag.git
cd langchain-ollama-rag
# 创建虚拟环境(推荐)
python -m venv .venv
source .venv/bin/activate # Windows: .venv\Scripts\activate
# 安装依赖
pip install -r requirements.txt
requirements.txt 核心依赖:
langchain
langchain-chroma
langchain-community
langchain-classic
fastapi
uvicorn
streamlit
pymysql
sqlalchemy
python-dotenv
五、项目结构
langchain-ollama-rag/
├── .env.example             # 环境变量模板
├── .gitignore               # Git 忽略配置
├── README.md                # 项目说明
├── requirements.txt         # Python 依赖
├── src/
│   ├── api.py               # FastAPI 接口层
│   ├── app.py               # Streamlit 前端页面
│   ├── config.py            # 配置读取
│   ├── constants.py         # 常量定义(Prompt、参数、安全校验)
│   ├── llm.py               # 大模型实例化(支持切换)
│   ├── rag.py               # RAG 检索 + 入库逻辑
│   ├── smart_agent.py       # 智能路由 + 工具调用 + 组合问题合并
│   ├── sql_agent.py         # Text-to-SQL 直连 MySQL
│   └── sync_mysql_to_chroma.py  # MySQL 数据同步到 Chroma
└── chroma_db/               # Chroma 持久化目录(自动生成)
六、配置与运行
1. 配置文件
复制 .env.example 为 .env,并填写真实配置:
cp .env.example .env主要配置项:
env
# Ollama 本地模型
OLLAMA_BASE_URL=http://localhost:11434
CHAT_MODEL=qwen2.5:7b
EMBED_MODEL=nomic-embed-text

# Chroma 持久化目录
CHROMA_DIR=./chroma_db

# MySQL 连接(Text-to-SQL 用)
MYSQL_DSN=mysql+pymysql://root:password@localhost:3306/rag_db

# 服务端口
STREAMLIT_PORT=8501
API_PORT=8000
2. 启动服务
终端 1 —— 启动 FastAPI 后端:
cd src
uvicorn api:app --port 8000
# 访问 http://localhost:8000/docs 查看 Swagger 接口文档界面如下:
终端 2 —— 启动 Streamlit 前端:
cd src
streamlit run app.py
# 访问 http://localhost:8501
界面如下:
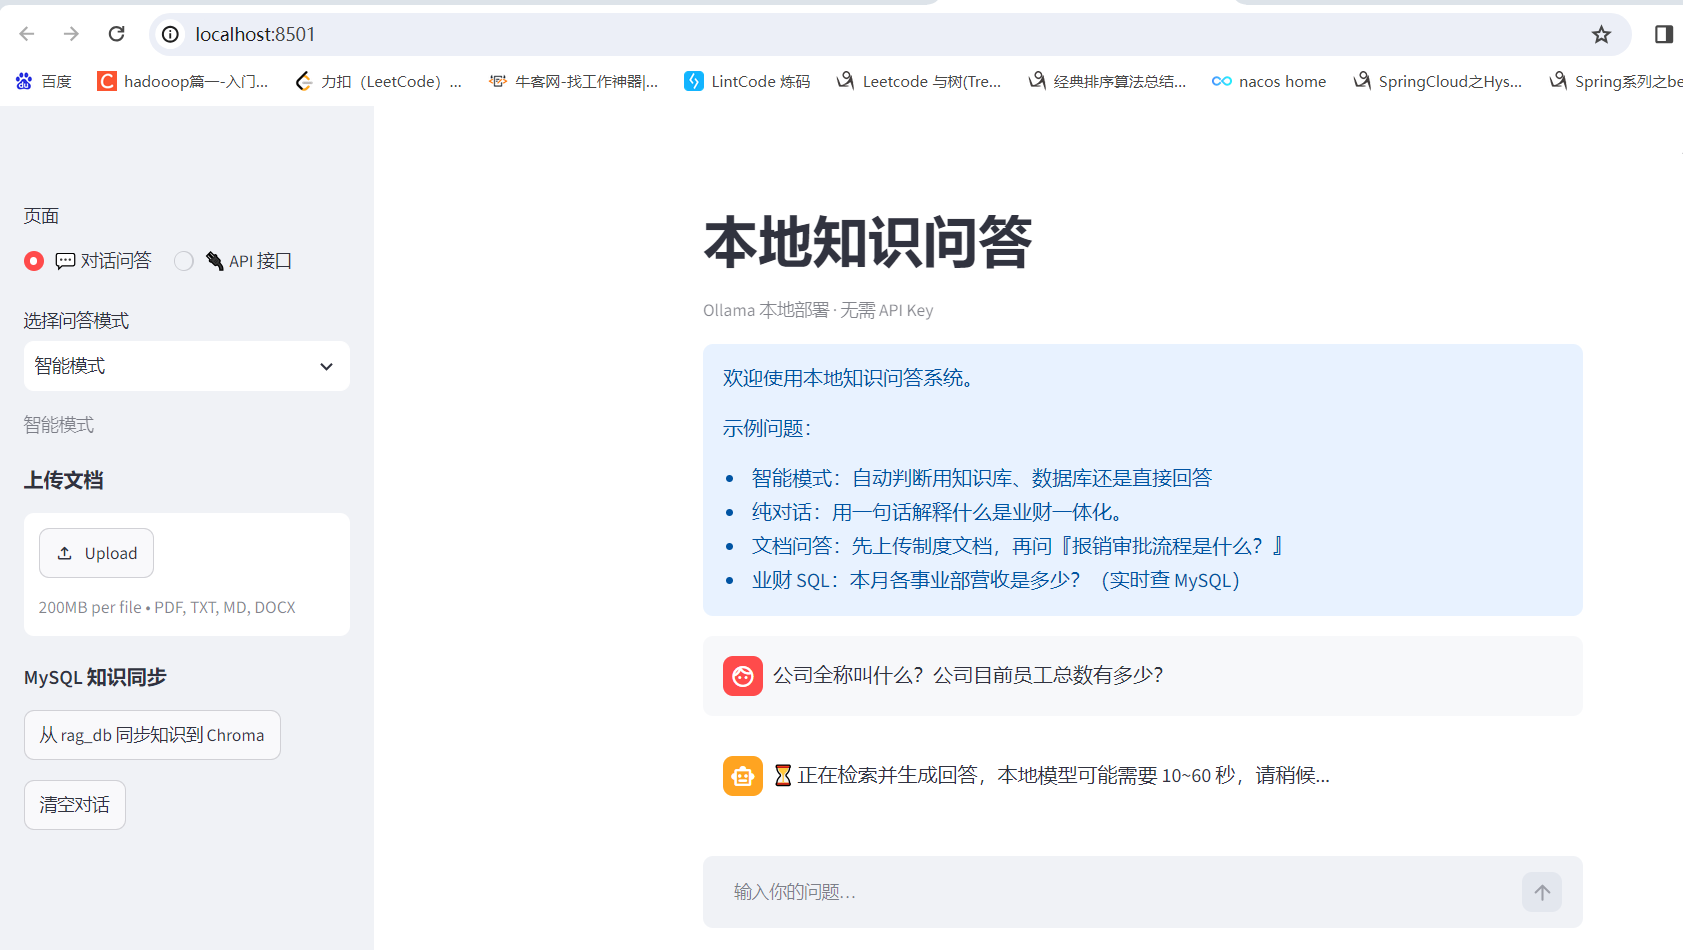
提问加载过程如下:
3. 同步 MySQL 知识数据(可选)
在 Streamlit 界面左侧边栏,点击「从 MySQL 同步知识到 Chroma」,即可将 knowledge_source 表的数据导入向量库。
七、接口验证
Swagger UI 在线测试
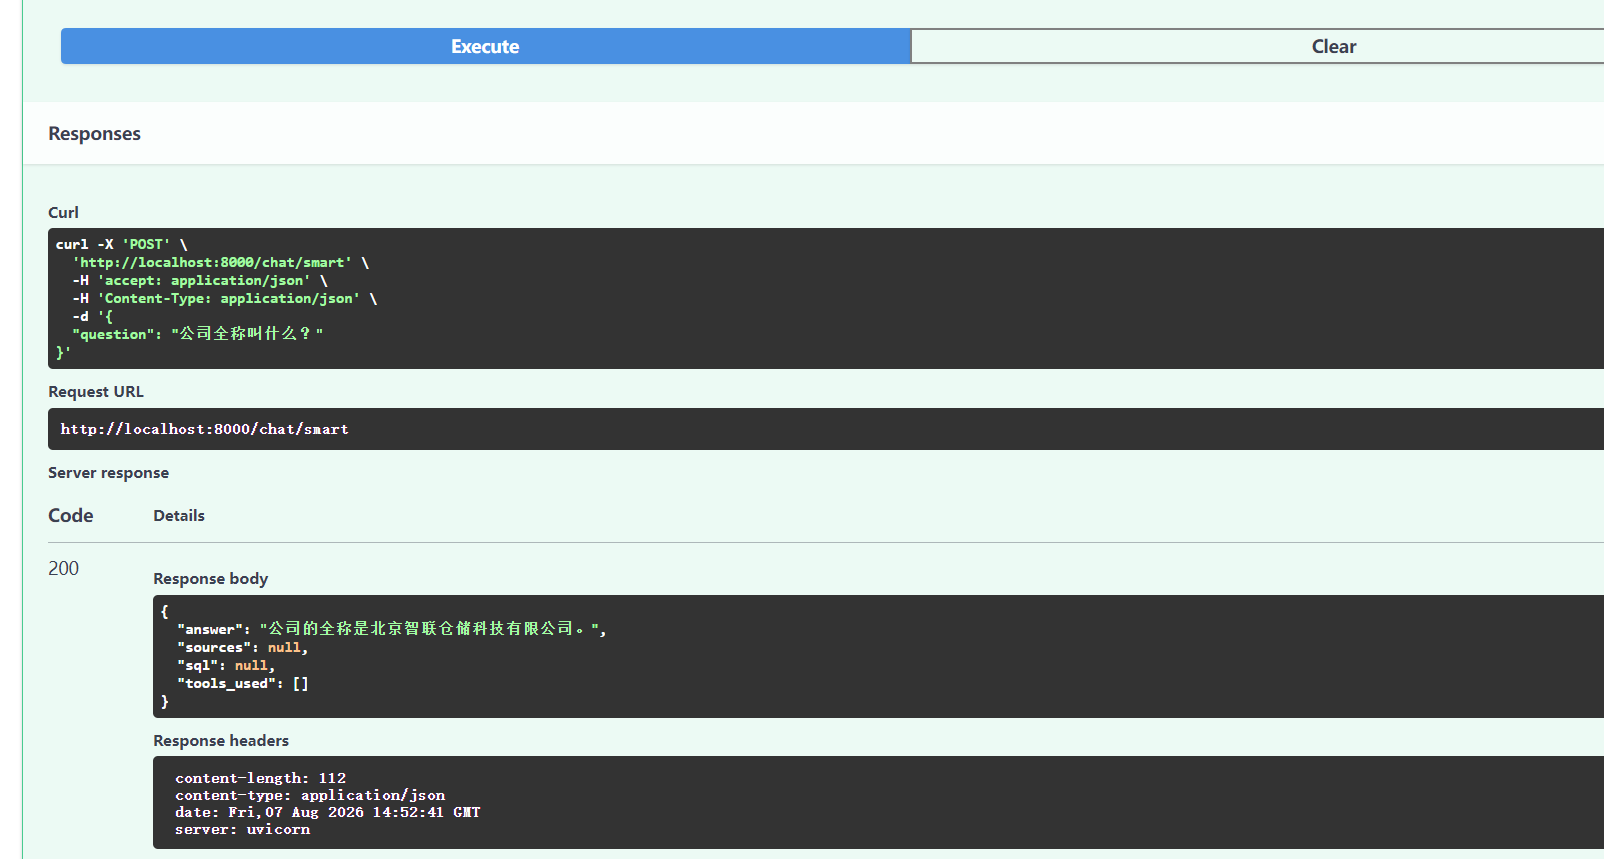
访问 http://localhost:8000/docs,点击 Try it out:
{
  "question": "公司全称叫什么?"
}
返回示例:
json
{
  "answer": "北京智联仓储科技有限公司",
  "sources": null,
  "sql": null,
  "tools_used": []
}
展示效果如下:
外部系统调用示例
curl -X POST "http://127.0.0.1:8000/chat/smart" \
     -H "Content-Type: application/json" \
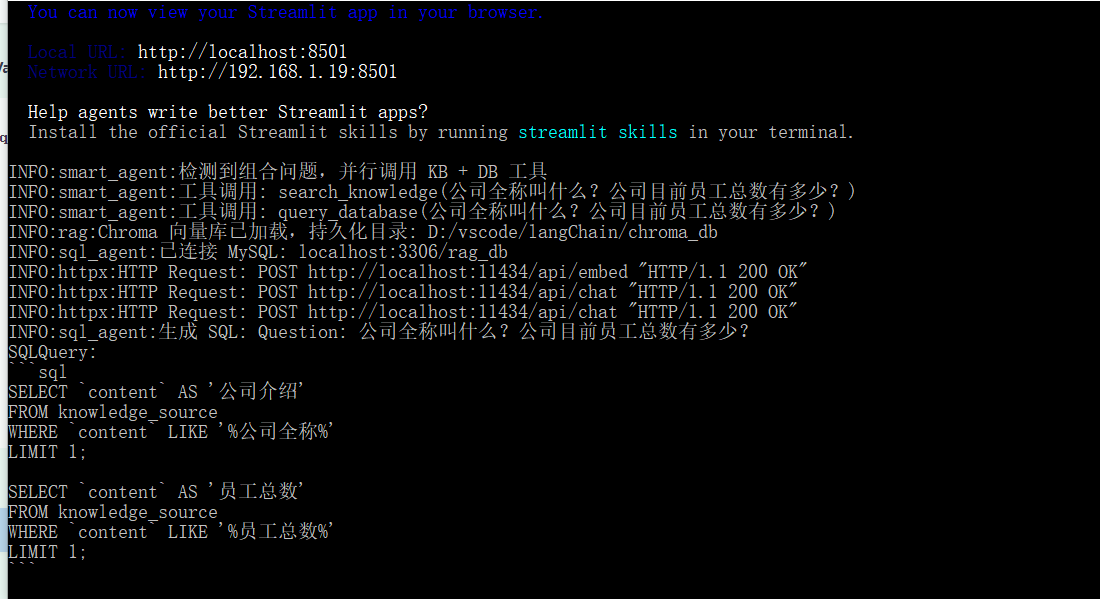
     -d '{"question": "公司目前员工总数是多少?"}'
后台加载过程如下:
八、核心逻辑解析
1. 智能路由设计
系统通过关键词预判问题类型:
python
_DB_KEYWORDS = ["员工总数", "总人数", "营收", "库存", "订单", ...]
_KB_KEYWORDS = ["制度", "流程", "规范", "部门", "全称", ...]
-
命中数据库关键词 → 走 Text-to-SQL 直查 MySQL
-
命中知识库关键词 → 走 RAG 检索 Chroma
-
两者都命中 → 并行执行,结果合并
-
都未命中 → 纯对话
选型思考:采用关键词轻量化路由,舍弃重型 Agent,降低本地大模型推理算力开销,适配离线低配服务器部署。
2. 组合问题并行执行
使用 ThreadPoolExecutor 并行调用知识库和数据库工具,减少串行等待时间。
选型思考:解决本地模型推理延迟高的痛点,多任务并发压缩整体问答耗时。
3. 无效结果过滤
当知识库返回"未找到"时,直接采信数据库结果,避免 LLM 被无信息干扰。
4. SQL 安全校验
三层防护:
-
白名单:只允许
SELECT语句 -
禁止危险关键词:
DROP、INSERT、UPDATE、DELETE -
防多语句注入
选型思考:面向企业内部业务库使用场景,杜绝 SQL 注入高危风险,满足内部系统安全管控要求。
九、常见问题
Q:问“总人数”查不到,问“员工总数”可以?
原因:Text-to-SQL 依赖精确字段映射,大模型无法自动推断“总人数”等于“员工总数”。
解决:增加查询改写层,在问题进入 SQL 生成前做同义词替换和兜底提示。
Q:本地推理速度慢怎么办?
-
使用 4-bit 量化模型:
qwen2.5:7b-instruct-q4_K_M -
简单结果(单行数字)跳过 LLM 解读
-
可替换为 DeepSeek API(目前免费),仅需修改一行配置:
# ===== Ollama 本地模型服务 =====
OLLAMA_BASE_URL=http://localhost:11434
CHAT_MODEL=qwen2.5:7b
EMBED_MODEL=nomic-embed-text:latest
# ===== DeepSeek API(快,需联网和 key) =====
# DEEPSEEK_API_KEY=your_key_here
# CHAT_MODEL=deepseek-chat拓展预留:整体架构预留配置层,后续可接入向量重排、Query 改写、多轮对话记忆、接口权限鉴权模块,直接迭代为生产可用版本。
十、参考文档与下载地址
| 工具 | 地址 |
|---|---|
| Ollama | https://ollama.com |
| Chroma | https://docs.trychroma.com |
| LangChain | https://python.langchain.com |
| FastAPI | https://fastapi.tiangolo.com |
| Streamlit | https://streamlit.io |
| 项目源码 | https://github.com/316959108/langchain-ollama-rag |
十一、总结
这个项目从环境准备到代码实现,完整走通了"本地知识库 + 智能路由 + 对外接口"的全链路。核心设计点包括:
-
Chroma 与 MySQL 并存的异构数据架构
-
组合问题的并行执行
-
无效结果的合并过滤
-
Text-to-SQL 的安全校验
整套系统完成了全链路私有化 AI 问答落地,解决了传统 RAG 无法兼容结构化业务数据库、Java/Python 异构系统打通困难、本地部署性能与安全平衡三大痛点。整套工程开箱即用,无论是个人学习大模型应用开发,还是企业内部业务知识库、业财数据问答原型搭建,都可以直接基于本项目二次开发。
系列博文联动:本项目为 Python 侧异构拓展实现,Java 原生业务落地版本可查看本人博客置顶文章《后端 AI 实战|SpringBoot+SpringAI+Ollama 私有化知识库搭建》,两套架构分别适配 Java 业务改造、Python 快速服务搭建两种场景,可根据业务技术栈自由选用、组合部署。
更多推荐

 7
 0
- 0


 已为社区贡献2条内容

所有评论(0)