
Claude Code 架构拆解:它到底是怎么把大模型变成编程 Agent 的
Claude Code 架构拆解:它到底是怎么把大模型变成编程 Agent 的
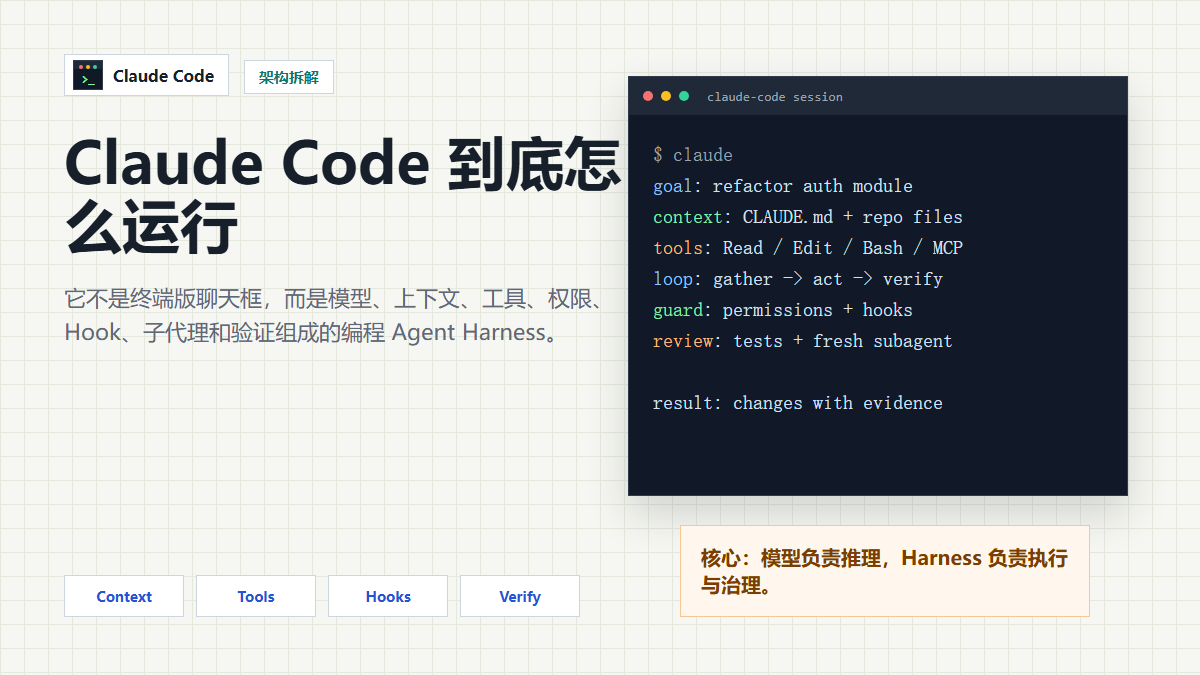
别把 Claude Code 理解成“会敲命令的聊天机器人”
很多人第一次看 Claude Code,会把它理解成:
Claude + 终端 + 自动改代码
这个理解能入门,但不够准确。
如果只是“模型能在终端里回答问题”,那它和普通聊天框差别不大。Claude Code 真正厉害的地方,是它把大模型放进了一个工程运行时里:
- 能读项目文件。
- 能搜索代码。
- 能编辑多个文件。
- 能运行测试和脚本。
- 能读取命令输出继续判断。
- 能通过权限系统控制风险。
- 能用 Hook 固定检查流程。
- 能通过 Skill 加载领域知识。
- 能用 Subagent 隔离大上下文探索。
- 能用 MCP 接外部工具和数据源。
- 能用 Worktree 隔离并行修改。
所以 Claude Code 的核心不是 Prompt,而是架构。
一句话概括:Claude Code 是围绕 Claude 模型构建的编程 Agent 运行时,模型负责推理,Harness 负责上下文、工具、权限、扩展、执行和验证。
下面我们按架构层次拆开。
一、最小心智模型:模型是大脑,Harness 是身体和工作台
Claude Code 官方文档里有一个很关键的说法:Claude Code serves as the agentic harness around Claude。
换成中文就是:Claude Code 是包在 Claude 模型外面的 Agent Harness。
你可以把它拆成两部分:
| 部分 | 负责什么 | 例子 |
|---|---|---|
| Claude 模型 | 理解意图、规划步骤、写代码、解释结果、根据反馈调整 | “应该先看 auth 模块,再改 middleware,再跑测试” |
| Claude Code Harness | 管理上下文、提供工具、执行命令、控制权限、记录会话、组织扩展 | Read、Edit、Bash、MCP、Hooks、Skills、Subagents |
这和人类程序员很像。
人脑负责思考,但真正完成工作需要工作台:
- IDE。
- 终端。
- Git。
- 测试框架。
- 文档。
- 权限。
- 代码规范。
- CI。
- Code Review。
Claude Code 做的事,就是给模型配了一套这样的工程工作台。
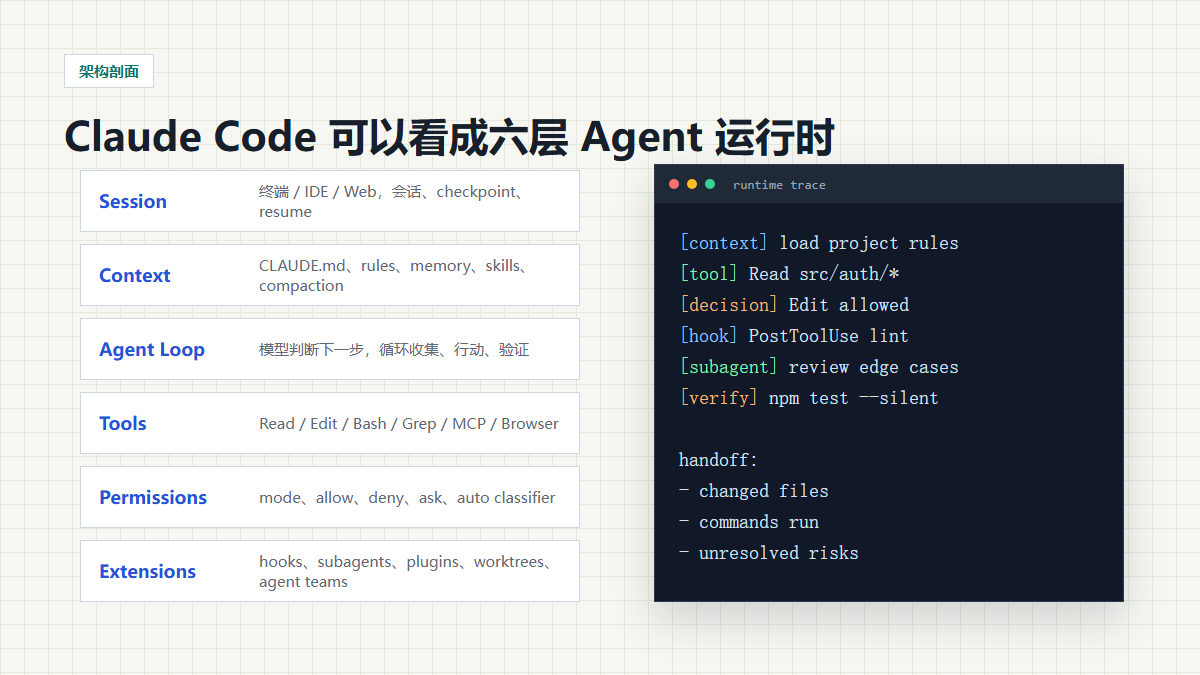
从架构上看,可以分成六层:
- Session 层:记录一次任务的对话、工具调用、文件变更和可恢复点。
- Context 层:决定模型每一轮能看到什么。
- Agent Loop 层:让模型循环收集上下文、行动、验证。
- Tool 层:把文件系统、Shell、Git、MCP 暴露成可调用工具。
- Permission 层:决定哪些动作允许、询问或阻断。
- Extension 层:用 Hooks、Skills、Subagents、Plugins、Worktrees 扩展工作流。
这六层合在一起,Claude Code 才能从“会回答”变成“能干活”。
二、Agent Loop:Claude Code 每轮到底在干什么
Claude Code 的执行循环可以压缩成三步:
- Gather Context:收集上下文。
- Take Action:执行动作。
- Verify Results:验证结果。
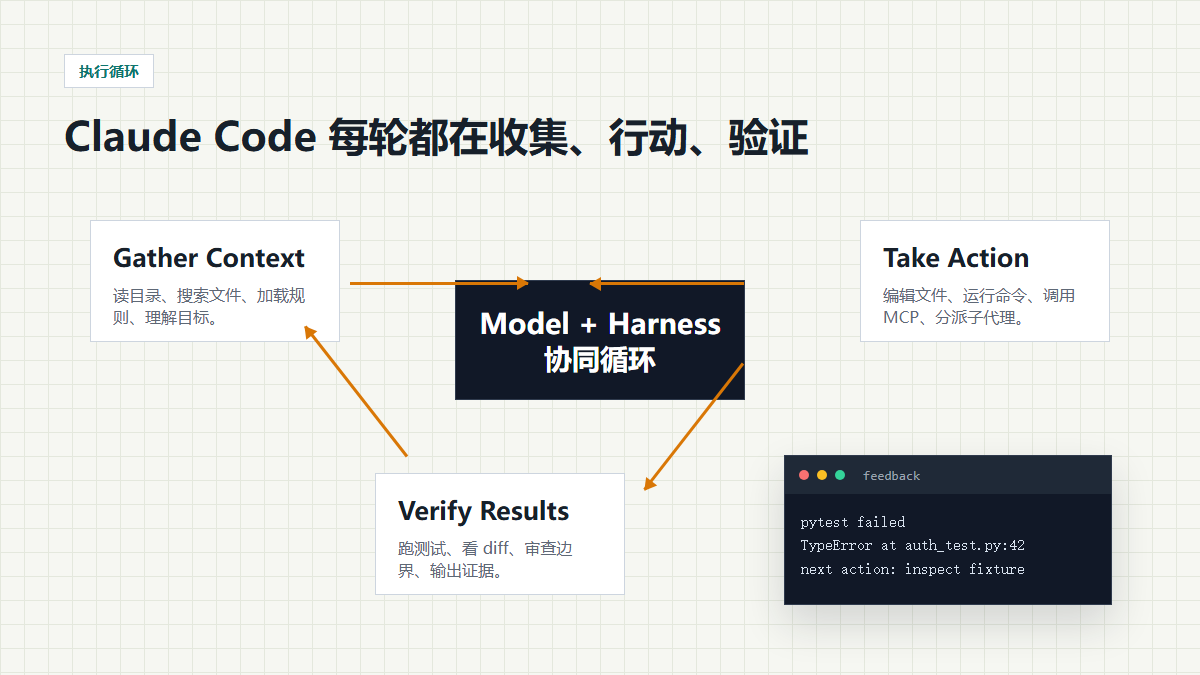
比如你让它修一个认证 bug,它可能会这样走:
读取 README 和 package.json
-> 搜索 auth 相关代码
-> 读取 middleware、controller、test
-> 判断 bug 来源
-> 修改代码
-> 运行测试
-> 根据失败信息继续改
-> 查看 git diff
-> 总结变更和验证结果
注意,这不是一次模型调用。
这是一个多轮循环。每一次工具结果都会重新进入模型上下文,影响下一步判断。
这也是 Claude Code 和普通代码问答最大的差别:
普通聊天:
用户问题 -> 模型答案 -> 用户自己执行

Claude Code:
用户目标 -> 模型判断 -> 工具执行 -> 环境反馈 -> 模型再判断 -> 验证完成
所以 Claude Code 的架构重点,不是“模型能不能写出代码”,而是“模型能不能在环境反馈里持续推进任务”。
三、Context 层:Claude Code 如何管理项目知识
编程 Agent 的第一瓶颈,通常不是模型不会写代码,而是上下文会变脏、变满、变乱。
Claude Code 的上下文窗口里会放很多东西:
- 对话历史。
- 用户当前任务。
- 文件内容。
- 命令输出。
CLAUDE.md。- rules。
- auto memory。
- 已加载的 Skills。
- MCP 工具名称和描述。
- 系统指令。
这些东西都很有用,但也都会占 token。
所以 Claude Code 里有几类上下文机制。
1. CLAUDE.md:项目级长期说明
CLAUDE.md 是 Claude Code 每次会话都会读取的项目说明文件。
它适合放:
- 项目启动命令。
- 测试命令。
- 特殊代码规范。
- 团队约定。
- 非显而易见的架构规则。
- 常见坑。
它不适合放:
- 所有接口文档。
- 所有业务背景。
- 冗长教程。
- 每个文件的解释。
- 模型自己读代码就能知道的内容。
原因很直接:CLAUDE.md 会进入上下文,太长会挤占当前任务空间,也会降低关键规则的遵循度。
2. Memory:跨会话记忆
Claude Code 的 memory 更适合记录长期偏好和反复出现的经验。
比如:
- “这个项目默认用 pnpm,不用 npm。”
- “API 测试前要启动本地 Redis。”
- “不要改 legacy-payment 目录,除非用户明确要求。”
Memory 的风险是过期。
所以它不能变成不可审计的黑箱。好的 memory 应该能被查看、编辑、删除。
3. Skills:按需加载领域能力
Skill 可以理解成一个能力包,通常包含:
SKILL.md指令。- references。
- scripts。
- templates。
- assets。
它和 CLAUDE.md 的区别是:CLAUDE.md 是每次都加载,Skill 是相关时再加载。
比如你不应该把“如何发布 npm 包”“如何写安全审计报告”“如何生成 PPTX”全塞进 CLAUDE.md。这些更适合做成 Skill。
4. Compaction:长会话压缩
长任务里上下文会逐渐接近上限,Claude Code 会通过 compaction 把历史压成摘要。
这解决了“继续做下去”的问题,但也带来风险:
- 临时口头约束可能被压丢。
- 嵌套目录里的局部规则可能需要重新触发。
- 大量工具输出会被摘要化。
- 早期决策如果没有落盘,后面可能变模糊。
所以工程实践里要把关键状态写进文件,而不是只留在聊天记录里。
比如:
docs/current-plan.md
docs/decision-log.md
docs/test-result.md
5. Subagent:上下文隔离
Subagent 最大的价值不是“多一个角色”,而是独立上下文。
主会话要实现功能时,可以让一个子代理去读几十个文件,最后只把结构化总结带回来。这样主上下文不会被大段原始文件污染。
典型用法:
- 研究陌生模块。
- 独立审查实现。
- 并行分析多个候选方案。
- 大量日志和文档读取。
- 写完后用 fresh context 做验证。
这就是 Claude Code 处理上下文压力的重要手段。
四、Tool 层:工具让模型能行动,但工具必须像 API 一样设计
没有工具,Claude 只能输出文字。
有了工具,Claude Code 才能:
Read:读取文件。Edit/Write:修改文件。Bash:执行命令。Grep/Glob:搜索代码。WebFetch/WebSearch:查资料。- MCP tools:访问外部系统。
- Agent tool:分派子代理。
这就是模型从“回答者”变成“执行者”的关键。
但工具不是越多越好。
工具越多,模型越容易选错。工具描述越模糊,模型越容易传错参数。工具返回越冗长,上下文越容易爆。
所以工具层要按 API 的标准设计。
一个好工具应该满足:
| 维度 | 要求 |
|---|---|
| 名称 | 具体、可区分,不要叫 doTask |
| 参数 | 字段名明确,避免 data、payload 这种泛名 |
| schema | 尽量结构化,减少模型猜格式 |
| 返回 | 只返回支持下一步判断的信息 |
| 风险 | 标明只读、写入、外部网络、破坏性操作 |
| 错误 | 错误信息要能指导下一步,而不是只返回失败 |
Anthropic 在工具工程文章里把工具称为 deterministic systems 和 non-deterministic agents 之间的 contract。
这个说法很准确。
普通函数是人调用的;Agent 工具是模型调用的。模型会犯错,所以工具要更清楚、更可审计、更难误用。
五、MCP 层:它解决连接问题,不解决全部架构问题
MCP 是 Claude Code 很重要的扩展方式。
它让 Claude Code 可以连接:
- GitHub。
- Figma。
- 数据库。
- 浏览器。
- Google Drive。
- 内部系统。
- 搜索工具。
- 工作流服务。
官方文档把 MCP 类比成 AI 应用的 USB-C 接口。这个类比很形象:它把外部数据源、工具和 workflow 接成标准接口。
但这里要小心一个误区:
MCP 是连接层,不是完整 Agent 架构。
接入 MCP 之后,仍然要解决:
- 哪些 MCP 工具能用?
- 哪些工具需要审批?
- 工具返回多大?
- 是否会把敏感数据带入上下文?
- 工具描述是否清楚?
- 结果如何验证?
- 调用失败怎么恢复?
所以 MCP 应该放在 Tool 层和 Permission 层之间看,而不是当成 Agent 的全部。
六、Permission 层:Claude Code 为什么必须有权限系统
Claude Code 能读写文件、运行命令、调用外部系统,所以权限系统不是可选项。
否则一个误解的指令,就可能变成真实破坏。
Claude Code 的权限机制可以分四块理解。
1. Permission Mode
常见模式包括:
| 模式 | 含义 | 适合场景 |
|---|---|---|
| default | 修改文件和有副作用命令前询问 | 日常稳妥使用 |
| acceptEdits | 自动接受文件编辑 | 明确范围内的快速编码 |
| plan | 只读探索和计划,不执行修改 | 代码评审、方案确认 |
| auto | 用分类器自动判断部分权限 | 长任务减少点击疲劳 |
| bypassPermissions | 跳过权限提示 | 只适合强隔离沙箱 |
真正的工程判断不是“哪个模式最爽”,而是“当前任务的风险边界是什么”。
2. Allow / Deny / Ask 规则
权限不能只靠临时点击。
团队应该把固定规则写进配置:
- 哪些命令默认允许。
- 哪些路径禁止读取。
- 哪些目录禁止修改。
- 哪些 MCP 工具必须询问。
- 哪些动作永远阻断。
例如:
{
  "permissions": {
    "deny": [
      "Read(./.env)",
      "Read(./secrets/**)",
      "Bash(rm -rf *)"
    ]
  }
}
这类规则比“请不要乱删文件”可靠得多。
3. Hooks
Hook 是 Claude Code 里非常关键的一层。
它可以在固定生命周期事件上执行脚本或逻辑。
比如:
PreToolUse:工具调用前检查风险。PostToolUse:工具调用后做审计或格式化。Stop:模型想结束时先跑测试。SubagentStop:子代理完成后记录结果。PermissionDenied:权限被拒绝时触发处理。
Hook 的重点是确定性。
不是提醒模型“记得测试”,而是直接跑测试;不是提醒模型“不要改生产配置”,而是在工具调用前拦截生产路径。
4. Auto Mode
Auto mode 是 Claude Code 为减少 approval fatigue 做的一种权限模式。
它大致思路是:低风险动作自动放行,高风险动作由分类器阻断或要求人类确认。
Anthropic 的工程文章里提到,auto mode 有两层防线:
- 输入层:工具结果进入上下文前,检查 prompt injection 风险。
- 输出层:工具调用执行前,用分类器判断动作是否越界。
这说明 Claude Code 的权限系统已经不只是“弹窗问用户”,而是在做风险分层治理。
但它也不是高风险场景的万能替代品。
涉及生产数据库、云资源、强破坏命令、敏感数据时,仍然需要更强的人工审查和环境隔离。
七、Extension 层:Skills、Hooks、Subagents、Plugins、Worktrees 分别干什么
Claude Code 的扩展能力很多,容易混。
可以按职责记。
| 扩展点 | 主要职责 | 一句话解释 |
|---|---|---|
CLAUDE.md | 项目长期规则 | 每次会话都要知道的项目约定 |
| Skills | 可复用领域能力 | 相关时加载的一套说明、脚本和资源 |
| Hooks | 确定性自动化 | 在生命周期事件上执行检查、阻断、审计 |
| MCP | 外部工具连接 | 把数据库、浏览器、Figma、GitHub 等接进来 |
| Subagents | 上下文隔离和并行 | 让独立任务在自己的上下文窗口里完成 |
| Plugins | 能力打包分发 | 把命令、agents、MCP、hooks、skills 打包给团队 |
| Worktrees | 文件变更隔离 | 并行开发时避免互相覆盖 |
| Agent teams | 多会话协作 | 多个 Claude Code 实例共享任务和消息 |
这几类不要混用。
比如:
- 项目规范写
CLAUDE.md。 - 发布流程写 Skill。
- 修改后必须跑测试写 Hook。
- 访问 GitHub 写 MCP。
- 大量代码调查用 Subagent。
- 并行改不同模块用 Worktree。
- 团队统一分发用 Plugin。
这样 Claude Code 的结构就清楚了。
八、长任务架构:为什么 Claude Code 不只是一次会话
Claude Code 这类工具真正难的不是改一个小函数,而是长任务。
长任务会遇到几个问题:
- 上下文越来越满。
- 早期目标被稀释。
- 日志和工具输出污染主会话。
- 模型过早收尾。
- 改了很多文件后难以回退。
- 人类中途离开后难以恢复。
- 子任务之间需要交接。
Anthropic 在 Managed Agents 和 long-running harness 文章里反复强调几个设计点:
- session:记录发生过的一切。
- harness:调用模型并路由工具调用。
- sandbox:给 Agent 一个执行代码和改文件的环境。
- structured artifacts:用结构化产物交接上下文。
- evaluator:用独立检查发现实现问题。
这也是你用 Claude Code 做大任务时应该学到的东西:
不要把所有关键状态留在聊天里。
更稳的做法是让 Claude Code 维护一些任务产物:
docs/plan.md
docs/implementation-notes.md
docs/test-report.md
docs/open-risks.md
然后每轮围绕这些文件推进,而不是靠模型记住所有历史。
九、用 Claude Code 的 6 个工程建议
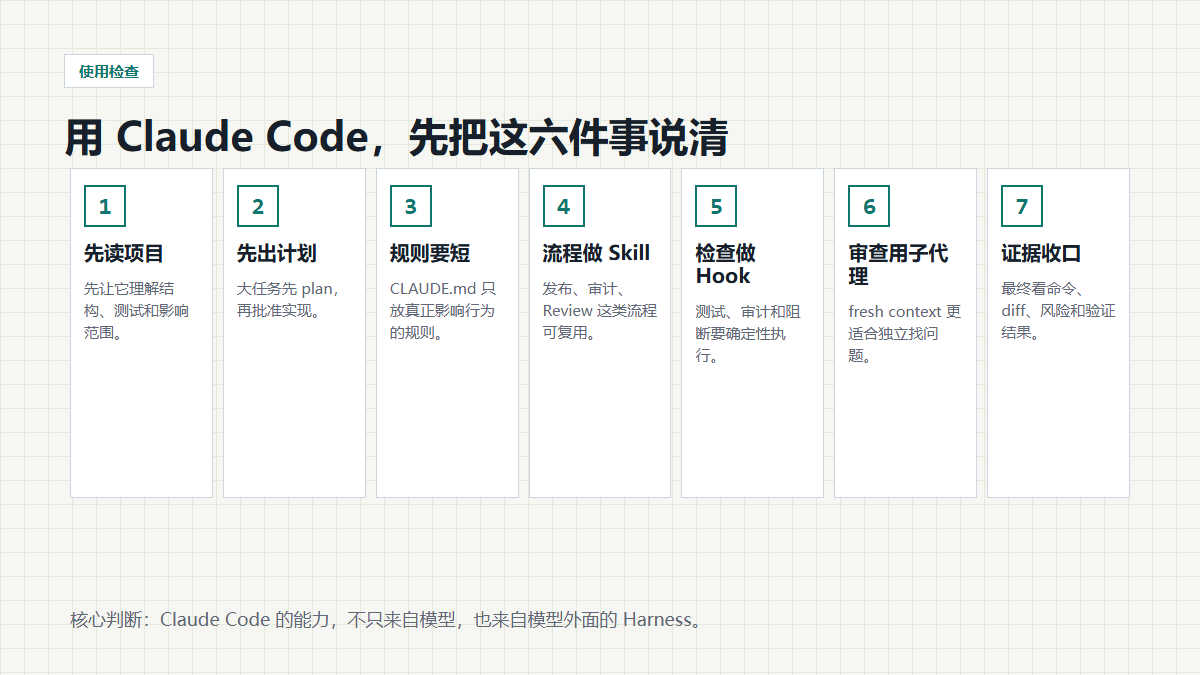
1. 先让它读项目,不要直接让它改
比如:
先阅读这个仓库的 README、package.json、测试目录和 auth 相关代码。
总结项目结构、认证链路、可能影响范围。不要修改文件。
这能降低它一上来乱改的概率。
2. 大任务先进入 plan 模式
让它先输出计划、影响文件、风险和验证命令。
计划确认后再进入实现。
3. 把项目规则写进 CLAUDE.md,但保持短
只写真正会影响行为的规则。
不要把文档库搬进去。
4. 把反复流程做成 Skill
比如:
- 发布检查。
- 接口审计。
- 安全 review。
- 数据库迁移 review。
- PR 描述生成。
这些流程不应该每次靠你重新解释。
5. 用 Hook 固定必须发生的检查
例如:
- 编辑后格式化。
- 结束前跑测试。
- 禁止改生产配置。
- 禁止读取
.env。 - 记录 MCP 高风险调用。
6. 用 fresh subagent 做审查
主会话写代码以后,让一个没参与实现的子代理审查。
它不会被前面的讨论带偏,更容易发现边界条件和安全问题。
十、最容易讲错的 5 个点
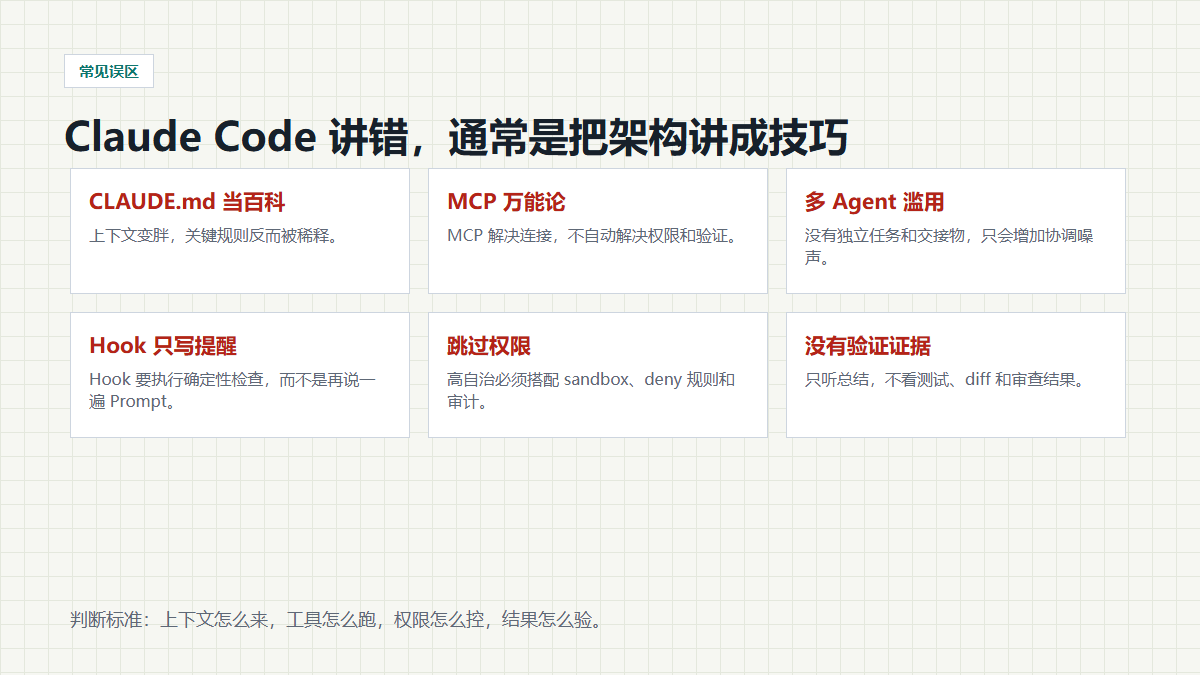
1. “Claude Code = 自动写代码”
不准确。
它是一个围绕代码工作流设计的 Agent Harness。写代码只是工具链里的一部分。
2. “CLAUDE.md 越详细越好”
不对。
太长会占上下文,也会让重点规则被稀释。真正需要时才加载的材料,应该做成 Skill 或文档引用。
3. “MCP 接上就等于完成架构”
不对。
MCP 只解决连接。权限、上下文、工具契约、审计、验证还要另外设计。
4. “Subagent 越多越专业”
不对。
Subagent 适合上下文隔离、并行探索和独立审查。小任务、强依赖任务、同文件修改不适合强拆。
5. “跳过权限才能发挥 Agent 能力”
很危险。
更稳的方式是 sandbox、allow / deny、auto mode、Hook、Worktree 和人工关键点审查。
总结:Claude Code 的本质是一套可执行的 Agent Harness
如果只记一个结论:
Claude Code 的架构核心,是把大模型放进一个受控工程环境里,让它围绕真实项目循环收集上下文、执行工具、验证结果,并通过权限、Hooks、Skills、Subagents 和 MCP 管理风险与扩展能力。
所以讲 Claude Code,不应该只讲“它能帮我写代码”。
更应该讲清楚:
- 它怎么拿上下文。
- 它怎么调用工具。
- 它怎么执行动作。
- 它怎么控制权限。
- 它怎么处理长任务。
- 它怎么隔离子任务。
- 它怎么验证结果。
这套结构才是 Claude Code 最值得学习的地方。
参考资料
- Claude Code Docs: How Claude Code works: https://code.claude.com/docs/en/how-claude-code-works
- Claude Code Docs: Explore the context window: https://code.claude.com/docs/en/context-window
- Claude Code Docs: How Claude remembers your project: https://code.claude.com/docs/en/memory
- Claude Code Docs: Choose a permission mode: https://code.claude.com/docs/en/permission-modes
- Claude Code Docs: Configure permissions: https://code.claude.com/docs/en/agent-sdk/permissions
- Claude Code Docs: Best practices for Claude Code: https://code.claude.com/docs/en/best-practices
- Claude Blog: How and when to use subagents in Claude Code: https://claude.com/blog/subagents-in-claude-code
- Anthropic Engineering: How we built Claude Code auto mode: https://www.anthropic.com/engineering/claude-code-auto-mode
- Anthropic Engineering: Harness design for long-running application development: https://www.anthropic.com/engineering/harness-design-long-running-apps
- Anthropic Engineering: Effective context engineering for AI agents: https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Anthropic Engineering: Writing effective tools for agents: https://www.anthropic.com/engineering/writing-tools-for-agents
- Model Context Protocol: What is MCP?: https://modelcontextprotocol.io/docs/getting-started/intro
更多推荐
 25
 0
- 0


 已为社区贡献16条内容

所有评论(0)