
C/C++内存管理修炼指南
1.C/C++的内存分布
1.1C/C++的程序内存区域划分
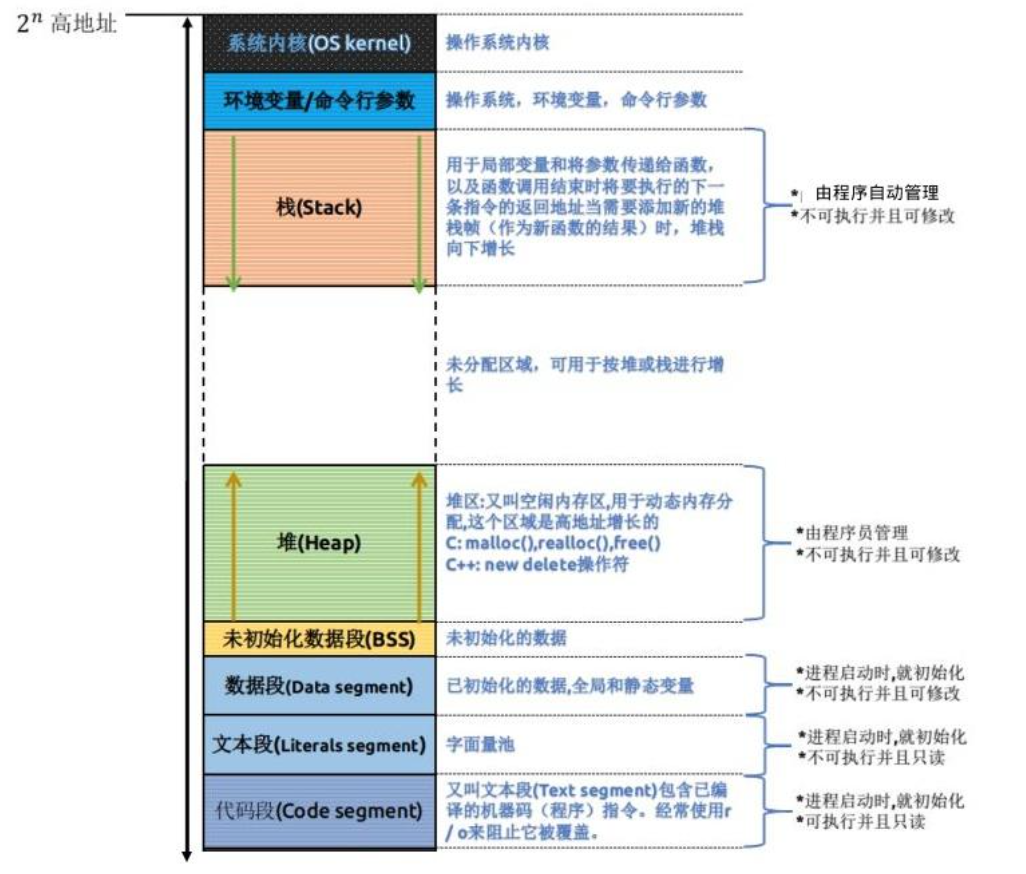
以上就是程序的内存区域划分;
用一个【厨房做饭】的比喻来理解
想象一下,一个程序就像一个厨师,而内存就是他的大厨房。进程内存管理,就是规定好:
固定工作区(栈):
(1)位置:厨房里有一个固定的、不大的台面。
(2)用途:厨师把正在做的菜的食材(局部变量)放在这里。比如切好的葱姜蒜。
(3)特点:用完即清。这道菜做完(函数调用结束),台面就会被清空,食材扔掉。井井有 条,但空间小。
灵活储物区(堆):
(1)位置:厨房旁边一个超大的、可以自由使用的仓库。
(2)用途:存放不常用但量大的食材。比如一整袋米、一大桶油(动态分配的大对象)。
(3)特点:需要自己管理。厨师要自己去仓库取米(malloc/new),并且用完要记得放回原 处或扔掉(free/delete),不然仓库会越来越乱(内存泄漏)。空间大,但管理麻烦。
菜谱和规则(代码段):
(1)位置:墙上贴着的菜谱。
(2)用途:告诉厨师每一步该做什么(程序的指令)。
(3)特点:只读,不能随便修改。
常备调料(数据段):
(1)位置:灶台边上的调料架。
(2)用途:放着盐、酱油等全局都用的调料(全局变量、静态变量)。
(3)特点:一直存在,从做饭开始到结束都在那里。
所以,内存管理的目的就是:
(1)隔离:保证每个厨师(进程)都有自己的独立厨房(内存空间),不会跑到别人的厨房里乱拿东西(防止程序崩溃或恶意修改)。(2)高效:让固定的工作(栈)快速完成,让灵活的需求(堆)有地可放。
(3)安全:菜谱(代码)不能随便改,防止做出黑暗料理。
值得注意的是栈是向下增长的 而堆是向上增长的,这是为什么呢?
栈:通常位于高地址区域,并随着数据的压入(如函数调用)向低地址方向增长。堆:通常位于低地址区域(代码段和数据段之上),并随着动态内存的分配(如 malloc, new)向高地址方向增长。而根本区别不在增长方向,而在内存管理上。
增长方向是它们不同管理策略和用途的物理体现。栈的LIFO特性决定了它简单、高效、自动的生命周期管理,而堆的灵活性则满足了动态、大容量内存的需求。相反的增长方向是一种巧妙的工程设计,目的是让这两种不同性质的内存区域能够高效、灵活地共享整个进程的地址空间。
总结来说就是,对于栈来讲,生长方向是向下的,也就是向着内存地址减小的方向;对于堆来讲,它的生长方向是向上的,是向着内存地址增加的方向增长。
1.2.1各个内存区域的特点
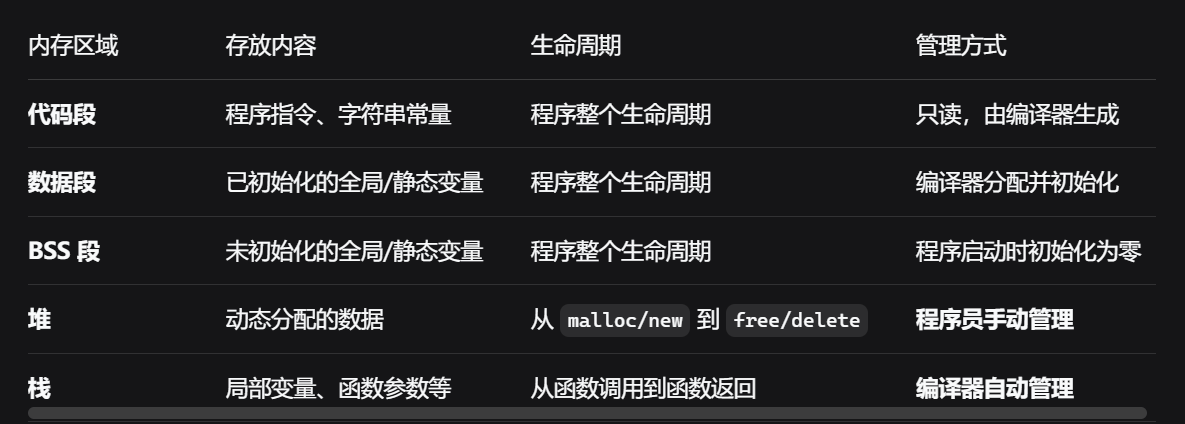
1.2.2在一段代码中的内存区域划分
#include <stdlib.h>
#include <string.h>

int global_var; // 未初始化 -> 存储在 BSS 段
int init_global_var = 10; // 已初始化 -> 存储在数据段

void func(int param)
{ // 参数 param 存储在栈上
    int local_var; // 局部变量 -> 存储在栈上
    static int static_var; // 未初始化的静态变量 -> 存储在 BSS 段

    char* str_literal = "Hello"; // "Hello" 是字符串常量,存储在代码段
                                 // str_literal 这个指针变量本身在栈上

    char* dynamic_mem = (char*)malloc(100); // 动态分配 100 字节 -> 存储在堆上
    strcpy(dynamic_mem, "World");

    free(dynamic_mem); // 程序员负责释放堆内存
}

int main()
 {
    func(5);
    return 0;
 }
2.C语言中动态内存管理方式:malloc/calloc/realloc/free
在C语言中,动态内存分配发生在称为堆heap的内存区域。堆与栈(Stack)不同:
栈:用于存储局部变量、函数调用信息等,由编译器自动管理,生命周期与作用域绑定。并且它的释放遵循后进先出(LIFO)的原则;
堆:一个更大的、结构相对松散的内存池,程序员可以手动申请和释放其中的内存块。这些内存块的生命周期完全由程序员控制。
2.1malloc的作用以及特点
(1)原型:void *malloc(size_t size);
(2)功能:向系统申请一块连续可用的、大小为 size 字节的内存。
(3)返回值:
成功:返回一个指向这块内存起始地址的 void* 指针。由于是 void*,通常需要强制转换为目标 类型。
失败(如内存不足):返回 NULL。
(3)内存状态:malloc 只负责分配内存,不初始化内存内容。这块内存中的数据是随机、不确定的(通常是之前使用留下的垃圾值)。
2.2calloc的作用以及特点
(1)原型:void *calloc(size_t num, size_t size);
(2)功能:为 num 个长度为 size 字节的对象分配连续的内存空间。
(3)返回值:与 malloc 相同。
(4)内存状态:calloc 不仅分配内存,还会将内存中的每一位都初始化为0。这对于数组和结构体非常有用。
2.3realloc的作用以及特点
(1)原型:void *realloc(void *ptr, size_t new_size);
(2)功能:调整之前通过 malloc, calloc, 或 realloc 分配的内存块的大小。
(3)参数:
ptr:指向原有内存块的指针。
new_size:新的目标大小(字节)。
(4)行为逻辑(非常重要!)
原地扩大:如果原内存块后面有足够的空闲空间,系统会直接在原地扩大这块内存,并返回与 ptr 相同的地址。
异地迁移:如果后面的空间不够,系统会:
a. 寻找一块足够大的新内存区域。
b. 将原内存块中的数据复制到新区域。
c. 释放原内存块。
d. 返回一个指向新内存区域的指针。
(5)返回值:一个指向重新分配后内存块的指针。这个指针可能与原指针不同,也可能是 NULL(表示调整失败)。因此,不要直接用原指针接收返回值,以免调整失败导致原指针丢失。
3.C++的内存管理方式
C++兼容C的malloc、realloc等,但不在推荐使用它们。这是因为
(1)类型不安全:返回的是void*,需要强制类型转换,
(2)不调用构造函数和析构函数:malloc 只分配内存,不会调用类的构造函数;free 只释放内 存, 不会调用析构函数。这对于带有资源的类(如string、vector)是灾难性的。
(3)代码冗长:需要手动检查返回值、计算大小
因此在此基础上,C++引入了new和delete这两个操作符来进行内存管理;
3.1new/delete操作内置类型
3.1.1new/delete的作用及特点
A.new/delete的作用
C++ 中的 new 运算符主要用于在堆(自由存储区)上动态分配内存。它的核心作用是: a.内存分配:向操作系统申请一块指定大小的内存。 b.对象构造:在分配好的内存上调用构造函数,初始化对象(对于类类型);delete的作用是 a.对象析构:调用对象的析构函数。 b.内存释放:将内存归还给操作系统。
B.new/delete的特点
a. 动态内存管理的核心 :new 和 delete 取代了 C 语言中的 malloc、calloc 和 free。与 C 函数相比,new 不仅分配内存,还会自动调用构造函数;delete 不仅释放内存,还会自动调用析构函数。这是最重要的区别。
b. 触发构造函数调用:这是 new 与 malloc 最根本的区别。当使用 new 创建一个类对象时,编译器会确保在内存分配成功后调用该类的构造函数。
voidTest()
{
  // 动态申请一个int类型的空间
  int*ptr4=newint;

  // 动态申请一个int类型的空间并初始化为10   int*ptr5=newint(10);

  // 动态申请10个int类型的空间
  int*ptr6=newint[3];
  deleteptr4;
  deleteptr5;
  delete[] ptr6;
}
new 返回的是正确类型的指针,不需要像 malloc 那样进行强制类型转换。3.1.1对于delete没有和new配套使用对于内置类型和自定义类型的区别
// 内置类型 - 相对安全(但不推荐)
char* p1 = new char[100];
delete p1; // 通常没问题// 自定义类型 - 严重错误
MyClass* p2 = new MyClass[10];
delete p2; // 只析构第一个对象,内存泄漏!
3.1.2C++ 对象析构顺序分析题
设已经有A,B,C,D4个类的定义,程序中A,B,C,D析构函数调用顺序为? ( )
C c;
void main()
{
A*pa=new A();
B b;
static D d;
delete pa;
}
动态对象:
delete时立即析构局部自动对象:所在作用域结束时析构(函数栈展开时)
局部静态对象:在 main 结束后、全局对象析构前析构(按构造逆序)
全局对象:在 main 结束后最后析构(按构造逆序)
因此顺序为: A B D C
4. operator new与operator delete函数
4.1operator new/new 以及operator delete /delete的区别
核心概念:它们是函数,不是操作符
首先要明确:operator new 和 operator delete 是函数,而不是 new 表达式和 delete 表达式。
operator new - 负责分配原始内存的函数
operator delete - 负责释放原始内存的函数
new 表达式 - 调用 operator new + 调用构造函数
delete 表达式 - 调用析构函数 + 调用 operator delete
4.2operator new与operator delete函数和malloc的关系
(1)相似之处
// 功能上等价
void* ptr1 = malloc(100);
void* ptr2 = operator new(100);

// 释放也等价
free(ptr1);
operator delete(ptr2);
(2)区别 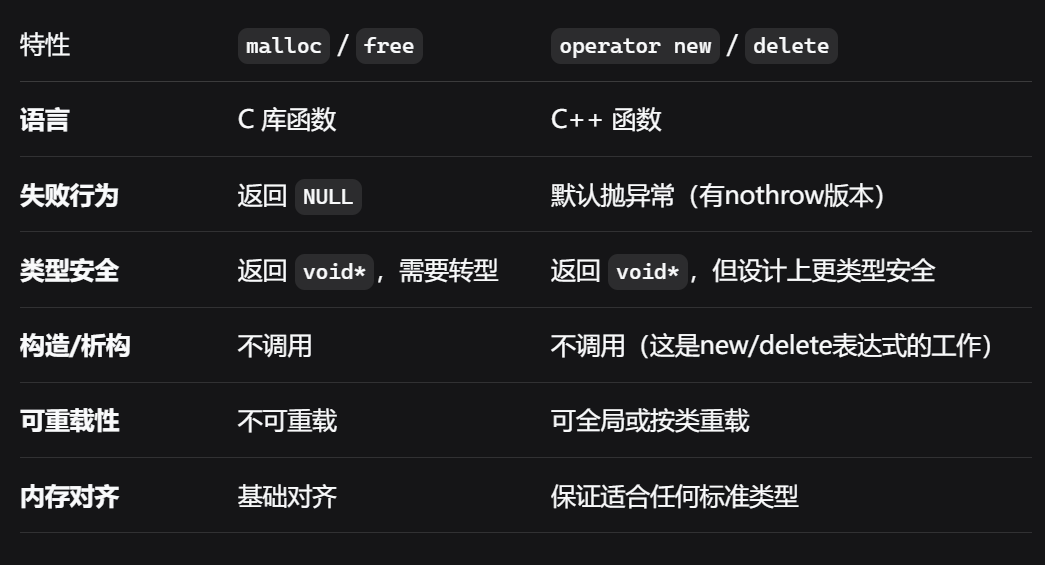
4.3operator new与operator delete函数的使用场景
✅ 需要自定义内存分配策略(内存池、对象池)
✅ 需要内存使用监控和调试
✅ 需要特殊对齐要求
✅ 实现放置new等高级特性
❌ 普通对象创建 - 直接用 new/delete 表达式
❌ 简单内存分配 - 考虑 std::vector、智能指针等更安全的替代品
5. 内存泄漏
5.1什么是内存泄漏
5.2内存泄漏的危害
6.内存管理一些容易混淆的点
6.1数组和指针的存储
// 情况1:数组 - 字符串在栈上
char char2[] = "abcd";
// *char2 = 'a' (在栈上)
//符合数组在栈上,数组元素也在栈上;
//数组变量在哪个区域,数组元素就在哪个区域
//因为数组是连续的内存块,元素与数组本身在同一内存区域。

// 情况2:指针 - 字符串在常量区
char* pChar3 = "abcd";
// *pChar3 = 'a' (在代码段/常量区);
所有用双引号表示的字符串字面量都存储在常量区
//字面量:字面量就是你在代码中直接写出来的那些固定值,比如数字、字符串、字符等。

char* pChar3 = "abcd";
// *pChar3 = 'x';
// 错误!试图修改常量区内容,会导致运行时错误
6.2sizeof 和strlen 在指针变量计算上的区别
对于 char *pchar3="abcd"这行代码
A. sizeof(pChar3) - 计算指针变量本身的大小
计算的是指针变量
pChar3占用的内存字节数在32位系统:指针占 4字节
在64位系统:指针占 8字节
与指针指向的内容无关
B. strlen(pChar3) - 计算指针指向的字符串长度
从指针指向的地址开始,统计字符直到遇到 '\0'
字符串 "abcd" 包含:'a', 'b', 'c', 'd', '\0'
有效字符数 = 4(不包括 '\0')
结果与系统位数无关,只与字符串内容有关
更多推荐
 16
 0
- 0


 已为社区贡献2条内容

所有评论(0)