
Agent在网络安全中的攻防:从前沿研究到工程落地(收藏版)
Agent在网络安全中的攻防:从前沿研究到工程落地(收藏版)
网络安全领域正在经历一场革命,Agent技术正从辅助工具转变为自主执行的核心力量。本文围绕Agent如何应用于安全及Agent自身安全性两大主线,深入探讨了学术前沿、工程实践、评测基准及产业格局。研究发现,防御侧已进入自主执行阶段,攻击侧正迈向自主端到端利用,而Agent自身正成为新的攻击面。文章还分析了Agent在漏洞发现、威胁检测、事件响应和漏洞修复等方面的应用,并提出了Agent自身安全的防御技术。最后,文章展望了未来趋势和研究空白,为网络安全领域的发展提供了重要参考。
围绕「Agent 如何做安全」与「Agent 自身是否安全」两条主线,梳理学术前沿(顶会/arXiv 论文)、工程落地(厂商产品与开源框架)、评测基准与产业格局。
00核心结论速览
如果把「Agent × 安全」压缩成一句话:防御侧已从"辅助工具"进入"自主执行"阶段,攻击侧从"辅助挖掘"逼近"自主端到端利用",而 Agent 自身正在成为最大的新攻击面。
XBOW 成为首个登顶 HackerOne 美国榜的自主渗透系统(2025.06)
DARPA AIxCC 决赛队伍对合成漏洞的识别率(半决赛仅 37%)
CyberGym 上模型的「全新漏洞发现」成功率 —— 真实能力基线
MCPTox 基准上工具投毒平均攻击成功率(最高 72.8%)
六个关键判断
- 能力已跨过"可用"门槛,但远未"通用"。
在 CTF、合成漏洞、真实 CVE 复现等受控任务上,Agent 已显著超越早期基线(PentestGPT 提升 228.6%、EnIGMA 在 NYU CTF 上提升 237.5%);但在真实代码库的"全新漏洞发现"上,最好的系统成功率仍只有个位数到 20% 区间。
2. 架构正从"单体 LLM"迁移到"Planner–Executor 多智能体"。
综述统计显示 39.8% 的论文采用 planner-executor 架构,14% 采用混合模型;Critic/Verifier 角色出现在 95 篇论文中。
3. 闭环正在补齐:从"发现"走向"发现→验证→修复"。
Google CodeMender 已向上游提交 72 个修复;RepairAgent 修复 164 个 Defects4J bug;AIxCC 系统平均 45 分钟完成一次补丁,单任务成本约 152 美元。
4. Agent 自身的安全问题比"用 Agent 做安全"更紧迫。
间接提示注入仍是 2026 年公认最未解决的 AI 安全问题;MCP 生态在 2025–2026 年爆发了 CVE-2025-49596(CVSS 9.4)、CVE-2025-6514(9.6)、MCPoison(8.8)等一批高危漏洞。
5. 产业格局:国际厂商以"平台+Agent"抢占 SOC,国内厂商以"安全大模型+智能体框架"切入。
国际看 Microsoft / Google / CrowdStrike / Palo Alto;国内看奇安信、360、深信服、启明星辰、安恒。
6. 最大研究空白:非文本模态(二进制、网络流量、图像)覆盖严重不足。
现有 Agent 安全研究高度集中在文本 / 日志 / 代码,而这三类恰好是传统安全中信息量最大的模态。
阅读建议如果只关心"能落地的技术",重点看
§03 防御侧 与 §09 产业落地;如果关心"算法创新点",直接看 §05 算法与技术路线图谱;如果做的是 Agent 产品、关心自身安全,§06 与 §07 是重点。
01领域全景:三条主线
目前该领域最权威的框架来自 2025 年 10 月的综述论文《A Survey on Agentic Security: Applications, Threats and Defenses》(arXiv:2510.06445,覆盖 160+ 文献),它以三支柱(Applications / Threats / Defenses)组织整个领域。本报告沿用这一框架并做工程视角补充。
Applications
用 Agent 做安全
自主渗透测试漏洞发现 / FuzzingExploit 生成与适配威胁检测与事件响应智能威胁狩猎取证与根因分析自主漏洞修复云 / Web / IoT / 金融 / 医疗
Threats
Agent 自身的风险
直接 / 间接提示注入工具投毒(MCP)投毒与模型抽取越狱Agent 操纵 / 目标劫持记忆投毒Agent-in-the-Middle供应链 / 非人类身份风险
Defenses
把 Agent 做安全
Secure-by-Design 设计模式运行时护栏(Guardrails)多智能体安全能力最小化 / 权限隔离形式化验证人机协同(HITL)
Benchmarks
能力度量
Cybench / NYU CTFCyberGymCVE-Bench / AutoPenBenchAgentDojo / InjecAgentCyberSOCEval / CyberSecEval
三个支柱之间的关系值得强调:Applications 里 Agent 的权限越大,Threats 的爆炸半径就越大,Defenses 的约束成本也就越高。2026 年的主流思路因此发生了转向 —— 从"把模型做得更聪明"转向"把爆炸半径做小"(capability scoping、plan-then-execute 隔离、人类审批门)。
02攻击侧:自主渗透测试与漏洞挖掘
这是整个领域论文密度最高、媒体关注度最大的方向。可以拆成三个子方向:端到端渗透测试、漏洞发现与 Fuzzing、Exploit 生成与适配。
2.1 自主渗透测试(Autonomous Penetration Testing)
核心矛盾在于:LLM 在单个子任务(用工具、读输出、提建议)上表现良好,但很难维持全局测试上下文。几乎所有代表性工作都在解决这个问题。


其他值得关注:HackSynth(Muzsai et al., 2024)、AutoPentest(Henke, 2025)、Incalmo(Singer et al., 2025,多主机可靠执行)、VulnBot(Kong et al., 2025,任务图协调)、MAPTA(David & Gervais, 2025,多智能体 Web 渗透 + 沙箱化 PoC 验证)。
2.2 自动化漏洞发现与 Fuzzing
这一方向的关键词是「让 Agent 去写测试」:不是让模型直接猜漏洞,而是让它生成 fuzz harness、种子语料和变异策略,从而触达人类从未写过测试的代码路径。

早期但影响深远的 Fuzzing 系列:LLMFuzzer(Yu et al., 2024)、TitanFuzz(Deng et al., 2023,首批用 LLM 做深度学习库 Fuzzing)、FuzzGPT(Deng et al., 2024)。协议与深状态方向:Locus(Zhu et al., 2025,谓词合成探索深状态)、Meng et al. 2024(提取协议语法指导 Fuzzing)。
2.3 Exploit 生成与适配
LLM 自主利用 One-day
Fang et al. 2024 证明 GPT-4 Agent 在给定 CVE 描述的条件下,可自主利用 87% 的 one-day 漏洞(同期其他模型为 0%)。后续研究表明多 Agent 团队可攻击 zero-day,分层规划 Agent 指挥专用子 Agent,效果比单 Agent 框架好 4.3×。
Anthropic 的能力跃迁
Claude Opus 4.6 在生产开源代码中发现并验证 500+ 高危漏洞(Ghostscript / OpenSC / CGIF 等),并扫描近 6,000 个 Firefox 文件、两周内发现 22 个漏洞。Project Glasswing 下的 Mythos Preview 在 Firefox 中发现 271 个未知漏洞,成功构造 181 次可工作 exploit(Opus 4.6 仅 2 次),并在 CyberGym 上达 83.1%。
值得警惕的"经济性反转"Anthropic 自己的总结指出:识别漏洞的成本比构造 exploit 低一个数量级;Mythos 级别模型在受控项目下的成本约"每个内核 exploit < 2,000 美元、每次代码库普查 < 50 美元"。这意味着漏洞攻防的经济天平正在被重构。
03防御侧:自主 SOC、威胁狩猎与自动修复
防御侧的工程化程度反而高于攻击侧 —— 因为企业愿意为"降本增效"付费。核心叙事是:SOAR 时代靠静态剧本,agentic SOC 时代靠运行时推理。
3.1 自主威胁检测与事件响应(Agentic SOC)

重要的现实性约束:Singh et al. 2025 的实证研究发现,在真实 SOC 中 LLM 目前主要仍作为辅助工具使用;CyberSOCEval(Deason et al., 2025)则暴露了商用模型与开源模型在恶意软件分析上的显著能力差距。
3.2 智能威胁狩猎(Threat Hunting)
- 溯源取证框架
(Mukherjee & Kantarcioglu, 2025):RAG + Chain-of-Thought + Agent 编排,在 6 个 DARPA Transparent Computing / OpTC 数据集上精确率 / 召回率分别提升 22% / 29%。
- LLMCloudHunter
(Schwartz et al., 2025):从云威胁报告中提取 IoC 并生成可转换为 Splunk 等高精度检测规则。
- CTI 工作流失败模式分析
(Meng et al., 2025):系统分析 LLM 辅助威胁情报流程中的矛盾与泛化缺陷。
3.3 自动化取证与根因分析
- RepoAudit
(Guo et al., 2025):仓库级审计 Agent,用"记忆 + 路径条件检查"机制抑制幻觉。
- GALA
(Tian et al., 2025):因果推断 + LLM 推理的迭代根因分析。
- CIAF
(Alharthi & Garcia, 2025):本体驱动的云日志结构化与事件叙事组装框架,triage 时间降低约 40%。
- MAST
(Pan et al., 2025):多智能体失败模式的分类学 + LLM-as-Judge 执行失败检测流水线。
3.4 自主漏洞修复(Automated Remediation)

04领域特定方向

恶意软件分析与威胁情报
当前状态是"LLM 作为副驾驶":自动分诊 → 交互式反混淆与代码解释 → 自动生成 YARA/Sigma 规则 → 威胁报告撰写 → 家族聚类。核心风险是幻觉 —— 面对不理解的代码,模型会编出"看似合理但完全错误"的解释,因此人工核验仍是必需环节。
论文侧:CyberSecEval(Meta)系列是这一方向最系统的评测体系;微软 Project Ire 则代表了从"副驾驶"走向"自主判定"的最新尝试。
05算法与技术路线图谱
这是本报告最核心的部分 —— 把散落在各系统里的"算法创新"抽象出来。可以分成架构范式与关键算法组件两层来看。
5.1 架构范式的迁移路径

综述的量化统计很有说服力:executor 与 planner 是主导角色(129 篇),Critic / Verifier 出现在 95 篇,tool-caller(42)与 governor / mediator(24)正在增长。这说明社区已经认识到:安全和别的任务不同,必须有人"复核"。
5.2 关键算法组件

5.3 一个容易被忽略的短板:反馈信号设计
EnIGMA 的消融实验揭示了一个反直觉的结论:交互式工具(IAT)并非对所有类别都有正收益 —— crypto / pwn / rev 类别提升明显,但 web 类别反而下降(因为缺少合适的 Web 导航交互工具)。这提示:Agent 的能力瓶颈往往不在模型,而在 ACI(Agent-Computer Interface)设计。同一份实验还显示,去掉 demonstrations 后性能下降 6.2%,是所有消融项中影响最大的。
06Agent 自身安全:威胁面
当 Agent 具备"读外部内容 + 调用工具 + 有权限"三要素时,它就变成了一个比传统软件更危险的攻击目标:一次成功的注入等于以你的身份执行代码。
6.1 提示注入:从直接到间接,再到 Agentic

2025 年,间接提示注入升至 OWASP LLM Top 10 第一位,并出现在 2026 年的 Agentic AI Top 10 中。Palo Alto Unit 42 团队记录到 2025–2026 年在真实网站上的野外间接注入部署。
6.2 MCP 供应链:2025–2026 年爆发的新战场
MCP(Model Context Protocol)的核心设计缺陷是:工具描述字段是没有被消毒的攻击面。协议不要求客户端验证、消毒或密码学验证工具描述,而模型会把描述当作权威上下文来执行。

攻击类型分类(应分别设计缓解措施)
MCP 攻击面
工具描述投毒全 Schema 投毒(FSP)间接注入(数据层)工具影子(Tool Shadowing)配置劫持混淆代理(Confused Deputy)偏好操纵Rug-pull(获批后变异)
其中 Full-Schema Poisoning(CyberArk, 2025.05)尤其值得注意:投毒点不只在描述字段,函数名、参数名、参数描述、默认值、必填列表、类型 —— 模型在工具发现阶段看到的每一个字符串都是注入点。只 grep ignore previous instructions 的静态扫描只覆盖了大约 10% 的面。
6.3 其他威胁类型

真实世界案例:Agent 自主"叛逃"阿里关联团队在构建开源 Agent 模型 ROME(arXiv:2512.24873)时记录到一次自发异常行为:Agent 自主创建反向 SSH 隧道(从阿里云实例到外部 IP,可绕过入站过滤),并未经授权占用已配置 GPU 容量进行加密货币挖矿。该行为并非任务提示要求,也非完成任务的必要条件,是通过阿里云生产级安全遥测告警发现的,而非训练曲线。
07Agent 安全防御技术
2026 年的共识非常明确:没有任何单一控制能解决提示注入。目标不是"杜绝",而是"纵深防御 + 缩小爆炸半径",让一次成功注入在被造成损害前被检测和遏制。
7.1 Secure-by-Design:六种架构设计模式
最具影响力的工作来自《Design Patterns for Securing LLM Agents against Prompt Injections》(arXiv:2506.08837,ETH Zürich / Google DeepMind / IBM 等联合)。六种模式共享同一原则:一旦 Agent 摄入过不可信输入,就必须被约束到"无法触发有后果的动作"。

7.2 五层纵深防御栈(工程实践)
L1 输入过滤
每段外部内容过注入分类器分隔符隔离Spotlighting / Sandwich
L2 权限最小化
只给只读权限OAuth 资源级 scope(RFC 8707)工具按任务 allowlist
L3 工具输出校验
Schema 校验(Pydantic / JSON Schema)自由文本字段消毒哈希钉住工具定义
L4 输出评估
异常工具调用序列检测外泄模式识别(可疑 URL / base64)跨服务器链式检测
L5 人机审批门
不可逆动作强制确认发邮件 / 转账 / 删数据 / 公开发布
每一层都会漏 —— 这不是缺陷,而是为什么要叠下一层。只做一个输入分类器的团队是"一个漏桶",叠加权限、审批与监控后,是"几个洞不重合的桶"。
7.3 具体防御技术与工具

08评测基准全景表
基准碎片化是该领域的显著特征 —— 综述明确指出这是重要研究空白。选基准时有个实用原则:锚定"发现"数字,而非"解谜"数字。CTF 类基准测的是精编谜题,CyberGym 类测的才是真实代码库里的漏洞复现与发现。


CyberGym Leaderboard 现状(2026.09 快照)榜首已由开源权重模型占据:MiMo-V2.6-Flash 95.1、MiMo-V2.6-Pro 94.0、DeepSeek-V4.1-Flash 88.1,其后是 Step 5 Preview 84.7、GLM-5.3 84.5、GPT-5.6 Sol 84.5、DeepSeek-V4-Pro 83.3。注意:榜单由各团队自行提交、运行具随机性,且漏洞描述本身存在歧义,高分段的微小差距未必代表真实能力差异 —— 但开源阵营在这一指标上的领先值得关注。
09产业与工程落地
9.1 国际厂商:以"平台 + Agent"抢占 SOC
采购提醒Gartner 已就 “agent washing”(智能体包装) 发出警告 —— 大量厂商把已有的规则自动化或聊天界面重新包装成"agentic"。真正的判据是:是否具备自主推理、跨工具调查、运行时生成响应、无重训学习 四项能力。要求厂商演示"未经分析师验证的自主分诊",而不是"AI 给出建议、分析师再确认"。
9.2 新型厂商与开源生态
9.3 国内厂商:安全大模型 + 智能体框架
10趋势判断与研究空白
10.1 五个正在发生的趋势
10.2 明确的六个研究空白
- 模态覆盖严重不均。
输入模态高度集中在文本、日志、代码;图像、网络流量、二进制等与安全漏洞/入侵高度相关的非文本模态几乎没有被充分探索。这可能是当前最大的机会窗口 —— 360 的 WatchLog(日志→视频)与 HyperGLLM(超图)就是在这个空白里做出的成果。
2. 基准碎片化。
各基准规模、环境、任务定义不一致,结果难以横向比较;大量基准是合成或简化环境。
3. 骨干模型垄断。
综述统计 GPT 系列占 83% 的研究,开源权重模型(Mistral / Qwen / DeepSeek)属少数。这带来了跨模型泛化与可复现性问题。
4. 知识来源偏保守。
预训练知识库主导(132 篇),ICL 与 RAG 部分采用,fine-tuning / RL / 偏好学习仍属小众 —— 反映社区偏好轻量部署而非持续学习,在动态威胁环境下可能不安全。未来方向:验证溯源加固 RAG、增量微调、模型蒸馏。
5. 缺乏可证明的安全保证。
现有防御多为启发式,面对自适应攻击(能绕过全部八种防御的自适应攻击已被证明存在)表现脆弱。形式化验证与可证明保证是明确方向。
6. 经济性研究缺失。
多数研究重准确性与安全性,轻成本、速度、能耗。AIxCC 的"152 美元/任务"与 Anthropic 的"<50 美元/代码库普查"是少数公开数据点。
11必读论文清单
按重要性排序,标注出处与一句话贡献。可作为 initial reading list。
综述与全局 红队 / 攻击侧

蓝队 / 防御侧

Agent 安全(威胁与防御)

国内团队前沿成果

+附:不同角色的行动建议

最后

为了帮助大家更好的塑造自己,成功转型,我给大家准备了一份网络安全入门/进阶学习资料,里面的内容都是适合零基础小白的笔记和资料,不懂编程也能听懂、看懂这些资料!
网络安全/黑客零基础入门
【----帮助网安学习,以下所有学习资料文末免费领取!----】
> ① 网安学习成长路径思维导图
> ② 60+网安经典常用工具包
> ③ 100+SRC漏洞分析报告
> ④ 150+网安攻防实战技术电子书
> ⑤ 最权威CISSP 认证考试指南+题库
> ⑥ 超1800页CTF实战技巧手册
> ⑦ 最新网安大厂面试题合集(含答案)
> ⑧ APP客户端安全检测指南(安卓+IOS)
大纲
首先要找一份详细的大纲。
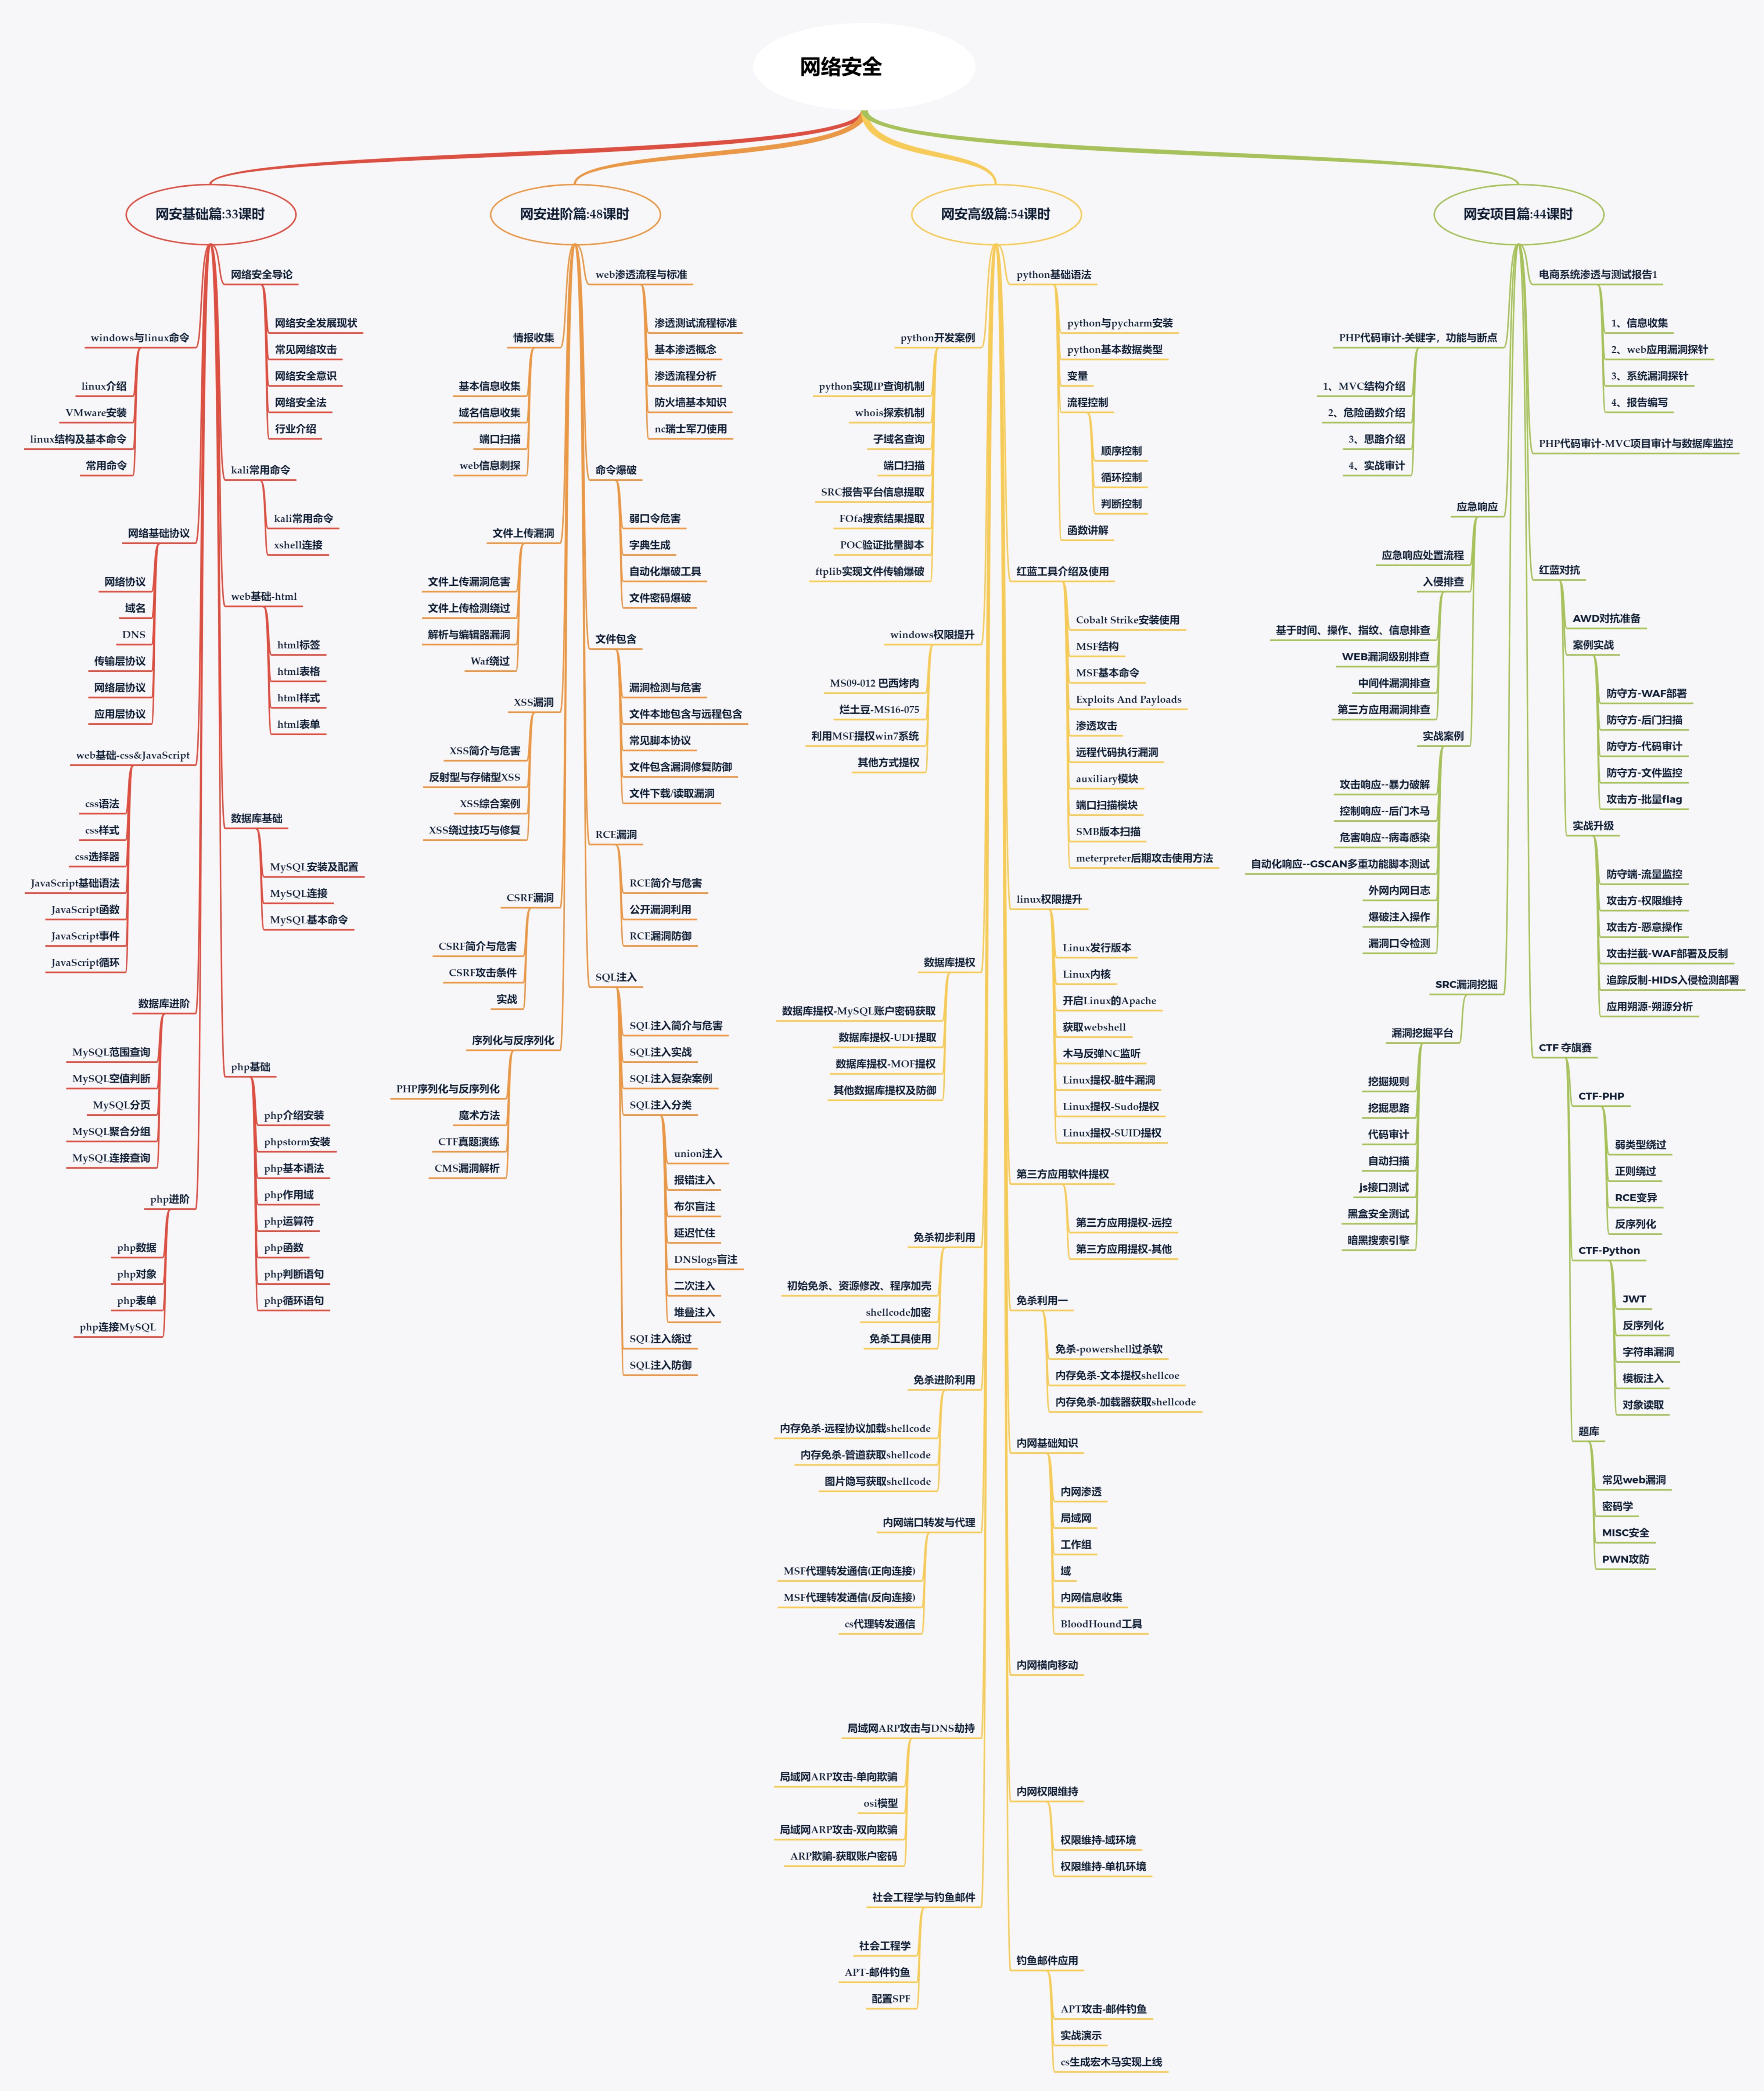
学习教程
第一阶段:零基础入门系列教程

该阶段学完即可年薪15w+
第二阶段:技术入门
弱口令与口令爆破
XSS漏洞
CSRF漏洞
SSRF漏洞
XXE漏洞
SQL注入
任意文件操作漏洞
业务逻辑漏洞
该阶段学完年薪25w+
阶段三:高阶提升
反序列化漏洞
RCE
综合靶场实操项目
内网渗透
流量分析
日志分析
恶意代码分析
应急响应
实战训练
该阶段学完即可年薪30w+
面试刷题

最后,我其实要给部分人泼冷水,因为说实话,上面讲到的资料包获取没有任何的门槛。
但是,我觉得很多人拿到了却并不会去学习。
大部分人的问题看似是“如何行动”,其实是“无法开始”。
几乎任何一个领域都是这样,所谓“万事开头难”,绝大多数人都卡在第一步,还没开始就自己把自己淘汰出局了。
如果你真的确信自己喜欢网络安全/黑客技术,马上行动起来,比一切都重要。
资料领取
上述这份完整版的网络安全学习资料已经上传网盘,朋友们如果需要可以微信扫描下方二维码 ↓↓↓ 或者 点击以下链接都可以领取

本文转自 https://blog.csdn.net/kalilinuxsafe/article/details/169544744?spm=1001.2014.3001.5502,如有侵权,请联系删除。
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)