
大模型「失忆」怎么办?收藏这份保姆级教程,小白也能给AI装上超强记忆!
本文探讨了大模型「失忆」的原理,分析了其四层记忆结构,并介绍了三种核心记忆管理策略:截断、总结、检索。文章以LangChain框架为例,阐述了工程实现路径,并提供了精确控token和向量检索的实战方案
一、为什么大模型会「失忆」
大模型很聪明,但「记性」差得离谱:你问它任何一句,它对上一句毫无印象——除非你把历史一条条重新喂给它。这就是所谓「无状态」。本文从机制讲起,把大模型的记忆分成几个层次,再落到 LangChain 这类框架的工程实现上,讲清楚「怎么给 AI 装上记忆」。
从原理上说,Transformer 的前向传播是纯函数式的:输入一串 token,输出下一串 token,算完就结束,模型内部没有任何「状态」被保留下来。它不像人脑有海马体,也不像传统程序有全局变量。所谓「对话」,其实是你每次把历史重新拼一遍、再调用一次模型,前面说了什么,它一概不记得,得靠你原封不动地再传一遍。
最简单粗暴的做法,是把所有历史消息塞进 messages 数组一股脑丢给模型。这有两个致命缺陷:一是上下文窗口有限(比如 200k token),塞多了超限、塞满了费钱;二是每轮请求都重复发送全部历史,对话越长,延迟和成本线性上涨。所以记忆管理的目标就一句话:在有限的脑容量里,保留最有用的信息。
「失忆」在真实产品里不是小问题:多轮客服会答非所问,个人助手记不住你的偏好,长文档问答读到后面忘了前面,Agent 执行多步任务时常常「忘了自己在干什么」。而一旦你想让它「记住」,就得自己搭一套记忆机制——这正是本文要拆解的东西。

图 1:LLM 无状态,历史必须原样重新传入
二、记忆的分层:大模型的「脑结构」
要设计记忆系统,先得看清大模型有几层「记忆」。
最底层是参数记忆。训练时学到的知识就固化在权重里,这是它的长期记忆,但它是「隐式」的——你没法精确说它记住了哪句话,也没法随时增删,只能靠微调或继续预训练来整体更新。
往上一层是上下文窗口,这是模型唯一能直接读写的「工作记忆」。它的容量由训练时的位置编码长度决定,虽然现在动辄几十万 token,但注意力计算是 O(n²) 的,窗口越大、算得越慢越贵,所以它不是无限扩张的免费资源。
推理时还有个 KV Cache,缓存了已生成 token 的键值对。它的本质是为避免重复计算的「草稿纸」,是加速手段,不是真正的记忆——会话一结束它就没了。再往外,是外部记忆:数据库、文件、向量库,它们持久、可检索、可跨会话,是真正意义上「长期记忆」的载体。
理解了这四层,就会明白:所谓「给大模型装记忆」,本质是把「塞不进窗口的、需要长期保留的」信息搬进外部记忆,再按需「召回」进窗口。
这里还有个反直觉的坑:就算你把所有历史都塞进了窗口,模型对「中间」内容的注意力也会明显衰减,学界管这叫「Lost in the Middle」。所以窗口大不等于记得牢,关键信息得放在最前或最后,或者干脆靠检索把它提到眼前。

图 2:大模型的四层记忆
三、三种核心策略:截断、总结、检索
不管是自研还是用 LangChain,记忆管理逃不出三种思路。
截断(Truncation):只保留最近 N 条或 N 个 token,简单粗暴,适合短期对话。它几乎零成本,代价是丢掉早期上下文——一旦对话里某个早期设定很重要,它就会被无情抛弃。
总结(Summarization):每隔一段轮数,调一次LLM 把历史压缩成摘要,用摘要替换原始消息。它省 token 又保留核心事实,但摘要本身是「有损」的,细节会丢,还多了一次 LLM 调用的成本和延迟。
检索(Retrieval):把历史消息或文档嵌入成向量存进向量库,每次提问用问题向量去召回最相关的几条,拼进 prompt。这是长期记忆的「终极方案」——按需召回,而不是一刀切地保留或丢弃;代价是引入了向量库、嵌入模型这套额外基础设施。
三者的关系不是互斥,而是分工:截断管「短期流畅」,总结管「中期压缩」,检索管「长期智能召回」。
拿客服机器人举例:最近几轮用「截断」保持流畅;对话超过几十轮就用「总结」把前半段压成摘要、替换原始消息;用户的历史订单、偏好这些散落信息,提前存进向量库,一提到相关话题就「检索」回来。三种策略在同一套系统里各司其职。

图 3:记忆管理的三种核心策略
四、从内存到磁盘:LangChain 的工程路径
落到代码上,LangChain 给出了一条清晰的进化线。消息本身分三种:SystemMessage 定「人设」(比如「你是客服助手」),HumanMessage 是用户输入,AIMessage 是模型输出,三者一起构成历史记录。
最轻量的是 InMemoryChatMessageHistory,把消息存在 RAM 里,进程重启就丢,只适合单次会话。用法上有个容易忽略的点:模型返回的 AIMessage 必须主动存回 history,否则下一轮它就「失忆」了;而 SystemMessage 每次请求都要带上才持续生效。取历史用 history.getMessages(),返回的是按添加顺序排列的消息数组,调用模型前要把它和 systemMessage 合并成完整列表。
from langchain_core.messages import SystemMessage, HumanMessage, AIMessagefrom langchain_core.chat_history import InMemoryChatMessageHistory
history = InMemoryChatMessageHistory()history.add_message(SystemMessage(content="你是客服助手,语气友好"))history.add_user_message("我的订单什么时候发货?")history.add_ai_message("您的订单预计明天发出。")
# 调用模型前:人设 + 历史合并成完整消息列表messages = [SystemMessage(content="你是客服助手")] + history.get_messages()
要跨会话(用户第二天回来还记得),就用FileSystemChatMessageHistory,把消息序列化成 JSON 落盘,用 sessionId 区分不同用户,新消息会追加到文件末尾。
fromlangchain_community.chat_message_histories import FileSystemChatMessageHistoryhistory = FileSystemChatMessageHistory( file_path="chat_history.json", session_id="user_001", # 用 sessionId 区分不同用户)history.add_user_message("记住:我喜欢红色")history.add_ai_message("好的,已记住")

图 4:LangChain Memory 的工程进化线
五、精确控 token:trimMessages + tiktoken
截断看似简单,按「条数」切其实不精确——有的消息很长有的很短,同样条数占用的 token 可能天差地别。更靠谱的是按 token 数截断:用 trimMessages 从末尾逆向累积 token 直到上限,配合 tiktoken 精确计数。
这里的关键认知是:不同模型分词器不同,GPT-4 用 cl100k_base,其他模型各有各的 BPE 词表。只有用匹配的编码器才算得准 token,避免「以为没超限、实际已经爆了」。这也是为什么不能用简单的 len(content) 去估算——一个中文字在有的分词器里可能是 1 个 token,在另一些里可能是 2 到 3 个。
import tiktokenfrom langchain_core.messages import trim_messages
enc = tiktoken.get_encoding("cl100k_base")   # GPT-4 / GPT-3.5 的分词器
def count_tokens(msgs):    text = "/n".join(m.content for m in msgs)    return len(enc.encode(text))
trimmed = trim_messages(    messages,    max_tokens=2000,    token_counter=count_tokens,    strategy="last",        # 从末尾逆向累积保留    include_system=True,    # 人设始终保留)
六、长期记忆的终局:向量检索
当对话长到几百条,截断和总结都会丢失或模糊早期细节。向量检索的思路是:把历史嵌入成向量存进 Milvus 这类向量库,提问时用问题向量做相似度检索,召回最相关的几条拼进 prompt。它跳出了「保留还是丢弃」的二元困境,变成「按需召回」。这也是当前 Agent 长期记忆的主流方向——配合周期性总结,既控制 token,又不丢关键上下文。
from langchain_community.vectorstores import Milvusfrom langchain_openai import OpenAIEmbeddings
vectorstore = Milvus(    embedding_function=OpenAIEmbeddings(),    connection_args={"uri": "http://localhost:19530"},)vectorstore.add_documents(history_docs)     # 历史/文档嵌入入库
retrieved = vectorstore.similarity_search("用户偏好红色", k=4)# 把检索结果拼进 prompt,实现按需召回
再往前看一步,就是 MemGPT、Generative Agents 那套「分层记忆」的思路:给模型配一个能自己调度的记忆管理器,像操作系统换页一样,在「主上下文」和「外部存储」之间自动搬运。这把记忆从「静态配置」升级成「主动管理」,是 Agent 长期记忆的下一站。
但向量检索也不是万能的:纯语义召回可能漏掉「时间顺序」这类信息——比如「我上一轮说的那个」靠相似度未必找得回来。所以工程上常把「向量召回」和「按时间保留最近几条」叠加使用,语义负责「相关性」,时间负责「新鲜度」。

图 5:实战中的组合拳记忆工作流
七、选型与工程实践
选型没有银弹,看场景下菜:
单次对话、轻量:InMemoryChatMessageHistory。
跨会话、低频访问:FileSystemChatMessageHistory。
严格控 token 开销:trimMessages + tiktoken。
长对话保核心信息:周期总结+ 截断结合。
大规模智能检索:向量库 + 嵌入召回(Milvus 等)。
实践中几乎都是组合拳:短期用内存保证流畅,定期落盘持久化,用截断或总结控制窗口,关键历史进向量库做长期召回。判断什么时候该上向量库,可以看两个信号:历史量是否大到截断和总结已经撑不住,以及召回是否真的需要「按相关性」而不是「按时间」。如果只是要最近几条,截断就够了,别为了上向量库而上向量库。
结语
大模型的记忆,说到底是一套「搬运」的艺术:把有限的窗口让给当下最需要的信息,把过去放进外部存储,需要时再拿回来。理解了这层,你就不会再把「记忆」当成一个黑盒,而是能按自己的场景,搭出一套从「金鱼脑」到「大象记忆」的工程方案。
如何学习AI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

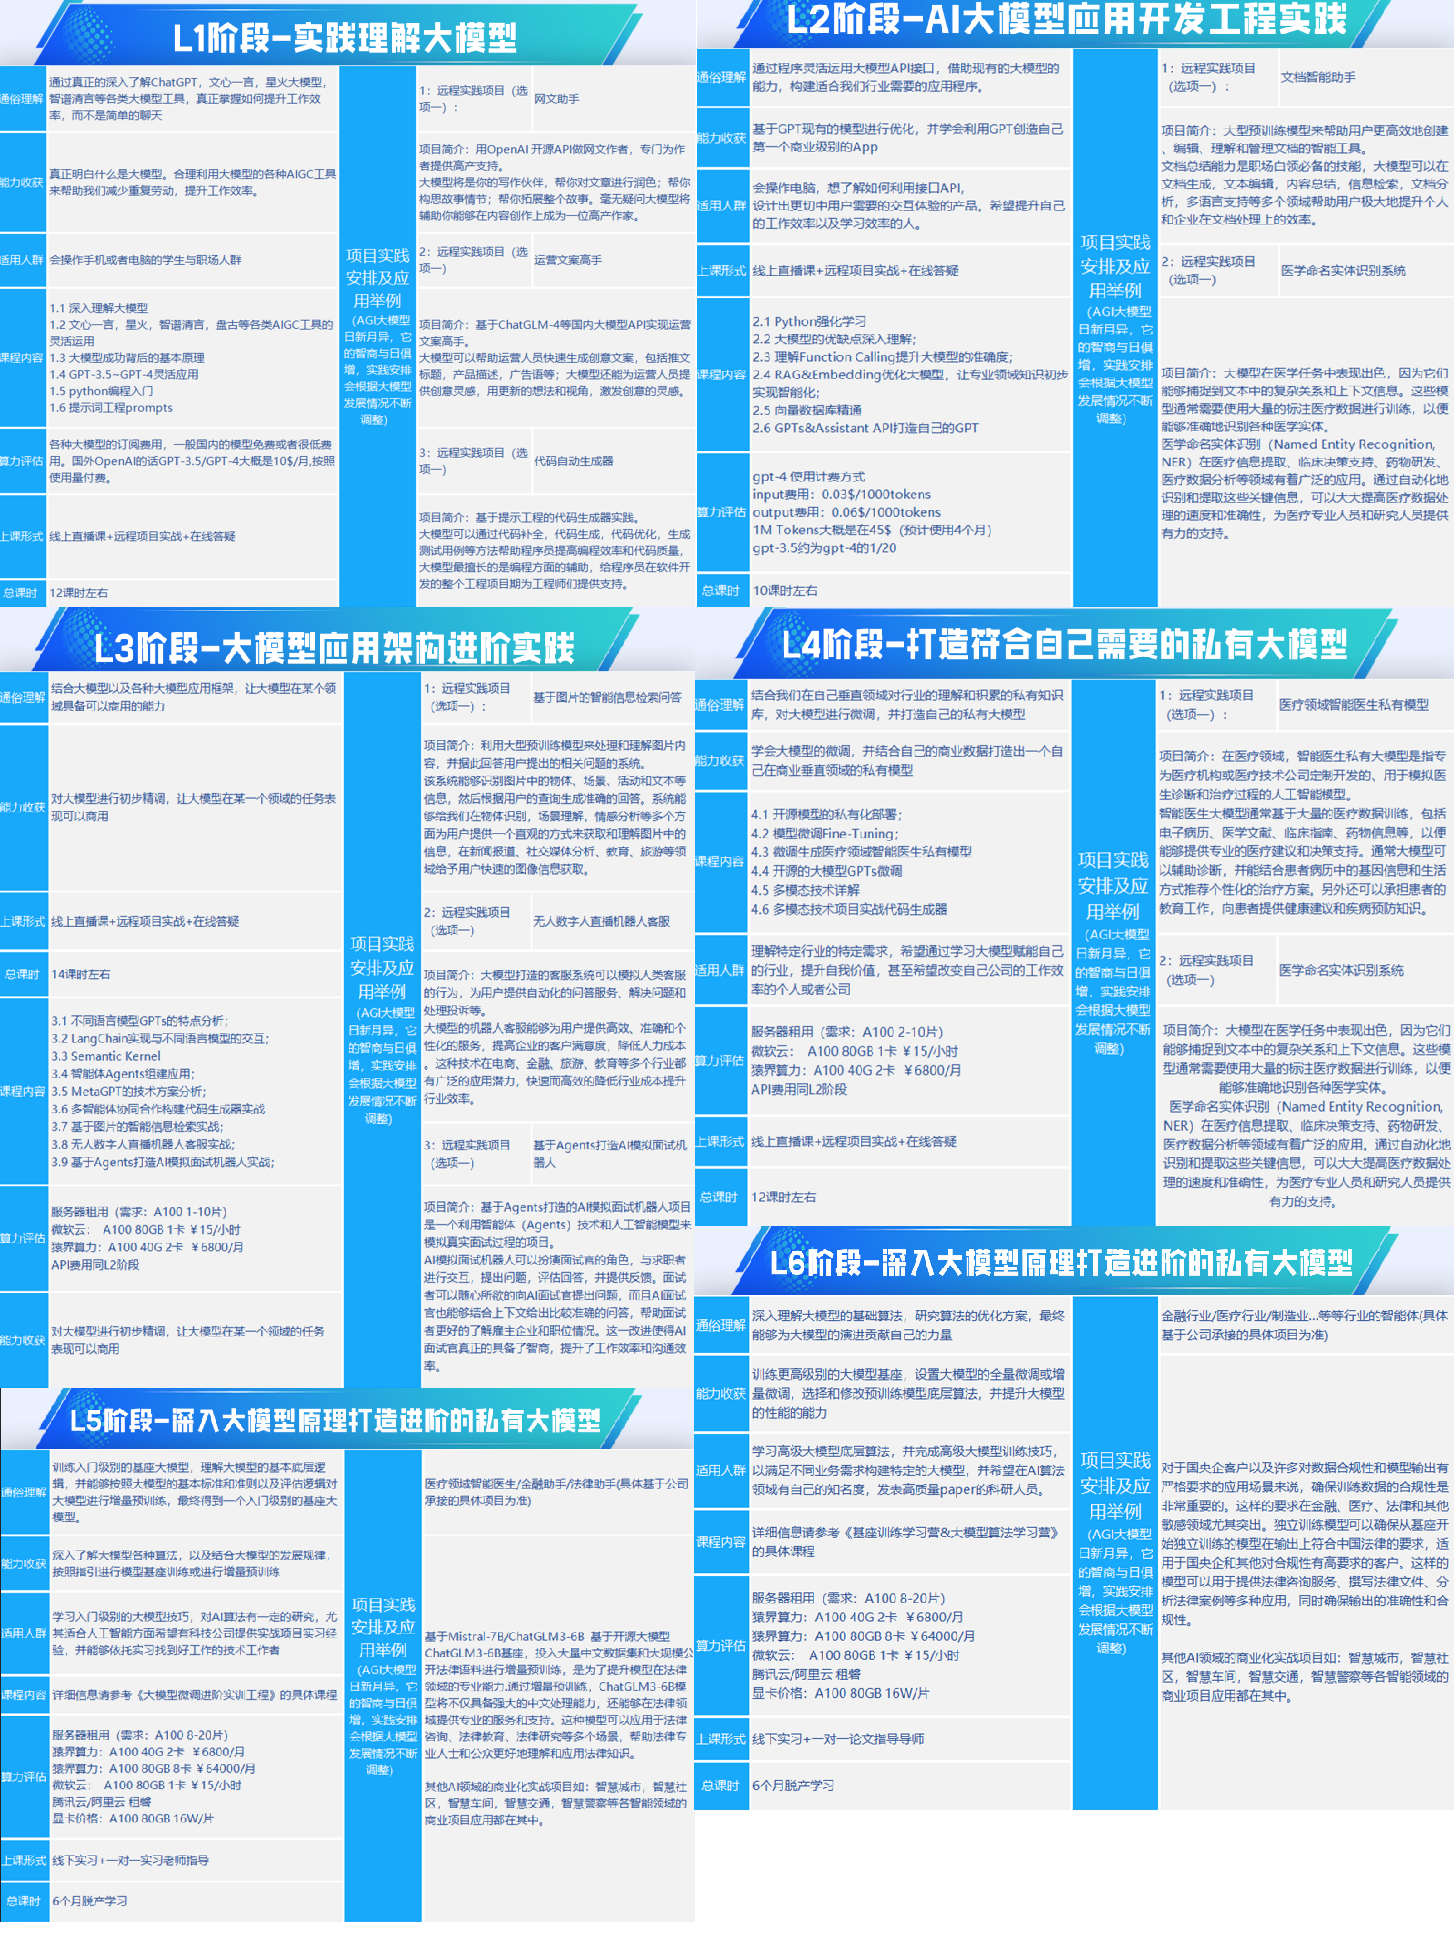
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
四、AI大模型商业化落地方案

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
更多推荐


 3
 0
- 0


 已为社区贡献14条内容

所有评论(0)