人人都能复刻Harness,Coding Agent真正壁垒早已不在模型
文章目录
P.S. 推荐一个大神的教程给想要了解或者学习人工智能知识的读者,这个教程里内容讲解通俗易懂且风趣幽默,对我帮助很大。我想与大家分享这个宝藏教程,请点击下方链接查看, 传送门https://blog.csdn.net/qq_74013365
前言
最近DeepSeek一开Harness内测招募,评论区直接秒变个人开发者赶集现场。
几百个开源仓库齐刷刷往上贴,人均揣着一套自己手搓的Harness过来自荐。覆盖Coding Agent、记忆、Skills、评测、安全,啥方向都有。
搁半年前,大家还在面红耳赤吵“AI辅助编程到底提效2倍还是100倍”;现在卷的门槛已经悄咪咪变成了——你能不能自己写一套Harness。
就挺魔幻的。几个月前还觉得是大厂专属的黑科技,现在个人开发者熬几个通宵就能拼出一套能用的。
那问题来了:当模型能随便换、Harness能照着抄、核心组件都大同小异的时候,Coding Agent到底还能靠什么拉开差距?
1 模型卷不动了,战场早就换地方了
今年有个很有意思的现象:好多做Coding工具的创始人,都开始说同一句话——模型已经拉不开差距了。
1.1 说“模型已死”的人,这次真没瞎说
Amp的联合创始人Thorsten Ball直接放话:“模型已经死了。”
搁以前肯定有人跳出来抬杠,但现在圈内越来越多人认同这个说法。
你日常写业务代码、改Bug、调接口,这些活儿哪个主流模型干不了?换最新款的模型,回头再用旧的,你会发现体感差别真没那么大,基本属于“用哪个都一样”。
甚至还有更扎心的:新版本模型能力不一定涨,搞不好还能给你整个技能倒退。
毕竟能力越强,场景越复杂,厂商越难保证旧能力不退化。评测集就那么多,真实世界的代码千奇百怪,根本覆盖不过来。
以前大家说“国产模型不行,就靠工具凑”,现在情况反过来了:模型都够打了,反倒是工具层成了新的赛场。
就像大家都用同款CPU,拼的就不再是主频,而是主板、散热、电源、整机调校。
模型负责决策,真正的编码、调试、重构,全靠Harness里的工具落地。既然模型拉不开差距,竞争自然就下沉到Harness这一层。
2 Harness早就趋同了,但差距藏在看不见的地方
Harness真不是什么新鲜概念。
早在2022年ChatGPT刚出来那会儿,4000Token的上下文窗口逼得大家只能靠工具调用、MCP、RAG来管理上下文,Cursor、Windsurf、Aider全是那个时期冒出来的。
后来窗口越做越大,任务越跑越长,大家又发现新问题:Agent跑几个小时就开始丢三落四,关键信息记不住,总结还能给你整变形。
于是有人上Sub-agent,有人搞Agent Swarm,变着法儿给模型搭更好的运行环境。
“Harness”这词今年年初才火起来,结果才半年时间,大家的技术路线就长得差不多了。
2.1 薄Agent Loop,厚Control Plane
最核心的Agent Loop,说白了就是模型循环、读写文件、管上下文、控安全,满打满算也就几百行代码。
Thorsten Ball甚至用315行Go代码,从零搓了个能在终端读、搜、改文件的Coding Agent。
给大家看个极简版的核心逻辑,差不多就这么回事:
// 极简版Coding Agent核心Loop
func runAgent(task string, workspace *Workspace) {
    for {
        // 拿到当前状态与任务
        state := workspace.GetState()
        if taskIsDone(task, state) {
            break
        }

        // 模型决策下一步动作
        action := model.DecideNextAction(task, state)

        // 执行操作(改文件/跑命令/搜代码)
        result := workspace.Execute(action)

        // 出错就回滚到最近检查点
        if result.Err != nil {
            workspace.RollbackLastCheckpoint()
            continue
        }

        // 更新状态、存检查点
        workspace.UpdateState(result)
        workspace.SaveCheckpoint()
    }
}
就这么个循环,真没什么技术壁垒。你能写,我能写,大厂个人都能写。
但一套完整能用的Harness,得往外堆Planner、Coder、Reviewer、Search、Shell、Sub-agent、MCP一大堆组件。
很多人以为差距在“有没有这些组件”,其实根本不是。
就像数据库,MySQL、TiDB、PostgreSQL都有SQL、优化器、存储引擎,但没人觉得它们是一个东西。真正的差距,从来不是组件齐不齐,而是这些组件怎么组合成一个能真正解决问题的系统。
TiDB团队的思路就很值得品:他们直接基于开源的Pi做核心Loop,自己不搁这层内卷。
人家说了,Agent Loop是变化最快、也最容易同质化的一层。模型协议、工具调用、流式输出、推理能力一直在变,LLM厂商和云厂商迟早会把这层卷到极致。咱们没必要在这死磕,站在巨人肩膀上就行。
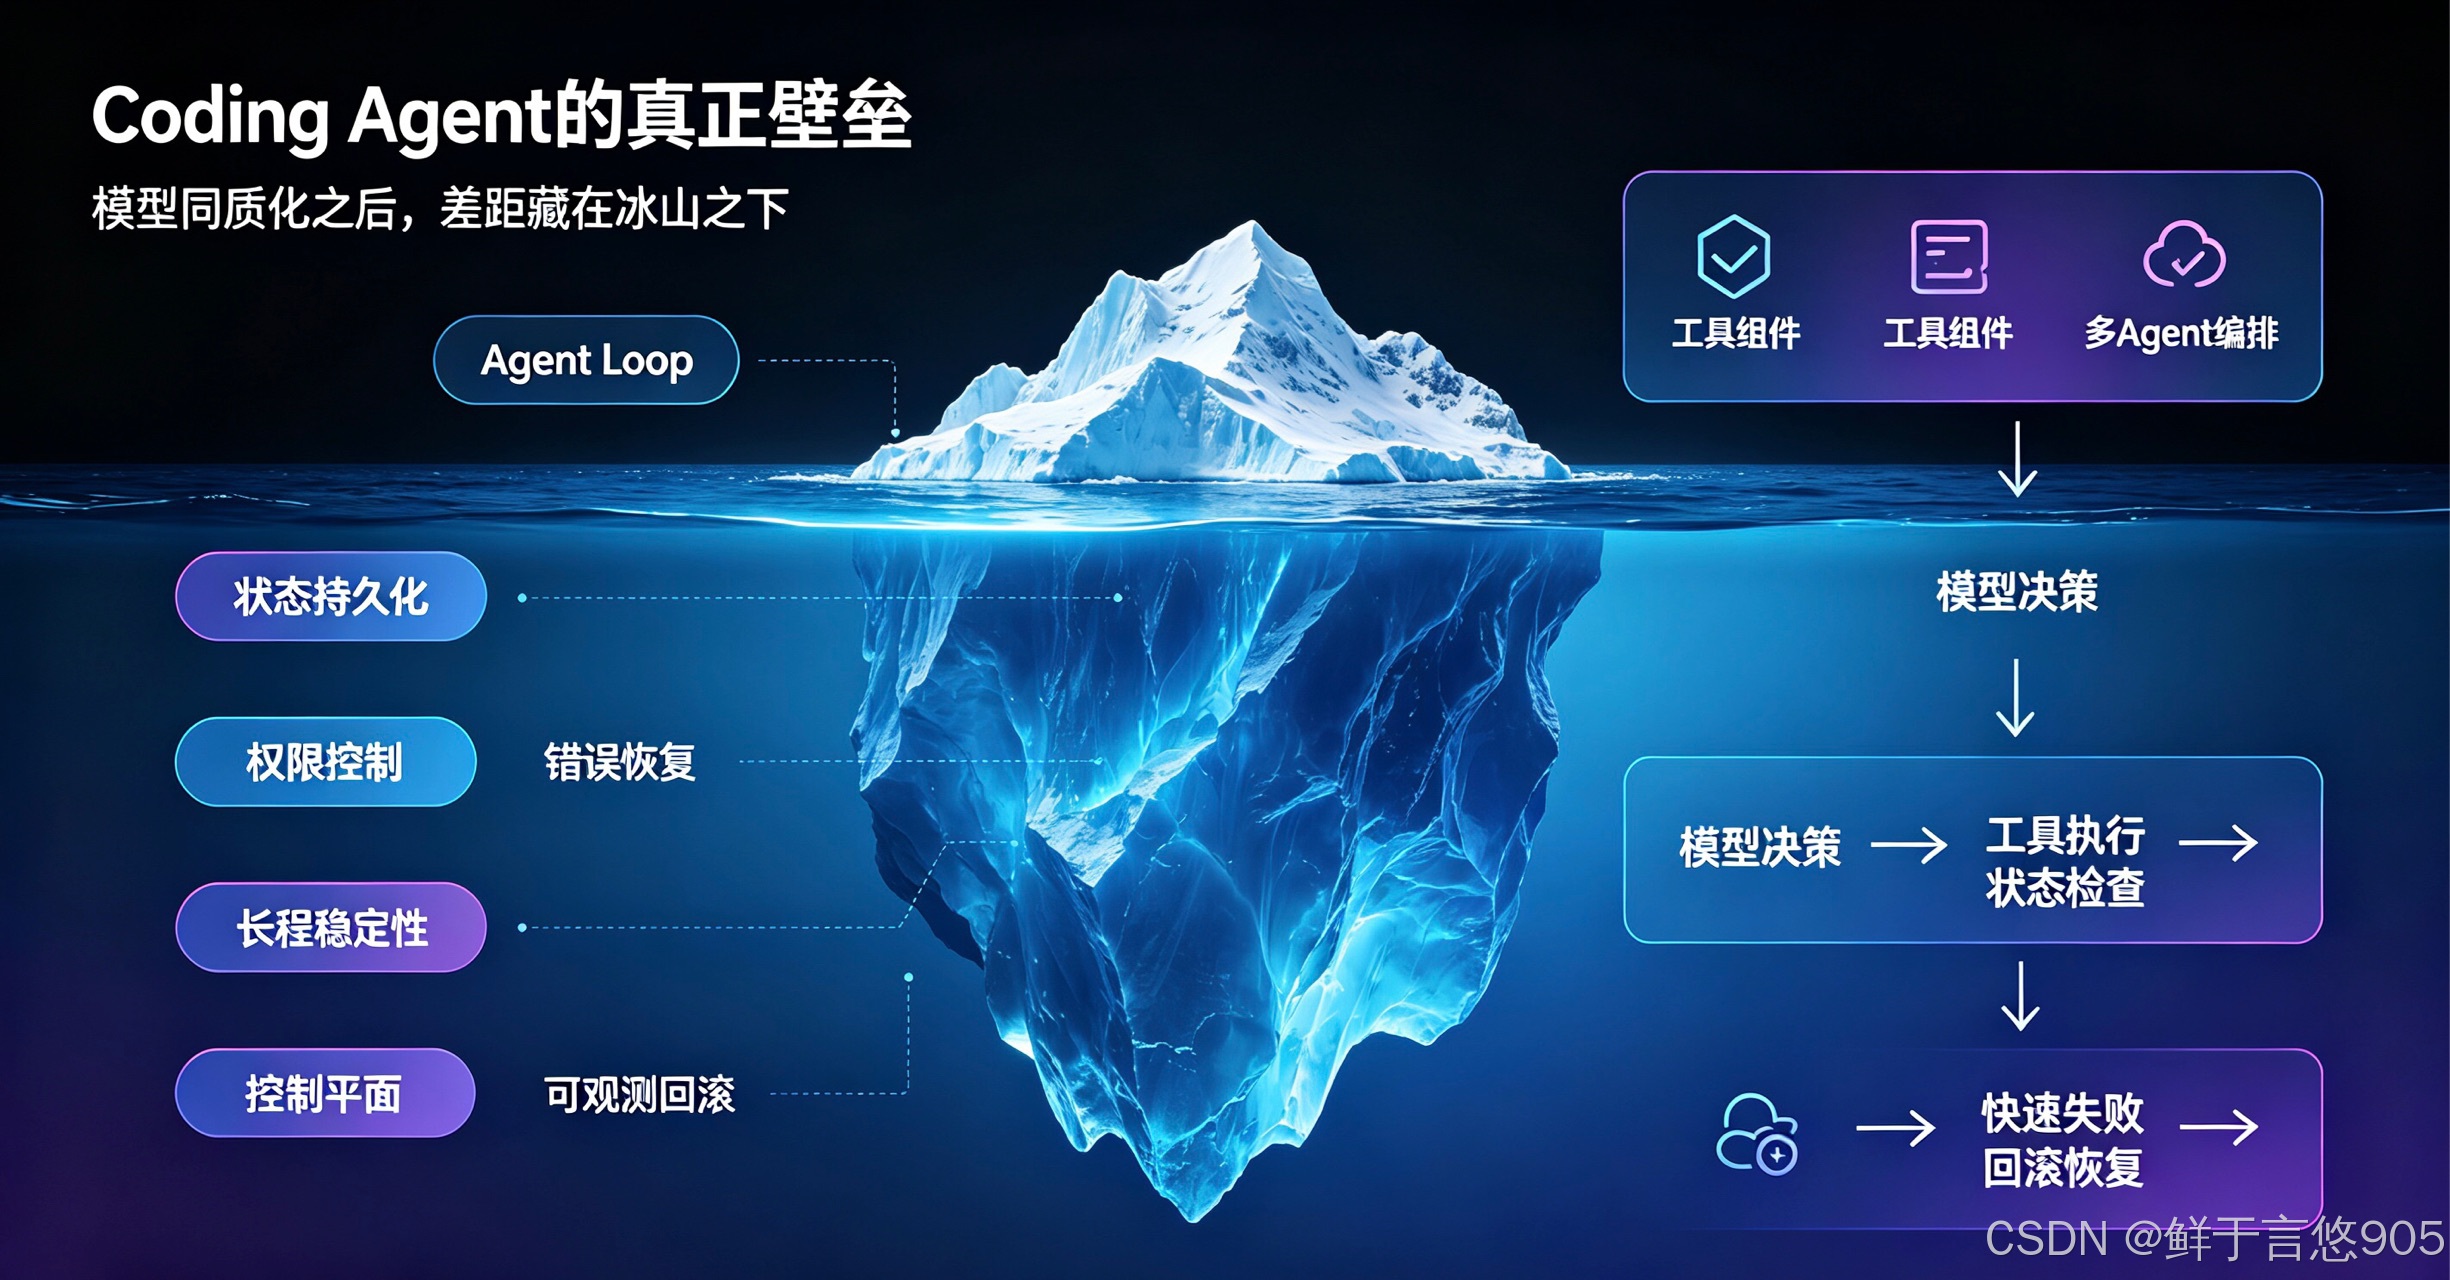
真正要自己下功夫的,是数据库行业干了二十年的老问题:状态怎么持久化、权限怎么收、副作用怎么控、失败了怎么恢复、结果怎么证明是对的、出问题了怎么审计复盘。
一句话总结:薄Agent Loop,厚Control Plane。
这么干最大的好处就是:换模型、换Agent核心,不用推倒重来。
最开始用OpenCode,后来换成Pi,上面的Agent怎么换,下面的沙箱、权限、状态、控制面全都不用动。
模型能力越强,越可以放宽沙箱里的探索空间,但真实生产系统的副作用边界,半点儿都不能松。
这跟数据库一个逻辑:SQL、优化器可以越来越聪明,但事务、权限、持久化这些边界,绝不会因为上层更聪明就消失。
3 多Agent编排?听着高大上,实则分布式内耗
现在聊Agent,不提“多Agent编排”好像就落伍了。
动不动就是几千个Agent并发跑,忙的时候直接上万,听着就科技感拉满。Claude Code还直接把这玩法产品化了,叫Dynamic Workflows,你给个目标,它自己拆任务、调度几百个子Agent去干活。
2026年还被叫做“Agent编排之年”。
3.1 这剧本十年前就演过一遍
看到这儿我就笑了。这剧本,十年前容器圈刚演过。
2016年也叫“容器编排之年”,Docker把应用标准化了,大家发现跑一个容器不难,难的是管几千个。然后Kubernetes、Swarm、Mesos打成一锅粥,最后赢的是控制平面。
十年轮回,现在Agent又走一模一样的路。大模型厂商、云厂商、企业软件巨头、开源框架、治理平台,全都往这个位置挤,每家都想当“Agent界的K8s”。
但这个位置真的存在吗?还是说,大家一窝蜂冲进了一条被过度炒作的死胡同?
TiDB的唐刘有个观点,听着像暴论,越想越有道理:Agent编排的未来,可能是越来越少的编排。
以前你让Agent干个复杂活,得手把手教:第一步干啥、第二步干啥、Planner怎么工作、Coder怎么输出、Reviewer怎么检查,写一大堆Prompt把协作流程硬塞进去。
现在呢?很多时候你只要告诉它“我要这个结果”,它自己就能把内部规划全做了。
模型越强,一部分显式编排就一定会消失。
这跟数据库的演进一模一样:早期你得告诉数据库怎么Join、从哪张表开始、走什么索引;后来优化器越来越强,你只管说“我要什么数据”,怎么执行数据库自己定。
Agent也会走这条路:从命令式编排,走向声明式目标。
做分布式系统的人都懂一句话:Communication is complexity。
一个系统里十个组件频繁通信,大概率难调试、性能也好不了。Agent也一样,A问B,B问C,C改完通知A和D,大家不停同步状态,这系统设计上可能就已经出问题了。
所以TiDB在多Agent上反而特别克制,甚至有点反潮流。他们更信Unix哲学:一个Agent做好一件事,Agent之间靠清晰的输入输出解耦,尽量少瞎聊。
上层可以有个Agent或者Workflow分配任务、汇总结果,但整体拓扑一定要尽量简单。
“复杂性永远有成本。别因为我们能做复杂系统,就一定要做复杂系统。我不觉得未来是一百个Agent在Slack群里开大会的软件公司。”
这话太对了。真正好的多Agent系统,反而可能看起来特别安静。每个Agent在自己边界里把活干明白,最后靠明确的状态和结果协作,不是天天开会扯犊子。
腾讯研究院的茹炳晟也认同这个看法:多Agent从来不是默认选项,是单Agent实在搞不定了才用的补充方案。
现在很多人把多Agent编排分成顺序、并行、路由十几种固定模式,在他看来这都只是描述了连接方式,算不上真正的智能体设计模式。
真正的设计模式,是认知能力和执行拓扑的二维矩阵。感知、记忆、推理、行动、反思、协作、治理,配上链式、路由、并行、循环、层级、编排,每个交点都能衍生出具体模式。
但核心原则只有一个:单Agent能搞定的,就别上多Agent。
复杂度不会消失,只会转移。从单体拆成微服务,通信和状态管理成了新坑;从单Agent拆成多Agent,协作、同步、汇总、治理全是新坑。
你以为多Agent降低了复杂度,其实只是把问题从一个地方挪到了另一个地方。
什么时候值得花这个成本?目前看就两个场景最实在:一个是拆任务缓解上下文压力,主Agent只收结果;另一个是交叉验证,两个模型互相查错,碰出新想法。
除此之外,为了编排而编排,纯纯给自己找罪受。
4 长程稳定性,才是下一代的真正分水岭
问个灵魂问题:一个Agent连续跑50个小时,它还知道自己到底干过什么吗?
这就是通用Agent框架的终极考场。
现在Harness的核心模块已经高度标准化了:上下文管理、任务拆解、工具调用、记忆整合,各家方案大同小异。
架构趋同之后,拼的就是模块之间怎么配合。单点领先不算什么,几十轮执行下来,细节的差异会累积出完全不同的结果。
所以圈内现在基本有共识:长程稳定性,会是下一代Agent产品的核心分水岭。
很多Agent前十几步跑得又快又准,四五十步就开始跑偏,越跑越离谱。
而且别光看步数。调用50次同一个稳定API,未必比修改7个互相依赖的文件更长程。真正决定难度的,是依赖链深度、状态跨越的时间、工具数量、目标开放程度、操作可逆性,还有错误要多少轮才能被发现。
4.1 重试是陷阱,快速失败才是精髓
这根本不是“模型能不能咬牙坚持跑完”的问题。真正的问题是:一个小错误出现以后,系统能不能在它变成大故障之前把它拦住。
错误很少突然爆炸。模型本身有概率性,用户需求常常模糊,再加上长链条里目标被稀释、上下文被压变形、工具出问题、反馈不及时,一堆因素缠在一起。早期一个不起眼的偏差,等跑到验证环节才发现,早就晚了。
既然问题是“错误发现得太晚”,解法自然就是让错误尽早暴露。
这和分布式系统的逻辑一模一样。网络会断、磁盘会坏、机器会挂,所有分布式系统都会失败。真正危险的不是失败本身,而是系统不停重试,把小故障放大成雪崩。
所以唐刘说过一句话,我特别认同:重试很危险,快速失败的价值却总被低估。
但Fail Fast不是说直接放弃任务。它只是把问题暴露的时间点,从五十步之后提前到了十步。
第十步走错了,不代表任务失败。真正可怕的是,第十一步到第五十步还在错误的前提上接着跑,上下文里的错误信息越攒越多,到最后你根本不知道从哪一步开始错的。
所以Fail Fast必须配另外两个能力:限制错误传播、从最近一个可信状态恢复。
答案还是从数据库里找:要有Checkpoint,要有持久化状态,要能换个Agent、换条路径接着干。
事务日志、检查点、回滚、故障转移,数据库这套可靠性哲学,放到Agent身上完全适用。
没人会设计一个假设“机器永远不坏”的数据库,那凭啥设计Agent就要假设“它永远不犯错”?
可靠性从来不是不失败,而是失败了之后,系统还能保持正确。
再往深想一层:能恢复,能不能自改?
可以,但必须是受控闭环。发现问题、生成改动、隔离评测、灰度发布、保留回滚,一步都不能少。
没有版本管理和可观测性,所谓的自进化就是在积累技术债。
关键从来不是“能不能改自己”,而是怎么证明改得更好、代价可控,而且随时能退回去。
只有可观测、可溯源、可回滚,自进化才不是伪命题。
5 编程只是训练场,更大的战场在办公室
别以为Harness只能用来写代码。编程只是Harness最早跑通的场景,但绝对不是终点。
从今年年初开始,国内大厂的AI资源就已经在悄悄从编程向办公场景倾斜了。
字节调整AI资源分配,重心从消费产品转向企业服务;阿里成立ATH事业群统一调度算力,整合了多条智能体产品线;腾讯全力押注WorkBuddy,资源一路绿灯。
半年时间,三家大厂不约而同干了同一件事:把算力、人才、预算集中到AI办公这条主线上。
但这转向不是从零开始的。
腾讯的路径最典型:CodeBuddy和WorkBuddy本来就是同一个团队的。Claude Cowork发布后,四个人的团队一个周末就搓出了WorkBuddy的原型,原CodeBuddy的负责人直接带队转过去,Coding Harness的能力完完整整带进了办公场景。
字节的Trae Work和Trae IDE,阿里的Qoder和Qoder Work,全都是一个路子:从Coding Harness泛化到Work场景。
OpenAI更直接,明确说ChatGPT Work和Codex底层Harness完全共享,就是同一套东西。
道理其实很简单。
IDE正在经历“能力原子化”,那些给人设计的界面和功能,正在被拆成一个个细粒度的Tool,交给Agent按需调用。
办公场景也一样。邮件、文档、日历、审批,这些人类熟悉的操作界面,一样会被拆成Agent能调用的接口。
今年飞书开源的那套CLI,本质就是把飞书的消息、文档、日历、审批全封装成了Agent可调用的工具,上线直接就火了。
所以这两类产品,底层都是同一套Harness核心,区别只是调用的工具集不一样:IDE产品操作代码仓库和终端,Work产品操作文档、网盘和邮箱。
底层逻辑全是通的:理解目标、选择工具、执行多步任务、维护状态、验证结果。
编程Agent这几年积累的能力——上下文管理、任务规划、工具调用、状态持久化、错误恢复,正在从一个垂直场景,变成一套通用的工作基础设施。
编程给这套Harness提供了最早的训练场和商业化验证,而办公,才是真正更大的市场。
回到最开始的问题:人人都能整一套自己的Harness了,那我们还在拼什么?
拼谁的Loop写得更炫吗?当然不是。
拼的是看不见的地方:状态稳不稳、权限严不严、错误能不能及时拦、长程跑下来会不会跑偏、换了模型能不能无缝衔接、出了问题能不能快速定位复盘。
就像冰山,露在水面上的Loop和组件人人都能抄,水面下的工程化、控制力、稳定性,才是真正的壁垒。
毕竟,几百行的循环好写,能扛住真实世界千锤百炼的系统,从来都不是靠几行核心代码撑起来的。
P.S. 推荐一个大神的教程给想要了解或者学习人工智能知识的读者,这个教程里内容讲解通俗易懂且风趣幽默,对我帮助很大。我想与大家分享这个宝藏教程,请点击下方链接查看,传送门https://blog.csdn.net/qq_74013365
小龙虾开发者社区是 CSDN 旗下专注 OpenClaw 生态的官方阵地,聚焦技能开发、插件实践与部署教程,为开发者提供可直接落地的方案、工具与交流平台,助力高效构建与落地 AI 应用
更多推荐
 3
 0
- 0


 已为社区贡献3条内容

所有评论(0)