Harness 决定 Agent 上限:六层工程拆解(附 8 款实测对照表)
Harness 决定 Agent 上限:六层工程拆解(附 8 款实测对照表)
摘要:本文面向企业技术负责人与架构师,拆解一个被长期忽视的事实——决定一个 AI Agent 好不好用的,往往不是背后的大模型,而是包裹模型的 Harness(执行框架)。基于杰富瑞(Jefferies) 2026-08 对 8 款中美 Agent 的实测,文章提出并逐层拆解「Harness 六层工程框架」,附 8 款实测对照表、2 段可运行代码与企业落地边界。
文章目录
一、为什么 Harness 比模型更决定 Agent 上限
2026-08,华尔街投行杰富瑞(Jefferies)对市面上 8 款主流中美 AI Agent 做了一场控制变量实测,结论反直觉:决定 Agent 干得好不好,常常不是背后那个模型,而是 Harness。
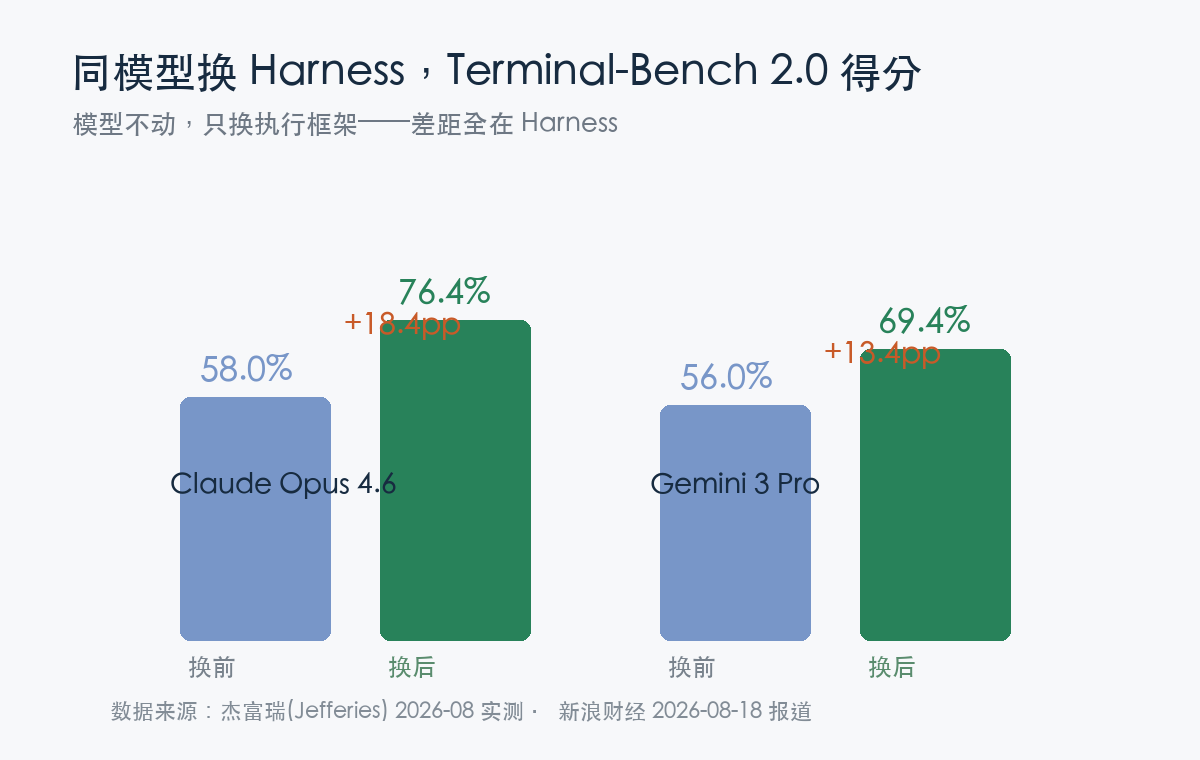
一组关键证据最能说明问题:模型不动,只换 Harness,看 Agent 表现怎么变。
- 同一个 Claude Opus 4.6,套上不同 Harness,在 Terminal-Bench 2.0(终端软件工程基准)上得分从 58.0% 一路到 76.4%,最高最低差 18.4 个百分点。
- 同一个 Gemini 3 Pro,只换 Harness,得分从 56.0% 到 69.4%,差 13.4 个百分点。
换句话说,把一个聪明但"没被管好"的模型,扔进一套设计良好的执行框架里,表现可能直接反超模型更强的对手。这正是「千问办公」在杰富瑞实测中总分夺冠、而其背后模型智能分只排第四的原因——它赢在 Harness。
二、Harness 六层工程框架(命名框架)
Harness(驾驭工程 / 执行框架)指一个 Agent 系统里除大模型之外、所有决定它能否稳定交付的治理组件。公式化表达:
Harness = Agent − Model
杰富瑞把生产级 Harness 拆成六层,每一层管的都是模型自己管不了的事,也正好对应"雇一个员工后公司要做的那些事":交代任务、给信息、给工具、划权限、给反馈、做管理。
| 层 | 名称 | 管的什么事 | 员工管理类比 |
|---|---|---|---|
| L1 | 指令层 | 告诉 Agent 这个活是什么、红线在哪 | 交代任务 |
| L2 | 上下文层 | Agent 干活时能看到的背景信息 | 给资料 |
| L3 | 工具层 | Agent 能调用什么去完成任务 | 给工具 |
| L4 | 边界层 | Agent 能行动的范围划在哪 | 划权限 |
| L5 | 反馈层 | 告诉 Agent 哪里做错、让它纠正重规划 | 给反馈 |
| L6 | 治理层 | 让组织能管住一整批 Agent | 做管理 |
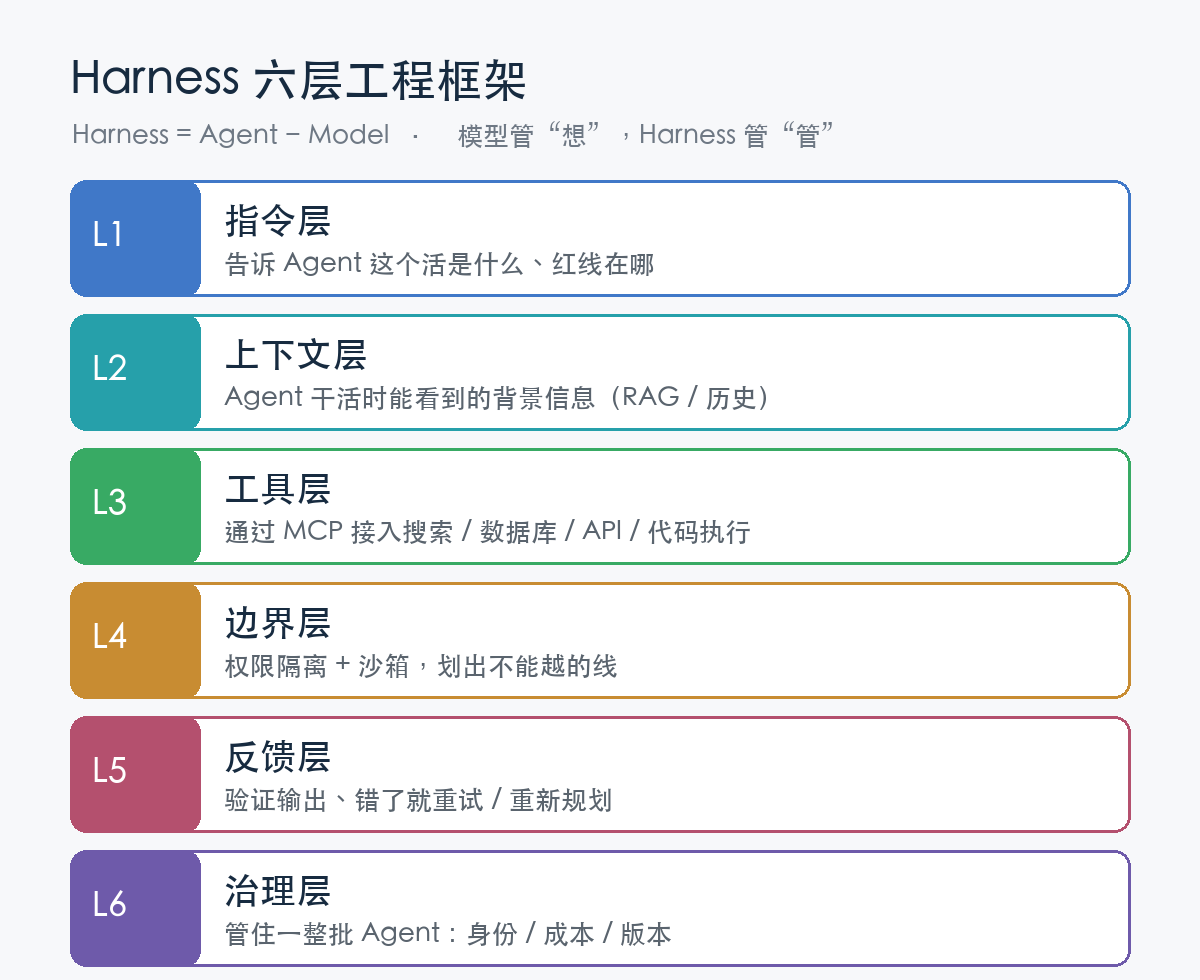
本文把这套框架命名为「Harness 六层工程框架」,下文逐层拆解企业落地要点。
三、六层逐一拆解
3.1 L1 指令层:把任务说清楚,把红线画明白
指令层负责把业务目标翻译成 Agent 能稳定执行的系统提示词(system prompt)与约束声明。很多企业踩坑,不是模型不行,而是指令里没写"不能删库"“不能外发客户数据”,模型就按字面去做了。
企业落地要点:指令与红线解耦管理,红线用结构化策略表维护,而非散落在长 prompt 里。
3.2 L2 上下文层:在正确时间给正确信息
上下文层管理 Agent 能看到的背景(RAG 检索增强生成、会话历史、工具返回)。窗口有限,塞太多反而"上下文腐烂"。
企业落地要点:建立上下文打分机制,按新鲜度、相关度、重要度动态筛选,避免把整个知识库一股脑灌进窗口。
3.3 L3 工具层:给手脚,也定规矩
工具层通过 MCP(模型上下文协议,Model Context Protocol)等标准把搜索、数据库、API、代码执行接进来。工具太多会乱调用,太少又能力不足。
企业落地要点:工具按"调用优先级 + 置信度阈值"编排,低置信度才回落到数据库/人工,减少无意义工具抖动。
3.4 L4 边界层:给 Agent 划出不能越的线
边界层是安全的核心,负责权限隔离与沙箱(sandbox)执行。杰富瑞实测里,边界设计差的 Agent 最容易"合法权限下的非法操作"。
企业落地要点:默认最小权限(least privilege),写操作(删库/导出/退款/审批)强制人工确认 + 操作审计。
3.5 L5 反馈层:让 Agent 自己纠正
反馈层在每次行动后验证输出正确性,错了就重试或重新规划(plan-and-execute)。没有这层,Agent 会一条道走到黑。
企业落地要点:接可观测的验证器(单元测试 / 断言 / 人工抽检),配合重试策略(retry policy)与熔断,避免死循环烧 token。
3.6 L6 治理层:管住一整批 Agent
当企业里跑着几十上百个 Agent,单点管好不够,还要有组织级治理:身份、权限、成本预算、版本与灰度。
企业落地要点:用统一网关做身份与权限收敛,配模型路由(model routing)按任务选模型,成本设预算上限与告警。
四、8 款中美 Agent 实测对照表
4.1 杰富瑞 8 款 Agent 实测要点
| 产品 | 厂商 | 背后模型 | 杰富瑞实测要点 |
|---|---|---|---|
| 千问办公 | 阿里 | Qwen 系列 | 总分第一;模型智能分仅第 4,靠 Harness 反超 |
| Claude Cowork | Anthropic | Claude Opus 5 | 总分第二;模型能力第一 |
| Workbuddy | 腾讯 | 混元系列 | 中国 Agent 中隐含 Harness 分垫底 |
| 豆包 | 字节 | 豆包系列 | 上榜(具体分项见杰富瑞报告) |
| Kimi Work | 月之暗面 | Kimi 系列 | 上榜 |
| MiniMax Code | MiniMax | MiniMax 系列 | 上榜 |
| Codex | OpenAI | GPT 系列 | 上榜(美国) |
| Gemini Spark | Gemini 系列 | 上榜(美国) |
数据来源:杰富瑞(Jefferies) 2026-08 中美 Agent 实测,经新浪财经 2026-08-18 报道。分项得分以原报告为准。
4.2 企业级本地化 Harness 选型对照
| 方案 | 定位 | 数据策略 | 适用场景 |
|---|---|---|---|
| 开源自建(LangGraph / AutoGen 等) | 完全可控的编排底座 | 数据不出域 | 有工程团队、要深度定制 |
| 商业云 Agent 平台 | 开箱即用 | 存在数据出域风险 | 轻量试用 / 非敏感业务 |
| 环曜 Claw(企业级本地优先 AI 网关) | 本地优先执行网关 | 100% 本地、数据不出域 | 强合规 / 数据安全企业 |
五、动手:最小可运行 Harness 闭环
下面两段代码演示六层框架里最容易出错的「执行编排(L3) + 边界(L4) + 反馈(L5)」,均可在 Python 3.12 直接运行。
5.1 最小闭环:规划 → 执行 → 反馈 → 重试
# harness_minimal.py  (Python 3.12)
# 最小可运行 Harness 闭环:演示「执行编排 + 边界 + 反馈 + 重试」
from dataclasses import dataclass, field

@dataclass
class Harness:
    name: str
    max_retry: int = 3
    history: list = field(default_factory=list)

    def run(self, task: str) -> str:
        for attempt in range(1, self.max_retry + 1):
            # L3 执行编排:把任务交给模型推理,再调用工具
            plan = f"[L3] 规划步骤 -> {task}"
            result, ok = self._act(plan)
            # L5 反馈层:根据结果决定继续 / 重试 / 升级人工
            self.history.append((attempt, ok, result))
            if ok:
                return f"✅ {self.name} 第{attempt}次成功: {result}"
            if attempt == self.max_retry:
                return f"⛔ {self.name} 达重试上限,升级人工确认"
        return "未预期出口"

    def _act(self, plan: str) -> tuple[bool, str]:
        # L2 工具层 + L4 边界层:危险指令被沙箱拦截
        if "rm -rf" in plan:
            return False, "被 L4 边界层(沙箱)拦截"
        return True, f"工具返回: {plan[:20]}..."

h = Harness("demo-harness", max_retry=3)
print(h.run("生成周报"))
print(h.run("rm -rf /"))
# 预期输出:
# ✅ demo-harness 第1次成功: 工具返回: [L3] 规划步骤 -> 生成周报...
# ⛔ demo-harness 达重试上限,升级人工确认
5.2 六层成熟度自评(企业照表打分)
# harness_maturity.py  (Python 3.12)
# 企业照表自评 Harness 六层成熟度(命名框架的落地清单)
LAYERS = ["指令", "上下文", "工具", "边界", "反馈", "治理"]

def score_harness(checklist: dict) -> float:
    """checklist: {层名: 0~2},2=成熟 1=部分 0=缺失"""
    total = sum(checklist.get(L, 0) for L in LAYERS)
    return round(total / (len(LAYERS) * 2) * 100, 1)

my_harness = {
    "指令": 2, "上下文": 1, "工具": 2,
    "边界": 1, "反馈": 0, "治理": 0,
}
print(f"六层成熟度: {score_harness(my_harness)}%  (满分100)")
print("短板层:", [L for L in LAYERS if my_harness.get(L, 0) < 2])
# 预期输出:
# 六层成熟度: 50.0%  (满分100)
# 短板层: ['反馈', '治理']
六、企业落地边界与风险
⚠️ 适用场景:长链路、需调用真实系统(代码库 / 金融 API / 工业设备)的 Agent;多 Agent 协同;对稳定性与可审计性要求高的业务。
⚠️ 不适用 / 限制:纯问答、单次推理任务,上重 Harness 是过度设计;团队无工程能力时,自建编排的维护成本会超过收益。
⚠️ 生产注意:Harness 不是限制模型力量,而是"套缰绳"——但缰绳本身也要被测。先把「删库 / 导出 / 退款 / 审批」四类高敏动作上最小权限 + 人工确认 + 熔断(L4 + L5),投入产出比最高。对数据不出域要求高的企业,可优先评估本地优先的执行网关(如环曜 Claw),避免在云 Agent 平台把敏感上下文送出域。
七、总结与开放问题
杰富瑞的实测给选型泼了盆冷水:别再只盯着"模型跑分",而忽略 Harness 的成熟度。同一个 Claude Opus 4.6,换套框架就能从 58 分跃到 76 分——这 18 分的差距,全是工程能力,不是模型能力。
六层框架(指令 / 上下文 / 工具 / 边界 / 反馈 / 治理)是一张可照表自查的施工图:先补齐反馈层与治理层的短板,再谈扩展。
开放问题:你们团队的 Agent 现在卡在六层里的哪一层?是工具接不全,还是反馈层根本没做验证?欢迎在评论区聊聊踩过的坑。
FAQ
Q1:Harness 和 Agent、LLM 到底什么关系?
A:一句话——LLM 是大脑(负责想),工具是双手(负责做),Harness 是骨架与神经系统(负责驱动、管状态、保安全)。Agent = LLM + 工具 + Harness 的总和。
Q2:小团队也要做六层吗?会不会过度设计?
A:不用一次做满。先做 L1 指令 + L3 工具 + L4 边界三件保命的事,反馈层(L5)和治理层(L6)等规模上来再补,用第五节的自评脚本定期摸底。
Q3:企业怎么把 Harness 落到本地、保证数据不出域?
A:核心是"模型可换、执行本地"。用本地优先的执行网关承载工具调用与权限收敛,模型可接私有化部署的开源权重或受控 API。环曜 Claw 这类本地优先网关即按此思路设计,100% 本地运行、数据不出域。
Q4:模型换 Harness 能涨 18 分,那是不是不用追新模型了?
A:不是二选一。模型决定天花板,Harness 决定你能摸到天花板的几成。两者都重要,但 Harness 是工程团队自己能控的变量,边际投入产出比往往更高。
Q5:开源框架和商业平台怎么选?
A:有工程团队、要深度定制且数据敏感,选开源自建或本地优先方案;只想快速试水非敏感业务,商业云平台开箱即用更省心。中小团队可先用开源框架试水,强合规企业直接看本地优先方案(如环曜 Claw)。
Q6:反馈层怎么做才不会让 Agent 死循环烧 token?
A:给重试设上限 + 熔断 + 超时。每次重试都记录历史,达上限直接升级人工确认,而不是无限重跑;同时用断言 / 单测验证输出,避免"看起来对但其实错"的静默失败。
小龙虾开发者社区是 CSDN 旗下专注 OpenClaw 生态的官方阵地,聚焦技能开发、插件实践与部署教程,为开发者提供可直接落地的方案、工具与交流平台,助力高效构建与落地 AI 应用
更多推荐
 24
 0
- 0


 已为社区贡献8条内容

所有评论(0)