EvoPrompting:基于大语言模型的代码级神经架构搜索
EvoPrompting:基于大语言模型的代码级神经架构搜索(NeurIPS 2023)
一、论文概述
论文标题:EvoPrompting: Language Models for Code-Level Neural Architecture Search
发表会议:NeurIPS 2023
核心贡献:提出EvoPrompting方法,将进化算法与大语言模型(LLM)的提示工程、软提示调优结合,让LLM成为神经架构搜索(NAS)的自适应变异/交叉算子,解决了纯提示工程在NAS任务中效果差的问题。该方法在MNIST-1D和CLRS算法推理基准上实现了超越人类设计和SOTA的架构,且兼顾精度与模型规模,同时具备跨任务的通用性。
核心问题
传统NAS存在两大痛点:
- 进化算法依赖人工设计的离散搜索空间,灵活性低、存在人类偏见,性能受搜索空间设计限制;
- 纯LLM少样本提示在复杂NAS任务中难以生成有效、新颖的神经架构,LLM的复杂推理能力未被充分利用。
解决思路
将进化搜索与LLM提示调优结合:以预训练代码LLM为核心,通过进化迭代优化少样本提示的上下文示例,同时对LLM进行软提示调优,让LLM成为自适应的NAS变异/交叉算子,突破人工搜索空间的限制,利用LLM的代码预训练知识生成多样化、高性能的神经架构代码。
二、相关工作基础
1. 代码大语言模型
大模型在代码生成、数学推理、复杂问题求解上的突破为NAS提供了新可能,预训练LLM编码了丰富的代码结构和功能知识,可直接生成以代码表示的神经架构,无需人工定义搜索基元。
2. 提示工程(Prompting)
少样本提示(Few-shot Prompting)让LLM无需任务特定微调即可完成各类任务,但纯naive提示在NAS这类复杂任务中效果差,需要对提示的上下文示例进行优化。软提示调优(Prompt-tuning)通过微调少量提示参数,让LLM更好地适配特定任务,且计算成本远低于全量微调。
3. 进化神经架构搜索(ENAS)
进化算法是NAS的经典方法,通过“生成-评估-选择”的迭代过程搜索最优架构,但传统ENAS的搜索空间由人工设计,灵活性差。本文将LLM替代人工设计的搜索空间,同时让LLM作为自适应的变异/交叉算子,并通过进化迭代优化LLM的提示输入。
4. 现有相关方法的不足
- Lehman et al. (2022):将LLM作为进化变异算子,但需指定固定的修改类型,灵活性低,且未在真实NAS任务验证;
- Meyerson et al. (2023):将LLM作为交叉算子,但依赖MAP-Elites算法做多样性权衡,且未引入提示调优,未针对NAS的精度-规模双目标优化。
三、EvoPrompting核心方法
EvoPrompting的核心是元学习循环,将进化算法的“生成-评估-选择”与LLM的“提示生成-软提示调优”深度融合,整体框架如图1所示。方法分为问题形式化、LLM作为进化交叉/变异算子、元学习算法三个核心部分。
3.0 EvoPrompting框架总览
EvoPrompting的核心是“进化搜索+LLM提示调优”的元学习循环,整体流程如图1所示:
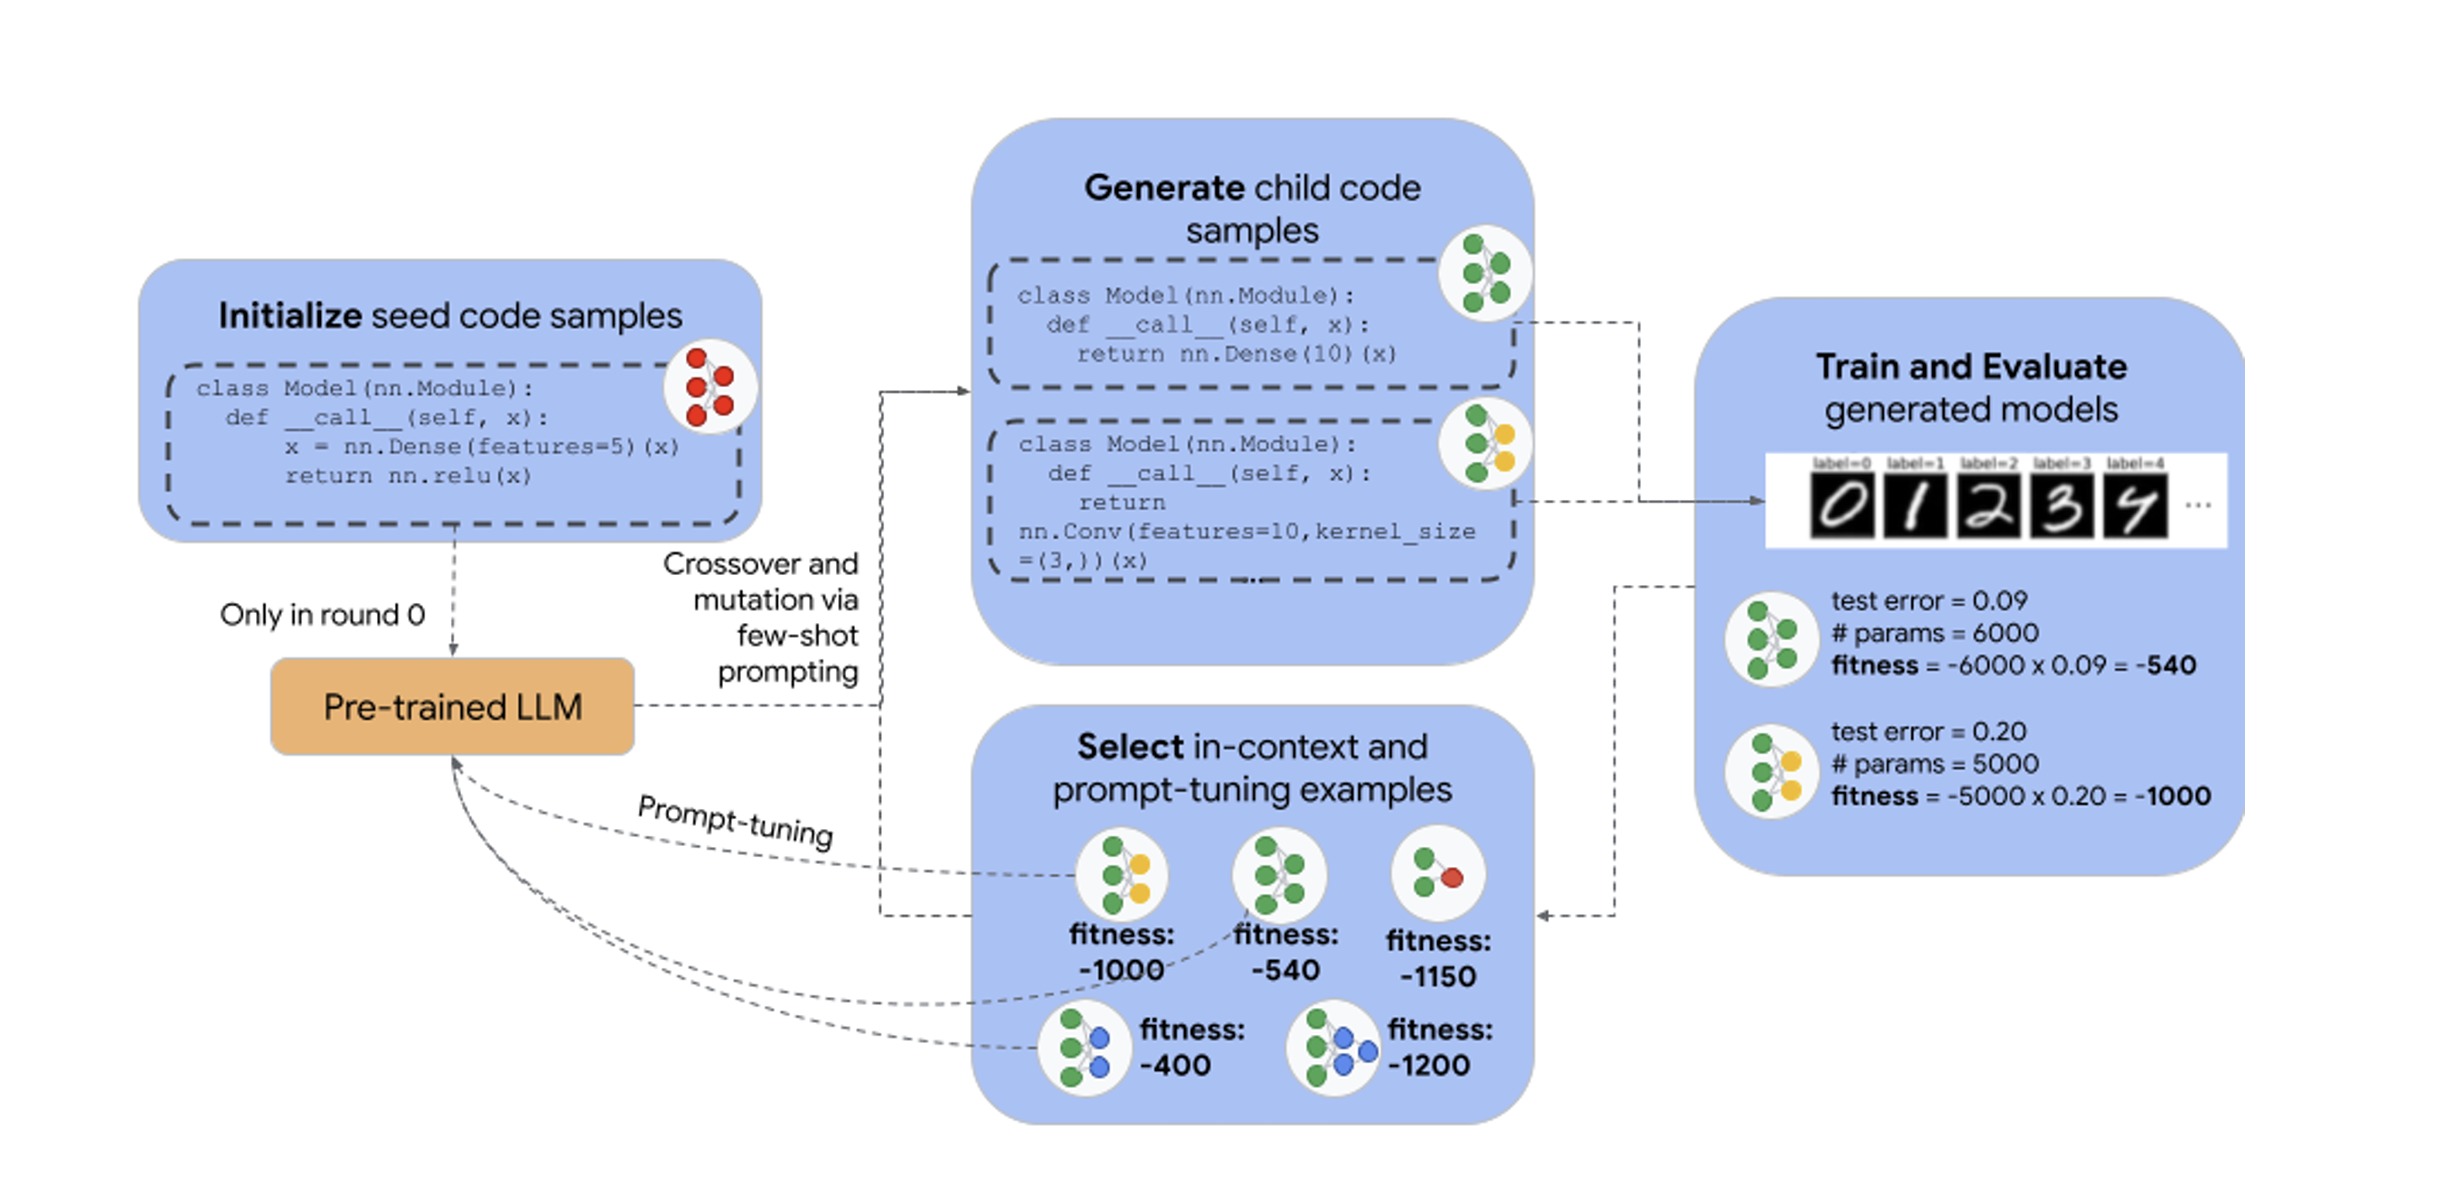
图1:EvoPrompting元学习循环示意图。流程包括:初始化种子代码→LLM生成候选架构→训练评估→筛选最优个体作为下一轮提示示例→LLM软提示调优,迭代循环直至收敛。
3.1 架构搜索问题形式化
- 定义目标任务TTT和数据集DDD,包含输入输出对(x,y)(x,y)(x,y);
- 预训练代码LLM表示为πθ:V→{0,1}\pi_\theta: V \to \{0,1\}πθ:V→{0,1},VVV为LLM词汇表,可采样生成代码片段c∈V∗c \in V^*c∈V∗(即神经架构的代码实现);
- 评估函数EVALT(c,D)EVAL_T(c,D)EVALT(c,D):训练代码ccc对应的架构,输出适应度分数sss,本文将适应度定义为验证误差×模型规模的负值,兼顾精度和模型效率双目标;
- 目标:找到代码集合CCC,最大化Ec∈CE(x,y)∈D[EVALT(c,D)]\mathbb{E}_{c \in C} \mathbb{E}_{(x,y) \in D}[EVAL_T(c,D)]Ec∈CE(x,y)∈D[EVALT(c,D)]。
3.2 LLM作为进化的交叉/变异算子
与传统ENAS的人工设计交叉/变异算子不同,EvoPrompting中LLM承担以下核心作用:
- 搜索空间无人工限制:LLM的词汇表和代码预训练知识构成搜索空间,可生成任意以Python表示的神经架构,突破人工设计的基元限制;
- 自适应算子:通过迭代的软提示调优,LLM可不断学习生成更高适应度的架构,即“算子自身在进化”;
- 交叉+变异融合:基于父代架构的代码和性能指标生成少样本提示,LLM在提示引导下生成子代架构,自然融合交叉(父代特征融合)和变异(新颖特征生成)的功能。
3.3 EvoPrompting元学习算法(核心)
算法由初始化、交叉变异、过滤评估、适应度选择、LLM提示调优5个步骤组成,迭代执行TTT轮,核心伪代码见论文Algorithm 1/2/3,详细流程如下:
步骤1:初始化
- 全局历史种群G=[]G = []G=[],当前种群PPP由人工设计的高性能种子架构初始化(如MNIST-1D的CNN/GRU/MLP,CLRS的Triplet-GMPNN变体),实现搜索的暖启动;
- 种子架构通过EVALT(c,D)EVAL_T(c,D)EVALT(c,D)完成评估,得到适应度分数。
步骤2:交叉变异(CROSSMUT)
基于当前种群PPP生成少样本提示,引导LLM生成子代架构代码,核心细节:
- 提示构造:从PPP中随机选择kkk个父代架构,每个架构包含性能指标(参数量、验证精度)和代码实现,并在提示末尾设置目标性能(父代最小参数量的90%、父代最大精度的102%),引导LLM生成更优架构;
- LLM采样:对每个提示,LLM以混合温度采样(温度从[0.2,0.6,0.8,1.0]均匀选取)生成nnn个子代代码,平衡生成的探索性和利用性;
- 每轮生成m×nm×nm×n个子代架构,记为集合CCC。
提示示例(2-shot,论文Listing 1):
""" Metrics:
{'num_params': '4800', 'val_accuracy': '0.865'}
"""
class Model(nn.Module):
    @nn.compact
    def __call__(self, x):
        x = nn.Dense(features=10)(x)
        return x

""" Metrics:
{'num_params': '4300', 'val_accuracy': '0.880'}
"""
class Model(nn.Module):
    # LLM在此处生成子代架构代码
步骤3:过滤与评估(FILTERANDEVAL)
- 对所有子代代码c∈Cc \in Cc∈C,训练对应的神经架构,得到验证误差;
- 过滤:设置验证误差阈值α\alphaα,剔除误差超过α\alphaα的无效架构,避免无意义的搜索;
- 计算适应度:s=−c.model_size×c.errors = -c.model\_size × c.errors=−c.model_size×c.error,将评估后的有效架构和适应度加入全局种群GGG。
步骤4:适应度基选择(GETTOP)
从全局种群GGG中选择适应度最高的ppp个架构作为下一轮的父代种群PPP,且选中的父代将被永久移除,避免重复使用。该步骤是进化算法的核心,保证搜索向高适应度方向收敛。
步骤5:LLM软提示调优(TRAIN)
将本轮评估后未被选为父代的子代架构作为训练数据,对LLM进行软提示调优:
- 调优细节:软提示长度16,训练5个epoch,批大小16,学习率0.1(基于Lester et al. (2021)的Prompt-tuning方法);
- 核心目的:让LLM学习本轮搜索的经验,优化后续生成架构的能力,实现算子的自适应进化。
算法关键超参数(论文Table 2)
| 超参数 | 含义 | 取值 |
|---|---|---|
| ppp | 每代选择的父代数量 | 10 |
| kkk | 每个提示的上下文示例数 | 2 |
| TTT | 进化轮数 | 10 |
| mmm | 每轮的提示数 | 10 |
| nnn | 每个提示生成的样本数 | 16 |
| α\alphaα | 验证误差阈值 | 0.5 |
3.4 EvoPrompting的核心创新点
- 进化提示工程:通过进化迭代优化少样本提示的上下文示例,解决了纯naive提示在NAS中效果差的问题;
- 自适应LLM算子:将LLM作为NAS的交叉/变异算子,且通过软提示调优让算子自身迭代优化,突破传统ENAS的人工算子限制;
- 无人工搜索空间:以LLM的代码预训练知识为搜索空间,支持生成任意Python表示的神经架构,灵活性远高于传统NAS;
- 双目标优化:适应度函数同时考虑精度和模型规模,生成的架构兼顾高性能和轻量级。
四、实验设置
4.1 实验数据集
选择两个代表性任务,分别验证EvoPrompting在传统视觉架构和复杂算法推理架构上的效果:
- MNIST-1D:轻量级一维MNIST变体,40维特征,4000训练/1000测试样本,无验证集则从训练集划分500样本,适合算法的详细分析,核心任务是卷积架构搜索;
- CLRS Algorithmic Reasoning Benchmark:包含30个经典算法(如BFS/DFS、排序、最小生成树等),以图为输入,评估神经架构的算法推理能力,核心任务是图神经网络(GNN)架构搜索,基线模型为Triplet-GMPNN(Ibarz et al., 2022)。
4.2 实验用LLM
核心模型为62B参数的PALM模型(Chowdhery et al., 2022):
- 预训练:1.3T对话、网页、代码令牌,额外在64B Github的Python代码上微调;
- 采样方式:混合温度采样([0.2,0.6,0.8,1.0]);
- 调优方式:软提示调优(Prompt-tuning),非全量微调。
4.3 基线方法
为验证EvoPrompting各组件的有效性,设计消融实验基线和传统方法基线:
- Naive few-shot prompting:纯少样本提示,仅用种子架构构造提示,无进化迭代和提示调优(T=1T=1T=1);
- EvoPrompting (-prompt-tuning):移除软提示调优步骤,仅保留进化提示工程;
- EvoPrompting (random parents):随机选择父代,而非基于适应度选择,破坏进化的收敛性;
- 人类设计架构:MNIST-1D的CNN/GRU/MLP,CLRS的Triplet-GMPNN;
- 传统NAS算法:在NATS-Bench上与REA、REINFORCE、Random、BOHB等对比。
4.4 训练与评估细节
- 硬件:单NVIDIA Tesla P100 GPU;
- 优化器:AdamW,MNIST-1D训练8000步(学习率0.01,批大小128),CLRS训练2000步(因架构更大);
- 评估指标:测试误差(精度)、模型参数量(规模)、适应度分数(综合指标)、样本效率(评估样本数与最大适应度的关系)。
五、实验结果与分析
5.1 MNIST-1D:卷积架构搜索结果
(1)精度-规模的Pareto前沿(论文Figure 2a)
EvoPrompting的Pareto前沿最接近原点,说明其生成的架构在更低测试误差的同时,模型规模远小于其他基线,部分架构的参数量比人工设计架构小一个数量级,且精度更高。
- 核心发现:EvoPrompting擅长优化卷积架构,生成的更窄、更深、小步长、无全连接层的卷积架构,性能优于人工设计的浅而宽的卷积架构。
(2)样本效率(论文Figure 2b)
- 随机父代基线最快收敛但性能最差,约200个样本后达到性能瓶颈;
- EvoPrompting(无提示调优)收敛较慢,但性能高于纯提示;
- 完整EvoPrompting收敛最慢,但最终达到的最大适应度最高,样本效率最优,说明进化迭代和提示调优的结合能持续挖掘更优架构。
(3)消融实验结论
- 移除适应度选择(随机父代):性能与纯提示相当,说明适应度选择是进化收敛的核心;
- 移除提示调优:性能显著下降,说明LLM的自适应调优对生成高适应度架构至关重要;
- 单一组件缺失都会导致性能大幅下降,进化提示工程+软提示调优是EvoPrompting有效的关键。
(4)迭代轨迹(论文Figure 4)
EvoPrompting从第0轮到第10轮,架构的平均规模和测试误差持续向原点靠近,说明搜索过程持续收敛。其中3-5轮同时优化精度和规模,0-2/6-10轮以小幅规模增加换取精度的大幅提升。
5.2 CLRS:图神经网络(GNN)架构搜索结果
(1)样本效率(论文Figure 3)
在Articulation Points、Graham Scan、Kruskal MST三个高潜力任务上,EvoPrompting的最大适应度仍显著高于基线,虽结果波动比MNIST-1D大(因任务更复杂),但仍验证了方法的有效性。
(2)超越SOTA的新型GNN架构
EvoPrompting生成了5种新型Triplet-GMPNN变体,在CLRS的30个任务中,21个任务的OOD(分布外)精度超越基线Triplet-GMPNN,且多数架构的参数量与基线相当或更小(论文Table 1/3)。核心新型架构及设计亮点:
- QUADNODEMINMAX:用四元组节点表示替代三元组,计算最大值-最小值,在Articulation Points任务上OOD精度达100%;
- CONCATREP:将节点/边/图表示拼接投影层和前馈层,在Heapsort任务上OOD精度提升125.19%,参数量仅增加6.68%;
- DIV2MEAN:将节点表示缩放1/2,用均值聚合替代最大值聚合,在DFS/Insertion Sort/Quicksort上精度大幅提升且规模下降;
- MAXMEAN:先对三元组取最大值再取均值,在BFS/Graham Scan上实现100%/93.76% OOD精度;
- TANHEXPANDTRIPLETS:对三元组做维度扩展,最大值聚合后加tanh激活,在Task Scheduling上精度略超基线且规模相同。
(3)跨任务泛化性
新型架构在未参与搜索的CLRS任务上仍表现优异,说明EvoPrompting生成的架构并非过拟合单一任务,而是学习到了算法推理的通用特征,具备良好的泛化性。
5.3 NATS-Bench:与传统NAS算法对比
在NATS-Bench的规模搜索空间上,EvoPrompting与REA、REINFORCE、Random、BOHB等传统NAS算法对比(论文Table 4),结果显示:
- EvoPrompting在CIFAR-10/CIFAR-100/ImageNet-16-120上的验证/测试精度与传统NAS算法相当,部分指标略优;
- 注:该对比为非公平对比(LLM被限制生成固定格式的架构字符串,丧失代码预训练优势),但仍验证了EvoPrompting在传统NAS基准上的竞争力。
六、结论与局限性
6.1 核心结论
- 进化提示工程大幅提升LLM的复杂任务能力:纯少样本提示无法完成NAS,但结合进化迭代和软提示调优后,LLM可生成超越人类设计的神经架构;
- EvoPrompting是高效的通用NAS方法:在卷积架构和GNN架构搜索上均实现SOTA,生成的架构兼顾高精度和轻量级,且无需人工设计搜索空间;
- LLM作为自适应进化算子的潜力:LLM的代码预训练知识可替代人工设计的NAS算子,且通过提示调优实现算子自身进化,为NAS提供了新范式;
- 通用性:EvoPrompting不仅适用于NAS,还可推广到所有依赖上下文学习(ICL)或提示调优的LLM任务。
6.2 方法局限性
- 与传统NAS的对比不充分:因EvoPrompting为开放式搜索,而传统NAS为封闭式搜索,缺乏公平的对比基准,仅在NATS-Bench上做了初步对比;
- 计算成本较高:基于62B PALM模型的生成和调优需要一定的计算资源,暂无法在低算力设备上运行;
- 依赖高质量种子架构:初始化的种子架构质量会影响搜索的收敛速度和最终性能,若种子架构较差,可能导致搜索陷入局部最优。
6.3 未来研究方向
- 降低EvoPrompting的计算成本,适配小参数量LLM;
- 扩展到更多任务,如Transformer架构搜索、多模态模型架构搜索;
- 结合检索增强提示(Retrieval-Augmented Prompting),进一步提升LLM生成架构的质量;
- 探索无种子架构的零初始化EvoPrompting,摆脱对人工设计架构的依赖。
七、论文核心亮点总结
- 首次将进化算法与LLM提示工程深度融合,提出EvoPrompting范式,解决了LLM在复杂NAS任务中效果差的问题;
- 突破传统NAS的人工搜索空间限制,以LLM的代码预训练知识为搜索空间,实现开放式神经架构搜索;
- 兼顾性能与效率,生成的架构在多个基准上超越SOTA,且参数量更小,具备实际应用价值;
- 方法通用性强,不仅适用于NAS,还可推广到所有LLM的上下文学习任务,为大模型的复杂任务推理提供了新思路。
论文地址:https://arxiv.org/abs/2310.03744
代码:论文未公开官方代码,可基于PALM/LLaMA等代码LLM结合进化算法复现。
小龙虾开发者社区是 CSDN 旗下专注 OpenClaw 生态的官方阵地,聚焦技能开发、插件实践与部署教程,为开发者提供可直接落地的方案、工具与交流平台,助力高效构建与落地 AI 应用
更多推荐
 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)