登录社区云,与社区用户共同成长
邀请您加入社区
时序数据库选型应聚焦数据链路而非单纯性能。基于工业场景的“端-边-云”架构,Apache IoTDB 凭借树/表双模型、TsFile 存储优化、乱序写入分离、边缘轻量部署(512MB内存)及内置AI推理能力,在高基数、低资源环境下具备显著适用性。其核心优势在于生态集成与真实场景适配,而非跑分。选型关键:先画链路图,再对齐建模、协议、部署与成本约束。
文章摘要:数字人落地面临三大技术瓶颈:视频流架构的高延迟、交互打断不自然、云端渲染成本过高。魔珐星云提出参数流解决方案,通过端侧AI渲染实现低延迟(≈500ms)、低成本、高并发的数字人交互。文章详细对比了参数流与视频流的技术差异,并提供了30分钟快速接入魔珐星云SDK的实战案例,展示如何实现"用户输入→大模型响应→数字人实时反馈"的完整具身智能交互链路,为数字人商业化落地提供了可行路径。 (字数
AI编程终极扫盲指南 本文系统梳理AI编程核心概念,帮助开发者快速掌握必备知识: 基础概念解析 Token:AI处理的最小文本单位,1Token≈0.75英文单词/0.5-1汉字,直接影响计费和上下文限制 上下文长度:模型的"记忆容量",主流模型1-2M Token(可处理2000+页代码) 推理模式:标准推理(快/便宜)vs 思维链推理(慢/贵但适合复杂问题) API调用要点 API Key:调
在美妆穿搭内容爆发式增长的当下,一个**会说话、会展示、能实时互动**的 3D 数字人,既能降低真人出镜成本,又能打造统一时尚 IP。本文基于**魔珐星云具身智能平台**,从 0 到 1 完整搭建「美妆穿搭达人数字人」,全程不涉及复杂建模,新手可直接复刻,包含环境配置、代码修改、界面美化、功能联调全步骤
摘要: 在快节奏生活中,孤独感和情绪内耗成为普遍问题。传统AI助手缺乏情感温度与真实交互体验。本文介绍基于魔珐星云具身智能数字人平台开发的日常生活陪伴数字人,通过3D形象、表情动作和语音交互,提供情绪安抚、生活提醒等陪伴功能。项目采用零基础低代码开发,整合大模型对话能力,实现多模态实时交互,具备真实感强、响应快、跨端适配等优势,为普通开发者提供高效创作路径,填补AI情感陪伴的空白。
Claude一夜翻车!4月6日的新功能刚一上线,就遭遇大规模宕机,开发者怒喷「神坛崩塌」,性能退化降智、token狂烧,prompt封杀更是惹众怒,Anthropic到底怎么了?Anthropic翻车了!最近几天,全球开发者社区的愤怒,正像火山一样爆发,Claude仿佛一夜之间就跌下了神坛。就在昨天,Anthropic推出了Claude Code v2.1.92,带来了一个听起来很酷的新功能——U
Google新一代AI图像生成模型Nano Banana 2(Gemini 3.1 Flash Image)正式发布,具备4K分辨率、精准文字渲染和实时网页搜索等突破性功能。该模型在图像质量、推理能力和主体一致性方面全面升级,支持多语言翻译和极端画幅,生成速度更快且成本更低。用户可通过DeepSider浏览器插件免费体验,适用于电商设计、科研绘图等多元场景,为创意工作提供高效支持。
这是一份情景推演,而非预测。作者并非 AI 悲观主义者或末日论者。唯一目的是建模一个相对未被探索的情景,帮助读者为 AI 让经济变得越来越“怪异”时的潜在左尾风险做好准备。
【摘要】本文探讨了FastGPT作为企业级AIAgent构建平台的核心价值。当大模型能力趋同,真正的竞争在于如何将LLM转化为稳定、可编排的业务系统。FastGPT通过三层核心能力——模型接入层、知识库管理(RAG)和可视化Workflow编排,解决了Agent工程化的关键问题。平台支持复杂场景如智能客服、文档分析等,通过MCP协议实现外部系统调用,使Agent真正落地。特别适合需要稳定性、可维护
DeepSeek模型通过创新的MoE 3.0架构和MLA注意力机制实现了高效性能。MoE 3.0采用32个专项专家模块,通过动态路由机制按需激活3.3B参数,相比传统13B模型降低67%计算量,推理速度提升2.1倍。MLA技术将传统二维注意力升级为三维矩阵,通过语义分组和代表token机制,使128K文本处理的显存需求从48GB降至19.2GB,速度提升50%。这些技术突破使模型在保持高性能的同时
《AIGC高效编程:Python从入门到高手》愿成为你通往未来的一块坚实踏板。 让AI陪你学,让Python陪你走。今天开始,一切都不晚。
本文详细介绍了RAG中的四种文本分块技术:固定大小分块实现简单速度快,适合对语义要求不高的任务;递归字符分块保持语义完整性,适合中英文混合文本;语义分块基于句子向量计算,确保块内语义高度一致,适合长篇文章;基于文档结构的分块保留宏观逻辑,适合RAG应用。文章通过代码示例展示了各种分块方法的实现,并提供了根据需求选择合适分块策略的指导。
【摘要】系统介绍了构建复合智能体的技术框架与实践方法。指出单一LLM在复杂业务场景下的局限性,提出通过模块化设计实现可控性、工具化、可组合性和可审计性的目标。核心部分详细解析了六大组件:LLM作为基础接口层、RAG增强事实检索、Memory管理系统状态、Tooling实现外部调用、MCP/A2A标准化交互协议,以及LangChain等编排框架的使用。随后对比了三种典型架构模式的适用场景,并举例说明
【摘要】随着大模型在企业级落地加速,技术选型正从框架工具向完整服务体系演进。本文从 LangChain 的原型探索切入,梳理企业级 LLM 服务在架构设计、可观测性、私有化部署、向量数据库与生态集成等关键维度的演化路径,并结合应用场景与实践经验,为企业搭建稳定、可扩展的大模型应用提供系统化参考。
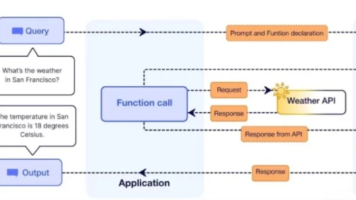
本文详细解析了大模型的Function Calling技术,解释了它如何让大模型在遇到无法处理任务时自动调用外部工具或API。文章介绍了Function Calling的工作流程,包括理解用户输入、上下文管理、识别功能并调用、生成输出内容四个步骤,并澄清了常见误区:大模型本身不具备执行工具的能力,而是通过程序生成工具参数并由程序执行。最后推广了智泊AI的AI大模型课程,帮助学习者掌握这一关键技术。
Embedding技术作为RAG系统的核心,将非结构化文本转化为语义向量,使机器能理解文本相似度。文章详解了从Word2Vec到Sentence-BERT的模型演进、Transformer自注意力机制原理、向量生成流程,以及在RAG系统中如何实现知识检索。同时分析了长文本处理、领域适配、计算效率等挑战及未来发展方向,强调了Embedding作为"机器理解人类语言的通用语言"对AI应用落地的关键价值
摘要: 2017年,谷歌提出的Transformer架构彻底改变了人工智能领域,从最初的机器翻译任务扩展为通用计算引擎,广泛应用于跨语言翻译、蛋白质结构解析、虚拟对话等场景。Transformer通过自注意力机制解决了长距离依赖和并行计算难题,其编码器-解码器结构(含多头注意力和前馈网络)支持多模态数据处理。输入文本经Tokenizer转为ID序列,再通过嵌入层(词嵌入+位置编码)转换为向量。核心
作者结合自学前端经验尝试套用传统学习路径失败后,总结出适合工程师的AI学习路线:1)避开过早钻研数学原理,从B站/YouTube优质课程入手(推荐李宏毅教授的系列课程);2)通过LangChain等框架文档实践基础开发;3)深入研究GitHub开源项目(如字节Deer-Flow、清华MiroODR)并动手复现;4)强调"学以致用"需结合真实项目,避免停留demo阶段。文末附赠大模型学习资源包(含路