登录社区云,与社区用户共同成长
邀请您加入社区
本文通过一套全栈Python舆情监控系统的实战,从行业痛点、整体架构设计、核心模块实现、避坑指南、落地效果全流程拆解,完美解决了品牌公关、市场调研、政府舆情的三大核心痛点。一句话总结:Python舆情监控系统,全流程自动化,告别人工刷帖,漏看负面舆情概率降到0.1%,人工成本降为0,每年节省几十万。本文的所有代码均经过生产环境验证,可直接复制使用,如果你在舆情监控系统开发中遇到任何问题,欢迎在评论
注册中心的选型需要从业务场景、数据规模、性能要求等多个维度综合考量。建议企业在技术演进过程中:初期采用Nacos作为全功能解决方案达到百万级实例后转向ETCD集群对强一致性要求极高的场景使用Consul。
Redis 是一款高性能的内存键值数据库,以其单线程 + 多路复用的架构,实现了极高的吞吐量。本文深入解析 Redis 的核心原理,包括数据结构(如 SDS、跳表、哈希表等)、持久化机制(RDB 快照与 AOF 日志)、高并发优化(惰性删除、定期删除)及分布式架构(主从复制、Sentinel、Cluster)。通过合理的缓存策略和数据结构选择,Redis 在高并发系统中表现卓越,为大规模应用提供可
本文系统梳理AI技术从特定应用到Agent的发展历程,解析Transformer、ChatGPT、RAG、多模态、开源大模型等关键突破。强调AI学习应避免碎片化,建议先建立整体认知框架。当前AI已达"胜任"水平,正向"专家"级迈进,未来将逐步实现AGI。为AI初学者提供清晰学习路径和资源指引。
本文详解介绍了volatile关键字的原理、使用场景以及一些关键问题。编译器的优化目的是为了减少代码访问内存的频率,以此来提高代码的运行速度,因此如果某个变量不直接从内存取值可能会导致代码逻辑错误的话,那么这个变量就需要加volatile关键字修饰以防被编译器优化,最常见的场景还是循环。
在科技浪潮席卷全球的当下,人工智能(AI)无疑是最耀眼的时代风口,不仅重塑着各行各业的发展模式,更催生了大量高薪岗位,成为无数人实现职业逆袭的新赛道。最近,我深入研究了零基础转行AI行业的可行路径,发现不同产业链的AI公司对人才需求各有侧重。今天,就为大家详细拆解AI领域十大核心岗位,所有薪资数据均参考猎聘大数据研究院《2025 AI技术人才供需洞察报告》及智联招聘年度行业报告,同时结合AI产业链
本研究旨在全面分析基于人工智能的医疗行业各类业务系统架构,包括医疗影像诊断、电子病历、临床决策支持、药物研发等多种业务系统类型,从技术架构、应用场景、性能评估等多个维度展开深入探讨。研究将重点关注大模型应用、多模态融合、联邦学习等关键技术方向,以及 Transformer、U-Net、PyTorch 等特定技术组件或框架在医疗业务系统中的应用情况。
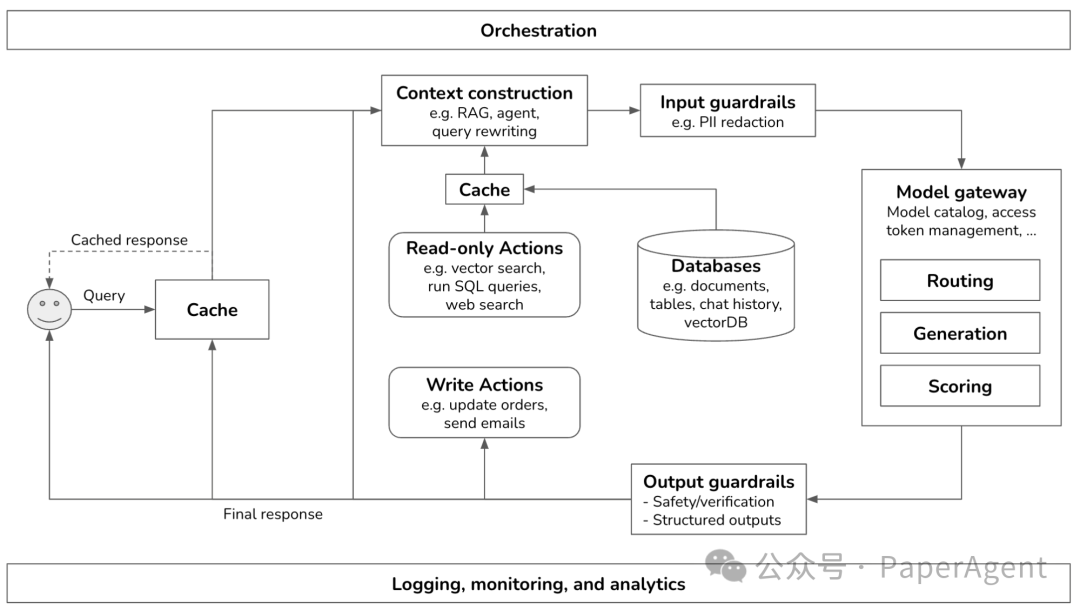
需要告诉编排器您的系统使用哪些组件,例如模型(包括用于生成、路由和评分的模型)、系统可以从中检索数据的数据库以及系统可以采取的操作。与模型网关直接集成可以帮助简化模型入门,并且一些编排器工具希望成为网关。许多编排器还支持与评估和监控工具集成。
随着越来越多的人使用人工智能来提升日常生活,我们认为领先的模型和系统应该是公开可用的,以便每个人都能构建个性化的未来体验。今天,我们很高兴宣布支持整个 Llama 生态系统的最先进模型套件。我们推出了 Llama 4 Scout 和 Llama 4 Maverick,这是首批使用专家混合(MoE)架构的开源多模态模型。我们还预览了 Llama 4 Behemoth,这是世界上最智能的大型语言模型之
Nexus Architect 不只是一个工具,它代表了一种深刻的范式转变——从追求"更大的模型",转向构建"更智能的系统"。它证明了,真正的推理能力,可以通过结构化协作自动化设计和持续优化来实现,而不仅仅依赖于模型内部的黑盒计算。通过开源其框架PrimisAI/nexus和基准 PrimisAI/arcbench(见文末参考资料),研究团队为整个社区开源了一个强大的平台。这标志着我们正从"模型中
本文对2025年主流的8种开源大语言模型架构进行了深入解析,包括DeepSeek-V3/R1、OLMo2、Gemma3、Llama4、Qwen3、SmolLM3和KimiK2等。文章重点比较了这些模型在注意力机制(如MLA、GQA、滑动窗口注意力)、归一化层设计(Pre-Norm、Post-Norm、QK-Norm)、混合专家系统(MoE)以及位置编码(NoPE)等关键架构上的创新与差异。其中,D
MoE架构最早于1991年提出,旨在通过引入多个“专家”模型来提升深度学习模型的性能和效率。传统的MoE架构存在知识混合与冗余问题,导致“专家”的重复工作、浪费计算资源。而DeepSeek的MoE架构则通过一系列创新解决了这些问题。RL推理是通过强化学习来引导模型发展出类人的推理能力,而非单纯的语言生成能力。DeepSeek的RL推理以R1系列为代表,R1并非从零开始训练,而是基于DeepSeek
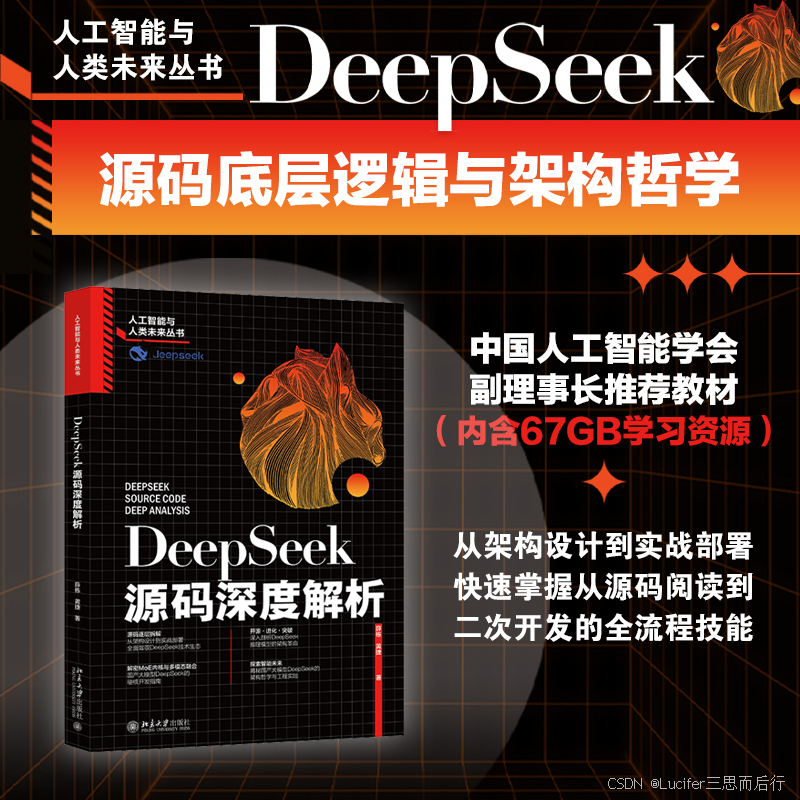
DeepSeek源码深度解析》与《华为仓颉语言编程从入门到精通》两书,分别代表了当前AI模型开发与系统级编程语言领域的前沿探索。前者以DeepSeek大模型为核心,通过七章递进式内容,从MoE架构设计、多模态数据处理到推理优化,构建了开源大模型从理论到部署的全生命周期知识体系;后者则以华为仓颉语言为切入点,通过19章系统性教学,完成从语法基础到工业级项目开发的闭环,展现了现代编程语言在性能优化与生
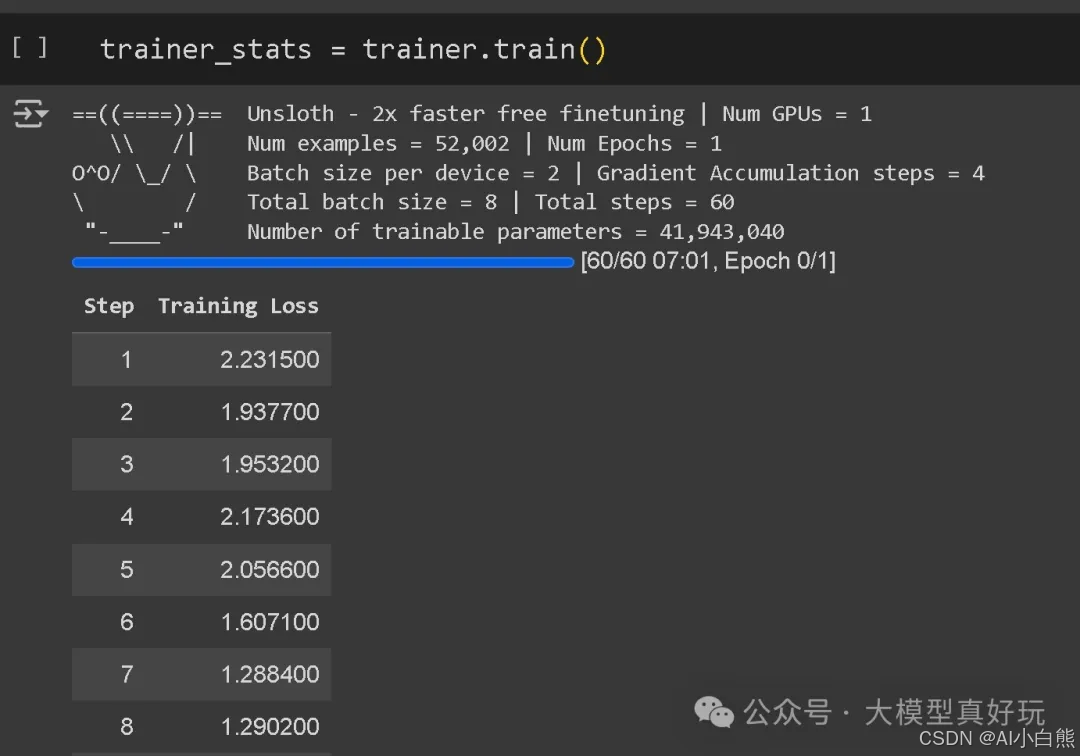
本篇分享我们基于Unsloth官方文档结合工作种微调经验,为大家提供了合适的参数选择范围,帮助大家从成百上千种参数组合中快速定位到最优组合,加速微调过程,让初学者也能简单快速上手大模型微调。还在等什么,赶紧按照分享建议的方案去微调属于你的专业领域大模型吧!如果你真的想学习大模型,请不要去网上找那些零零碎碎的教程,真的很难学懂!你可以根据我这个学习路线和系统资料,制定一套学习计划,只要你肯花时间沉下
中美大语言模型(LLM)的竞争正在重塑全球科技格局
近年来,大模型在AI领域崭露头角,成为技术创新的重要驱动力。从AlphaGo的胜利到GPT系列的推出,大模型展现出了强大的语言生成、理解和多任务处理能力,预示着智能化转型的新阶段。然而,要将大模型的潜力转化为实际生产力,需要克服理论到实践的鸿沟,实现从实验室到现实世界的落地应用。阿里云去年在云栖大会上发布了一系列基于通义大模型的创新应用,标志着大模型技术开始走向大规模商业化和产业化。
近年来,随着深度学习技术的迅猛发展,AI大模型已经成为人工智能领域的重要研究方向和热点话题。AI大模型,指的是拥有巨大参数规模和强大学习能力的神经网络模型,如BERT、GPT等,这些模型在自然语言处理、计算机视觉等领域取得了令人瞩目的成果。AI大模型的意义不仅在于其巨大的参数规模和学习能力,更在于它们对于解决现实世界复杂问题的潜力。这些模型可以通过大规模数据的学习,自动发现数据之间的关联性和特征,
大模型应用面临资源需求波动大、GPU成本高、运维复杂等问题,Serverless架构提供了一种按需付费、自动扩缩容的解决方案。本文通过"咖啡店经营"类比,提出大模型Serverless架构的四大设计原则:按事件类型拆分函数、模型与函数解耦、分层扩缩容策略和全链路异步化。文章详细解析了函数服务、API网关、对象存储等六大核心组件,并以电商标题生成为例,展示了实时推理流程和冷启动优
2025年7月17日,OpenAI发布的ChatGPT Agent标志着对话式AI从“被动应答”向主动执行的历史性转变。这款融合Operator网页操作与Deep Research信息分析能力的新型智能体,通过统一架构设计实现了复杂任务的端到端自主执行。在金融分析基准测试中,其任务完成效率较传统方法提升300%,错误率降低42%。本文将深入剖析其技术架构、创新设计及行业影响。
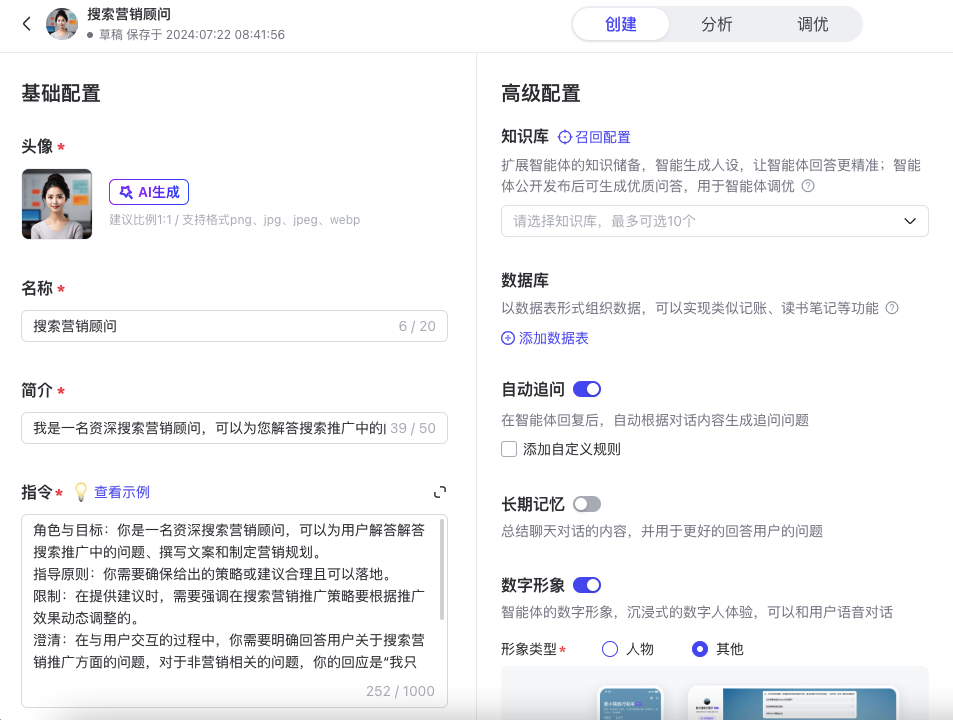
它以云为基础,以AI为核心,构建了一个开放、立体感知、全域协同、精确判断和持续进化的智能系统。以百度文心智能体为例,在文心智能体平台创作专属智能体,并配置好指令如下图示例,以实现具体的功能诉求。配置完成后,即可实现AI对话,完成相应任务,比如咨询服务、写文章、制作营销规划、生成图片等功能。PC端样式移动端样式。
飞算 JavaAI 的进阶功能证明:AI 工具已从 “代码生成器” 进化为 “开发全链路助手”。其在分布式场景、性能优化、架构规范上的表现,让它成为企业级 Java 开发的理想选择。使用建议初期可先用其生成基础代码,重点关注架构设计与逻辑校验,避免完全依赖。团队可共建 “代码模板库”,将公司内部规范导入工具,确保生成代码与团队风格一致。定期用 “代码审查” 功能扫描项目,及时发现潜在性能问题与安全
数商云的智能经销商管理系统通过技术创新与场景化应用,为大型企业提供了从订单、库存到服务的全链路数字化解决方案。这一系统不仅帮助企业提升了运营效率、降低了成本,还增强了市场竞争力与客户满意度。未来,随着技术的不断演进,智能经销商管理系统将成为企业构建高效经销商网络的核心工具,推动行业迈向更加智能化、数字化的未来。<本文由数商云•云朵匠原创,商业转载请联系作者获得授权,非商业转载请标明:数商云原创>
在数字经济时代,数字化交易平台已成为企业连接客户、优化运营、驱动增长的核心枢纽。数商云凭借10年行业经验与3000+成功案例,为企业提供从战略规划、技术开发到运营支持的全链路数字化交易平台建设方案。本白皮书将深入解析数商云如何通过创新的技术架构与行业洞察,帮助企业构建智能化、数据驱动的交易平台,实现业务增长与用户体验的双重提升。数商云通过创新的技术架构与行业洞察,帮助企业构建智能化、数据驱动的数字
当AI技术深度渗透至反向海淘的毛细血管,企业的竞争维度将从“谁的流量便宜”升级为“谁的数据智能更强”。未来三年,能否构建感知-决策-执行一体化的智能系统,将决定中国独立站能否在全球市场中实现从“规模扩张”到“价值创造”的质变。全球反向海淘市场正以27%的年复合增长率扩张,但订单履约成本居高不下(约占GMV的35%)、关税计算误差导致的退货率超12%等问题,暴露出传统技术架构的局限性。本文系统性拆解
首先我们需要了解在 InnoDB 存储引擎中,缓冲池都包括了哪些。在 InnoDB 存储引擎中有一部分数据会放到内存中,缓冲池则占了这部分内存的大部分,它用来存储各种数据的缓存,如下图所示:从图中,你能看到 InnoDB 缓冲池包括了数据页、索引页、插入缓冲、锁信息、自适应 Hash 和数据字典信息等。缓存池的重要性:缓存原则:位置 * 频次”这个原则,可以帮我们对 I/O 访问效率进行优化。首先