登录社区云,与社区用户共同成长
邀请您加入社区
使用requests库每晚12点预约体育馆
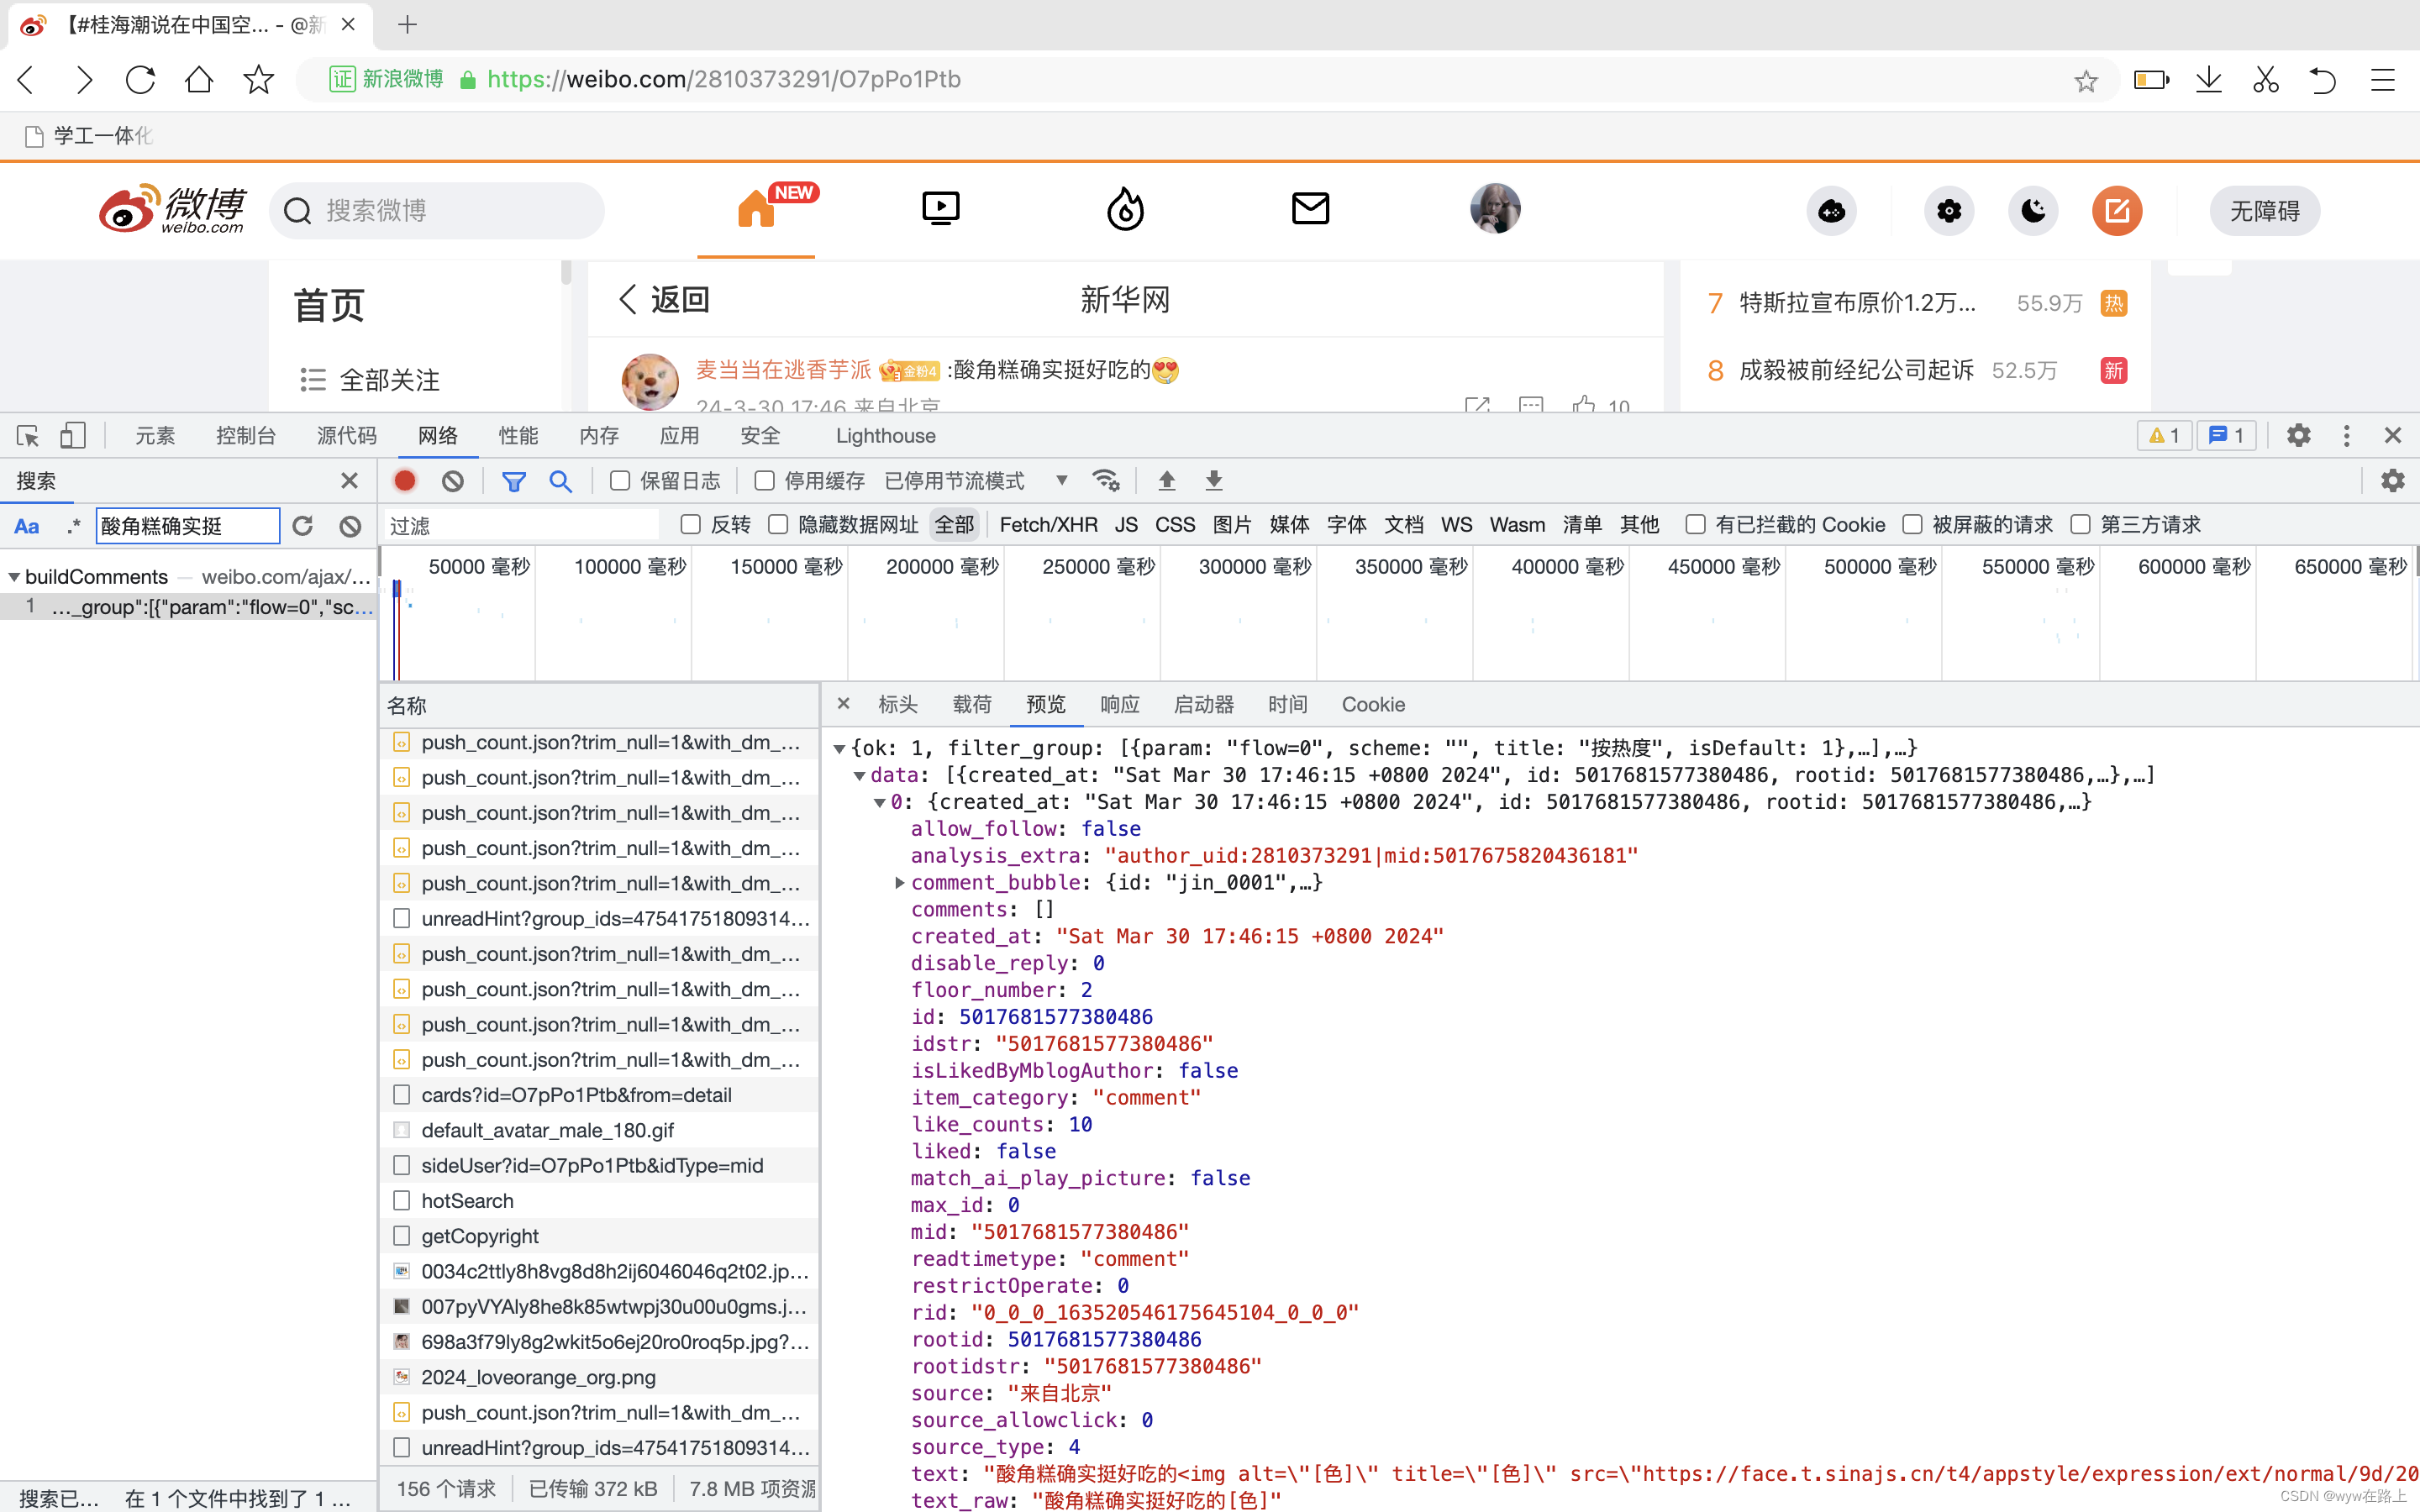
本文想要达成的目标为:运行 python 代码之后,在终端输入视频链接,可自动下载高清 1080P 视频并保存到相应文件夹。具体可分为两大步:首先,使用浏览器开发者工具 F12 获取请求链接相关信息(根据 api 接口下载?加密参数信息?是从 html 文件获取到具体的链接?链接在 html 文件中位置?然后,确定使用的 python 库,并写出代码。
一、Selenium简介一、Selenium简介Selenium是一个用于Web应用程序自动化测试工具。Selenium测试直接运行在浏览器中,就像真正的用户在操作一样。支持的浏览器包括IE(7, 8, 9, 10, 11),Mozilla Firefox,Safari,Google Chrome,Opera等。适用于自动化测试,js动态爬虫(破解反爬虫)等领域。
2025 年国庆前夕,DeepSeek 再次“无预警放大招”,发布了全新通用模型该版本基于持续训练而成,核心创新在于引入了,显著提升了模型在长上下文任务中的训练与推理效率。
本文介绍了Bright Data推出的MCP网页抓取工具,该工具可帮助AI开发者和数据工程师实时连接并理解互联网内容。文章提供了免费试用链接,注册可获得30美元测试资金,适合验证AI模型原型或轻量级部署。推荐关注官方技术博客和GitHub等渠道获取最新动态。小贴士建议先用免费额度测试项目可行性,适合开发者及创业团队使用。
基于Python的就业信息推荐系统 Python+Django+Vue.js,可以通过对求职者的简历、职业倾向和市场需求的深度分析,运用大数据和人工智能技术,为求职者提供个性化的职位推荐,帮助他们更高效地找到理想工作
本文记录了作者与ChatGPT进行Python爬虫学习的角色扮演过程。文章展示了四个初级实践任务:1) 爬取Quotes to Scrape网站前三页名人名言并保存为CSV;2) 从彼岸图网下载首页图片;3) 爬取Books to Scrape网站书籍标题和价格;4) 处理分页数据并去重。每个任务都提供了完整代码实现,包括网页请求、数据解析(BeautifulSoup)、文件存储等关键步骤。作者强
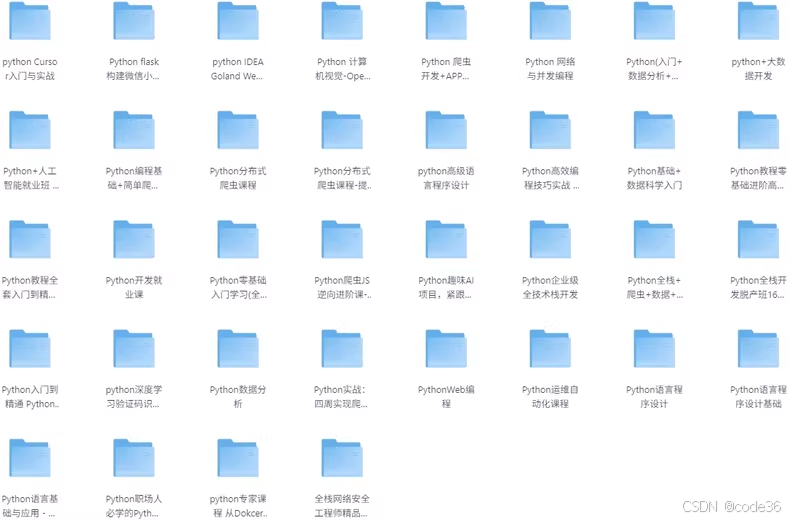
Python企业级全技术栈开发。- Python高级语言程序设计。- Python IDEA开发。- Python爬虫开发APP。- Python人工智能就业班。- Python基础+数据分析。- Python分布式爬虫课程。- Python零基础入门学习。- Python网络并发编程。- Python数据科学入门。- Python高效编程技巧。- Python趣味AI项目。- Python入门与
计算机毕业设计hadoop+spark+hive酒店推荐系统 酒店数据分析可视化大屏 酒店爬虫 酒店预测系统 大数据毕业设计 Sqoop
和周期性爬行和刷新页面的网络爬虫相比,增量式爬虫只会在需要的时候爬行新产生或发生更新的页面,并不重新下载没有发生变化的页面,可有效减少数据下载量,及时更新已爬行的网页,减小时间和空间上的耗费,但是增加了爬行算法的复杂度和实现难度。由于商业原因,它们的技术细节很少公布出来。Raghavan等人提出的HIWE系统中,爬行管理器负责管理整个爬行过程,分析下载的页面,将包含表单的页面提交表单处理器处理,表
但是我们发现这个并不是像我们想的一样,将网页的文本用文字的方式呈现,那么接下来我们要用到一个方法,让我们能够用文字的方式输出网页数据----->定义请求头。为什么要定义请求头,因为从网站的设置初衷,它是不想服务于我们的爬虫程序的,网站正常只想服务于客户的访问服务,那么我们要将我们的爬虫程序伪装成为正常的服务。
从我们的第一次爬取中,我们注意到 category 页面也被爬取了,而我们对它们不感兴趣,所以让我们将它们排除在爬取之外。在爬取规则下,添加一个新规则来禁止爬取以路径模式 /catalogue/category/ 开头 (Begins with) 的页面。现在我们可以在新规则生效的情况下重新进行一次爬取。注意:作为探索过程的一部分,每次更改网络爬虫配置时,我建议删除内容。在最后一章 “准备生产部署
如对本文内容有任何疑问、建议或意见,请联系作者,作者将尽力回复并改进📓;(联系微信:Solitudemind )😎成功注册账户并登录之后🎉,在用户界面输入折扣代码😜,即可享受抵扣🎁!点击下方名片,加入IT技术核心学习团队。一起探索科技的未来,共同成长。🪁🍁 希望本文能够给您带来一定的帮助🌸文章粗浅,敬请批评指正!👍亮数据特为粉丝呈上 10 美金的抵用券👏。🤨倘若存在相关问题?
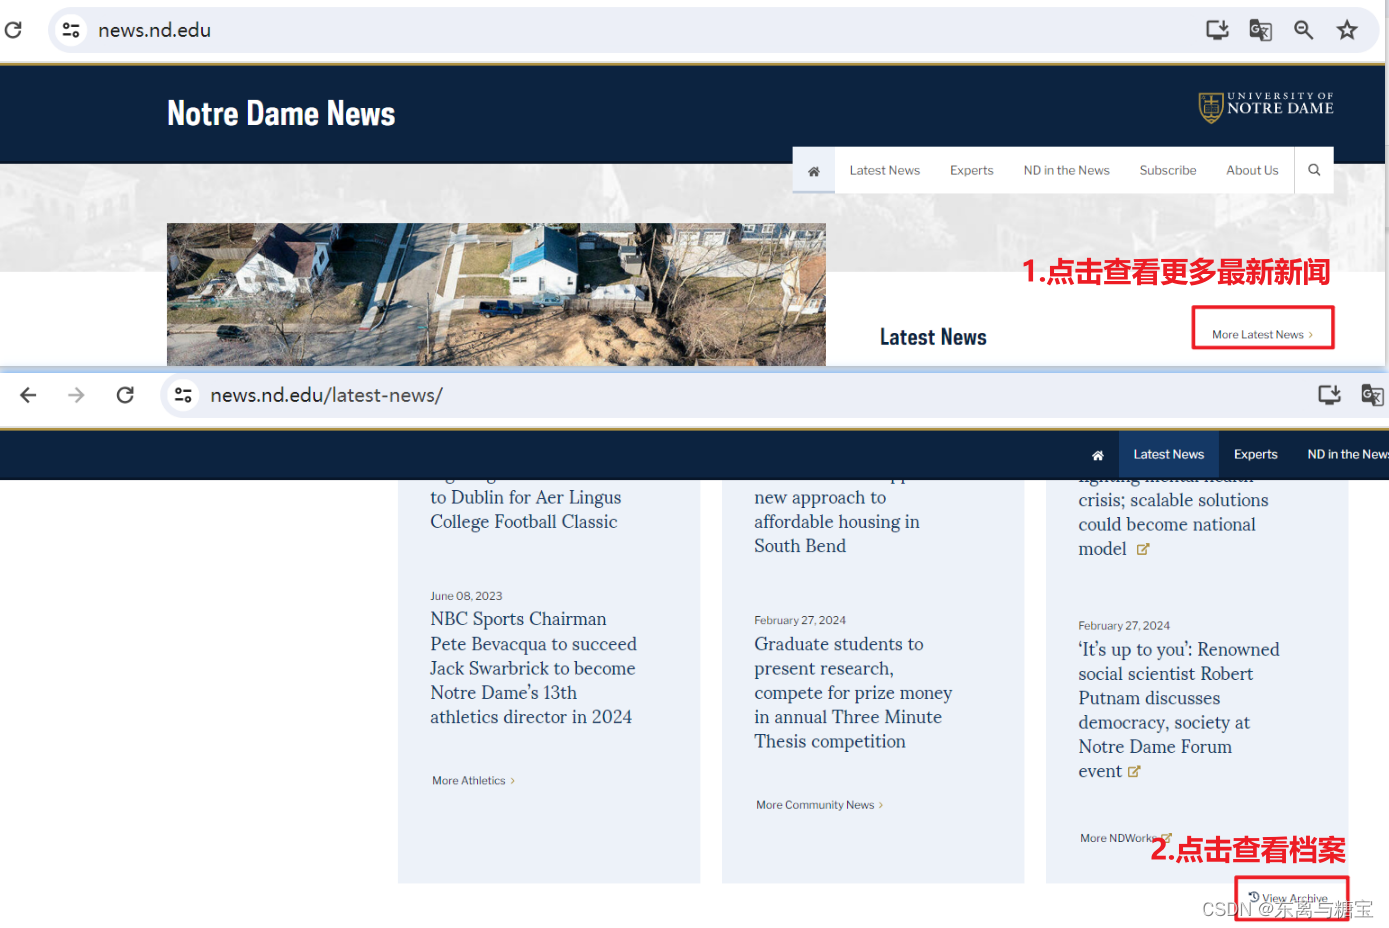
由于一个版面对应一篇文章,所以版面url 、更新时间、标题和文章是一样的,并且按照设计版面id和文章id的区别只是差了个01,所以可以传递版面url、版面id、更新时间和标题四个参数到解析文章的函数里面。我们发现有两种方式查看所有新闻,一种是按照类别,一种是按照时间,经过进一步的观察我们发现按照时间查看新闻会更全,所以我们选择按照年份(按照月份和按照年份一样的效果)爬取。的字段,包含标题、内容,作
b占视频 爬虫selenium:unexpected keyword argument 'options' & use options instead of chrome_options
在大数据时代,信息采集是一项重要的工作,而互联网中的数据是海量的,如果单纯靠人力进行信息获取,不仅低效繁琐,而且搜集的成本也会提高,如何自动高效地获取互联网中的数据是一个重要的问题,而爬虫技术就是针对这些问题而生的。网络爬虫(Web crawler)又称为网络蜘蛛或网络机器人,是一种自动化程序,用于在互联网上浏览和抓取信息,是互联网时代一项普遍运用的网络信息搜集技术。该项技术最早应用于搜索引擎领域
这是一个使用JavaScript编写的爬虫程序,它使用了Elasticsearch和Nginx来收集和存储数据。在这个程序中,我们首先设置了代理信息,然后使用JavaScript编写了一个爬虫程序来收集数据。
目标网站:aHR0cHM6Ly9wYXNzcG9ydC5tZWl0dWFuLmNvbS9hY2NvdW50L3VuaXRpdmVsb2dpbg==最后看下成果吧,基本是全过的。
如:https://img.alicdn.com/imgextra/i3/15353738/TB2HDHAqN9YBuNjy0FfXXXIsVXa_!请求参数:imgid=http://g-search3.alicdn.com/img/bao/uploaded/i4/O1CN01IDpcD81zHbpHs1YgT_!获取加密时间的接口:https://open-s.1688.com/openser
本项目的目的是练习刚刚学到的golang语言语法与特性下面做简要介绍:1.首先打开开始页面.2.抓取下一页的地址,这里用。
打开网址:https://www.geetest.com/adaptive-captcha-demo。t(f’背景图:{slice_image_url}')
但是爱偷懒的程序员拿到需求还是去翻找了一些大型网站寻找下有没有大恩人免费发过!首先他的需求是爬取某天气网站的某年到某年中的天气情况,导出到Excel中!分享下我掉好几根头发写出的代码把!(爱学习的小伙伴也一起过来掉头发吧)得知需求后我先去网址查看了下难不难,结果我一看还算可以。最近闲来无趣,帮一大学生搞了个小作业,来分享下成果!看来还是得靠自己去动脑搞了,又是掉头发的一天。结果一点不理想,根本都不
只要想提取的表格是属于<table 标签内,就可以使用pd.read_html(),它可以将网页上的表格都抓取下来,并以DataFrame的形式装在一个列表中返回。首先F12,页面元素点击表格内容,发现最上面的层级是<table,那么就可以用pandas直接抓!pandas还能当爬虫用,你敢信吗?而且超级简单,两行代码就趴下来。就看到保存的CSV文件了。
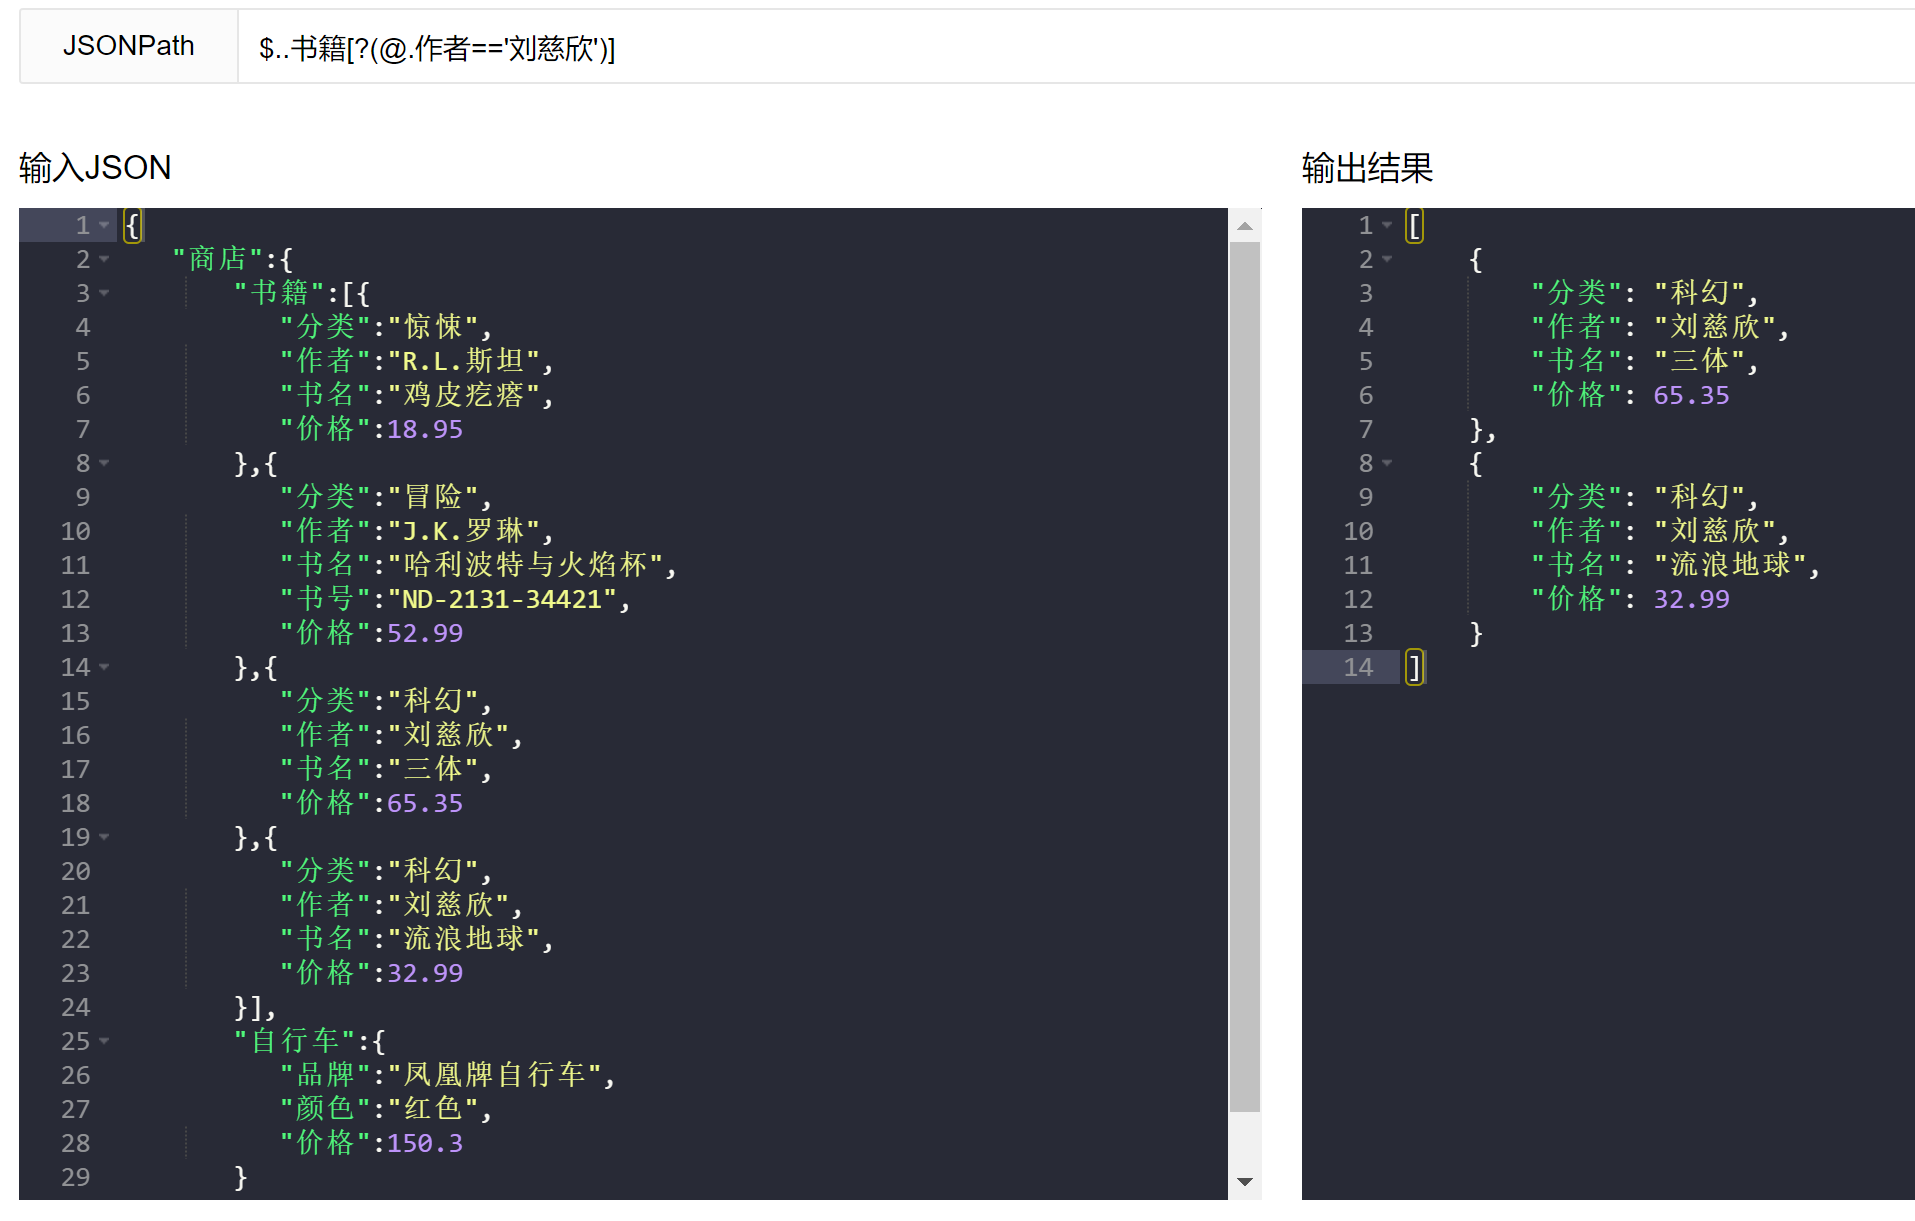
JSONPath是一种用于在JSON(JavaScript Object Notation)数据中定位和提取特定元素的查询语言。它类似于XPath对XML的作用,可以帮助我们轻松地按照特定的路径表达式从复杂的JSON结构中获取所需的数据。通过使用JSONPath,开发人员可以更有效地处理和解析JSON数据,同时减少冗余代码和手动遍历的工作量。它在Web开发、API集成、数据转换等领域具有广泛的应用
某站点的宝塔人机识别的cookie分析
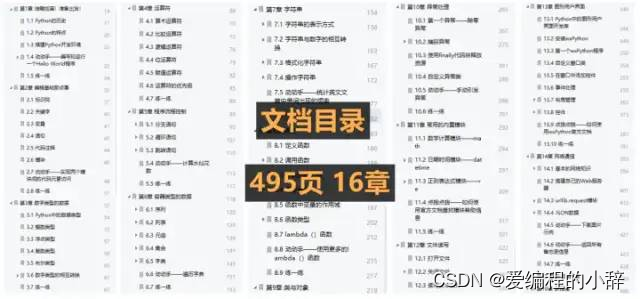
在进行爬虫活动时,需要遵循伦理规范和法律法规,尊重网站的隐私权和信息所有权。未经授权的爬虫活动可能涉及侵犯隐私、盗取数据等问题,违反相关法律法规可能会面临法律责任。我整理了编程语言Python的学习资料,拿出来和大家分享,有需要的朋友可以扫描下方二维码进行领取哦。
此篇文章中介绍requests模块中的代理IP参数proxies的详细用法。proxies参数:代替本机的IP地址, 去对接网络的IP地址;其作用是,隐藏真实IP,避免被目标网站封掉。
Python 在编写网络爬虫常常用到的一些库。Python爬虫网络库主要包括:urllib、requests、lxml、fake-useragent、bs4(BeautifulSoup)、grab、pycurl、urllib3、httplib2、RoboBrowser 、MechanicalSoup、mechanize、socket、Unirest for Python、hyper、PySocks
简单来说,爬虫就是获取网页并提取和保存信息的自动化程序,下面概要介绍一下。
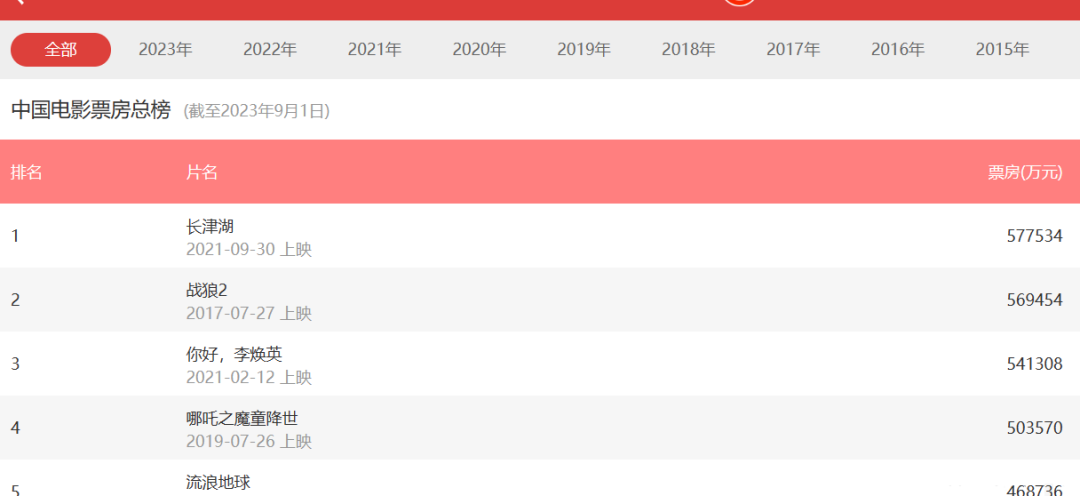
可以看到,我国高票房的电影,从2010年开始高速增长,到2017年到达峰值,著名的《战狼2》就是2017年上映的,然后2018和2019略微下降,2020年断崖下跌,,为什么,懂得懂得,疫情原因嘛。当我学到一定基础,有自己的理解能力的时候,会去阅读一些前辈整理的书籍或者手写的笔记资料,这些笔记详细记载了他们对一些技术点的理解,这些理解是比较独到,可以学到不一样的思路。对数据进行一定的清洗,我们看到
如果我们把互联网比作一张大的蜘蛛网,那一台计算机上的数据便是蜘蛛网上的一个猎物,而爬虫程序就是一只小蜘蛛,沿着蜘蛛网抓取自己想要的数据。
本文旨在利用Python编程语言实现天气数据信息的爬取和可视化分析。Python作为一种简单易学且功能强大的编程语言,被广泛应用于数据处理和分析领域。通过使用Python,我们可以方便地进行网页爬取和数据处理。详细介绍了如何使用Python编写网络爬虫程序来获取天气数据。
在爬虫程序中,使用代理IP是规避反爬机制和提高请求效率的重要手段之一。通过创建一个代理IP池并灵活获取和释放代理IP,可以更好地管理代理IP的使用情况,提高请求效率和稳定性。同时,需要根据实际需求选择合适的代理IP获取方式,综合考虑成本、可用性和稳定性等因素。在未来的发展中,随着网络爬虫技术的不断进步和反爬机制的不断升级,我们需要持续关注和研究新的技术和方法,以适应不断变化的应用需求和市场环境。
代理IP指的是位于互联网上的一台中间服务器,它充当了爬虫与目标服务器之间的中介角色。通过使用代理IP,爬虫可以隐藏真实的IP地址,使得对目标服务器的请求看起来是来自代理服务器而非爬虫本身。通过使用代理IP,爬虫可以隐藏其真实的IP地址,增强匿名性,防止被目标服务器追踪。代理IP允许爬虫通过多个不同的IP地址发送请求,有效地分散了请求负载,降低了单个IP的请求频率,减轻了对目标服务器的压力。有些网站
【代码】第十三章 python之爬虫。
我特别喜欢升级各种包,默认每次看到小三角形▲,就像给它升个级,你看我这里面的包都是升级到没有显示三角形▲的了,目前也只有Twisted这个包是可以升级的状态。使用pycharm这个管理包的版本还是非常方便的,卸载就点减号-,安装新的包就点击加号+,想升级,就选中可以升级的包,再点击三角形▲就可以了。升级的时候,一次只能点击一个升级一个包,因为升级一个包后它就自动刷新界面了。(FreeBSD,mac
计算机毕业设计:基于python机器学习的全国气象数据采集预测可视化系统预测模型+爬虫(包含文档+源码+部署教程)
Element对象,然后进行xpath路径截取,存储在一个列表中,然后进行一个for循环遍历列表,得到图片对应的页面源码。表达的就是在这个页面下的class叫ibox2 all的div下的ul下的li元素,包含着所有的ul下的li。Step4:运用xpath方法对图片的url进行截取然后进行请求,并转换成二进制文件,然后进行持续化存储。Step3:使用etree中的HTML方法对字符串格式的源码进
本文介绍了如何使用 BeautifulSoup 爬取网页数据,并提供了详细的代码和注释。通过本文的学习,读者可以掌握如何使用 BeautifulSoup 解析 HTML 和 XML 文档,从而提取出需要的数据。同时,读者也可以将本文中的代码应用到其他网页数据的爬取中。
Python爬虫(1)一次性搞定Selenium(新版)8种find_element元素定位方式
众所周知,Java 语言适合应用于 Web 开发领域,不擅长用来编写爬虫。但在 Web 开发过程中有时又存在爬取数据的需求,此时采用其它语言编写独立爬虫模块的话存在维护不方便的问题,所以此处笔者选择了使用 Java + XPath 实现简单的爬虫功能,如果爬虫需求较多且复杂还是推荐采用其它语言实现独立的爬虫模块。
首先在未排序序列中找到最小(大)元素,存放到排序序列的起始位置,然后,再从剩余未排序元素中继续寻找最小(大)元素,然后放到已排序序列的末尾。插值搜索类似于人们在电话目录中搜索名称的方法(用于订购书籍条目的关键值):在每个步骤中,算法计算剩余搜索空间中的位置,基于搜索空间边界处的键值和所寻找的键的值,通常可以通过线性插值来寻找项目。这样的列表叫做h排序。因为基本拉丁字母中有26个字母(2×13),所
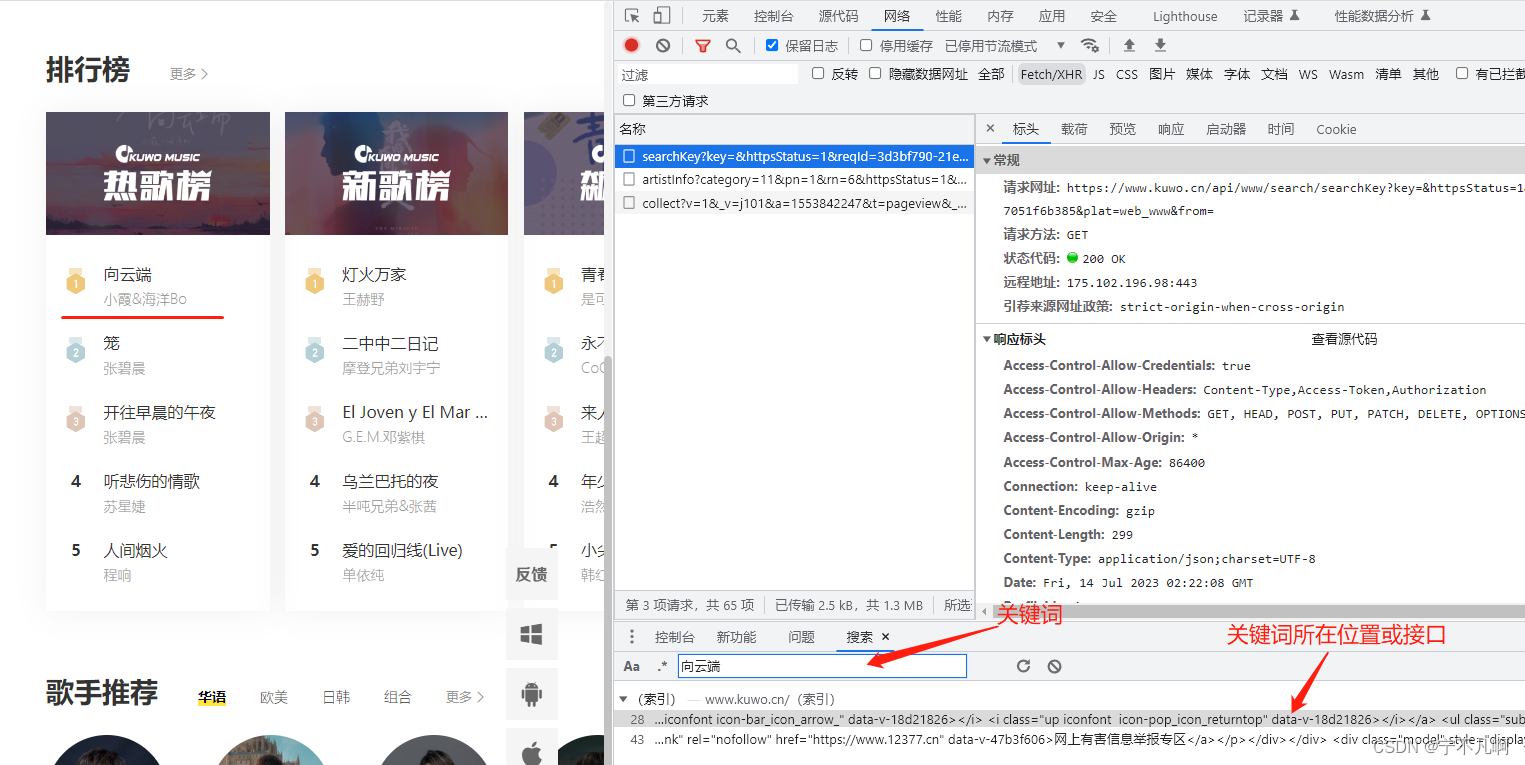
不知道数据用什么加密方式就全局搜,或者一个一个加密方法试。最后才选择单步调试~可能首先想到的是用正则匹配,那有没有办法办法直接获取到。点击搜索结果,跳转至关键词数据所在页面,在此页面搜索(既然是js,那就想办法运行这段js。声明:仅用于学习交流,切勿用于其他用途~页面用的是Nuxt服务器端渲染,看到。,结论:数据来源于页面。了吧,这段js被混淆了。
【代码】报错: error: subprocess-exited-with-error。
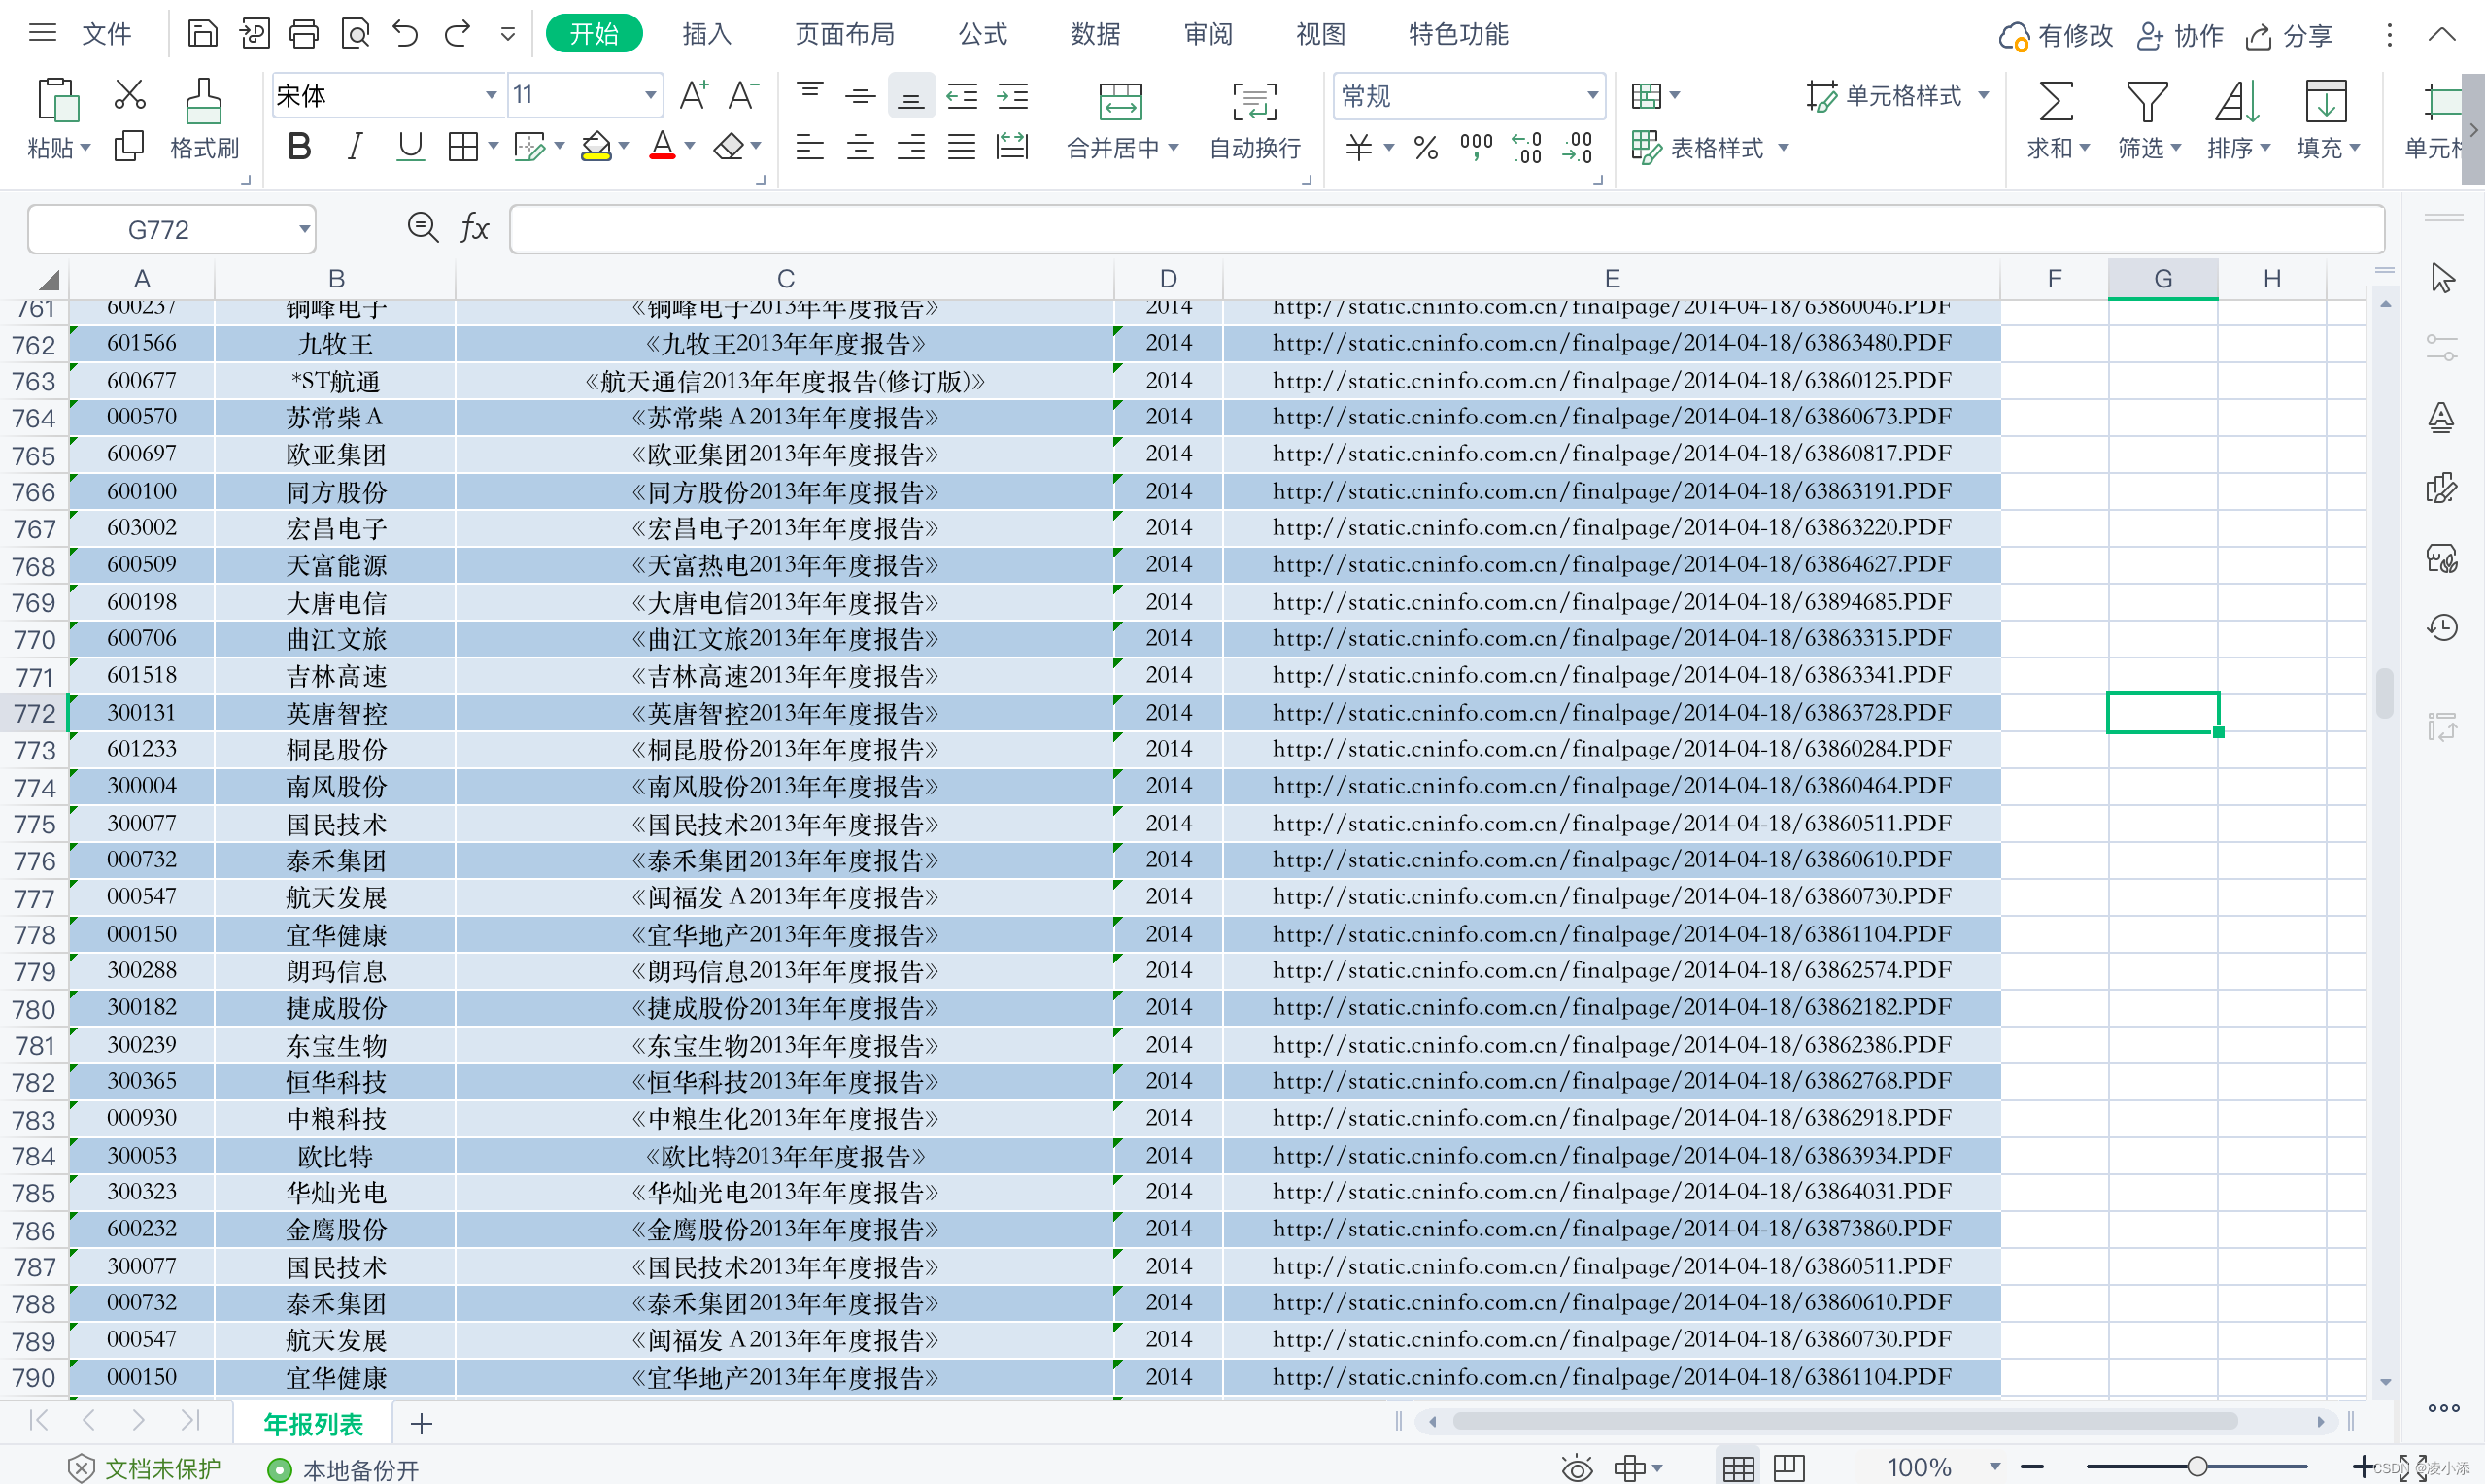
如何用100行代码实现对上市公司年报链接的爬取,简单上手,附源码。