
SpeechEmotionNet 基于声音的情绪识别系统的设计与实现
摘 要
随着人工智能技术的快速发展,语音情绪识别作为情感计算的重要分支,在心理健康监测、智能客服、人机交互等领域展现出广阔的应用前景。针对传统情绪识别系统部署复杂、功能单一、轻量化不足的问题,本文设计并实现了一套基于声音的 SpeechEmotionNet 情绪识别系统。
系统采用前后端分离架构,前端基于Vue 3框架构建直观的交互界面,支持用户实时录音、音频上传、历史记录查询与数据可视化展示;后端以FastAPI为核心搭建高效服务,结合Python与PyTorch框架实现语音情绪识别模型的部署与推理;数据层采用SQLite完成轻量化存储,保障数据安全与快速访问。系统核心功能包括用户与管理员双角色权限管理、语音文件元数据记录、情绪识别结果存储与状态监控,实现了从语音采集、特征提取、模型推理到数据展示的完整业务闭环。
实验与测试结果表明,本系统界面友好、操作便捷,基于wav2vec2预训练模型的情绪识别模块具备较高准确率与稳定性,可有效完成多场景下的语音情绪识别任务。系统轻量化部署、易于维护,满足本科毕业设计场景下对功能实现与演示效果的双重需求,为语音情绪识别技术的工程化落地提供了可行方案,也为后续进一步拓展应用场景奠定了基础。
关键词:wav2vec2;语音情绪识别;深度学习
Abstract
With the rapid advancement of artificial intelligence technology, speech emotion recognition, as a critical branch of affective computing, has demonstrated broad application prospects in domains such as mental health monitoring, intelligent customer service, and human-computer interaction. To address issues inherent in conventional emotion recognition systems—such as complex deployment, limited functionality, and insufficient lightweight design—this paper designs and implements a voice-based SpeechEmotionNet emotion recognition system.
The system adopts a frontend-backend decoupled architecture. The frontend, built using the Vue 3 framework, provides an intuitive user interface supporting real-time audio recording, audio upload, querying of historical records, and data visualization. The backend employs FastAPI as the core for building an efficient service, integrating Python and PyTorch frameworks to deploy and infer the speech emotion recognition model. The data layer utilizes SQLite for lightweight storage, ensuring data security and fast retrieval. Core functionalities include dual-role permission management for users and administrators, logging of audio metadata, storage of emotion recognition results, and system status monitoring. This forms a complete business pipeline spanning voice acquisition, feature extraction, model inference, and data visualization.
Experimental and testing results indicate that the system features a user-friendly interface and simple operation. The emotion recognition module, based on a wav2vec2 pre-trained model, achieves high accuracy and stability, effectively performing speech emotion recognition across multiple scenarios. With its lightweight deployment and maintainability, the system fulfills both the functional implementation and demonstration requirements of an undergraduate capstone project context. It provides a practical engineering solution for the application of speech emotion recognition technology and establishes a foundation for further expansion into additional application scenarios.
Key words:wav2vec2;voice emotion recognition;deep learning
目 录
1 绪论
近年来,随着人工智能、大数据与情感计算技术的深度融合,语音情绪识别已成为人机交互、智能感知与智慧服务领域的研究热点。语音作为人类最自然、最直接的交流载体,不仅承载语义信息,更蕴含丰富的情绪特征,能够实时反映个体的心理状态与情感变化。在智能客服、心理健康监测、智能驾驶、在线教育、人机交互等实际场景中,精准、高效的语音情绪识别技术能够显著提升系统智能化水平与服务体验。
传统语音情绪识别多依赖人工设计的声学特征,如梅尔频谱、过零率、基频等,结合传统机器学习模型完成分类,存在泛化能力弱、特征提取依赖经验、复杂场景适应性差等问题。随着深度学习技术的快速发展,基于自监督学习的语音预训练模型凭借强大的特征表征能力,为情绪识别任务提供了新的技术路径。wav2vec2.0 等预训练模型能够直接从原始音频中学习高鲁棒性特征,有效提升情绪识别的准确率与稳定性。
与此同时,现有研究多集中于算法优化与实验验证,面向实际使用的轻量化、可部署、具备完整权限管理与可视化功能的系统相对较少,难以满足真实场景下的使用需求。在此背景下,本课题以实际应用为导向,基于 wav2vec2.0 预训练模型,设计并实现一套集语音采集、情绪识别、数据管理、可视化展示于一体的语音情绪识别系统,对推动情绪识别技术工程化落地具有重要的理论与现实意义。
国外在语音情绪识别领域的研究起步早、技术路线多元化,聚焦于模型架构创新与优化算法结合。Almogren 等提出基于特征驱动的集成深度学习与 PUMA 优化算法的语音情绪识别模型,通过优化特征选择与模型集成策略提升识别精度;Saumard 等将深度函数多索引模型应用于语音情绪识别,探索了复杂特征空间下的情绪表征方法;Wang 等结合微调后的 Wav2vec2.0 与神经控制微分方程分类器,进一步增强了模型对语音时序特征的捕捉能力。在特定场景优化方面,Sapkota 等针对构音障碍语音的变异性问题,提出基于严重程度感知的 Wav2vec2 ASR 模型微调策略,为特殊人群的语音情绪识别提供了新思路。此外,Wav2vec2 系列模型已被广泛应用于多语言语音情感识别、语音不流畅检测等细分方向,体现了预训练框架在语音处理领域的通用性。
国内研究更注重语音情绪识别的场景化应用与技术落地,同时紧跟预训练模型的研究趋势。郭丽丽等梳理了离散语音情感识别的研究进展,指出预训练模型与特征融合是未来核心方向;张佳男基于预训练模型与特征融合技术开展语音情感识别研究,验证了多特征融合对识别精度的提升作用;曹荣贺等结合 Wav2vec2.0 与语境情感信息补偿,优化了对话场景下的语音情绪识别效果;李小平则针对列车司机场景构建语音情绪识别模型,实现了技术与工业场景的结合。此外,脱丽莎等、王锐等学者围绕深度学习架构优化开展研究,探索了 CNN、BiGRU 等网络在语音情绪识别中的应用,但整体来看,国内研究仍存在 “重算法实验、轻系统落地” 的问题,多数成果未形成可部署的一体化系统,且针对多角色权限管理、实时录音识别等工程化需求的研究较少。
本课题的研究具有重要的理论与实践意义。理论层面上,本研究基于 wav2vec2 预训练模型开展语音情绪识别研究,通过冻结主干网络、分层解冻 Transformer 层、分组学习率等微调策略,验证预训练语音表征在小样本情绪数据集上的适配能力,对比传统手工特征结合深度学习模型的效果,丰富语音预训练模型在情绪分类任务中的应用研究。实践层面上,本研究构建前后端分离的语音情绪识别系统,实现用户注册登录、音频上传与实时录音、情绪识别、历史记录查询、数据统计可视化、模型效果展示等完整功能,解决算法模型与实际应用脱节的问题。系统采用轻量化架构,部署简单、使用便捷,同时支持双角色权限管理,实现用户数据隔离与管理权限区分,提升系统的实用性与规范性。
Python 是一种面向对象、解释型、动态类型的高级程序设计语言,自发布以来凭借简洁清晰的语法、高效的开发效率与强大的跨平台能力,成为人工智能、Web 开发、数据处理等领域的主流编程语言。Python 语法结构简洁直观,采用缩进式代码组织方式,具有极高的可读性和可维护性,能够大幅缩短项目开发周期,同时降低学习与调试成本。Python 拥有极为丰富的第三方库与开发框架,覆盖深度学习、语音处理、后端服务、数据存储、科学计算等多个方向,可快速满足各类系统开发需求。该语言具备良好的可扩展性与兼容性,能够与 C/C++、Java 等语言混合编程,方便调用底层算法与外部接口。Python 支持多线程、异步编程等多种开发模式,在处理高并发、数据密集型任务时表现稳定,非常适合搭载深度学习模型的 Web 服务场景。
在本语音情绪识别系统中,Python 作为核心开发语言贯穿全流程。后端服务、语音信号预处理、wav2vec2 模型构建与推理、数据库操作、身份认证等功能均基于 Python 实现。借助 PyTorch、torchaudio 等成熟工具库,Python 将算法模型与业务逻辑高效整合,实现从语音识别到系统管理的一体化开发。Python 简洁的语法与完善的生态,使系统具备开发高效、部署简便、易于调试等优势,为系统的实现提供了坚实可靠的技术保障。
wav2vec2是Facebook AI研究院提出的自监督语音预训练模型,基于 Transformer 架构构建,能够直接从原始语音波形中自动学习高鲁棒性的声学表征,不再依赖 MFCC、梅尔频谱等传统人工设计特征。模型通过掩码对比学习任务在大规模无标注语音数据上完成预训练,可有效捕捉语音中的时序结构、韵律、音高变化与上下文关联信息,生成适用于各类语音下游任务的通用特征表示。wav2vec2 提供BASE、LARGE等多种规模版本,具备优秀的迁移学习能力,仅需少量标注数据即可快速适配语音识别、说话人验证、语音情绪识别等任务。本系统选用wav2vec2 BASE作为主干网络,针对语音情绪识别任务采用分层微调策略,冻结底层特征提取模块以保留预训练学到的通用语音知识,解冻顶部四层 Transformer 层进行任务适配,并使用分组学习率分别控制主干网络与分类头的更新幅度,提升模型在小样本数据集上的特征提取能力与泛化性能,使系统在开心、愤怒、悲伤、恐惧四类情绪识别上获得更稳定、更准确的识别效果。
Vue是一款现代化、轻量级且高性能的渐进式前端开发框架,作为构建用户界面的主流技术之一,它采用组件化开发思想,将页面拆分为独立、可复用的组件单元,有效提升代码的可维护性与开发效率。Vue基于Proxy实现全新的响应式系统,相比旧版本具有更高的执行效率与更低的内存占用,能够实现数据与视图的自动同步,大幅简化前端交互逻辑。该框架支持组合式API,可更灵活地组织业务逻辑,适合中大型项目的逻辑拆分与复用。
Vue 拥有完善的生态系统,可搭配路由、状态管理、构建工具等组件形成完整的前端开发方案,适用于快速搭建单页应用。在本系统中,Vue作为前端核心框架,承担用户界面渲染、交互事件处理、数据请求封装等关键任务,实现登录注册、实时录音、音频上传、情绪识别结果展示、历史记录查询、个人中心管理等功能。结合TypeScript进一步提升代码的规范性与可靠性,使前端界面更加稳定、流畅、易用,为用户提供良好的操作体验。
FastAPI是基于Python构建的高性能Web后端框架,凭借出色的运行效率与简洁的开发方式,成为当前API服务与机器学习部署的常用选择。它依托Python自身的类型提示机制完成数据校验与参数解析,能够自动生成规范的接口文档,有效减少开发过程中的重复工作,提升接口编写与调试的效率。该框架原生支持异步处理,在面对多用户同时访问时依然可以保持稳定的响应速度,尤其适合搭载语音情绪识别这类需要一定计算资源的服务。FastAPI具备灵活的路由管理、模块化结构与良好的扩展性,可以便捷地对接数据库、文件存储、模型推理等模块,让业务逻辑与底层功能清晰分离,提高系统整体的可维护性。在本语音情绪识别系统中,FastAPI承担着后端核心支撑作用,负责处理用户登录认证、音频文件接收、语音预处理调度、情绪识别推理调用、识别结果入库、历史记录查询以及数据统计等关键任务。系统通过FastAPI提供标准接口实现前后端的数据交互,并结合身份认证实现不同角色的权限控制与数据隔离,保证系统运行稳定、安全、高效,能够很好地满足毕业设计场景下轻量化部署与实际演示的需求。
SQLite 是一款轻量级的嵌入式关系型数据库,它不需要独立的服务进程,所有数据都存储在单一文件中,配置简单、部署便捷,对系统资源占用极低,非常适合在无专业服务器环境下运行。这款数据库支持标准 SQL 语法,同时兼容常见的事务处理与数据持久化机制,能够稳定完成数据的增删改查操作。在本语音情绪识别系统中,SQLite 主要用于存储用户信息、语音识别记录、情绪分类结果以及系统运行相关数据,既保证了数据的安全性与完整性,又避免了复杂的环境配置。
由于无需额外安装数据库服务,整体项目可以直接打包运行,大幅降低部署难度。结合 ORM 框架使用后,开发人员可以更方便地操作数据,提升开发效率。在轻量化使用场景中,SQLite 能够稳定支撑系统运行,满足小型应用对数据存储、管理和查询的全部需求。
深度学习是机器学习的分支,基于多层神经网络结构自动从数据中学习特征表示,无需人工设计规则,在计算机视觉、语音识别、自然语言处理等领域广泛应用。深度学习通过构建多层非线性变换网络,能够从原始数据中挖掘深层抽象特征,显著提升复杂任务的识别精度。
在语音信号处理领域,深度学习可直接从波形、频谱图中学习情感、语义等高级信息,取代传统人工提取声学特征的方式。本系统使用的 wav2vec2 预训练模型、卷积神经网络(CNN)、门控循环单元(GRU)与注意力机制均属于深度学习技术范畴,通过大量数据与反向传播算法优化网络参数,实现高精度语音情绪识别。深度学习为系统提供了强大的特征学习与分类能力,是情绪识别模块的核心支撑。
3.1 可行性分析
系统采用前后端分离架构,前端使用 Vue 框架构建交互界面,后端基于 FastAPI 提供接口服务,数据存储采用 MySQL 数据库,核心算法基于 PyTorch 与 Wav2vec2.0 预训练模型实现。Vue 具有轻量、组件化、响应式等优势,可快速完成页面开发;FastAPI 具备高性能、自动生成接口文档、支持异步处理等特点,能高效提供语音识别服务。Wav2vec2.0 作为成熟的语音预训练模型,在语音特征提取与情绪分类任务中已得到广泛验证,相关技术开源资源丰富。整体技术栈成熟稳定、开发门槛适中,可在普通计算机环境完成开发与部署,技术层面完全可行。
系统所使用的 Vue、FastAPI、MySQL、PyTorch 等框架与工具均为开源免费软件,无版权与使用费用。训练与运行无需高端服务器与 GPU 设备,普通个人电脑即可完成模型推理与系统演示,硬件成本低。开发流程简洁、周期短,可快速完成设计、实现与测试,大幅降低人力与时间成本。系统部署无需额外服务器费用,可直接本地运行用于毕业设计展示与测试,经济成本低廉,具备良好经济可行性。
系统采用 B/S 架构,用户仅通过浏览器即可访问使用,无需安装客户端,操作简单便捷。界面基于 Element Plus 组件库设计,布局清晰、流程直观,普通用户可快速完成注册、登录、音频上传、实时录音、结果查看等操作。管理员端功能集中,可便捷进行用户管理、识别记录查看、数据统计等操作。系统部署流程简单,启动命令少、环境配置便捷,适合学生在答辩现场快速演示,操作层面完全可行。
3.2 功能需求分析
本系统面向用户与管理员两类角色设计,采用用例化分析方法梳理核心功能,确保覆盖情绪识别全流程业务。
注册与登录:用户可通过账号、密码完成注册与登录,系统校验信息合法性并保障账号安全。
音频情绪识别:支持本地 WAV 文件上传与浏览器实时录音两种方式,提交后快速返回情绪类别与置信度。
查看历史记录:查看本人所有识别记录,支持按时间、情绪类型筛选与详情展示。
个人中心:修改个人信息、密码,查看个人统计数据,管理账号信息。
查看可视化结果:以图表形式展示个人情绪识别分布,直观呈现统计结果。
用户用例图如图3-1所示。
图3-1 用户用例图
登录:只能使用管理员账号密码登录到管理端。
用户管理:查看、查询、管理所有普通用户信息,支持用户账号启用与禁用。
识别记录管理:查看全平台所有语音识别记录,支持数据导出、筛选与统计。
数据统计与可视化:查看系统整体用户量、识别次数、情绪分布等数据,以图表形式展示。
模型管理:查看模型运行状态,保障系统稳定运行。
管理员用例图如图3-2所示。
图3-2 管理员用例图
3.3 非功能需求分析
界面设计需求:系统界面应简洁美观、布局合理,符合 Web 应用操作习惯,按钮、表单、图表展示清晰。页面响应迅速、交互流畅,适配不同分辨率浏览器,提升用户使用体验。
性能需求:音频识别接口响应较快,登录、查询、统计等常规接口响应低于 1 秒。系统在普通电脑运行时 CPU 与内存占用合理,不出现卡顿、崩溃现象。
安全性需求:用户密码加密存储,禁止明文保存;接口采用身份校验,未登录用户无法访问核心功能。普通用户仅可查看本人数据,管理员拥有全量权限,实现数据隔离。对上传音频文件做格式与大小校验,防止恶意文件上传,保障系统安全。
可扩展性需求:系统采用模块化、低耦合设计,支持后续扩展情绪类别、新增多语言识别、接入更多数据集等功能。数据库与代码结构便于维护与迭代,可快速适配不同应用场景。
可维护性需求:代码结构规范、注释清晰,前后端分层明确,便于调试与修改。系统日志完整,异常信息可追溯,降低后期维护难度。
本章对 SpeechEmotionNet 基于声音的情绪识别系统进行整体设计,明确系统功能架构、业务执行流程与数据存储结构,确保系统满足普通用户与管理员双角色操作需求,同时保证模块解耦、流程清晰、数据安全稳定,为后续系统实现提供规范依据。
情绪识别系统按照角色权限的类型进行划分,分为用户和管理员两个模块。普通用户主要完成账号操作、语音情绪识别、个人数据查看与管理;管理员在用户功能基础上,增加全局数据监控、用户账号管理、模型状态查看与全量识别记录管理权限,实现系统整体运维管控。系统的总体模块设计如图4-1所示。
图4-1 系统总体功能模块图
本系统采用SQLite 数据库,轻量易部署,满足系统的数据存储与查询需求。数据库设计遵循结构清晰、冗余低、安全性高原则,主要包含用户表、语音文件信息表、情绪识别结果表和管理员表。
本小节主要对系统数据库的实体关系图进行设计与说明。结合情绪识别系统的业务流程,将数据抽象为用户、管理员、语音文件与情绪识别结果四个核心实体,通过实体-属性图直观展示各实体的属性信息与相互关联关系。
用户实体是系统的基础信息载体,包含用户唯一标识、用户编号、姓名、性别、年龄、联系方式、账号名称、密码、状态标识、备注信息、创建时间与更新时间等属性。该实体完整记录了用户的身份信息与账号状态,为后续语音文件上传、情绪识别等业务流程提供用户主体支撑。用户实体-属性图如图4-2所示。
图4-2 用户实体图
语音文件实体是系统的核心业务数据载体,包含文件唯一标识、所属用户标识、文件名称、文件存储地址、来源类型、文件时长与创建时间等属性。该实体用于记录用户上传或录制的每一条语音文件的元数据,是连接用户与情绪识别结果的关键中间实体。语音文件实体-属性图如图4-3所示。
图4-3 语音文件实体-属性图
情绪识别结果实体是系统的业务输出载体,包含结果唯一标识、关联语音文件标识、情绪标签、置信度、特征状态、模型推理状态与识别完成时间等属性。该实体记录了语音文件经过模型处理后的情绪识别结果与流程状态,为用户查看历史记录与情绪统计分析提供核心数据。情绪识别结果实体-属性图如图4-4所示。
图4-4 情绪识别结果实体-属性图
管理员实体是系统的权限管理载体,包含管理员id、账号名称、密码、状态标识与创建时间等属性。该实体用于存储后台管理人员的账号信息与状态,为系统用户管理、数据维护与权限控制提供安全支撑。管理员实体-属性图如图4-5所示。
图4-5 管理员实体-属性图
用户表用于存储系统用户的完整信息,以id作为自增主键,唯一标识每个用户;user_code为用户编号,便于后台管理;name、gender、age、contact字段分别代表姓名、性别、年龄和联系方式,记录用户基本资料;username与password_hash用于系统登录验证,其中密码以哈希形式存储,保障账号安全;is_active标识账号是否处于启用状态,默认值为1,表示正常可用;created_at与updated_at自动记录用户信息的创建与修改时间,便于系统维护与审计。用户表如表4-1所示。
表4-1 用户表
| 列名 | 数据类型 | 非空 | 默认值 | 描述 | 说明 |
| id | INTEGER | 是 | 主键 | 用户id | |
| user_code | VARCHAR(32) | 是 | 用户编号 | ||
| name | VARCHAR(64) | 是 | 姓名 | ||
| gender | VARCHAR(16) | 是 | 性别 | ||
| age | INTEGER | 是 | 年龄 | ||
| contact | VARCHAR(64) | 是 | 联系方式 | ||
| remark | VARCHAR(255) | 否 | 备注信息 | ||
| created_at | DATETIME | 是 | CURRENT_TIMESTAMP | 创建时间 | |
| updated_at | DATETIME | 是 | CURRENT_TIMESTAMP | 更新时间 | |
| username | VARCHAR(64) | 否 | 用户名称 | ||
| password_hash | VARCHAR(512) | 否 | NULL | 密码 | |
| is_active | BOOLEAN | 是 | 用户状态标识 |
语音文件信息表用于存储用户上传或录制的语音文件元数据,以id作为自增主键,唯一标识每条语音记录;user_id为外键,关联用户表,表明文件所属用户;file_name和 file_path分别存储文件的原始名称与服务器存储路径;source_type区分语音的采集方式,如上传或实时录音;duration_seconds记录语音时长,为后续预处理和模型输入校验提供依据;created_at自动记录文件上传时间。该表是情绪识别流程的基础,后续情绪识别结果将通过外键与本表关联,实现完整的业务闭环。语音文件信息表如表4-2所示。
表4-2 语音文件信息表
| 列名 | 数据类型 | 是否为空 | 默认值 | 描述 | 说明 |
| id | INTEGER | 是 | 主键 | 文件记录id | |
| user_id | INTEGER | 是 | 外键 | 用户id | |
| file_name | VARCHAR(255) | 是 | 语音文件名称 | ||
| file_path | VARCHAR(512) | 是 | 语音文件地址 | ||
| source_type | VARCHAR(32) | 是 | 语音来源类型 | ||
| duration_seconds | FLOAT | 否 | 语音文件时长 | ||
| created_at | DATETIME | 是 | CURRENT_TIMESTAMP | 创建时间 |
情绪识别结果表用于存储语音文件的情绪识别结果与处理状态,该表以id作为自增主键,唯一标识每条识别记录;audio_record_id为外键,关联语音文件信息表,表明结果对应的原始音频;emotion_label存储模型输出的情绪标签,confidence记录预测置信度;feature_status与inference_status分别记录特征提取与模型推理的处理状态,便于流程监控与问题排查;recognized_at自动记录识别完成的时间。该表是系统核心业务数据的存储载体,支撑用户查看历史识别记录、情绪统计分析等功能。情绪识别结果表如表4-3所示。
表4- 3 情绪识别结果表
| 列名 | 数据类型 | 非空 | 默认值 | 描述 | 说明 |
| id | INTEGER | 是 | 主键 | id | |
| audio_record_id | INTEGER | 是 | 文件id | ||
| emotion_label | VARCHAR(32) | 是 | 情绪标签 | ||
| confidence | FLOAT | 是 | 置信度 | ||
| feature_status | VARCHAR(32) | 是 | 特征状态 | ||
| inference_status | VARCHAR(32) | 是 | 模型推理状态 | ||
| recognized_at | DATETIME | 是 | CURRENT_TIMESTAMP | 识别完成时间 |
管理员表用于存储系统管理员的账号信息,以id作为自增主键,标识每个用户;username存储用户登录名称,password_hash存储加密后的密码,避免明文泄露;is_active标识账号是否处于可用状态;created_at记录账号创建时间。管理员表如表4-4所示。
表4- 4 管理员表
| 列名 | 数据类型 | 非空 | 默认值 | 描述 | 说明 |
| id | INTEGER | 是 | 主键 | 用户id | |
| username | VARCHAR(64) | 是 | 用户名称 | ||
| password_hash | VARCHAR(512) | 是 | 密码 | ||
| is_active | BOOLEAN | 是 | 用户状态标识 | ||
| created_at | DATETIME | 是 | CURRENT_TIMESTAMP | 创建时间 |
4.3 数据集介绍与预处理
本项目使用的原始数据为公开的RAVDESS语音情感数据集,核心字段包括角色编号、情绪类别、情绪强度、语音内容编号、音频文件路径。数据涵盖平静、快乐、悲伤、愤怒、恐惧、厌恶、惊讶、中性等多种情绪表达的语音样本,本研究选取其中快乐、悲伤、愤怒、恐惧四类情绪样本用于模型训练。数据为标准化录制的音频文件,为语音情感识别模型的训练与评估提供了基础数据支撑。
图4- 6 部分数据集展示图
为提升语音情感特征的稳定性与模型训练效率,本项目对RAVDESS数据集进行标准化预处理。处理流程严格统一,确保输入数据规范一致,主要流程如下:
音频加载与单声道转换:读取WAV格式语音文件,将多声道音频转换为单声道,消除声道冗余;
重采样:统一采样率为16kHz,适配Wav2Vec2模型输入要求;
静音裁剪:基于30dB阈值裁剪语音首尾静音段,保留有效情感语音信息;
长度标准化:将所有语音裁剪或填充至4秒固定长度,保证模型输入尺寸统一;
特征提取:分别提取梅尔频谱图、MFCC、MFCC一阶 /二阶差分特征,以及全局频谱统计特征。
预处理后的语音信号与特征,分别输入Wav2Vec2模型与CNN模型进行特征学习与分类。
图4- 7 数据预处理流程图
4.4 模型训练与评估
本项目设计双路径融合语音情感识别模型,包含基于Wav2Vec2的上下文特征提取路径与基于CNN的频谱特征提取路径,两路径特征融合后完成情感分类。
1.基于 Wav2Vec2 的情感分类模型:
Wav2Vec2分类模型以预训练Wav2Vec2 BASE为骨干网络,结合注意力统计池化与分类头实现情感识别,结构设计如下:
骨干网络配置:采用Wav2Vec2 BASE预训练模型,冻结特征提取器,解冻最后4层Transformer层,保留预训练特征的同时适配情感识别任务;
注意力统计池化:对Wav2Vec2输出的时序特征进行注意力统计池化,同时计算均值与标准差,融合全局统计信息,计算过程为:
1.评价指标
本文采用分类任务通用指标评估模型性能,包括:
准确率(Accuracy):正确分类样本占总样本的比例;
精确率(Precision):预测为某类的样本中真实为该类的比例,宏平均精确率为各类精确率的算术平均;
召回率(Recall):真实为某类的样本中被正确预测的比例,宏平均召回率为各类召回率的算术平均;
F1 值:精确率与召回率的调和平均,宏平均F1值为各类F1值的算术平均,计算公式:
混淆矩阵:直观展示各类情绪的预测与真实标签对应关系。
2.实验结果与分析
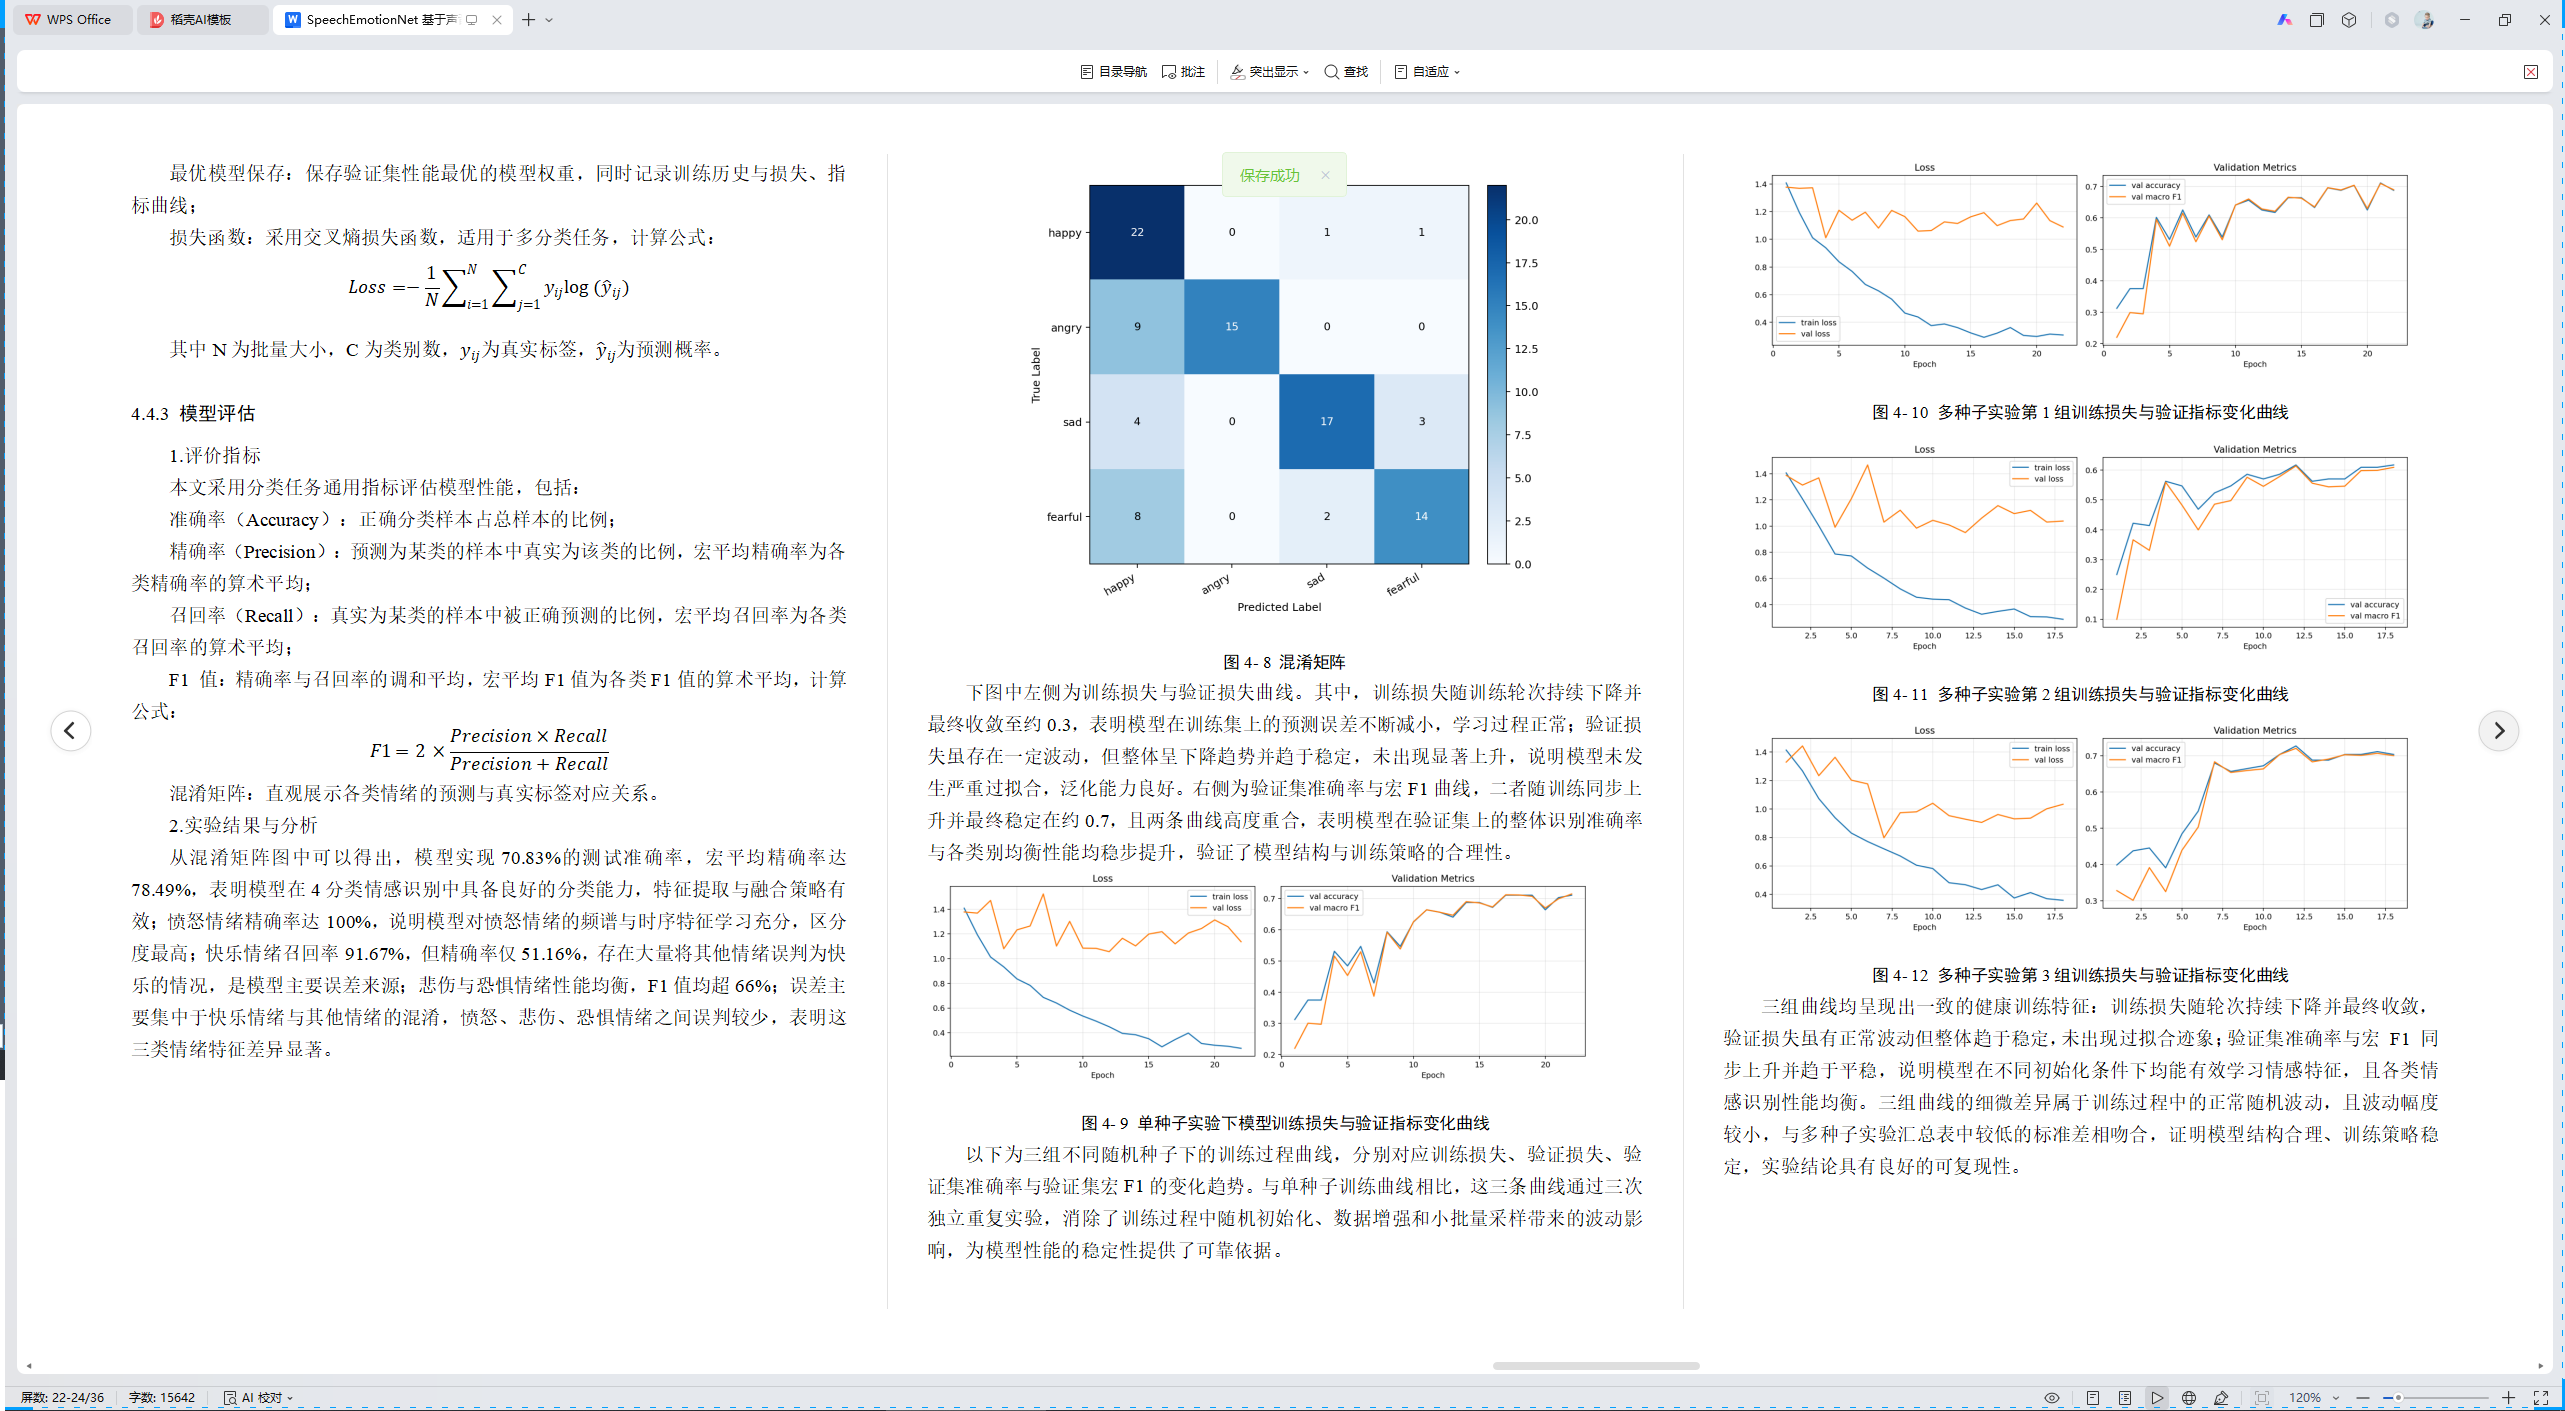
从混淆矩阵图中可以得出,模型实现70.83%的测试准确率,宏平均精确率达78.49%,表明模型在4分类情感识别中具备良好的分类能力,特征提取与融合策略有效;愤怒情绪精确率达100%,说明模型对愤怒情绪的频谱与时序特征学习充分,区分度最高;快乐情绪召回率91.67%,但精确率仅51.16%,存在大量将其他情绪误判为快乐的情况,是模型主要误差来源;悲伤与恐惧情绪性能均衡,F1值均超66%;误差主要集中于快乐情绪与其他情绪的混淆,愤怒、悲伤、恐惧情绪之间误判较少,表明这三类情绪特征差异显著。
图4- 8 混淆矩阵
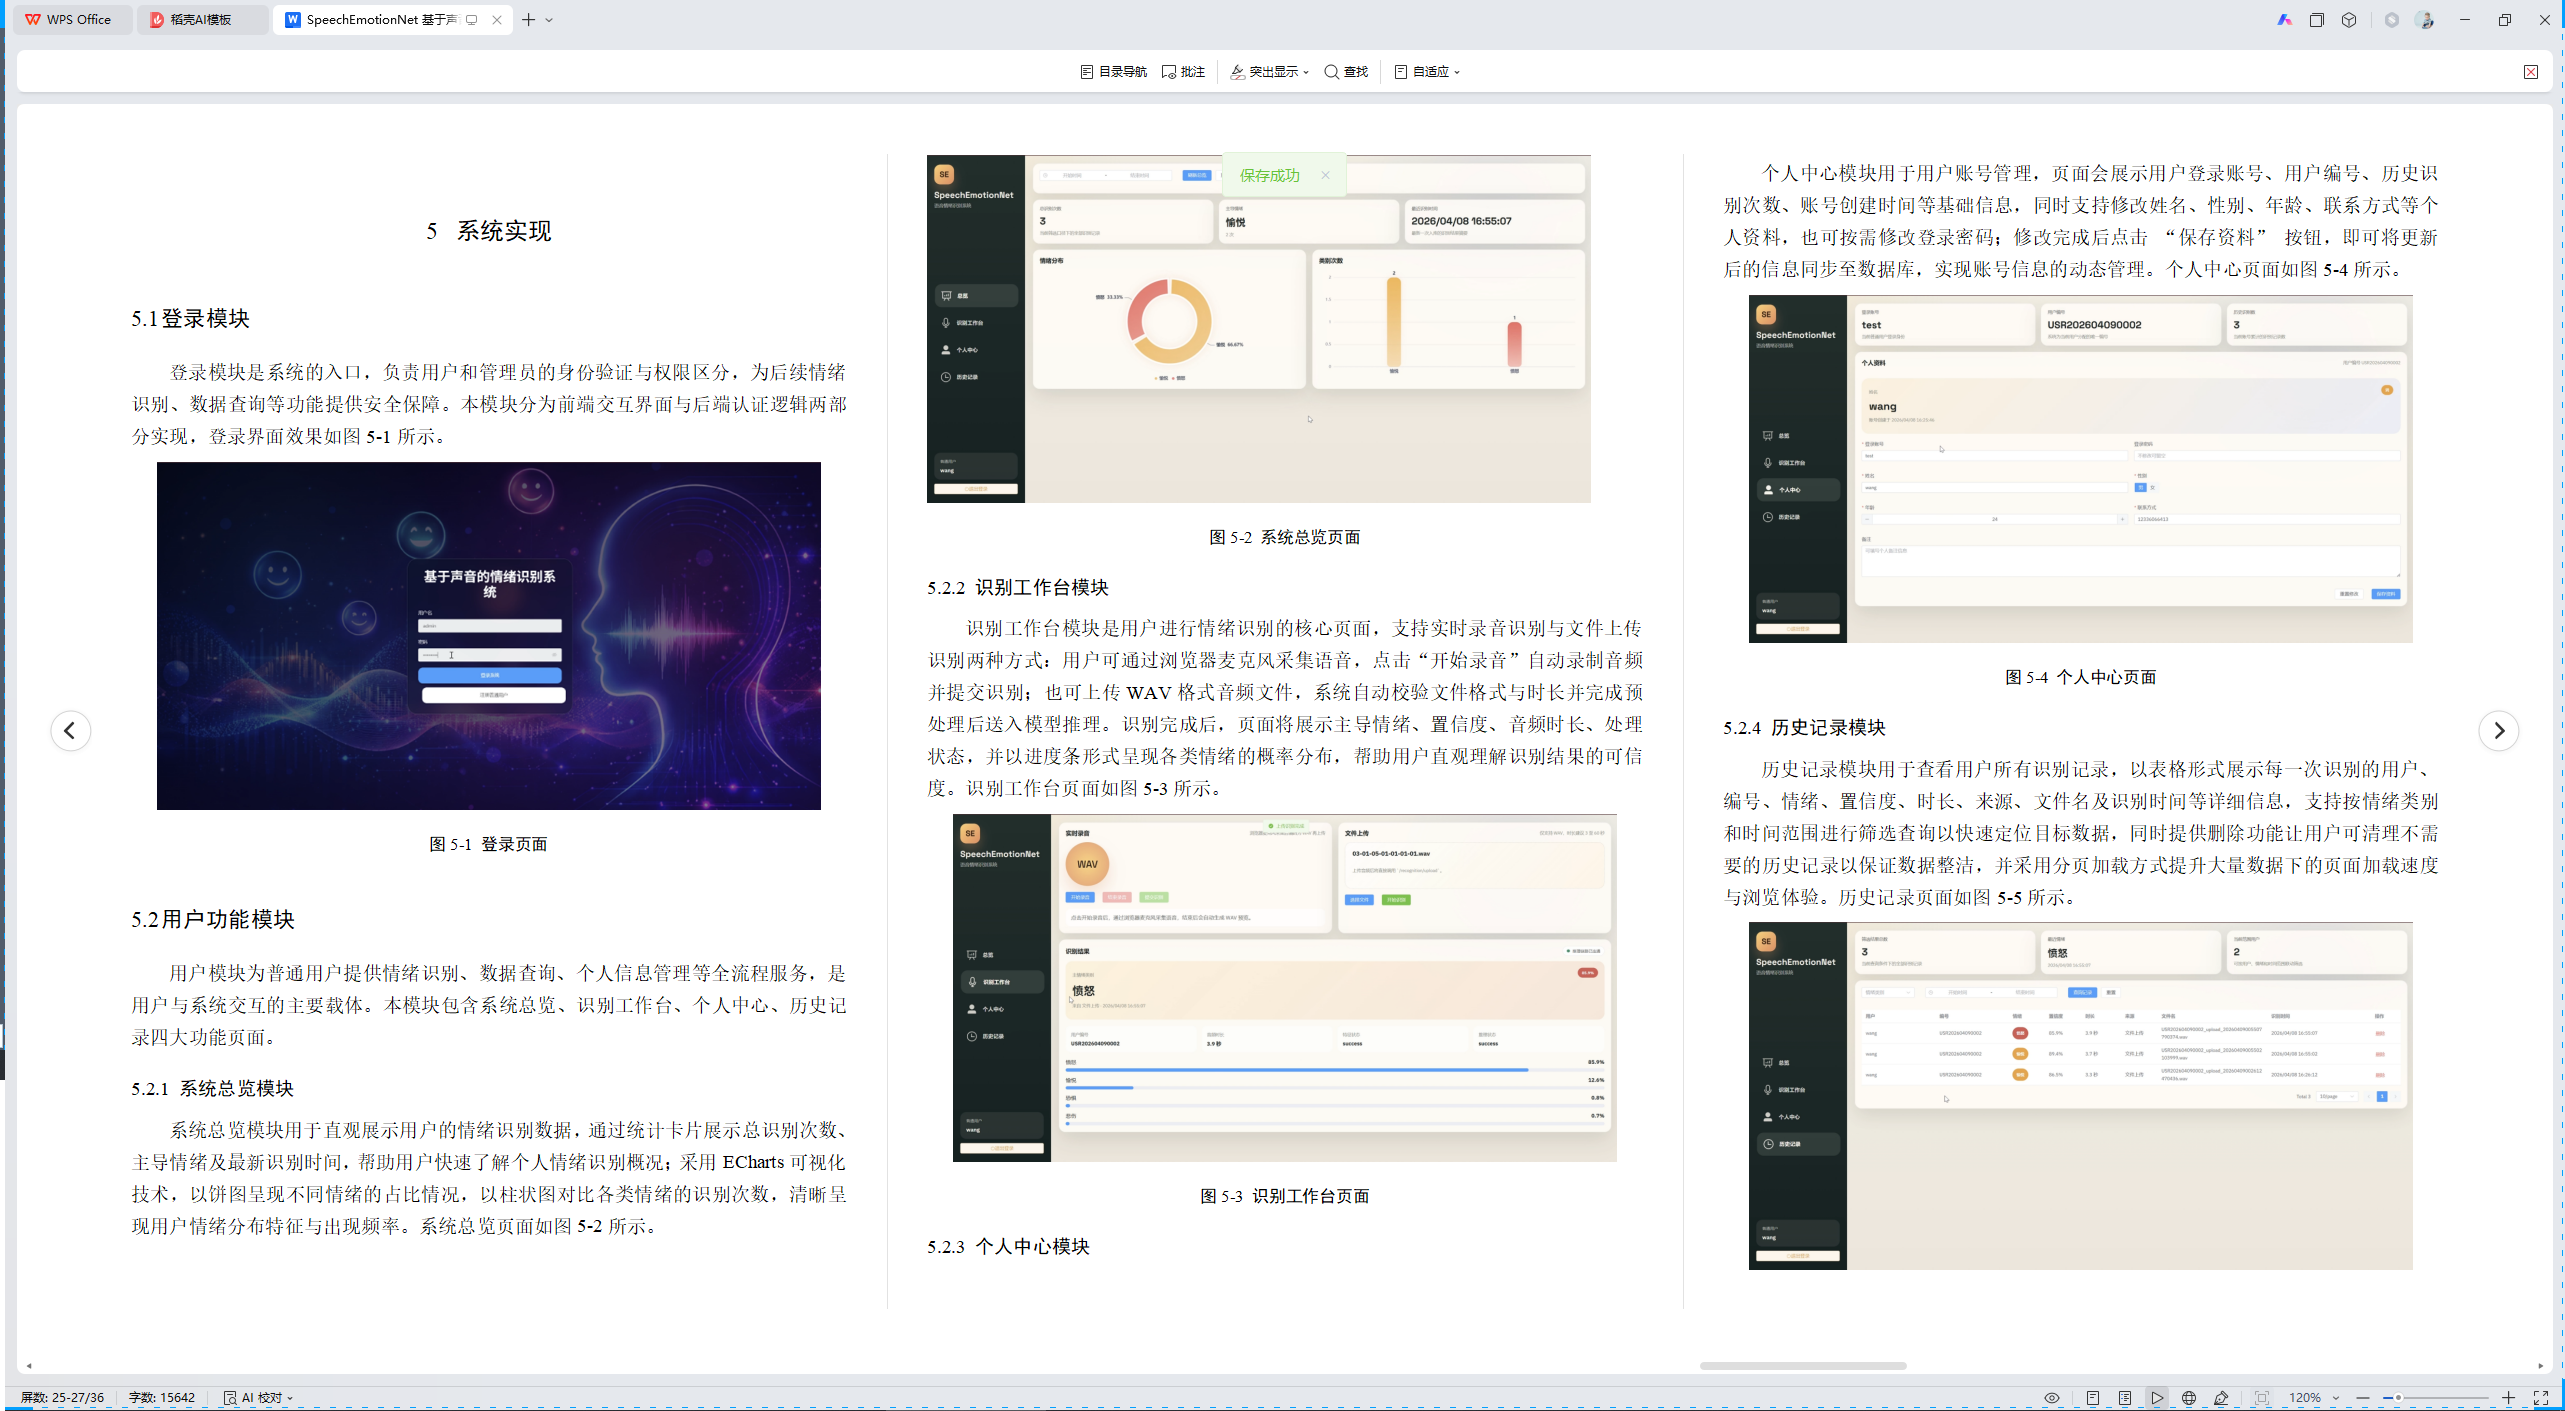
下图中左侧为训练损失与验证损失曲线。其中,训练损失随训练轮次持续下降并最终收敛至约0.3,表明模型在训练集上的预测误差不断减小,学习过程正常;验证损失虽存在一定波动,但整体呈下降趋势并趋于稳定,未出现显著上升,说明模型未发生严重过拟合,泛化能力良好。右侧为验证集准确率与宏F1曲线,二者随训练同步上升并最终稳定在约0.7,且两条曲线高度重合,表明模型在验证集上的整体识别准确率与各类别均衡性能均稳步提升,验证了模型结构与训练策略的合理性。
图4- 9 单种子实验下模型训练损失与验证指标变化曲线
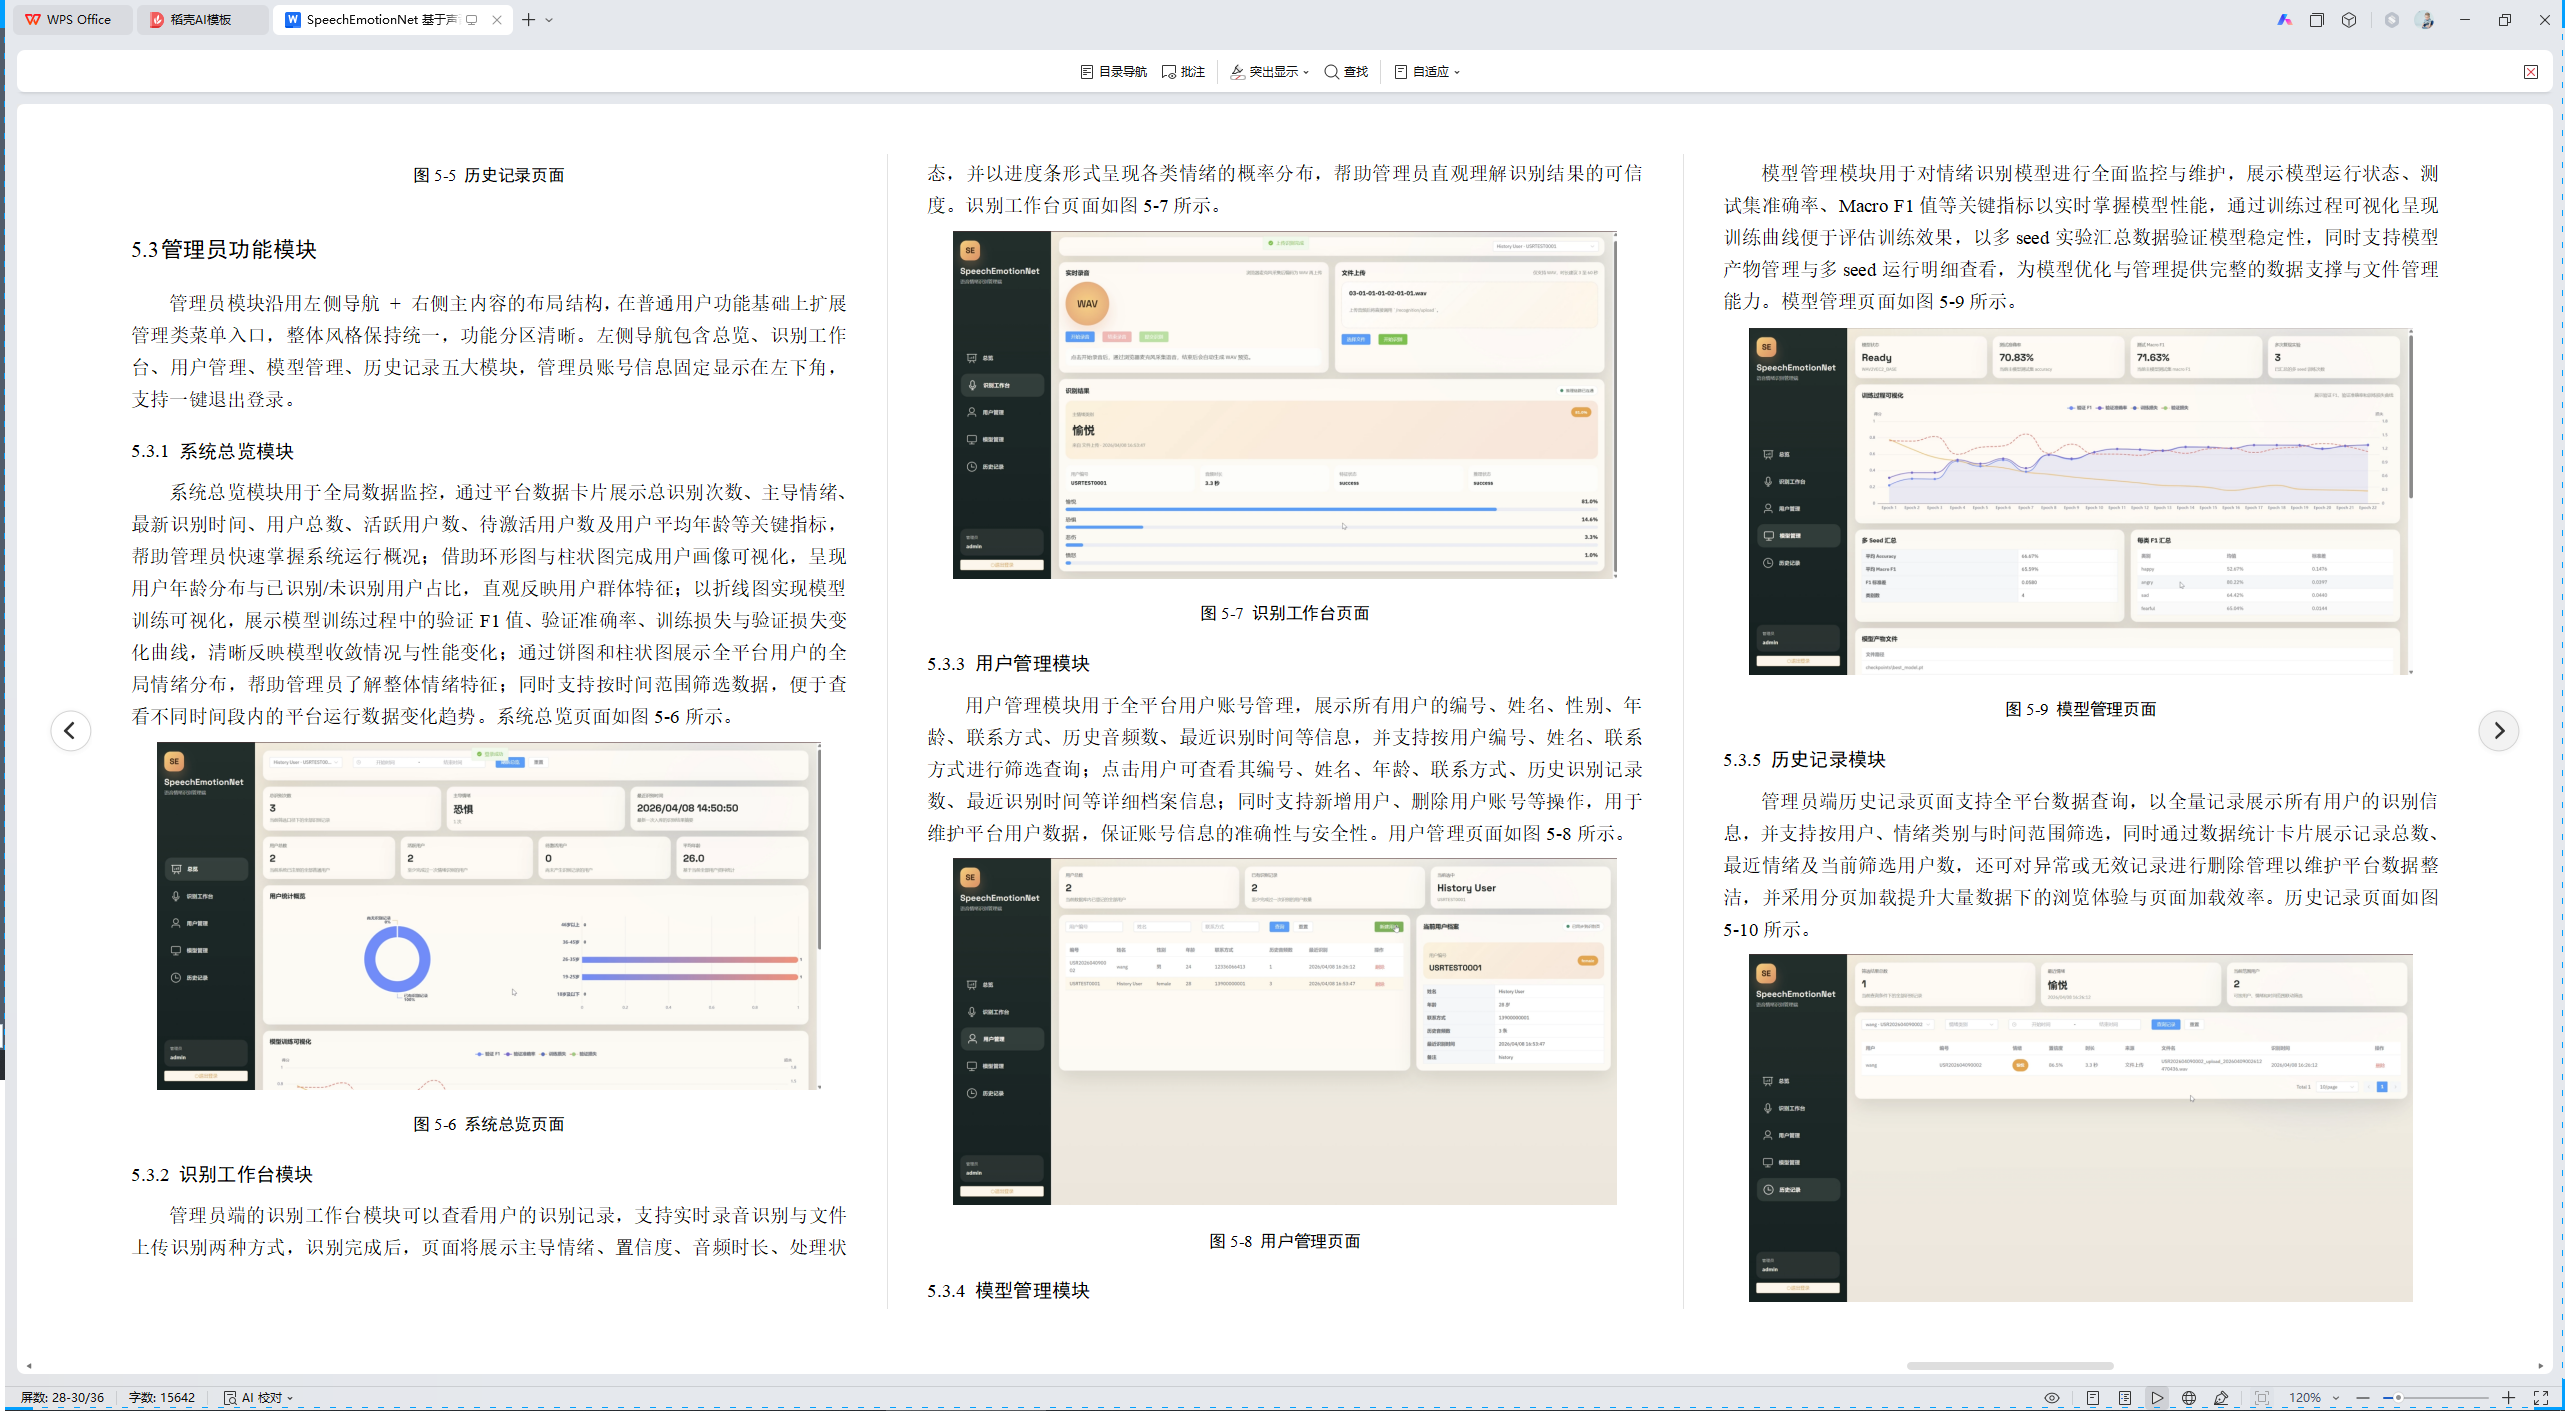
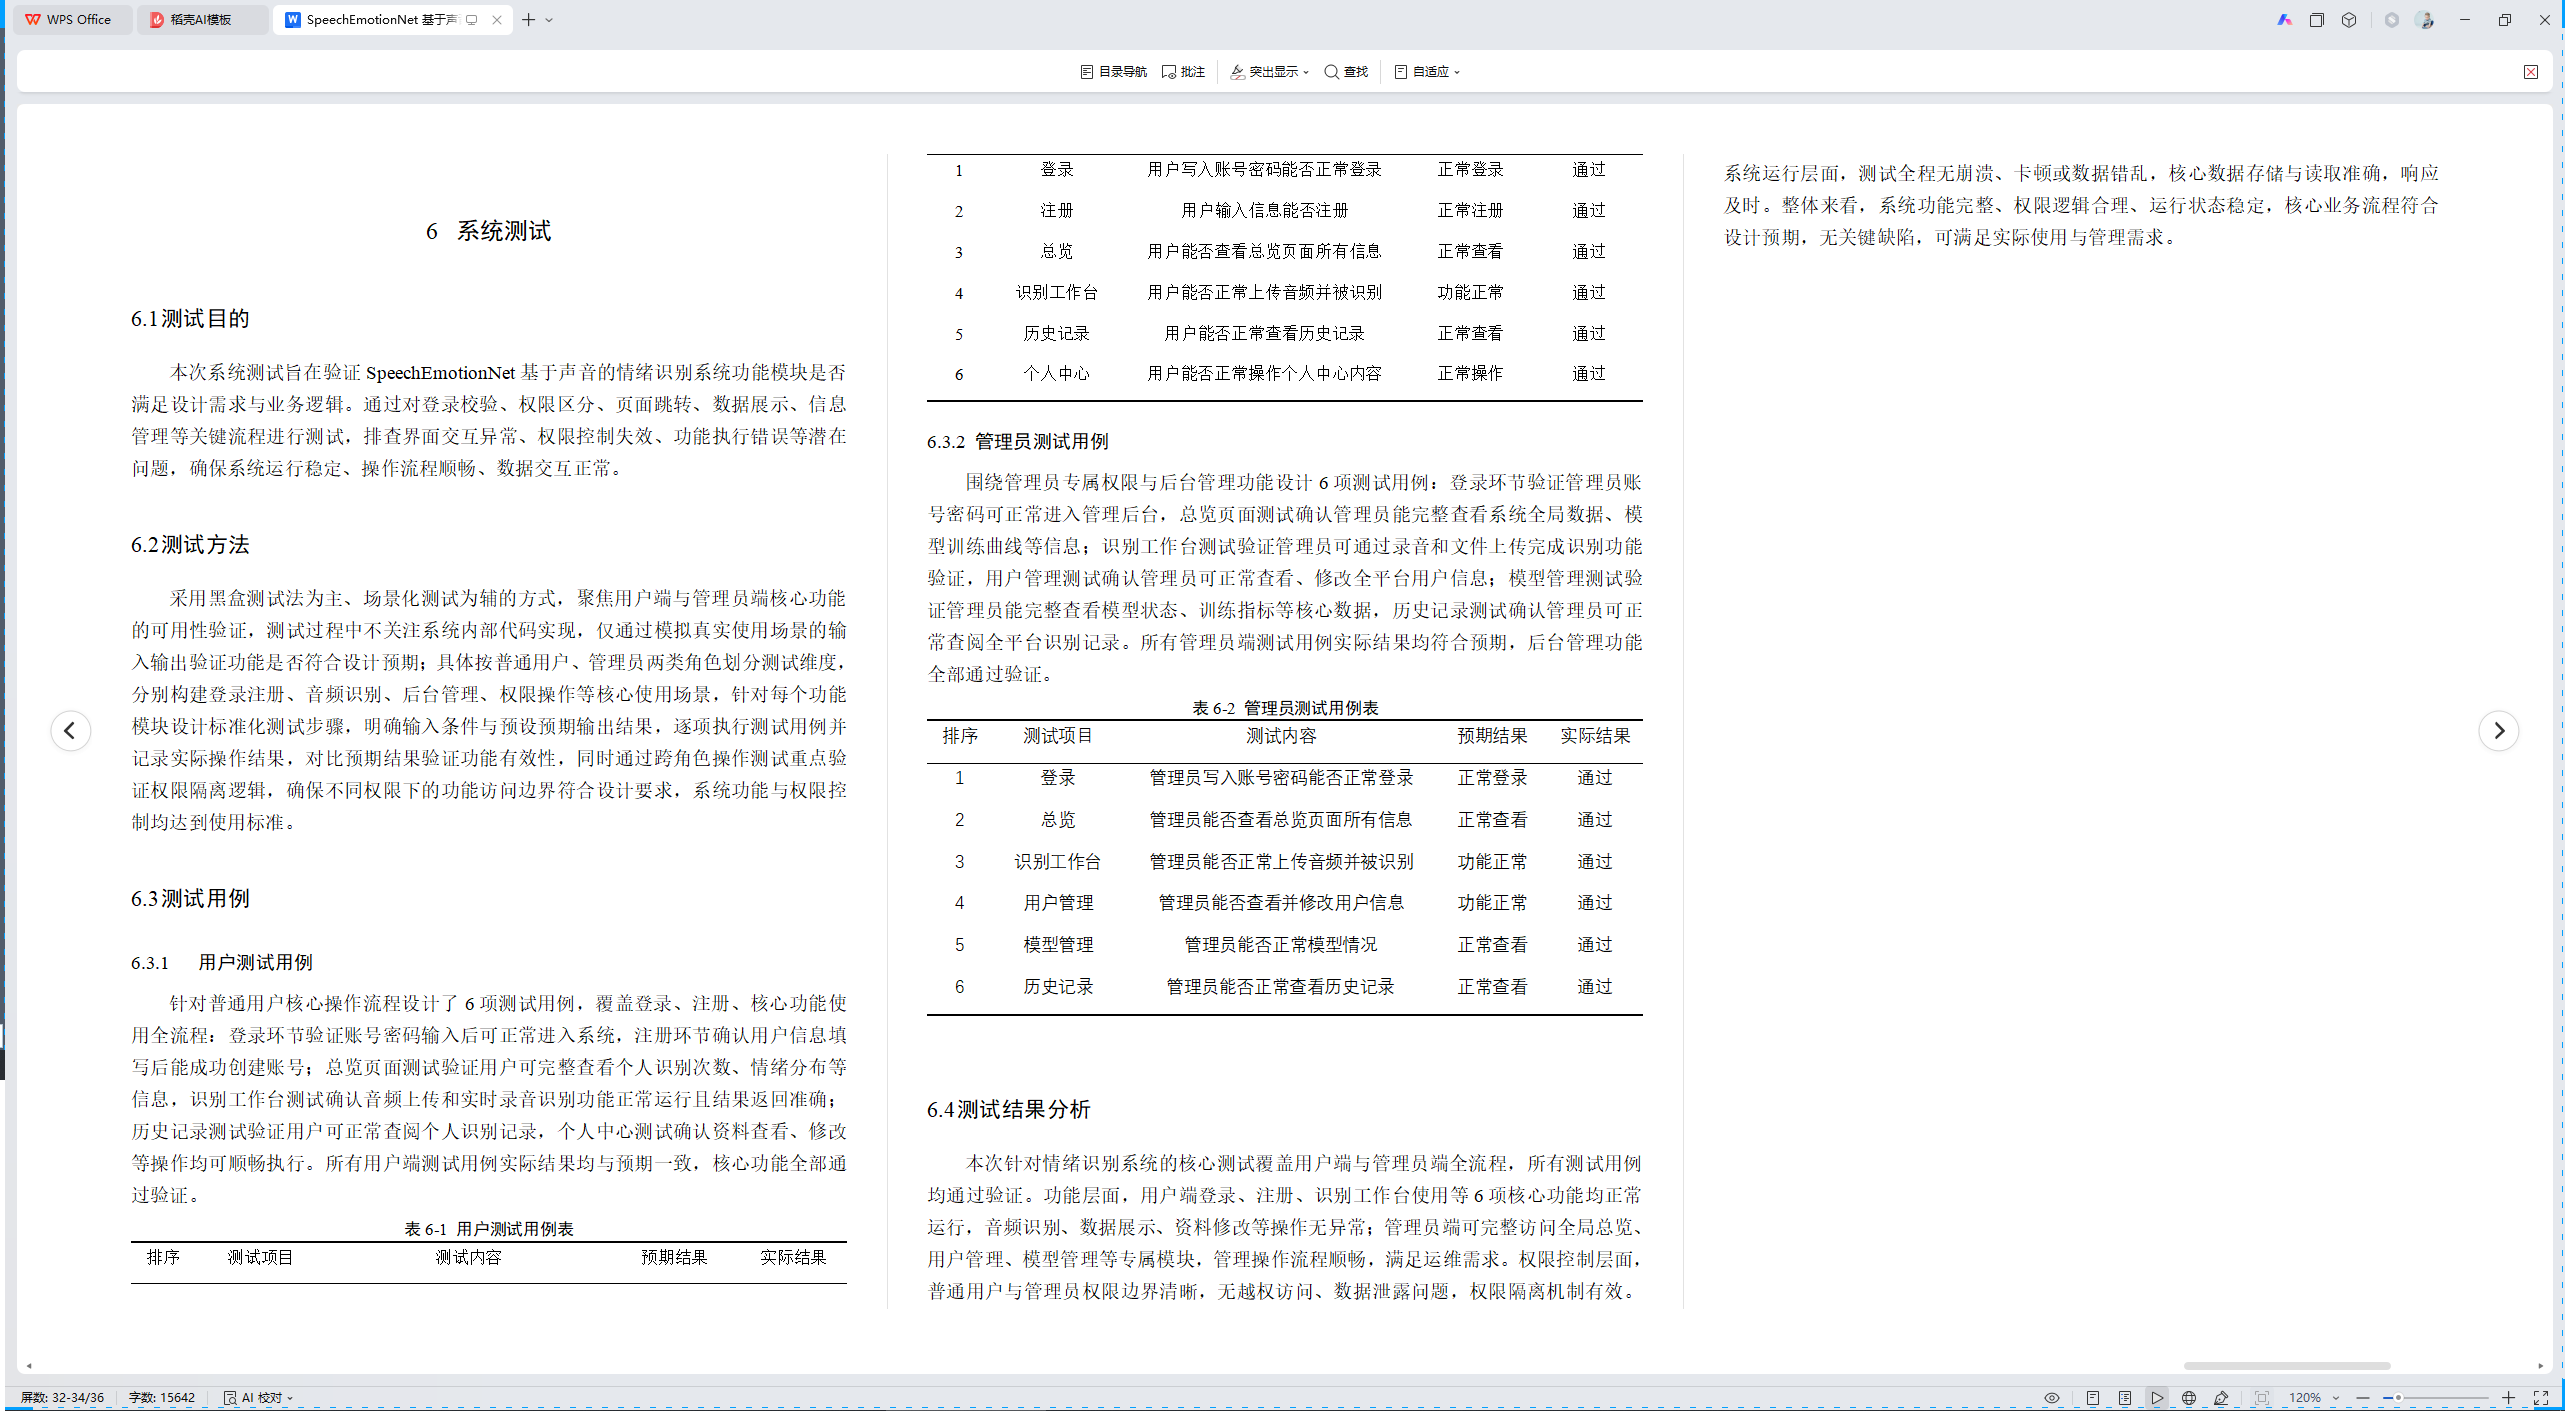
以下为三组不同随机种子下的训练过程曲线,分别对应训练损失、验证损失、验证集准确率与验证集宏F1的变化趋势。与单种子训练曲线相比,这三条曲线通过三次独立重复实验,消除了训练过程中随机初始化、数据增强和小批量采样带来的波动影响,为模型性能的稳定性提供了可靠依据。
图4- 10 多种子实验第1组训练损失与验证指标变化曲线
图4- 11 多种子实验第2组训练损失与验证指标变化曲线
图4- 12 多种子实验第3组训练损失与验证指标变化曲线
三组曲线均呈现出一致的健康训练特征:训练损失随轮次持续下降并最终收敛,验证损失虽有正常波动但整体趋于稳定,未出现过拟合迹象;验证集准确率与宏 F1 同步上升并趋于平稳,说明模型在不同初始化条件下均能有效学习情感特征,且各类情感识别性能均衡。三组曲线的细微差异属于训练过程中的正常随机波动,且波动幅度较小,与多种子实验汇总表中较低的标准差相吻合,证明模型结构合理、训练策略稳定,实验结论具有良好的可复现性。
登录模块是系统的入口,负责用户和管理员的身份验证与权限区分,为后续情绪识别、数据查询等功能提供安全保障。本模块分为前端交互界面与后端认证逻辑两部分实现,登录界面效果如图5-1所示。
图5-1 登录页面
用户模块为普通用户提供情绪识别、数据查询、个人信息管理等全流程服务,是用户与系统交互的主要载体。本模块包含系统总览、识别工作台、个人中心、历史记录四大功能页面。
系统总览模块用于直观展示用户的情绪识别数据,通过统计卡片展示总识别次数、主导情绪及最新识别时间,帮助用户快速了解个人情绪识别概况;采用ECharts可视化技术,以饼图呈现不同情绪的占比情况,以柱状图对比各类情绪的识别次数,清晰呈现用户情绪分布特征与出现频率。系统总览页面如图5-2所示。
图5-2 系统总览页面
识别工作台模块是用户进行情绪识别的核心页面,支持实时录音识别与文件上传识别两种方式:用户可通过浏览器麦克风采集语音,点击“开始录音”自动录制音频并提交识别;也可上传WAV格式音频文件,系统自动校验文件格式与时长并完成预处理后送入模型推理。识别完成后,页面将展示主导情绪、置信度、音频时长、处理状态,并以进度条形式呈现各类情绪的概率分布,帮助用户直观理解识别结果的可信度。识别工作台页面如图5-3所示。
图5-3 识别工作台页面
个人中心模块用于用户账号管理,页面会展示用户登录账号、用户编号、历史识别次数、账号创建时间等基础信息,同时支持修改姓名、性别、年龄、联系方式等个人资料,也可按需修改登录密码;修改完成后点击 “保存资料” 按钮,即可将更新后的信息同步至数据库,实现账号信息的动态管理。个人中心页面如图5-4所示。
图5-4 个人中心页面
历史记录模块用于查看用户所有识别记录,以表格形式展示每一次识别的用户、编号、情绪、置信度、时长、来源、文件名及识别时间等详细信息,支持按情绪类别和时间范围进行筛选查询以快速定位目标数据,同时提供删除功能让用户可清理不需要的历史记录以保证数据整洁,并采用分页加载方式提升大量数据下的页面加载速度与浏览体验。历史记录页面如图5-5所示。
图5-5 历史记录页面
管理员模块沿用左侧导航 + 右侧主内容的布局结构,在普通用户功能基础上扩展管理类菜单入口,整体风格保持统一,功能分区清晰。左侧导航包含总览、识别工作台、用户管理、模型管理、历史记录五大模块,管理员账号信息固定显示在左下角,支持一键退出登录。
系统总览模块用于全局数据监控,通过平台数据卡片展示总识别次数、主导情绪、最新识别时间、用户总数、活跃用户数、待激活用户数及用户平均年龄等关键指标,帮助管理员快速掌握系统运行概况;借助环形图与柱状图完成用户画像可视化,呈现用户年龄分布与已识别/未识别用户占比,直观反映用户群体特征;以折线图实现模型训练可视化,展示模型训练过程中的验证F1值、验证准确率、训练损失与验证损失变化曲线,清晰反映模型收敛情况与性能变化;通过饼图和柱状图展示全平台用户的全局情绪分布,帮助管理员了解整体情绪特征;同时支持按时间范围筛选数据,便于查看不同时间段内的平台运行数据变化趋势。系统总览页面如图5-6所示。
图5-6 系统总览页面
管理员端的识别工作台模块可以查看用户的识别记录,支持实时录音识别与文件上传识别两种方式,识别完成后,页面将展示主导情绪、置信度、音频时长、处理状态,并以进度条形式呈现各类情绪的概率分布,帮助管理员直观理解识别结果的可信度。识别工作台页面如图5-7所示。
图5-7 识别工作台页面
用户管理模块用于全平台用户账号管理,展示所有用户的编号、姓名、性别、年龄、联系方式、历史音频数、最近识别时间等信息,并支持按用户编号、姓名、联系方式进行筛选查询;点击用户可查看其编号、姓名、年龄、联系方式、历史识别记录数、最近识别时间等详细档案信息;同时支持新增用户、删除用户账号等操作,用于维护平台用户数据,保证账号信息的准确性与安全性。用户管理页面如图5-8所示。
图5-8 用户管理页面
模型管理模块用于对情绪识别模型进行全面监控与维护,展示模型运行状态、测试集准确率、Macro F1值等关键指标以实时掌握模型性能,通过训练过程可视化呈现训练曲线便于评估训练效果,以多seed实验汇总数据验证模型稳定性,同时支持模型产物管理与多seed运行明细查看,为模型优化与管理提供完整的数据支撑与文件管理能力。模型管理页面如图5-9所示。
图5-9 模型管理页面
管理员端历史记录页面支持全平台数据查询,以全量记录展示所有用户的识别信息,并支持按用户、情绪类别与时间范围筛选,同时通过数据统计卡片展示记录总数、最近情绪及当前筛选用户数,还可对异常或无效记录进行删除管理以维护平台数据整洁,并采用分页加载提升大量数据下的浏览体验与页面加载效率。历史记录页面如图5-10所示。
图5-10 历史记录页面
本次系统测试旨在验证SpeechEmotionNet基于声音的情绪识别系统功能模块是否满足设计需求与业务逻辑。通过对登录校验、权限区分、页面跳转、数据展示、信息管理等关键流程进行测试,排查界面交互异常、权限控制失效、功能执行错误等潜在问题,确保系统运行稳定、操作流程顺畅、数据交互正常。
采用黑盒测试法为主、场景化测试为辅的方式,聚焦用户端与管理员端核心功能的可用性验证,测试过程中不关注系统内部代码实现,仅通过模拟真实使用场景的输入输出验证功能是否符合设计预期;具体按普通用户、管理员两类角色划分测试维度,分别构建登录注册、音频识别、后台管理、权限操作等核心使用场景,针对每个功能模块设计标准化测试步骤,明确输入条件与预设预期输出结果,逐项执行测试用例并记录实际操作结果,对比预期结果验证功能有效性,同时通过跨角色操作测试重点验证权限隔离逻辑,确保不同权限下的功能访问边界符合设计要求,系统功能与权限控制均达到使用标准。
针对普通用户核心操作流程设计了6项测试用例,覆盖登录、注册、核心功能使用全流程:登录环节验证账号密码输入后可正常进入系统,注册环节确认用户信息填写后能成功创建账号;总览页面测试验证用户可完整查看个人识别次数、情绪分布等信息,识别工作台测试确认音频上传和实时录音识别功能正常运行且结果返回准确;历史记录测试验证用户可正常查阅个人识别记录,个人中心测试确认资料查看、修改等操作均可顺畅执行。所有用户端测试用例实际结果均与预期一致,核心功能全部通过验证。
表6-1 用户测试用例表
| 排序 | 测试项目 | 测试内容 | 预期结果 | 实际结果 |
| 1 | 登录 | 用户写入账号密码能否正常登录 | 正常登录 | 通过 |
| 2 | 注册 | 用户输入信息能否注册 | 正常注册 | 通过 |
| 3 | 总览 | 用户能否查看总览页面所有信息 | 正常查看 | 通过 |
| 4 | 识别工作台 | 用户能否正常上传音频并被识别 | 功能正常 | 通过 |
| 5 | 历史记录 | 用户能否正常查看历史记录 | 正常查看 | 通过 |
| 6 | 个人中心 | 用户能否正常操作个人中心内容 | 正常操作 | 通过 |
围绕管理员专属权限与后台管理功能设计6项测试用例:登录环节验证管理员账号密码可正常进入管理后台,总览页面测试确认管理员能完整查看系统全局数据、模型训练曲线等信息;识别工作台测试验证管理员可通过录音和文件上传完成识别功能验证,用户管理测试确认管理员可正常查看、修改全平台用户信息;模型管理测试验证管理员能完整查看模型状态、训练指标等核心数据,历史记录测试确认管理员可正常查阅全平台识别记录。所有管理员端测试用例实际结果均符合预期,后台管理功能全部通过验证。
表6-2 管理员测试用例表
| 排序 | 测试项目 | 测试内容 | 预期结果 | 实际结果 |
| 1 | 登录 | 管理员写入账号密码能否正常登录 | 正常登录 | 通过 |
| 2 | 总览 | 管理员能否查看总览页面所有信息 | 正常查看 | 通过 |
| 3 | 识别工作台 | 管理员能否正常上传音频并被识别 | 功能正常 | 通过 |
| 4 | 用户管理 | 管理员能否查看并修改用户信息 | 功能正常 | 通过 |
| 5 | 模型管理 | 管理员能否正常模型情况 | 正常查看 | 通过 |
| 6 | 历史记录 | 管理员能否正常查看历史记录 | 正常查看 | 通过 |
本次针对情绪识别系统的核心测试覆盖用户端与管理员端全流程,所有测试用例均通过验证。功能层面,用户端登录、注册、识别工作台使用等6项核心功能均正常运行,音频识别、数据展示、资料修改等操作无异常;管理员端可完整访问全局总览、用户管理、模型管理等专属模块,管理操作流程顺畅,满足运维需求。权限控制层面,普通用户与管理员权限边界清晰,无越权访问、数据泄露问题,权限隔离机制有效。系统运行层面,测试全程无崩溃、卡顿或数据错乱,核心数据存储与读取准确,响应及时。整体来看,系统功能完整、权限逻辑合理、运行状态稳定,核心业务流程符合设计预期,无关键缺陷,可满足实际使用与管理需求。
更多推荐



 2
 0
- 0


 已为社区贡献33条内容

所有评论(0)