
深度学习中食物图像分类项目讲解
一、介绍
这套代码完成了一个 20 类食物图像分类任务,从目录扫描生成索引,到数据增强、Dataset、DataLoader、CNN 训练、验证、保存最优模型,再到灰度图测试,形成了完整闭环。
二、核心代码讲解
2.1生成索引文件:train_test_file()
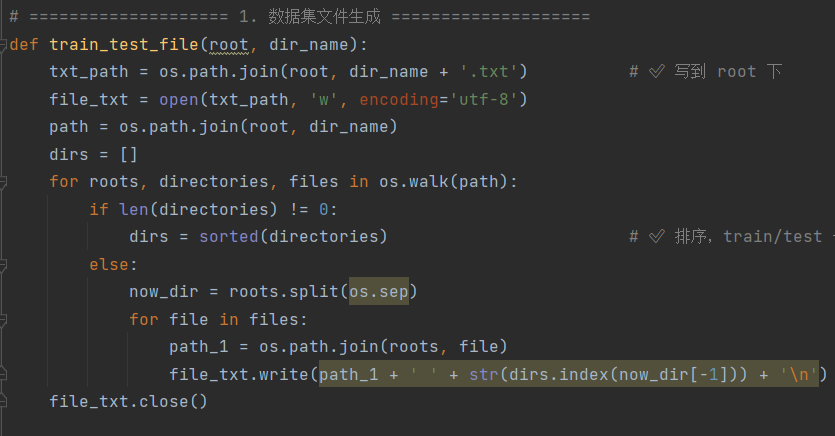
它的逻辑是:
1.进入food_dataset/train或food_dataset/test。
2.第一层os.walk遇到的是所有类别文件夹,例如:八宝粥、哈密瓜......
3.把这些类别文件夹排序:sorted(directories),保证train和test的标签顺序一致。
4.再进入每一个类别文件夹,用dirs.index(now_dir[-1])找到当前类别在排序列表中的下标,作为标签。
2.2数据增强与预处理
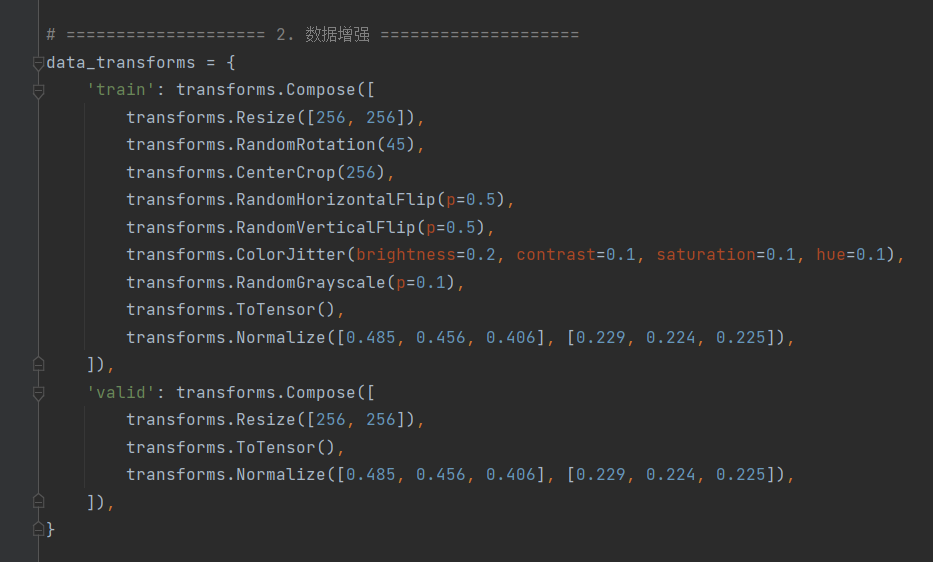
Resize([256,256]):统一图片大小。
RandomRotation(45):随机旋转最多45度。
CenterCrop(256):中心裁剪。
RandomHorizontalFilp/RandomVerticalFlip:随机水平、垂直翻转。
ColorJitter:随机调整亮度、对比度、饱和度、色调。
RandomGrayscale(p=0.1):10%概率转灰度,增强模型对颜色变化的鲁棒性。
ToTensor():PIL图片转成PyTorch张量,数值从0-255变成0-1.
Normalizze(...):用ImageNet的均值和标准差做标准化。
2.3自定义Dataset
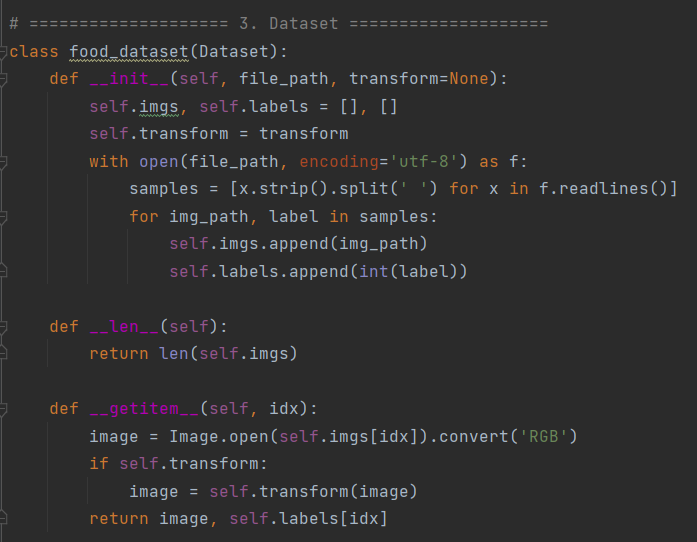
1.读取train.txt或test.txt
2.每行按空格拆成图片路径和标签。
3.__getitem__ 打开图片,强制转成 RGB 三通道,再做 transform,返回(image,label)。
因为模型输入必须是三通道,所以即使你给了灰度图,convert('RGB')也会把它变成三通道,只是三个通道数值相同
2.4CNN模型结构
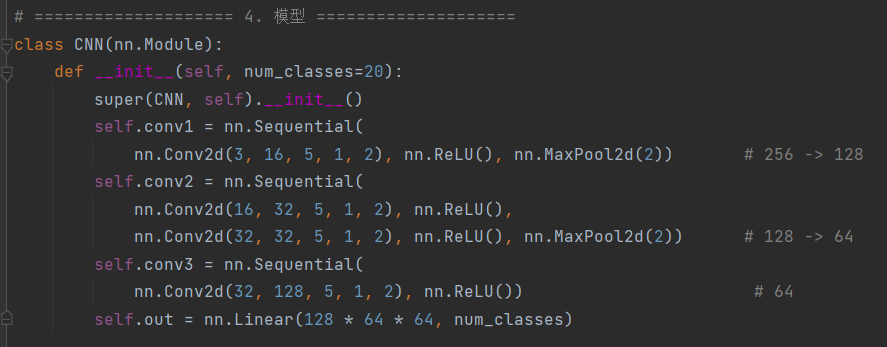
输入是3*256*256,变化过程:
1.conv1:Conv3——>16,kernel=5,padding=2,尺寸保持256;MaxPool后变成16*128*128
2.conv2:Conv16——>32,再Conv32——>32,MaxPool后变成32*64*64。
3.conv3:Conv32——>128,尺寸仍是128*64*64。
4.x.View(x.size(0),-1)展平:128*64*64=524288维。
5.Linear(128*64*64,20)输出20类分数。
2.5训练、验证与测试
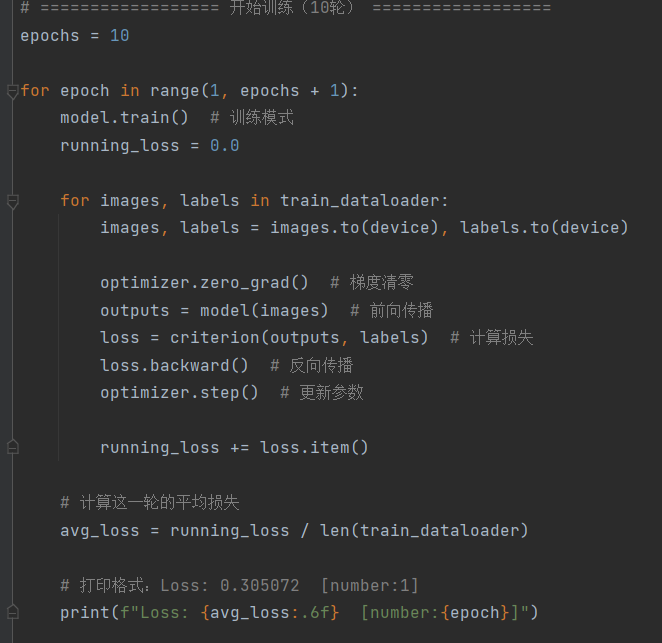
损失函数是:criterion = nn.CrossEntropyLoss()
优化器是:optimizer = torch.optim.Adam(model.parameters(),lr=0.001,weight_decay=1e-4)
更多推荐



 1
 0
- 0


 已为社区贡献10条内容

所有评论(0)