
dlib人脸检测+关键点定位+表情识别 学习笔记(附完整代码)
最近在学计算机视觉的人脸相关算法,从dlib入门感觉还是比较友好的,比OpenCV自带的Haar级联检测器效果好不少。整理了一下从入门到简单表情识别的5个Demo,一步步递进,每段代码都保留了原注释,方便自己回头看,也给同样入门的朋友做个参考。
一、环境准备
需要提前装好这几个库:
opencv-python:读图、绘图、调用摄像头dlib:核心人脸检测和关键点预测库numpy:坐标矩阵运算scikit-learn:计算欧氏距离(表情识别用)pillow:在图片上写中文
直接pip安装就行,dlib安装如果报错的话,建议先装cmake和boost。
pip install opencv-python dlib numpy scikit-learn pillow
另外关键点定位需要预训练模型 shape_predictor_68_face_landmarks.dat,可以去dlib-models的github仓库下载
二、Demo1:图片人脸检测
最基础的入门,检测一张图片里的所有人脸,画个矩形框出来。dlib用的是HOG算法,比OpenCV的Haar特征检测率高,误检少。
1. 导入库并创建检测器
import cv2
import dlib

# get_frontal_face_detector()生成人脸检测器
# 使用HOG算法、线性分类器、金字塔图像结构和滑动窗口检测等技术。
# 比opencv提供的harr级联分类器效果更好
detector=dlib.get_frontal_face_detector()# 构造脸部位置检测器HOG
2. 读取图片并检测人脸
第二个参数1是上采样次数,数值越大能检测到越小的脸,但速度会变慢,一般0或1就够了。
img=cv2.imread("img.png")

# faces = detector(image,n)使用人脸检测器返回检测到的人脸框
# 参数:image:待检测的可能含有人脸的图像。
# 参数n:表示采用上采样的次数。上采样会让图像变大,能够检测到更多人脸对象,提高小人脸的检测效果
#通常建议将此参数设置为 0 或 1。较大的值会增加检测的准确性,但会降低处理速度。
# 返回值faces:返回检测图像中的所有人脸框。
faces=detector(img,0)
3. 遍历人脸画框并显示
for face in faces: #对每个人脸框进行逐个处理
    # 获取人脸框的坐标
    x1=face.left()
    y1=face.top()
    x2=face.right()
    y2=face.bottom()
    # 绘制人脸框
    cv2.rectangle(img,(x1,y1),(x2,y2),(0,255,0),2)

# 显示捕获到的各个人脸框
cv2.imshow("result",img)
cv2.waitKey(0)
cv2.destroyAllWindows()
运行效果就是图片上每个人脸都会被绿色框标出来,多人脸也能同时检测到。
三、Demo2:实时视频人脸检测
把图片换成摄像头实时画面,逻辑基本一样,套个循环就行。
import cv2
import dlib

detector=dlib.get_frontal_face_detector()# 构造脸部位置检测器HOG
cap=cv2.VideoCapture(0) # 0是默认摄像头
主循环里逐帧读取,做个水平翻转(镜像),看着更自然,检测逻辑和图片版一模一样。
while True:
    ret,frame=cap.read()
    frame=cv2.flip(frame,1)
    faces = detector(frame, 0)

    for face in faces:  # 对每个人脸框进行逐个处理
        # 获取人脸框的坐标
        x1 = face.left()
        y1 = face.top()
        x2 = face.right()
        y2 = face.bottom()
        # 绘制人脸框
        cv2.rectangle(frame, (x1, y1), (x2, y2), (0, 255, 0), 2)
最后显示画面,按ESC键退出。
    # 显示捕获到的各个人脸框
    cv2.imshow("result", frame)
    if cv2.waitKey(1)==27: # ESC键退出
        break

cv2.waitKey(0)
cv2.destroyAllWindows()
四、Demo3:人脸68关键点定位
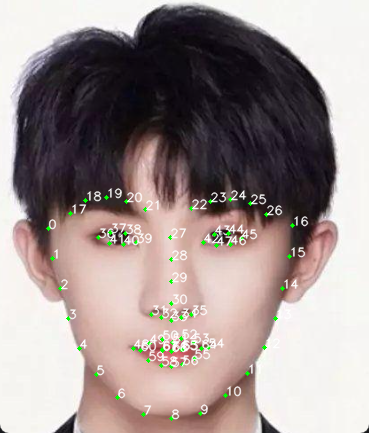
检测到人脸框之后,进一步定位脸上的68个特征点,包括眉毛、眼睛、鼻子、嘴巴、脸颊轮廓。
1. 初始化模型
'''关键点定位:表示定位到人脸的眼睛、鼻子、眉毛、轮廓等'''
import numpy as np
import cv2
import dlib

img = cv2.imread("majiaqi.png")# 读取图像
detector = dlib.get_frontal_face_detector()#构造人脸检测器
faces = detector(img, 0)#检测人脸

#dlib.shape_predictor载入模型(加载预测器)
# 可以从[https://github.com/davisking/dlib-models](https://github.com/davisking/dlib-models)下载
predictor = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")
2. 提取关键点坐标并绘制
shape.parts()返回的是dlib的点对象,转成numpy数组方便后续计算。每个点画个小圆,顺便标上序号,方便知道每个位置对应几号点。
for face in faces: #获取每一张脸的关键点(实现检测)
    shape=predictor(img, face)# 获取关键点
    # 将关键点转换为坐标(x,y)的形式
    # landmarks = np.matrix([[p.x, p.y] for p in shape.parts()])
    landmarks = np.array([[p.x, p.y] for p in shape.parts()])

    #绘制每一张脸的关键点(绘制shape中的每个点)
    for idx, point in enumerate(landmarks):
        # pos = (point[0, 0], point[0, 1])# 当前关键的坐标
        pos = [point[0],point[1]]# 当前关键的坐标
        # 针对当前关键点,绘制一个实心圆
        cv2.circle(img, pos,2,(0, 255, 0),-1)
        # 普通大小的等宽字体
        cv2.putText(img, str(idx), pos, cv2.FONT_HERSHEY_SIMPLEX,0.4,
                    (255, 255, 255),1, cv2.LINE_AA) # 线条类型:抗锯齿线条。
cv2.imshow("img", img)
cv2.waitKey()
cv2.destroyAllWindows()
68个点的分布大概是:0-16是脸颊轮廓,17-26是眉毛,27-35是鼻子,36-47是眼睛,48-67是嘴巴。记住序号后面做表情识别会经常用到。
五、Demo4:人脸轮廓绘制
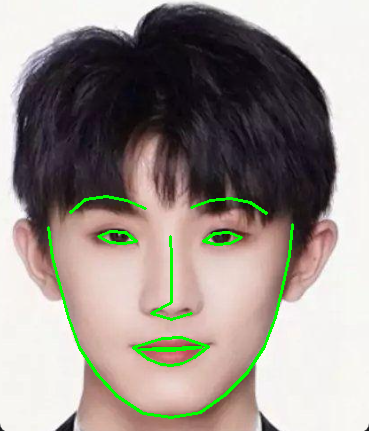
光有点不够直观,把相邻的点连起来,画出人脸的轮廓。分两种画法:折线和凸包。
1. 两个绘图工具函数
drawLine是点对点连线,适合脸颊、眉毛、鼻子这种轮廓;drawConvexHull是生成凸包,适合眼睛、嘴巴这种闭合区域。
import numpy as np
import dlib
import cv2

# 4个用法
def drawLine(start,end):      # 将指定的点连接起来
    pts = shape[start:end]     # 获取点集
    for l in range(1, len(pts)):
        ptA = tuple(pts[l - 1])
        ptB = tuple(pts[l])
        cv2.line(image, ptA, ptB,(0, 255, 0),2)

def drawConvexHull(start,end):
    # 将指定的点构成一个凸包,绘制成轮廓,一般眼睛、嘴使用凸包用来绘制
    Facial = shape[start:end+1]
    mouthHull = cv2.convexHull(Facial) # 凸包函数
    cv2.drawContours(image,[mouthHull], -1,(0, 255, 0),2)
2. 检测+绘制各部位
image=cv2.imread("majiaqi.png")
detector = dlib.get_frontal_face_detector()# 构造脸部位置检测器
faces = detector(image, 0)#检测人脸方框位置

#读取人脸关键点定位模型
predictor = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")

for face in faces:# 对检测到的rects,逐个遍历
    shape = predictor(image, face) # 获取关键点
    # 将关键点转换为坐标(x,y)的形式
    shape = np.array([[p.x, p.y] for p in shape.parts()])

    drawConvexHull(start=36, end=41)   # 绘制右眼凸包
    drawConvexHull(start=42, end=47)   # 绘制左眼凸包
    drawConvexHull(start=48, end=59)   #绘制嘴外部凸包
    drawConvexHull(start=60, end=67)   # 绘制嘴内部凸包

    drawLine(start=0, end=17)   # 绘制脸颊点线
    drawLine(start=17, end=22)  # 绘制左眉毛点线
    drawLine(start=22, end=27)  # 绘制右眉毛点线
    drawLine(start=27, end=36)  # 绘制鼻子点线
cv2.imshow("Frame", image)
cv2.waitKey()
cv2.destroyAllWindows()
运行完就能看到完整的人脸线框了,五官都能清晰勾勒出来。代码里也注释掉了视频版的代码,想用摄像头实时跑把注释放开就行。
六、Demo5:简单表情识别
基于关键点的几何特征来判断表情,不用训练模型,纯靠比例阈值判断。
1. 三个核心特征值
主要计算三个比例:
- MAR:嘴部高宽比,嘴巴张得越大值越高
- MJR:嘴宽/脸颊宽,嘴巴往两边咧的值越高
import numpy as np
import dlib
import cv2
from sklearn.metrics.pairwise import euclidean_distances  #计算欧氏距离
from PIL import Image, ImageDraw, ImageFont
# 计算嘴的宽高比
def MAR(shape):
    A = euclidean_distances(shape[50].reshape(1, 2), shape[58].reshape(1, 2))
    B = euclidean_distances(shape[51].reshape(1, 2), shape[57].reshape(1, 2))
    C = euclidean_distances(shape[52].reshape(1, 2), shape[56].reshape(1, 2))
    D = euclidean_distances(shape[48].reshape(1, 2), shape[54].reshape(1, 2))
    return ((A+B+C)/3)/D
#计算嘴宽度、脸颊宽度的比值
def MJR(shape):
    M = euclidean_distances(shape[48].reshape(1, 2), shape[54].reshape(1, 2)) #嘴宽度
    J = euclidean_distances(shape[3].reshape(1, 2), shape[13].reshape(1, 2)) #下颌的宽度
    return M/J
2. OpenCV写中文的工具函数
OpenCV原生不支持中文,得用PIL转一下。
# 向图片中添加中文
def cv2AddChineseText(img, text, position, textColor=(0, 255, 0), textSize=30):
    if (isinstance(img, np.ndarray)):  # 判断是否OpenCV图片类型
        img = Image.fromarray(cv2.cvtColor(img, cv2.COLOR_BGR2RGB))#实现array到image的转换
    draw = ImageDraw.Draw(img) # 在img图片上创建一个绘图的对象
    # 字体的格式
    fontStyle = ImageFont.truetype("simsun.ttc", textSize, encoding="utf-8")
    draw.text(position, text, textColor, font=fontStyle) # 绘制文本
    return cv2.cvtColor(np.asarray(img), cv2.COLOR_RGB2BGR)# 转换回OpenCV格式
3. 实时检测主逻辑
阈值是经验值,可以自己打印数值调整。这里区分了大笑、微笑表情。
detector = dlib.get_frontal_face_detector() # 构造脸部位置检测器
predictor = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")#读取人脸关键点定位模型
cap=cv2.VideoCapture(0)

while True:
    ret,frame = cap.read()
    frame=cv2.flip(frame,1)
    faces = detector(frame, 0) # 获取图片中全部人脸位置

    for face in faces:
        shape = predictor(frame, face) #获取关键点
        # 将关键点转换为坐标(x,y)的形式
        shape = np.array([[p.x, p.y] for p in shape.parts()])

        mar = MAR(shape)    #计算嘴部的高宽比
        mjr = MJR(shape)    #计算“嘴宽/脸颊宽”
        mer =  MER(shape)   #计算眼睛的高宽比

        result="正常"       #默认是正常表情

        # print("mar",mar,"tmj",mjr) #测试一下实际值,可以根据该值确定
        if mar > 0.5:  #可更改项目要求调整阈值。
            result="大笑"
        elif mjr>0.45 : # 超过阈值为微笑
            result="微笑"
4. 绘制结果
把嘴巴的凸包画出来,在人脸上方标注表情结果。
        # frame = cv2AddChineseText(frame, result, (50, 100))#输出中文
        # cv2.putText()#输出英文
        mouthHull = cv2.convexHull(shape[48:61]) # 嘴型构造凸包
        frame = cv2AddChineseText(frame, result, mouthHull[0][0]) #多人脸
        cv2.drawContours(frame,[mouthHull], -1,(0, 255, 0),1)
    cv2.imshow("Frame", frame)
    if cv2.waitKey(1) == 27:
        break
cv2.destroyAllWindows()
cap.release()
七、小结
- dlib的HOG人脸检测器确实比Haar稳,侧脸、小角度偏转也能检测到,但大侧脸还是不行,要更准得上CNN或者MTCNN。
- 68关键点是基础,后面的人脸对齐、表情识别、换脸很多都基于这个。
- 基于几何特征的表情识别就是图一乐,鲁棒性一般,受角度、光照影响大,真正实用还是得深度学习训练模型。
- 阈值一定要自己调,不同人脸比例不一样,打印出mar、mjr的数值,根据自己情况改判断条件。
- 代码里每个都能写出对应的视频版,简单修改一下就行。
更多推荐


 3
 0
- 0


 已为社区贡献6条内容

所有评论(0)