
AI 学习型基数估计第一周复盘:从神话走向务实融合的边界
·
AI 学习型基数估计第一周复盘:从神话走向务实融合的边界
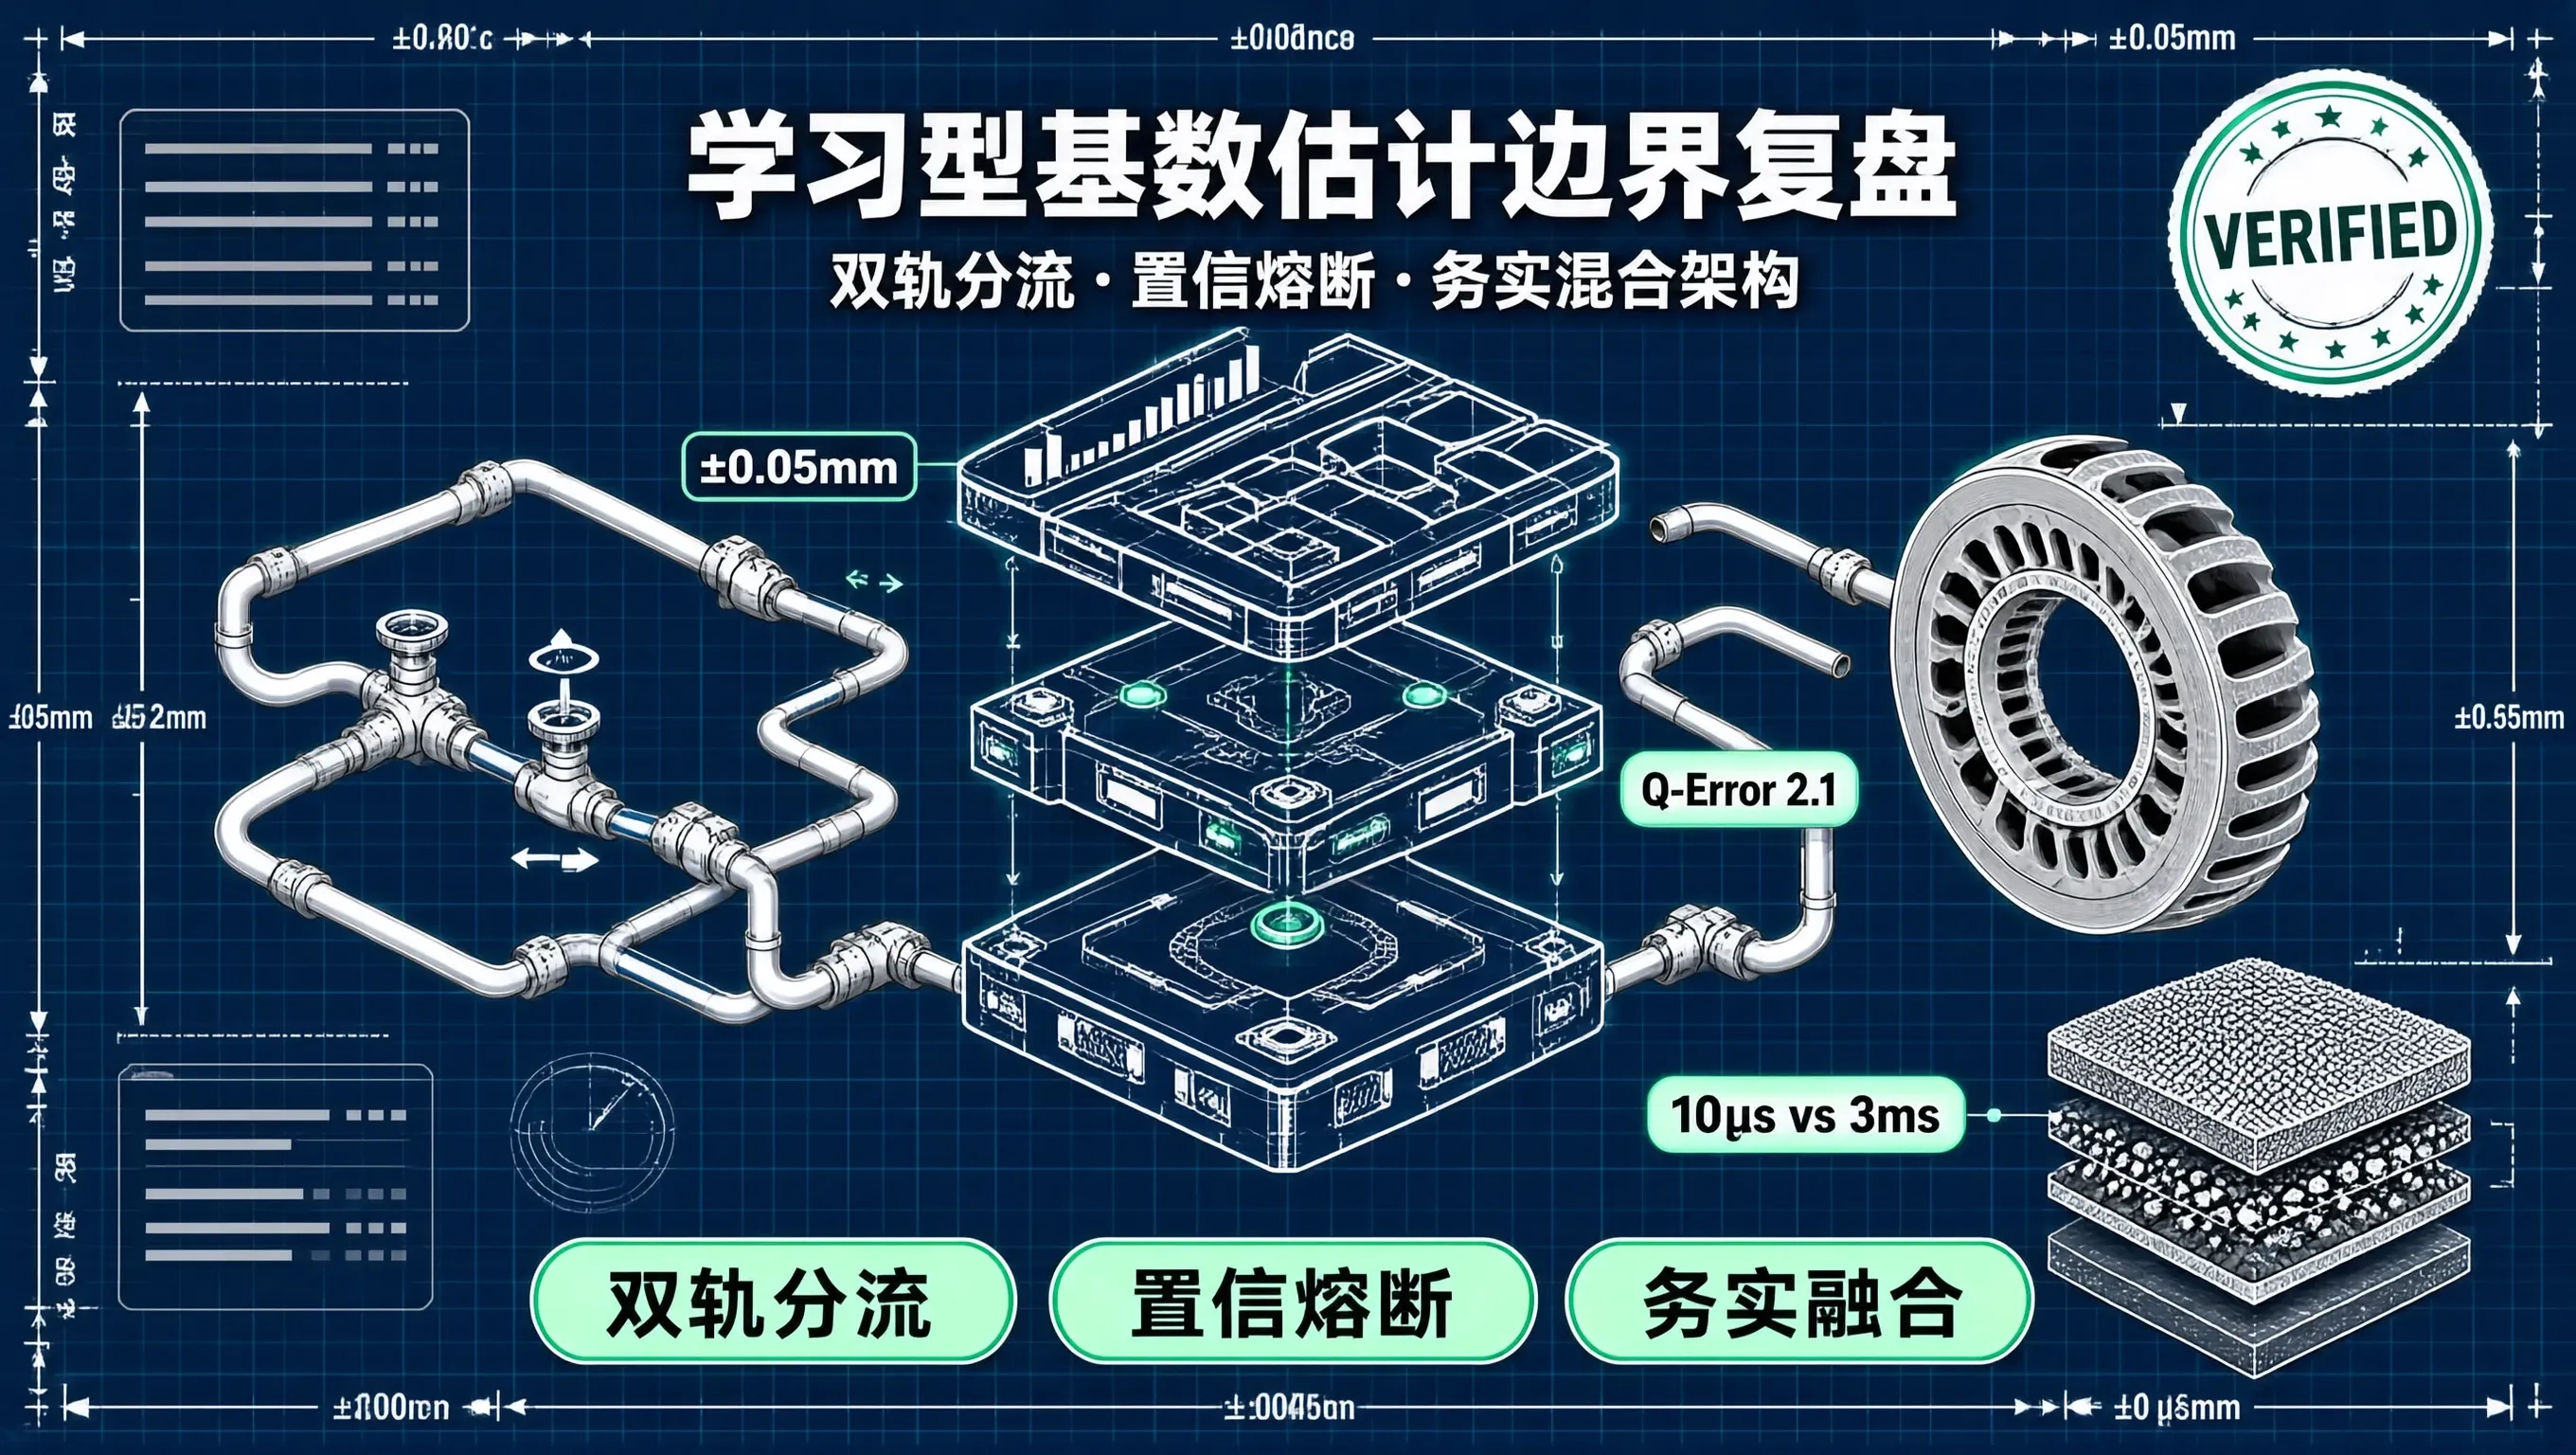
作为九月份“存储内核的秋天:万亿数据下的稳定性冲刺”战役的第一周(W1),我们在过去六天里,对学术界和工业界热议的学习型基数估计(Learned Cardinality Estimation) 进行了全方位的实战检验与压力拷打。
从 9 月 1 号的自回归模型实测,到 9 月 2 号的数据倾斜翻车复盘,再到冷启动降级策略与经典 HyperLogLog(HLL)算法的对比,整个技术攻坚过程让我们彻底走出了最初对 AI“全盘接管优化器内核”的盲目幻想,看清了深度学习在数据库底层物理世界的真实定位。
在开启下一阶段关于“AI 执行计划生成可信度验证”之前,我们必须对学习型基数估计的真实能力边界与融合架构做一次深度复盘。
[学习型基数估计第一周攻坚与实测结论矩阵]

  ┌─────────────────────────────────────────────────────────────┐
  │ 核心优势区 (AI 的绝对胜场)                                    │
  │   - 多维非线性强相关谓词 (Q-Error 从传统 48.2 压降至 2.1)     │
  │   - 消除手工维护多列统计信息的巨大运维负担                  │
  ├─────────────────────────────────────────────────────────────┤
  │ 致命死穴区 (AI 的物理短板)                                    │
  │   - 推理延迟过高 (单次 2~5ms vs 传统直方图 10µs,拖垮 OLTP)   │
  │   - 数据倾斜与长尾 OOD 区域泛化崩塌 (导致极端暴跌计划)       │
  │   - 动态写入下的灾难性遗忘与高昂重训成本                     │
  ├─────────────────────────────────────────────────────────────┤
  │ 最终落地方案 (务实混合架构)                                  │
  │   - OLTP 短事务: 100% 走传统直方图 + 代数规则                │
  │   - 离线长查询: 模型异步推理 + SPM 计划基线缓存               │
  │   - 设置置信度双向安全熔断与贝叶斯平滑过渡                   │
  └─────────────────────────────────────────────────────────────┘
认知破局:为什么单纯替代不可行?
过去一周的实测数据,粉碎了“神经网络全面替换传统优化器”的学术神话:
- 时间尺度的错位:
关系型数据库的单次点查与轻量范围扫描,要求端到端延迟在 1~3 毫秒 以内。如果优化器光是计算基数就需要消耗 3 毫秒的 CPU 矩阵运算,这种“为了最优计划而付出更高总耗时”的优化本质上是倒退; - 确定性与极端容错的要求:
工业级数据库永远把最坏情况(Worst-Case Bound) 置于最高优先级。传统直方图哪怕估算有偏差,其误差范围是可通过数学上界证明的;而深度神经网络在未充分训练的冷启动或生僻枚举空间中,输出的不可预测概率往往会直接触发全表笛卡尔积,导致系统性崩溃。
务实融合:双轨制分流架构(Dual-Track Architecture)
第一周攻坚最宝贵的产物,是我们探索出了一套**“双轨制混合基数裁决流水线”**:
class DualTrackOptimizerCoordinator:
    """双轨制优化器协同裁决器"""
    def __init__(self, traditional_optimizer, learned_model_gateway):
        self.trad_opt = traditional_optimizer
        self.learned_gw = learned_model_gateway

    def route_and_optimize(self, query_ast, table_meta):
        # 1. 快速模式识别:OLTP 高频短查询走极速纯传统通道
        if self._is_simple_oltp(query_ast):
            return self.trad_opt.generate_plan(query_ast)

        # 2. 复杂多表关联与 Ad-hoc 分析:尝试拉取学习型模型建议
        if self._is_complex_analytical(query_ast):
            model_prediction = self.learned_gw.async_predict(query_ast)

            # 3. 严格安全校验:比对传统直方图上界,防止模型幻觉
            if self._is_prediction_safe(model_prediction, table_meta):
                return self.trad_opt.generate_plan_with_hint(query_ast, model_prediction)

        # 默认回退传统计划
        return self.trad_opt.generate_plan(query_ast)

    def _is_simple_oltp(self, ast) -> bool:
        # 单表或双表主键/唯一索引查询直接绕行
        return ast.table_count <= 2 and ast.has_point_lookup
下周展望:从基数估计走向执行计划生成
搞清楚了基数估计的边界,下周(W2)我们将进一步挺进内核深水区——探索利用大模型直接评估并推荐复杂多表关联的物理执行计划(AI Query Plan Generation)。
在基数已知的条件下,大模型能否比传统动态规划(DP)和遗传算法(Genetic Algorithm)更快找到全局最优 Join 顺序?如何对大模型生成的 Plan 进行确定性的代价可信度校验?我们将带着本周沉淀的敬畏与冷静,继续在代码与基准压测中寻找终极答案。
更多推荐



 4
 0
- 0


 已为社区贡献421条内容

所有评论(0)