
机器学习中的熵,5种距离
机器学习常见概念
一.机器学习中常见的几种距离度量
1.欧式距离
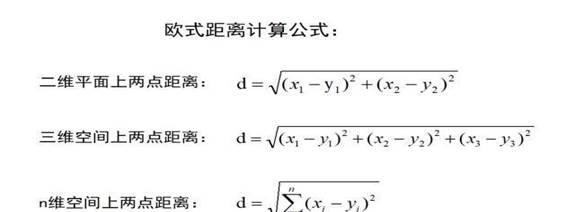
在用机器学习的方法处理大数据时,经常需要分析数据之间的相似度,通常的做法是构建一个距离模型,通过计算样本之间的距离判断两个样本是否相似。最常见的距离描述方法是欧式距离(也称为欧几里得度量),二维平面或三维空间中两个点的距离是最典型的欧式距离,很容易被我们理解。在实际应用中数据的维度往往很高,数十维、数百维,甚至可能达到上千维,欧式距离的计算公式如下图所示。注意两个点的坐标用向量表示(x1, x2, x3, ……, xn)和(y1, y2, y3, ……, yn)。
2.曼哈顿距离
美国纽约曼哈顿由一条条横平竖直的道路划分为一个个街区,可由下图表示。如果想要从左下角的点开车前往右上角的点,如何规划一条最短的路径呢?显然我们有很多路径可以选择,如图中红色、蓝色、黄色的路径,这些路径的总长度都是相等的。这种距离度量方式被称之为曼哈顿距离,假设两个n维向量可以表示为(x1, x2, x3, ……, xn)和(y1, y2, y3, ……, yn)计算公式为:d=|x1-y1|+|x2-y2|,当然也可以推广到n维空间:d=Σ|xi-yi|。
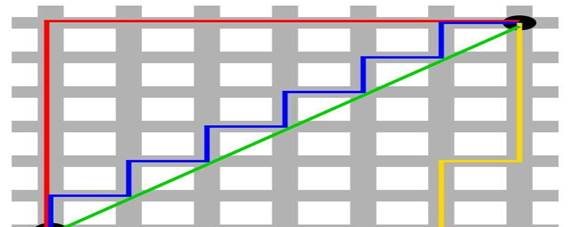
曼哈顿距离是非常容易理解的,它表示了开车的实际距离,图中的绿色线段长度是两个点的欧式距离,虽然这个距离最短,但是没有任何实际意义,因为车辆只能沿道路行驶,不能从街区内部穿越。由于曼哈顿距离更贴近实际,因此应用非常广泛,前文在介绍A*算法时,就使用了曼哈顿距离作为启发式函数。
3.切比雪夫距离
在国际象棋的规则中,国王既可以沿直线移动,也可以沿斜线移动,但是每次只能移动一格。下图用国际象棋棋盘展示了切比雪夫距离,国王位于第6行第f列,棋盘方格中的数字是国王移动到该位置所需的步数,即距离国王所在位置的切比雪夫距离。切比雪夫距离的计算公式为:d=max(|x1-y1|, |x2-y2|),当然也可以推广到n维。
4.闵科夫斯基距离
先来看一下闵科夫斯基距离的定义:假设两个n维向量可以表示为(x1, x2, x3, ……, xn)和(y1, y2, y3, ……, yn),那么这两个向量的闵科夫斯基距离可用下图第一个公式表示。闵科夫斯基距离实际上是将上面讲的三种距离进行了统一的描述,曼哈顿距离是p=1时的闵科夫斯基距离,欧式距离是p=2时的闵科夫斯基距离,而切比雪夫距离是p趋近∞时的闵科夫斯基距离。
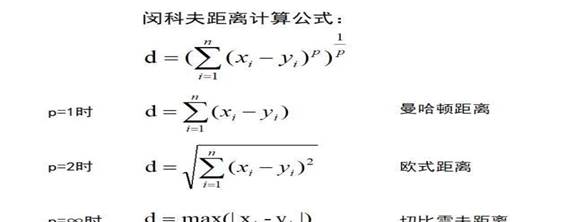
5.标准化欧式距离
标准化欧式距离是对欧式距离的改进,欧式距离是有缺陷的,下面用一个简单的例子加以说明。比如用身高和体重来描述一个人的体型,用欧式距离来描述两个人的体型相似度,那么身高172cm体重70kg的体型是与身高180cm体重65kg的体型更相似,还是与身高165cm体重80kg的体型更相似?身高、体重这两个分量的尺度分布不同,用欧式距离分别得到的相似度显然不可靠。标准化欧式距离的思路是将分量进行标准化处理,方法是将每一个累加项除以该分量的方差。如果将方差的倒数看作权重,标准化欧式距离就变成了加权欧式距离。
6.小结
上文提到的5种度量方法本身没有优劣之分,它们各自适用于不同的环境和条件。当然在机器学习和数据分析中,距离度量的方法远不止这几种,常用的度量数量多达数十种,每个人都可以根据自己的实际需要定义独一无二的距离度量方法。本文介绍的都是最简单最基本的几种度量,接下来的文章中将继续介绍协方差、马氏距离等内容,敬请期待。
二.信息熵
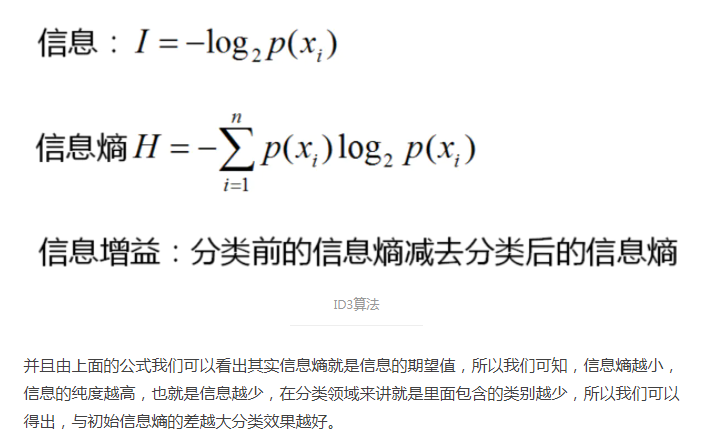
信息熵就是信息的期望值,所以我们可知,信息熵越小,信息的纯度越高,也就是信息越少,在分类领域来讲就是里面包含的类别越少,
1.信息熵
就是信息的期望值,所以我们可知,信息熵越小,信息的纯度越高,也就是信息越少,在分类领域来讲就是里面包含的类别越少,所以我们可以得出,与初始信息熵的差越大分类效果越好。
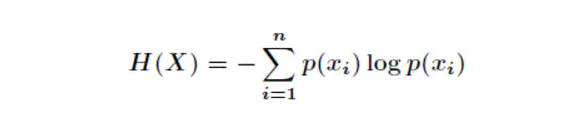
2.信息增益 (Info Gain)
信息增益=分类前的信息熵-分类后的信息熵(大-小)
gain()=info before Split()–info after Split()
3.信息增益率(Info Gain Ratio)
Gain-ratio=(分类前的信息熵-分类后的信息熵)/分类前的信息熵
Gain-ratio=Gain(A)/I
4.基尼系数
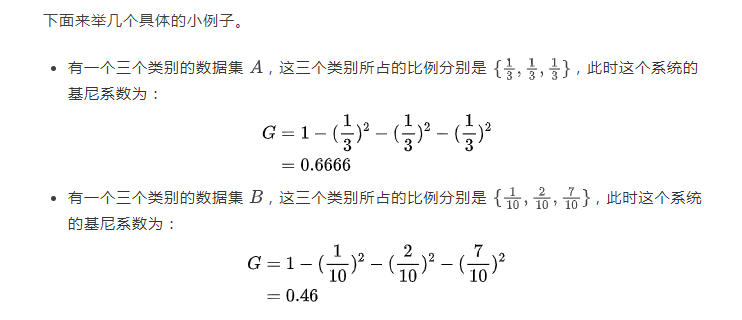
现在可以比较两组数据的基尼系数,数据集 的基尼系数要比数据集 B的基尼系数大。
「基尼系数越大说明系统不确定性越高(或越随机),基尼系数越小说明系统的不确定性越高(或越确定)。」
三.机器学习评价指标
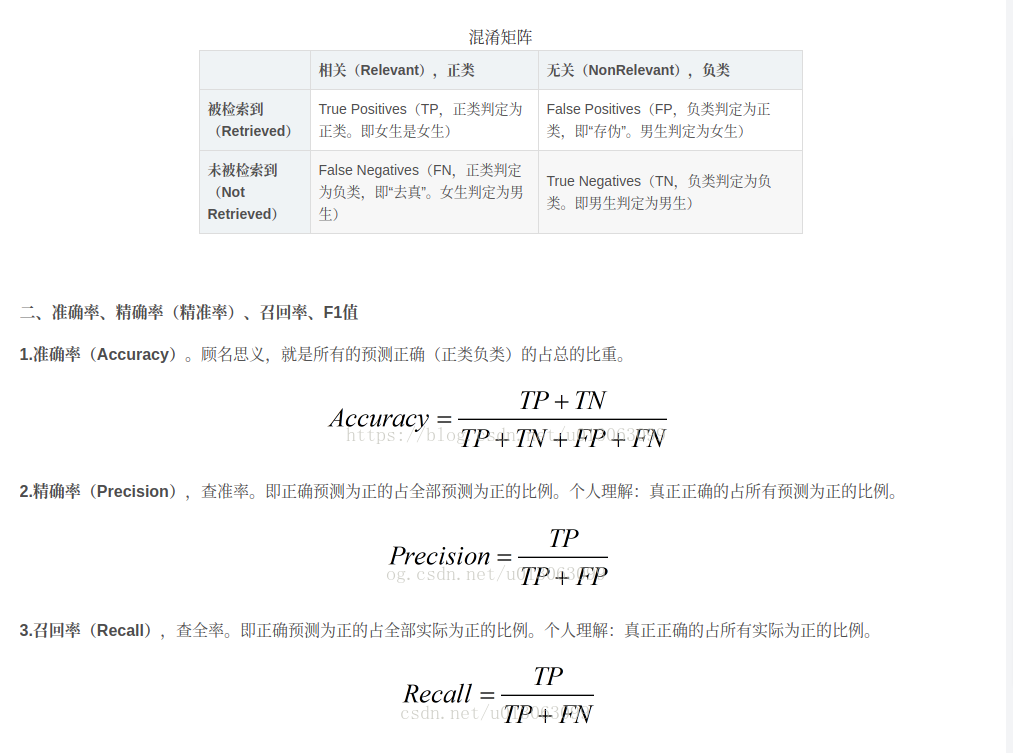
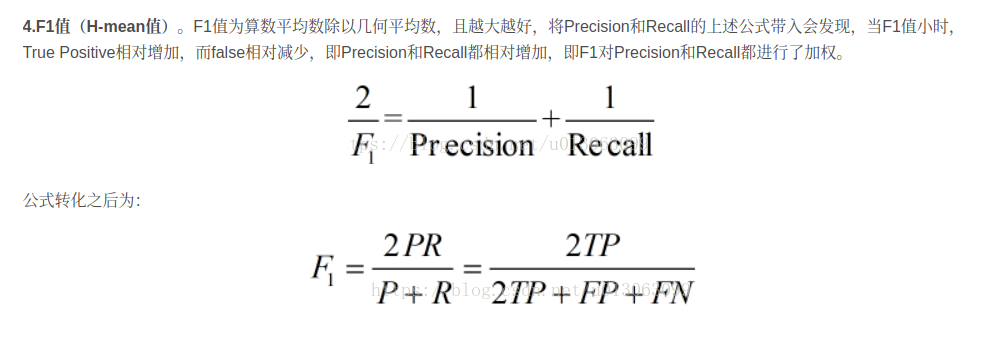
1、准确率、精确率(精准率)、召回率、F1值
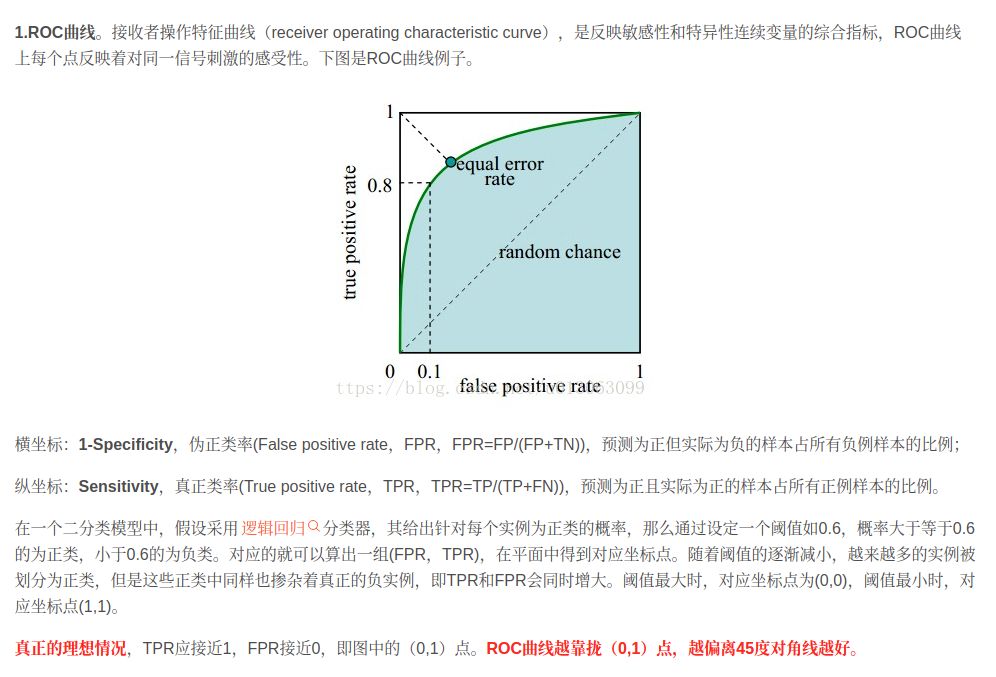
2.ROC曲线
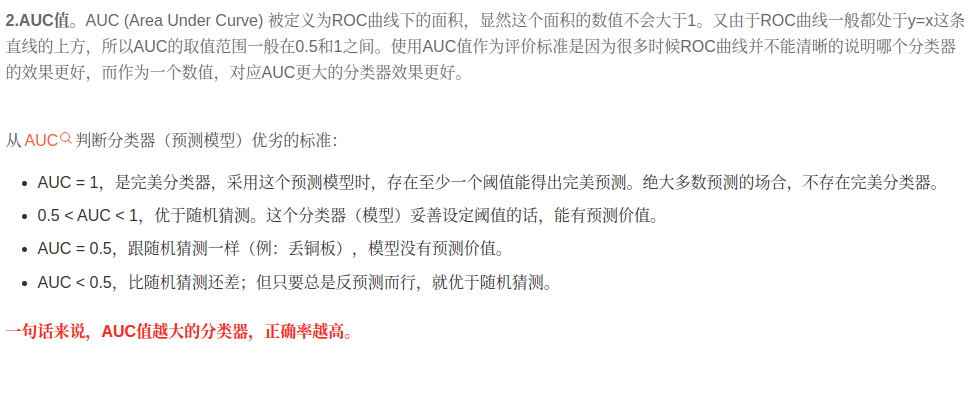
3.AUC 值
更多推荐


 10
 0
- 0


 已为社区贡献3条内容

所有评论(0)