
(0基础/入门)机器学习/深度学习入门必备专业词
总结了一些基础的定义,希望可以帮助到ai的初学者。
-
人工智能:人工智能是通过机器来模拟人类认知能力的技术
-
机器学习:当代的人工智能普遍通过学习来获得进行预测和判断的能力。这样的方法被称为机器学习,它已经成为人工智能的主流方法。
从数据中学习,机器学习分为监督学习、无监督学习和半监督学习
在行动中学习,被称为强化学习
-
向量(vector):数字的个数称为向量的维数(dimension) 例如(1,3,5)的维数为3
-
内积:两个具有相同维数的向量做内积,就是它们的每个数字对应相乘并求和
(1,3)·(2,4)=1x2+3x4=14
-
特征:可以对事物的某些方面的特点进行刻画的数字或者属性
-
目标检测大概流程:输入图片->特征提取->分类器->识别图中物体
-
特征向量(feature vector):把描述一个事物的特征数值都组织在一起
比如化的花瓣长度为1.1cm,宽度为0.1cm,那么该花的特征就可以用(1.1,0.1)来表示
-
特征点(feature point): 将特征向量表示在直角坐标系中,比如(1.1,0.1)可以看成坐标系中的一个点
-
特征空间(feature space):特征点构成的空间
-
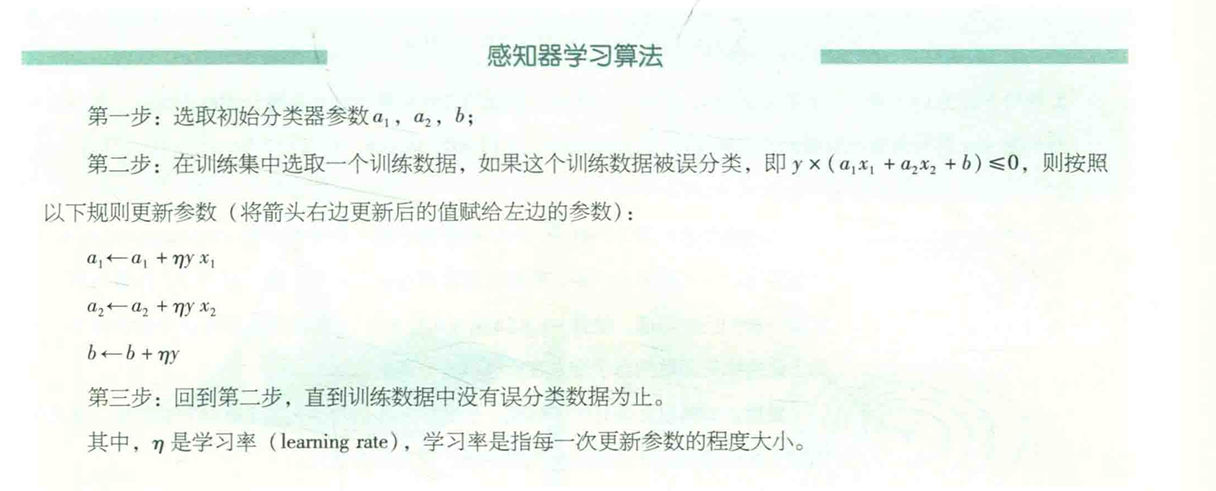
两种常见的训练线性分类器的算法--感知器和支持向量机,它们提供了两种利用训练数据自动寻找参数的方法。
-
感知器(perception):
-
损失函数(loss function):在训练过程中用来度量分类器输出错误程度的数学化表示。
预测错误程度越大,损失函数的取值就越大
-
optimization(优化):就是调整分类器的参数,使得损失函数最小的过程
-
分类间隔(classification margin):两个类别中离分类直线最近的点到直线的距离和
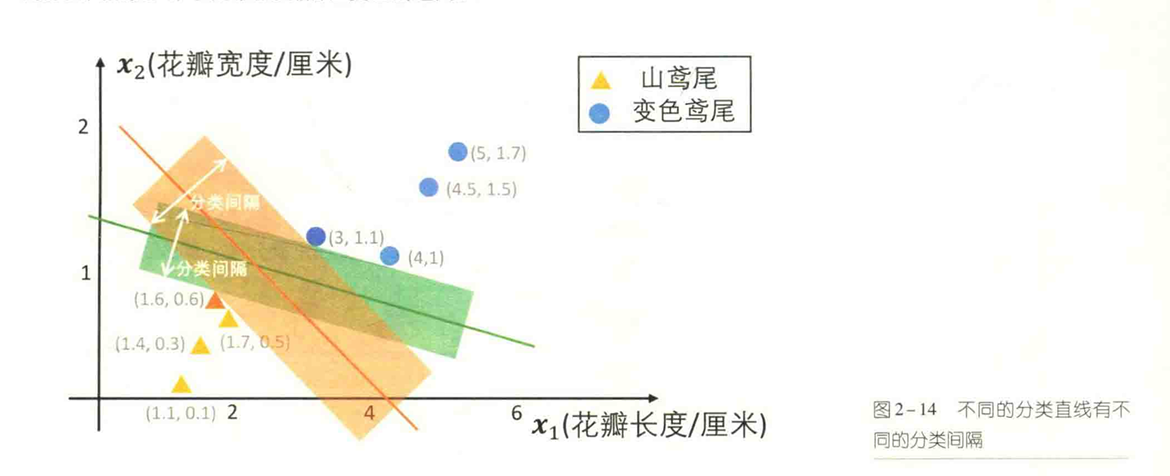
一个点距离分类直线越远,分类预测的可信程度越高
从图中看到,橙色直线的阴影区域更宽,对应的分类间隔更大,其预测的确信程度也会更高。
-
支持向量机(support vector machine,SVM)也叫线性支持向量机,在特征空间上分类间隔最大的分类器,它与感知器一样,是对两个类别进行分类
-
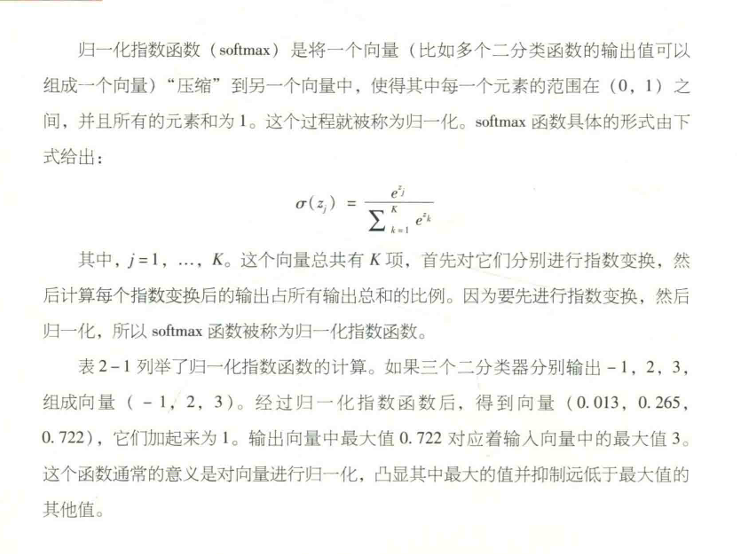
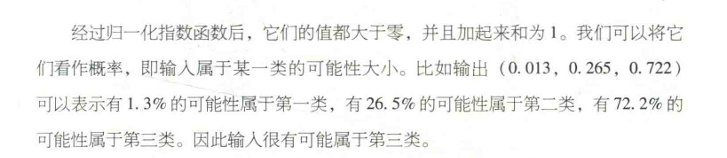
归一化指数函数(softmax):将一个向量“压缩”到另一个向量中,使得其中每一个元素的范围在(0,1)之间,并且元素和为1
-
计算机眼中的图像
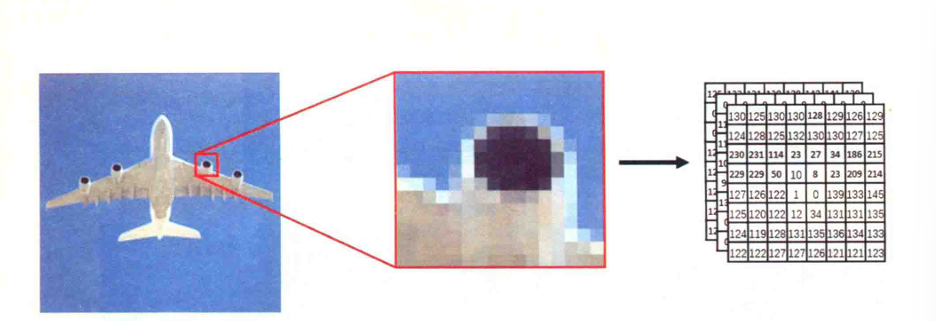
图像表示为一个由数字组成的矩形阵列,小格子我们称为像素(pixel),而格子的行数和列数统称为分辨率(resolution)。反过来,如果给出一个数字组成的矩阵,我们将矩阵中的每个数值转换成为对应的颜色,并在电脑屏幕上显示出来,就可以复现这张图像。
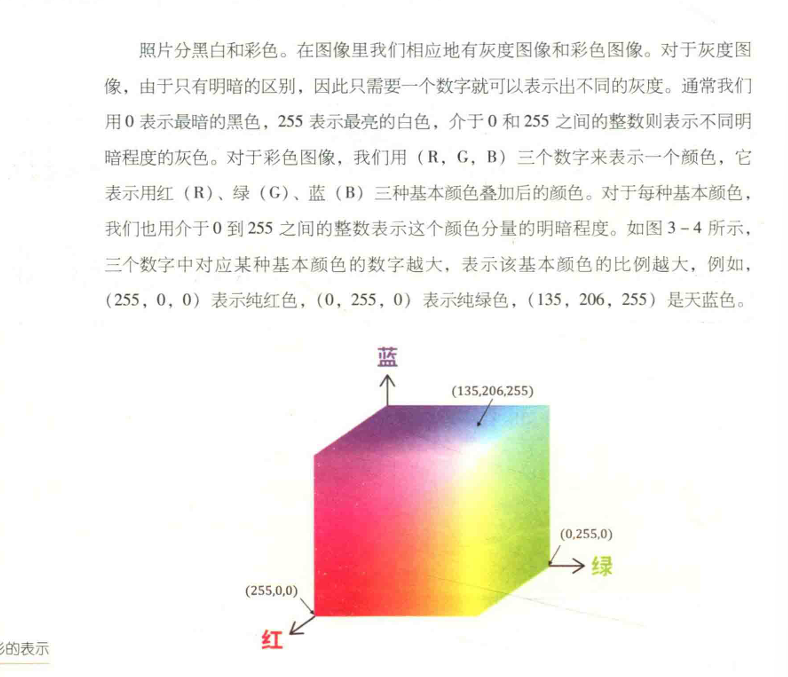
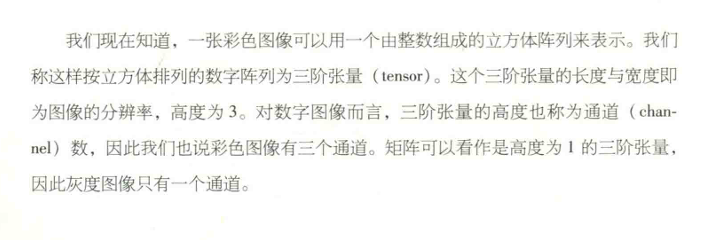
矩阵可以堪称二维也可以堪看成三维 看成三维:m×n×1 (高为1)
更多推荐



 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)