
【大数据系列】Flink两阶段提交协议详解
flink端到端数据一致性保障
官网原文:https://flink.apache.org/2018/02/28/an-overview-of-end-to-end-exactly-once-processing-in-apache-flink-with-apache-kafka-too/
apache flink 1.4.0 2017年12月发布。引入两阶段提交协议并提取两阶段提交协议的通用逻辑,并支持flink以及一系列数据源和接收器构建端到端一次应用程序。用户只需要实现少量的方法可以实现端到端的精确一次语义。
TwoPhaseCommitSinkFunction抽象类。
精确一次处理语义概念
“精确一次语句”,意思是每次传入的事件只影响一次最终结果。即使机器或者软件故障,也没有重复数据、没有未处理的数据。
即使在发生各种故障(如进程崩溃、机器宕机、网络中断)的情况下,流处理应用程序中的每一条输入消息(或事件)只会被处理一次,且只会对输出结果产生一次影响。
- 不丢:数据不会因为系统故障而丢失
- 不重:数据不会因为重试机制而被重复处理
一致性保障语义
- 至多一次:每条消息可能被处理零次或者1次,如果处理失败,消息直接丢弃,不会重试。
问题:可能丢失数据,对于数据有要求的场景是无法接受这种语义
- 至少一次:每条消息可能被处理1次或多次,如果处理失败,会重试,直到成功为止
问题:可能产生重复数据,对数据有精确一次性要求的,该语义不支持
精确一次语句就是为了解决以上两种语句而产生的,保证数据不丢失、数据不重复。
实现精确一次语义关键技术
现代流处理引擎通常通过两种主要技术实现”精确一次语义“
- 分布式快照/状态检查点(Flink)
核心思想:定期为整改应用程序的状态创建快照,将快照持久化到可靠的后端存储(HDFS、S3、Rocks),快照包括数据源读取的记录、程序的状态(状态值等)。
当发生故障时,程序会找到最近一次最完整的快照,将整个应用程序的状态回滚到对应的时间点,数据源也从对应的位置消费数据。
这相当于给整个应用程序做了一次“存档”。故障发生后,直接“读档”重来,从故障点之后的所有操作(包括计算和输出)都被撤销并重新执行。这样就保证了状态和输出的精确一次
- 幂等性写入
核心思想:设计输出操作,使得多次执行同一个操作与只执行一次产生的结果完全相同
实现方式:通常为每个输出消息分配一个唯一的ID(如主键)。当向外部系统(如数据库)写入时,如果发现该ID已经存在,则执行更新操作而不是插入,或者直接忽略重复的写入。
适用场景:非常适合输出到支持主键约束的数据库(如MySQL、PostgreSQL)或支持幂等生产的消息队列(如Kafka启用enable.idempotence=true)
- 两阶段提交协议(结合Flink)
这种方式比较重量级但比较通用的方法,通常用于保证输出端Sink的精确一次。
核心思想:将写入操作分为两个阶段,与处理引擎的检查点周期协调。
- 预提交阶段:当Flink开始创建检查点时,会通知所有Sink开始“预提交”事务。Sink将数据写入,但不会最终提交(例如,在Kafka中,数据对消费者不可见)
- 提交阶段:只有当所有算子的检查点都成功完成,Flink的JobManager才会向所有Sink发出“提交”指令。此时,Sink才正式提交事务,使数据对外可见
注意:如果任何一个环节在提交前失败,所有Sink都会回滚这个未完成的事务,确保输出端没有部分写入的数据。这保证了输出端与内部状态的一致性。
精确一次语句的优势在于提供最强的一致性保证,适合数据准确性极高的场景(金融、计费),劣势在于资源消耗和数据延迟,因此在选择处理语义时,需要根据业务场景在”准确性“和”性能/延迟“做出平衡,对于可以接受数据重复和数据丢失的场景选择至少一次和至多一次。
Flink端到端保证精确一次两阶段提交协议
这里参考flink官网介绍两阶段提交协议。利用flink的检查点机制以及kafka支持事务提交和回滚来进行说明。
利用读取和写入kafka分布式消息队列的示例中启动端到端的精确一次语义。kafka是比较大众的消息传递系统,因kafka0.11版本添加了对事务的支持,可以从kafka接收数据和向kafka写入数据时在应用程序中提供端到端的精确一次语义。
提取声明,flink对端到端的精确一次语义不仅是支持kafka,可以与任务提供必要协调机制的源/接收器一起使用(比如mysql、pg等)。
任务算子状态讲解
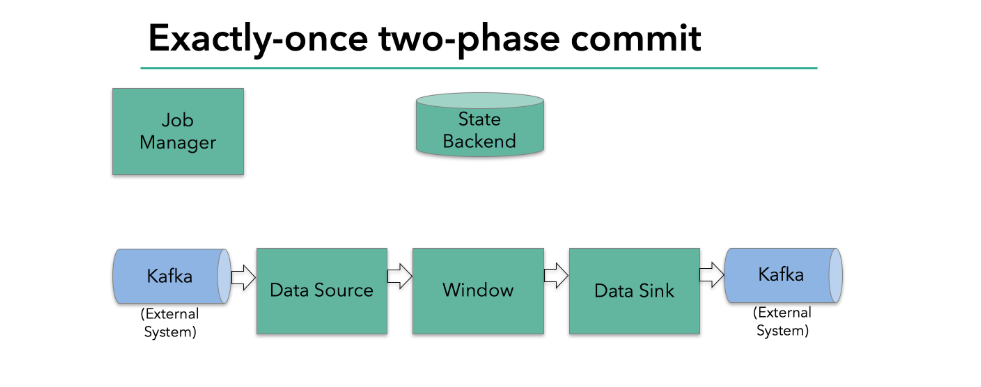
JobManager:监控该应用程序算子执行状态、检查点触发时发生barrier标记到流中等。
state Backend:状态后端,用于存储算子状态相关的信息
Datasource:源(大数据一般用kafka)
Window:窗口计算(具体的逻辑计算)
Datasink:数据接收器,用于将流中的数据写入目标系统
为了使数据接收器提供精确一次语义的保证,必须在事务的范围内将所有数据写入kafka。提交一个检查点范围内的整体数据,确保发生故障时可以进行回滚。
在分布式的场景下,数据接收器与应用程序的并发数量有关系,那么在进行事务提交时,需要保证所有并行的数据接收器提交的结果一致,Flink使用两阶段提交协议及其预提交的方式进行实现。
预提交阶段
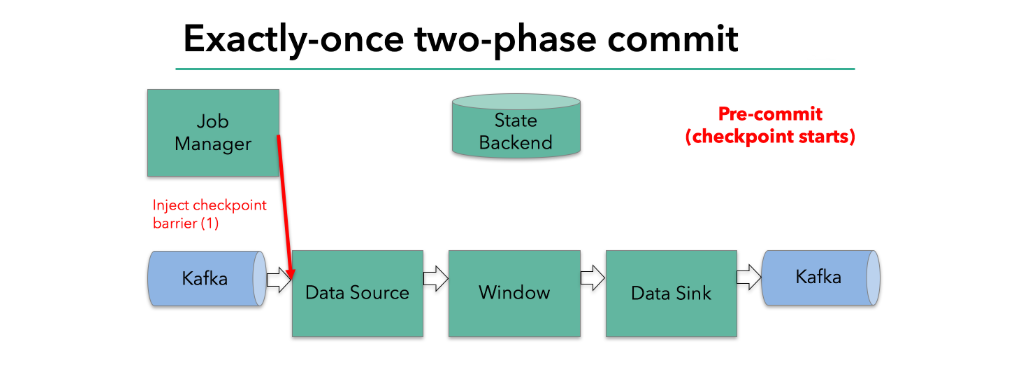
检查点的开始代表两阶段提交协议的”预提交阶段“。当检查点启动时,JobManger会将第一个barrier(检查点屏障将数据流中的记录分开到进入当前检查点的集合和进入下一个检查点的集合)推送到数据流中。
barrier随着数据在operator之间传递。barrier的传递会伴随这状态后端记录operator的快照。例如数据源存储消费的偏移量offsets,完成操作后将barrier传递给聚合窗口算子,依次记录状态。
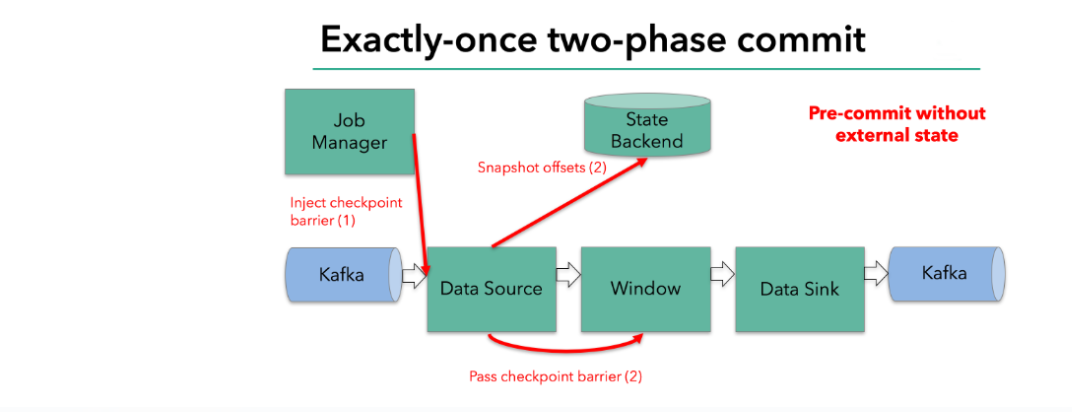
当operator只有内部状态时,状态信息由flink的后端进行存储和管理,在检查点完成之前只需要更新状态的值即可,但是当opeartor具体有外部状态时,就需要用不同的方式处理此状态。外部系统通常是写入外部系统也就是数据接收器opeartor,在这种业务场景需要保证精确一次语义,就需要外部系统必须为两阶段提交协议集成的事务提供支持。
示例中数据接收器与外部系统kafka存在交互,这里需要处理外部系统的状态,在预提交阶段,除了将数据接收器的状态写入状态后端,还必须预提交外部事务。
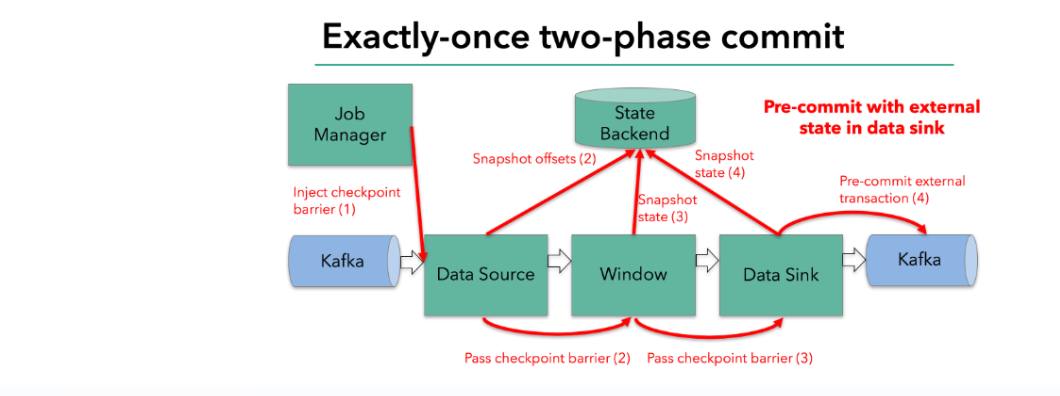
当检查点barrier通过所有operator并完成快照状态保存成功回调后,预提交阶段结束。此时,检查点成功,由整个应用程序的状态组成,包括预提交的外部状态。如果发生故障,我们将从此检查点重新初始化应用程序。
提交阶段
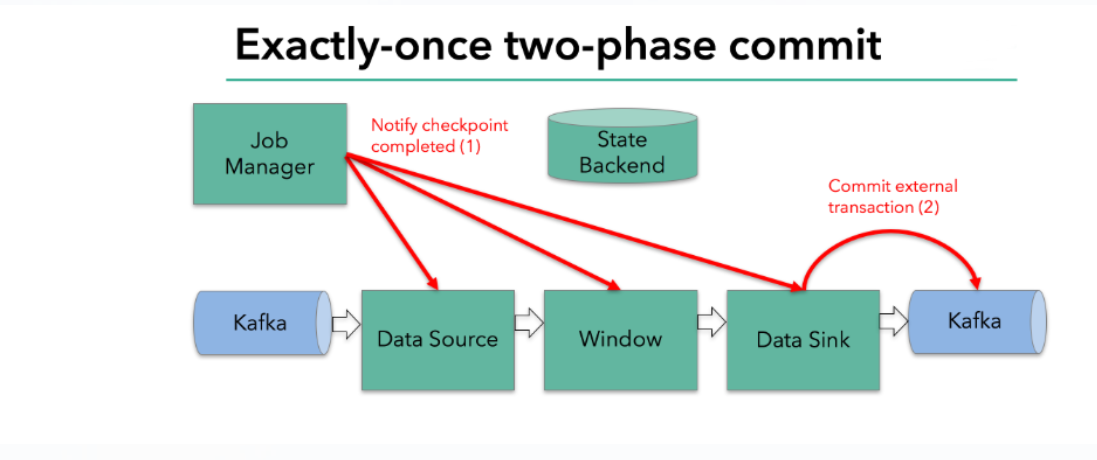
当预提交阶段完成后,jobmanager为应用程序发出检查点执行完成回调。窗口算子和数据源没有外部状态,因此在提交阶段不会有任务操作,数据接收器确实具有外部状态,并使用外部写入提交事务。
从预提交到提交阶段可以看出,预提交阶段所有的operator接收到barrier后触发状态快照保存并传递barrier到下一个opertor,所有operator都完成状态快照保证以及外部状态处理后,预提交阶段结束。提交阶段由jobmanager回调检查点执行完成情况,来确定是否提交外部事务,释放外部状态占用的资源,如果没有外部状态的operator,在提交阶段不需要做任何操作。
- 一旦所以opertor都完成了预提交阶段,都会发生一个正式提交(commit)
- 如果其中一个opertor在预提交阶段失败,所有的提交都会中止,应用程序将回滚到上一个成功的检查点
- 预提交成功后,必须保证提交最终成功。应用程序operator和外部系统都需要保证,如果提交失败,应用程序将会失败,根据用户配置的重试策略重新启动并尝试下一次提交。
最终的目的是:要么数据提交成功,要么数据提交失败(重试进行下一次提交)
Flink两阶段提交实现
Flink将两阶段提交协议中的通用逻辑抽象为了一个类——TwoPhaseCommitSinkFunction。
我们在实现端到端exactly-once的应用程序时,只需实现这个类的4个方法即可(以文件为例说明):
- beginTransaction:开始事务时,会在目标文件系统上的临时目录中创建一个临时文件,之后将处理数据写入该文件。
- preCommit:在预提交时,我们会刷新文件,关闭它并不再写入数据。我们还将为下一个Checkpoint的写操作启动一个新事务。
- commit:在提交事务时,我们自动将预提交的文件移动到实际的目标目录。
- abort:中止时,将临时文件删除。
如果出现任何故障,Flink将应用程序的状态恢复到最近一次成功的Checkpoint。如果故障发生在预提交成功之后,但还没来得及通知JobManager之前,在这种情况下,Flink会将operator恢复到已经预提交但尚未提交的状态。
实战:FLink写Doris实现两阶段提交
示例版本:flink1.13.6 doris2.0.3
以Doris外部系统为例,自定义两阶段提交实现数据精确一次。
doris建表
CREATE TABLE test.my_table ( `fd` varchar(256) NULL )
    ENGINE=OLAP DUPLICATE KEY(`fd`) COMMENT 'OLAP' DISTRIBUTED BY HASH(`fd`) BUCKETS 5
    PROPERTIES (
    "replication_allocation" = "tag.location.default: 1",
    "storage_format" = "V2");
自定义TwoPhaseCommitSinkFunction类
如果开源的依赖没有明确提供对数据库的两阶段提交协议实现,就需要自定义类继承TwoPhaseCommitSinkFunction抽象类实现具体的方法。
- 无参构造器,初始化变量和指定事务上下文对象的类型和flink上下文对象的类型(没有指定Void即可)
- beginTransaction:在Flink启动或上一个事务结束后,需要开始一个新的事务时
- invoke:处理流数据,调用事务上下文对象将数据写入外部系统,对于外部系统来说,不同事务之间的数据是不可见的。
- preCommit:在Flink的检查点快照完成之前(即所有Operator的snapshotState方法被调用之前),预提交事务只是刷新数据,但并不真正提交事务。
- commit:在Flink的JobManager成功收到所有Operator的检查点快照之后。正式提交事务。此时才会真正调用 commit
- abort:如果事务在 preCommit 阶段失败,或者Flink检查点最终失败,回滚事务,rollback。
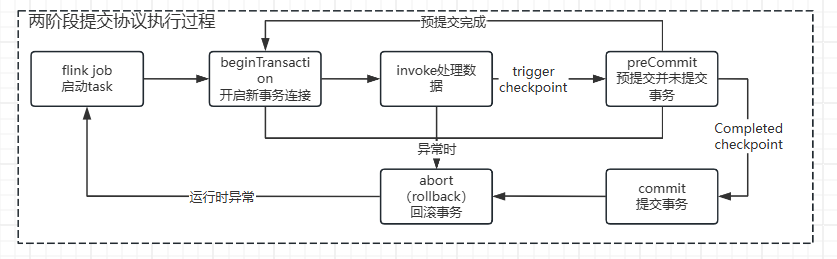
具体代码如下:
/**
 * Doris 二阶段提交 Sink
 * 该类实现了 Flink 的二阶段提交 Sink 函数,用于将数据批量写入 Doris 数据库,
 * 通过二阶段提交协议确保数据的一致性和精确一次语义。
 * 数据输入类型  事务上下文类型  上下文类型
 */
public class DorisBatchTwoPhaseCommitSink
        extends TwoPhaseCommitSinkFunction<String, DorisTransaction, Void> {
    private static final Logger log = LoggerFactory.getLogger(DorisBatchTwoPhaseCommitSink.class);
    private final String jdbcUrl;
    private final String username;
    private final String password;
    private final String tableName;
    private final int batchSize;

    private transient ListState<DorisTransaction> checkpointedState;

    /**
     * 构造 Doris 批量二阶段提交 Sink 实例
     *
     * @param jdbcUrl   Doris 数据库 JDBC 连接地址
     * @param username  数据库用户名
     * @param password  数据库密码
     * @param tableName 目标表名
     * @param batchSize 批处理大小
     * @param env       Flink 执行环境,用于创建序列化器
     */

    public DorisBatchTwoPhaseCommitSink(String jdbcUrl, String username,
                                        String password, String tableName, int batchSize,
                                        StreamExecutionEnvironment env) {


        //需要显示指定事务上下文类型
    super(TypeInformation.of(DorisTransaction.class).createSerializer(env.getConfig()),
      Types.VOID.createSerializer(env.getConfig()));


        this.jdbcUrl = jdbcUrl;
        this.username = username;
        this.password = password;
        this.tableName = tableName;
        this.batchSize = batchSize;
    }

    /**
     * 打开 Sink 连接,初始化操作
     *
     * @param parameters 配置参数
     * @throws Exception 初始化异常
     */

    @Override
    public void open(Configuration parameters) throws Exception {
        super.open(parameters);
        // 注册 Doris JDBC 驱动
        Class.forName("com.mysql.jdbc.Driver");
    }

    /**
     * 开始事务 - 创建事务上下文
     * 建立数据库连接并设置手动提交模式
     *
     * @return DorisTransaction 事务上下文对象
     * @throws Exception 数据库连接异常
     */

    @Override
    protected DorisTransaction beginTransaction() throws Exception {
        log.info("开始新事务");
        Connection connection = DriverManager.getConnection(jdbcUrl, username, password);
        connection.setAutoCommit(false);
        return new DorisTransaction(connection, new ArrayList<>(), tableName, batchSize);
    }

    /**
     * 执行写入操作 - 批量缓存数据
     * 将数据添加到事务缓冲区,达到批处理大小时执行批量写入
     *
     * @param transaction 当前事务上下文
     * @param value       输入数据记录
     * @param context     Sink 上下文
     * @throws Exception 数据处理异常
     */

    @Override
    protected void invoke(DorisTransaction transaction, String value, Context context) throws Exception {
        transaction.addRecord(value);

        // 如果达到批处理大小,执行批量写入
        if (transaction.shouldFlush()) {
            transaction.executeBatch();
        }
    }

    /**
     * 预提交阶段 - 执行批量写入但不提交
     * 确保所有缓冲数据都写入数据库,为正式提交做准备
     *
     * @param transaction 当前事务上下文
     * @throws Exception 预提交异常
     */

    @Override
    protected void preCommit(DorisTransaction transaction) throws Exception {
        log.info("预提交事务,当前批次大小: {}", transaction.getRecordCount());
        // 确保所有数据都写入
        if (transaction.getRecordCount() > 0) {
            transaction.executeBatch();
        }
    }

    /**
     * 提交事务
     * 正式提交数据库事务,确保数据持久化
     *
     * @param transaction 当前事务上下文
     */

    @Override
    protected void commit(DorisTransaction transaction) {
        try {
            log.info("提交事务");
            transaction.commit();
        } catch (SQLException e) {
            log.error("提交事务失败", e);
            throw new RuntimeException("提交事务失败", e);
        } finally {
            transaction.close();
        }
    }

    /**
     * 中止事务
     * 回滚数据库事务,用于处理异常情况
     *
     * @param transaction 当前事务上下文
     */

    @Override
    protected void abort(DorisTransaction transaction) {
        try {
            log.warn("中止事务");
            transaction.rollback();
        } catch (SQLException e) {
            log.error("中止事务失败", e);
        } finally {
            transaction.close();
        }
    }

    /**
     * 初始化状态
     * 用于恢复检查点状态,确保故障恢复后的一致性
     *
     * @param context 函数初始化上下文
     * @throws Exception 状态初始化异常
     */

    @Override
    public void initializeState(FunctionInitializationContext context) throws Exception {
        super.initializeState(context);

        ListStateDescriptor<DorisTransaction> descriptor =
                new ListStateDescriptor<>("doris-transaction-state",
                        TypeInformation.of(new TypeHint<DorisTransaction>() {
                        }));
        checkpointedState = context.getOperatorStateStore().getListState(descriptor);
    }

    @Override
    public void snapshotState(FunctionSnapshotContext context) throws Exception {
        super.snapshotState(context);
    }
}
自定义事务上下文对象
什么是事务上下文对象?
事务上下文对象是应用程序与外部系统进行事务的核心载体。
作用:
- 封装事务生命周期:它提供了方法,让 Flink 在特定的时间点去驱动这个事务的各个阶段。
- 实现两阶段提交协议:它直接对应着两阶段提交协议中的“预提交”和“提交”两个阶段。
/**
 * Doris 事务上下文
 */
public class DorisTransaction implements Serializable {
    private static final long serialVersionUID = 1L;
    private final transient Connection connection;
    private final List<String> records;
    private final String tableName;
    private final int batchSize;
    private transient PreparedStatement preparedStatement;
    private int recordCount;

    private  static  final Logger log= LoggerFactory.getLogger(DorisTransaction.class);
    public DorisTransaction() {
        // 用于反序列化时的构造函数
        this.connection = null;
        this.records = new ArrayList<>();
        this.tableName = null;
        this.batchSize = 0;
        this.recordCount = 0;
    }


    public DorisTransaction(Connection connection, List<String> records,
                            String tableName, int batchSize) {
        this.connection = connection;
        this.records = new ArrayList<>(records);
        this.tableName = tableName;
        this.batchSize = batchSize;
        this.recordCount = 0;
        initializePreparedStatement();
    }

    /**
     * 初始化预编译SQL语句
     * 根据表名构建 INSERT 语句并创建 PreparedStatement 对象
     *
     * @throws RuntimeException 当SQL执行异常时抛出运行时异常
     */
    private void initializePreparedStatement() {
        try {
            // 根据实际表结构调整 SQL
            String sql = "INSERT INTO " + tableName + "  VALUES (?)";
            this.preparedStatement = connection.prepareStatement(sql);
        } catch (SQLException e) {
            throw new RuntimeException("初始化 PreparedStatement 失败", e);
        }
    }

    /**
     * 添加一条记录到记录集合中
     *
     * @param record 要添加的记录字符串
     */

    public void addRecord(String record) {
        records.add(record);
        recordCount++;
    }

    /**
     * 判断是否达到批处理阈值需要刷新
     *
     * @return true-需要刷新,false-不需要刷新
     */

    public boolean shouldFlush() {
        return recordCount >= batchSize;
    }

    /**
     * 执行批量写入操作
     * 将缓冲区中的数据通过 PreparedStatement 批量插入到 Doris 表中
     *
     * @throws SQLException SQL执行异常
     */

    public void executeBatch() throws SQLException {
        if (records.isEmpty()) {
            return;
        }

        for (String record : records) {
            // 根据实际数据结构解析字段
            preparedStatement.setString(1, record);
            preparedStatement.addBatch();
        }

        int[] results = preparedStatement.executeBatch();
        //这里执行commit会把满足批次提交的数据写入Doris,如果想完全根据checkpoint提交可以把这里注释掉
        connection.commit(); // 这里先提交批次,最终事务由二阶段提交控制

        log.info("执行批量写入,影响行数: {}", results.length);

        // 清空当前批次
        records.clear();
        recordCount = 0;
        preparedStatement.clearBatch();
    }

    /**
     * 提交事务
     * 提交当前数据库连接中的所有未提交操作
     *
     * @throws SQLException SQL执行异常
     */

    public void commit() throws SQLException {
        // 提交最终事务
        if (!connection.getAutoCommit()) {
//            connection.commit();
        }
    }

    /**
     * 回滚事务
     * 回滚当前数据库连接中的所有未提交操作
     *
     * @throws SQLException SQL执行异常
     */

    public void rollback() throws SQLException {
        if (!connection.getAutoCommit()) {
            connection.rollback();
        }
    }

    /**
     * 关闭资源
     * 释放 PreparedStatement 和 Connection 资源
     */

    /**
     * 关闭连接也会提交事务
     */
    public void close() {
        try {
            if (preparedStatement != null && !preparedStatement.isClosed()) {
                preparedStatement.close();
            }
            if (connection != null && !connection.isClosed()) {
                connection.close();
            }
        } catch (SQLException e) {
            log.error("关闭连接失败", e);
        }
    }

    /**
     * 获取当前记录计数
     *
     * @return 当前缓冲区中的记录数量
     */

    public int getRecordCount() {
        return recordCount;
    }
    /**
     * 获取数据记录列表副本(用于状态恢复的序列化)
     *
     * @return 数据记录列表的副本
     */
    public List<String> getRecords() {
        return new ArrayList<>(records);
    }

    //序列化
    private void writeObject(ObjectOutputStream out) throws IOException {
        out.defaultWriteObject();
        // 只序列化可序列化的字段
    }
    private void readObject(ObjectInputStream in) throws IOException, ClassNotFoundException {
        in.defaultReadObject();
        // 反序列化后,transient 字段会自动设为 null
    }
}
flink日志解释
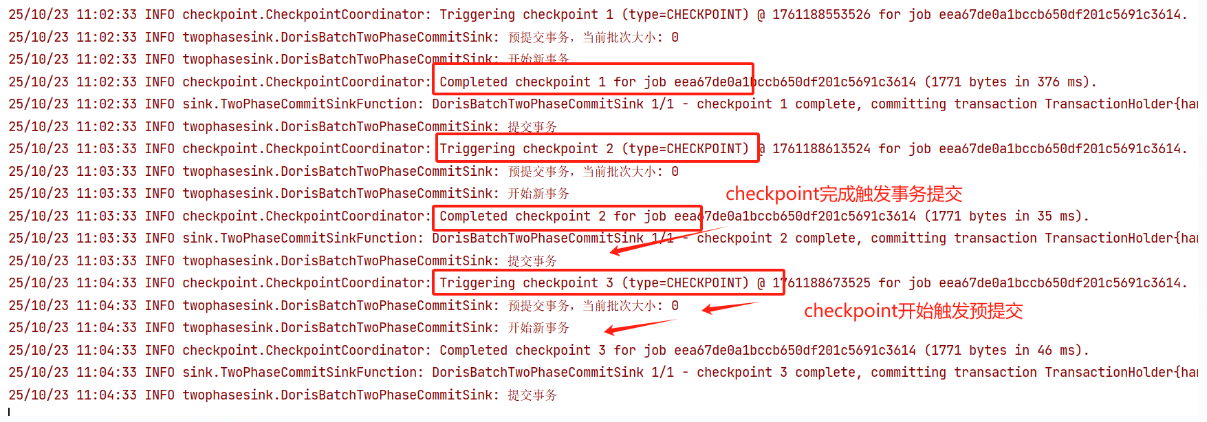
从日志上来看,triggering checkpoint触发预提交的动作,也就是执行executeBatch并没进行commit,紧接着创建下一个checkpoint周期的连接,等待checkpoint确认完成后,最终再执行commit操作提交事务。
遇到的问题点
- 事务上下文序列化问题
部分日志如下:
java.lang.StackOverflowError at java.util.HashMap.hash(HashMap.java:339)
at java.util.HashMap.get(HashMap.java:557)
at com.esotericsoftware.kryo.Generics.getConcreteClass(Generics.java:43)
at com.esotericsoftware.kryo.Generics.
原因:从日志看出 StackOverflowError 是由于 Kryo 序列化框架在尝试序列化 对象时陷入了无限递归。从堆栈信息可以看出,问题出现在 Kryo 处理泛型类型时的 getConcreteClass 方法中。
解决方式:
a.如果自定义类中包含了不可序列化的字段需要标记为transient
b.添加无参构造器支持反序列化
c.添加自定义序列化方法
private void writeObject(ObjectOutputStream out) throws IOException {
    out.defaultWriteObject();
    // 只序列化可序列化的字段
}

private void readObject(ObjectInputStream in) throws IOException, ClassNotFoundException {
    in.defaultReadObject();
    // 反序列化后,transient 字段会自动设为 null
}
d.实现Serializable接口
关键是要确保所有不可序列化的字段都被标记为 transient,这样Kryo 在序列化时就会跳过这些字段。
- 继承TwoPhaseCommitSinkFunction后构造方法需要指定事务上下文类型
    //需要显示指定事务上下文类型
super(TypeInformation.of(DorisTransaction.class).createSerializer(env.getConfig()),
  Types.VOID.createSerializer(env.getConfig()));
更多推荐



 28
 0
- 0


 已为社区贡献9条内容

所有评论(0)