
云计算数据存储安全挑战与解决方案
云计算中的数据存储安全服务:挑战与解决方案
1 引言
云计算可以被定义为一种计算模式,在这种模式下,可动态扩展的资源(即存储、网络和计算资源)通过互联网按需以服务的形式提供。云计算的服务交付模型是指云计算所提供的服务集合,通常称为SPI模型,即软件即服务(SaaS)、平台即服务(PaaS)和基础设施即服务(IaaS)。在SaaS模型中,云服务提供商(CSPs)在云中安装并运行应用软件,云用户则可以通过云客户端访问这些软件。用户无需购买软件,而是租用使用。
通过订阅或按使用付费模式,例如 Google Docs [1]。SaaS 客户不管理应用程序运行所依赖的云基础设施和平台。在 PaaS 模型中,云服务提供商提供一个计算平台,包括操作系统、编程语言执行环境、Web服务器和数据库。应用程序开发者随后可以在云平台上开发和运行其软件解决方案。借助 PaaS,开发者通常无需在计算机上安装任何工具即可构建Web应用程序,并且无需具备专业的系统管理技能即可部署这些应用程序 [2]。PaaS 提供商的示例包括 Windows Azure [3]和 Google App Engine [4]。IaaS 模型提供运行应用程序所需的基础设施(即计算能力、网络和存储资源)。此外,它还提供按使用付费的定价模式,并可根据需求扩展服务。IaaS 提供商的示例包括 Amazon EC2[5]和 Terremark [6]。
云服务可根据客户的需求以四种方式进行部署。云部署模型包括:公共云、私有云、社区云和混合云。在公共云(或外部云)中,云基础设施由第三方供应商在一个或多个数据中心托管、运营和管理[2]。网络、计算和存储基础设施与其他组织共享。多个企业可以同时使用所提供的基础设施。用户可以通过互联网从异地服务提供商动态获取资源[7]。在私有云中,云基础设施专用于特定组织,可由该组织自身或第三方服务提供商进行管理。这模拟了在私有网络上实现虚拟化和云计算的概念。在社区云中,基础设施由多个组织共享,用于共同的目标,可由这些组织自身或第三方服务提供商管理,且基础设施位于第三方场所。混合云由两种或多种不同的云部署模型组成,通过标准化技术连接在一起,从而实现数据在它们之间的可移植性。借助混合云,组织可以在公共云中运行非核心应用,同时将核心应用和敏感数据保留在内部的私有云中[2]。
云存储系统(CSS)可被视为由分布式数据中心组成的网络,通常使用虚拟化等云计算技术,并提供某种接口用于存储数据[8]。为了提高可用性,数据可能会在不同位置进行冗余存储。此类基础云存储服务的示例包括亚马逊S3[9]和Rackspace[10]。使用云存储系统(CSS)的一个基本优势是成本效益,数据所有者可以避免昂贵的大型设备采购、基础设施设置、配置、部署以及频繁的维护成本。相反,数据所有者仅需为其实际使用的资源和使用时间付费。弹性也是使用云存储系统(CSS)的关键优势之一,因为存储资源可以根据需要动态分配,而无需人工干预。可扩展性是采用云存储系统(CSS)的另一项优势,因为云存储架构可根据需求横向或纵向扩展,即根据需要添加或移除新节点。此外,云存储系统(CSS)提供了更高的可靠性和可用性,数据所有者可以从任何位置访问其数据。
并且随时随地可用。此外,云服务提供商出于业务连续性和灾难恢复的考虑,使用多个复制站点。
尽管云存储服务具有诸多吸引人的优势,但也给用户外包数据带来了新的、极具挑战性的安全威胁。由于云服务提供商(CSPs)是独立的管理实体,存储在云中的数据的正确性和机密性面临以下风险:首先,由于云基础设施在多个组织之间共享,因此数据完整性仍面临广泛的内部和外部威胁,例如亚马逊EC2等云服务的中断事件 2010[11]。其次,用户不再物理掌控其数据的存储,即数据被远程存储和处理,因此他们可能担心自己的数据会被滥用或被未授权用户访问 [12]。例如,一个不诚实的云服务提供商可能会为了盈利而将企业的机密信息出售给该企业的商业竞争对手。第三,云服务提供商在处理用户外包数据时存在多种不忠诚行为的动机。例如,云服务提供商可能出于经济原因通过删除长期未访问或极少访问的数据来回收存储空间,甚至可能隐瞒数据丢失事件以维护自身声誉 [13]。总而言之,尽管将数据外包到云中在长期大规模存储方面具有经济上的吸引力,但云存储系统中的数据安全仍然是一个突出的问题。云存储系统本身并不能立即为数据的完整性、机密性和可用性提供任何保证。因此,云服务提供商应采用数据安全实践,以确保其客户的数据具备可用性、正确性,并防止未授权访问和泄露。
下载所有数据并在检索时进行检查是验证数据完整性的传统方法,但这会导致高昂的传输成本和繁重的I/O开销。此外,在访问数据时检查数据完整性不足以保证云中所有存储数据的完整性和可用性,因为对于很少被访问的数据无法得到保障。因此,必须拥有能够验证外包数据完整性的存储审计服务,并向数据所有者提供证明,以证实其数据已在云中被正确存储。
基于传统服务器的访问控制方法(如访问控制列表(ACL)[14])无法直接应用于云存储系统,因为数据所有者并不完全信任云服务提供商。此外,在云服务器上共享数据时,传统的加密解决方案也无法直接应用,因为这些方案需要复杂的密钥管理,并在服务器端带来较高的存储开销。而且,数据所有者必须始终在线,以便向新用户传递密钥。因此,迫切需要一种访问控制方法,能够限制和管理对数据的访问,确保外包数据免遭未授权访问和泄露[15]。
本文对云存储审计和访问控制方法进行了广泛的综述。此外,还针对不同的性能标准对这些方法进行了评估。本文的其余部分组织如下:第2节概述了各种云存储审计方法。第3节介绍了云计算中访问控制方法的相关文献。第4节对现有的云计算数据安全方法进行了比较分析。
2 数据存储审计方法
本节首先定义了云计算中数据存储审计方案的系统模型和安全模型。然后,介绍了现有的数据存储审计方法,并将其分为不同类别。
数据存储审计可以被定义为一种使数据所有者能够在不下载数据或明确了解全部数据 [16] 的情况下检查远程数据完整性的方法。任何审计方案的系统模型都包含三个实体,如[17]中所述: 1. 数据所有者:拥有大量数据文件需要存储在云中的实体,可以是个人用户或组织。 2. 云存储服务器(CSS):由云服务提供商(CSP)管理的实体,具有充足的存储空间和计算资源以维护客户数据。 3. 第三方审计员或验证者(TPA):具备专业知识和能力,能够检查存储在云存储服务器(CSS)上数据完整性的实体。
在大多数数据审计方案的安全模型中,审计员被假定为诚实但好奇的。它在整个审计协议过程中会诚实执行操作,但对收到的数据内容存在好奇。因此,在审计协议期间,必须保证数据对审计员是机密且不可见的,而云存储服务器可能是不诚实的,并可能发起以下攻击 [18]: 1. 替换攻击:当服务器已经丢弃了数据块 mi 或数据标签 ti 时,可能会选择另一对有效的、未损坏的数据块和数据标签(mk, tk)来替换被挑战的数据块和数据标签(mi, ti)。 2. 伪造攻击:如果所有者的秘密标签密钥被重复用于不同版本的数据,则服务器可能伪造数据块的数据标签,从而欺骗审计员。 3. 重放攻击:服务器可能利用先前的证明或其他信息生成新的证明,而无需检索所有者的真实数据。
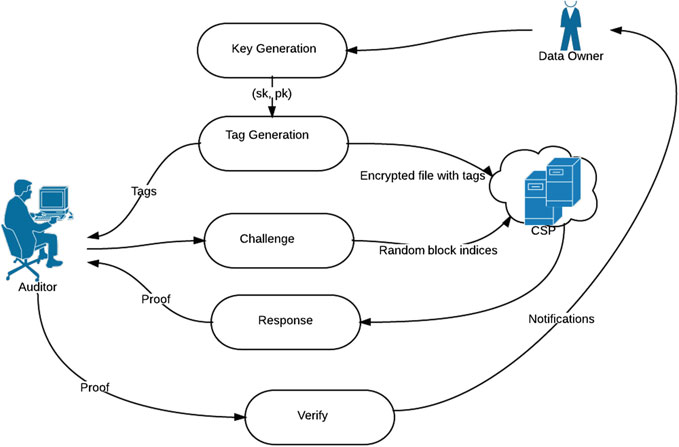
如图1所示,一个数据审计方案应基本包含五个算法:
- 密钥生成:由数据所有者运行。它以安全参数1 λ作为输入,输出一对私有和公共密钥(sk,pk)。 2. 标签生成:由数据所有者运行,用于生成验证元数据,即数据块标签。它以公钥pk、私钥sk和文件块b作为输入,输出可验证的块标签Tb。
现有的数据存储审计方案基本上可以分为两大类:
- 可证明数据持有(PDP)方法:为在不将数据发送给不可信服务器的情况下验证数据完整性,审计员通过从云服务提供商处采样随机数据块集合来验证概率性持有证明[19]。2. 可恢复性证明(PoR)方法:将一组称为哨兵块的随机值检查块嵌入到加密文件中。为了审计数据存储,审计员通过指定哨兵块子集的位置并要求服务器返回相应的哨兵值来向服务器发起挑战[20]。
现有的数据存储审计方法可以根据以下内容进一步分为几类:
i. 审计员/验证者的类型:公共审计或私有审计。ii. 待审计数据的分布:单副本或多副本数据。iii. 数据持久性:静态或动态数据。
2.1 公共审计与私有审计
根据审计模型中审计员的角色,数据存储审计方案可分为两类:私有审计和公共审计[21]。在私有审计中,只有数据所有者可以向云存储服务器发起挑战,以验证其外包数据的正确性[22]。然而,私有审计方案存在两个局限性: (a)它们给数据所有者带来在线负担,需亲自验证数据完整性;(b)数据所有者必须具备强大的计算能力来进行审计。仅支持私有审计的审计方案示例包括[23–26]。在公共审计或第三方审计中[27],,数据所有者能够将审计任务委托给独立第三方审计员(TPA),而无需投入自身的计算资源。然而,公共审计方案应确保TPA不会获取被验证数据的任何私有信息。已有若干基于不同密码学原语提出的、支持公共审计的PDP方案变体,例如 [17, 24, 25, 28],。
2.2 单副本与多副本数据的审计
为了验证云存储中外包数据的完整性,已提出了多种审计方案,这些方案可以分为: i. 单副本数据的审计方案。ii. 多副本数据的审计方案。
i. 单副本数据的审计方案
沙查姆和沃特斯 [29]提出了两种基于同态认证器的快速PoR方案,该同态认证器使存储服务器能够通过聚合各个文件块的认证标签来降低审计的复杂性。第一种方案基于BLS签名,支持公共审计。第二种方案基于伪随机函数,仅支持私有审计,但其响应消息比第一种方案更短,仅为80位。这两种方案均采用里德-所罗门擦除编码方法[30],以支持额外的功能,即允许客户端恢复外包在云中的数据。然而,对于大文件而言,它们的编码与解码速度较慢。
袁和余[31]成功抑制了通信成本与存储成本之间的权衡需求。他们通过结合固定大小多项式承诺、BLS签名和同态线性认证器等技术,提出了一种具有公共审计功能且具有恒定通信成本的可恢复性证明方案。另一方面,他们的数据准备过程需要 (s+3) 次幂运算,其中 s 是块大小。然而,他们的方案不支持数据动态性。
徐和张 [32] 提出了一种新的称为POS的PDP模型。该POS模型在初始化阶段无需模幂运算,并且在验证阶段使用的群幂运算次数更少,例如对于一个1G的文件仅需约102次。POS仅支持对静态数据的私有审计,其通信开销与挑战查询中编码元素的数量呈线性关系。
Ateniese 等人 [33]提出了一种具有两个优势的PDP模型:轻量级和鲁棒性。他们的挑战/响应协议传输少量且常数的数据,从而最小化了网络通信。此外,该模型还包含用于减轻任意数量数据损坏的机制。另一方面,它依赖于里德-所罗门编码方案,其中对n块文件进行编码与解码所需的时间为O(n2)。
曹等人 [34]提出了一种适用于具有并发用户访问的分布式存储系统的公共审计方案。为了高效地恢复任何损坏数据的精确形式,他们采用了精确修复方法 [35],其中新生成的块与先前存储的块相同。因此,无需为修复的数据动态生成验证标签。这减轻了数据所有者的在线负担。然而,他们的方案增加了每个服务器上的存储开销,使用了一个额外的修复服务器来存储原始数据包以及编码数据包,并且不支持数据动态性。
ii. 多副本数据审计方案
巴苏姆和哈桑 [36, 37]提出了两种动态多副本PDP方案:基于树的和基于映射的动态多副本PDP(分别为TB-DMCPDP和MB-DMCPDP)。这些方案利用AES加密方案的扩散特性,防止云服务提供商作弊并维持较少的副本数量。TB-DMCPDP方案基于默克尔哈希树(MHT),而MB-DMCPDP方案则基于映射版本表,以支持动态数据的外包。TB-DMCPDP方案的初始化成本高于MB-DMCPDP方案。另一方面,MB-DMCPDP方案的存储开销与副本数量无关,而TB-DMCPDP方案的存储开销随副本数量线性增长。然而,授权用户需要知道副本数量才能生成原始文件,这可能要求云服务提供商向用户透露其内部结构。
朱等人 [38]提出了一种用于多云存储完整性验证的协作式可证明数据持有方案(CPDP),并提出了两种基本技术:哈希索引层次结构(HIH)和同态可验证响应(HVR)。利用哈希索引层次结构,来自多个云服务提供商的客户端挑战的多个响应可以合并为一个最终响应结果。同态可验证响应支持多云存储环境中的分布式云存储,并实现了一种高效的抗碰撞哈希函数。
王和张 [39]证明了CPDP [38]是不安全的,因为它不满足知识可靠性,即任何恶意的云服务提供商或恶意组织者即使删除了所有存储的数据,也能够通过验证。此外,CPDP不支持数据动态性。
Etemad 和 Kupcu [26]提出了一种分布式复制的 DPDP( DR-DPDP),该方案可在多个服务器上实现数据的透明分布与复制,其中云服务提供商可对客户端隐藏其内部结构。该方案使用基于持久秩的认证跳表,以更高效地处理动态数据操作,如插入、删除和修改。然而, DR-DPDP 存在三个显著缺点:第一,仅支持私有审计;第二,不支持损坏数据的恢复;第三,组织者类似于一个中心实体,可能面临过载并造成瓶颈。
Mukundan 等人 [24]提出了一种动态多副本可证明数据持有方案( DMR-PDP),该方案使用 Paillier 概率加密进行副本区分,从而防止云服务提供商作弊并维护比所支付副本数量更少的副本。DMR-PDP 还支持在云服务器上的数据副本上进行高效的动态操作,如块修改、插入和删除。然而,它仅支持私有审计,并未提供任何安全证明。
陈和Curtmola [25]提出了一种面向基于复制的分布式存储系统的远程数据检查方案,称为RDC-SR。RDC-SR支持服务器端修复,并将最小负载施加于仅需充当修复协调者的数据所有者。在RDC-SR中,每个副本均为原始文件的掩码/加密版本,以实现副本区分。为抵御即时复制攻击(ROTF 攻击),他们使副本创建过程变得更加耗时。然而,RDC-SR存在三个显著局限性:第一,授权用户必须知晓掩码步骤中使用的随机数,才能生成原始文件;第二,它仅支持私有审计;第三,它仅适用于静态数据。
2.3 静态与动态数据审计
考虑到数据持久性,现有的审计方案可以分为:仅支持静态归档数据的审计方案,例如[3, 5, 25];以及支持数据动态性的审计方案,例如插入、删除和修改。为了实现动态操作,现有的数据存储方案采用了不同的认证数据结构,包括:(i) 默克尔哈希树 [40],;(ii) 平衡更新树 [41],;(iii) 跳表 [42– 44];以及 (iv) 映射版本表(索引表)[25, 45],具体说明如下:
i. 默克尔哈希树
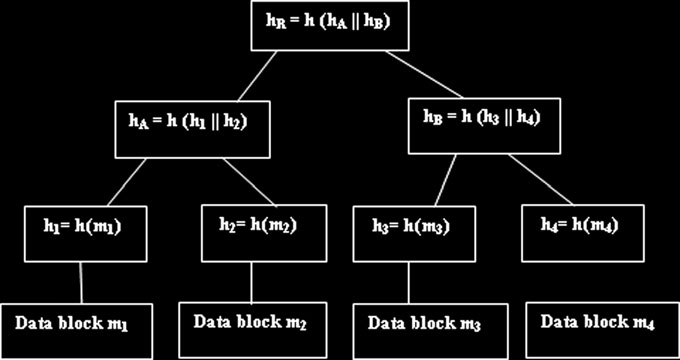
默克尔哈希树(MHT)[40]是一种二叉树结构,用于高效验证数据的完整性。如图2所示,MHT 是一种哈希树,其叶节点为数据块的哈希值。王等人 [46]提出了一种支持完全动态数据操作的公共审计协议,该协议通过调整经典的默克尔哈希树结构以实现块标签认证,从而达到高效数据动态性。他们还能够实现批量审计,即不同用户可以将多个审计任务委托给第三方审计员 (TPA)同时执行。然而,他们的协议未能保护数据隐私,TPA 可能从审计过程中收集的信息推导出用户的数据。此外,该协议在发生数据损坏时不支持数据恢复。
卢等人[47]解决了先前审计协议在签名生成阶段存在的安全问题,该问题允许云服务提供商在验证过程中通过使用来自不同文件的数据块进行欺骗。他们提出了一种基于同态哈希函数和BLS短签名方案的安全公共审计协议,该方案具有公开可验证性并支持数据动态性,同时还能保护隐私。然而,他们的方案存在较高的计算和通信开销。
王等人[48]提出了一种使用随机掩码和同态线性认证器(HLAs)[49]的隐私保护公共审计方案。他们的审计方案还利用默克尔哈希树(MHT)支持数据动态性,并使审计员能够同时高效地对多个用户进行审计。然而,他们的方案容易受到TPA离线猜测攻击。
ii. 平衡更新树
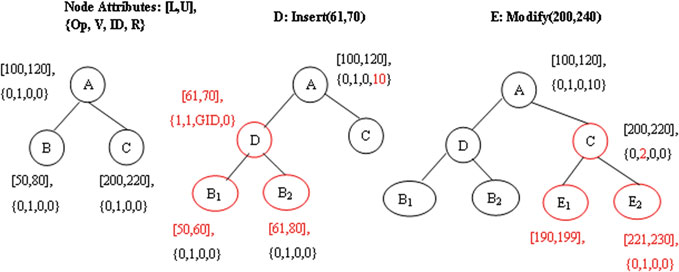
张和Blanton [41]提出了一种称为“平衡更新树”的新数据结构,以支持动态操作并验证数据完整性。在更新树中,每个节点对应已执行更新(即插入、删除或修改)的一段数据块。构建此类树的挑战在于确保:(i)能够高效地在树中定位一段数据块;(ii)在应用由客户端查询引起的必要更新后,树仍保持平衡,即该树的大小独立于整个文件大小,而取决于更新次数。然而,这会增加客户端的存储开销。此外,该审计方案需要检索(即下载)数据块,从而导致较高的通信成本。图3展示了平衡更新树操作的一个示例。
iii. 跳表
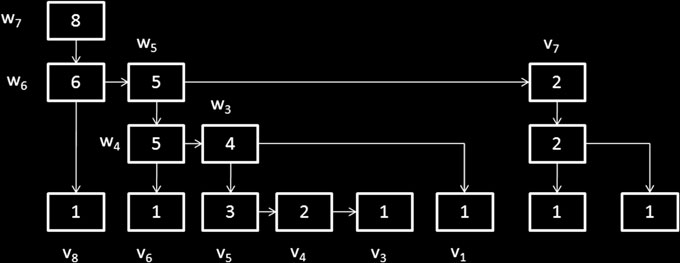
跳表[42]是一种链表的层次结构,用于存储有序集合。基于抗碰撞哈希函数构建的认证跳表[43]在每个节点中保存一个哈希值。由于哈希函数具有抗碰撞性,之后可使用根节点的哈希值来验证完整性。图4[44]展示了一个基于秩的认证跳表的示例,其中节点内的数字表示其秩,即从该节点可达的底层节点数量。卢等人[47]在其PDP模型中使用跳表结构支持数据动态性,将计算和通信复杂度从log(n)降低到常数。然而,使用跳表会带来一些额外的存储开销,即在云服务提供商端约为原始文件的3.7%,在客户端约为0.05%。此外,它仅支持私有审计。
iv. 索引表
映射版本表或索引表是由所有者创建并存储在验证者端的小型数据结构,用于验证所有文件的完整性和一致性由云服务提供商[36]存储的副本。映射版本表包含三列:序列号(SN)、块编号(BN)和版本号(VN)。SN表示文件块的索引,用于指示数据文件中某个块的物理位置。BN是用于对文件块进行逻辑编号/索引的计数器。VN表示文件块的当前版本。
李等人 [50, 51]提出了一种使用映射-版本表来支持数据块更新的完全数据动态PDP方案。随后,他们讨论了如何将该方案扩展以支持其他功能,包括公共审计、隐私保护、公平性和多副本检查。
最近,杨和晓华[18]提出了一种第三方存储审计方案(TSAS),该方案是一种隐私保护审计协议。它还通过使用索引表(ITable)支持数据的动态操作。此外,他们在索引表中增加了一个新列Ti,即用于生成数据标签的时间戳,以防止重放攻击。他们应用了批量审计来实现多个数据所有者的完整性验证,从而降低审计员的计算开销。然而,该方案将审计的计算负载从可信第三方审计员(TPA)转移到了云服务提供商(CSP)上,即配对运算,这导致云服务提供商(CSP)端产生较高的计算开销。
3 访问控制方法
尽管云存储服务具有成本效益和可靠性,但数据所有者可能认为它们是企业外部的不确定存储池。由于共享云基础设施,数据所有者可能担心其数据会被滥用或被未授权用户访问。对云服务提供商而言,一个重要方面是实施访问控制方法,以确保其数据的机密性和隐私,即防止数据遭受未授权访问和泄露。
通常,访问控制可以定义为限制特权/授权实体对资源/数据的访问 [52]。已经提出了多种访问控制模型出现的包括自主访问控制(DAC)[53],强制访问控制(MAC)[54],和基于角色的访问控制(RBAC)[55]。在这些模型中,主体(例如用户)和对象(例如数据文件)通过唯一名称进行标识,访问控制基于主体的身份或其角色。自主访问控制(DAC)、强制访问控制(MAC)和基于角色的访问控制(RBAC)适用于封闭且相对不变的分布式系统,这些系统仅处理一组已知用户对一组已知服务的访问,且数据所有者和服务提供商位于同一信任域[56]。
在云计算中,服务与用户之间的关系更加临时且动态,服务提供商和用户不在同一安全域中。用户通常通过其特征或属性而非预定义的身份来识别 [56]。因此,密码学解决方案,例如在数据外包前进行数据加密,可以作为一种简单的方法,以防止未经授权的用户和不可信的云服务提供商(CSPs)访问敏感数据。然而,仅依靠加密解决方案难以高效地将一个文件加密给多个接收者,并且无法支持细粒度访问控制,即无法向一组用户授予差异化访问权限,也无法灵活指定各个用户的访问权限。此外,传统的基于访问控制列表(ACL)的访问控制方法要求将授权用户列表附加到每个数据对象上。当使用加密方法强制执行访问控制列表时,每个数据对象在密文大小和/或相应的数据加密操作方面的复杂性与系统中用户数量呈线性关系,从而使系统可扩展性降低[57]。
以下各节概述了现有的访问控制方法,并重点介绍了它们的主要优点和缺点。
3.1 传统加密
实施访问控制并确保数据机密性的一种方法是将敏感数据以加密形式存储。只有被授权访问数据的用户才拥有所需的解密密钥。加密方案主要有两类: (i)对称密钥加密和(ii)公钥加密 [45]。在针对外包数据访问控制的领域中,已有若干方案 [58–60] 被提出,这些方案使用传统的对称密钥密码学或公钥密码学来解决类似的数据访问控制问题。尽管这些方案适用于传统文件系统,但其中大多数并不适合大规模数据中心中的细粒度数据访问控制,因为此类数据中心可能拥有大量用户和数据文件。显然,在云服务器上共享数据时不应直接应用这两种方法,因为它们在将文件加密给多个接收者时,就密钥大小、密文长度以及加密的计算开销而言效率低下。此外,它们无法支持细粒度的基于属性的访问控制和密钥委托。
3.2 广播加密
在广播加密(BE)中,发送者在广播信道上为正在收听的用户子集S加密一条消息,使得只有S中的接收者才能使用其私钥解密该消息。实用广播加密问题最早由菲亚特和诺尔在 1994[61]中进行了形式化研究。该BE系统可抵御k个用户的合谋攻击,这意味着如果超过k个用户合谋,则系统可能不再安全。
此后,文献中描述了多种解决方案,例如哈莱维和沙米尔 [62] 以及博内等人 [63] 提出的方案,这些是目前最著名的BE方案。然而,这两种方案的效率都取决于授权用户集的大小。此外,它们还要求广播者/发送者参考其用户授权数据库。
德勒拉布尔等人 [64] 提出了一种动态公钥广播加密方案,该方案同时具备以下优点:接收方无状态;加密机制对于任意大规模的用户合谋具有抗共谋安全,且在标准模型下安全性紧密;新用户可动态加入(即无需修改用户解密密钥和密文大小)。
最近,金等人[65]提出了一种具有固定大小私钥和密文的半静态安全广播加密方案,该方案改进了亨特里和沃特斯[66]提出的方案。他们将私钥和密文大小减少了一半。此外,公钥和私钥的大小不依赖于用户总数。不幸的是,该方案仅能抵御自适应选择明文攻击(CPA)。
显然,广播加密(BE)系统以一般性能实现了一对多加密。然而,在云服务器上共享数据时可能无法直接应用,因为它不支持基于属性的访问控制和密钥委托。
3.3 基于身份的加密
基于身份的加密(IBE)由博内等人在 1984[63]中提出。但是,IBE多年来一直是一个未解决的问题,直到哈莱维和沙米尔提出了一个完全功能的基于身份的加密(IBE)方案[62]。它可以被定义为一种公钥密码学(PKC),其中对应于唯一用户信息的任意字符串都可以作为有效的公钥,例如电子邮件地址或物理IP地址。相应的私钥由一个称为私钥生成器(PKG)的可信第三方(TTP)计算得出,如图5[67]所示。与传统PKC相比,IBE系统消除了对接收者认证的公钥进行在线查询的需求。然而,IBE系统引入了若干问题:首先,只有一个PKG负责向每个用户分发私钥,这导致了密钥托管问题,即PKG知道所有用户的私钥,并可能解密任何消息;其次,PKG是一个中心化实体,可能会过载并成为单点故障。
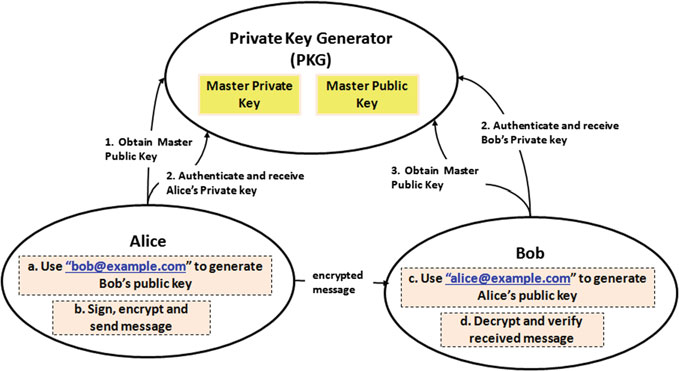
导致瓶颈。第三,如果私钥生成器(PKG)服务器遭到破坏,该服务器使用的所有消息也会被泄露。最近,李等人[68]提出了一种可撤销IBE方案,解决了在用户撤销期间私钥生成器(PKG)上的计算开销这一关键问题。他们为每个用户采用混合私钥,其中通过与门将身份组件和时间组件连接并绑定。最初,用户能够获得身份组件和一个默认的时间组件,即PKG可以为其颁发当前时间段的私钥。然后,未被撤销的用户需要定期向一个新引入的实体——密钥更新云服务提供商(KU-CSP)请求时间组件的密钥更新,这会带来额外的通信成本。
3.4 层次化基于身份的加密
Horwitz和Lynn [69]提出了分层基于身份的加密(HIBE)系统的概念,以减轻根PKG的负担。他们提出了一种两级HIBE方案,其中根PKG只需为域级PKG生成私钥,而域级PKG则为其域内下一级的所有用户生成私钥。该方案在随机预言模型中具有选择密文安全性。此外,它在上层实现了完全抗共谋,在下层实现了部分抗共谋。
Gentry和Halevi [70]提出了一种具有完全抗共谋特性的分层身份基加密方案,该方案在任意层数下均有效,并在BDH假设和密钥随机化的条件下,在随机预言模型中具有选择密文安全性。值得注意的是,他们的方案具有一个有价值的特性,即一对多加密,即加密文件可由接收者及其所有祖先分别使用各自的私钥进行解密。然而,密文和私钥的长度,以及加密和解密的时间,均随接收者在层次结构中的深度线性增长。
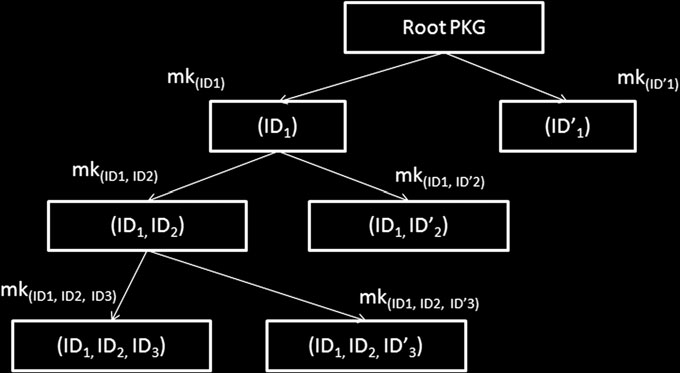
图6[71]展示了HIBE的一个示例,其中根PKG为HIBE系统生成系统参数,并为下级PKG生成私钥,而这些下级PKG又为其域内底层的实体生成私钥。换句话说,用户公钥是一个ID元组,由用户身份(ID)及其祖先的ID组成。每个PKG使用其私钥(包括主密钥和私钥)以及用户公钥,为其域中的每个用户生成私钥。Liu等[72]利用了[70]的“一对多”加密特性,提出了一种高效的共享安全云存储服务方案。在他们的方案中,发送者可以通过将接收者的数量和公钥作为HIBE系统的输入,指定多个用户作为加密文件的接收者。使用该方案,发送者只需对文件加密一次,并且无论预期接收者数量多少,仅需存储一份相应的密文。该方案的局限性在于,密文长度随接收者数量线性增长,因此只能用于涉及少量接收者的机密文件场景。
最近,Mao 等人[73]提出了一种新的HIBE系统,其密文大小和解密开销均与层次深度无关,即具有固定长度密文和在解密过程中执行常数次双线性映射运算。此外,他们的方案在标准模型中是完全安全的。该HIBE系统显然实现了密钥委托,且一些HIBE方案以足够的性能实现了一对多加密。然而,在云服务器上共享数据时可能无法直接应用,因为它不能高效地支持细粒度访问控制。
3.5 基于属性的加密
属性基加密(ABE)方案是IBE方案的推广。在IBE系统中,用户仅由一个属性即ID来标识;而在属性基加密方案中,用户由一组属性来标识,例如专业、部门、位置等。Sahai 和 Waters [74]首次提出了属性基加密方案的概念,其中发送者在加密消息时指定一个属性集合和一个数值d,使得只有拥有至少d个指定属性的接收者才能解密该消息。尽管该方案被称为阈值加密,具有抗共谋性和选择性-ID安全,但它存在三个缺点:第一,难以定义阈值,即接收者解密密文所需的最小属性数量;第二,撤销用户需要重新定义属性集合;第三,缺乏表达能力,限制了其在更大规模系统中的适用性。
作为属性基加密方案的扩展,文献中提出了两种变体:(i)基于密钥策略的ABE(KP-ABE)方案和(ii)基于密文策略的ABE(CP-ABE)方案。
i. 基于策略的基于属性的加密
一种密钥策略属性基加密(KP-ABE)方案由Goyal 等[75]首次提出,该方案支持由与门、或门或阈值门组成的任意单调访问公式。他们的方案被认为实现了细粒度且可表达的访问控制。KP-ABE 是一种将访问结构或策略嵌入用户私钥中的方案,而密文则与一组描述性属性相关联。
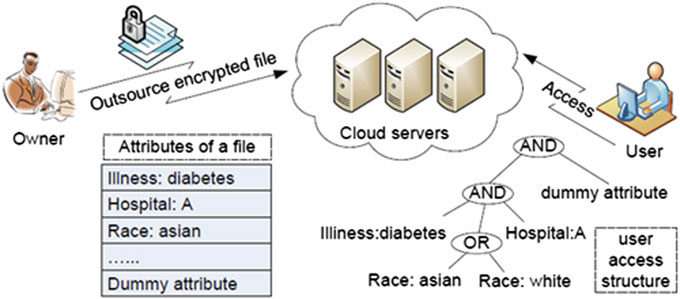
如[76],所述,任何单调访问结构都可以表示为数据属性上的访问树。例如,图7展示了一个在医疗应用中可生成的访问结构和属性集[77]。数据所有者在将其上传到云。只有其私钥中指定的访问结构与文件属性匹配的用户才能解密该文件。换句话说,具有如下访问结构的用户:糖尿病(亚洲人 V 白人)A,可以解密在属性糖尿病、A、亚洲人下加密的数据文件。最近,[77, 78]提出了一种用户私钥可撤销的具有非单调访问结构的密钥策略属性基加密(KP-ABE)方案,该方案可与XACML策略[79]相结合,以解决将复杂的访问控制过程迁移至云,并构建安全可证明的公开可验证云访问控制方案。
上述所有先前的工作均假设使用单一可信权威(TA)来管理系统域中的所有属性,例如添加、颁发、撤销等。这种假设不仅可能造成负载瓶颈,还会导致密钥托管问题,因为可信权威(TA)能够解密所有文件,从而引发隐私泄露。因此,蔡斯 [80] 提出了一种多权威属性基加密方案的构造方法,支持多个不同权威机构同时运行,每个机构管理不同的域属性集,即为不同的属性集 [81] 颁发私钥。然而,该方案仍不理想,存在三个主要问题:第一,存在一个中心权威机构,因其掌握系统密钥而能够解密所有密文,从而引发密钥托管问题;第二,共谋的权威机构很容易构建出每个全局标识符(GID)对应的所有属性的完整档案;第三,权威机构的集合是预先确定的。
蔡斯和周 [82] 提出了一种更实用的多权威KP-ABE系统,该系统去除了可信中心权威机构以保护用户隐私。他们的方案允许用户通过假名与属性权威机构通信,而无需提供其全局标识符(GIDs)。此外,他们防止了属性权威机构聚合数据以及关联同一用户的多个属性集。
于等人[77]利用属性基加密、代理重加密(PRE)[60],和延迟重加密(LRE) [83]这三种技术的独特结合,使数据所有者能够将用户撤销过程中涉及的大部分计算任务委托给不可信的云服务提供商(CSPs),同时不泄露底层数据内容。代理重加密(PRE)消除了数据所有者与用户之间在解密密钥分发过程中的直接交互需求,而延迟重加密(LRE)允许云服务提供商聚合多个用户撤销操作的计算任务。例如,一旦某个用户被撤销,云服务提供商仅需记录该事件;只有当有用户提出文件数据访问请求时,云服务提供商才对所请求的文件进行重新加密,并更新请求用户的私钥。
最近,李等人[84]提出了一种具有恒定密文大小的表达性强的去中心化 KP-ABE方案,即密文大小与方案中使用的属性数量无关。在他们的构造中,无需可信中心权威机构来进行系统初始化,且访问策略可以表示为任意非单调访问结构。此外,该方案在所谓的选择性集合模型下基于n-DBDHE假设是语义安全的。
霍恩伯格和沃特斯 [85] 提出了一种KP-ABE方案,其中密文可以通过常数次配对操作进行解密,且对属性数量没有限制。然而,用户私钥的大小随着访问策略中不同属性的数量增加而增加。此外,还存在一个可信的单一机构为用户生成私钥,这会侵犯用户隐私并导致密钥托管问题。
不幸的是,在所有KP-ABE方案中,数据所有者无法控制谁可以访问他们加密的数据,只能通过为数据选择描述性属性集来间接控制。相反,他们必须信任密钥颁发者向适当的用户颁发合适的密钥以授予或拒绝访问权限。此外,用户的私钥大小以及加密和解密操作中的计算开销与访问策略中涉及的属性数量呈线性关系。
ii. 密文策略属性基加密
在Bethencourt等人提出的密文策略ABE(CP-ABE)中[86],密文和密钥的角色与KP-ABE方案相反。数据所有者决定数据可被解密的策略,而私钥则与一组属性相关联。
大多数已提出的CP-ABE方案在加密和解密操作中会产生较大的密文大小和计算开销,这些开销至少与访问策略中涉及的属性数量呈线性关系。因此,Chen等人[87]提出了两种CP-ABE方案,这两种方案对于包含带通配符的与门的访问策略均具有常数大小密文和常数计算开销。第一种方案在标准模型下基于判定n-BDHE假设可证明是CPA安全的,而第二种方案在标准模型下基于判定n-BDHE假设以及抗碰撞性哈希函数的存在性可证明是CCA安全的。
朱等人 [88, 89]提出了一种支持完整比较关系(例如<、>、≤、≥)的基于比较的加密方案,可在策略中对整数属性(如时间与等级属性)实施各种范围约束。他们结合代理重加密与密文策略属性基加密(CP-ABE),以支持密钥委托,并通过将大部分解密操作外包给云服务提供商来降低轻量级设备上的计算开销。该方案为每个范围属性提供了O(1)大小的私钥和密文。此外,该方案在RSA和CDH假设下是可证明安全的。然而,该方案依赖于中心化单一权威机构来进行系统初始化并管理所有属性,且未提供高效的用户撤销机制。
张和陈[90]提出了针对公共云存储的“访问控制即服务”理念,其中数据所有者控制授权,且通过使用密文策略属性基加密(CP-ABE)和代理重加密,可将PDP(策略决策点)与策略执行点(PEP)安全地委托给云服务提供商(CSP)。然而,该方法会带来较高的通信和设置成本。
大多数传统CP-ABE方案的主要局限性在于:首先,由于访问结构被嵌入到密文中,可能会泄露数据文件范围以及具有访问权限的授权用户信息,从而损害用户隐私。Nishide等人[91],提出的明显解决方案是隐藏密文策略,即隐藏访问结构。随后,出现了各种改进传统CP-ABE方案的研究工作,以支持隐私保护访问策略,如[92–94]所示。传统CP-ABE方案的另一个局限性是依赖于单一中心权威机构来监控和发放用户的私钥。最近,许多密文策略属性基加密方案考虑了多权威机构环境[94–96]。
为了实现对个人健康记录(PHRs)的细粒度和可扩展的数据访问控制,李等人 [95] 采用了密文策略属性基加密(CP-ABE)技术来加密每位患者的PHR文件,并重点关注多数据所有者场景。此外,他们采用代理加密和延迟撤销机制,以高效支持属性和用户的撤销。然而,密钥生成、加密和解密过程的时间开销均与属性数量呈线性关系。
3.6 层次化基于属性的加密
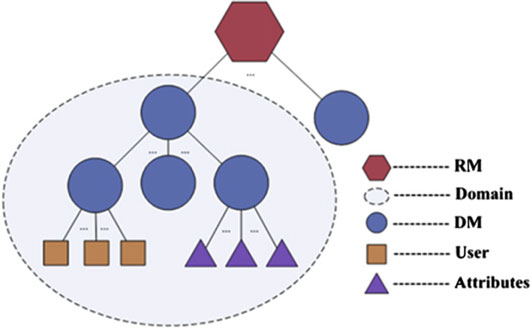
分层属性基加密(HABE)模型,如[97,98],中所述,融合了HIBE模型[71]和ABE模型[74]的特性。如图8所示,该模型由根管理者(RM)和多个域组成,其中根管理者(RM)充当可信第三方(TTP),而各个域则代表企业用户。更具体地说,每个域包含多个对应于内部可信方(ITPs)的域管理者(DMs)以及大量对应于终端用户的用户。根管理者(RM)的角色类似于 HIBE系统中的根PKG,负责生成和分发系统参数及域密钥。域管理者(DM)的角色则结合了HIBE系统中域PKG和ABE系统中AA的特性,负责向下一级的域管理者(DMs)委派密钥,并向用户分发私钥。
王等人[99]提出了一种支持完全密钥委托且解密过程中仅需常数次双线性映射运算的模糊精确身份基加密(FPIBE)方案。该FPIBE方案能够高效地通过结合HIBE系统和CP-ABE系统实现灵活的访问控制。利用FPIBE方案,用户可以通过指定接收者ID集合或基于属性的访问控制策略来加密数据,使得只有其ID属于该ID集合或其属性满足访问控制策略的用户才能解密相应数据。然而,密文长度与授权用户的数量和加密时间成正比。此外,用户私钥的大小与其在层次结构中的深度成正比。
为了在可扩展、灵活和细粒度的访问控制中支持复合和多值属性, Wan等人[100]通过将具有用户层次结构的密文策略属性集加密( CP-ASBE)进行扩展,提出了层次属性集加密(HASBE)。HASBE采用多种访问过期时间的值分配方式,以更高效地处理用户撤销。然而,授权访问操作与密钥结构中的属性数量成正比。
Chen等人[101]提出了一种新的层次密钥分配方案,称为 CloudHKA,用于解决在云数据上实施层次访问控制策略的密码密钥分配问题。CloudHKA具有多项优势:(1)每个用户只需存储一个私钥,(2)可灵活地为每个用户授权写或读或两者的访问权限,(3)支持动态用户集和访问层次,以及(4)可证明安全地抵御合谋攻击。然而,在用户撤销情况下,其重密钥成本与同一安全等级中的用户数量呈线性关系。CloudHKA未考虑表达性强的用户属性,因此可被视为一种粗粒度访问控制方案。
王等人[102]最近通过引入时间概念来执行自动代理重加密,扩展了层次化CP-ABE方案[97, 98]。更具体地说,他们提出了一种基于时间的代理重加密(TimePRE)方案,使得用户的访问权限在预定时间段过后可自动过期。在这种情况下,数据所有者可以在用户撤销过程中处于离线状态。然而,TimePRE方案存在两个缺点:第一,它假设所有实体之间存在全局时间;第二,用户私钥大小为O(mn),其中m是对应于用户有效时间周期的时间树中的节点数量,n是用户属性数量。
3.7 基于角色的访问控制
在基于角色的访问控制(RBAC)系统中,访问权限被分配给角色,角色再被分配给用户/主体[103]。可以根据系统需求创建、修改或禁用角色。角色-权限分配相对稳定,而用户-角色分配则变化较为频繁(例如人员跨部门调动、职责重新分配等)。因此,管理用户-角色权限比单独管理用户权限要容易得多[104]。
周等人[105]提出了一种用于安全云存储的基于角色的加密(RBE)方案。该方案指定了分配给用户的一组角色,每个角色具有
一组权限。角色可以定义为层次结构,这意味着一个角色可以拥有子角色(后继角色)。数据所有者可以将私有数据加密到特定角色。只有在指定角色或其祖先角色中的用户才能解密该数据。无论用户被分配了多少角色,解密密钥大小仍保持常数。然而,解密开销与同一角色中授权用户的数量成正比。
4 云数据存储安全方法的比较分析
本节根据不同的性能标准,评估了前几节中提出的审计和访问控制方法的性能。
4.1 数据存储审计方法的性能分析
本节评估了现有的一些数据存储审计方案的不同特征,例如审计员类型、对动态数据的支持、复制/多副本以及数据恢复,如表1所示。此外,还从云服务提供商和审计员的计算复杂度、云服务提供商和审计员的存储开销、审计员与云服务提供商之间的通信复杂度等方面评估了它们的性能,如表3所示。
如表1所示,大多数审计方案仅关注文件的单个副本,无法提供证明以表明云服务提供商存储了数据所有者文件的多个副本。尽管数据所有者可能需要将其关键数据复制到多个数据中心的多台服务器上,以确保数据的可用性,但仅有少数方案[26, 37, 38]支持对数据所有者文件的多个副本进行审计。
表2给出了不同审计方法中使用的密码操作的更多符号。设 r、n、k 分别表示副本数量、每个副本的块数以及每块扇区数(在块碎片化的情况下)。s 表示块大小。c 表示挑战块数量。设 λ为安全参数,通常为密钥的大小。设 p 表示群的阶,且 φ(N)表示 RSA 模数 N 上的欧拉函数。
如表3所示,基于MAC的方案[29]需要存储开销较大的元数据,即每个数据块大小的块标签。另一方面,它们在云服务提供商和审计员处具有高效的计算复杂度。基于BLS签名的同态标签[19, 29]比基于RSA的同态标签短得多[29]。然而,由于双线性配对操作比其他密码操作耗时更多,基于 BLS的审计方案在审计员处的验证开销,即计算开销,高于基于RSA的审计方案。
| 方案 | 审议员类型 | 动态数据 | 复制 | 数据恢复 |
|---|---|---|---|---|
| Liu et al. [17] | 公共 | Yes | No | No |
| 杨和晓华 [18] | 公共 | Yes | No | No |
| Ateniese 等人 [19] | 公共 | No | No | No |
| 王等人[48] | 公共 | Yes | No | No |
| 沙查姆和沃特斯 29 | 公共 | No | No | Yes |
| 沙查姆和沃特斯 29 | 公共 | No | No | Yes |
| 沙查姆和沃特斯 29 | 私有 | No | No | Yes |
| 袁和余 [31] | 公共 | No | No | Yes |
| 徐和张[32] | 公共 | No | No | Yes |
| 巴苏姆和哈桑[37] | 公共 | Yes | Yes | No |
| 朱等人 [38] | 公共 | No | Yes | No |
| Etemad 和 Kupcu [26] | 私有 | Yes | Yes | No |
表1 数据存储审计方案的特征
| 符号表示 | 密码操作 |
|---|---|
| MUL | 群G中的乘法运算 |
| ADD | 群G中的加法运算 |
| EXP | 群G中的指数运算 |
| H | 哈希到群G |
| 配对 | 双线性配对;e(u, v) |
| SEncr | 流加密 |
| MOD | zN中的模运算 |
表2 密码操作的符号表示
为了减少存储开销,数据所有者可以将标签与数据块一起仅存储在云服务提供商处。当向云服务提供商发起挑战时,云服务提供商生成数据证明和标签发送给审计员,而不仅仅是数据证明。但该解决方案将增加云服务提供商与审计员之间的通信成本。事实上,在审计员处的存储开销与云服务提供商和审计员之间的通信成本之间存在一种权衡。
袁和余的方案[31]忽略了通信成本与存储成本之间的权衡。在审计过程中,云服务提供商与审计员之间交换的消息包含常数个群元素。然而,它需要进行4次双线性配对操作来验证证明,导致审计员端的计算成本较高。通过使用短同态标签(如BLS标签)可以降低通信开销,[6, 24, 26]这些标签使云服务提供商能够通过聚合认证标签来降低审计的通信复杂度
将单个文件块合并为一个标签。批量审计[18, 48]可以通过允许云服务提供商发送被挑战的数据块的线性组合(其大小等于一个数据块)来进一步降低通信开销,而无需按顺序发送这些数据块。
支持动态数据的审计方案[17, 18, 26, 37, 48]会增加审计员端的存储开销。基于MHT的方案[48]将元数据(即MHT根节点)保存在审计员侧,其大小小于使用索引表[18, 37],的方案,因为索引表条目总数等于文件块的数量。相反,基于MHT的方案的计算和通信开销高于基于表的方案。在基于MHT的方案执行动态操作期间,数据所有者向云服务提供商发送修改请求并接收认证路径。云服务提供商根据所需的动态操作更新MHT,重新生成新的目录根节点,并将其发送给审计员。而对于基于表的方案,数据所有者仅需向云服务提供商发送请求,并更新索引表,无需使用任何密码操作。然而,基于索引表的审计方案[18,37]在插入或删除操作期间会遭受性能损失,最坏情况下为O(n),因为在插入/删除点之后的所有块的索引都会发生变化,且这些块的所有标签都需要重新计算。而使用跳表[26]时,插入或删除操作的复杂度为O(log n)。
4.2 访问控制方法的性能分析
本节从密文大小、用户私钥大小、解密开销、用户撤销开销以及是否存在多个授权机构等方面对不同的访问控制方法进行评估。表4评估了不同访问控制方法的性能。
如表4所示,用户撤销是访问控制方法中一个极具挑战性的问题,需要对被撤销用户可访问的数据文件进行重新加密,并可能需要为所有未撤销用户更新私钥。因此,用户撤销会给数据所有者带来较大的计算开销,并且还可能要求其始终保持在线。采用代理加密的访问控制方法可以高效地执行用户撤销操作,例如[90, 95, 96, 101]。为了进一步改善用户撤销的复杂性,分层访问控制方法(如[100, 105])采用了密钥委托的概念。密文大小和私钥大小是当前访问控制方法中的另外两个挑战性问题,可能导致较高的存储开销和通信开销。密文和私钥大小通常随着系统域中属性数量的增加而线性增长。方法[90, 92, 100, 101, 105]具有常数级密文大小,而只有方法[92, 105]实现了常数级私钥大小。
在大多数访问控制方法中,解密开销随着访问策略的复杂性或属性数量的增加而增加,这在某些情况下是不可行的,例如手机等轻量级设备。某些访问控制方法,例如 [85,90, 92, 96, 99]具有常数级解密开销。一些访问控制方法,例如[85, 90, 92],假设使用一个可信权威(TA),由其管理(例如添加、颁发、撤销等)系统域中的所有属性。这种假设不仅可能造成负载瓶颈,而且存在密钥托管问题,因为可信权威(TA)可以解密所有文件,从而导致隐私泄露。相反,最近的访问控制方法,例如 [99–101],考虑了不同实体的存在,这些实体称为属性权威(AAs),负责管理个人的不同属性,例如机动车管理部门可测试你是否具备驾驶资格,或大学可证明你是学生等。每个属性权威(AA)管理一个不相交子集的属性,而任何一个属性权威(AA)都无法单独控制整个系统的安全。
| Access control method | Approach | Ciphertext size | User key size | Decryption cost | User revocation cost | Multiple authority |
|---|---|---|---|---|---|---|
| Hohenberger and Waters[85] | KP-ABE | Linear with no. of attributes | Linear with no. of attributes | Constant no. of pairings | N/A | No |
| Doshi and Jinwala [92] | CP-ABE | Constant | Constant | Constant no. of pairings | N/A | No |
| Qian et al.[93] | CP-ABE fully hidden access structure | Linear with no. of attributes | Linear with total no. of attributes | Linear with no. of attribute authorities | N/A | Yes |
| Li et al.[95] | CP-ABE with proxy encryption and lazy re-encryption | Linear with no. of attributes and no. of AA | Linear with no. of attributes in the secret key | Linear with total no. of attributes | Linear with no. of attributes in the secret key | Yes |
| Yang et al.[96] | CP-ABE with proxy encryption | Linear with no. of attributes in the policy | Linear with the total no. of attributes | Constant | Linear with no. of non-revoked users who hold the revoked attribute | Yes |
| Wang et al.[99] | HIBE+ CP-ABE | Linear with no. of users and the max. depth of hierarchy | Linear with no. of attributes of a user | Constant | N/A | Yes |
| Wan et al.[100] | CP-ABE+ HIBE | Constant | Linear with no. of attributes of a user | Linear with no. of attributes in the key | Constant | Yes |
| Chen et al.[101] | HIBE with proxy encryption | Constant | Read and write keys independent of number of ciphertexts | Linear with the depth of the user in hierarchy | Linear with no. of authorities and no. of ciphertext accessed by revoked user | Yes |
| Zhou et al.[105] | Hierarchical RBAC | Constant | Constant | Linear with no. of users in the same role | Linear with no. of roles | Yes |
| Zhang and Chen[90] | CP-ABE+ proxy encryption | Constant | Linear with no. of attributes | Constant no. of pairings | Constant | No |
表4 不同访问控制方法的性能分析
5 讨论与结论性评述
根据前几节的广泛综述,我们得出结论:云计算中的数据安全是阻碍云存储服务采用的主要问题之一。最关键的安全问题涉及数据完整性、可用性、隐私和机密性。
为了验证云计算中的数据完整性和可用性,已在不同的安全级别和密码学假设下提出了许多审计方案。大多数审计方案在随机预言模型中是可证明安全的。现有审计方案的主要局限性可以总结如下:(1)仅处理归档静态数据文件,未考虑插入、删除和更新等动态操作;(2)依赖抽查机制,只能检测存储在云服务提供商处的数据是否大部分遭到破坏,但无法检测数据小部分的损坏情况;(3)依赖里德-所罗门编码方案以支持数据丢失或损坏时的数据恢复功能,但这会导致大文件的编码与解码效率低下;(4)仅支持私有审计,要求数据所有者周期性地对其数据进行审计,从而带来较高的计算和在线负担;(5)仅能验证单份数据文件,未考虑复制的数据文件;(6)产生较高的计算成本和存储开销。
因此,为了克服先前的局限性,一个理想的审计方案应具备以下特征:
1. 公共审计:使数据所有者能够将审计过程委托给可信第三方审计员( TPA),以按需验证外包数据的正确性。 2. 隐私保护保证:防止在审计过程中被验证数据的泄露。 3. 数据动态性:允许客户高效地对数据文件执行块级操作,如插入、删除和修改,同时保持相同水平的数据正确性保证并确保数据新鲜度。 4. 鲁棒性:能够高效地恢复任意数量的数据损坏。 5. 可用性和可靠性:支持对可区分的多副本数据文件进行审计,以确保云服务提供商(CSP)存储了所有约定的数据副本。
6. 无块验证:允许可信第三方审计员在无需拥有或检索被挑战的数据块副本的情况下,按需验证云数据的正确性。7. 无状态验证:可信第三方审计员在审计之间无需维护任何状态。8. 效率:实现以下方面:
(a) 云服务提供商和可信第三方审计员的最低计算复杂度。(b) 云服务提供商与可信第三方审计员之间的最低通信复杂度。(c) 云服务提供商和可信第三方审计员的最小存储开销。
为了确保云计算中的数据机密性,提出了各种访问控制方法,以限制对数据的访问,并保证外包数据免受未授权访问。然而,这些方法存在诸多缺陷,例如:(1)由于用户撤销操作,导致数据所有者面临沉重的计算开销和繁琐的在线负担;(2)密文和私钥大小较大,且加密和解密操作的计算开销较高,其开销至少随访问策略中涉及的属性数量线性增长;(3)在访问策略中泄露有关数据文件和授权用户的一些信息,从而损害用户隐私;(4)依赖单一机构来管理访问策略中的不同属性,可能导致瓶颈和密钥托管问题。
因此,我们认为理想的访问控制方法应满足以下要求:
1. 细粒度:向一组用户授予不同的访问权限,并在指定各个用户的访问权限时提供灵活性和表达能力。2. 隐私保护:访问策略不会向云服务提供商泄露有关数据文件范围以及被授权访问的用户类型或属性的任何信息。3. 可扩展性:授权用户的数量不能影响系统的性能。4. 高效性:该方法在密文大小、用户私钥大小以及加密、解密和用户撤销的开销方面应具有高效率。5. 前向和后向安全:被撤销用户不应能够使用新公钥解密新生成的密文;而新加入用户若满足访问策略,则应能够使用先前的公钥解密此前发布的密文。6. 抗共谋:不同用户之间无法相互勾结并组合其属性来解密加密数据。7. 多机构:为克服负载瓶颈和密钥托管问题,应由多个授权机构来管理用户属性并颁发私钥,而非依赖单一的中央可信机构。
6 结论
云存储服务因其成本效益和可靠性而变得极具前景。然而,该服务也为数据安全和隐私带来了许多新的挑战。因此,云服务提供商必须采用安全实践,以确保客户数据的安全。本文介绍了云存储服务中的不同安全挑战,并对确保数据完整性、可用性和机密性的各种方法进行了综述。同时根据多种预定定义的性能标准对这些方法进行了比较评估。最后,我们提出了云计算环境中的数据安全的以下研究方向:(1)将基于属性的加密与基于角色的访问控制模型相结合,使得用户-角色和角色-权限的分配能够通过应用于用户、角色、对象和环境属性的访问策略分别构建。(2)开发一种上下文感知的基于角色的控制模型,并将其集成到云的策略执行点中,仅当用户位于特定逻辑位置、时间间隔和特定平台时才启用或激活角色,以防止恶意内部人员泄露授权用户的身份。(3)将高效访问控制和审计方法与新的硬件架构和虚拟化特性相结合,以帮助保护数据和资源的机密性与完整性。(4)结合审计与访问控制之间的关系,以保障安全的云存储服务。(5)在当前的审计方法中扩展数据恢复功能。
更多推荐
 7
 0
- 0


 已为社区贡献19条内容

所有评论(0)