
深度学习Step1
提示:城南看花花正开,清明微雨洒尘埃
文章目录
这里若是你要写论文用到这篇文章,你使用的技术主要包括深度学习框架PyTorch ,Web框架:Flask,图像处理:PIL,Numpy,机器学习算法:KNN,前端:HTML,CSS,JavaScript。
第一章 项目架构
1.1项目简介
这是一个基于深度学习的图片识别系统(其实人脸识别也是同样的原理),集成了图像相似性搜索,图像去噪,商品分类等功能,通过PyTorch深度学习框架开发,使用Flask提供Web界面,这个项目是一个很常见的项目,但是对于理解深度学习是一个很好项目、等你随着我看完这个项目,你会知道很多领域其实都用到了这些功能。
1.2 核心功能
图片相似性搜索
提取图片的特征,将每一个图片对应的特征存储起来,通过KNN(KNN简单来说就是找数值上和他最相近的K个数值)来计算特征之间的相似性来实现相似图片检索的过程
图像去噪处理
对上传的图片添加噪音,并且对去噪之后的图片进行展示,这个模块也就是给图片加噪音,然后对于加噪音的这个图片,将这个有噪音的图片恢复成为原来的图片,某种程度上也是一个有监督的学习过程。
商品分类识别
通过上传图像,系统能够在数据库中找到视觉上最相似的5个商品
这里是一个有监督的学习,基于预标签的数据提取图像特征,发掘图像和分类之间的潜在关系,实现商品的分类。
1.3 环境准备
这里环境准备,这里我就不写了,大家可以找一个安装Python环境的,这个网络上有很多,我这里尽量快的教大家实现一个项目, 这里使用的是Pycharm(若是没有软件的,请添加微信公众号Sun小明同学私信说明来意)
第二章 模块配置
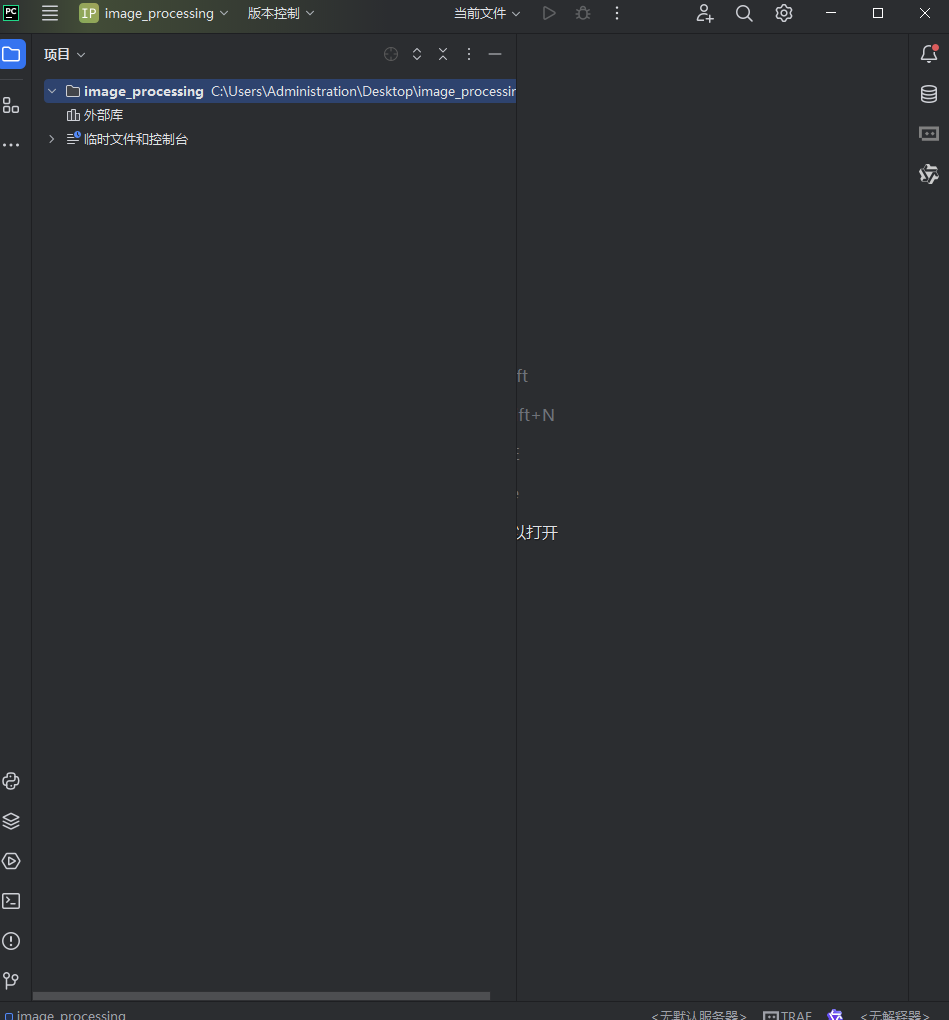
现在随便找一个文件夹,在其中创建一个文件夹,但是项目路径最好不要有中文,名字为image_processing,使用Python打开,
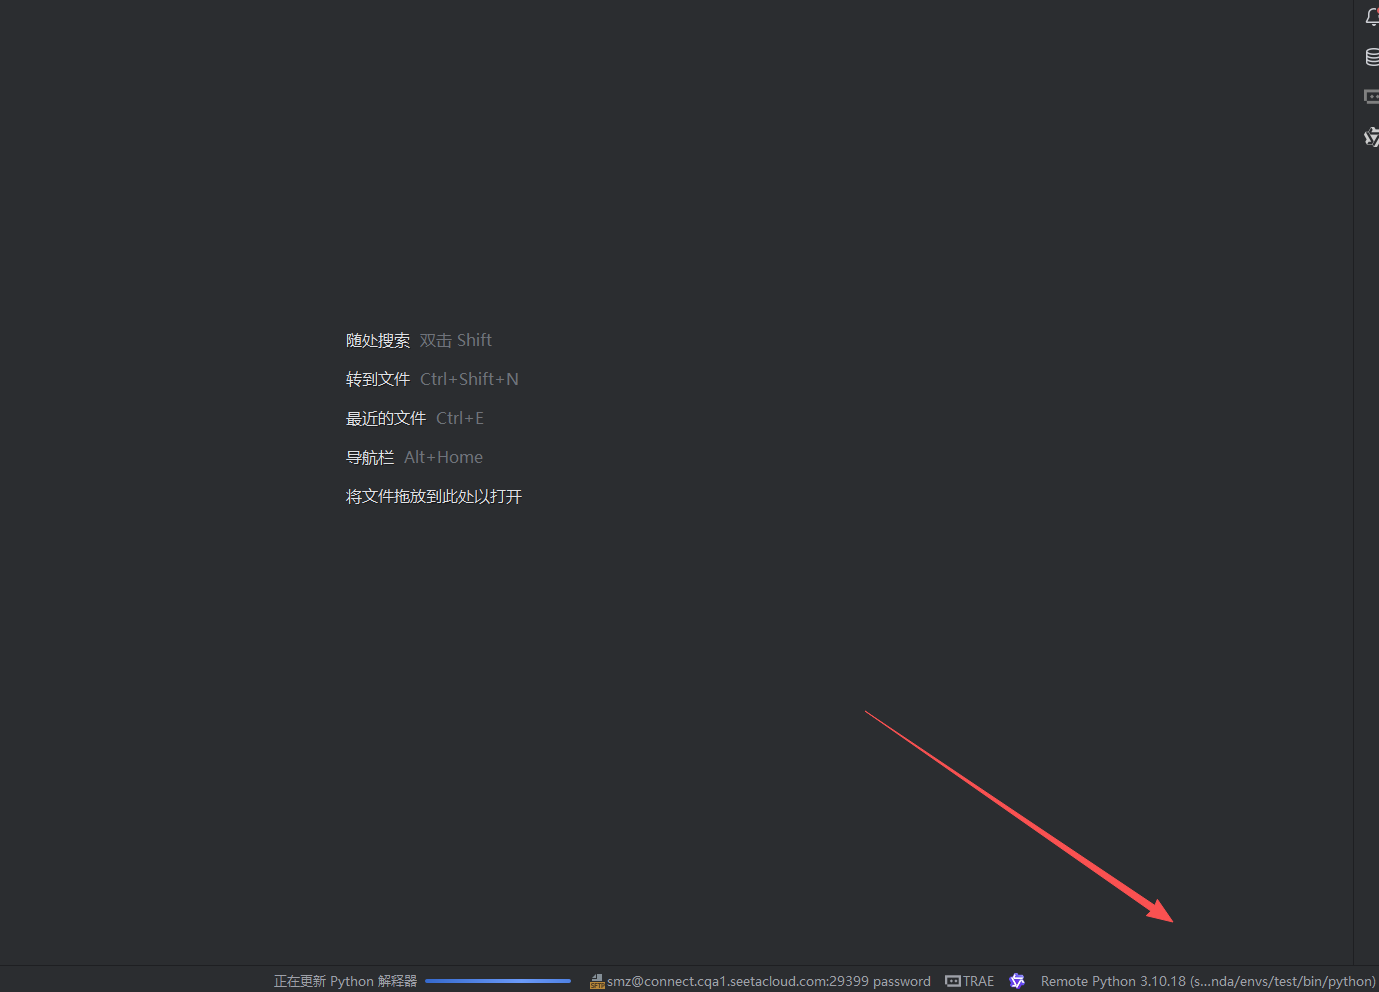
我这里使用的是服务器,即使没有服务器也无所谓,在这个平台中使用搜索anaconda安装,按照上面的提示也能起到同样的效果,主要有一个解释器就可以,添加解释器,
2.2 创建模块
这里我们主要有三个功能模块和一个web模块,另外我们还有一个通用模块(这个模块的作用是将一些通用的功能放入到这个模块中)
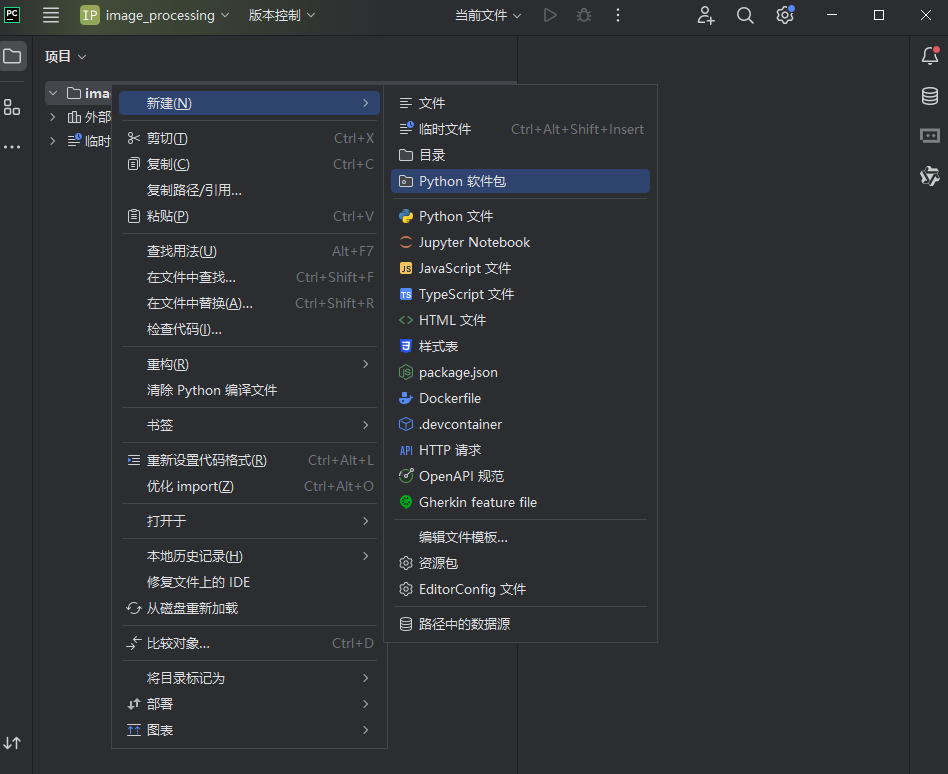
接下了分别创建这五个模块,分别创建一个,右键点击image_processing,在image_processing目录下创建文件夹
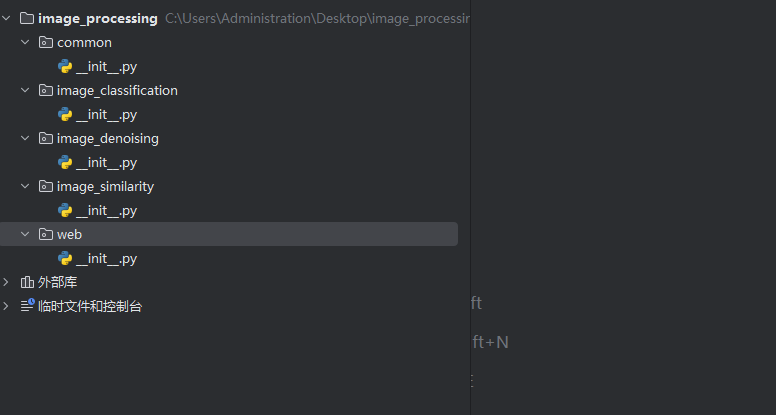
将数据放入到这个common这个文件夹中,以及数据的标签也放入到这个common这个文件夹之下,放入之后就是这样一个效果,至于这个数据,因为这个平台不能进行数据的上传,所以依然是请移步到”Sun小明同学“这个微信公共号免费获取,得到如下的文件目录。并且这个每一天的总的代码也都会提供,也请移步到”Sun小明同学“这个微信公共号免费获取
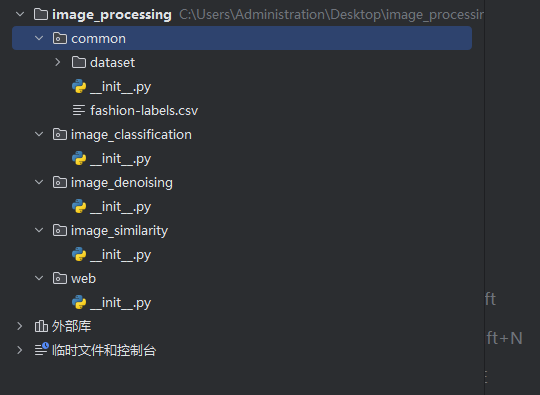
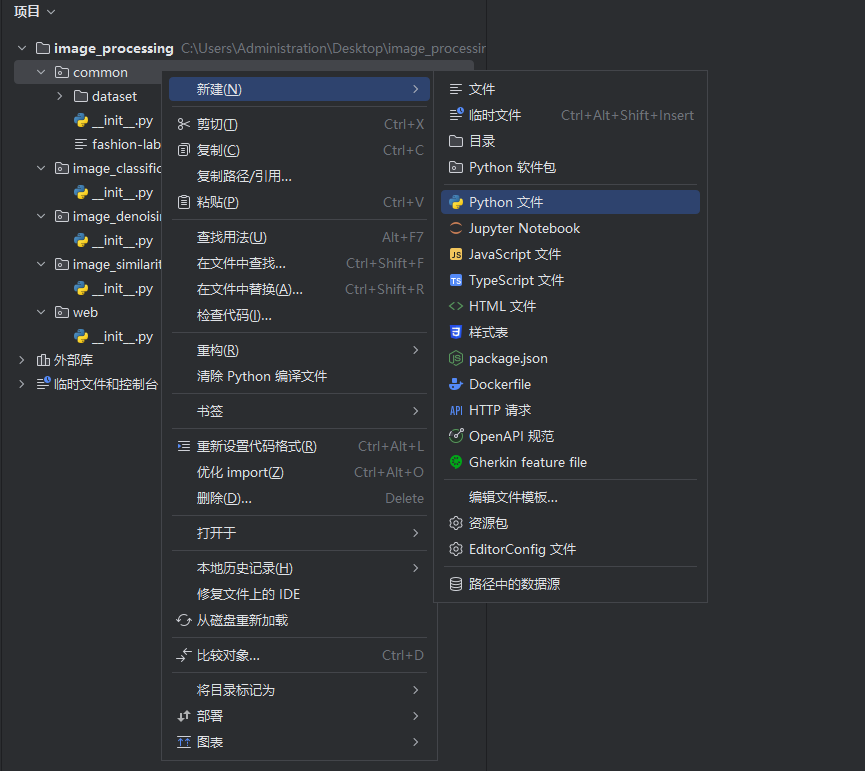
然后 在common文件夹下创建一个util.py这样一个工具类,里面就是包含一些工具函数
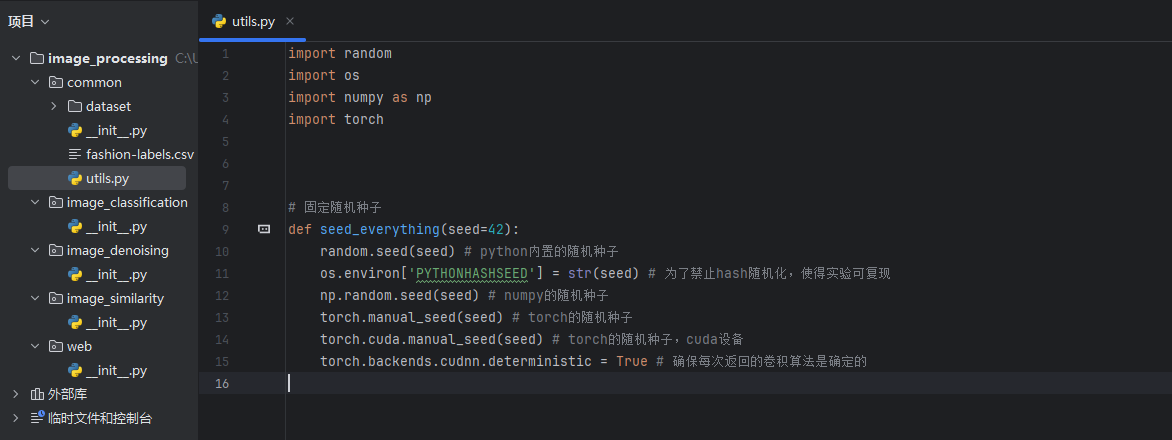
为了使得代码可复现,所以这里在util中添加一个确定的随时数种子,这里的代码,我几乎只打印了第一行,其他的都是人工智能自己生成的,
第三章 去噪模块
去噪模块,首先是一个无噪音的图片,通过一步加噪音,得到一个有噪音的图片,这个有噪音的图片通过一个神经网络得到一些本质特征,通过这个本质特征来与未加噪音的图片来做有监督学习,通过正向传播,反向优化,就能得到通过这个有噪音的图片得到一个无噪音的图片的神经网络,当你有其他的图片需要去噪这个过程的时候,直接使用这个神经网络就能达到去噪的效果,简单来说我们最初的时候有一个A,现在加噪之后就是A’,使用A’使用有监督的得到A,在这个过程中我们训练得到一个黑箱子,这个黑箱子就是能从A’得到A的黑箱子,我们多训练一些数据,也就是使得这个黑箱子的泛化能力得到了提升,所以当我们有一个B’直接通过这个黑箱子,是不是也同样的能起到去噪效果。
3.1 核心结构
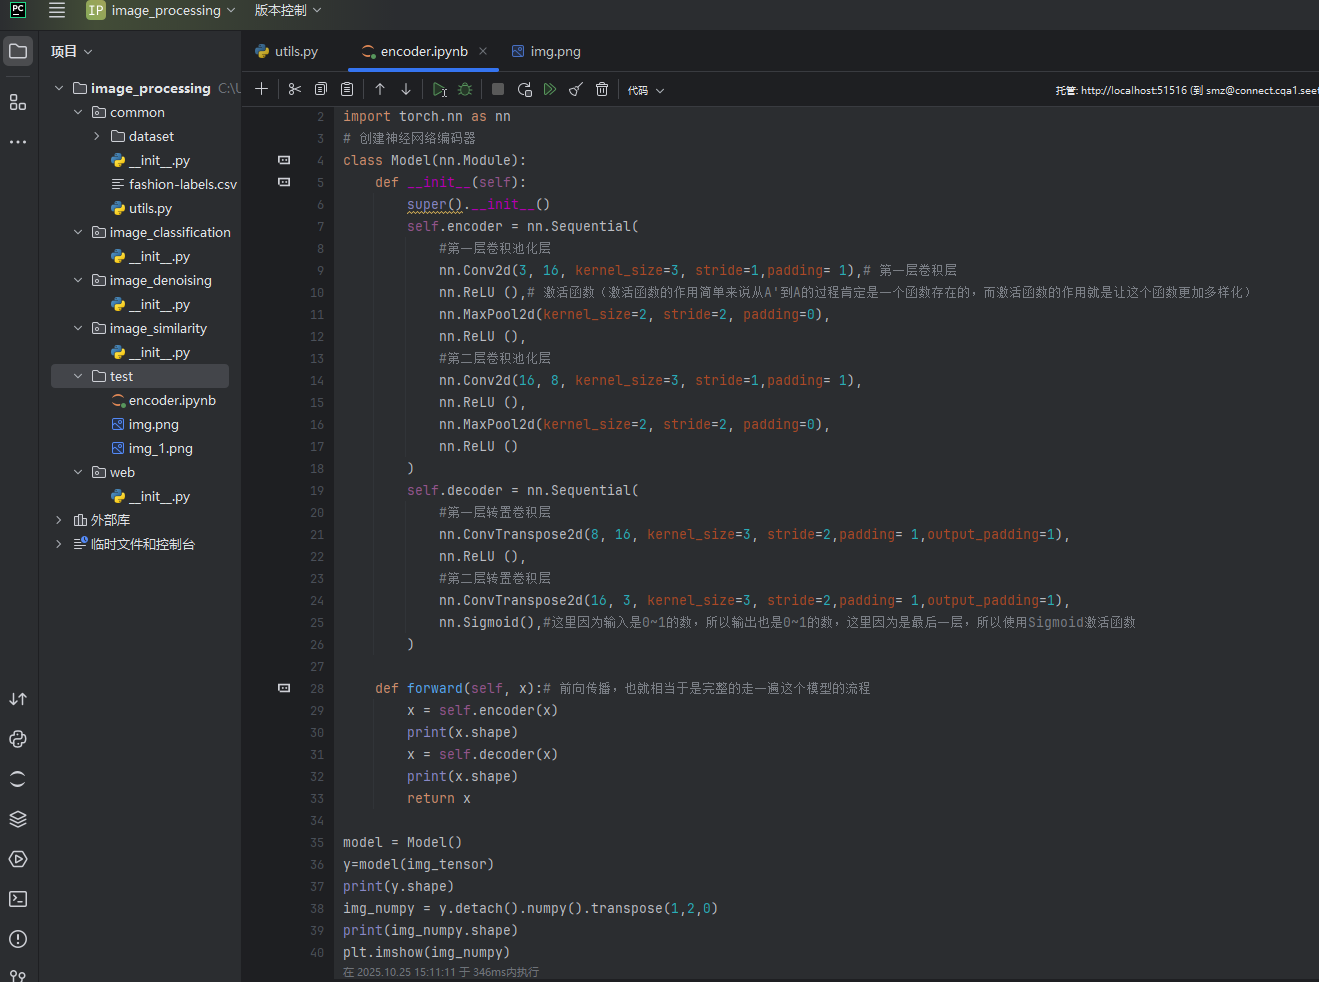
(1)编码器(Encoder)
将输入数据压缩为低纬的潜在表示(编码),也就是提取一些数据数据的关键特征,简单来说输入特征可能是有100个数值,而编码器的作用就是从100个数值中找到10个有用的数值,当然这个数值是我随便说的,而这里的3,16,8这些数值就是相当于多头,若是每一个特征提取看作为一个人进行评分的话,所谓的多头就是相当于不同的人进行评分
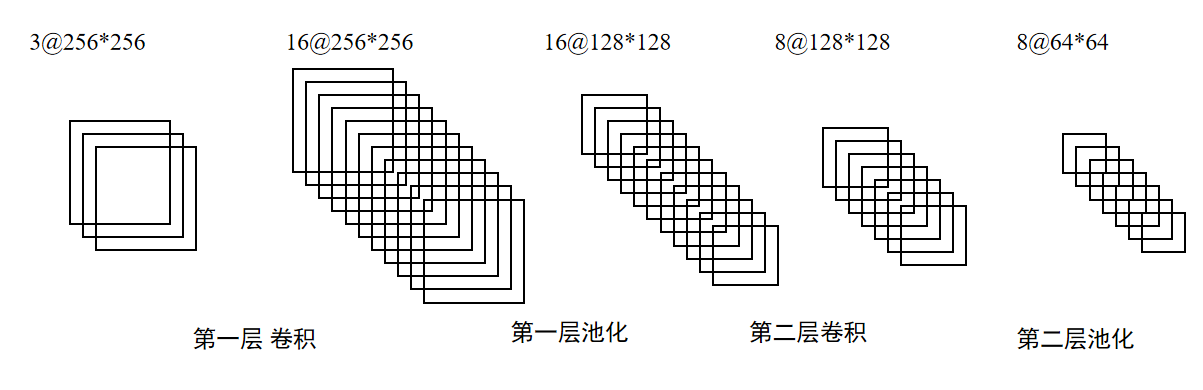
或者通常来所,卷积的时候保持维度不变,通道数增加,池化的时候维度减为一半,若是不想知道具体的过程也无关系,只需要记住,卷积的时候若是要想保持不变也就是使得卷积核k=3,步幅和填充等于1,也就可以保持当前的形状不变,若是要维度减半这里也就是K=2,而步幅S=1,填充P等于0便可(若是想了解这个具体的计算过程,OH=((H+2P-K)/S)+1,这里的OH是输出维度,H是输入维度,P是填充,K是卷积核的大小,S是步幅,若是这些填充步幅不理解可以到b站搜,很多教学视频),
(2)解码器(Decoder)
从潜在表示重建原始数据,目标是尽可能准确的还原输入,简单来说就是通过上述的10个有用的数据起到几乎和100个数值同样的效果,
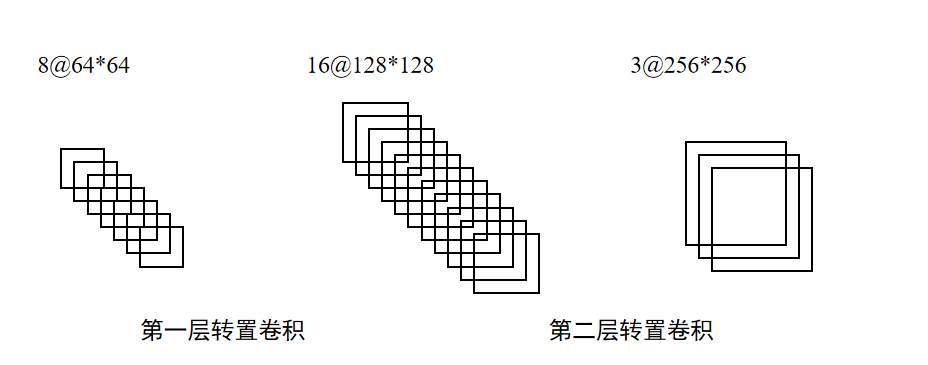
转置卷积能看到都是扩大两倍,也就是相当于上述编码器的逆运算,这里记住我们扩大两倍基本上几个参数都是设置为3,2,1,1,(3是卷积核的大小K,2是步幅S,1是输入的填充P,最后的1是输出填充OP)
最前面的两个是为输入输出通道数,有人可能也想知道这个计算方式,这里将计算方式也放入进来也就是(OH=(H-1)S-2P+K+OP)
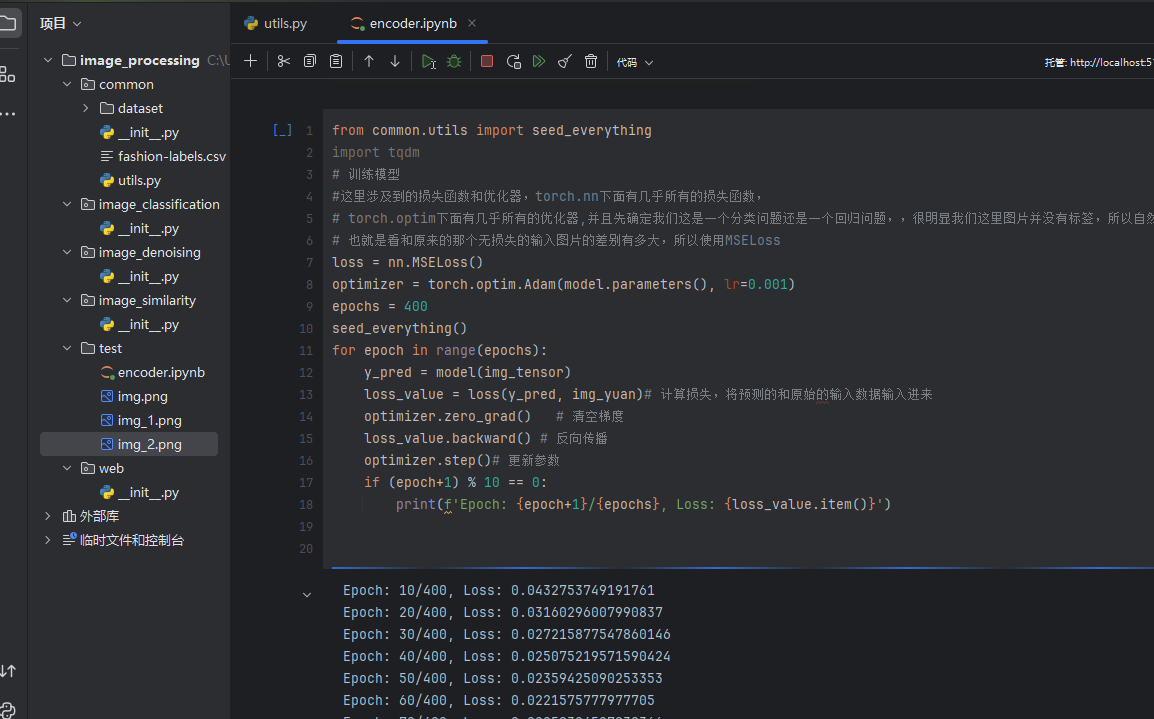
(3)loss损失
通过不断最小化误差来更新模型的参数,loss其实也就是上述两个图片开始的是3@256256 ,最后得到的也是3@256*256,但是他们并不是同一个,所以通过最小化他们之间的差异,这个差异就是损失,
3.2 加载图片
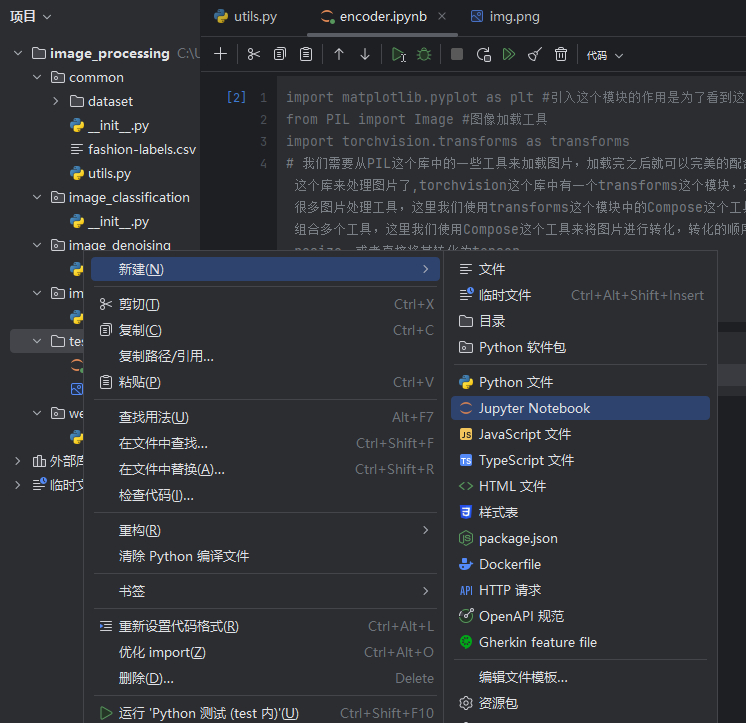
创建一个文件夹test,将图片放置到test文件夹之下(放在这个文件夹下直接就能找到),并且在test文件夹下创建一个encoder文件
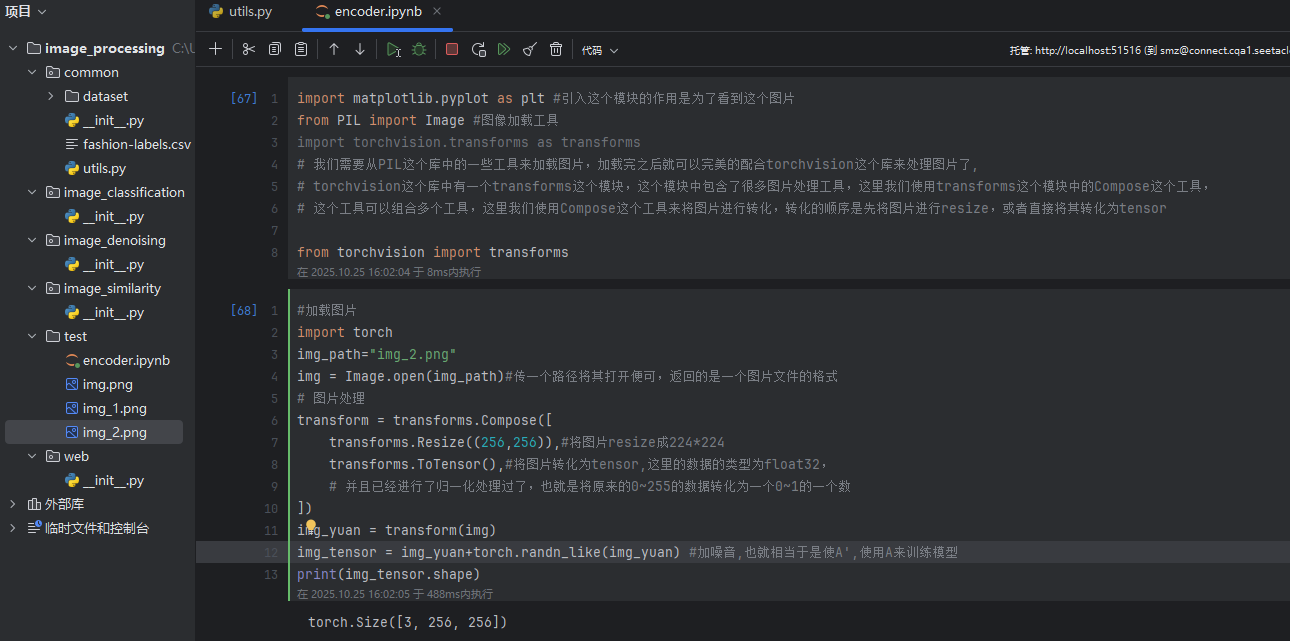
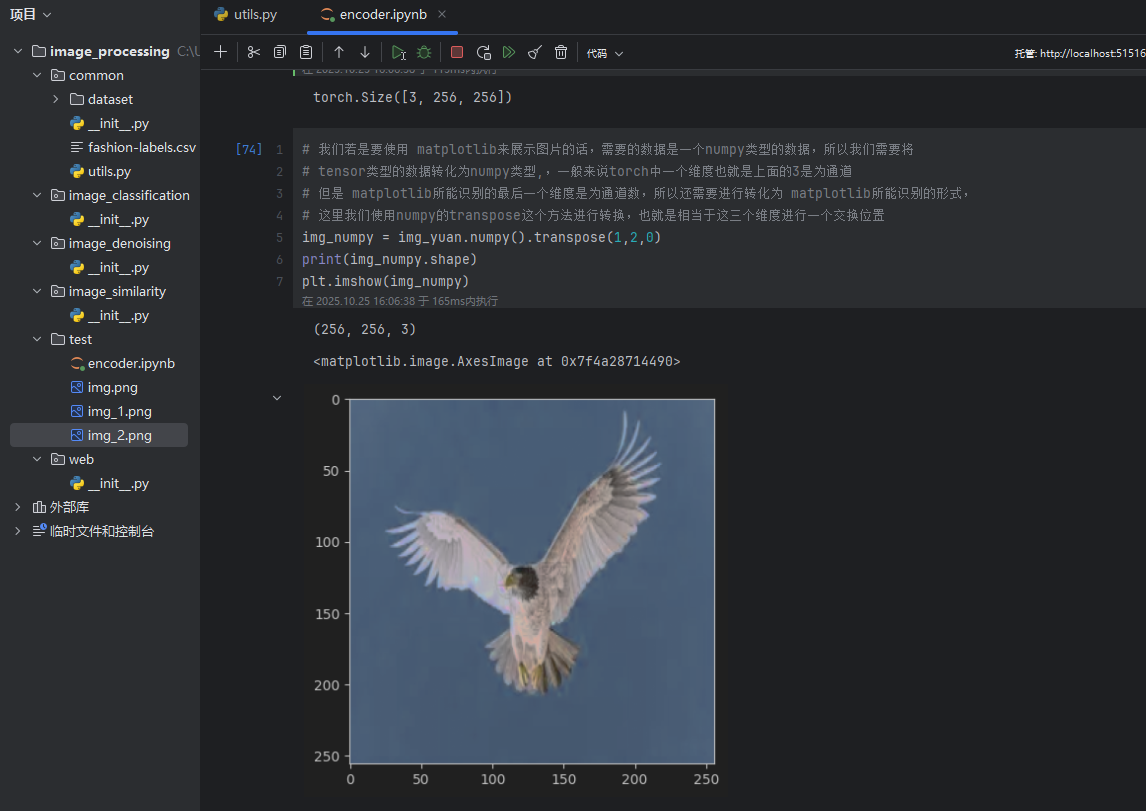
通过这样的处理可以看到我们的图片已经能满足我们想要的编码器的输入了,接下来打印出这个加载的图片
3.3 定义模型
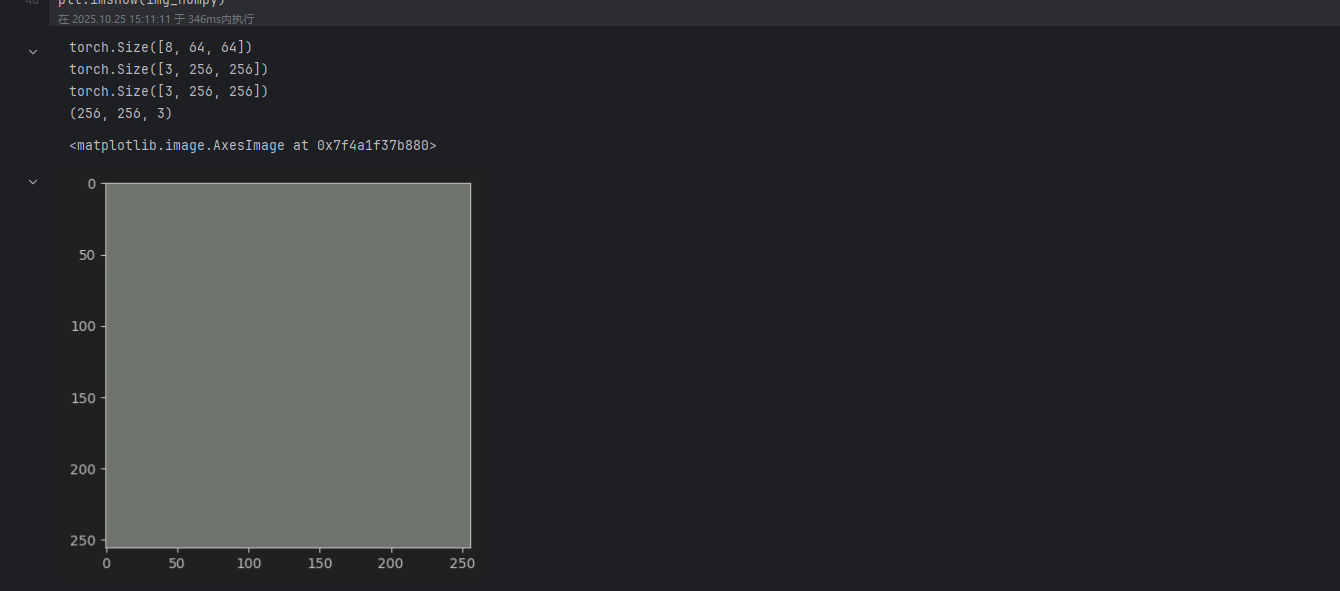
同学,你说通过这个模型的输出此时会是什么?
答案自然是为 ,因为此时的模型还未通过正向传播,反向传播等更新模型的参数,所以此时的参数都是随机值,所以呈现出来的图像也是一个几乎看不出来任何东西的图片
3.4 训练模型
训练模型这里使用经典五步走,模型预测,计算损失,清空梯度,反向传播,更新参数(几乎所有的深度学习模型都是这经典五步走)
3.5 模型预测
使用刚才训练好的模型,进行预测即可
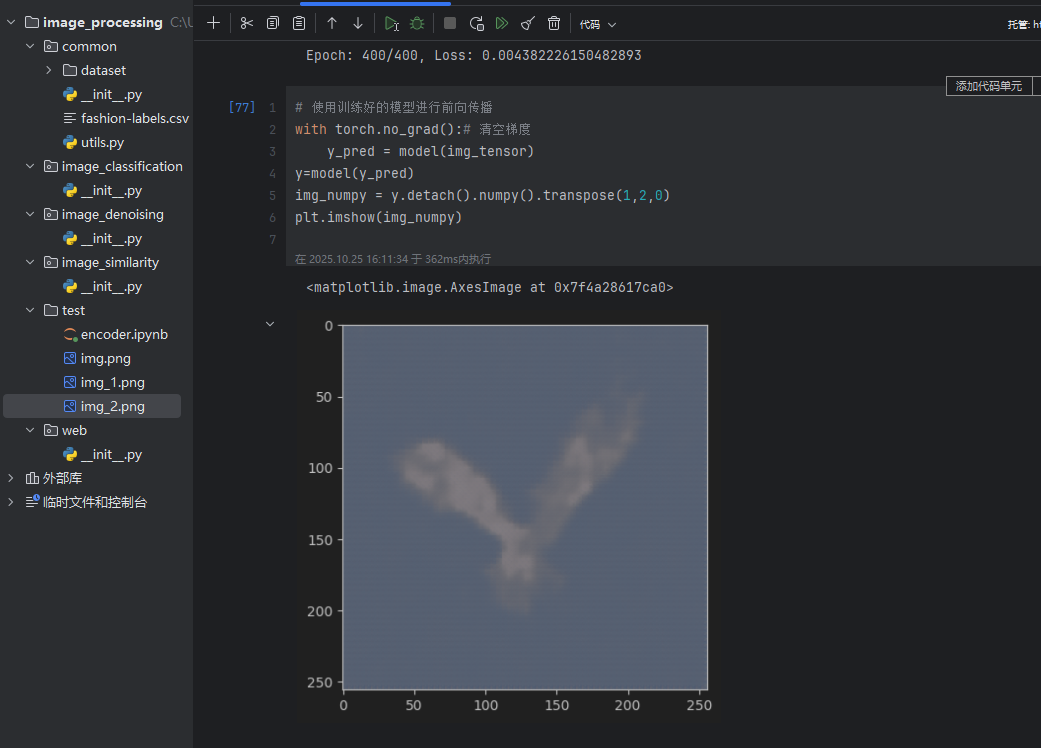
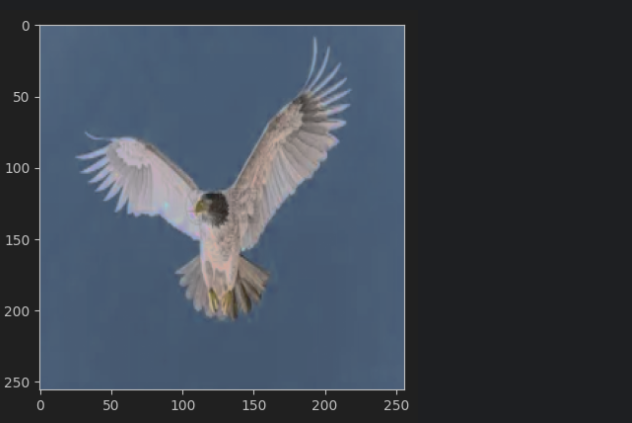
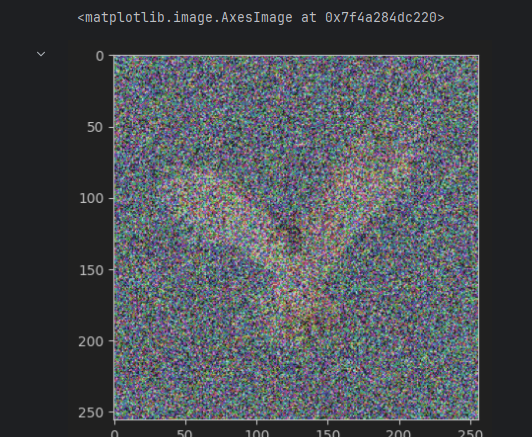
通过对比噪音图片,
原始图片
噪音图片
去噪之后的图片
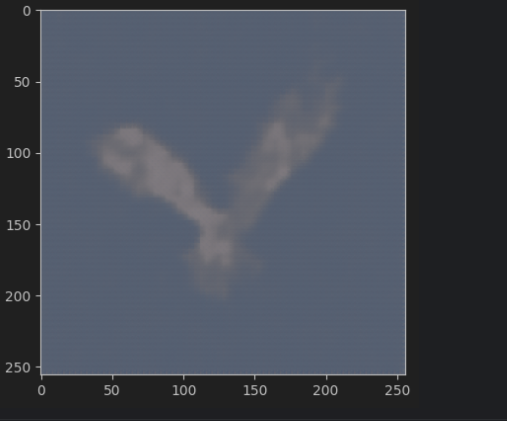
通过这几个图片进行对比,可以看到最后去噪之后的图片虽然不如原始图片,但是对比噪音图片来说已经是一个很大的去噪效果了,现在这个图片还只是这一个图片进行训练,所以泛化能力肯定是很差,所以多一些图片之后,就能提高模型的泛化能力
最后今天的全部代码请关注公众号“Sun小明同学获取”
更多推荐
 11
 0
- 0


 已为社区贡献7条内容

所有评论(0)