
大数据框架
目录
大数据
核心:数据存储、数据计算、数据传输。
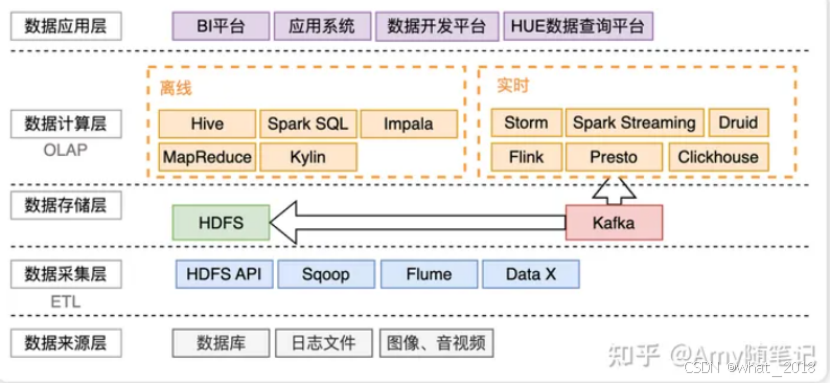
速(Velocity),即资料输入、输出的速度;提取高价值的信息
类(Variety),即多样性。常见的来源有:网络日志、音频、视频、图片等
V是Value:大量的不相关信息,不经过处理则价值较低,属于价值密度底的数据。
以视频为例,连续不间断监控过程中,可能有用的数据仅仅有一两秒。
ETL全称 Extract-Transform-Load,它是将大量的原始数据经过提取(extract)、转换(transform)、加载(load)到目标存储数据仓库的过程。
ETL 虽然大部分应用在大数据领域,对小数据也可以经过这个过程的处理 。 /ɪkˈstrækt/
需求分析 - ETL-指标计算 - 可视化展示(BI软件)
分布式系统常见组织形式
去中心化模式:没有明确中心,大家协调工作。
中心化模式: 没有明确中心,基于中心节点分配工作。
什么是主从模式?
主从模式就是中心化模式,表示一个主节点作为管理者,管理协调下属一批从节点工作
Hadoop 主从模式的中心化模式
什么是计算、分布式计算?
计算:对数据进行处理,使用统计分析等手段得到需要的结果。
分布式计算:多台服务器协同工作,完成一个计算任务。
分布式计算常见的2种工作模式
分散->汇总(MapReduce就是这种模式)
中心调度->步骤执行(大数据体系的Spark、Flink等是这种模式)
流程:
①由一个节点作为中心调度管理者
②将任务划分为几个具体步骤
③管理者安排每个机器执行任务
④最终得到结果数据
场景:项目经理和项目成员,一个分配任务,其余人员领取任务。
hadoop三大组件:
Hdfs分布式文件系统; HBase/Hive都存储在hdfs上
yarn分布式资源调度; [jɑːn]
mapReduce分布式数据计算 [rɪˈdjuːs]、 Spark 、flink快
MapReduce<key,value>
Hive是基于Hadoop的一个数据仓库工具,
将SQL语句翻译成MapReduce程序,sql 语法和mysql类似。
Hive是单机工具,只需要部署一台服务器即可。
Hbase基于hdfs的非关系型数据库,是一种Key/Value系统,它运行在HDFS之上。
分布式集群部署,互相备份
HDFS
block块存储128M
NameNode主节点,进程作为管理节点
DataNode从节点,进程作为工作节点
SecondaryNameDode 主节点的辅助节点都需要启动
分块存储文件,集群之间相互备份
HDFS:// 表示HDFS协议, File:// 表示linux 协议,都是可以省略
命令和linux 基本一样。
Yarn
ResourceManager作为集群资源管理者,进程作为管理节点
NodeManager作为单机资源管理者,进程作为工作节点
ProxyServer 代理服务器保障WEB UI访问安全性、JobHistoryServer 记录历史信息和日志 ,都是辅助节点
都需要启动
MapReduce
无需启动任何进程MapReduce程序运行在yarn容器中。
Map 分散 ,由服务器分布式处理数据。
Reduce 汇总,进行数据汇总统计得到结果。
运行机制
将要执行的需求,分解多个Map task和Reduce Task
将Map Task和Reduce Task 分配对应服务器去执行
存储数据
Hive
Hive是单机工具,只需要部署一台服务器即可。核心架构有元数据管理、sql解析器、用户接口:提交用户hive交互功能。
传统MapReduce开发:写MR代码->得到结果
使用hive开发:写sql->得到结果
底层都是MR在运行,但是使用层面上更加简单。yarn可以看到执行信息
优点:操作接口采用类SQl语法,提供快速开发能力(简单、容易上手)。
Hbase
Hadoop database,即hadoop数据库。
列式存储的分布式数据库 , Key-Value
计算框架
MapReduce->spark->Flink
spark 操作语言是Spark SQL ,比hadoop的mapreduce更快,效率更高。
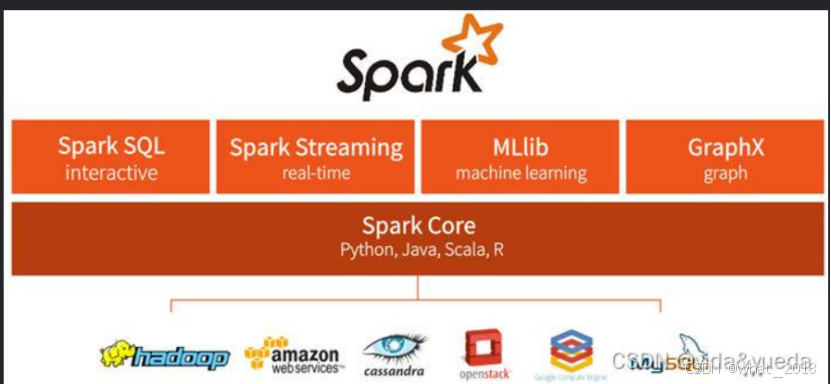
Spark Coke、 Spark SQL 编程、 Spark Streaming 流式数据、 Spark GraphX、 Spark MLlib 机器学习
flink
采用flink流式处理框架计算(一条条写入),写入到redis的mysql中;
Spark Streaming 支持从多种数据源获取数据,包括 Kafka、Flume (实时日志收集系统)
架构发展
Lambda 架构[离线、实时二条线重复业务]
kappa架构[实时,不支持sql分析]
数据湖
数据湖是一个集中式的存储库,可以存储各种数据格式。
例如:结构化型、非结构化数据、视频、文本。
hudi、lceberg
lceberg是一个数据湖解决方案、一个面向海量数据分析场景的开放表格式(Table Format)。
单表可以存储十PB、支持实时批量数据读取/写入,支持 flink 、spark计算引擎、
支持sql查询、添加、删除、更新、回滚数据。适配spark、flink、hive等计算。
Lceberg 是个lib包。
数仓分层:
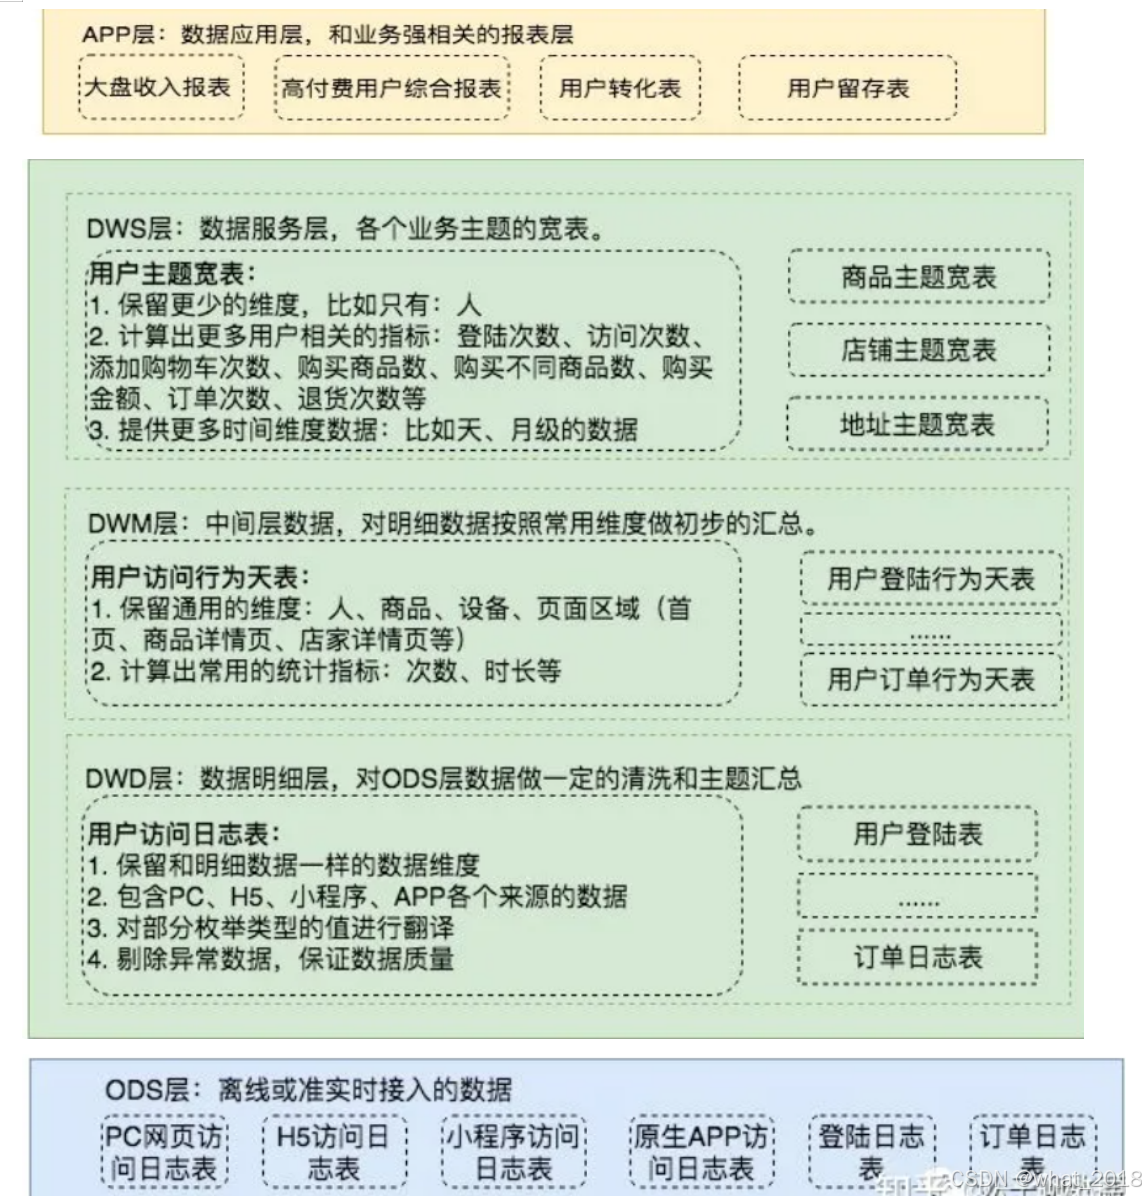
ODS、DWD、DWM、DWS、ADS
ADS(Application Data Store)数据应用层
DWS( data warehouse service)数据服务层,汇总层宽表
DWD是业务层与数据仓库的隔离层, 这一层主要解决一些数据质量问题和数据的完整度问题。[数据清洗过滤、数据映射,转换]
ODS(Operational Data Store,又称数据基础层):将原始数据几乎无处理地存放在数据仓库系统中,结构上与源系统基本保持一致,是数据仓库的数据准备区。
数据采集: Flume、canal /kəˈnæl/ 监听binlog;
场景:日志,爬虫
数据缓存: redis、kafka
数据存储 :hdfs 、hive 、数据湖
数据分析处理:mapReduce、spark、flink
展示:kudu、Mysql、ES
数据中台:提取公共部分
更多推荐


 18
 0
- 0


 已为社区贡献2条内容

所有评论(0)